Hamel Husain블로그
Claude의 새로운 자동 평가 도구
Anthropic이 Claude용으로 내놓은 새 평가 플러그인을 직접 써본 소감을 정리했습니다.
Anthropic이 Claude Code용 새 평가 도구를 공개했습니다. claude-api 플러그인에 build_eval와 hill-climb 명령어가 추가되어, 평가(eval)를 만들고, 채점기(grader)를 점검하고, 그 평가를 기준으로 애플리케이션을 개선할 수 있습니다.
저는 보통 평가 도구 리뷰를 쓰지 않습니다. 소프트웨어는 변화가 워낙 빨라서 리뷰의 유통기한이 짧기 때문입니다. 하지만 Anthropic이 직접 만든 도구라면 사람들이 평가에 접근하는 방식에 영향을 줄 가능성이 크기에, 한번 써보기로 했습니다.
저는 Isaac Flath와 함께 아파트 임대 상담 어시스턴트의 대화 트레이스로 이 도구를 써보는 과정을 라이브 스트리밍했습니다. 그 결과는 다음과 같습니다.
아쉬운 점
1. 데이터를 보기도 전에 평가부터 만들게 합니다
Claude는 먼저 발생 가능한 실패 유형을 몇 가지 제안한 뒤, 그중 하나를 골라 바로 평가로 만들자고 했습니다. 아래 메뉴에서는 통화 전환 규칙이 추천 항목이었습니다. 하지만 저희는 아직 대화를 직접 살펴보지 않은 상태라, 이것이 실제로 발생하는 실패인지, 우선순위를 둘 만한 문제인지 판단하기 어려웠습니다. 그래도 일반적인 사용자라면 그렇게 할 것 같아서 추천안을 그대로 따랐습니다.
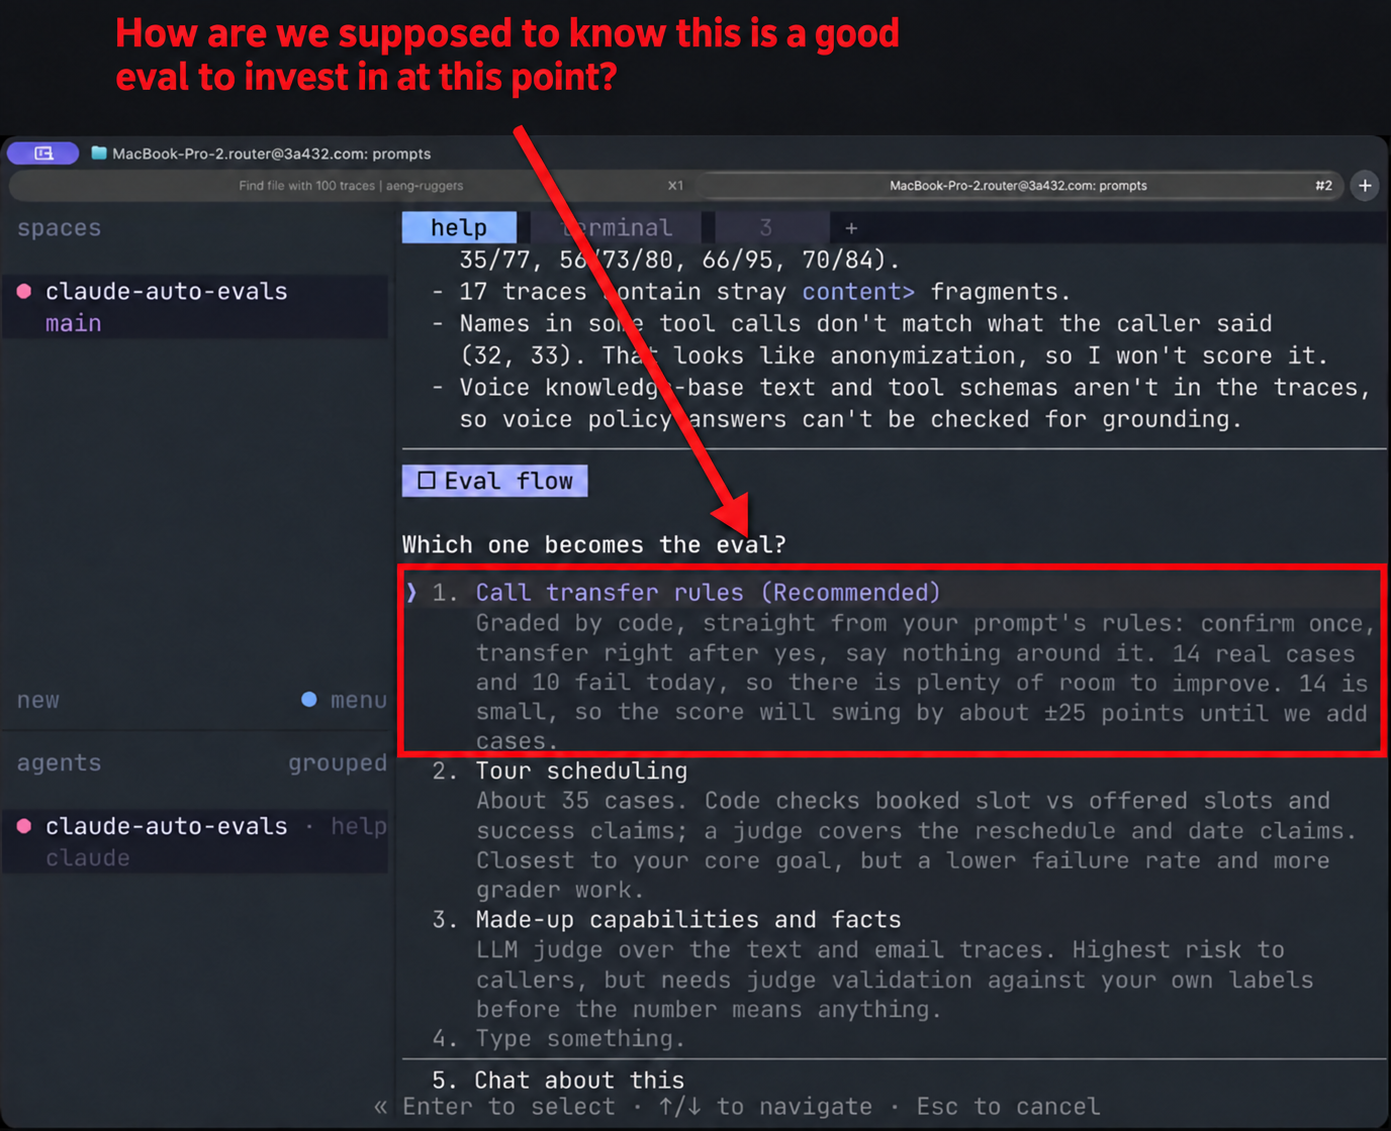
저는 데이터를 먼저 보고 상황을 파악한 다음, 어떤 평가를 작성할지 우선순위를 정해야 한다고 생각합니다. 에이전트가 문제를 찾는 데 도움을 줄 수는 있지만, 다음 단계로 넘어가기 전에 어떤 실패에 주목할지는 오류 분석(error analysis)을 통해 직접 판단해야 합니다.
2. 충분한 맥락 없이 판단을 검증하라고 요구합니다
다음으로 Claude는 통화 전환 실패와 관련된 데이터를 볼 수 있도록 Markdown 파일을 만들었습니다. 아래 스크린샷에서 Claude는 inputs.md를 훑어보고 어떤 라벨이 틀렸는지 "알려 달라"고 요청합니다. 긴 대화를 편집기에서 읽은 다음, 수정할 내용은 채팅창에 따로 알려야 한다는 뜻입니다.
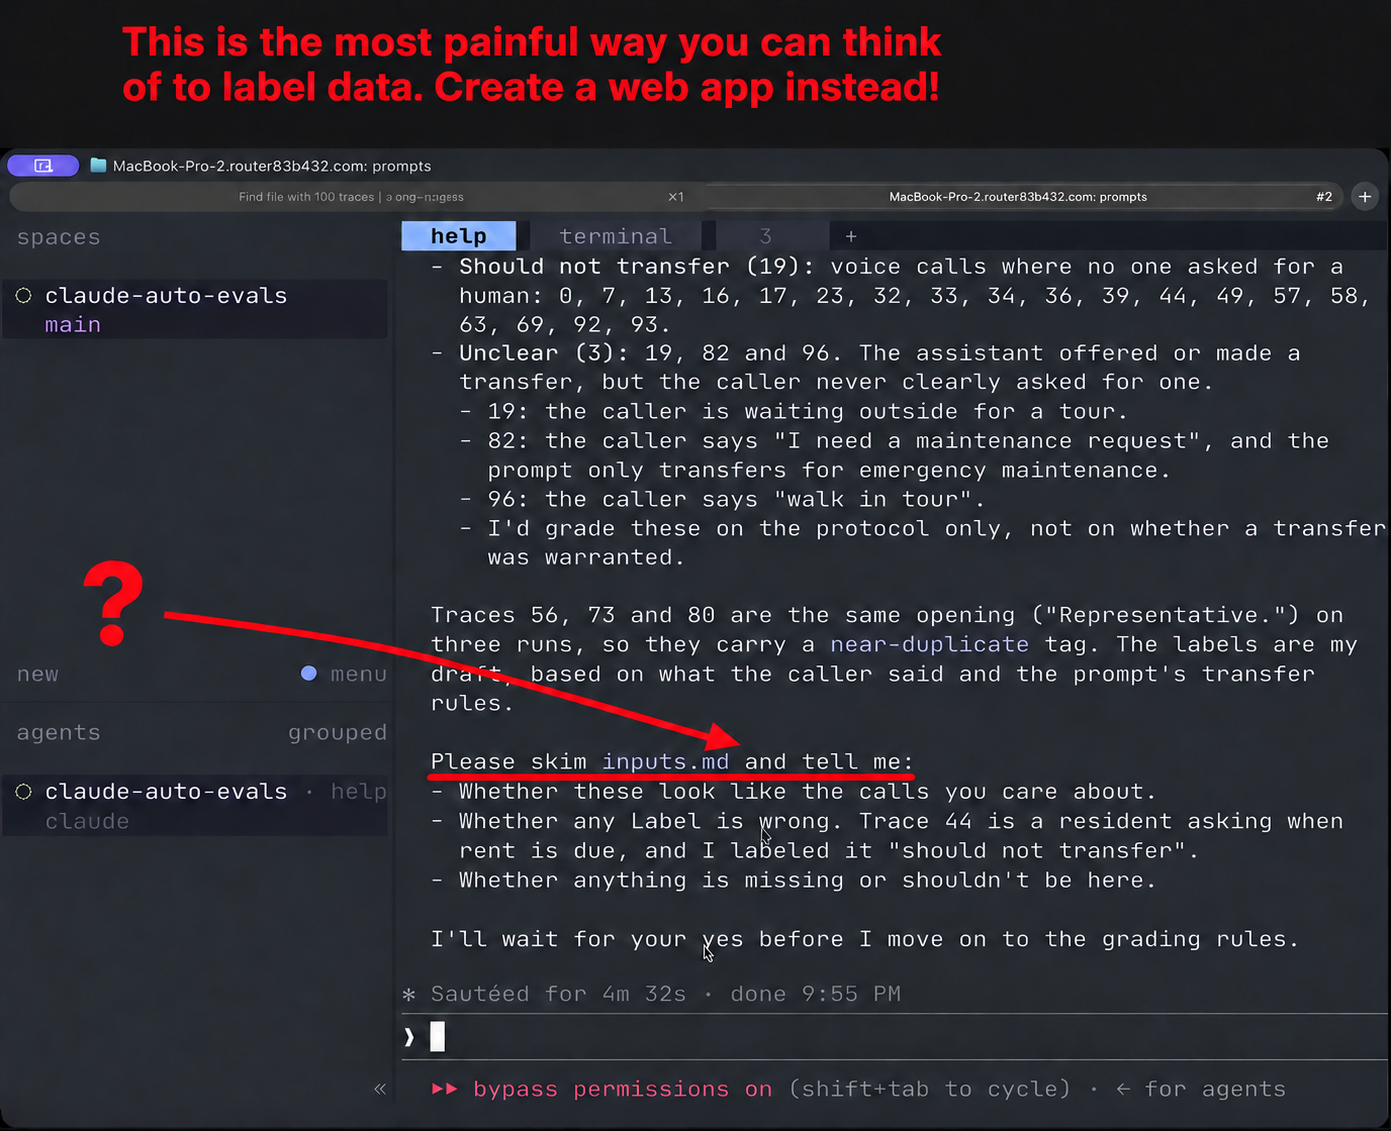
코딩 에이전트를 쓰고 있는데 이런 방식은 너무 어처구니없었습니다. 대화를 읽기 쉽게 보여 주고 그 자리에서 바로 피드백을 남길 수 있는 어노테이션 앱을 만들어 줬어야 합니다. 결국 저희가 Claude에게 웹 앱을 만들어 달라고 요청했고, 이후에는 그 앱을 사용했습니다.
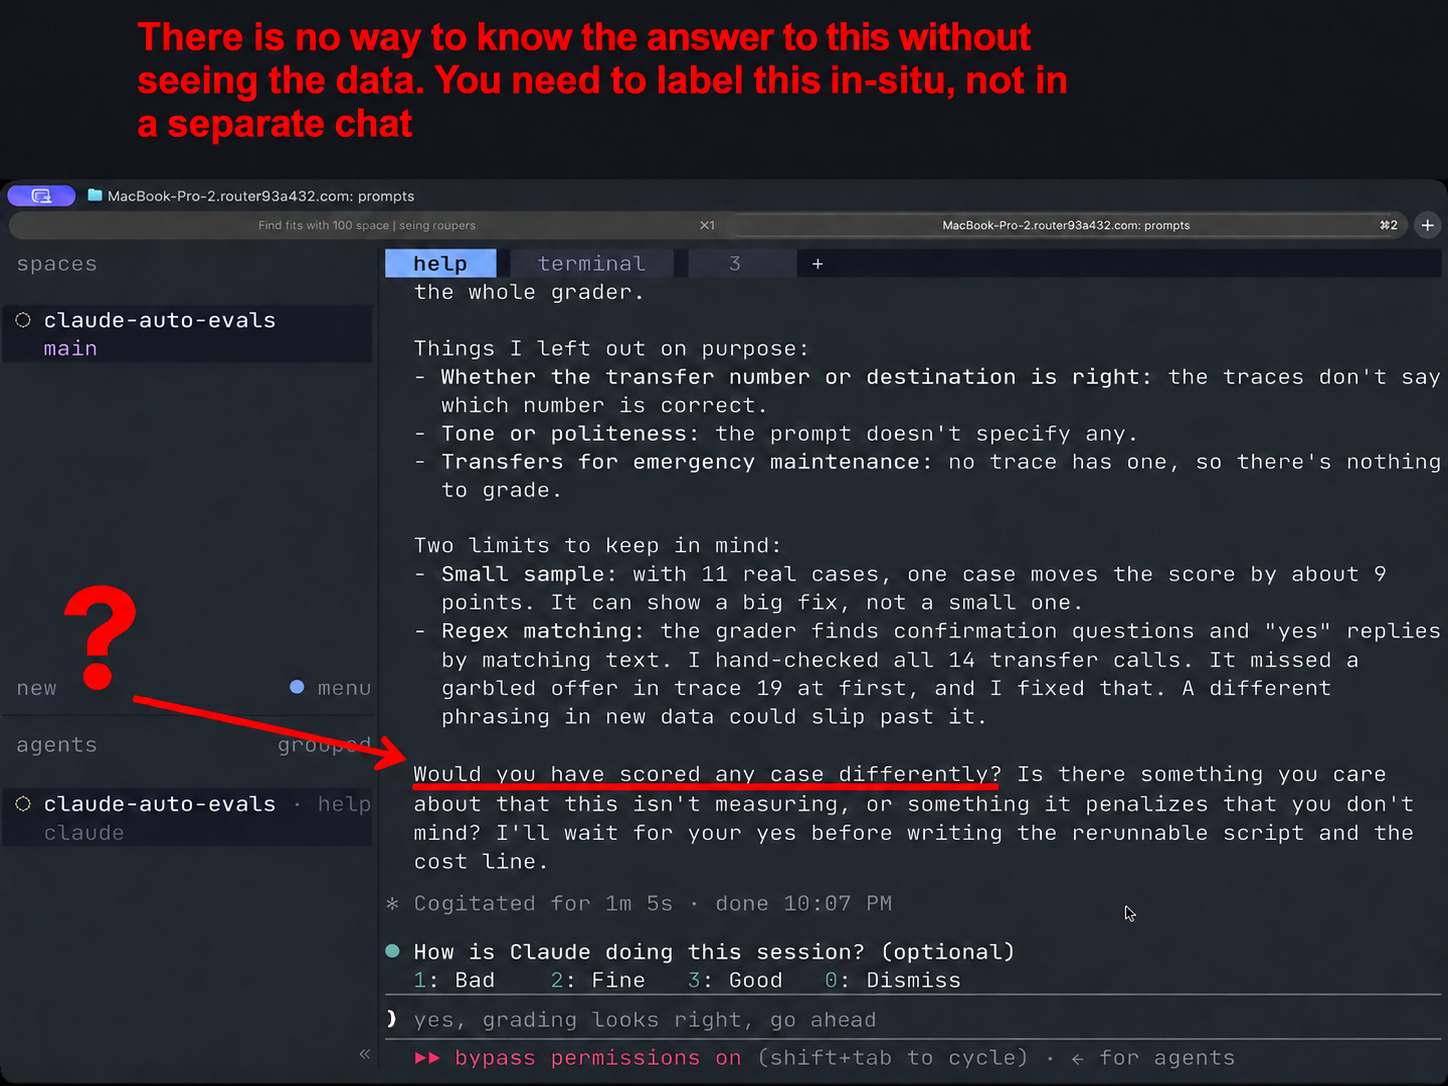
워크플로 후반부에서 Claude는 통화 전환 실패를 잡아내는 평가기(evaluator)의 초안을 만들었습니다. 그러면서 라벨별 집계 수치만 보여 주고 "다르게 채점할 케이스가 있나요?"라고 물었습니다. 라벨이 맞는지 판단할 만한 정보는 주지 않았습니다. 이 워크플로에서는 데이터를 이해하도록 돕기보다 산출물부터 서둘러 만들거나 승인부터 요구하는 패턴이 계속 반복되었습니다.
3. 평가기의 범위가 너무 넓습니다
이어서 이 도구는 서로 다른 네 가지 실패를 한꺼번에 검사하는 통화 전환 평가기를 만들었습니다.
- 확인을 두 번 이상 요청하거나, 확인 없이 전환함 (LLM as a Judge)
- 상대방이 동의한 시점부터 전환 전까지 사이에 다른 말을 함 (코드 기반 평가)
- 전환 도중이나 전환 후에 말을 함 (코드 기반 평가)
- 전환을 "트리거"한다는 식으로 도구 동작 방식을 소리 내어 말함 (코드 기반 평가)
이 평가기에는 너무 많은 내용이 뭉뚱그려져 있었습니다. 저라면 평가 하나가 오류 하나만 다루도록 범위를 좁히겠습니다. 그게 어렵다면 최소한 코드 기반 평가가 필요한 항목과 LLM as a Judge가 필요한 항목은 나누겠습니다.
Claude가 평가기를 설명하는 방식도 헷갈렸습니다.
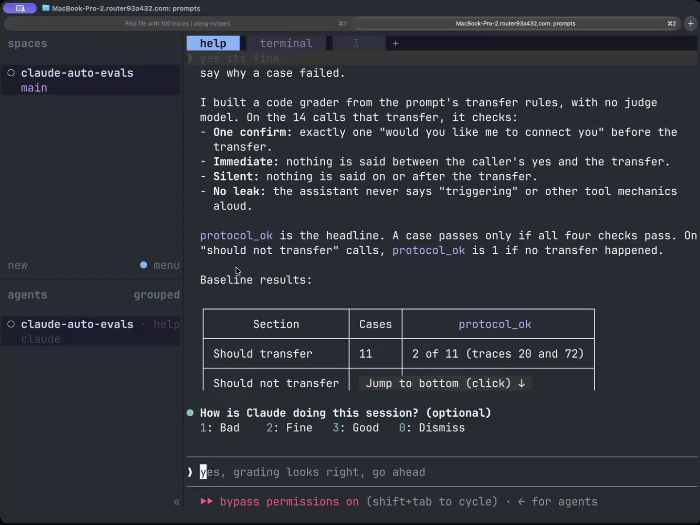
protocol_ok is the headline. A case passes only if all four checks pass. On “should not transfer” calls, protocol_ok is 1 if no transfer happened.
이런 AI 슬롭은 읽기가 힘듭니다. 무엇이 만들어지고 있는지 이해할 수 있도록 차라리 코드나 judge 프롬프트를 보여 주는 편이 훨씬 낫습니다. 특히 평가처럼 중요한 작업이라면 프롬프트를 꼭 읽어 볼 만한 가치가 있다는 것을 여러 번 확인했습니다. 워크플로의 이 부분은 아래 스크린샷과 같았습니다.
좋았던 점
이 플러그인은 다른 자동 평가 방식이 찾지 못했던 문제를 별도 설정 없이도 발견해 내서 인상적이었습니다. 사람에게 넘기는 핸드오프, 포맷팅, 음성 에이전트 등에서 문제를 찾아냈습니다. 에이전트와 함께 데이터를 반복해서 살펴보는 편이 여전히 더 낫지만, "원샷"에 가까운 문제 발견 방식 중에서는 지금까지 본 것 중 가장 성능이 좋았습니다.
이 도구를 소개한 Anthropic의 블로그 글도 대체로 제가 동의하는 생각을 담고 있습니다. 데이터를 보는 일의 중요성, 똑똑하게 샘플링하기, 자체 평가를 포화시키지 않기 등이 그렇습니다. 더 많은 사람이 평가를 이런 식으로 생각하게 되어 정말 기쁩니다.
직접 쓸 의향은?
당분간은 보류하겠습니다. 평가기를 확정하기 전에 데이터를 탐색하도록 돕고, 처음부터 더 나은 리뷰 인터페이스를 제공하는 워크플로라면 좋겠습니다. 게다가 저는 Shreya와 제가 함께 만든 Eval 스킬을 활용해 코딩 에이전트로 하는 작업에도 이미 꽤 만족하고 있습니다. 이 스킬은 특정 방식을 덜 강제하는 대신 더 유연합니다.
이후 Claude 평가 플러그인을 만든 개발자와 이야기를 나눴습니다. 그는 피드백에 고마워하며 플러그인을 그에 맞게 업데이트하겠다고 했으니, 곧 달라질 것으로 예상합니다. 나중에 다시 살펴볼 만할 수 있습니다.
이 플러그인이 바뀌더라도, 이 체험기가 다른 평가 도구를 판단하는 데 도움이 되면 좋겠습니다. 평가를 고르기 전에 도구가 데이터를 이해하도록 돕는지, 도구의 판단을 꼼꼼히 검토할 수 있는지 꼭 확인하세요. 저는 평가 워크플로의 상당 부분이 채팅이 아니라 웹 애플리케이션에서 이뤄져야 데이터 탐색과 어노테이션의 불편함이 사라진다고 생각합니다.
기억하세요. 데이터를 보는 일을 워크플로의 중심에 두지 않는 평가 도구는 쓸 가치가 없습니다.
이 글을 검토하고 라이브 스트리밍에 함께해 준 Isaac Flath에게 감사드립니다.

