Anthropic개발 블로그Playbooks
Claude로 평가 설계와 힐클라이밍 자동화하기
스스로를 속이지 않으면서 평가를 설계하고 그 평가를 기준으로 힐클라이밍을 진행하는 원칙을 정리했습니다. claude-api 스킬의 build-eval, hillclimb 명령어가 이 원칙을 실제로 어떻게 구현하는지도 함께 소개합니다.
평가(evaluation)는 앱이나 스킬이 특정 작업에서 어느 정도 성능을 내는지 알려 주는 신호입니다. 하지만 평가를 설계하는 일, 그리고 스스로를 속이지 않으면서 그 평가 점수를 끌어올리는 일은 모두 쉽지 않습니다. 그래서 claude-api 스킬에 두 가지를 위한 가이드를 추가했습니다.
이 스킬을 쓰면 /claude-api build-eval을 실행해 코드베이스 안에 평가를 만들 수 있습니다. 이어서 /claude-api hillclimb를 실행하면 그 평가를 기준으로 애플리케이션을 한 번에 하나씩 개선해 나가며, 따로 떼어 둔(held-out) 예시 세트로 과적합을 잡아냅니다.
이 글에서는 좋은 평가 설계와 힐클라이밍의 원칙을 먼저 짚고, claude-api 스킬을 사용하는 Claude Code가 이 원칙을 어떻게 적용하는지 살펴봅니다. 마지막으로 이 명령어들을 실제로 사용한 예시를 몇 가지 소개합니다.
평가 설계
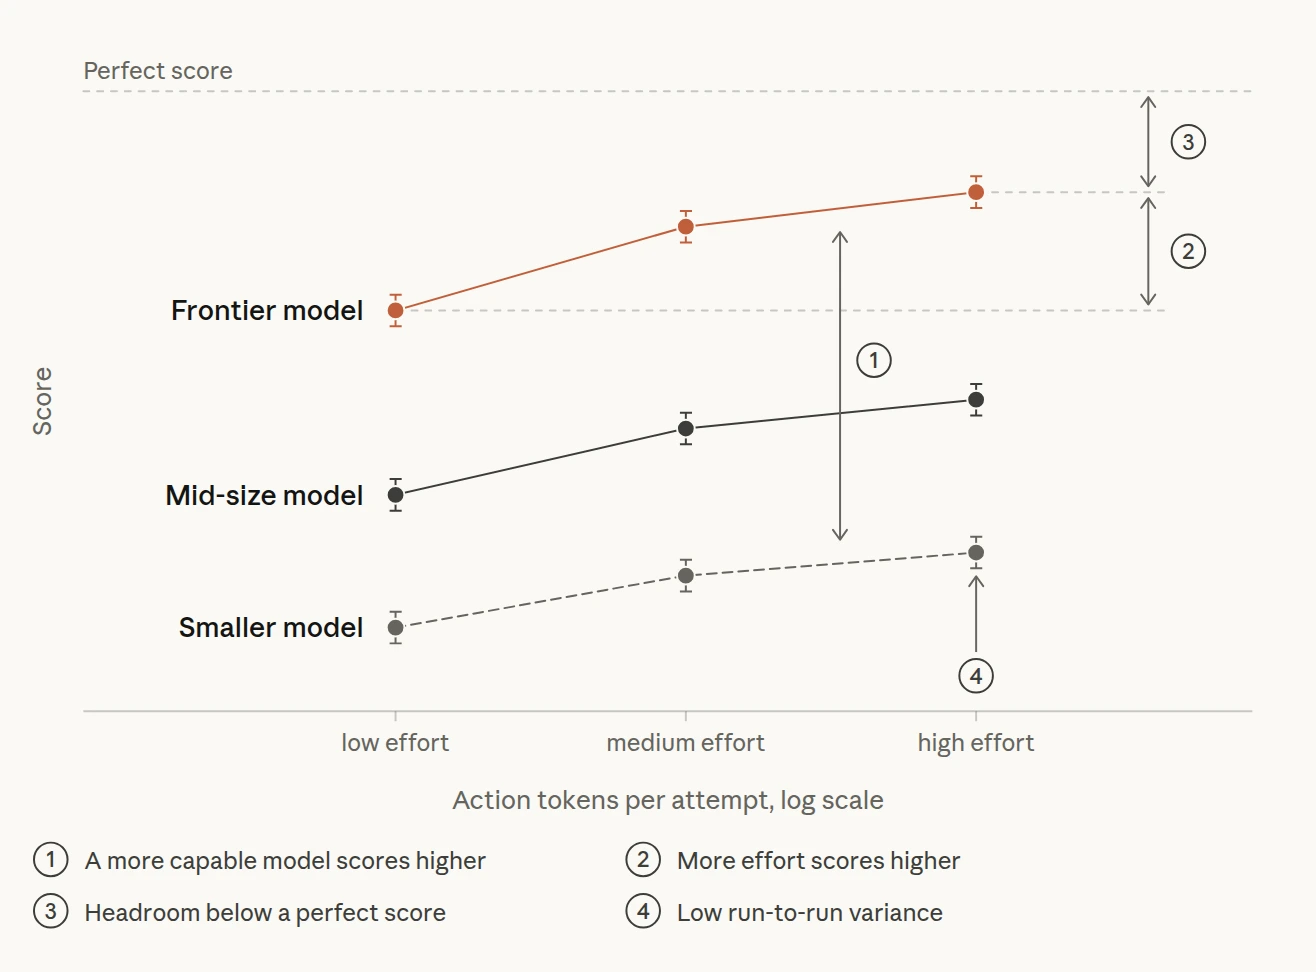
잘 설계된 평가에는 몇 가지 공통 요소가 있습니다(그림 1).
- 평가 작업은 프로덕션 환경을 그대로 반영합니다. 테스트하려는 기능이나 애플리케이션이 실제로 쓰이는 환경, 즉 "프로덕션"에서 중요하게 여기는 작업을 샘플링하세요. 만들기 쉽거나 채점하기 쉽다는 이유로 작업을 고르는 경우가 종종 있습니다. 하지만 작업 분포가 실제로 중요하게 여기는 것을 대표하는지 반드시 확인해야 합니다.
- 더 강력한 모델과 더 많은 사고를 투입할수록 성능이 올라갑니다. 일반적으로 성능이 더 뛰어난 모델과 더 높은 effort 수준에서는 평가 결과가 더 좋아야 합니다. 그렇지 않다면 모호한 작업이나 제대로 보정되지 않은 채점기가 성능을 깎고 있을 가능성이 큽니다.
- 최상위 모델에도 "통과 가능한" 여유 구간(headroom)이 있습니다. 가장 뛰어난 모델을 가장 높은 effort로 돌려도 점수가 100%에 한참 못 미쳐야 합니다. 그렇지 않으면 변경이 성능에 미치는 영향을 믿을 만하게 판단할 수 없습니다. 중요한 점은 이 격차가 불가능하거나 모호한 작업 때문이면 안 된다는 것입니다. 반복 횟수와 상관없이 평가를 돌릴 때마다 계속 실패하는 작업이 있다면 대표적인 신호입니다. 좋은 작업이란 해당 분야 전문가 두 사람이 같은 결론에 이르고, 채점기가 확인하는 모든 내용이 작업 설명에 명시되어 있는 작업입니다.
- 실행 간 편차가 작습니다. 편차가 큰 원인은 대개 설계가 부실하고 모호한 작업이거나, 똑같은 출력에도 판정이 달라지는 채점기입니다. 편차는 설정에 숨어 있기도 합니다. 예를 들어 effort가 일관되게 적용되지 않을 수 있습니다. 환경도 평가 결과에 영향을 줍니다. 이전 시도에서 남은 상태(파일, git 히스토리 등)가 에이전트에게 정답을 알려 주는 경우가 그렇습니다.
적대적 샘플링
모델의 능력은 들쭉날쭉합니다. 오늘의 모델이 실패한다는 이유로 사례를 고르면, 결국 특정 모델의 능력 곡면에서 골짜기만 샘플링하는 셈입니다(그림 2). 이렇게 만든 평가는 애플리케이션 입장에서 본질적으로 어렵거나 가치 있는 일이 아니라, 그 모델만의 실패 지문을 측정하게 될 수 있습니다.
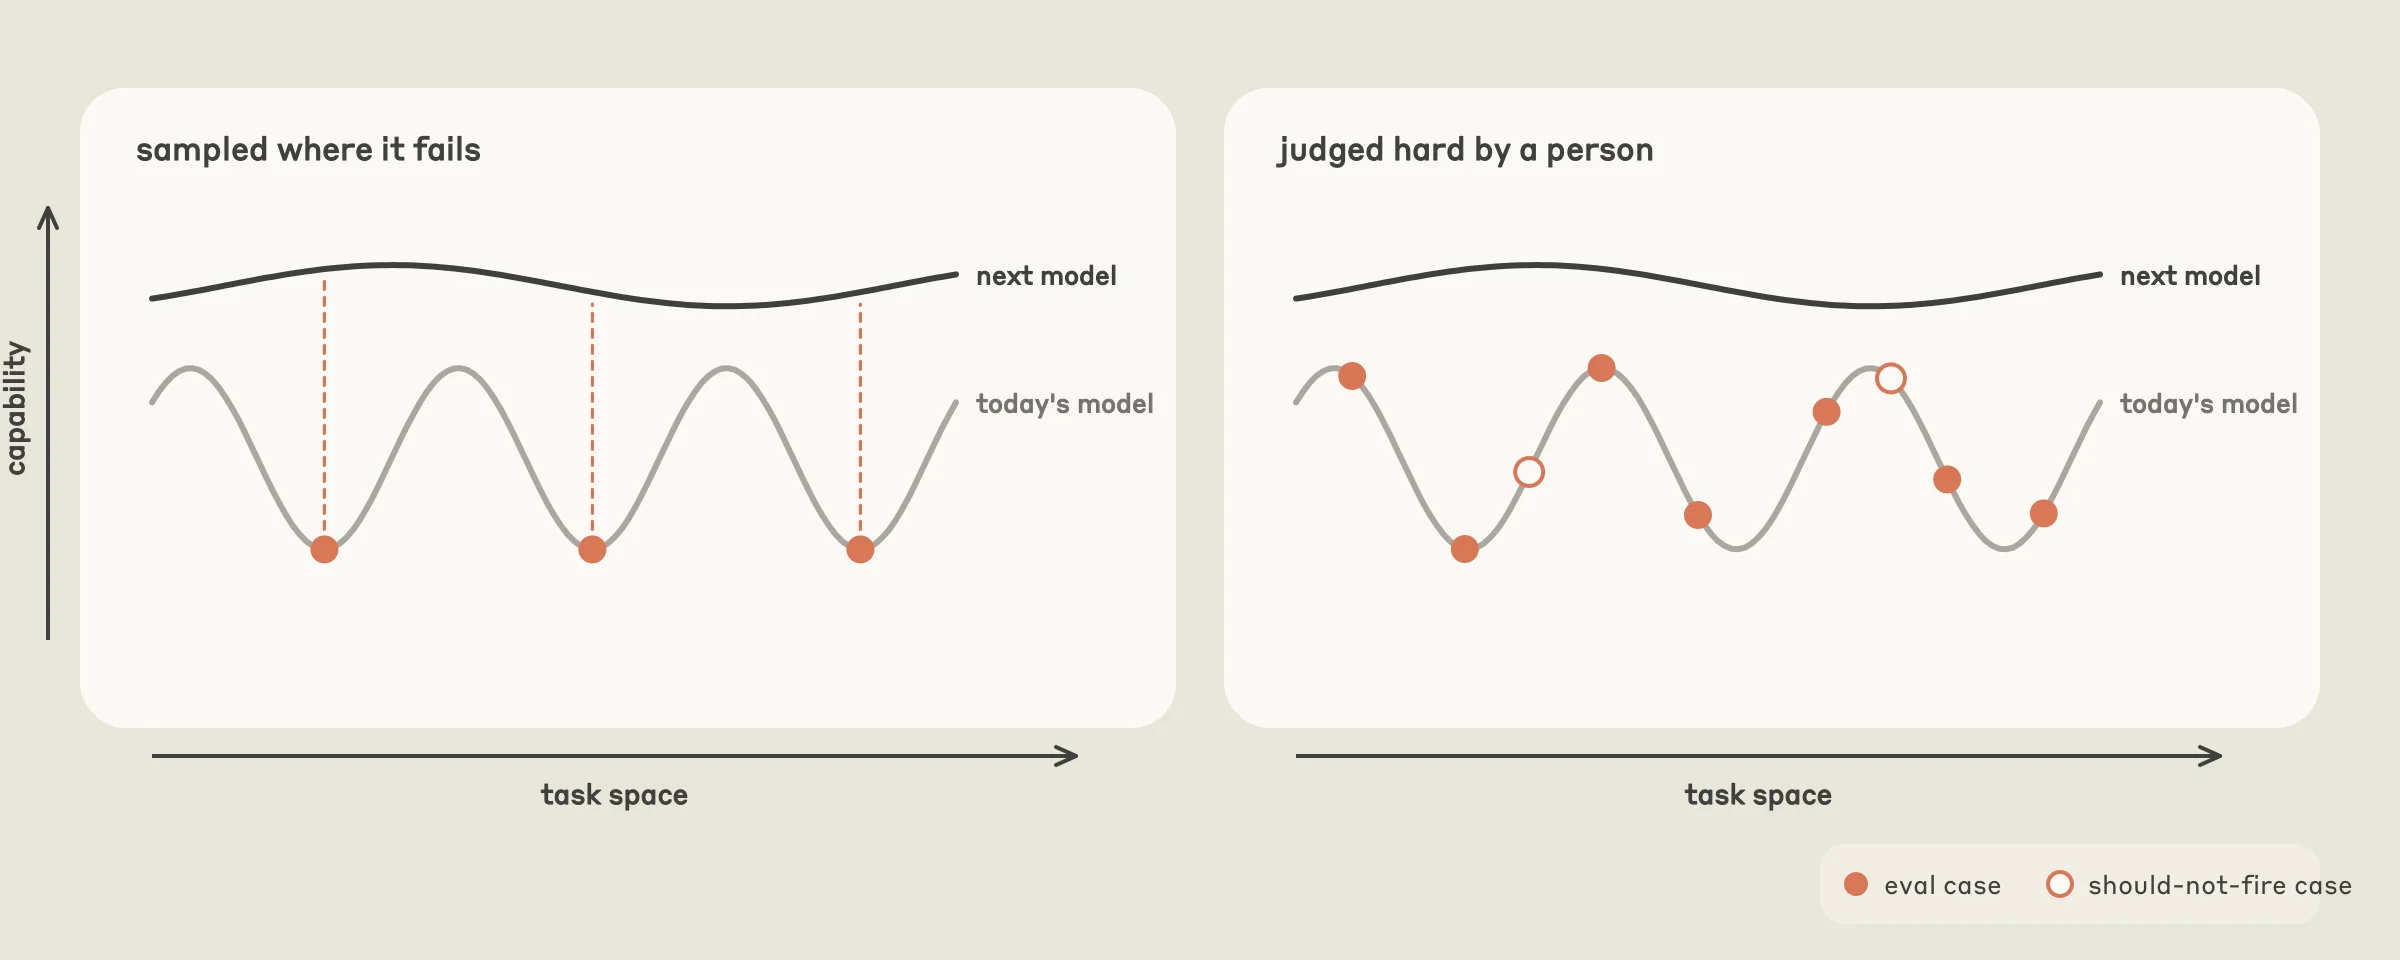
어려운 사례는 사람이 어렵다고 판단했기 때문에 골라야 합니다. 작업을 넣기 전에 왜 어려운지 설명할 수 있는지 확인해 보면 도움이 됩니다. 프로덕션 트래픽, 버그 리포트, 티켓에서 나온, 애플리케이션 고유의 실패 사례도 포함하세요. 다만 사용자 트래픽을 맹신해서는 안 됩니다. 사용자는 대개 될 것 같은 일만 시도하기 때문에, 사용자 트래픽에서만 뽑은 작업 분포는 쉬운 쪽으로 치우칠 수 있습니다.
/CLAUDE-API BUILD-EVAL
claude-api 스킬의 build-eval 명령어는 이 원칙을 안내형 워크플로로 만든 것입니다. Claude Code에서 /claude-api build-eval를 실행하면 Claude가 먼저 질문을 던져 요구 사항을 파악하고, 코드베이스 안에 평가를 구축하며, 정해진 지점마다 멈춰서 승인을 받습니다.
예시 설계
Claude는 다음 순서로 입력을 샘플링해 평가를 구성하도록 돕습니다.
- 프로덕션 대화 기록: 데이터 보관 기간과 민감 정보 여부를 먼저 확인합니다.
- 버그 리포트와 고객 지원 티켓
- 직접 작성한 5~10개의 사례
- 코드베이스를 바탕으로 합성한 사례
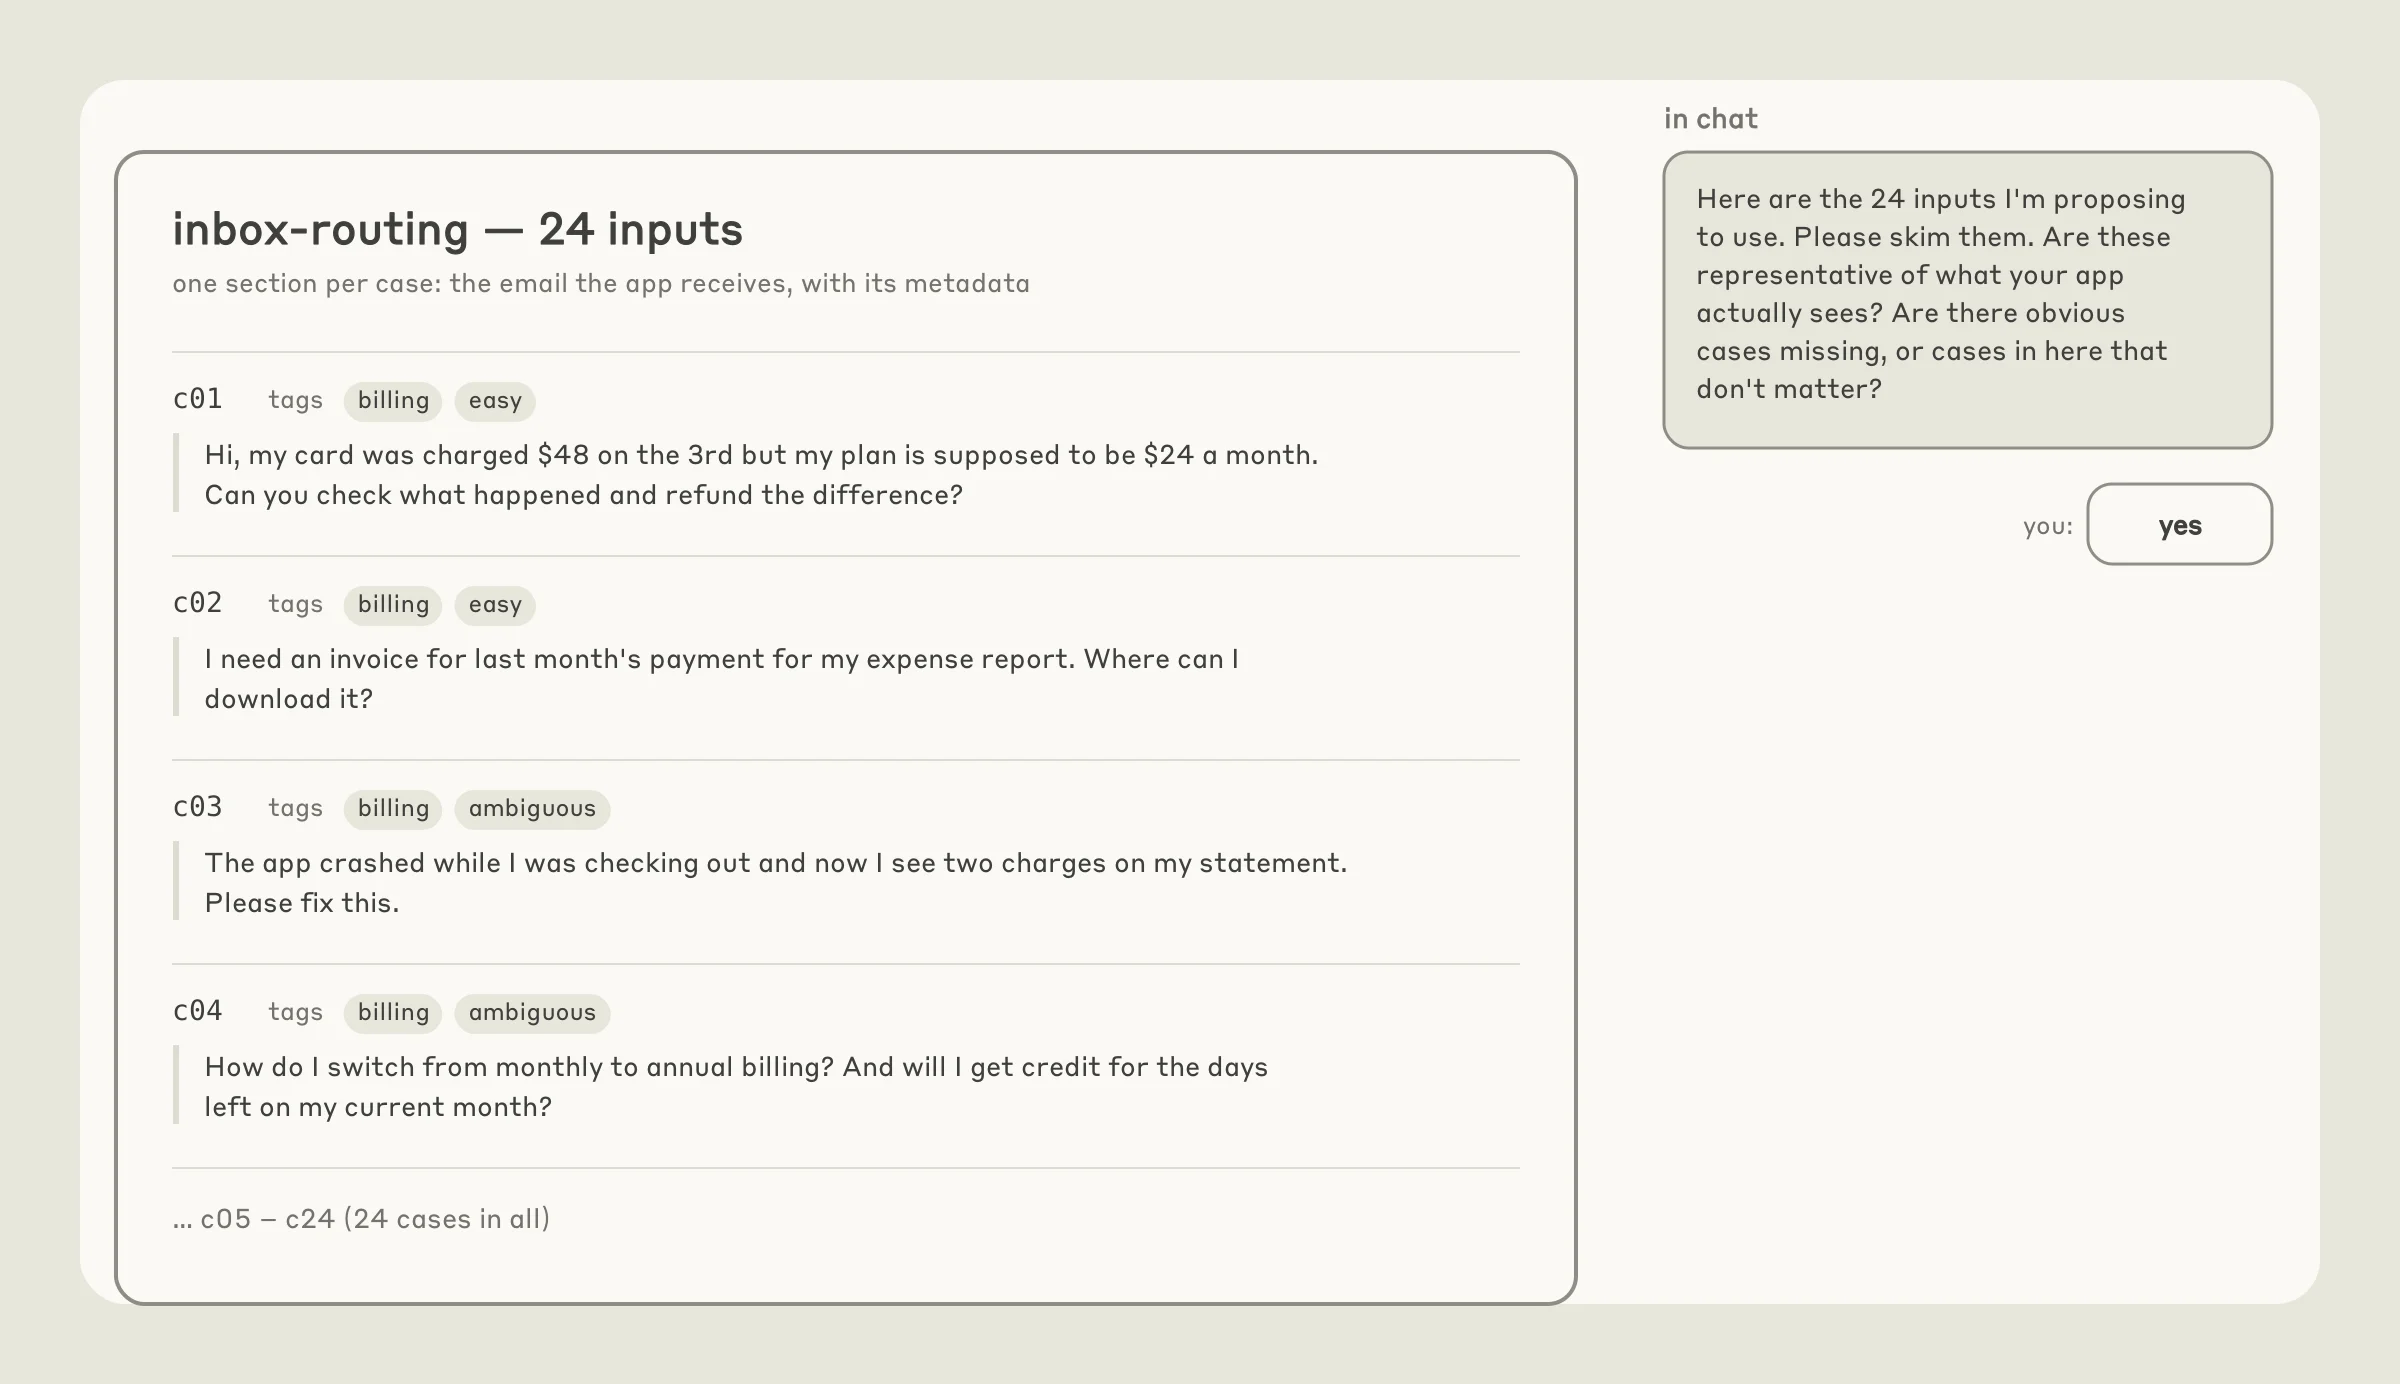
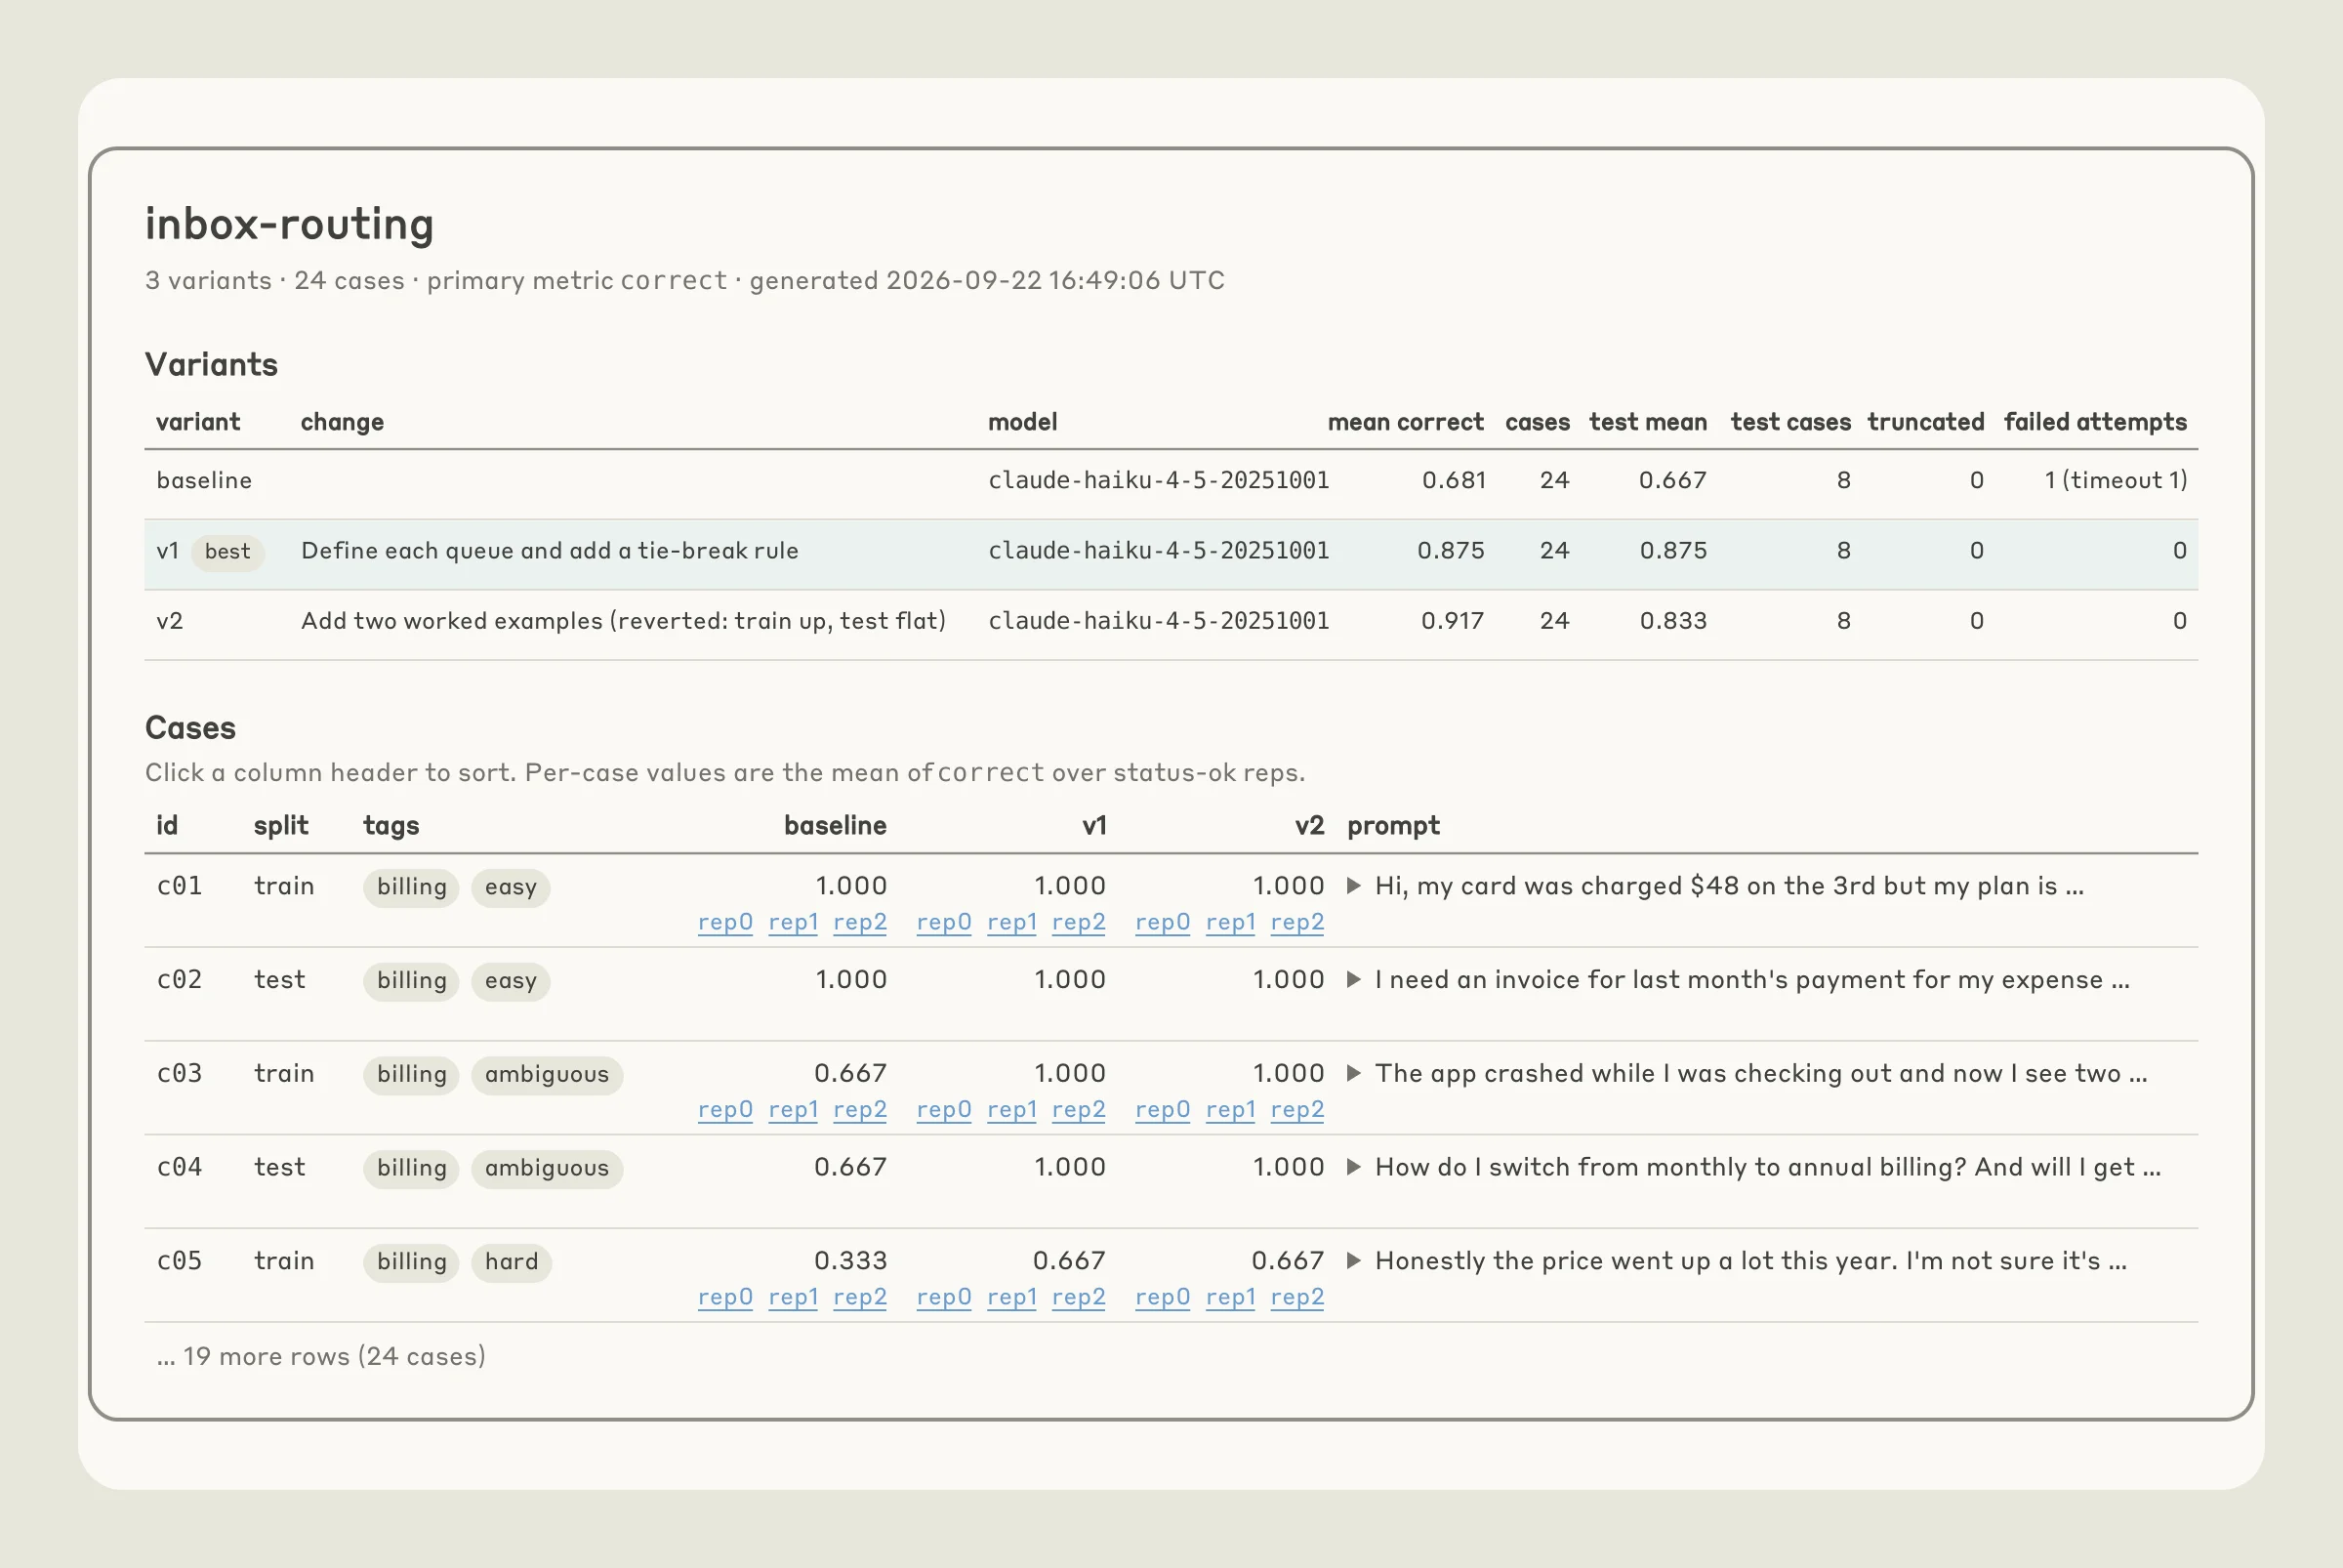
이 스킬은 프로덕션 트래픽을 우선하지만, 사용자가 제공한 실제 예시 몇 개를 기반으로 합성 데이터를 만들 수도 있습니다. 스킬은 Claude에게 모든 입력을 보여 주는 간단한 페이지를 생성하고, 사용자가 확인할 때까지 기다리도록 지시합니다. 예시로, 이메일 라우터 애플리케이션에서 스킬이 사용자에게 검토를 요청할 만한 입력 세트를 아래에 보여 드립니다(그림 3).
채점기 검증
입력을 확정하면 Claude는 애플리케이션의 출력 형태에 맞는 가장 저렴한 채점기를 제안합니다.
- 프로그램 방식 검증: 출력 가능한 값이 제한되어 있으면 코드 기반 검사를 사용합니다(정확히 일치하는지, 정해진 집합의 레이블인지, 스키마에 맞는 JSON인지, 테스트를 통과하는지 등).
- LLM-as-judge: 정답이 여러 가지일 수 있지만 품질 기준은 분명한, 출력 범위가 열려 있는 경우에는 기본적으로 이 방식을 씁니다. 이때 두 번째 모델이 입력, 출력, 그리고 검증 가능한 주장 형태로 쓴 루브릭(1~5점 척도가 아닙니다)을 읽고 근거와 함께 점수를 매깁니다. 비교할 기준선(baseline)이 있다면, 심사 모델은 두 출력을 무작위 순서로 읽고 어느 쪽이 기준선인지 알지 못한 채 더 나은 쪽을 고릅니다. 심사 모델은 사용자가 직접 정하며, 테스트 대상 모델과 달라야 합니다.
Claude는 몇 가지 사례를 채점한 뒤, 다르게 채점했을 사례가 있는지 묻습니다(그림 4). 일반적으로 평가기를 믿기 전에 채점된 대화 기록 일부를 직접 읽어 보는 일이 중요합니다. 채점 오류는 평가가 잘못 구성되는 가장 흔한 원인 중 하나입니다.
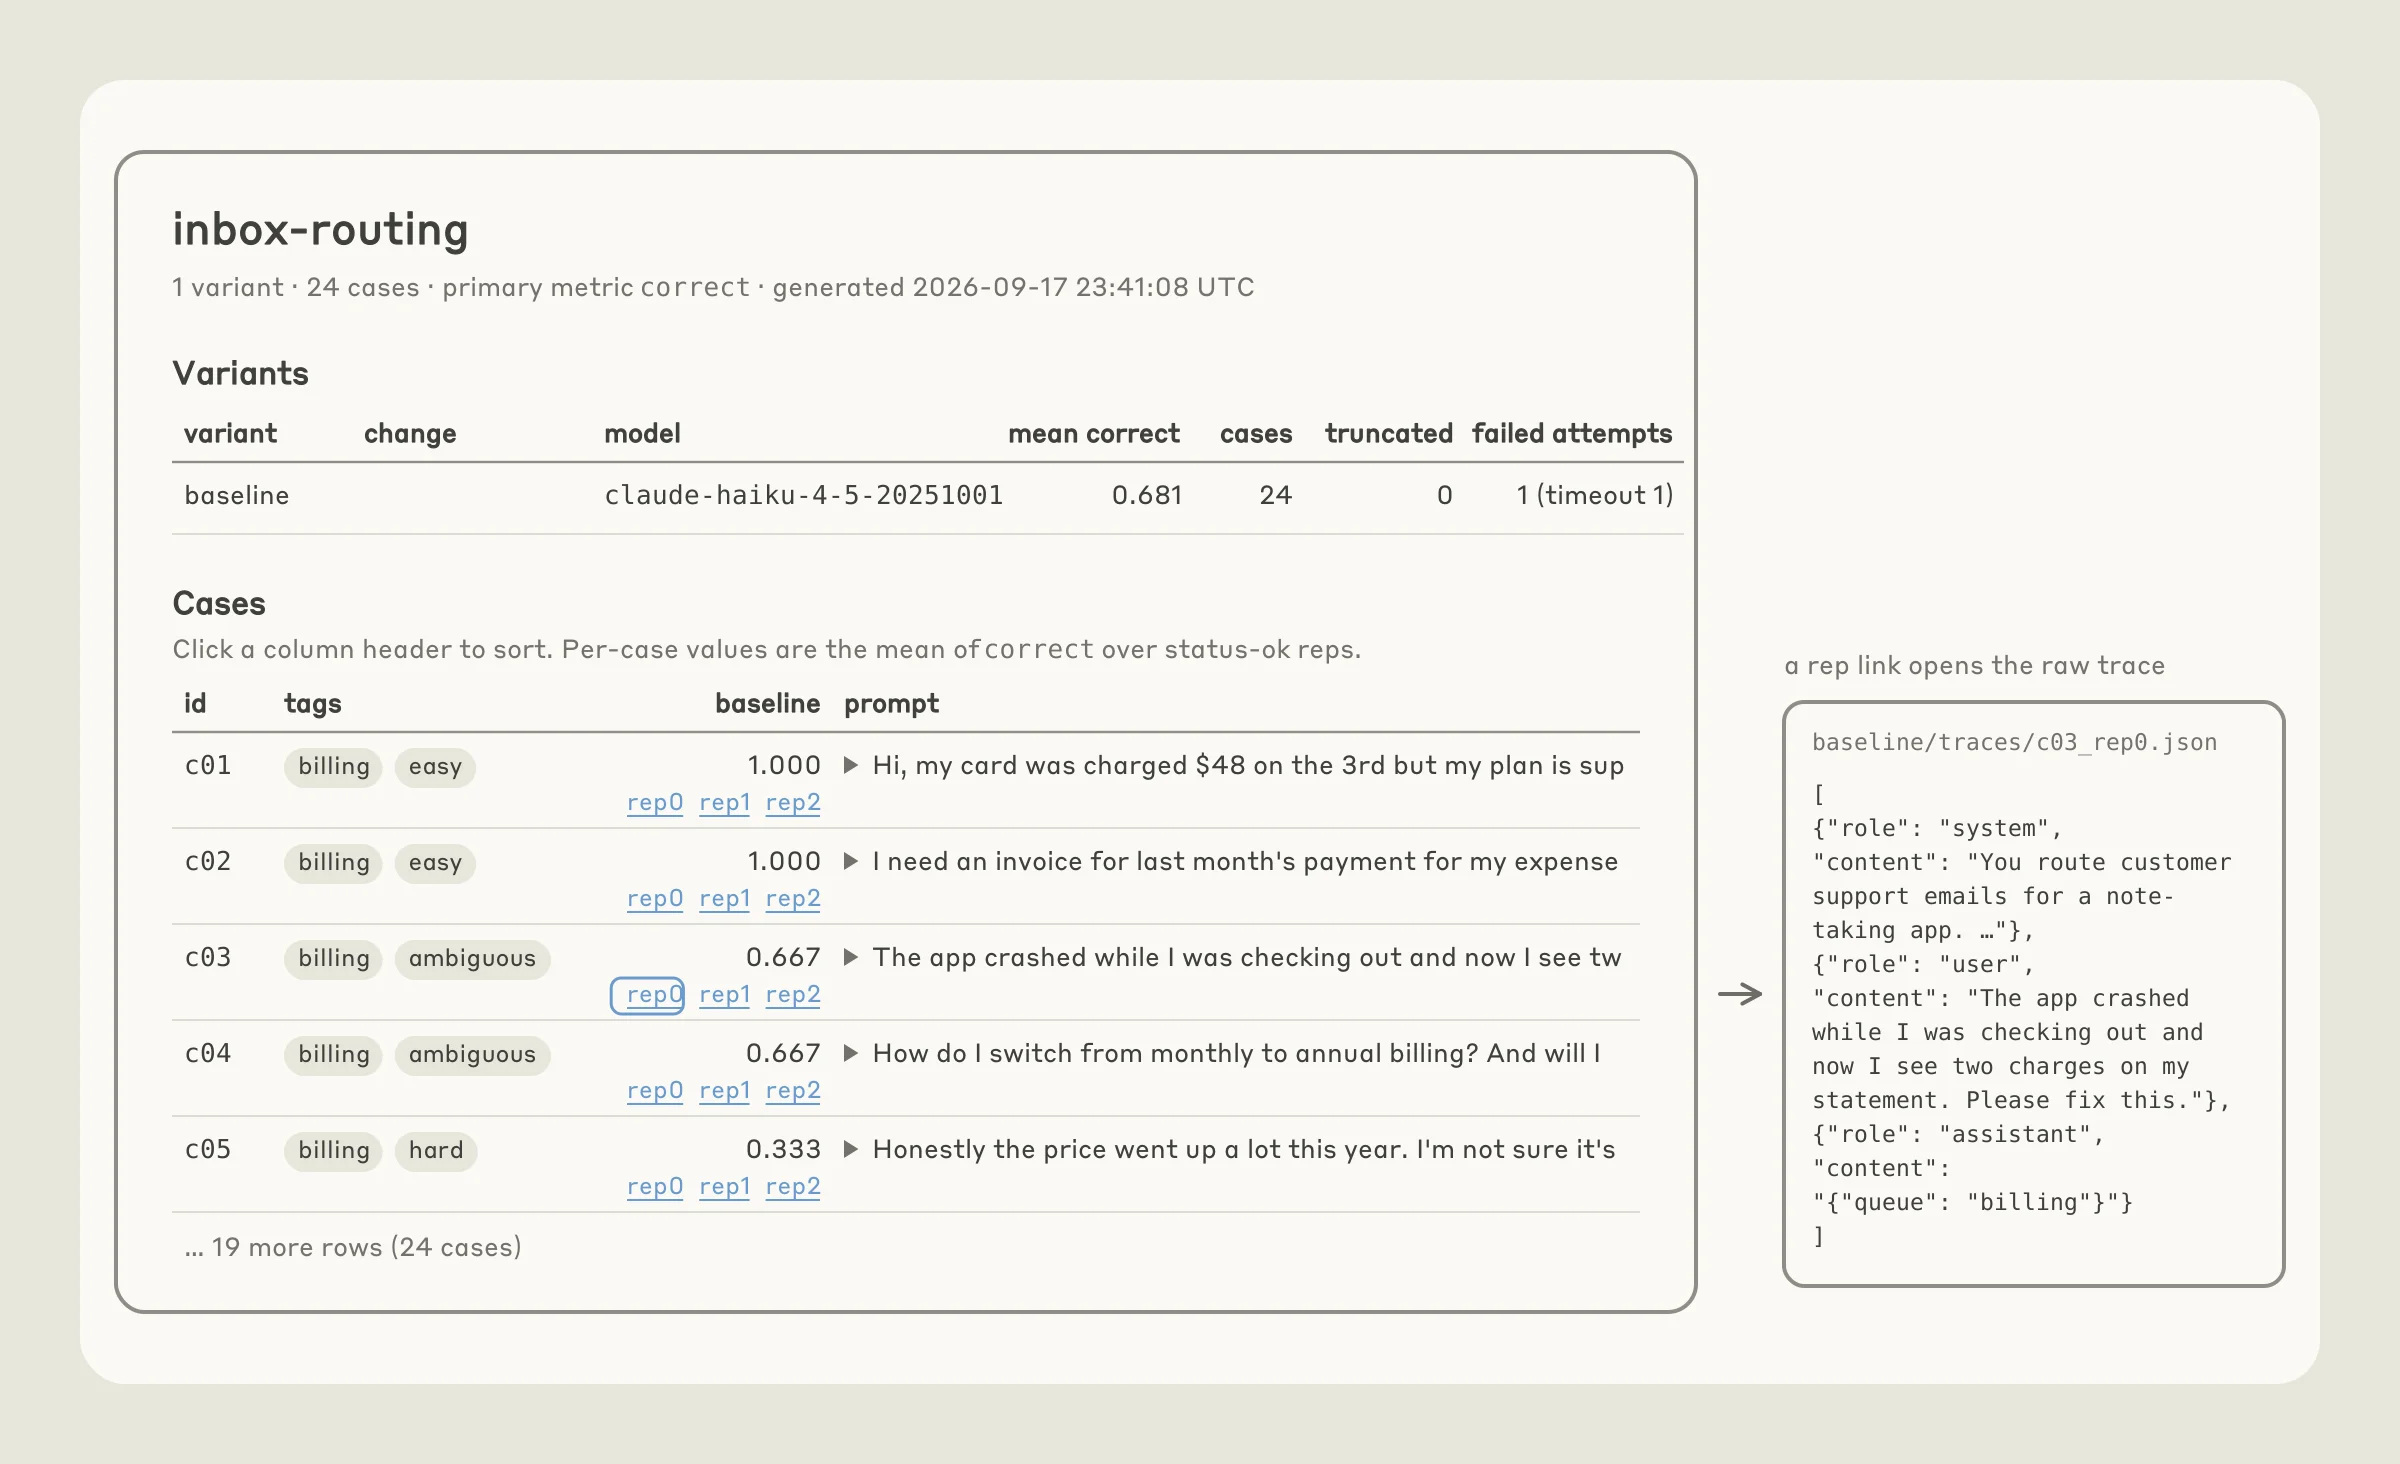
채점기 검증이 끝나면 스킬은 평가 세트의 규모(사례 수 × 반복 횟수 × 모델, 그리고 대략적인 소요 시간)를 알려 주고, 기준선을 실행해 신뢰구간과 함께 점수를 출력합니다. 결과물은 사례, 채점기, 실행기, 사례별 JSON 한 줄과 전체 대화 기록 하나, 그리고 각 사례의 점수와 대화 기록 링크를 나열한 간단한 페이지입니다. 이 페이지에 없는 정보(예: 차트)가 필요하면 요청만 하세요. Claude가 옆에 별도 페이지로 만들어 줍니다. 이런 추가 페이지는 기본적으로 로컬에서 열리는 정적 파일이며, 네트워크에서 아무것도 불러오지 않습니다.
진단 검사
앞서 말한 기준선을 실행하는 동안 Claude는 여러 항목을 점검합니다.
- 채점기: 같은 출력을 채점기로 두 번 채점해 판정이 바뀌었는지 보고합니다.
- 배관(Plumbing): 타임아웃, API 오류, 중간에 잘린 응답을 확인해 인프라 노이즈가 모델의 편차로 둔갑하지 않도록 합니다.
- 여유 구간(headroom): 기준선 점수가 이미 95% 안팎 이상이면 스킬이 사용자에게 경고하고, 힐클라이밍의 목표를 품질이 아니라 비용이나 지연 시간 개선에 두라고 안내합니다.
힐클라이밍
이제 작업에서 애플리케이션의 성능을 믿을 수 있게 채점할 수단이 생겼으니, 성능을 개선해 볼 차례입니다. 힐클라이밍은 비용과 성능 사이의 균형을 좌우하는 effort나 프롬프트 같은 파라미터를 조정하는 데 효과적입니다. 어디에 적용할지 고를 때 참고할 만한 일반적인 팁은 다음과 같습니다.
- 저렴한 반복 - 힐클라이밍 대상으로 삼은 부분을 수정하는 데 시간, 비용, 노력이 적게 들어야 합니다. 내부 프로젝트와 고객사 중 상당수는 프롬프트나 스킬 같은 텍스트에 힐클라이밍을 집중했습니다. 텍스트는 바꾸고 되돌리기 쉽습니다. 반면 힐클라이밍 중에 에이전트 하네스를 자유롭게 수정하게 하면 대규모 코드 변경이 필요할 수 있습니다.
- 귀속 가능성 - 평가 점수의 변화는 힐클라이밍에서 수정하는 대상 덕분이라고 설명할 수 있어야 합니다. 예를 들어 성공한 힐클라이밍 사례 여러 건이 스킬 트리거에 집중했습니다. 평가 지표(스킬의 트리거 비율)가 수정 대상인 스킬 설명과 직접 연결되기 때문입니다.
- 범위가 명확한 목표 - 흔한 실패 패턴 하나는 평가에 남은 여유 구간을 신중히 따져 보지 않고 "성능을 개선해 달라"고 막연하게 요청하는 것입니다. 포화에 가까운 평가나 범위가 모호한 대상(예: 하네스를 업데이트해 달라는 막연한 요청)은 정체될 가능성이 더 큽니다. 여러 프로젝트에서 대체로 좋은 목표로 확인된 것이 비용입니다. 평가가 포화 상태라도 성능은 동일하게 유지하면서 비용을 줄일 방법을 찾아 달라고 Claude에게 요청할 수 있습니다.
과적합
잘 설계한 평가라도 프로덕션에서 중요한 실제 작업 분포와 정확히 일치하는 경우는 드뭅니다. 그래서 평가에 "과적합"되는 문제가 흔하게 발생하며, 그 결과 시스템은 프로덕션 트래픽보다 평가에서 더 좋은 성능을 보입니다.
평가가 하네스(모델을 둘러싼 코드로, 프롬프트, 도구, Claude를 호출하는 루프를 포함합니다)로 "새어 들어가는" 경로는 다양합니다. 예를 들어 어떤 평가 작업은 OCR이 도움이 되지만, 프로덕션 작업에서는 OCR이 거의 필요 없다고 해 봅시다. 평가용 하네스가 애플리케이션에 OCR 도구를 추가하면 벤치마크 점수는 오르지만 프로덕션에는 아무 영향이 없습니다. 더 넓게 보면, 힐클라이밍이 고른 평가 예시의 특수한 경우만 해결하는 기능을 하네스에 덧붙일 수도 있습니다. 이런 하네스 변경은 평가 점수를 올리지만 프로덕션 개선으로는 이어지지 않습니다(그림 5).
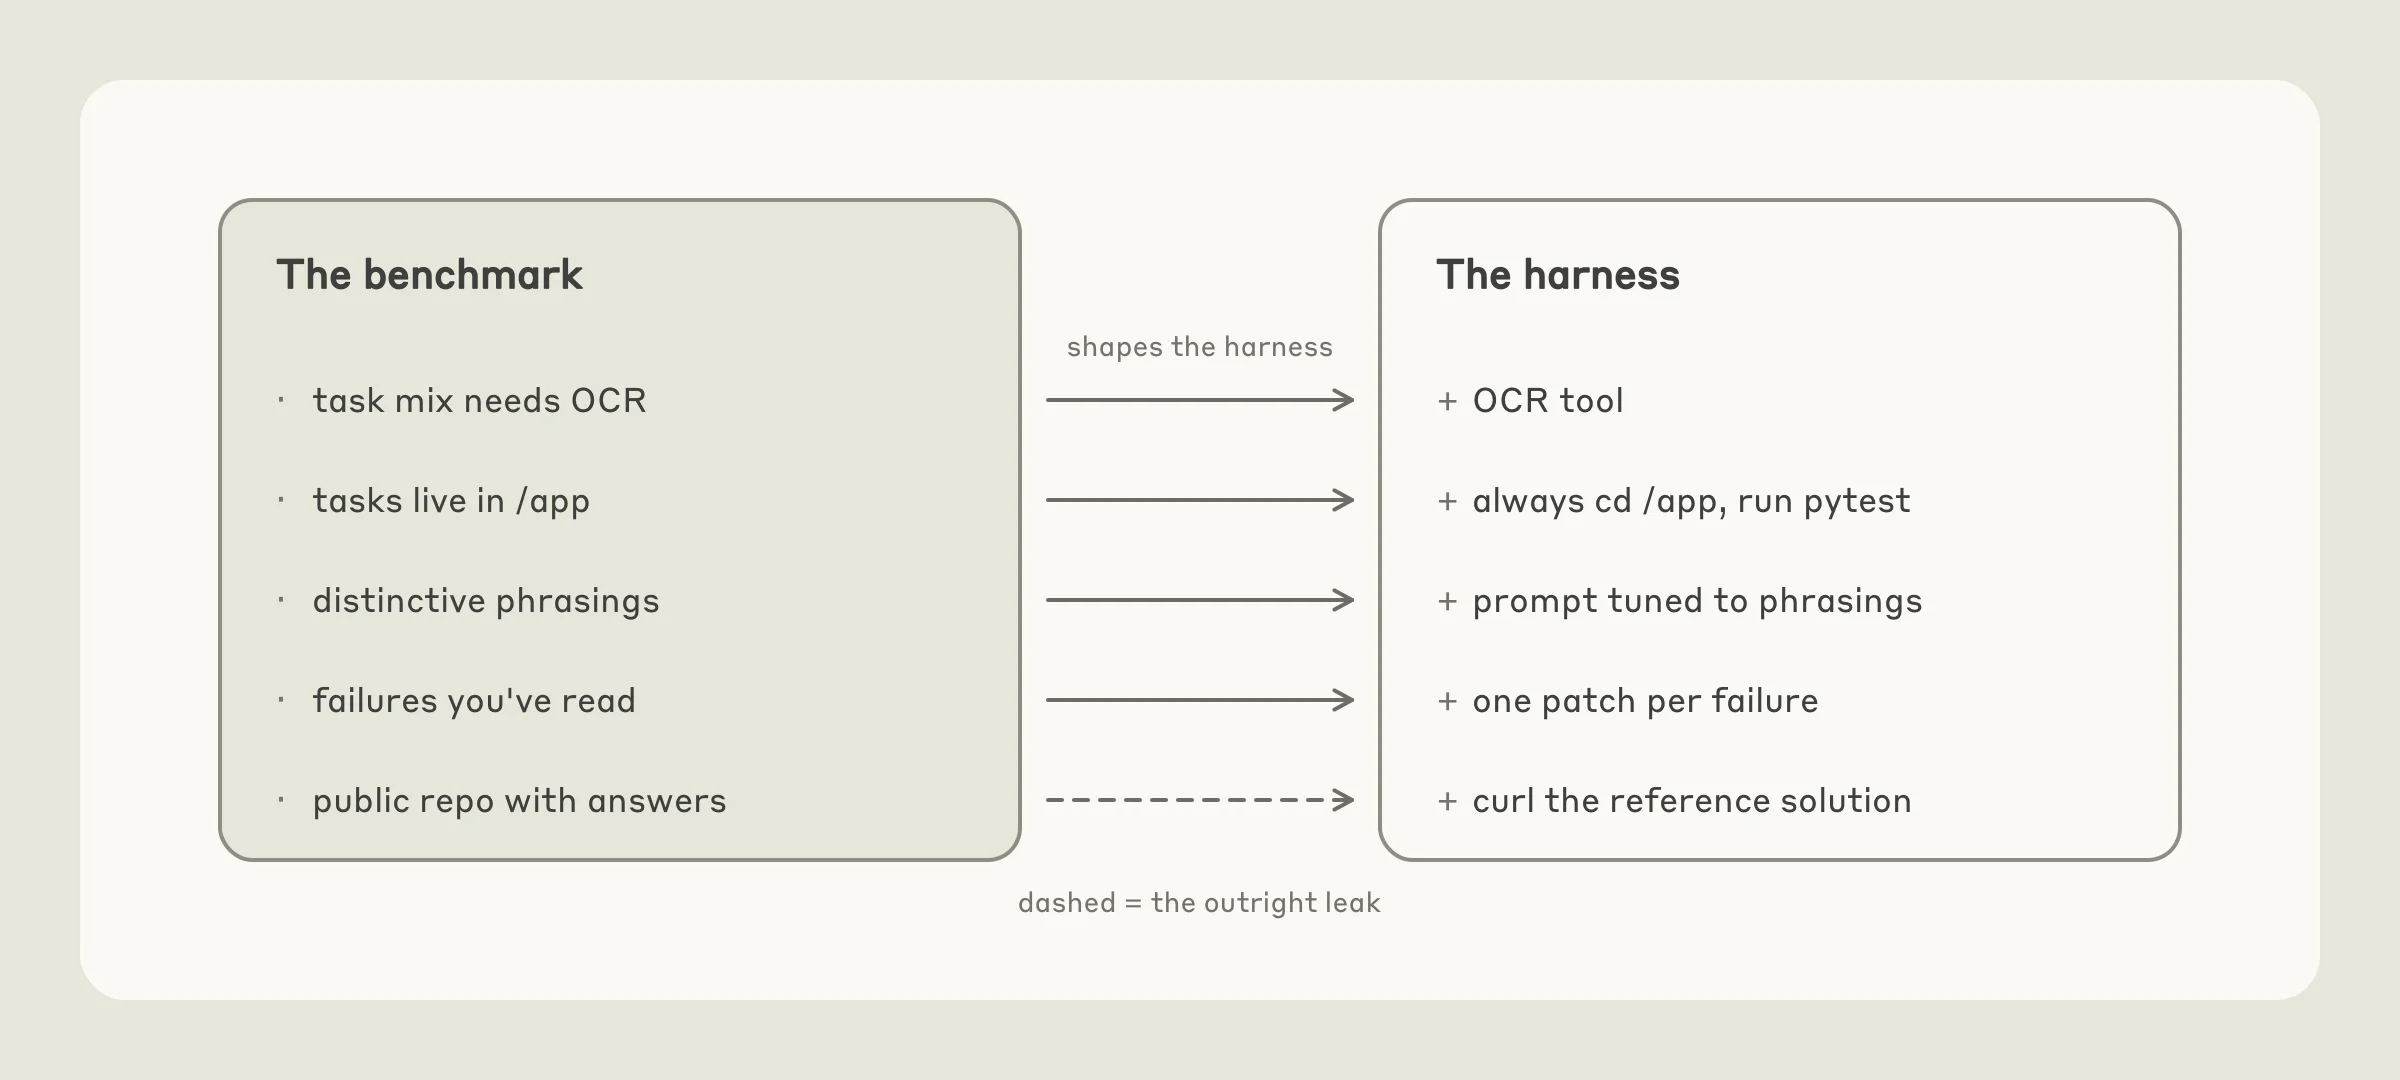
다음 세 가지가 도움이 됩니다.
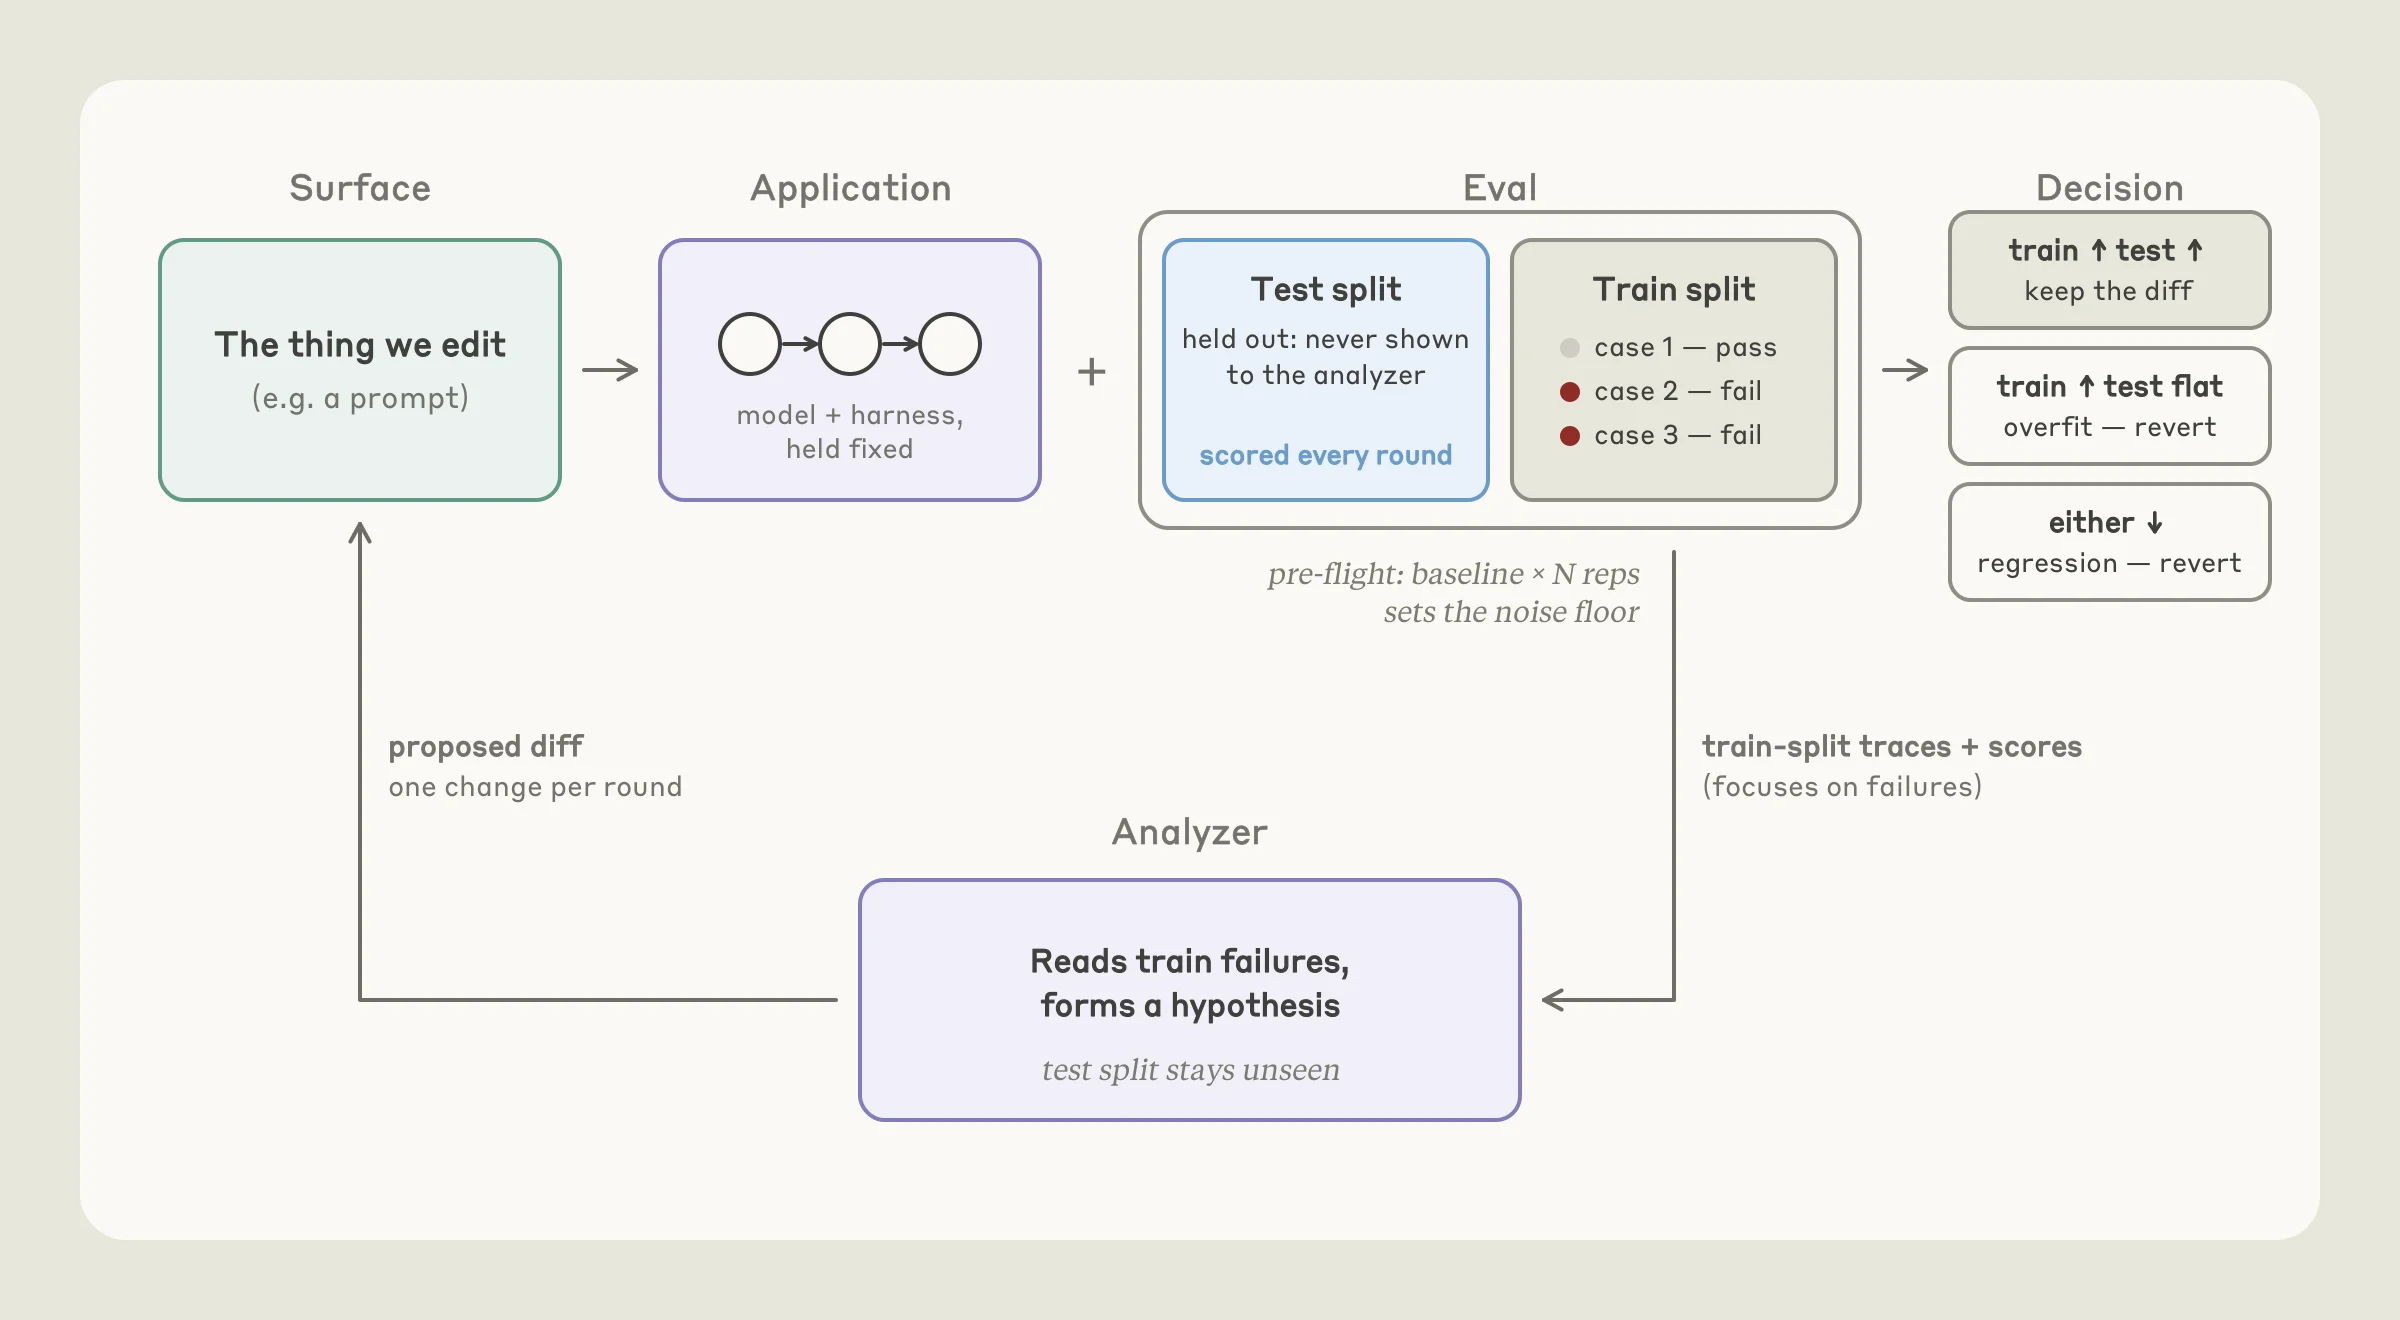
- 사례 분할: 힐클라이머가 읽을 수 있는 학습(train) 세트와, 절대 보여 주지 않는 테스트 세트로 나눕니다. 학습 세트 점수는 오르는데 테스트 세트 점수가 그대로라면 과적합을 의심할 만한 대표적인 신호입니다.
- 실패 사례를 프롬프트에 붙여 넣지 않기: 힐클라이머가 실패한 대화 기록을 읽더라도, 그 내용을 프롬프트에 그대로 붙여 넣어서는 안 됩니다.
- 정답이 구조적으로 모델의 손이 닿지 않는 곳에 있게 하기: 모델이 평가의 정답을 직접 찾아내는 식으로 "보상 해킹(reward hack)"을 하는 경우가 있습니다.
아래에서 설명하듯 claude-api 스킬이 이런 원칙을 대신 적용해 줍니다.
/CLAUDE-API HILLCLIMB
claude-api 스킬의 hillclimb 명령어는 이 원칙을 안내형 워크플로로 만든 것입니다. Claude Code에서 /claude-api hillclimb을 실행하면 Claude가 주어진 평가를 기준으로 반복하며 성능을 개선합니다. Claude가 수정할 수 있는 대상은 사용자가 정하며, 다음이 포함됩니다.
- 시스템 프롬프트
- 스킬 또는 지침 파일
- 도구 설명
- 모델 선택, effort 수준, 기타 API 파라미터
- 하네스 코드
시작 전에 Claude는 무엇을 최적화할지(예: 성능, 또는 성능을 유지하면서 비용 절감)를 묻고, 평가 세트를 무작위로 테스트 세트와 학습 세트로 나눕니다. 비용 절감이 목표라면 프롬프트 캐싱, 선택한 모델과의 호환성을 확인하는 프롬프트 점검, 모델과 effort 설정 선택처럼 비용을 좌우하는 대표적인 요인을 검토합니다.
첫 라운드 전에 Claude는 평가의 노이즈(우연만으로 점수가 움직일 수 있는 폭)가 사용자가 실제로 반영할 만한 최소 개선폭보다 작은지 확인합니다. 그렇지 않으면 그 사실을 알리고 반복 횟수나 사례를 늘리자고 제안합니다.
매 라운드마다 Claude는 직전 라운드의 학습 세트 대화 기록을 읽고 패치 형태로 변경 하나를 제안합니다. 효과가 평가 노이즈 위로 드러날 만한 변경을 목표로 삼습니다. 즉 한 줄의 표현만 바꾸지 않고, 실패하는 동작의 근본 원인을 해결합니다(예: 원인이 되는 섹션을 다시 쓰거나 빠진 규칙을 추가). 그런 다음 패치를 적용한 상태로 평가를 실행합니다. 이 시점에서 Claude는 검사를 하나 수행합니다. train 세트는 개선됐는데 test 세트는 그대로라면 과적합을 의심해 패치를 되돌립니다. 성능이 퇴보했을 때도 되돌립니다. 학습 세트와 테스트 세트가 모두 개선되면 패치를 유지합니다(그림 6).
점수가 두세 라운드 동안 정체되면 Claude는 남은 학습 세트 실패 사례를 하나씩 읽고 원인별로 분류합니다. 어떤 단일 수정으로도 평가 노이즈 이상의 개선을 얻기 어렵다면 더 일찍 같은 작업을 수행하고, 측정하기엔 너무 작은 변경에 라운드를 낭비하는 대신 반복 횟수나 사례를 늘리자고 제안합니다. 이 단계에서 모호한 평가 사례, 하네스 오류, 실행 간 편차를 찾아낼 수 있습니다.
이후 힐클라이밍 라운드에는 정당한 실패만 포함합니다.
힐클라이밍이 끝나면 Claude는 목표 기준으로 테스트 세트에서 가장 좋은 결과를 낸 버전으로 코드를 남겨 둡니다. 그리고 기준선 대비 테스트 결과를 신뢰구간과 함께 보고합니다(그림 7). 개선폭이 노이즈 범위 안이라면 그렇게 알리고 병합하지 말 것을 권고합니다.
사용 사례
비용 절감을 위한 힐클라이밍
내부 고객 지원 벤치마크에서 비용을 줄이면서 성능도 높이는 것을 목표로 /claude-api hillclimb를 실행했습니다. 벤치마크는 티켓 44건으로 구성했고, 30건은 탐색에 쓰고 14건은 따로 떼어 두었습니다. 출발점은 기본(high) effort 설정의 Opus 4.8로, 탐색용 티켓에서 판단 정확도가 74.4%, 토큰 비용은 티켓당 4.6센트였습니다.
힐클라이밍은 먼저 프롬프트를 점검해 필수 도구 호출 절차, 스크래치패드 단계, 서로 모순되는 규칙을 제거했습니다. 그다음 low effort의 Opus 5.5를 시도했습니다. 그 결과 정확도 87.8%로 기준선 정확도를 넘어섰고, 비용은 티켓당 1.9센트로 처음의 절반 아래로 줄었습니다.
절감분의 일부는 Opus 5.5의 가격 정책에서 나옵니다. 입력과 출력 토큰 비용이 Opus 4.8보다 20% 저렴하고, 캐시 읽기 비용은 60% 저렴합니다. Opus 5.5가 기준을 넘었기 때문에, 힐클라이밍은 한 단계 아래 모델로 내려가 더 저렴한 모델도 기준을 넘을 수 있는지 확인했습니다. low effort의 Sonnet 5는 88.9%로 거의 같은 점수를 냈고, 비용은 티켓당 약 1센트로 절반 수준이었습니다(그림 8).
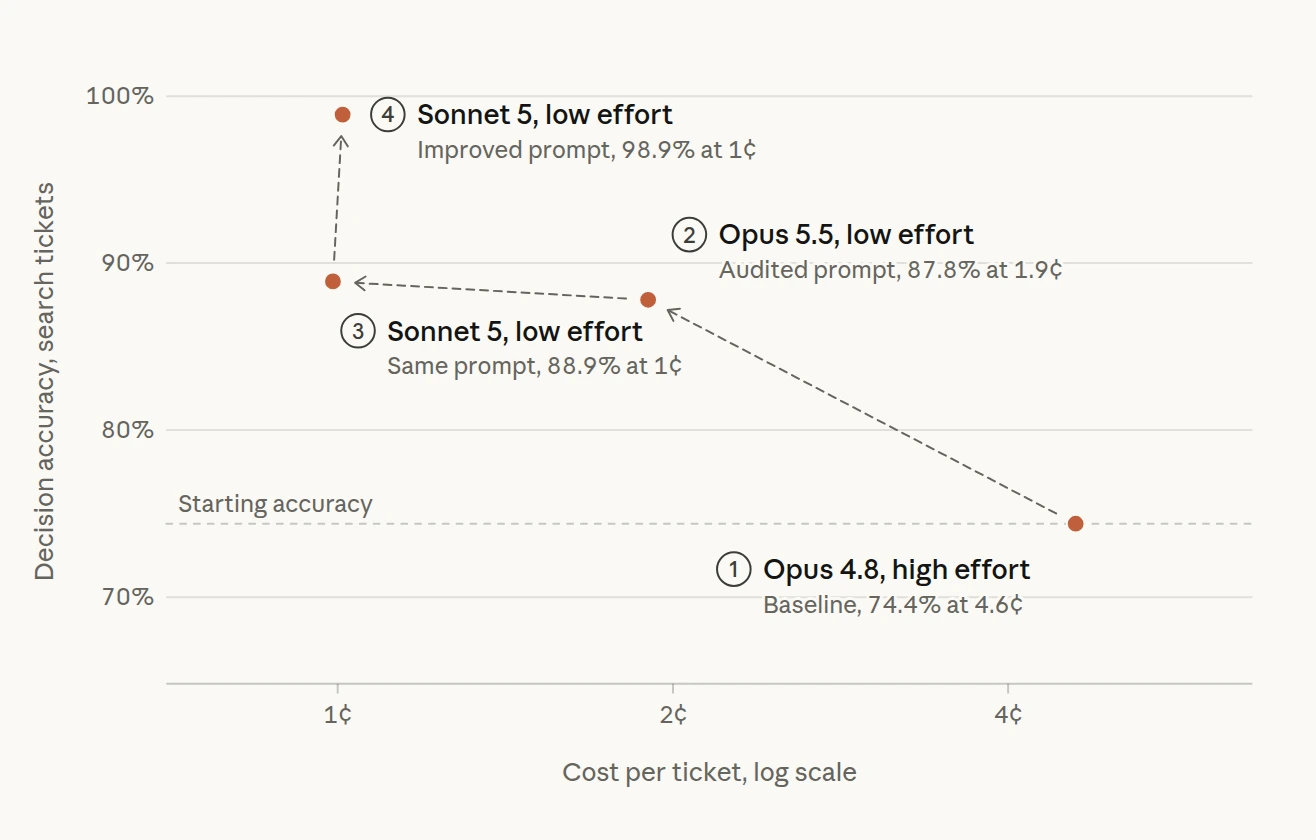
마지막으로 Claude가 라우팅 규칙과 환불 한도 상호 참조를 추가해 프롬프트를 개선했고, Sonnet 5의 정확도는 비슷한 비용에서 98.9%까지 올라갔습니다. 탐색 과정에서 한 번도 보지 못한 14건의 홀드아웃 티켓에서는 최종 구성이 90.5%를 기록해 기존 구성의 78.6%를 넘어섰고, 비용은 약 5분의 1이었습니다.
성능 향상을 위한 힐클라이밍
또 다른 예로 claude-api 스킬이 있습니다. 이 스킬은 Anthropic API 사용법과 Claude 활용 일반 팁(이 글에서 다룬 하위 명령어 포함)을 안내합니다. 스킬이 API를 쓰는 코드를 올바르게 구현할 수 있도록, 공식 문서를 바탕으로 평가 세트를 만들어 스킬을 테스트했습니다.
이 평가에서 스킬은 66%로 시작했습니다. 힐클라이머에게 문서와 SDK에 접근할 수 있는 권한을 주어, Claude가 오류를 찾아 스스로 고치게 했습니다(그림 9). Claude는 스킬에 기능 8개에 대한 내용이 빠져 있음을 발견했습니다.
해당 섹션을 스킬에 추가하자 성능이 74%로 올랐습니다. 이어 C#과 Java 타입 표의 오류를 찾아내 성능이 77%까지 올라갔습니다.
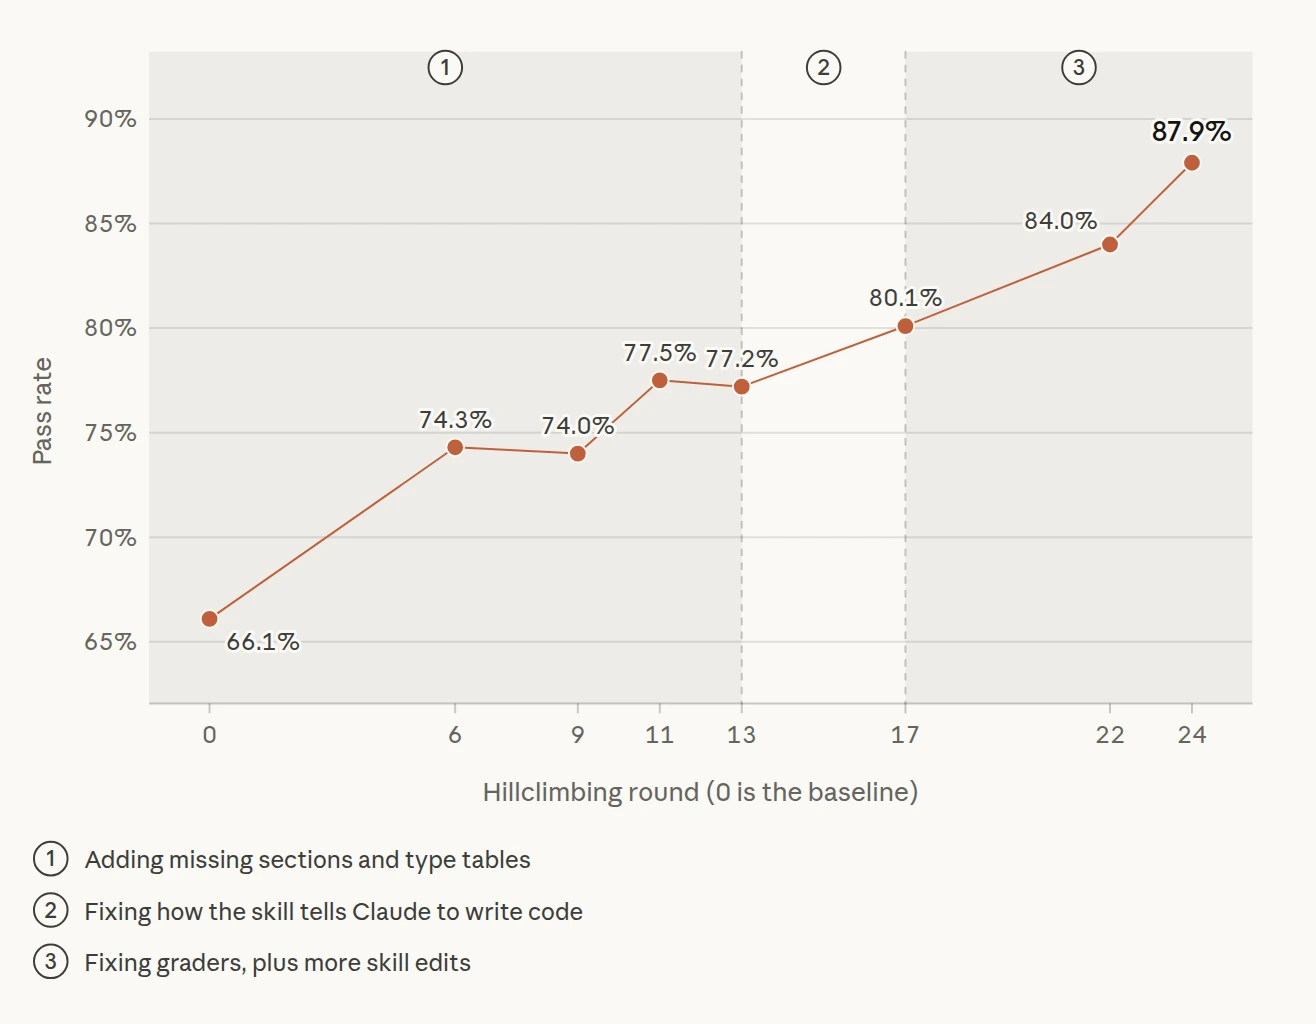
점수가 두 라운드 동안 정체되자 Claude는 남은 실패 사례를 분석해 근본 원인별로 분류했습니다. 일반적인 라운드에서는 가장 흔한 실패를 겨냥해 수정을 하나 합니다. 이 단계에서는 수정 없이, 남은 실패를 원인별로 분류하기만 합니다. 이렇게 돌아보는 단계는 여러 면에서 유용했습니다.
- 힐클라이머는 실패 사례 전체를 돌아보다가, 스킬에 관련 내용은 있는데도 Claude가 학습으로 익힌 사전 지식 때문에 예전 API 형식으로 코드를 쓰고 있다는 사실을 발견했습니다. 이를 해결하려고 스킬 상단 근처에 표를 추가해, Claude가 기억하는 옛 형식에서 현재 형식으로 안내했습니다. 예를 들어 최신 Opus 모델에서는 API가 더 이상 받아들이지 않는 고정 토큰 예산 방식의 extended thinking에서 adaptive thinking으로, 구버전 웹 검색·웹 가져오기 도구에서 현재 도구로 바꾸도록 했습니다. 또한 C#과 Java의 고정 예산 thinking 사용 금지 경고도 adaptive thinking 예시보다 위로 옮겼습니다. 그 결과 성능이 80%로 올랐습니다.
- 눈에 띄는 내용 누락을 보완했는데도 성능이 전혀 오르지 않는 작업은 예시나 채점기에 결함이 있다는 신호입니다. 한 작업은 오류 한 종류를 잡는 코드를 요구했는데, 채점기는 최소 세 단계의 체인을 기대했습니다. Claude는 이 작업의 문구를 고쳤습니다. 또 다른 채점기의 지침은 공식 문서와 모순되었는데, 실제 API로 테스트해 보니 문서가 맞았습니다. 이런 문제를 바로잡고 스킬을 추가로 수정하자 성능은 약 88%까지 올랐습니다.
시작하기
참고: 먼저 claude update을 실행하세요. claude-api 스킬은 Claude Code에 포함되어 배포되므로, 업데이트하면 이 명령어들의 최신 버전을 쓸 수 있습니다.
claude update그런 다음 Claude Code에서 다음을 실행합니다.
/claude-api build-eval
/claude-api hillclimb
이 하위 명령어들은 claude-api 스킬을 통해 Claude Code에서 바로 사용할 수 있습니다.
특정 문제를 위한 평가 세트를 만들고 싶다면 /claude-api build-eval을 실행하세요. 트레이스 같은 예시에 접근할 수 있게 해 주면 방향을 잡아 줄 수 있습니다. Claude는 이 글에서 소개한 가이드를 활용해 예시와 채점기를 설계하고, 사용자가 예시와 채점기를 반드시 승인하도록 합니다.
이미 평가가 있고 Claude가 이를 개선해 주길 원한다면 /claude-api hillclimb를 실행하세요. 목표(예: 더 나은 성능, 또는 성능을 유지하면서 비용 절감)를 기준으로 진행합니다. Claude는 이 글에서 소개한 가이드를 활용해, 힐클라이밍하는 동안 과적합 여부를 확인하고 평가 자체의 버그도 점검합니다. 정답처럼 보이는 답을 틀렸다고 채점하는 채점기나 하네스 오류가 그런 예이며, 점검은 첫 라운드 전과 점수가 정체될 때마다 이루어집니다.
스킬 개발에 힘써 준 Misha Khalman에게 특별히 감사드립니다. 검토, 기여, 제품 지원을 해 준 Misha Khalman, Michael Segner, Matt Bell, Matt Thanabalan, Punit Shah에게도 감사드립니다.