NEW2026년 9월 28일Anthropic제품 블로그Agents
NVIDIA와 함께 기업의 AI 에이전트 통제권을 강화하다
Anthropic은 NVIDIA와 협력해 자사의 오픈 에이전트 안전 플랫폼(Open Agent Safety Platform) 에이전트 스택에 보안과 제어 기능을 다층으로 보강했습니다.

자세히 보기
AI 개발 도구와 기술에 대한 심층 분석 글을 한국어로 읽어보세요.
Anthropic은 NVIDIA와 협력해 자사의 오픈 에이전트 안전 플랫폼(Open Agent Safety Platform) 에이전트 스택에 보안과 제어 기능을 다층으로 보강했습니다.
Credentials API에 시크릿을 한 번만 저장하고 ID로 참조해 두면, 이그레스 프록시가 전송 과정에서 자동으로 주입하기 때문에 에이전트 샌드박스에는 시크릿이 노출되지 않습니다.

지난 금요일, 산호세에서 열린 WeAreDevelopers World Congress North America의 클로징 키노트 무대에 섰습니다. 지난 1년간의 핵심 트렌드를 한데 엮어 2026년에 일어난 주요 변화들을 시간순으로 짚어봤습니다. 발표 영상은 유튜브에서 확인할 수 있으며, 강연 내용을 보완하는 주석 슬라이드와 발표 노트도 함께 공개합니다.

코딩 에이전트 하네스를 게임 엔진처럼 바라보면, 영속 상태·도구·설정·TUI·추론 모두 익숙한 엔지니어링 문제로 정리된다.

/prewalk은 저렴한 모델에 계획이 아닌 궤적(trajectory)을 전달해, SWE-Bench Pro 기준 절반 수준의 비용으로 프론티어 모델 통과율의 92~97%를 유지한다.

Snapcompact는 에이전트 컨텍스트를 픽셀 폰트 이미지로 변환해, 프런티어 모델 4종에서 입력 비용을 3분의 1로 줄이면서도 원문에 가까운 정확도로 내용을 재현합니다.

16개 코딩 모델을 대상으로 테스트한 결과, hashline의 콘텐츠 해시 라인 앵커 방식이 14개 모델에서 패치 방식을 앞질렀다. 기존 성능이 낮은 모델일수록 개선 폭은 더 컸다.

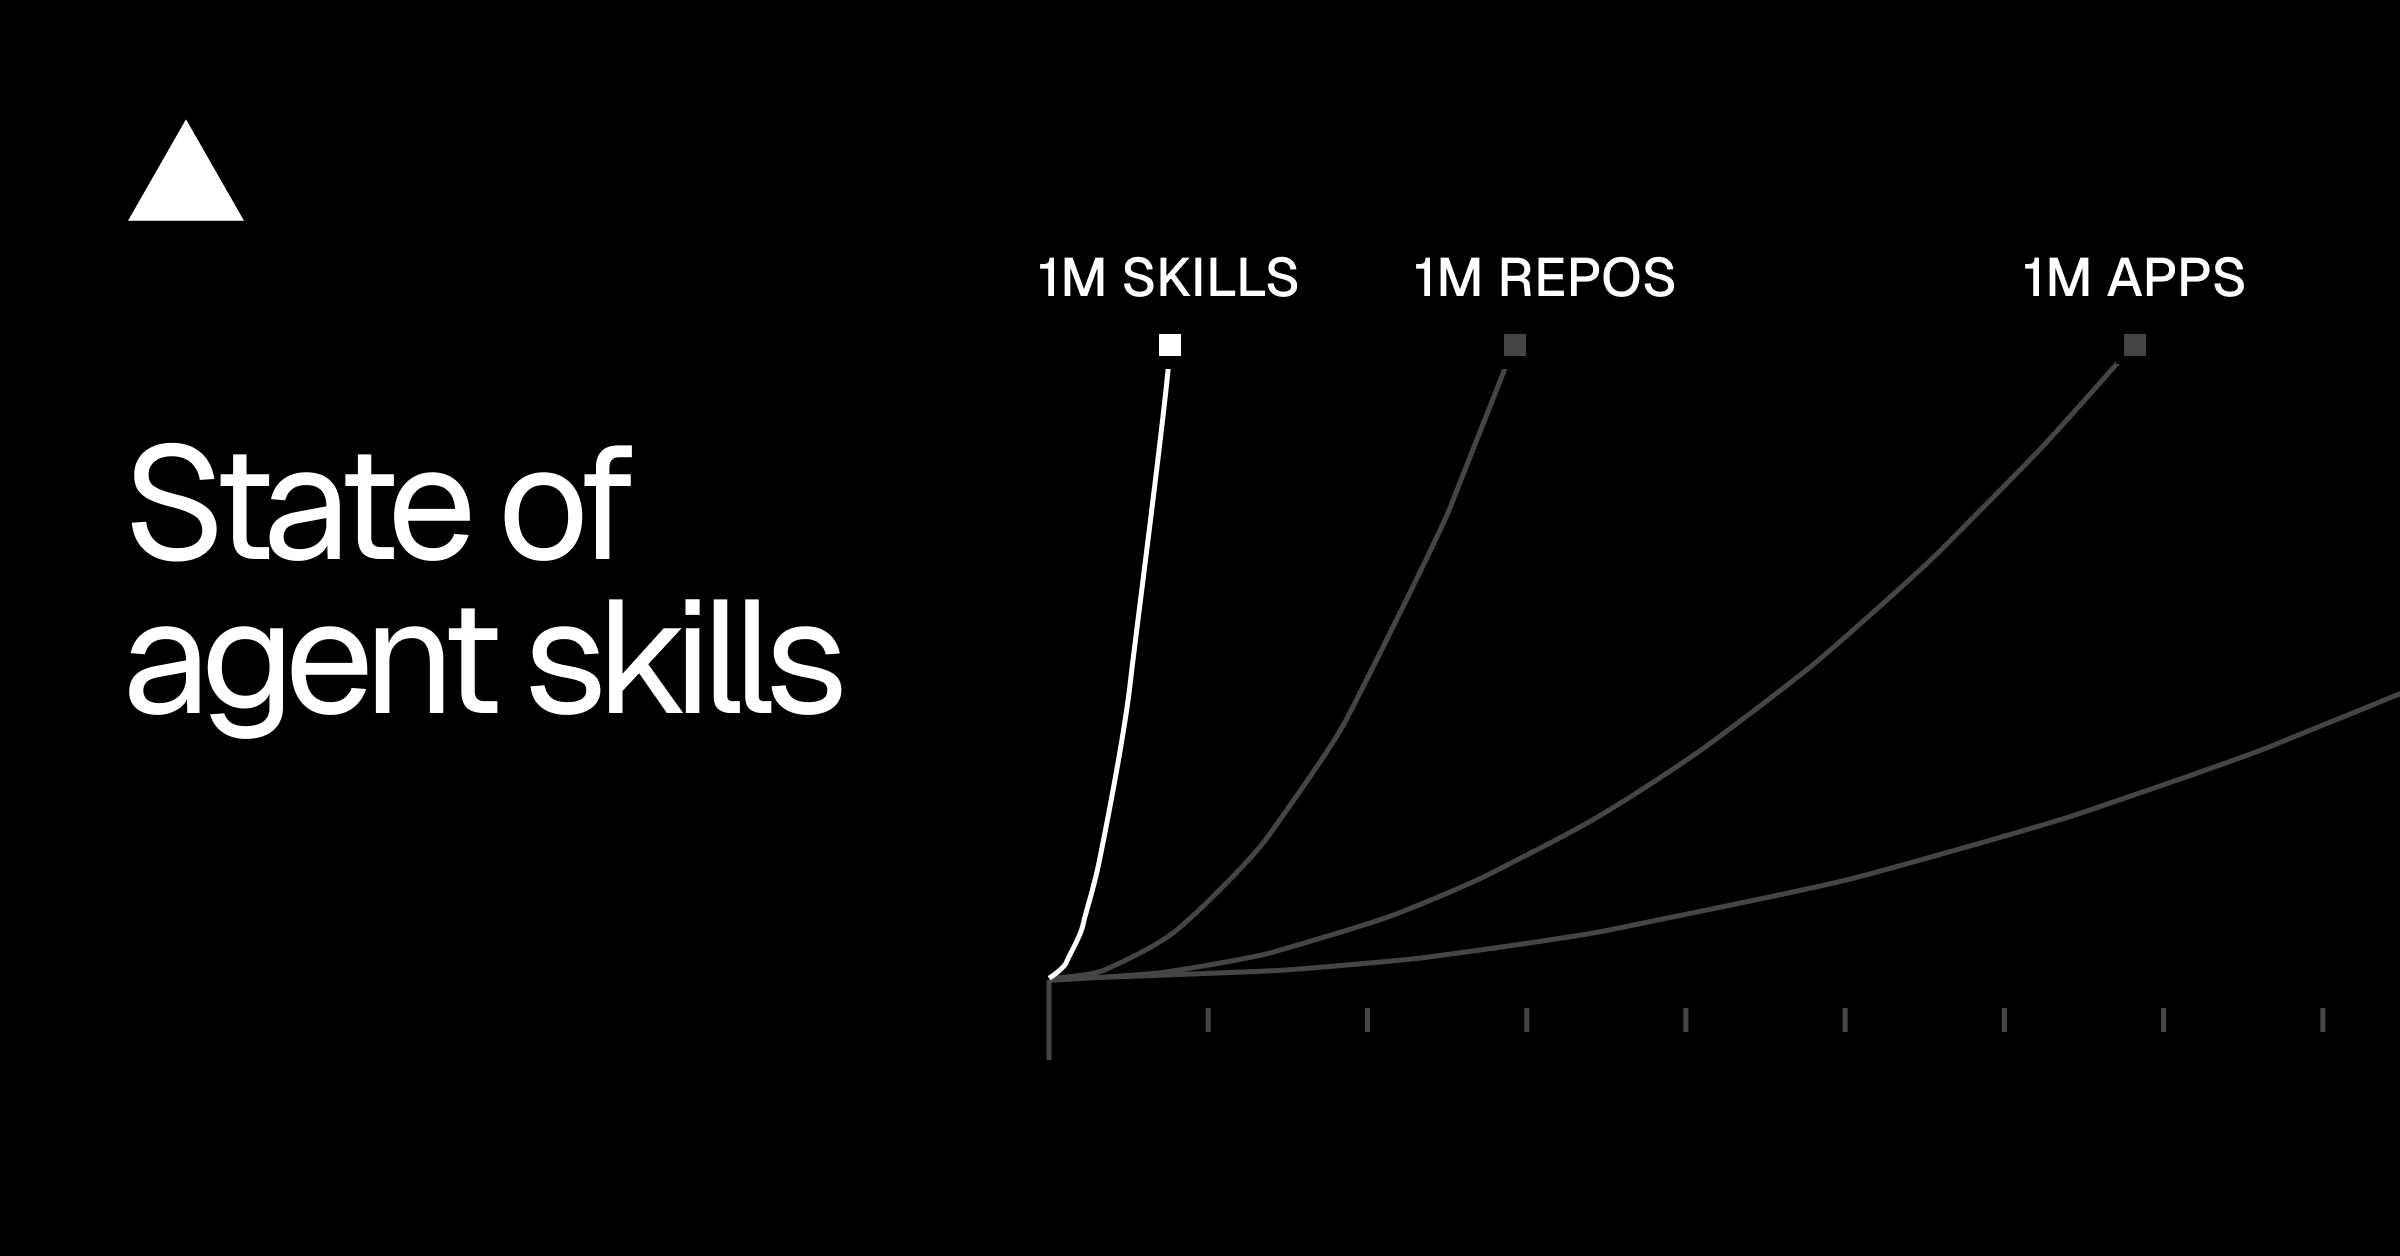
7개월 만에 skills.sh 레지스트리에 등록된 에이전트 스킬이 100만 개를 돌파했고, 설치 횟수는 약 2억 8천만 건에 달했습니다. 이 보고서는 해당 레지스트리의 집계 데이터를 토대로, 사람들이 에이전트에게 무엇을 가르치는지, 어떤 스킬이 많이 설치되는지, 그리고 어떤 스킬이 오래 살아남는지를 분석합니다.
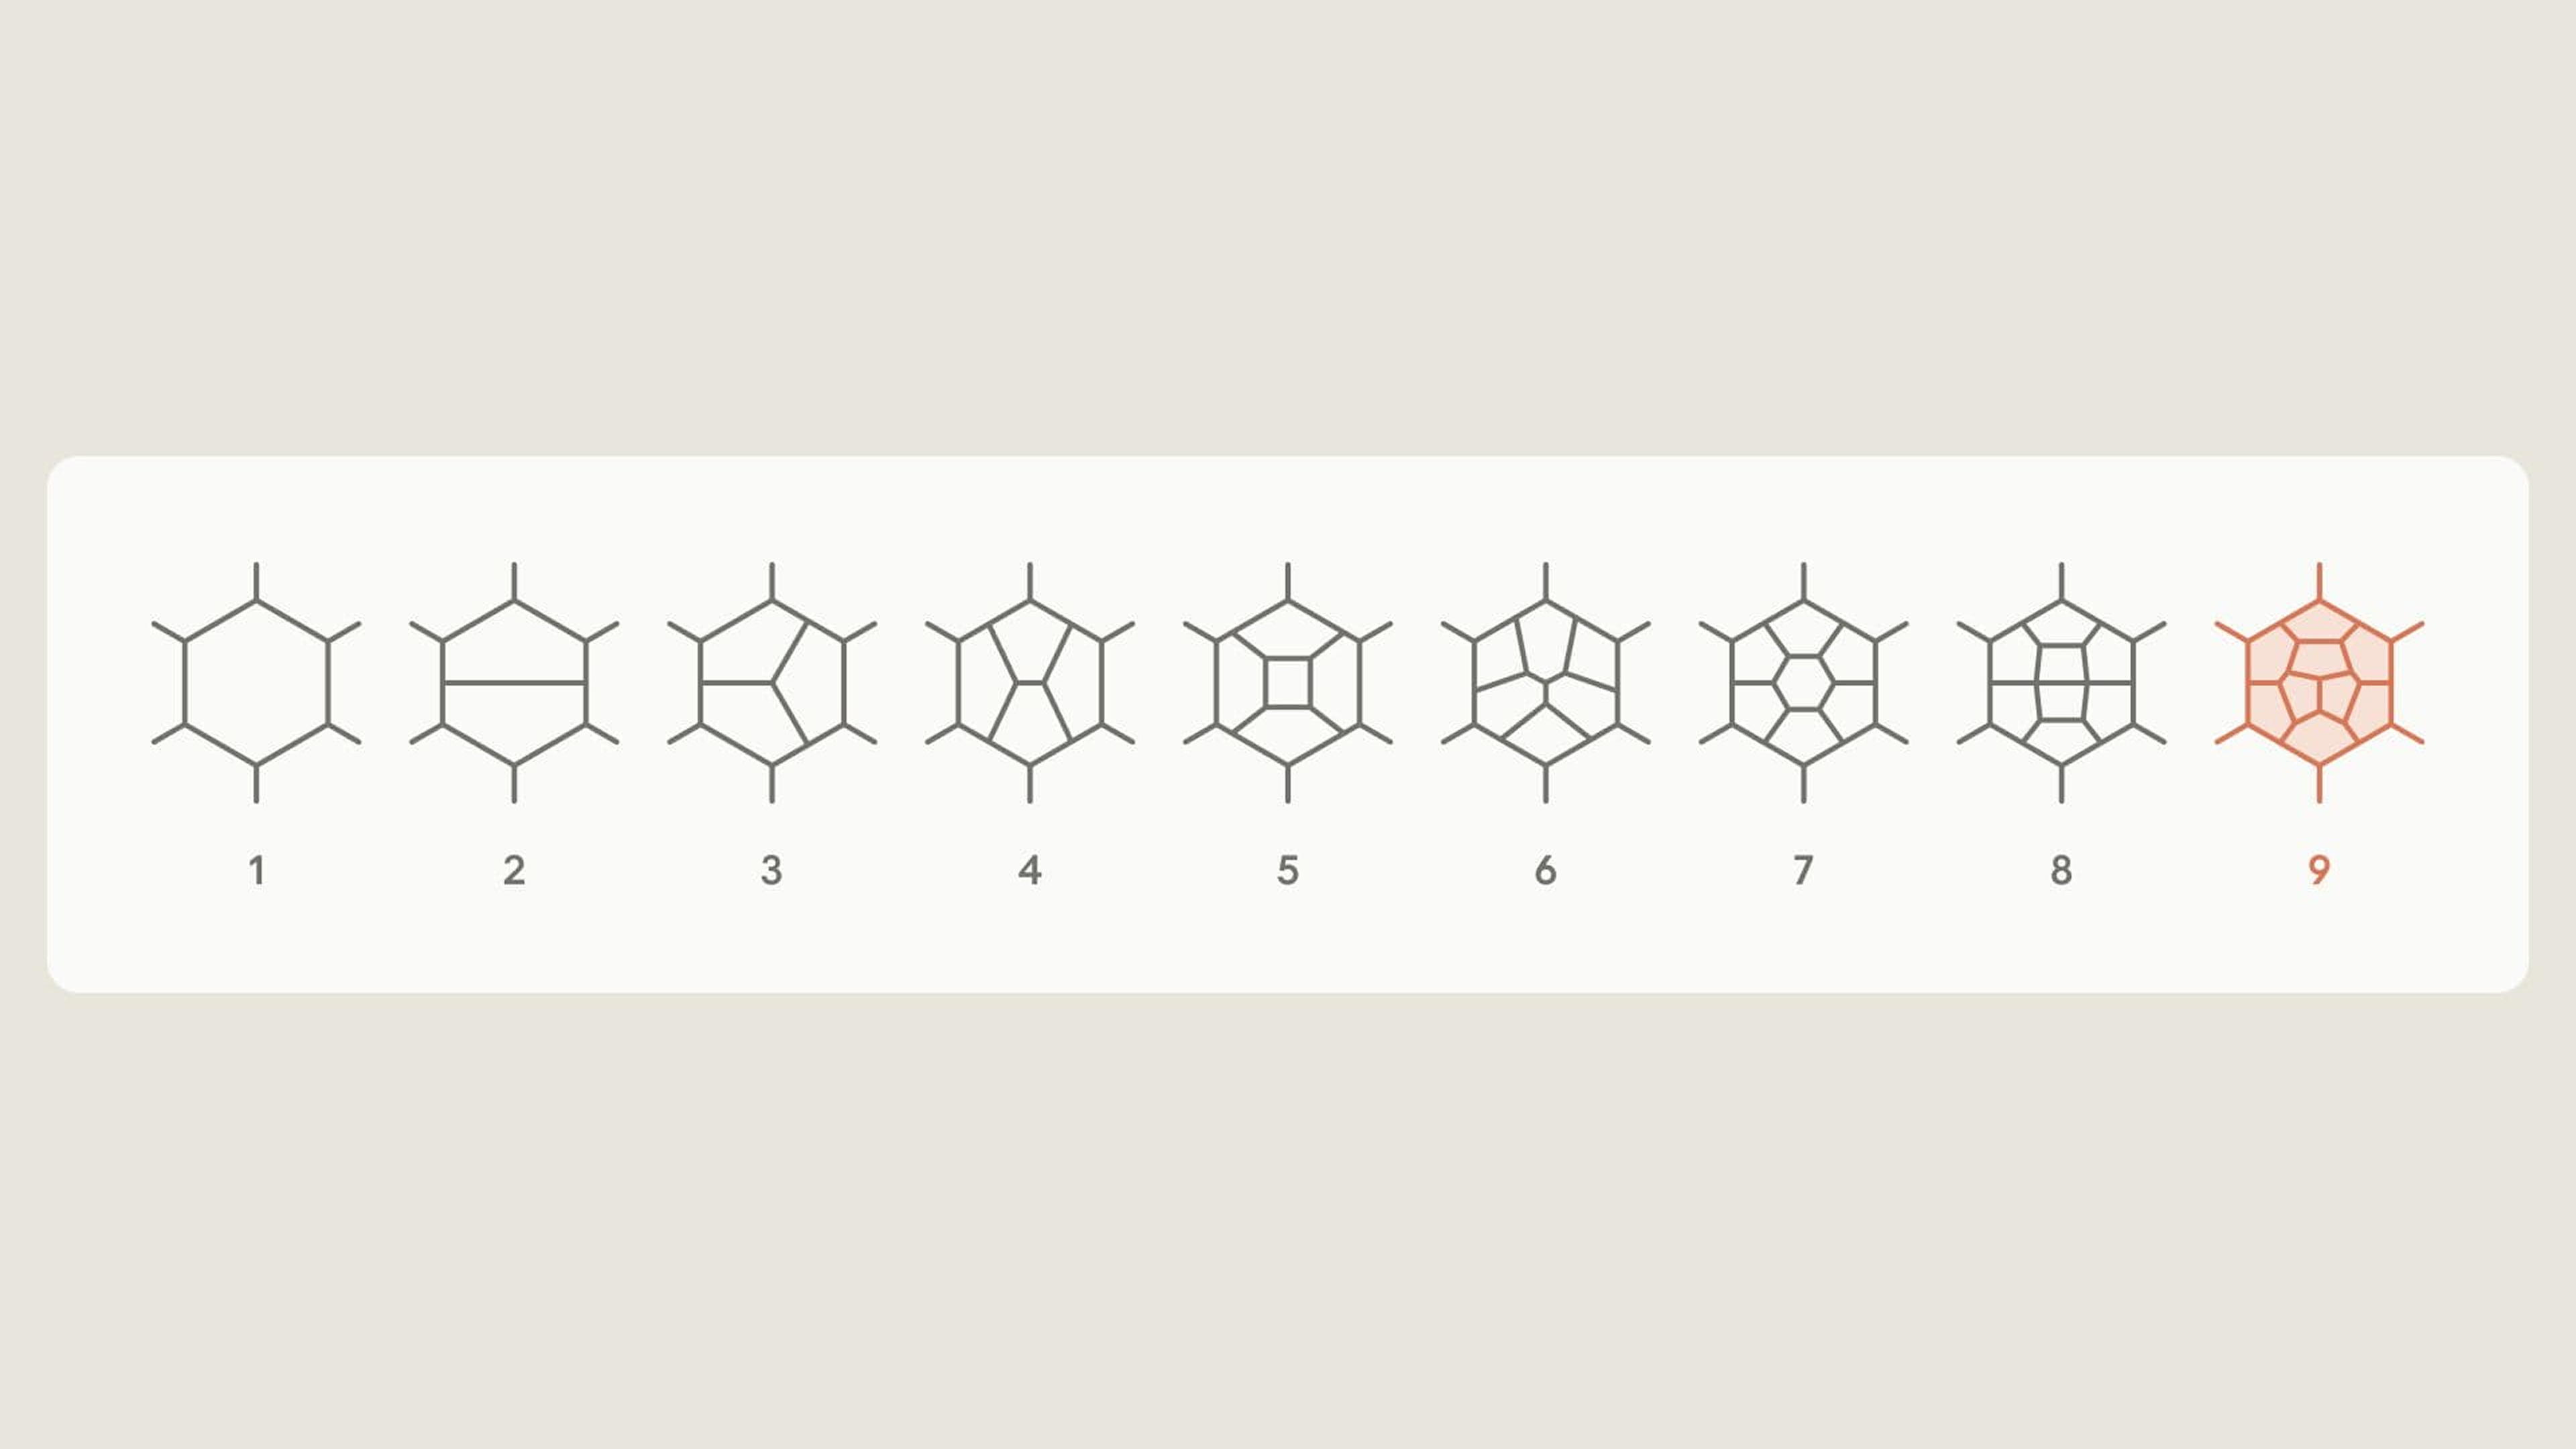
Claude가 N=4 super-Yang-Mills 이론에서 9루프 진폭을 계산해냈다
새로 열린 디렉터리 등록 포털을 통해 Claude 디렉터리에 플러그인을 제출할 수 있습니다. MCP 커넥터와 Agent Skills를 패키징하고 심사 진행 현황을 추적하며, 출시 이후에는 실제 사용 현황과 검색 노출 방식까지 한눈에 확인해 보세요.

Vercel의 버그 바운티 프로그램이 HackerOne을 통해 공개됐습니다. Vercel의 전체 제품군과 오픈소스 프로젝트가 대상이며, 참여 방법과 제보 절차를 안내합니다.

에이전트를 시장에 투입했을 때 무엇이 통하고 무엇이 문제가 되는지 확인하기 위해, Claude들로만 이루어진 소규모 모의 시장을 구축해 실험했다.
이제 Claude Tag를 사용하면 채널에서 요청할 때 개인 커넥터(connector)를 활용할 수 있습니다. 커넥터는 본인만 사용 가능하며, 출력 결과를 어떻게 표시할지도 직접 제어할 수 있습니다.

최신 Opus 모델은 오늘날 개발자들의 코딩 패턴에 맞춰 비용 효율을 극대화하도록 가격 책정과 훈련 방식을 새롭게 설계했습니다.

Gemini 3.8 Flash TTS를 활용하면 자신의 목소리를 그대로 복제하거나, 짧은 문장 하나만으로 새로운 목소리를 설계할 수 있습니다. 설계한 목소리는 문장 단위로 발화 방식을 세세하게 조정하는 것도 가능합니다.
에이전트를 활용하면 코드 현대화를 몇 달 안에 마칠 수 있다. 하지만 실제 속도를 좌우하는 건 결국 변화 관리다. 목표 설정부터 인증, 승격 정책 수립까지 — 반드시 짚어야 할 6단계를 정리했다.

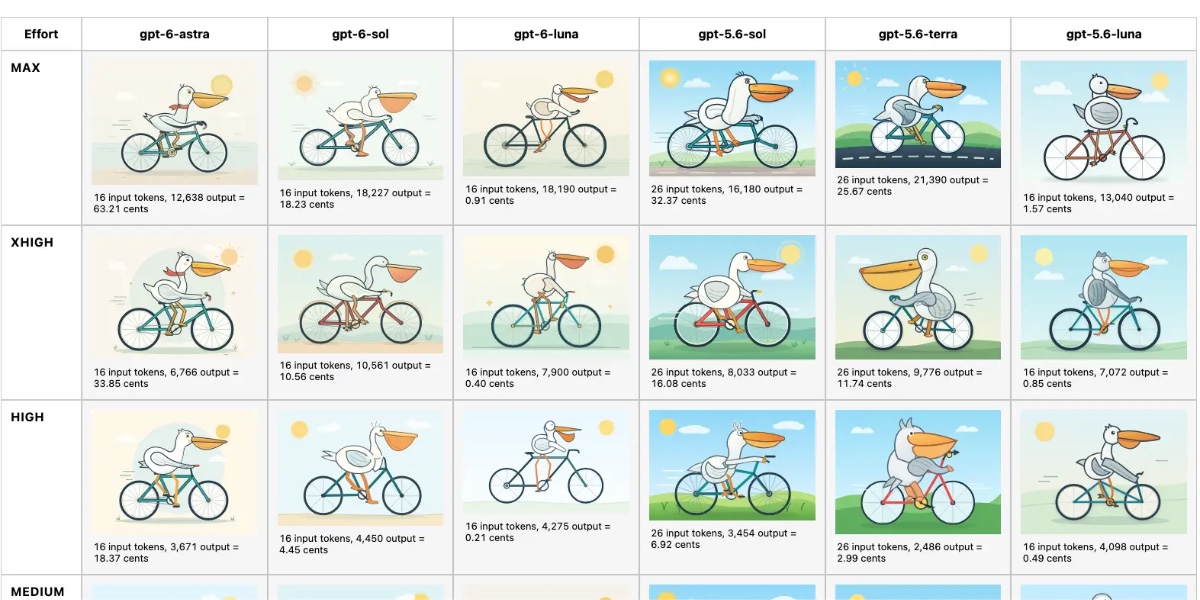
어제는 Grok 4.7(pelicans)과 MiMo v2.6 Flash/Pro(역시 pelicans)가 공개됐고, 오늘은 Anthropic이 Claude Opus 5.5를, 약 한 시간 뒤에는 OpenAI가 GPT-6 Sol과 GPT-6 Luna를 연달아 출시했습니다. 신규 모델 전체를 제대로 평가하려면 좀 더 시간이 필요하겠지만, 지금까지 파악한 첫인상을 공유합니다.
토큰 단가가 같아도 작업당 실제 비용은 크게 달라질 수 있습니다. Claude Code를 Opus 5.5로 사용할 때 작업당 비용이 어느 정도인지, 그리고 어떤 설정이 요금을 좌우하는지 살펴봅니다.

지난주 TypeSafe AI가 Jev를 공개했다. Jev는 이들이 '시스템 원 모델(System One model)'이라 부르는 새로운 모델 범주의 첫 번째 사례다(Maggie Appleton의 시각에 동의하는데, '의사결정 모델'이 더 적합한 이름인 것 같다). Jev는 기존 LLM과 구별되는 흥미로운 변형 모델이다. 텍스트를 입력받는다는 점은 같지만, 텍스트를 출력하는 대신 카테고리 분류, 예/아니오 질문, 평점, 그리고 각각에 대한 신뢰도 점수를 부동소수점 값으로 돌려준다.
2026년 9월 1일부터 19일 사이, Hamel Husain과 Shreya Shankar가 운영하는 AI 평가(Evals) FAQ에 새 질문 16건이 추가됐습니다. 각 답변 전문과 원문 링크를 함께 정리했습니다.