Anthropic개발 블로그Playbooks
Opus 5.5로 작업 하나를 처리하면 비용은 얼마나 들까
토큰 단가가 같아도 작업 한 건에 드는 비용은 크게 다를 수 있습니다. Claude Code에서 Opus 5.5로 작업을 실행할 때 실제로 얼마가 드는지, 어떤 설정이 비용을 바꾸는지 살펴봅니다.
작업 한 건의 비용, 그리고 재시도의 비용
우리가 수백만 토큰을 사려고 나서는 것은 아닙니다. 기능을 만들고, 마이그레이션을 끝내고, 작업을 실행하려는 것이죠. 토큰 수는 모델이 그 목표에 도달하는 데 필요했던 만큼 나온 결과일 뿐입니다.
토큰당 가격이 같은 두 모델도 같은 작업에서 드는 비용은 크게 다를 수 있습니다. 한 모델은 코드를 한 번 읽고 끝냅니다. 다른 모델은 코드를 읽고, 수정을 시도하고, 다시 읽습니다. 이런 단계 하나하나가 턴(turn)이고, 턴마다 그때까지의 대화 전체를 다시 보냅니다. 그래서 턴이 더 많이 필요한 모델은 단가가 같아도 비용이 더 듭니다.
이 글을 다 읽고 나면 자신의 작업에 대해 다음 세 가지 질문에 답할 수 있을 겁니다.
- Opus 5.5에서 내가 자주 하는 작업은 비용이 얼마나 들까?
- 어떤 설정이 비용을 바꾸고, 얼마나 바꿀까?
- 내 세션 사용량은 어떻게 확인할까?
먼저 말씀드릴 트레이드오프가 있습니다. 토큰을 아끼는 방법은 모두 작업을 끝내지 못하는 위험과 맞닿아 있습니다. effort를 낮추거나, 더 작은 모델을 쓰거나, 컨텍스트를 줄이면 분명 토큰은 아낄 수 있습니다. 하지만 재시도 한 번의 비용이 그렇게 아낀 금액보다 큽니다. 이 글에서는 각 트레이드오프에 가격을 매겨 보려 합니다.
이 글의 숫자 중 일부는 정가(list price)이고, 일부는 정가를 바탕으로 만든 예시입니다. 그림은 인터랙티브하니 읽으면서 입력값을 바꿔 보세요. 어디까지나 최대한 근사한 예시이므로, 반드시 공식 문서를 확인하고 직접 계산해 보시기 바랍니다.
작업 한 건에는 얼마가 들까?
Claude Code에서 작업은 하나의 루프입니다. 모델이 대화를 읽고, 도구를 호출하고, 결과를 읽은 뒤, 작업이 끝날 때까지 이 과정을 반복합니다. 루프를 한 바퀴 도는 것이 요청 한 건입니다. 루프의 비용은 네 가지 요소가 좌우합니다.
턴 수. 턴마다 그때까지의 대화 전체를 다시 보냅니다. 턴이 적을수록 처리하는 입력이 줄어듭니다.
캐시 읽기. 턴마다 다시 보내는 내용의 대부분은 모델이 이전 턴에서 이미 본 텍스트입니다. 이 부분은 캐시 읽기로 청구되며, 입력 단가의 아주 작은 일부만 냅니다.
출력 토큰 유형. 가장 비싼 토큰으로, 입력 단가의 다섯 배입니다. Thinking(사고)도 출력으로 청구되므로, 답에 이르기까지 덜 추론하는 모델이 비용도 적게 듭니다.
모델. 모델마다 가격이 다르며 가격 페이지에 나와 있습니다. 어떤 모델을 고르느냐에 따라 모든 토큰의 단가가 정해집니다.
이 글의 예시는 Opus 5.5의 API 정가를 기준으로 합니다. 입력 토큰은 100만 개당 $4, 출력 토큰은 100만 개당 $20, 캐시 읽기는 100만 개당 $0.20입니다. 아래의 계산기와 마찬가지로, 예시에서도 캐시된 입력은 읽기 가격으로, 나머지는 모두 입력 가격으로 계산하고 캐시 쓰기는 제외했습니다. 토큰 수는 예시용 값입니다.
턴 수
어떤 작업이 20K 토큰의 컨텍스트로 시작해, 모델이 파일과 도구 결과를 읽으면서 120K까지 늘어난다고 해 봅시다. 40턴이면 한 턴당 평균 약 70K 토큰을 보내게 됩니다. 대화 길이는 120K를 넘지 않았는데도 작업 전체의 입력 토큰은 약 2.8M이 됩니다. 이 중 90%를 캐시에서 읽으면 입력 비용은 약 $1.62입니다. 같은 작업을 25턴에 끝내면 처리하는 토큰은 약 1.75M, 입력 비용은 약 $1.02입니다.
한 턴의 비용은 그 턴에서 새로 추가되는 토큰보다 큽니다. 이전 내용을 전부 다시 보내기 때문입니다. 가장 저렴한 턴은 필요 없는 턴입니다.
턴을 줄이는 습관 하나는 모델이 스스로 결과를 검증할 방법을 주는 것입니다. 실행할 테스트, 빌드, 엔드포인트를 호출하는 스크립트 같은 것들입니다. 스스로 검증할 수 있는 모델은 실수를 더 일찍 발견합니다.
필요한 정보를 한 번에 모으고 도구 호출을 묶어서 처리하는 모델도 다시 보내는 횟수가 줄어 비용을 덜 냅니다.
캐시 읽기
같은 2.8M 입력 토큰이라도 캐시에서 읽는 비중이 0%면 $11.20이 듭니다. 적중률이 90%면 $1.62, 96%면 약 $0.99입니다. 입력 비용을 이만큼 움직이는 설정은 달리 없습니다. 안정적으로 진행되는 세션은 알아서 높은 적중률을 유지합니다. 캐시가 깨지지 않도록 피해야 할 행동은 이 글 뒷부분에서 다룹니다.
출력 토큰
Opus 5.5에서 출력 토큰 하나의 가격은 캐시 읽기의 100배입니다. 일반적인 작업 하나의 출력 토큰 60K는 $1.20으로, 캐시에서 6M 토큰을 읽는 비용과 같습니다. 출력에는 thinking도 포함됩니다. Claude Code가 요약만 보여 주더라도 전부 비용을 내야 합니다. 모델이 얼마나 생각하느냐를 주로 바꾸는 effort가 비용을 크게 움직이는 이유입니다.
모델
캐시 읽기가 더 싼 모델은 주로 긴 세션에 유리합니다. 출력이 더 싼 모델은 추론이 많이 필요한 작업에 유리합니다.
Opus 5.5에서 달라진 점
달라진 것은 두 가지입니다. 가격, 그리고 모델이 하는 작업량입니다.
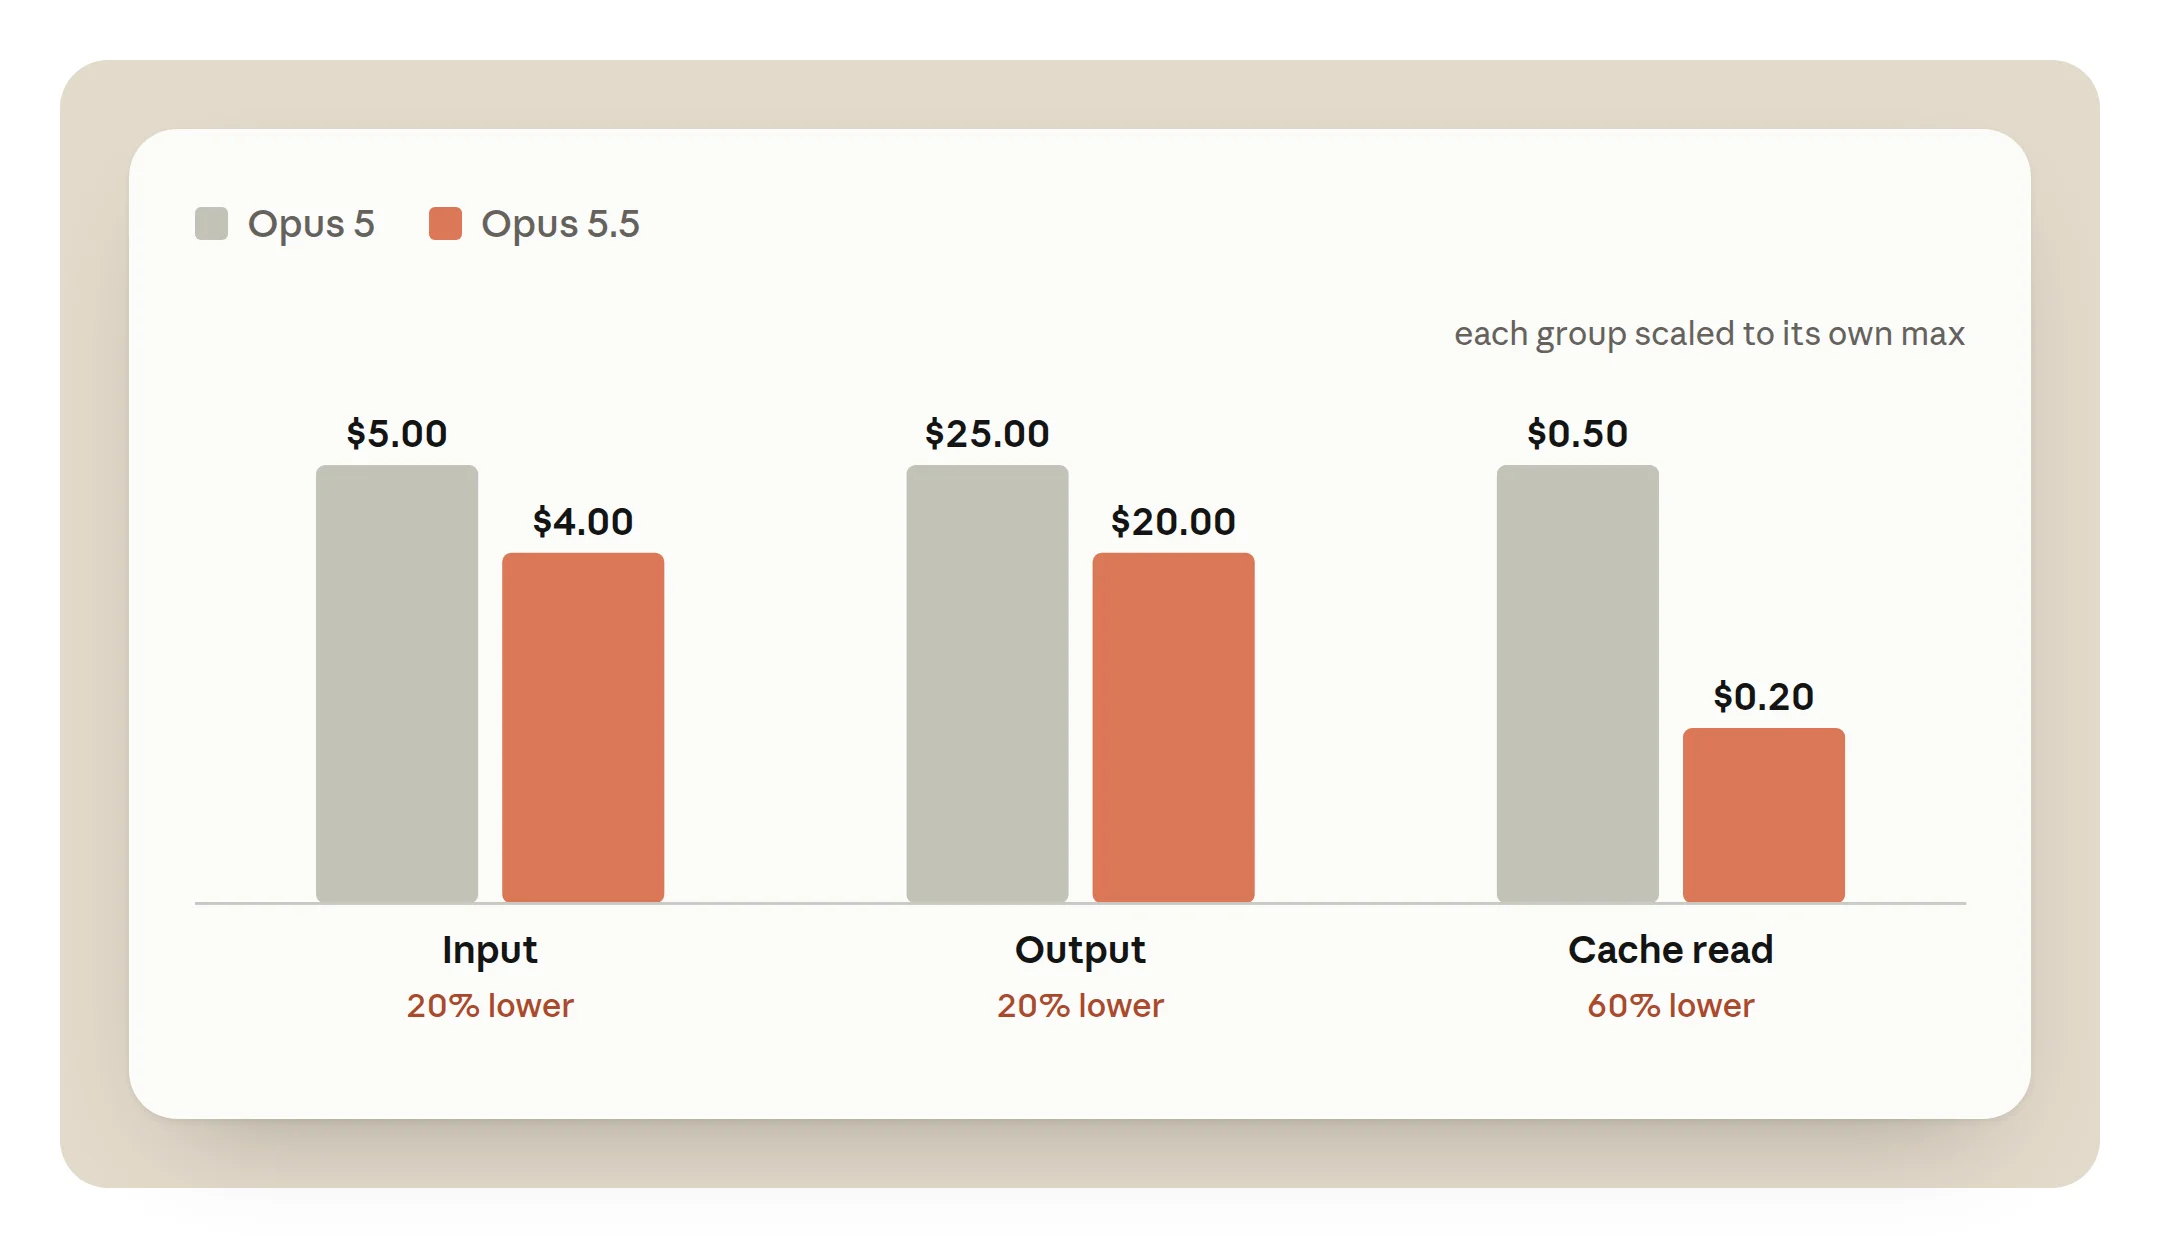
모든 가격 항목이 내려갔습니다. 입력과 출력 토큰은 Opus 5보다 20% 저렴해졌고, 캐시 읽기는 60% 저렴해졌습니다. 입력 가격이 내려가면서 읽기 요율도 함께 내려가, 입력 가격의 10분의 1에서 20분의 1이 되었습니다. Fig A에서 두 모델의 100만 토큰당 가격을 비교해 볼 수 있습니다. 여기 나온 것은 API 정가입니다. Pro, Max, Team 요금제에서는 Opus 5.5의 낮아진 가격이 캐시된 컨텍스트를 포함한 사용 한도에도 반영되어, Opus 5보다 약 25% 더 오래 쓸 수 있습니다. 캐시 읽기에 대한 추가 인하는 API 가격에만 해당합니다.
이와 별개로 Pro, Max, Team, 좌석 기반 Enterprise 요금제의 5시간 한도가 늘었고, 대상 구독자에게는 원하는 때 쓸 수 있는 한도 초기화 기회도 제공됩니다. 웹이나 Claude Desktop의 Settings > Usage에서 확인할 수 있으며, 터미널의 Claude Code에서는 볼 수 없습니다. 초기화는 Claude Code를 포함한 계정 전체에 적용됩니다.
API 키를 쓴다면 Claude Code에서는 캐시 읽기 가격 인하가 가장 큰 영향을 줍니다. 에이전트가 오래 도는 세션은 입력의 대부분을 캐시 읽기에 씁니다. 아래 Fig B에서 계산한 세션에서는 캐시 항목이 $1.00에서 $0.40으로 떨어지는데, 명세서에서 가장 큰 폭의 하락입니다.
얼마나 절약되는지는 작업의 성격에 따라 다릅니다. 대부분 캐시 읽기로 이루어진 세션은 입력 비용을 최대 60%까지 아낄 수 있습니다. 캐시 없이 짧게 묻고 길게 답을 받는 경우는 출력이 비용을 좌우하므로 절감 폭이 최대 20%입니다. Claude Code 작업 대부분은 이 둘 사이에 있습니다. 내 작업이 어디쯤인지는 아래 계산기에서 확인해 보세요.
Opus 5.5의 운영 비용이 Opus 5보다 40% 적다는 이야기를 들으셨을 수도 있습니다. 이는 토큰 단위로 청구되는 일반적인 워크로드를 기본 설정으로 실행할 때를 가정한 추정치입니다. 가격 인하에 더해, Opus 5.5가 기본값인 medium에서 작업당 더 적은 토큰을 쓴다고 가정한 값이므로 토큰 단가가 40% 내려간 것은 아닙니다. 토큰 가격은 Fig A에 나온 그대로이며, 가격 변화만의 효과는 Fig B에서 볼 수 있습니다.
Opus 5.5는 답하기 전에 항상 생각하기 때문에, 답변 하나에 토큰을 더 쓸 수도 있습니다. Opus 5.5에서는 더 많은 일을 해낼 수 있을 것으로 기대하지만 작업마다 다르므로, 직접 작업에서 측정해 보세요. Fig C는 두 모델의 작업당 비용을 비교합니다. 이 부분은 가격보다 훨씬 더 작업 내용에 좌우됩니다.
범위가 명확한 작업이라면 두 모델은 비슷한 턴 수로 끝나므로, 가격 인하분만큼만 이득을 봅니다. 격차는 범위가 열려 있는 작업에서 가장 클 것으로 보입니다. 이런 작업에서는 모델이 잘못된 방향에 여러 턴을 쓸 수 있기 때문입니다. 모든 코드베이스에 들어맞는 단일 수치는 없으니 직접 측정해 보세요(마지막 섹션 참고).
긴 실행은 보고로 끝납니다. Opus 5.5는 긴 실행을 마칠 때 무엇을 바꿨는지, 무엇을 발견했는지, 사용자에게 무엇이 필요한지를 정리해 줍니다. 이것도 비용 절감으로 이어질 수 있습니다. 무슨 일이 있었는지 볼 수 있으면 세션을 다시 돌리는 횟수가 줄기 때문입니다.
같은 작업을 나란히 비교하기
Fig B는 같은 토큰 수로 세션 하나를 두 모델에서 각각 계산합니다. 따라서 차이는 오직 가격 변화에서 나옵니다. 모델을 바꿔 가며 비교해 보세요. 토큰 수는 예시용 값입니다.
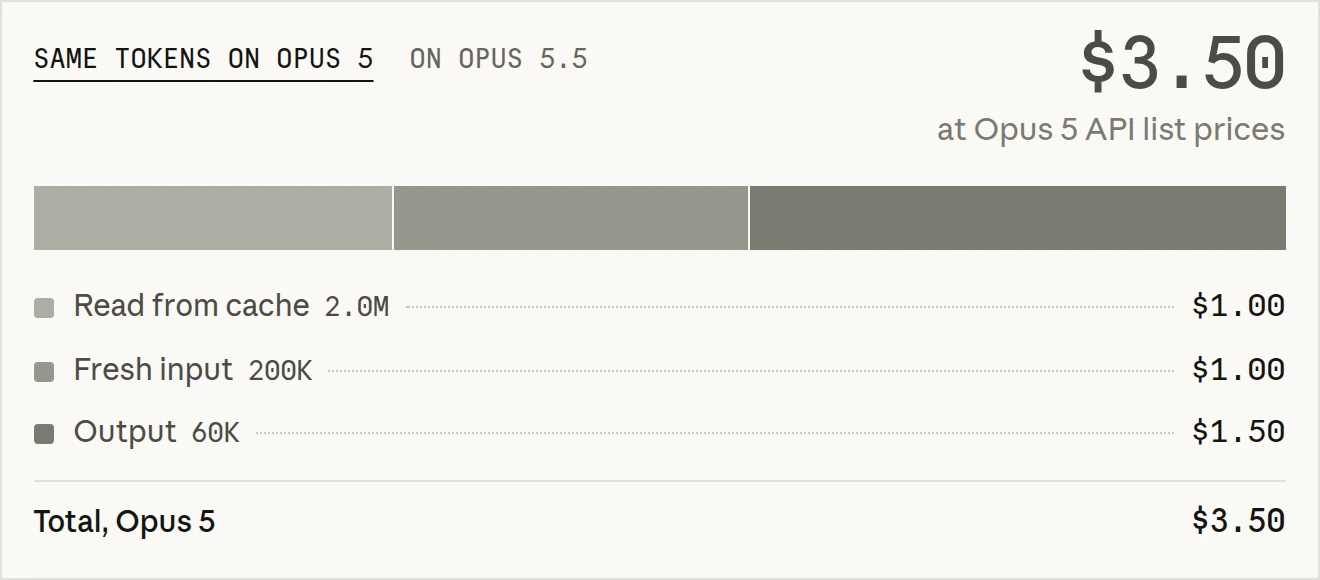
이 명세서에는 세션에 대해 /usage가 보여 주는 세 항목이 들어 있습니다. 토큰 수 기준으로 가장 큰 항목은 2M의 캐시 읽기입니다. 출력은 토큰 수로는 가장 작지만 비용으로는 가장 큽니다. 새 입력(fresh input)은 그 중간이며, 각 파일을 처음 읽을 때와 새 도구 결과가 들어올 때의 입력을 포함합니다.
Fig B는 두 모델에 같은 토큰 수를 적용하므로 가격 변화만의 효과를 보여 줍니다. 실제 세션에서는 Opus 5.5에서 토큰을 더 쓸 수도, 덜 쓸 수도 있습니다. 이렇게 계산하면 이 세션의 비용은 약 31% 줄어듭니다.
실제로 기록한 실행에서는 두 번째 효과, 즉 모델이 하는 작업량의 변화가 더해집니다. 잘못 시작했다가 되돌리는 작업에서는 격차가 더 벌어질 것입니다.
내 숫자로 계산해 보기
내 작업 하나가 쓰는 양을 직접 설정하거나, 프리셋에서 시작해 보세요. 프리셋도 어디까지나 예시이니 직접 계산해 보시길 권합니다. 캐시된 입력은 캐시 읽기 가격으로, 새 입력은 입력 가격으로 계산되므로, 캐시 슬라이더를 움직이면 차이 중 캐시 읽기에서 나오는 몫이 얼마인지 알 수 있습니다.
실제 세션의 값으로 슬라이더를 채우려면 작업이 끝난 뒤 /usage를 실행하세요. Session 블록에 입력, 출력, 캐시 수치가 나옵니다. 마지막 슬라이더는 내 작업에서 Opus 5.5가 하는 일이 얼마나 줄어드는지에 대한 가정입니다. 가격 변화만 보려면 0%로 두세요. 내 작업 기준으로 값을 정하려면 같은 작업을 Opus 5와 Opus 5.5에서 각각 실행해 턴 수와 출력 토큰을 비교하면 됩니다. 「직접 측정해 보기」에 방법이 나와 있고, 「세션 읽는 법」에서는 /usage에서 무엇을 확인해야 하는지 설명합니다.
입력 토큰2.2M
캐시 여부와 관계없이 모든 턴에서 모델에 보낸 전체 입력.캐시에서 읽은 비율91%
출력 토큰60K
출력으로 청구되는 thinking을 포함합니다.하루 작업 수10
Opus 5.5의 토큰 변화(직접 가정)0%
가격만 보려면 0%로 두세요. Opus 5.5는 Opus 5보다 토큰을 더 쓸 수도, 덜 쓸 수도 있으니 내 작업에서 직접 측정해 보세요.Opus 5, 이 토큰 기준$3.50월 $770
Opus 5.5, 이 토큰 기준$2.40월 $528
API 정가 기준 변화−31%가격만으로 월 $242 절감
세션의 가치를 최대한 끌어올리는 팁
Opus 5.5는 가격이 낮아져 토큰 하나하나의 비용이 줄었습니다. 토큰을 얼마나 쓰느냐는 세션을 어떻게 운영하느냐에 달려 있으며, 다음 방법들이 도움이 됩니다.
모델을 바꾸기 전에 effort부터 올리세요
effort는 모델이 매 턴에 토큰을 얼마나 쓸지에 대한 전반적인 성향을 정합니다. 여기에는 thinking, 작성하는 텍스트, 도구 호출이 모두 포함됩니다. effort가 낮으면 도구 호출 횟수가 줄고 호출 내용도 짧아집니다. Opus 5.5에는 low, medium, high, xhigh의 네 단계가 있고, 한 세션에만 쓸 수 있는 max가 별도로 있습니다. 아래에서 단계를 선택하면 언제 쓰면 좋은지와 설정 명령어를 볼 수 있습니다.
Medium: 범위가 명확한 일상 작업용
범위가 분명한 일상 작업에 적합합니다. high보다 턴당 생각을 덜 하므로 턴마다 비용이 적게 듭니다.
작업 범위가 명확하다면 여기서 시작하세요.
/effort medium/effort status/model/usage
Claude Code는 모델마다 기본 단계를 설정해 두며, /effort status로 현재 설정을 확인할 수 있습니다. 범위가 명확한 일상 작업에는 medium을 써 보세요. medium으로 막히면 high를 시도해 보세요. medium보다 턴당 비용이 늘지만, 더 큰 모델로 옮기는 것보다는 덜 듭니다. 이름 바꾸기나 알려진 패턴을 여러 파일에 적용하는 것 같은 기계적인 작업에는 low를 쓰세요.
Opus 5.5의 기본값은 medium으로, Opus 5의 기본값인 high보다 한 단계 낮습니다. 같은 단계라도 모델마다 생각하는 양이 같지는 않습니다. 같은 단계에서 Opus 5.5는 Opus 5보다 턴당 더 많이 생각하며, xhigh와 max에서 그 차이가 가장 큽니다. 따라서 Opus 5에서 고른 단계를 그대로 가져오지 마세요. medium에서 시작하고, xhigh와 max는 효과를 직접 측정해 이득이 확인된 작업에만 쓰세요.
effort 비용을 대략 가늠해 보면 이렇습니다. high가 작업 전체에서 thinking 토큰을 20K 더 쓴다고 합시다. Opus 5.5에서는 $0.40입니다. 캐시된 컨텍스트 100K에서 열 턴 동안 재시도 루프를 돌고 출력 토큰이 총 10K이면 비용이 거의 같습니다. 따라서 high는 재시도 한 번을 막아 주는 작업에서는 본전을 뽑습니다. medium으로도 한 번에 끝났을 작업에서는 낭비입니다.
medium이 한 계층만 고칠 때
effort를 높여야 한다는 가장 확실한 신호는 수정이 한 계층에서 멈추는 것입니다.
API 핸들러에서 필드 이름을 바꾼다고 해 봅시다. medium에서는 모델이 핸들러를 고치고 핸들러의 테스트도 통과하지만, 클라이언트는 여전히 예전 필드를 보냅니다. 시킨 일은 했지만, 두 번째 호출부를 찾을 만큼 멀리 읽지는 않은 것입니다. high에서는 코드를 쓰기 전에 호출 지점을 읽는 데 턴을 더 쓰고, 두 계층을 한 번에 고칩니다.
검증 수단으로도 같은 버그를 잡을 수 있습니다. 모델이 클라이언트를 거치는 테스트를 실행할 수 있다면, medium에서도 예전 필드는 코드를 작성한 바로 그 턴에 테스트에서 실패합니다. 그러니 effort를 올리기 전에 모델에게 스스로 검증할 방법이 있는지부터 확인하세요. 테스트 실행은 한 턴과 그 출력만큼의 비용이 듭니다. effort를 높이면 모든 턴에 thinking이 추가됩니다.
effort 단계를 올리고 검증 수단을 추가해도 해결되지 않는다면, 그때 더 큰 모델로 바꾸세요.
세션 도중에 effort 바꾸기
Claude Code에서 /effort 뒤에 단계를 붙여 실행하면 됩니다. 예를 들면 /effort high입니다. /effort status는 현재 단계를 출력합니다. 작업 중간에 바꿔도 되며, 새 단계는 다음 요청부터 적용됩니다.
API 키나 Claude 구독으로 Opus 5.5를 쓸 때는 effort를 바꿔도 캐시가 유지됩니다. 어려운 단계 하나에서만 effort를 올렸다가 다시 낮춰도 대화를 다시 쓰지 않아도 됩니다. Amazon Bedrock, Google Cloud의 Agent Platform, Claude apps 게이트웨이에서는 effort를 바꾸면 캐시된 대화가 여전히 지워지고, 다음 요청에서 대화 전체에 캐시 쓰기 가격을 냅니다. Opus 5.5는 thinking이 항상 켜져 있으므로 따로 바꿀 thinking 설정은 없습니다.
작업에 맞는 모델 고르기
모델 선택은 세션 안의 모든 토큰 단가를 정하므로 effort보다 비용에 더 큰 영향을 줍니다. 영향 범위도 더 넓습니다. 메인 모델을 상속하는 서브에이전트는 가격도 함께 상속하기 때문입니다. 대부분의 날에는 세 가지 모델이 필요합니다. 조회용 작은 모델, 가까이서 지켜보며 하는 작업용 Opus 5.5, 가장 어려운 작업용 더 큰 모델입니다.
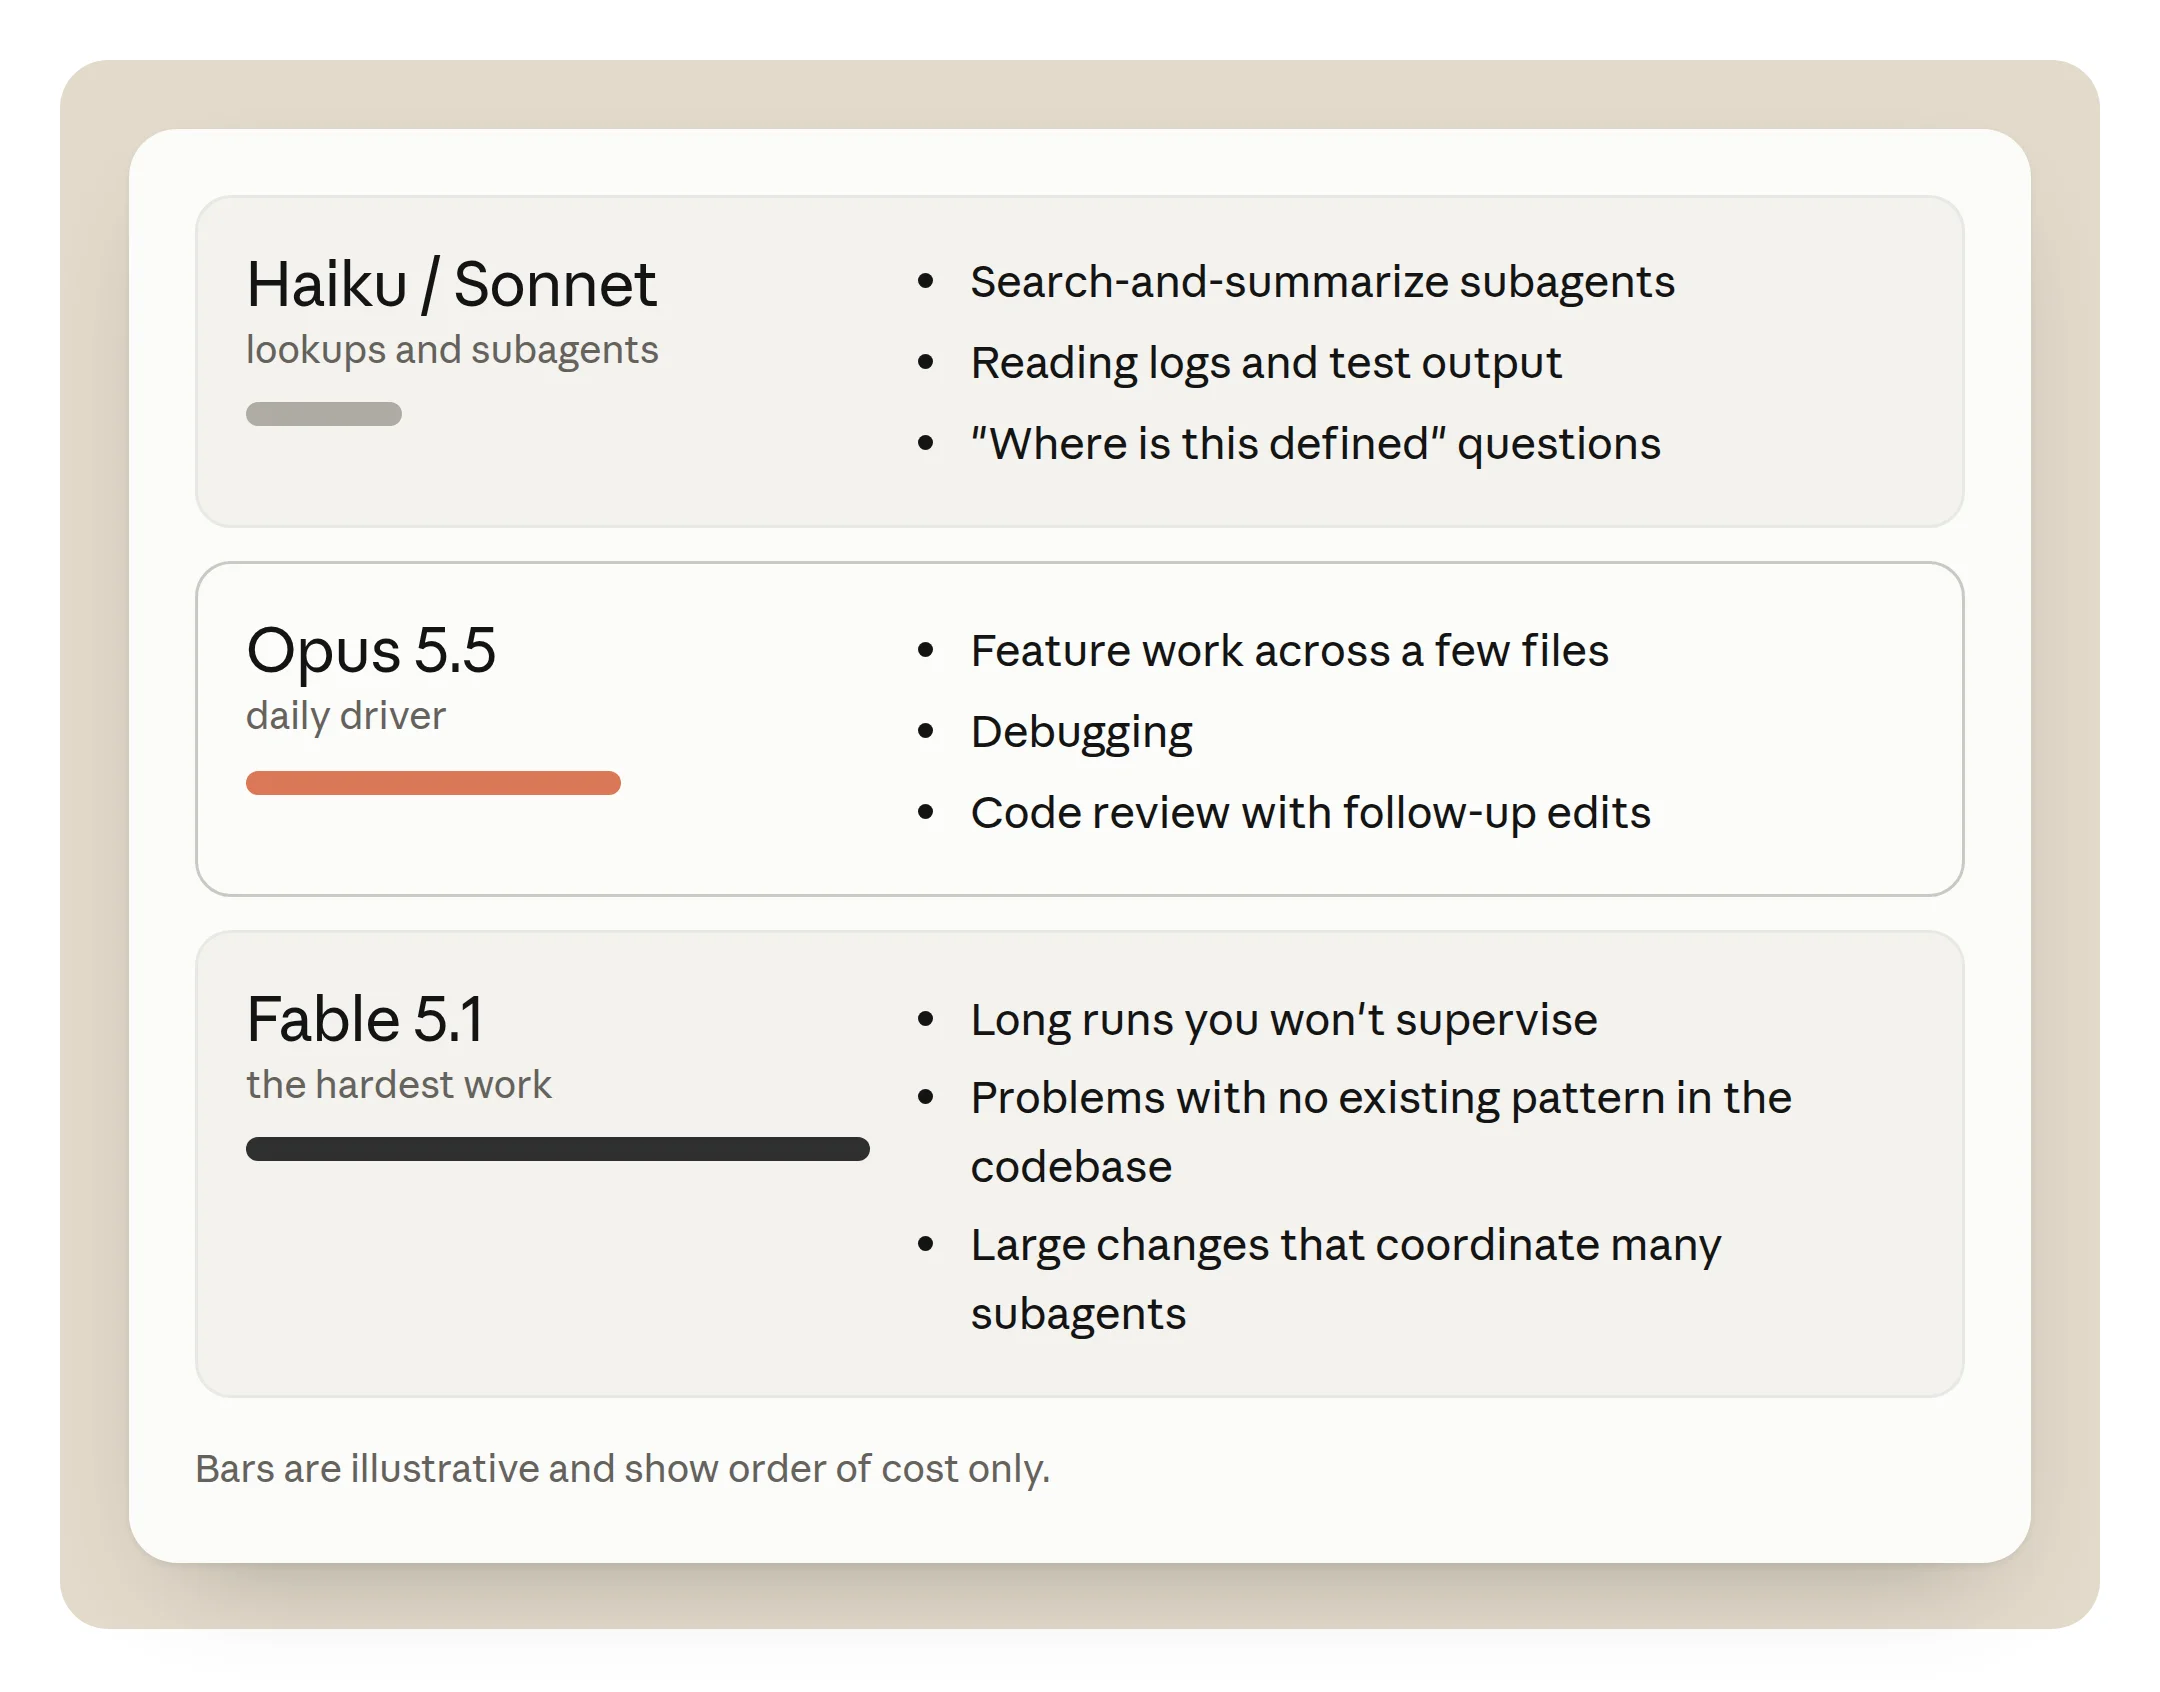
Opus 5.5를 기본 모델로
지켜보며 진행하는 작업에는 Opus 5.5를 쓰세요. 몇 개 파일에 걸친 기능 개발, 디버깅, 후속 수정이 따르는 코드 리뷰 같은 작업입니다. 모델이 하는 일을 읽어 가며 방향이 틀어지면 개입할 수 있으므로 루프가 짧게 유지됩니다.
Fable 5.1로 올리기
토큰 가격보다 결과가 더 중요할 때는 Fable 5.1로 올리세요. 예를 들면 지켜보지 않을 긴 실행, 코드베이스에 참고할 기존 패턴이 없는 문제, 많은 서브에이전트를 조율해야 하는 대규모 변경입니다. 세 번째 실패까지 기다리지 마세요. xhigh의 Opus 5.5가 같은 문제에서 두 번 막히면 바꾸고, 해결되면 다시 돌아오세요. 대화형 작업에는 지연 시간이 짧고 비용도 낮은 Opus 5.5가 더 잘 맞습니다.
Fable 5.1의 정가는 입력 토큰 100만 개당 $10, 출력 토큰 100만 개당 $50으로 Opus 5.5의 2.5배입니다. 캐시 읽기는 100만 개당 $0.25로 Opus 5.5 요율의 1.25배에 불과한데, 입력 가격의 0.025배로 청구되기 때문입니다. 그래서 캐시 비중이 큰 긴 실행에서는 격차가 가장 작고, 출력이 많은 작업에서는 가장 큽니다.
작업이 자연스럽게 끊기는 지점에서 전환하세요. 캐시는 이전 모델의 것이므로, 새 모델의 첫 턴에서는 대화 전체에 캐시 쓰기 가격을 내야 합니다. 그 턴의 비용을 줄이려면 먼저 /compact를 실행하거나, 짧게 정리한 계획을 들고 새 세션을 시작하세요. 전환은 /model에 별칭이나 모델 이름을 붙여 /model 명령으로 실행합니다. /model은 선택한 모델을 새 세션의 기본값으로도 저장하므로, 어려운 부분이 끝나면 다시 바꿔 두세요.
조회 작업은 더 작은 모델로 내리기
코드 작성이 아니라 조회 작업에는 Sonnet이나 Haiku로 내려가세요. 검색하고 요약하는 서브에이전트, 로그와 테스트 출력 읽기, "이건 어디에 정의돼 있지?" 같은 질문이 여기에 해당합니다. 여러 파일에 걸친 기계적인 수정은 Opus 5.5를 유지하고 effort를 low로 설정하세요. 나머지 코드를 작성하는 모델이 그대로 수정을 맡으면서 턴당 비용은 낮아집니다.
서브에이전트를 더 작은 모델에서 실행하려면 정의에 model: haiku 또는 model: sonnet을 지정하세요. 모든 서브에이전트를 한 모델로 통일하려면 CLAUDE_CODE_SUBAGENT_MODEL 환경 변수를 설정하면 됩니다. 서브에이전트 정의에 명시한 모델은 이 환경 변수보다 우선합니다. model 설정이 없는 서브에이전트는 환경 변수가 지정되지 않은 한 메인 모델에서 실행됩니다.
서브에이전트는 각자의 컨텍스트 윈도우에서 실행되고 요약만 돌려주므로, 서브에이전트가 읽은 파일은 메인 대화에 쌓이지 않습니다. 그래도 서브에이전트 자체의 토큰 비용은 내야 하므로, model 설정이 그 비용을 결정합니다.
실험 기능인 에이전트 팀(agent teams)은 이 비용을 몇 배로 키웁니다. 팀원은 각각 별도의 Claude Code 인스턴스로, 자체 컨텍스트 윈도우를 갖고 종료될 때까지 토큰을 계속 사용합니다. 비용 문서에 따르면 팀원이 plan mode로 실행될 때 팀의 토큰 사용량은 일반 세션의 약 7배입니다. 팀은 작게 유지하고, 각 작업은 독립적으로 완결되게 하고, 맡은 부분이 끝난 팀원은 종료하세요.
여기에도 트레이드오프가 있습니다. 작은 모델이 검색 결과를 잘못 읽으면 메인 모델이 엉뚱한 파일을 뒤지게 되고, 그 돌아가는 비용은 메인 모델이 냅니다. 작은 모델에는 파일 찾기, 테스트 실행, 로그 읽기처럼 실수를 알아채기 쉬운 작업만 맡기세요.
판단이 필요한 일은 메인 모델에 맡기세요. opusplan 별칭은 작업을 다르게 나눕니다. plan mode에서 Opus가 계획을 세우고 Sonnet이 그 계획을 실행합니다. 이러면 코드 수정을 Sonnet이 맡게 되어 위의 조언과는 반대입니다. 기본값으로 정하기 전에 내 작업에서 먼저 측정해 보세요.
마이그레이션할 때 프롬프트를 점검하세요
이전 모델용으로 작성한 지시문은 Opus 5.5가 더 많이 쓰고 도구 호출을 반복하게 만들 수 있습니다. Claude Code에서 /claude-api prompt-audit를 실행하면 스킬이나 CLAUDE.md 파일 같은 Claude Code 설정에 이런 프롬프트 안티패턴이 있는지 점검해 줍니다. Claude Platform에서 만든 앱의 코드도 함께 점검합니다.
Opus 4.8에서 Opus 5.5로 마이그레이션하는 상황에서 이를 테스트했습니다. 이런 패턴이 여럿 들어 있는 프롬프트를 쓰는 고객 지원 티켓 44건짜리 내부 벤치마크를 사용했습니다. low effort로 Opus 5.5로 옮기자 벤치마크 비용이 약 18% 줄었습니다. prompt-audit를 실행하자 9%가 더 줄어, Opus 4.8 시작점보다 약 25% 낮아졌습니다. 이 점검으로 모델이 더 많이 쓰고 도구 호출을 반복하게 만들던 형식적인 지시들이 제거되었습니다. 필수 6단계 절차, 스크래치패드 규칙, 두 번 검증하라는 규칙, 서로 모순되는 지시가 그런 예입니다.
이 결과는 벤치마크 하나에서 나온 것이므로, 기대할 수치가 아니라 하나의 사례로 받아들이세요. 점검을 실행한 뒤 실제 작업에서 전후의 /usage를 비교해 보세요(「직접 측정해 보기」 참고).
캐싱과 컴팩션
캐싱과 컴팩션은 Claude Code가 알아서 처리합니다. 다만 세션을 어떻게 운영하느냐에 따라 얼마나 절약되는지가 달라집니다.
캐시의 작동 방식
Claude Code는 시스템 프롬프트, 도구 정의, 지금까지의 대화처럼 요청에서 반복되는 부분을 캐시합니다.
Opus 5.5에서 캐시 읽기는 새 입력 토큰 가격의 5%입니다. 캐시 쓰기는 새로 읽는 것보다 비싸서, 현재 가격 기준으로 5분 캐시는 입력 가격의 1.25배, 1시간 캐시는 2배입니다. 캐시가 적중할 때마다 유지 시간은 추가 비용 없이 초기화됩니다.
Claude Code에서 캐시 유지 시간은 결제 방식에 따라 다릅니다. Claude 구독에서는 1시간입니다. API 키나 클라우드 제공업체를 쓰면 기본 5분이며, 구독도 사용 크레딧을 소진하기 시작하면 5분으로 줄어듭니다.
컨텍스트가 120K 토큰일 때 Opus 5.5에서 5분 캐시 쓰기는 약 $0.60, 읽기는 약 $0.02입니다. 쓰기 한 번이 읽기 25번과 같은 비용입니다. API 키를 쓰면 6분 커피 휴식만으로도 다음 $0.02짜리 읽기가 $0.60짜리 쓰기로 바뀝니다. 같은 크기에서 1시간 캐시 쓰기는 약 $0.96이며, API에서는 이 추가 비용을 내고 하루 중 작업이 끊기는 시간을 메울 수 있습니다.
세션의 형태와 적중률
캐시는 프리픽스(앞부분)를 저장하므로, 요청의 처음부터 이전 요청과 일치하는 부분만 재사용할 수 있습니다.
안정적인 세션은 매 턴 대화 끝에 내용을 덧붙이기만 하므로 적중률이 높게 유지됩니다. 요청의 앞부분을 바꾸는 것은 무엇이든 적중률을 떨어뜨립니다. 도구 정의를 바꾸면 캐시 전체가 지워지고, 시스템 프롬프트를 바꾸면 바뀐 지점부터 뒤쪽이 지워지는데 이는 거의 전부입니다.
실제로는 다음과 같은 경우에 캐시 쓰기가 발생합니다.
- 캐시 유지 시간보다 오래 멈출 때,
- Amazon Bedrock, Google Cloud의 Agent Platform, 게이트웨이에서 effort를 바꿀 때. 이 환경에서는 effort 단계가 캐시 일치 여부를 판단하는 대상에 포함됩니다.
- 대화에서 처음으로 fast mode를 켤 때. 캐시가 일치 여부를 판단하는 대상의 일부가 바뀝니다.
- MCP 서버를 연결하거나 해제할 때. 매 요청의 시작 부분에 로드되는 내용이 바뀔 수 있습니다.
- 모델을 전환할 때. 새 모델은 빈 캐시에서 시작합니다.
- 대화를 컴팩션할 때. 캐시가 일치하던 히스토리가 다시 쓰이기 때문입니다.
그러니 이런 설정은 세션을 시작할 때 정해 두고, 작업하는 동안에는 건드리지 마세요.
긴 세션은 왜 턴당 비용이 더 들까
턴마다 컨텍스트 전체를 다시 보내므로, 캐시가 살아 있어도 컨텍스트가 커질수록 턴 비용이 늘어납니다. 컨텍스트가 20K 토큰일 때 Opus 5.5에서 턴당 캐시 읽기는 약 $0.004입니다. 150K에서는 약 $0.03이고, 이 크기로 30턴을 진행하면 읽기 비용만 $0.90입니다. 같은 30턴을 20K에서 진행하면 약 $0.12입니다. Claude 4.6 이후 모델에서는 컨텍스트 윈도우가 커져도 토큰당 가격은 그대로이므로, 비용은 전적으로 대화를 다시 보내는 데서 나옵니다.
그 컨텍스트의 상당 부분은 이전 작업의 잔재입니다. 한 시간 전의 스택 트레이스, 이미 끝낸 파일, 이후 고친 테스트의 실행 결과 같은 것들입니다. 이 모두가 매 턴 계속 전송됩니다.
컴팩션, /compact, /clear
세션이 컨텍스트 한도에 가까워지면 Claude Code가 오래된 히스토리를 요약해, 이후 턴에서 보내는 양을 줄입니다. 컨텍스트가 어느 정도까지 차면 컴팩션이 일어날지는 /autocompact에 토큰 수를 붙여 조정할 수 있습니다.
직접 처리할 수 있는 명령어도 두 가지 있습니다. /clear는 대화를 비우며 비용이 들지 않으므로, 관련 없는 작업으로 넘어갈 때 쓰세요. /compact는 맥락을 이어 가며 요청 한 건의 비용이 듭니다. 요약할 대화를 읽어야 하기 때문이며, 유지할 내용을 지정할 수도 있습니다. 예를 들면 /compact keep the failing test names and the schema change와 같습니다.
150K 토큰에서 컴팩션할 때의 대략적인 비용은 약 $0.25입니다. 대화를 읽는 비용, 수천 출력 토큰 분량의 요약, 더 짧아진 컨텍스트에 대한 새 캐시 쓰기를 합한 값입니다. 이후 턴마다 읽기 비용이 약 $0.025씩 줄어들므로, 컴팩션은 열 턴 안팎이면 본전을 뽑습니다. 작업을 끝내기 직전의 컴팩션은 절약하는 것보다 비용이 더 듭니다.
이 가격은 캐시가 살아 있다는 전제입니다. 캐시가 살아 있는 동안에는 요약 요청이 캐시에서 대화를 읽으므로, 휴식 뒤가 아니라 휴식 전에 컴팩션하세요. 캐시 유지 시간보다 오래 쉰 뒤에 같은 /compact를 실행하면 대화 전체를 다시 읽고 캐시에 다시 씁니다. 5분 캐시에서 150K 토큰이면 입력만 약 $0.75입니다. 버리고 싶은 방향으로 진행했다면 대신 이전 턴으로 /rewind하세요. 캐시가 살아 있는 동안에는 이미 캐시된 프리픽스로 돌아가게 됩니다.
요약 과정에서 세부 내용이 사라지기도 합니다. 디버깅 도중에 컴팩션하면 결정적이었던 로그 한 줄이 빠질 수 있습니다. 작업이 자연스럽게 끊기는 지점에서 컴팩션하고, 다음 단계가 특정 내용에 의존한다면 /compact 지시에 그 내용을 명시하세요.
입력하기 전에 로드되는 것들
CLAUDE.md 파일은 세션이 시작될 때마다 컨텍스트에 로드되므로, 그 안의 모든 줄이 매 턴 다시 전송되는 내용의 일부입니다. 비용 문서에서는 200줄 이내로 유지하라고 권합니다. MCP 도구 정의는 지연 로드됩니다. 시작할 때는 도구 이름과 서버 지침만 로드되고, 전체 정의는 해당 도구를 쓸 때 로드됩니다. /mcp를 실행하면 어떤 서버가 연결되어 있는지 볼 수 있으니, 쓰지 않는 서버는 꺼 두세요.
그 밖의 청구 항목
아래 표는 Claude Code 세션에 영향을 주는 나머지 청구 규칙을 정리한 것으로, 문서가 있는 항목에는 링크를 달았습니다.
fast mode는 Opus 5.5를 최대 2.5배 빠르게 실행하며, 가격은 표준의 두 배입니다. 입력 토큰 100만 개당 $8, 출력 토큰 100만 개당 $40입니다. Claude 구독에서는 요금제 한도가 아니라 사용 크레딧으로 청구됩니다. 켠 뒤 첫 요청에서는 대화 전체에 캐시 없이 fast mode 입력 가격이 적용됩니다. 그러니 세션 중반이 아니라 시작할 때 켜세요.
| 청구에 포함되는 항목 | 작동 방식 |
|---|---|
| 캐시 유지 시간 | Claude Code에서는 구독 시 1시간, API 키나 클라우드 제공업체를 쓰거나 구독이 사용 크레딧을 소진하기 시작하면 5분입니다. 적중할 때마다 유지 시간이 초기화됩니다. API에서는 쓰기 가격이 더 높은 1시간 캐시도 제공합니다. 비용 문서(Claude Code 유지 시간) 및 프롬프트 캐싱 문서 |
| 캐시 쓰기 | 현재 API 가격 기준으로 5분 캐시는 입력 가격의 1.25배, 1시간 캐시는 2배입니다. 가격 문서 |
| Thinking | 사용자에게 반환되지 않는 thinking을 포함해 출력 토큰으로 청구됩니다. 확장 thinking 문서 |
| Effort | 텍스트, 도구 호출, thinking을 포함한 모든 출력 토큰에 적용됩니다. Effort 문서 |
| 자동 컴팩션 | 컨텍스트 윈도우가 한도에 가까워지면 실행됩니다. /autocompact에 토큰 수를 붙여 임계값을 설정합니다. 컨텍스트 윈도우 문서 |
| 서브에이전트와 에이전트 팀 | 서브에이전트는 자체 컨텍스트 윈도우에서 작업하고 요약을 돌려줍니다. plan mode의 에이전트 팀은 일반 세션의 약 7배 토큰을 씁니다. 컨텍스트 윈도우 및 비용 문서 |
| Batch API | Message Batches API로 보내는 요청은 입력과 출력 토큰 모두 절반 가격입니다. 배치 처리 문서 |
| 현재 일반적인 지출 | 엔터프라이즈 배포 전체 평균으로 개발자 1인당 활동일 기준 약 $13입니다. 사용자의 90%는 활동일 기준 $30 미만입니다. 두 수치 모두 현행 모델 기준입니다. 공개 문서, 비용 페이지(엔터프라이즈 평균 및 90% 상한) |
직접 측정해 보기
이 글의 수치는 예시입니다. 코드베이스, 프롬프트, 작업 습관은 저마다 다르므로 비용은 내 작업에서 직접 측정해 보세요. 확인 방법은 다음과 같습니다.
- 세션에서 /usage를 실행하세요. /cost도 같은 역할을 합니다. Session 블록에는 토큰 사용량과 정가 기준의 예상 비용이 표시됩니다. 프롬프트 캐시 줄에서는 입력 중 얼마나 캐시에서 나왔는지 볼 수 있습니다. Pro, Max, Team, Enterprise 요금제에서는 같은 화면에 요금제 사용량 막대도 표시됩니다. 금액은 사용자의 컴퓨터에서 정가로 계산한 값이므로, 구독에서는 청구 금액이 아니라 작업량을 가늠하는 지표입니다.
- 같은 작업을 두 번 실행해 보세요. Opus 5.5는 Claude Code v2.1.280 이상이 필요하므로, 먼저
claude update를 실행하세요. 간단한 예제 말고 백로그에 있는 실제 작업을 고르세요. /model로 Opus 5와 Opus 5.5를 전환하며, 실행마다 턴 수, 출력 토큰, 비용을 기록하세요. 결론을 내리기 전에 서너 개 작업을 해 보세요. - 팀 단위로는 사용량 및 비용 리포트를 활용하세요. Claude Code Analytics API는 사용자별 예상 비용을 제공합니다. Usage and Cost API는 모델별, 캐시된 토큰과 캐시되지 않은 토큰별로 지출을 나눠 보여 줍니다.
- effort 단계를 차례로 시험해 보세요. 어려운 작업 하나를 medium으로 실행한 다음 high로 실행해 보세요. 기계적인 작업 하나는 low로 실행해 보세요.
세션 읽는 법
작업이 끝나면 /usage에서 세 가지를 확인하세요.
- 캐시 비중. 긴 세션이라면 높아야 합니다. 낮다면 긴 휴식, 모델 전환, 중간에 연결한 MCP 서버, 클라우드 제공업체나 게이트웨이에서의 effort 변경을 살펴보세요. 프롬프트 캐시 줄에는 마지막 캐시 미스의 원인으로 보이는 항목이 표시되는 경우가 많습니다.
- 입력 대비 출력. 작은 변경에 출력이 많다면 대개 작업에 비해 effort가 너무 높거나 모델이 재시도하고 있다는 뜻입니다.
- 대화 크기 대비 총 입력. 총 입력이 대화 크기의 몇 배나 된다면 세션이 많은 턴을 거쳤다는 뜻이므로, 대화를 읽어 어디서 루프가 반복됐는지 찾아볼 만합니다.
기준선으로는 Claude Code 비용 문서에 나온 수치를 참고하세요. 엔터프라이즈 배포 전체 평균은 개발자 1인당 활동일 기준 약 $13이고, 사용자의 90%는 활동일 기준 $30 미만입니다. 평소 수준을 크게 웃도는 세션은 점검해 볼 만합니다.
기억해 둘 것
- 범위가 명확한 일상 작업에는 medium effort를 쓰세요.
- 모델이 스스로 검증할 방법을 주고, 여러 파일에 걸친 변경은 plan mode에서 시작하세요.
- medium으로 막히면 effort를 high로 올리세요. API 키나 구독에서는 바꿔도 캐시가 유지됩니다. 클라우드 제공업체나 게이트웨이에서는 작업이 끊기는 지점에서 바꾸세요.
- xhigh에서 같은 문제로 두 번 막히면 Fable 5.1로 전환하고, 해결되면 다시 돌아오세요.
- 검색과 로그 읽기를 맡는 서브에이전트는 Sonnet이나 Haiku에 두고, 코드 수정은 Opus 5.5에 맡기세요.
- 긴 세션은 끊기지 않게 이어 가서 캐시가 살아 있게 하세요.
- 관련 없는 작업 사이에는 /clear를, 작업이 끊기는 지점에서는 유지할 내용을 메모해 /compact를 쓰세요.
- 가장 중요한 것: 실제 작업 하나를 각 모델에서 실행해 /usage가 보고하는 값을 비교하세요. 믿을 수 있는 것은 내 숫자입니다.
이 글이 도움이 되었기를 바랍니다. Opus 5.5에서 Opus 5보다 한도가 더 오래 가지 않는다면 /feedback으로 알려 주세요.
더 읽어 볼 자료: 비용을 효과적으로 관리하기 · 모델 구성 · Claude Code에서 Claude 모델과 effort 단계 고르기 · Effort · 프롬프트 캐싱 · Claude Code 세션의 가치 극대화하기
리뷰해 주신 Michael Segner, Kacie Jenkins, Molly Vorwerck에게 감사드립니다.