Anthropic제품 블로그Claude Code
Claude Code 세션을 최대한 활용하는 법
토큰 한 개도 낭비하지 않고 세션을 효율적으로 운영하기 위한 실용적인 팁 모음.
핵심 요약
- 작업 사이에는
/clear을 실행하세요. 이전 작업의 불필요한 컨텍스트가 모델로 다시 전송되는 것을 막아 토큰 사용량을 줄일 수 있습니다. - 시작 전에 모델과 노력 수준을 설정하세요. 대화 중간에 둘 중 하나라도 변경하면 프롬프트 캐시가 깨져 토큰 비용이 늘어날 수 있습니다.
- 파일 이름을 직접 입력하는 대신 @-멘션을 사용하세요. 파일이 메시지에 바로 첨부되므로 Read 호출 한 번, 또는 Claude가 파일을 직접 찾아야 할 경우의 검색 비용을 아낄 수 있습니다.
- 출력이 많은 명령에는 quiet 플래그를 붙이거나, 서브에이전트에서 실행하세요. 명령 출력은 파일과 마찬가지로 대화에 추가되며, 세션이 끝날 때까지 그 자리에 남아 있습니다.
- 새 세션을 열고
/context을 한 번 실행해보세요. 현재 로드된 항목(CLAUDE.md, MCP 툴 정의 등)을 확인하고, 불필요한 것은 제거할 수 있습니다. /compact는 자리를 비우기 전에 실행하세요. 프롬프트 캐시는 한 시간이 지나면 만료되는데, 캐시가 살아 있는 동안 대화를 요약하면 훨씬 저렴합니다.
가치를 최대한 끌어내려면
얼마 전까지만 해도, 코드를 작성할 때 쓰는 도구는 정액제이거나 무료였습니다. 오후에 테스트를 하나 고치든 쉰 개를 고치든 편집기 비용은 똑같았고, 개별 작업에 따로 가격이 붙지 않았죠.
하지만 Claude Code 같은 에이전트 코딩 도구는 다릅니다. 같은 작업을 완료하더라도, 어떻게 사용하느냐에 따라 비용이 달라집니다.
어떤 세션에서는 Claude가 테스트 파일과 해당 파일이 다루는 소스 파일만 읽고, 몇 번의 턴 만에 수정을 마칩니다. 반면 다른 세션에서는 저장소 곳곳을 grep으로 뒤지고 열두 개의 파일을 거쳐서 결국 같은 두 파일에 도달하는데, 그 모든 턴마다 오늘 아침부터 대화에 쌓인 온갖 내용이 함께 딸려 갑니다.

수정 내용은 동일하지만, 소모한 토큰 수는 다릅니다. 그리고 그 내내 모델은 필요하지도 않은 열 개의 파일을 머릿속에 안고 생각해야 했습니다.
토큰을 효율적으로 쓴다는 건 토큰을 적게 쓴다는 뜻이 아닙니다. 사용하는 토큰이 실제로 요청한 작업에 쓰이도록 하는 것입니다.
그렇다면 토큰의 가격을 결정하는 요소는 무엇인지, 그리고 세션에서 토큰이 얼마나 전송되는지를 결정하는 요소는 무엇인지 살펴보겠습니다. 그 과정에서 세션을 어떻게 운영해야 하는지도 자연스럽게 드러납니다.
토큰 가격을 결정하는 요소
요금은 토큰 단위로 청구되지만, 실제로 비용을 결정하는 건 추론(inference)입니다. GPU(또는 TPU, 혹은 모델이 실행되는 어떤 장치든)가 토큰을 처리하는 데 걸리는 시간이죠.
토큰 하나를 처리하는 데 걸리는 시간은 세 가지 요소에 따라 달라집니다. 어떤 모델을 사용하는지, 입력 토큰(모델로 들어가는 것)인지 출력 토큰(모델에서 나오는 것)인지, 그리고 캐시 적중 여부입니다.
모델
모델이 클수록 입력과 출력 토큰 모두에 더 많은 연산을 수행합니다. 어떤 작업에 어떤 모델이 적합한지는 별도의 주제인데, Claude Code에서 Claude 모델과 노력 수준 선택하기에서 자세히 다루었습니다.
이 글에서 핵심은 하나입니다. 앞으로 다룰 모든 내용은 모델 가격에 곱해집니다. 문제가 진짜 어렵거나 모호할 때는 큰 모델을, 단순한 작업에는 작은 모델을 쓰세요.

입력 토큰과 출력 토큰
요청은 GPU에서 두 단계로 처리되며, 각 단계의 비용이 다릅니다.
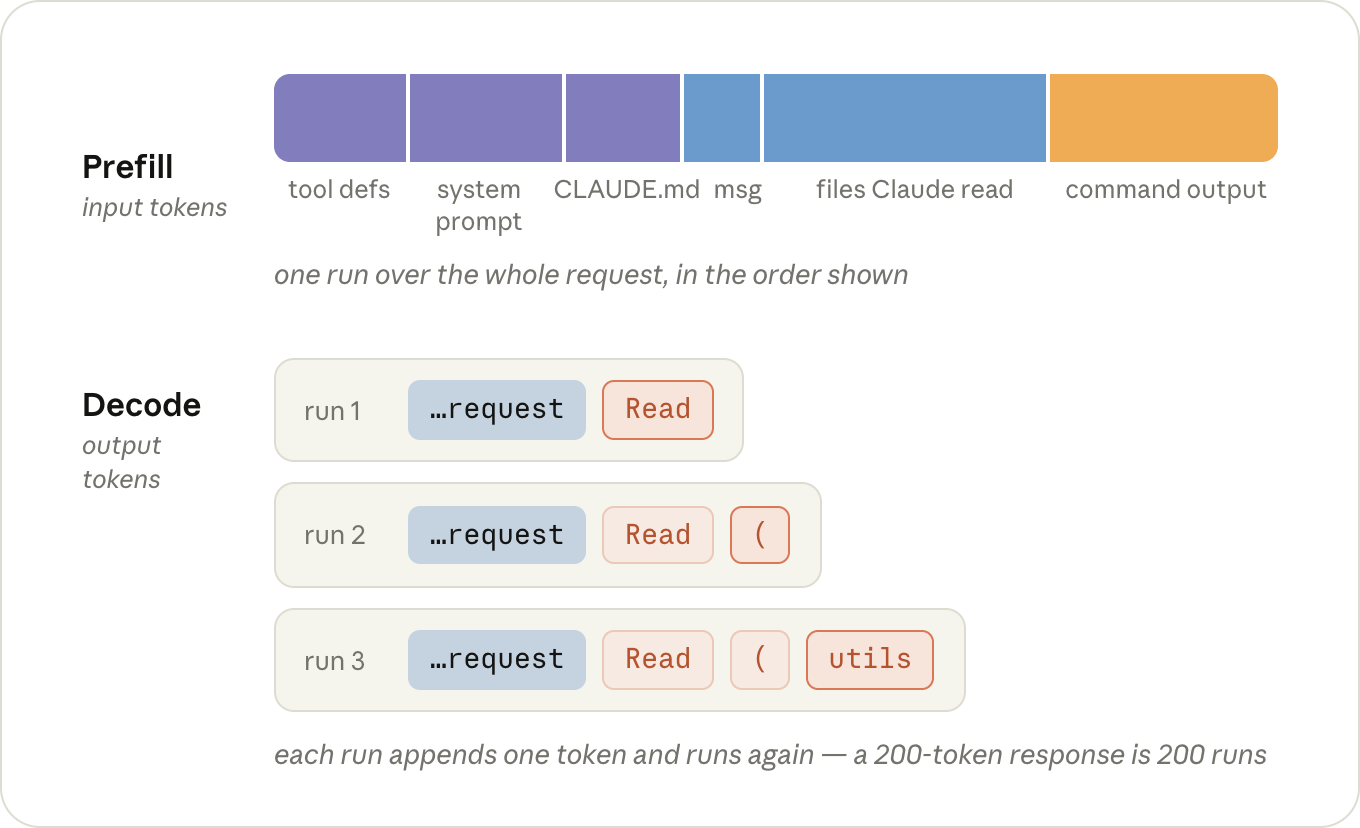
첫 번째 단계인 프리필(prefill)에서 모델은 요청과 컨텍스트를 읽습니다. 시스템 프롬프트, CLAUDE.md, 사용자 메시지, 그리고 그 이후 대화에 추가된 모든 것(Claude가 읽은 파일과 실행한 명령의 출력)이 여기에 해당합니다. 이것이 입력 토큰입니다.
두 번째 단계인 디코드(decode)에서 모델은 출력 토큰을 생성합니다. 생각(thinking), 툴 호출, 그리고 화면에 표시되는 텍스트가 여기에 해당합니다. 디코드는 토큰을 한 번에 하나씩 생성하며, 200토큰짜리 응답은 모델을 200번 순차적으로 실행하는 것과 같습니다. 디코드는 토큰당 GPU를 훨씬 오래 점유하기 때문에, 출력 가격이 입력의 약 5배로 책정됩니다.
세션에서 출력 토큰의 상당 부분은 사고(thinking) 토큰이며, 턴마다 모델이 얼마나 생각할지를 결정하는 것이 바로 노력 수준입니다. 모델 설정과 마찬가지로, /effort으로 설정한 수준은 다음 세션의 기본값으로도 유지됩니다.
팁: 새 세션에서/model과/effort을 한 번씩 실행해 현재 설정을 확인하세요. 두 설정 모두 마지막으로 선택한 값을 기억하므로, 의도적으로 선택한 것인지 확인할 필요가 있습니다.
팁: 단순 반복 작업이 예상되는 세션이라면MAX_THINKING_TOKENS=0를 사용하세요. 해당 세션 동안만 사고를 끄는 옵션으로(Haiku 5 제외),/effortlow보다 한 단계 더 낮은 수준입니다.
프롬프트 캐싱
새 요청의 시작 부분이 직전에 처리한 요청과 완전히 동일한 토큰으로 시작하면, 그 공통 부분의 상태가 같을 수밖에 없습니다. 그래서 서버는 이전에 계산한 상태를 보관해두고, 그 이후에 오는 새로운 부분만 프리필합니다. 이것이 프롬프트 캐싱입니다.
캐시에서 읽으면 입력 가격의 0.1배만 내면 됩니다. 연산 대신 저장된 상태를 불러오기 때문입니다. 캐시에 토큰을 쓰는 것은 일반 입력보다 최대 2배까지 비쌀 수 있는데, 이후 상태를 보관해야 하기 때문입니다. 하지만 쓰기는 토큰당 한 번만 발생하고, 이후 모든 턴에서 0.1배의 읽기 비용만 청구됩니다.
Claude Code는 매 요청마다 프롬프트 캐시를 자동으로 관리하므로 별도로 설정할 필요가 없습니다. 다만 캐시를 깨뜨릴 수 있는 상황이 있으므로, 불필요한 비용 급증을 피하는 방법을 알아두는 것이 중요합니다.
"utils.test.ts의 실패 테스트를 수정해줘"라고 입력했을 때 Claude Code가 실제로 어떤 요청을 보내는지 살펴보겠습니다.
- Claude Code는 시스템 프롬프트(툴 정의 포함),
CLAUDE.md, 사용자 메시지를 조합해 첫 번째 요청을 구성하고 전송합니다(입력 토큰). 아직 캐시에 아무것도 없으므로, 전체 내용이 프리필되어 캐시에 기록됩니다.
- 모델은 보지 않은 테스트를 수정할 수 없으므로, 잠시 생각한 뒤
utils.test.ts에 대한 Read 호출로 응답합니다(출력 토큰). Claude Code는 파일을 읽어 대화에 추가하고, 전체 내용을 다시 전송합니다(입력 토큰). 이번에는 첫 번째 요청의 모든 내용이 10분의 1 가격으로 캐시에서 읽히고, 새로 추가된 Read 호출과 파일 내용만 정가로 프리필됩니다.
- 이제 모델은 테스트 대상 파일이 필요합니다(출력). 또 다른 Read 호출이 발생하고 파일이 추가되어 모든 내용이 다시 전송됩니다. 1, 2번 요청은 캐시에서, 새 파일은 정가로 처리됩니다(입력).
- 모델이 Edit으로 응답합니다(출력). Claude Code가 수정을 적용하고 결과를 추가한 뒤 모든 내용을 다시 전송합니다. 패턴은 같습니다. Edit과 그 결과만 새로 처리되고, 그 앞의 모든 내용은 캐시에서 읽힙니다(입력).
- 모델이
npm test를 실행합니다(출력). Claude Code는 테스트 출력을 대화에 추가하고, 테스트 출력만 새로 포함한 전체 내용을 전송합니다(입력).
- 테스트가 통과되면 모델이 짧은 요약으로 응답합니다(출력). 툴 호출이 없으므로 추가할 내용도, 여섯 번째 요청도 없이 작업이 마무리됩니다.
작은 수정 하나에 요청이 다섯 번 발생했고, 매 요청마다 그 시점까지의 전체 대화가 포함되었습니다. 일반적인 턴은 비대칭적입니다. 수만 개의 토큰이 들어가고, 몇 백 개가 나옵니다. 하지만 해당 턴에서 새로 추가된 내용만 정가로 프리필됩니다.
턴당 청구 구조는 이렇습니다. 기존 대화는 캐시 읽기 가격으로, 새로 추가된 내용은 정상 입력 가격으로, 그리고 응답은 출력 가격으로 청구됩니다.
구독 플랜을 사용할 때도 마찬가지입니다. 가격이 직접 보이지 않을 뿐, 동일한 요청들이 사용 한도를 소비합니다.
캐시는 요청의 맨 처음부터 순서대로 일치해야 하며, 요청은 항상 같은 순서로 전송됩니다. 툴 정의, 시스템 프롬프트, 그리고 대화 내용 순서입니다(대화의 맨 앞에는 CLAUDE.md가 위치합니다).
이 앞부분에 변경이 생기면, 그 뒤의 모든 내용이 다시 프리필됩니다. 대화 끝에 툴 결과를 추가하는 것은 이상적인 경우인데, 뒤에 아무것도 없기 때문입니다. 캐시를 무효화하는 것은 요청의 앞부분을 바꾸거나, 캐시 키를 결정하는 요소를 바꾸는 모든 행위입니다.
/model: 모델마다 캐시가 별도로 존재하므로, 다음 턴에서 전체 대화가 다시 정가로 프리필됩니다. (계획 모드를 들어가고 나올 때마다 모델이 전환되는 opusplan도 여기에 해당합니다.)/effort:도 마찬가지입니다. 노력 수준도 캐시 키의 일부이기 때문입니다. 그래서/model과/effort은 대화 중간에 전환할 때 확인을 요청합니다.- 빠른 모드: 역시 캐시 키의 일부이며, 재프리필은 빠른 모드 가격으로 진행됩니다. 사용할 계획이라면 세션 시작 시 켜두세요. (끄는 것은 캐시 측면에서 비용이 없습니다.)
/compact: 대화가 더 짧은 내용으로 교체되므로 기존 내용은 더 이상 일치하지 않습니다(앞의 시스템 프롬프트는 유지됩니다). 요약 자체는 기존 대화가 캐시에 남아 있는 동안 실행하면 저렴하므로, 오랜 자리 비움 이후보다 이전에 실행하는 것이 훨씬 유리합니다.- 시간: 매 턴마다 타이머가 초기화되지만, 캐시는 구독 플랜에서는 한 시간, API 키에서는 5분 후에 만료됩니다(
ENABLE_PROMPT_CACHING_1H=1을 사용하면 한 시간으로 늘어납니다). 그 이상 지나면 다음 턴에서 전체 대화가 다시 프리필됩니다. 오래된 세션을 재개할 때도 거의 항상 마찬가지입니다. 그 시점에는 캐시가 대부분 만료되어 있고, 어차피 시스템 프롬프트는 실행 시점에 새로 구성됩니다.
이런 이유로 모델이나 노력 수준을 절대 바꾸지 말라는 것이 아닙니다. 비용이 적게 드는 타이밍이 있다는 뜻입니다. 세션 시작이나 /clear 직후가 좋은 시점이고, 긴 대화 중간은 비용이 많이 드는 시점입니다.
팁: 최근 몇 턴이 원하지 않는 방향으로 흘렀다면,/rewind으로 되돌리세요./compact를 실행하는 것보다 훨씬 저렴합니다. 되감기는 해당 턴들만 끝에서 잘라내므로, 그 앞의 내용은 여전히 캐시에 남아 있어 비용이 들지 않습니다. compact는 전체 대화를 새로 작성하므로 항상 비용이 발생합니다.
세션에서 전송되는 토큰 수를 결정하는 요소
여기서 가장 중요한 것은, 어떤 내용도 한 번만 전송되지 않는다는 점입니다. 대화에 추가된 모든 것, Claude가 읽은 파일이든 실행한 명령의 출력이든, 이후 모든 턴에서 세션이 끝날 때까지 계속 함께 전송됩니다.
캐시 덕분에 재전송 비용은 저렴하지만, 저렴하다고 공짜는 아닙니다. 게다가 모든 턴마다 모델이 그 내용을 컨텍스트로 안고 생각해야 하므로 공간도 차지합니다.
세션의 비용 구조는 결국 이것으로 귀결됩니다. 컨텍스트에 얼마나 많은 토큰이 쌓이는지, 그 토큰들이 몇 턴 동안 남아 있는지, 그리고 동시에 몇 개의 컨텍스트를 운영하는지입니다.
컨텍스트에 쌓이는 것들
컨텍스트의 일부는 아무것도 입력하기 전부터 이미 들어 있습니다. 툴 정의, 시스템 프롬프트, CLAUDE.md, 그리고 시작 시 로드되는 기타 항목들입니다.
팁: 새 세션에서/context을 실행하면, 아무것도 입력하기 전에 컨텍스트에 무엇이 들어 있는지 확인할 수 있습니다.CLAUDE.md은 핵심 지침만 담아두고, 작업별 지침은 스킬(skill)로 옮기세요. 스킬은 실제 사용될 때만 로드됩니다. 해당 세션에서 필요하지 않은 MCP 서버는/mcp로 꺼두세요.
세션 중에 추가되는 거의 모든 내용은 툴 결과입니다. Claude가 읽은 파일과 실행한 명령의 출력이 여기에 해당합니다.
Claude가 얼마나 많이 읽는지는 대체로 스스로 얼마나 많이 파악해야 하는지에 달려 있습니다. "테스트가 실패하고 있어"라고 말하면, 먼저 어떤 테스트인지 찾아야 합니다. grep을 몇 번 돌리고, 관련 파일을 열어 확인하는 과정이 생기는데, 이 모든 결과가 더 이상 유용하지 않게 된 후에도 컨텍스트에 계속 남아 있습니다.
"utils.test.ts의 실패 테스트를 수정해줘"라고 하면 검색 과정이 생략되고 파일 Read 호출 한 번으로 끝납니다. "@utils.test.ts의 실패 테스트를 수정해줘"라고 하면 Read 호출마저 필요 없습니다.
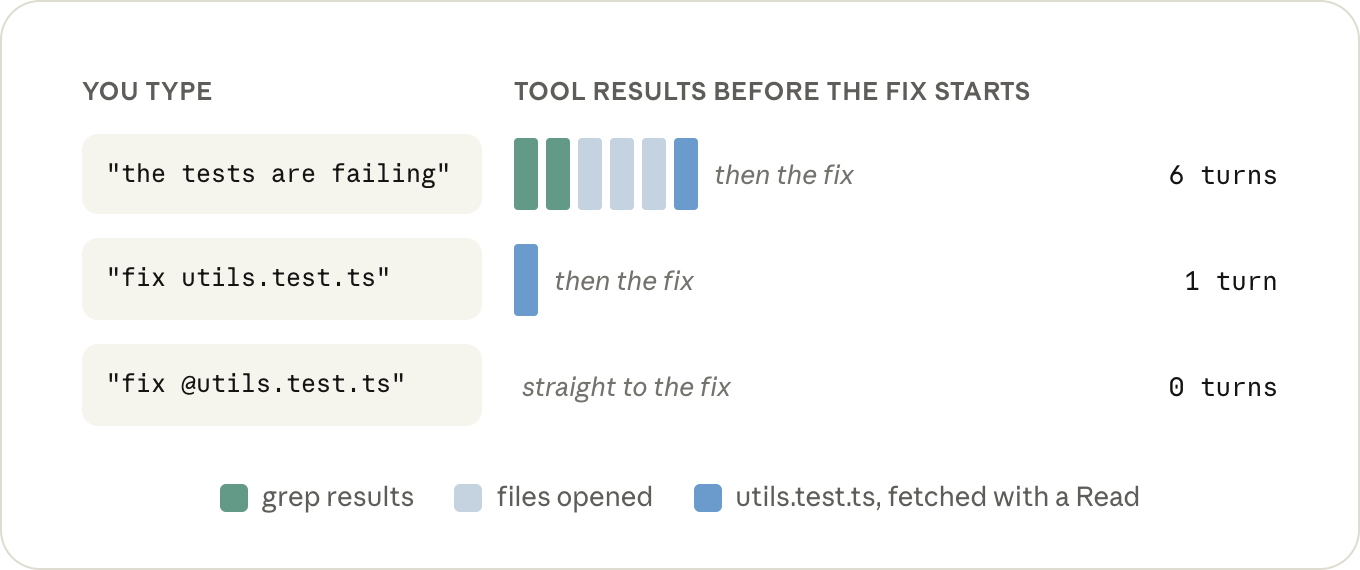
팁: 파일을 언급할 때는 경로를 직접 입력하는 대신 @-멘션을 사용하세요. Claude Code가 전송 전에 파일을 메시지에 첨부하므로 첫 번째 요청부터 포함되며, Read 호출이 발생하지 않습니다. 파일 자체가 차지하는 컨텍스트 공간은 어느 쪽이든 같으므로, 대화 중에 한 번만 언급하면 됩니다. 파일은 컨텍스트에 남아 있으며, 이후 턴에서 다시 @-멘션하면 일반적으로 두 번째 복사본이 첨부됩니다.
컨텍스트를 채우는 또 다른 요소는 Claude가 실행하는 명령의 출력입니다. 테스트, 빌드, git log를 실행할 때마다 그 출력이 파일 내용과 마찬가지로 대화에 추가되고, 같은 방식으로 계속 남아 있습니다.
출력이 매우 큰 경우는 사실 문제가 없습니다. 30,000자를 넘으면 Claude Code가 출력을 파일로 저장하고, 대화에는 짧은 미리보기와 경로만 넣습니다(변경하려면 BASH_MAX_OUTPUT_LENGTH을 사용하세요).
문제는 그 기준 이하의 출력입니다. 400개의 통과 테스트를 한 줄씩 출력하는 테스트 러너는 한도 안에 들어오고, 그 400줄이 이후 모든 턴의 일부가 됩니다.
Claude가 플래그나 tail로 알아서 처리하는 경우도 많습니다. 직접 제어하고 싶다면, 문서에 소개된 작은 훅을 활용해 실행 전에 출력이 많은 명령을 자동으로 재작성하여 필요한 줄만 돌아오게 할 수 있습니다.
팁: 하루에 자주 쓰는 명령 두세 개를 quiet 플래그까지 포함해CLAUDE.md에 적어두세요. 직접 입력하는 방식 그대로요("npx vitest run <file> --reporter=dot"으로 단일 테스트 파일 실행"). 작은 설정이지만, 이후 매 세션마다 턴 하나와 수백 줄의 출력을 아낄 수 있습니다.
내용이 얼마나 오래 남아 있는지
하나의 긴 세션은 같은 작업을 여러 짧은 세션으로 나누는 것보다 비용이 더 많이 듭니다. 생각보다 훨씬 많이요. 40번째 턴은 앞의 39번 턴을 모두 다시 읽기 때문입니다. 세션의 컨텍스트는 짧고 관련성 있게 유지해야 합니다. 새 작업을 시작할 때는 /clear 을 실행하고, 같은 작업의 앞부분이 마무리됐을 때는 /compact를 실행하세요.
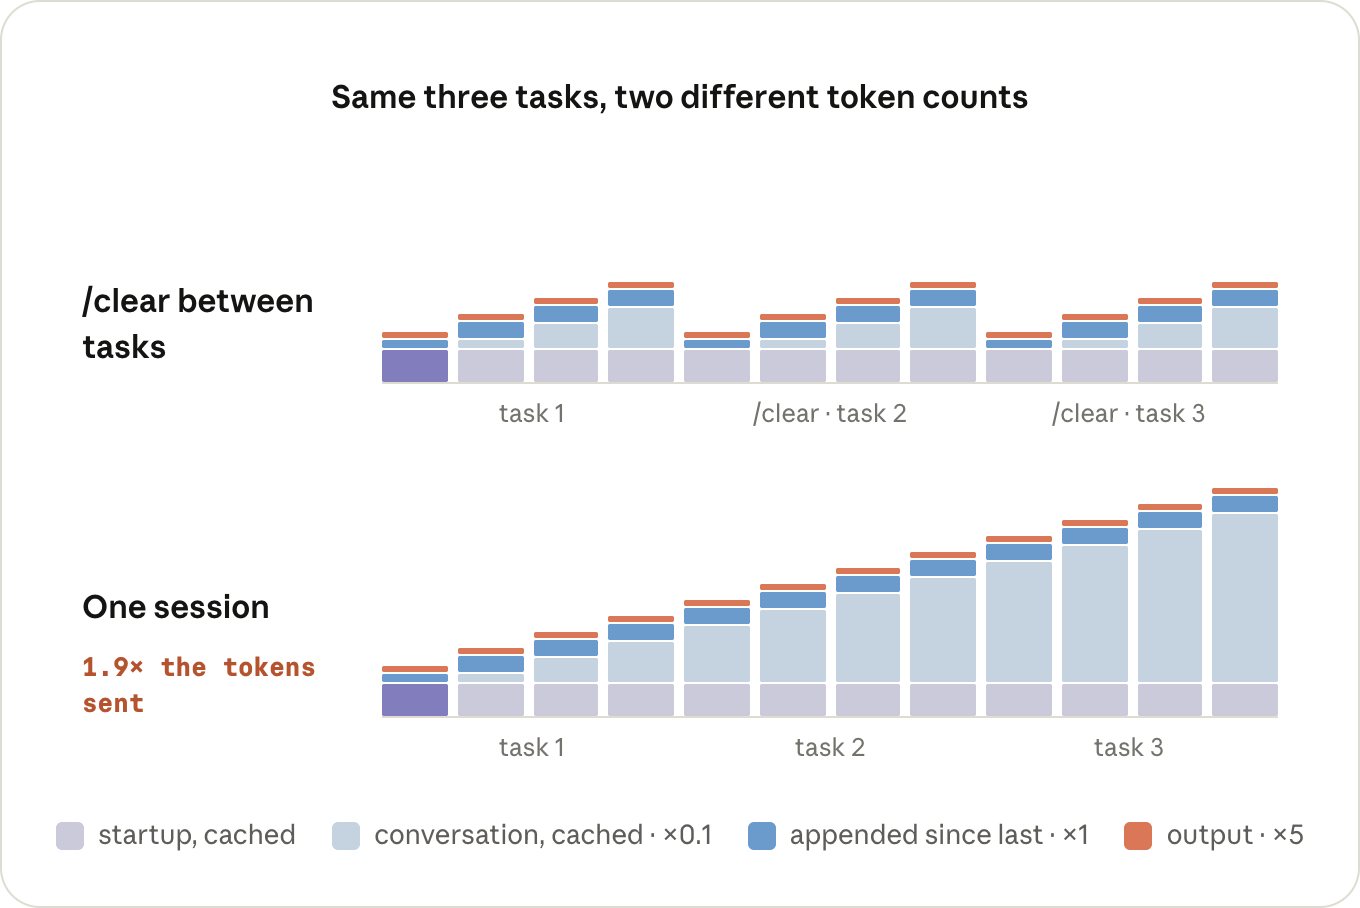
팁: 나중에 세션을 다시 사용할 것 같다면/rename전에/clear을 실행하세요./compact할 때는 무엇을 유지할지 지정하거나, 항상 같은 내용이라면CLAUDE.md에 "Compact instructions" 섹션을 추가해두세요. 1M 모델 사용 시 이전처럼 자동 compact 안전망을 원한다면,/autocompact 200k으로 복원할 수 있습니다(Claude Code v2.1.221 이상 필요).
직접 입력하지 않는 동안 발생하는 턴도 주의해야 합니다. /loop은 설정한 세션에서 완전한 턴으로 실행되며, 실행할 때마다 그 전체 대화를 함께 끌고 갑니다. 마지막 턴으로부터 한 시간이 넘었다면 캐시 미스까지 발생합니다. 다른 터미널에서 새 세션을 열고, 거기서 루프를 실행하세요.
서브에이전트
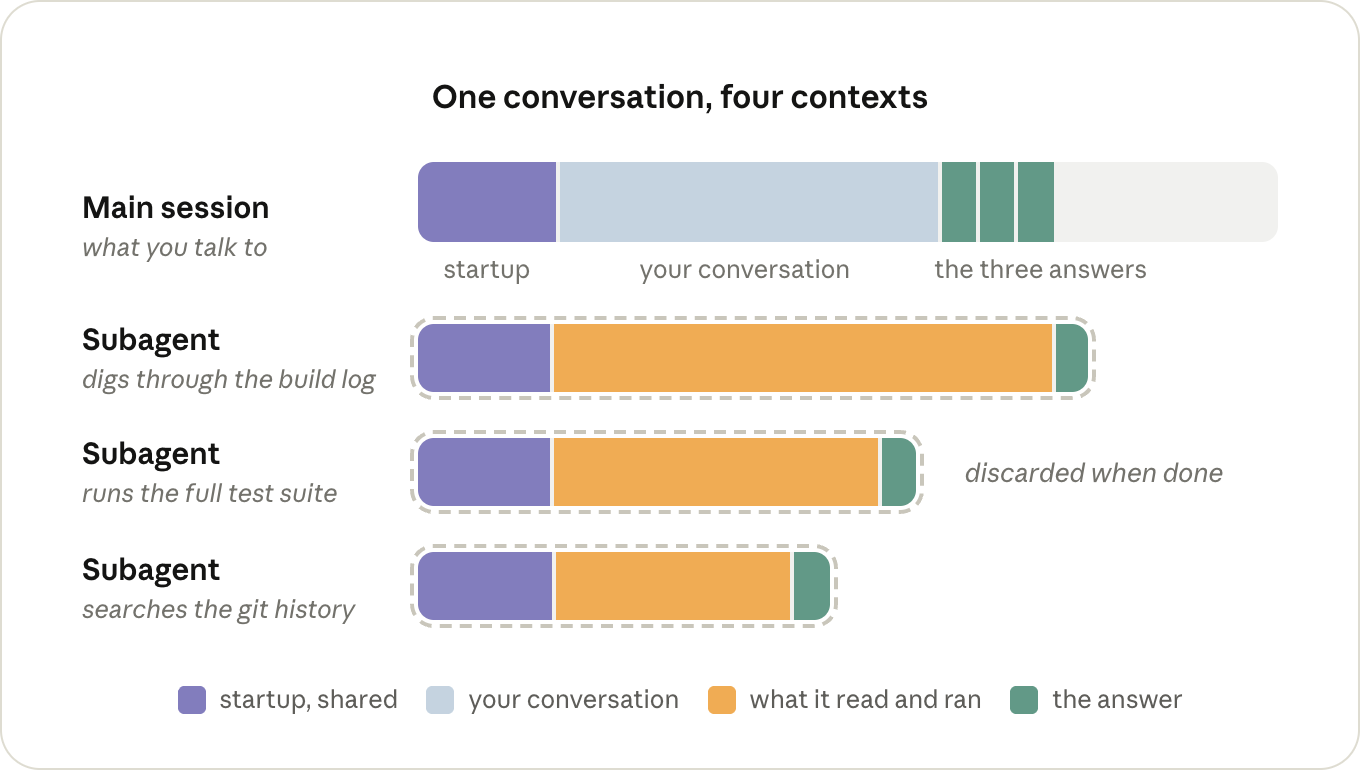
컨텍스트에서 무언가를 제외하는 또 다른 방법은 아예 다른 컨텍스트에서 처리하게 하는 것인데, 이것이 서브에이전트의 역할입니다. 서브에이전트는 독립된 컨텍스트 창을 가지며, 자체 시스템 프롬프트, 툴, CLAUDE.md가 포함되지만 현재 대화는 포함되지 않습니다. 서브에이전트는 자체적으로 턴을 실행하고, 메인 세션으로 돌아오는 것은 최종 답변뿐입니다. 나머지는 모두 작업 완료 후 폐기됩니다.
대화를 공유하지 않는 단점으로, 서브에이전트가 메인 세션에서 이미 읽은 내용을 다시 읽어야 할 때가 있으며, 그 동안의 턴 비용도 따로 발생합니다. 작은 작업에는 그냥 오버헤드입니다.
로그를 훑는 것처럼 결과물이 많지만 굳이 보존할 필요가 없는 작업에서는 서브에이전트가 효율적입니다. Claude가 그런 작업에 스스로 서브에이전트를 쓰는 경우도 많고, 그렇지 않을 때는 직접 요청할 수 있습니다("이 로그를 서브에이전트에서 처리해줘"). 다만 메인 세션에 돌아오는 것은 서브에이전트가 보고하기로 선택한 내용뿐임을 기억하세요.
팁: 반복적으로 위임하는 작업이 있다면, model: haiku(또는 sonnet)를 지정한 서브에이전트 정의를 따로 만들어두세요. 그렇지 않으면 메인 세션에서 사용 중인 모델로 실행됩니다.
먼저 살펴볼 것들
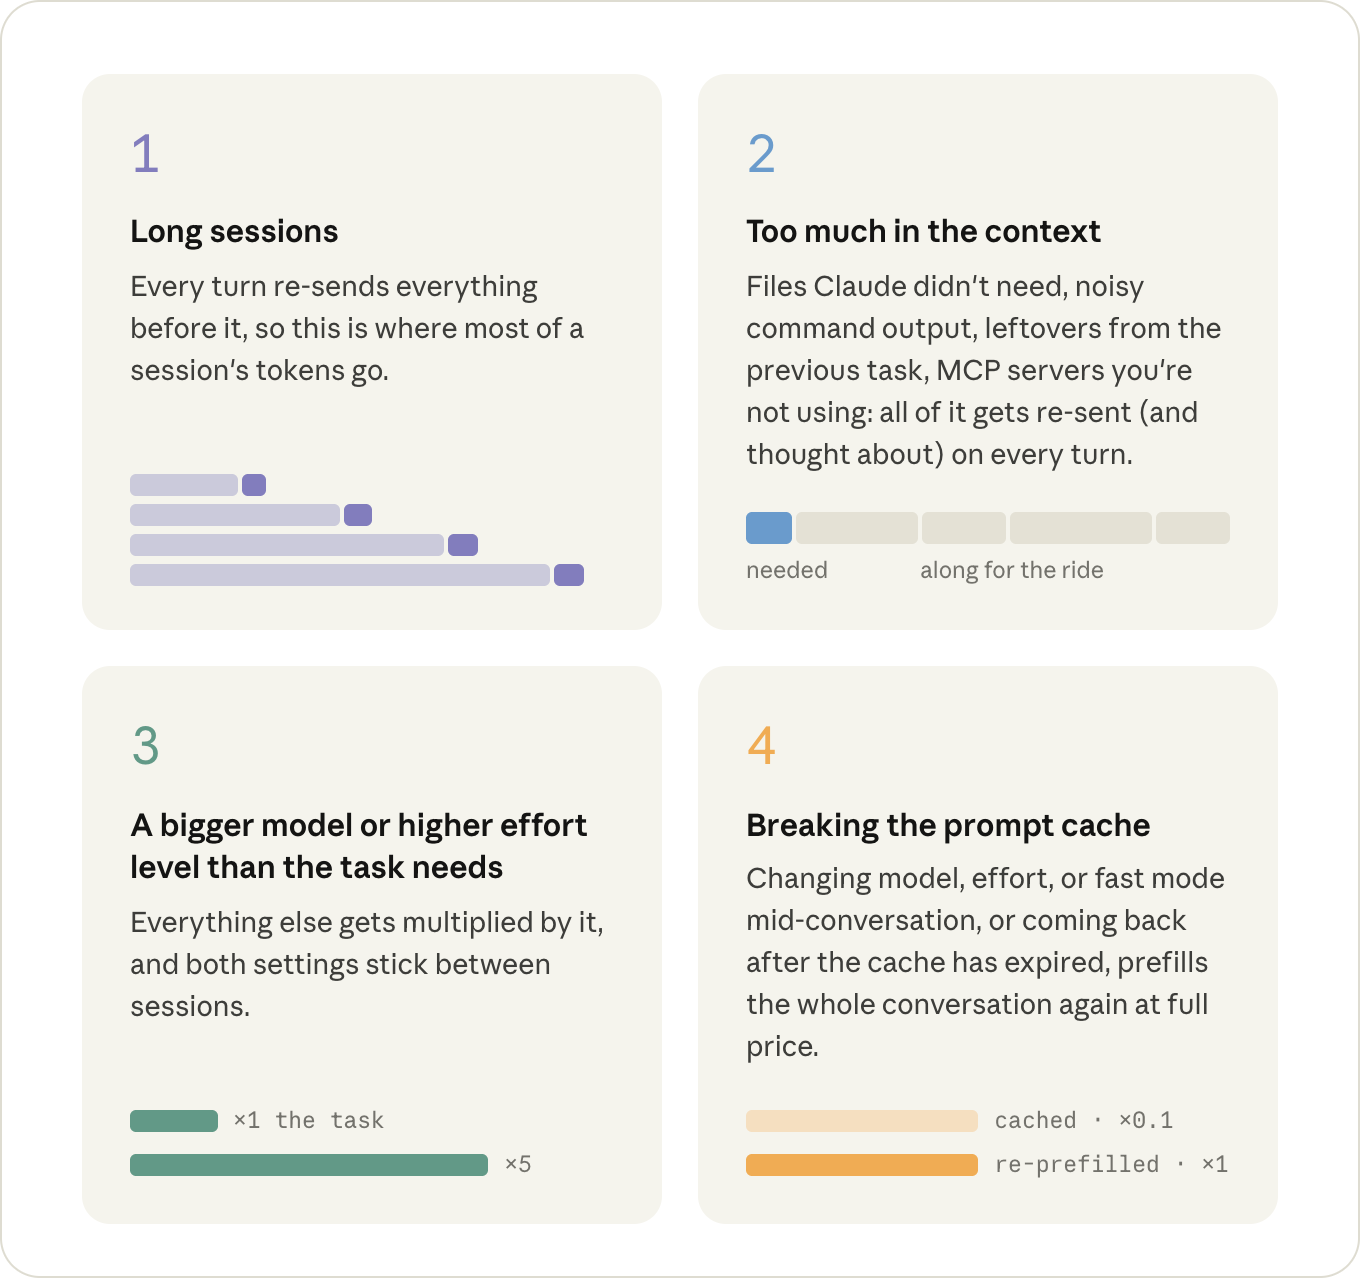
위에서 다룬 내용 중, 비용에 미치는 영향이 큰 순서대로 주목할 만한 네 가지를 정리합니다.