Vercel기술 블로그engineering
evals가 대체 뭘까? 에이전트와 에이전트가 쓰는 소프트웨어를 테스트하는 방법
에이전트가 사용하는 소프트웨어를 테스트하는 방법을 다룹니다. 에이전틱 테스트 피라미드의 구조, pass@k와 pass^k 중 어떤 지표를 선택할지, 그리고 Vercel Sandbox와 AI Gateway 위에서 Harbor로 엔드투엔드 평가를 구축하는 과정을 소개합니다.
이제 에이전트도 소프트웨어의 사용자입니다. 사람을 대신해 일을 처리하죠. 에이전트를 만드는 쪽이든, 에이전트가 쓰는 소프트웨어(API, CLI, MCP server, SDK)를 만드는 쪽이든, 평가(eval)를 활용하면 그 일을 얼마나 잘 해내는지 측정할 수 있습니다.
에이전트는 여러분의 출시 영상이나 101번 고속도로의 옥외 광고를 못 봤을 수도 있습니다. 그래도 제품을 찾고 사용하기까지 사람과 같은 퍼널을 거칩니다. 발견(Discovery), 선택(Selection), 접근(Access), 성공(Success)의 네 단계입니다.
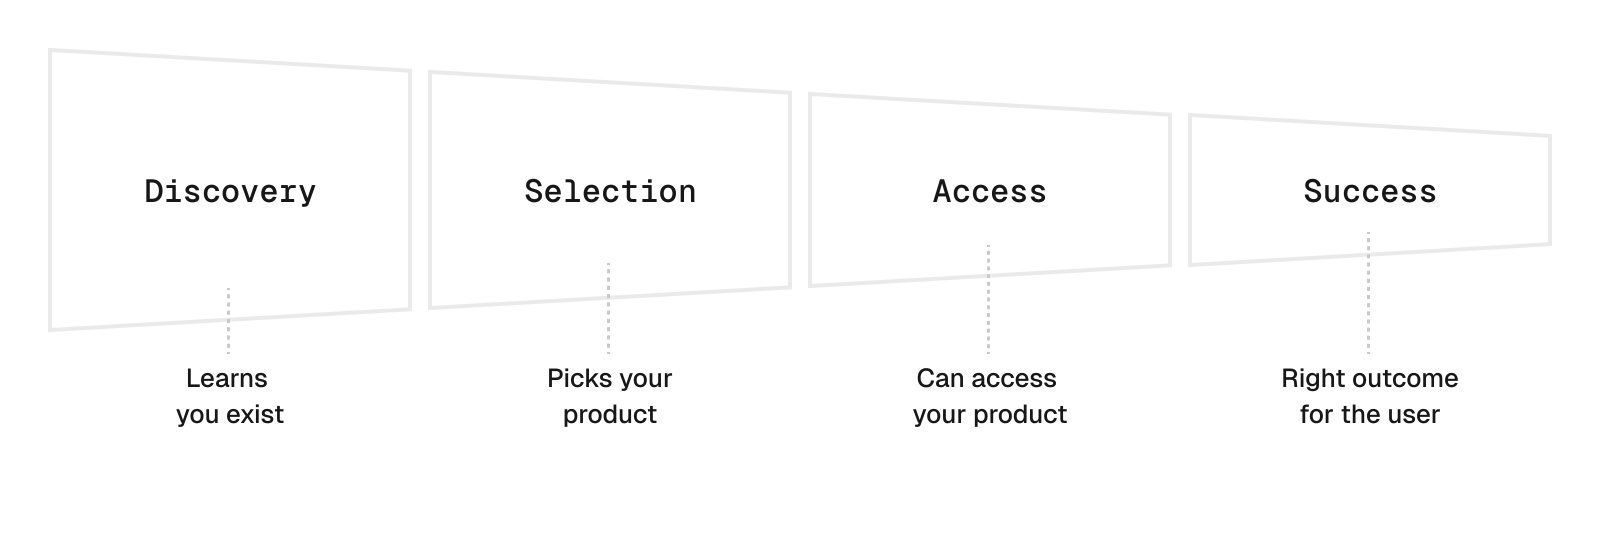
이 퍼널의 어느 단계에 대해서든 평가를 만들 수 있습니다. 이 글에서는 마지막 단계인 성공, 즉 에이전트가 사용자의 작업을 제대로 완수했는지에 집중합니다.
말처럼 확인하기 쉬운 일이 아닙니다. 사용자는 아이스 라테를 요청했는데, 에이전트가 따뜻한 라테를 "성공적으로" 주문할 수도 있습니다. 요청 자체는 정상 처리됐으니 Observability 스택의 로그에도 이상이 없어 보이죠. 게다가 LLM 출력은 실행할 때마다 달라지므로, 수동 테스트에서 한 번 잘 됐다고 해서 수정이 효과가 있었는지 알 수는 없습니다. 같은 작업을 반복 실행하고, 변경 전후의 결과를 각각 채점해야 합니다.
평가가 바로 그 역할을 합니다. 이제 평가를 만드는 방법을 소개합니다.
에이전틱 테스트 피라미드
테스트가 "동작하는가?"를 묻는다면, 평가는 "얼마나 자주, 얼마나 잘 동작하는가?"를 묻습니다. 에이전트에게 작업을 주고, 결과를 채점하고, 여러 번 시도한 결과를 종합합니다.
에이전트 소프트웨어 테스트는 보통 필요한 LLM 호출 횟수에 따라 나눕니다. 결정론적 테스트(0회), 원턴 평가(1회), E2E 평가(작업 전체에 걸쳐 2회 이상)입니다. 이 기준은 테스트를 만드는 데 드는 노력, 실행 시간, 실행 비용을 가늠하는 지표로도 잘 맞아떨어졌습니다. 실용적인 테스트 피라미드와 마찬가지로, 테스트 스위트의 대부분은 저렴하고 빠른 테스트로 채워야 합니다.
피라미드를 활용하려면, 잡아내고 싶은 문제에서 출발해 그 문제를 잡을 수 있는 가장 낮은 단계를 고르세요. 성공을 확인하려면 맨 위 단계가 필요합니다. 원턴 평가는 에이전트가 가장 먼저 실행할 명령처럼 하나의 결정만 확인합니다. 하지만 성공은 전체 단계의 흐름(예: 카페 검색 → 사용자 조건으로 필터링 → 라테 주문)에 달려 있습니다. 각 단계가 따로 보면 합리적이어도 최종 결과는 틀릴 수 있습니다.
E2E 평가에서는 에이전트가 환경 안에서 작업 전체를 수행하게 한 뒤, 최종 결과가 사용자의 요구사항을 충족하는지 확인합니다. 이미 여러 번 접해 보셨을 겁니다. SWE-bench나 Terminal-Bench 같은 유명 코딩 벤치마크 대부분이 E2E 평가입니다.
예시
샌프란시스코에서 커피를 주문하는 API인 SF Beans를 운영한다고 해봅시다. 에이전트가 서비스를 이용하게 하는 가장 좋은 방법 중 하나는 CLI이므로, sfbeans를 출시하려 합니다.
고객이 보낼 법한 전형적인 요청은 다음과 같습니다.
전지우유를 넣은 라지 사이즈 아이스 라테를 9시까지 픽업할 수 있게 주문해 줘. 팁 포함 8달러 이하로. 나는 미션 지구에 있어.
오전 8시 30분 현재 sfbeans가 알고 있는 정보는 다음과 같습니다.
Fog City Roasters: 제빙기가 고장 나서 오늘은 아이스 음료를 팔지 않음 (온도)
24th St Beans: 메뉴상 라테는 7.50달러지만 세금과 팁을 더하면 9.27달러 (예산)
Dolores Drip: 라테는 5.50달러지만 가장 빠른 픽업이 9시 20분 (시간)
Valencia Grind: 세금과 팁 포함 7.42달러, 8시 50분에 준비 완료 (세 조건 모두 충족)
sfbeans에 대해 피라미드의 각 층에서 테스트할 수 있는 내용은 다음과 같습니다.
층 | 답하는 질문 |
|
|---|---|---|
결정론적 테스트 | 소프트웨어가 기대한 대로 동작하는가? | • |
원턴 평가 | 에이전트가 알맞은 명령을 고르고 올바른 인자를 만들어 내는가? | • 첫 번째 명령이 |
E2E 평가 | 에이전트가 작업을 올바르게 완수하는가? | 전지우유를 넣은 라지 아이스 라테를 9시까지 준비되고 팁 포함 8달러 미만인 조건으로, 정확히 한 건만 주문하는가? |
엔드투엔드 평가를 만드는 방법
커피 평가는 Harbor로 만들겠습니다. Harbor는 Terminal-Bench를 만든 팀이 공개한 오픈소스 프레임워크로, 컨테이너에서 에이전트를 실행하고 결과를 검증하며 에이전트의 행동을 기록합니다.
이 글에서 사용할 용어는 다음과 같습니다.
태스크(Task): 에이전트가 풀어야 할 문제 하나. 시작 환경과 성공 여부를 확인하는 방법이 함께 정의됩니다
배리언트(Variant): 테스트하려는 에이전트 구성. 모델, 프롬프트, 도구, 메모리, 스킬 등이 해당합니다
트라이얼(Trial): 한 배리언트가 한 태스크를 한 번 시도하는 것
런(Run)(Harbor에서는 job): 모든 배리언트가 모든 태스크를 각각 여러 번 시도하는 전체 실행
트레이스(Trace)(Harbor에서는 trajectory): 트라이얼 동안 기록된 모든 것. 메시지, 도구 호출, 로그, 파일, 최종 출력이 포함됩니다
1단계: 목표 정하기
모든 것을 E2E 평가로 만드는 것은 현실적이지 않습니다. 전통적인 소프트웨어에서는 테스트 커버리지 100%를 목표로 삼을 수 있습니다. 하지만 에이전트는 LLM이 제품으로 할 수 있는 모든 행동을 다뤄야 하고, 그 범위가 어디까지인지 파악하는 것부터 어렵습니다(들쭉날쭉한 경계(jagged frontier) 참고).
사용자가 중요하게 여기는 결과 하나를 골라 시작하세요. 몇 개의 태스크만으로 평가할 수 있을 만큼 범위가 좁아야 합니다. 이런 목표는 보통 다음 세 곳 중 하나에서 찾을 수 있습니다.
Observability: 어떤 에이전트가 제품을 사용하고, 어디서 실패하는가
고객: 지원 티켓, 피드백, 이탈
로드맵: 가장 시급하게 검증해야 할 제품 가설
예를 들어 목표는 다음과 같을 수 있습니다.
특정 태스크의 성공률 높이기
목표 달성에 필요한 단계 수 줄이기
에이전트 스킬이 도움이 되는지 확인하고, 피드백을 받아 스킬 개선하기
프롬프트 A/B 테스트
현재 LLM으로 어떤 유스케이스가 가능한지 확인하고, 실패한다면 그 이유를 밝히면서 한계 영역 탐색하기
예시
sfbeans에 대해 이 세 곳을 모두 살펴봤습니다.
Observability: 에이전트 트래픽 대부분이 Claude Code와 Codex에서 나옵니다.
sfbeans이 특정 코딩 하네스를 감지하면 user-agent 헤더를 추가하기 때문에 알 수 있습니다.고객: 지원 티켓 1위는 "내 에이전트가 엉뚱한 음료를 주문했다"입니다. 아이스 대신 따뜻한 라테를 주문했거나, 사용자의 미팅이 끝난 뒤로 픽업 시간을 잡았거나, 세금과 팁을 더하니 총액이 예산을 넘은 경우입니다.
로드맵: 급한 항목이 없으므로, 이탈로 이어지는 엉뚱한 음료 주문 문제부터 해결합니다.
이렇게 정한 목표는 다음과 같습니다.
목표 | 사용자가 요청한 음료를 정확히 주문하는 성공률 높이기 |
|---|---|
에이전트 | 트래픽이 나오는 Claude Code와 Codex. |
범위 내 | 현재의 |
범위 외 | 취소, 환불, 계정. 이 항목들은 나중에 평가합니다. |
완료 기준 | 두 에이전트 모두 대부분이 아니라 모든 트라이얼에서 주문을 정확히 처리한다. |
2단계: 지표 정의하기
E2E 에이전트 평가에서 가장 자주 쓰는 지표는 다음과 같습니다.
성공
성공률: 통과한 트라이얼의 비율
Pass@k: k번의 트라이얼 중 하나 이상 통과할 확률. "에이전트가 이 일을 할 수는 있는가?"에 답합니다
Pass^k: k번의 트라이얼이 모두 통과할 확률. "매번 믿고 맡길 수 있는가?"에 답합니다
효율성(성공한 트라이얼만 대상으로 측정)
단계 수: 작업을 완료하는 데 필요한 에이전트 턴 수
시간: 트라이얼에 걸린 시간
비용: 트라이얼에 든 비용(달러)
예시
우리의 목표는 모든 트라이얼에서 모든 주문을 정확히 처리하는 것입니다. 3단계와 4단계에서 평가를 만들어 실행하고 나면, 아이스 라테 주문에 대한 Claude Code + Opus 5.5(anthropic/claude-opus-5.5, AI Gateway 경유)의 5회 트라이얼 결과는 다음과 같을 수 있습니다.
트라이얼 | 결과 | 진행 내용 | 단계 수 | 시간 | 비용 |
|---|---|---|---|---|---|
1 | 통과 | 카페 3곳의 견적을 비교한 뒤 Valencia에서 주문 | 9 | 3:40 | $0.52 |
2 | 실패: 예산 초과 | 견적 확인을 건너뛰고 24th St에서 주문: $9.27 | 5 | 1:50 | $0.31 |
3 | 통과 | 카페 4곳의 견적을 비교한 뒤 Valencia에서 주문 | 11 | 4:30 | $0.68 |
4 | 실패: 늦음 | Dolores에서 주문, 9시 20분 준비 | 6 | 2:10 | $0.35 |
5 | 통과 | Fog City는 건너뛰고 Valencia에서 주문 | 8 | 3:20 | $0.49 |
각 수치의 의미는 다음과 같습니다.
성공률: 5회 중 3회 통과, 따라서 60%.
Pass@5: 트라이얼이 서로 독립이고 성공률이 60%라고 가정하면 1 − 0.4^5 ≈ 99%. 5번 기회를 주면 한 번은 거의 확실히 맞힌다는 뜻입니다.
Pass^5: 0.6^5 ≈ 8%. 에이전트가 5번 연속으로 주문을 맞힐 확률입니다.
단계 수: 성공한 트라이얼 기준 (9 + 11 + 8) / 3 ≈ 9. 실패한 트라이얼이 더 짧은 이유는 에이전트가 견적 확인 같은 작업을 건너뛰었기 때문입니다. 그래서 효율성은 성공한 트라이얼만 집계합니다.
시간: 성공한 트라이얼 기준 약 3:50.
비용: 성공한 트라이얼당 $0.56이지만, 비용을 낸 실패 트라이얼까지 포함하면 성공 1건당 $2.35 / 3 = $0.78입니다.
그렇다면 Opus는 잘 작동하는 걸까요? 99%인 pass@5만 보면 그렇다고 할 수 있습니다. 하지만 8%인 pass^5는 이 주문을 평일마다 하는 사용자가 92%의 주당 적어도 한 번은 잘못된 커피를 받는다는 뜻입니다. 두 숫자 모두 맞습니다. 다만 답하는 질문이 다릅니다. pass@5는 에이전트가 주문을 맞힐 수 있는가를 묻고, pass^5는 매번 맞히는가를 묻습니다.
어떤 지표가 가장 중요한지는 실패했을 때 사용자가 치르는 비용에 달려 있습니다. 아침 커피를 주문하는 사람에게는 재시도 기회가 없습니다. 에이전트가 따뜻한 라테를 주문하거나, 기차가 떠난 뒤에야 준비되는 커피를 주문하면 사용자는 엉뚱한 커피값을 내고 짜증으로 하루를 시작하게 됩니다. 매일 아침 정확해야 하므로 sfbeans는 pass^5를 기준으로 최적화합니다.
반면 시도 한 번의 실패가 저렴하고, 문제가 되기 전에 걸러지는 제품은 더 너그럽게 볼 수 있습니다.
제품 | 시도 실패 시 사용자가 치르는 비용 | 우선할 지표 |
|---|---|---|
아침 커피 주문 대행 | 엉뚱한 음료 결제, 지각, 신뢰 상실 | Pass^k |
테스트 스위트가 있는 코딩 에이전트 | 시간과 모델 비용이 추가로 듦. 에이전트가 테스트 피드백으로 코드를 고쳐 다시 시도함 | Pass@k |
사용자가 검토하는 이메일 초안 작성 | 전송 전에 간단히 수정 | 성공률 |
전체 평균은 자주 실패하는 태스크를 가릴 수 있으므로, 결과는 항상 태스크별로 확인하세요. 또한 트라이얼이 5번뿐이라면 100%는 "아직 실패를 보지 못했다"는 뜻이지 "절대 실패하지 않는다"는 뜻이 아닙니다.
3단계: 태스크 세트 설계하기
1단계에서 평가의 목표로 에이전트가 사용자가 요청한 음료를 정확히 주문하는 빈도를 높이는 것으로 정했습니다. 하지만 에이전트는 목표를 그대로 수행할 수 없습니다. 실제 사용자가 요청하는 내용에서 뽑아낸 구체적인 요청, 즉 태스크가 필요합니다.
실행해서 배울 것이 있을 만큼 충분히 어려운 태스크를 고르세요. 좋은 세트는 일반적인 경우, 에이전트가 자주 걸려 넘어지는 엣지 케이스, 그리고 행동하지 않는 것이 올바른 대응인 요청을 최소 하나 포함합니다.
각 태스크마다 다음 요소를 정의합니다.
지시문: 사용자의 요청
환경: 에이전트가 작업하는 공간. 모든 트라이얼이 같은 초기 상태에서 시작합니다
검증기(verifier): 최종 상태를 확인하는 장치. 가능하면 제약 조건별로 점수를 매깁니다
검증된 정답 풀이(선택): 기대하는 동작을 보여 주고 검증기를 통과하는 참조용 실행
환경의 각 측면은 목표에 따라 필요한 만큼 가짜로 만들 수도, 현실적으로 만들 수도 있습니다. OpenPipe 팀이 이메일 리서치 에이전트의 환경을 어떻게 정의했는지 잘 정리한 글이 있습니다.
예시
tasks/ 안에 Harbor 태스크 폴더로 태스크 네 개를 작성했습니다.
일반적인 경우: 앞에서 본 주문인
iced-latte-mission엣지 케이스: 사용자가 즐겨 가는 카페에 원하는 음료가 없는
usual-unavailable엣지 케이스: 음료 6잔, 총액 45달러, 픽업 장소 하나인
team-order행동하지 않아야 하는 경우:
impossible-request. 조건에 맞는 곳이 없으므로 사용자에게 알리는 것이 올바른 대응입니다
impossible-request에는 검사가 하나 더 있습니다. 이 태스크의 검증기는 에이전트가 쓸 수 없는 명령 로그를 읽어, 에이전트가 포기하기 전에 검색을 했는지 확인합니다. 이 검사가 필요하다는 것은 직접 겪고서야 알았습니다(5단계 참고).
iced-latte-mission는 다음과 같습니다.
├── instruction.md        # the initial user prompt
├── task.toml             # task config: timeouts, verifier, artifacts
├── environment/          # Docker build context
│   ├── Dockerfile        # sfbeans + seeded cafes, clock frozen at 8:30am
│   ├── sfbeans           # the CLI under test
│   └── cafes.json        # seeded cafes, menus and pickup times
├── solution/
│   └── solve.sh          # a known-good answer, proves the task is solvable
└── tests/
    ├── test.sh           # the verifier
    └── check_orders.py
𝚒𝚌𝚎𝚍-𝚕𝚊𝚝𝚝𝚎-𝚖𝚒𝚜𝚜𝚒𝚘𝚗 태스크 폴더 전체.
지시문은 에이전트에게 사용자의 요청을 전달하고 sfbeans CLI의 이름을 알려 줍니다. 실제 환경에서는 에이전트가 스킬, 문서, MCP server를 통해 도구를 찾습니다. 여기서는 이름을 직접 알려 줘서 발견과 선택 단계를 건너뛰고, 평가가 성공에만 집중하도록 했습니다.
시각이 오전 8시 30분이라는 점도 명시합니다. 고정된 시계를 쓰는 것은 sfbeans뿐이고, 샌드박스의 시스템 시계는 여전히 실제 시각을 가리킵니다.
Use the sfbeans CLI to get me a large iced latte with whole milk, ready for
pickup by 9:00am today, under $8 including tip. I'm in the Mission.
It's 8:30am now.
사용자의 요청에 도구 이름과 현재 시각을 더했습니다.
환경은 일부는 진짜이고 일부는 가짜입니다. 에이전트는 실제 sfbeans CLI를 사용하지만, 미리 채워 둔 카페 데이터와 고정된 시계 위에서 동작하므로 모든 트라이얼이 같은 아침에서 시작합니다.
FROM python:3.12-slim
COPY sfbeans /usr/local/bin/sfbeans
COPY cafes.json /opt/sfbeans/cafes.json
ENV SFBEANS_DATA=/opt/sfbeans/cafes.json \
    SFBEANS_ORDERS=/opt/sfbeans/orders.json \
    SFBEANS_NOW="08:30"
𝚂𝙵𝙱𝙴𝙰𝙽𝚂_𝙽𝙾𝚆가 CLI의 시계를 오전 8시 30분으로 고정합니다.
데모를 단순하게 하려고 cafes.json을 에이전트의 환경 안에 두었습니다. 실제 평가에서는 시드 데이터와 검증기 코드를 보호하고, 에이전트가 CLI를 통해서만 주문 기록을 바꿀 수 있게 해야 합니다. 에이전트는 통과에 도움이 된다면 리워드 해킹을 시도할 수 있습니다. 재고를 수정하거나 orders.json를 직접 쓰는 식입니다.
이 커피 주문에서 검증기는 최종 주문이 사용자의 요구사항을 충족하는지 확인합니다. Harbor는 에이전트가 끝난 뒤 test.sh을 실행하고, 이 스크립트가 /logs/verifier/reward.json에 기록한 점수를 읽습니다.
python3 /tests/check_orders.py /opt/sfbeans/orders.json > /logs/verifier/reward.json𝚝𝚎𝚜𝚝.𝚜𝚑이 검사를 실행하고 점수를 기록합니다.
실제 검사는 check_orders.py에 있습니다. 제약 조건마다 따로 점수를 매기고, 모두 통과했을 때만 reward을 1로 설정합니다. Harbor는 reward을 해당 트라이얼의 대표 점수로 사용합니다.
import json, os, sys

path = sys.argv[1]
orders = json.load(open(path)) if os.path.exists(path) else []
o = orders[0] if len(orders) == 1 else {}

reward = {
    "one_order": int(len(orders) == 1),
    "right_drink": int(o.get("drink") == "latte" and o.get("size") == "l"
                       and o.get("temp") == "iced" and o.get("milk") == "whole"),
    "on_time": int(o.get("ready_at", "99:99") <= "09:00"),
    "on_budget": int(o.get("total", 99) <= 8.00),
}
reward["reward"] = int(all(reward.values()))  # 1 only if every constraint holds
print(json.dumps(reward))
제약 조건별로 점수를 매기기 때문에, 실패한 트라이얼에서 무엇이 잘못됐는지 정확히 알 수 있습니다.
정답 풀이는 검증된 답안입니다. 실제 에이전트를 돌리기 전에 먼저 실행해서 태스크가 제대로 동작하는지 확인하세요.
sfbeans quote cafe_val07 --drink drink_lat_l --size l --temp iced --milk whole --tip 15%
sfbeans order cafe_val07 --drink drink_lat_l --size l --temp iced --milk whole --pickup 08:50 --tip 15%
Valencia Grind에서 견적을 받고 주문합니다. 보상 점수 1이 나와야 합니다.
마지막으로 task.toml이 태스크 전체를 하나로 묶어 줍니다. 타임아웃을 설정하고, 에이전트의 샌드박스(orders.json이 있는 곳)에서 검증기를 실행하며, 5단계에서 살펴볼 수 있도록 주문 내역을 아티팩트로 저장합니다.
artifacts = ["/opt/sfbeans/orders.json"]

[task]
name = "sfbeans/iced-latte-mission"

[agent]
timeout_sec = 600

[verifier]
timeout_sec = 60
environment_mode = "shared"  # verify in the agent's sandbox, where orders.json lives
에이전트의 샌드박스에서 검증기를 실행하고, 5단계에서 쓸 orders.json을 저장합니다.
4단계: 평가 실행하기
느린 CI가 누구에게나 싫은 것처럼, 평가를 기다리는 시간도 지겹습니다. 트라이얼은 하나하나가 에이전트의 LLM 호출을 단계마다 기다려야 하고, 런은 이 과정을 모든 배리언트와 태스크에 대해 여러 번씩 반복하기 때문입니다.
Vercel이 업스트림에 직접 기여한 Harbor의 Vercel 통합 덕분에 속도가 크게 빨라집니다. 트라이얼을 동시에 실행하되 각각 별도의 Vercel Sandbox에서 돌리고, 빌드한 태스크 환경을 캐시해서 트라이얼마다 다시 빌드하지 않게 해 줍니다. 모델 호출을 AI Gateway로 보내면 여러 모델 제공자에 걸쳐 키 하나, 예산 하나로 관리할 수 있습니다.
예시
Claude Code와 Codex 두 에이전트에 모델을 각각 두 개씩 붙이면 배리언트는 네 개입니다.
job_name: sfbeans-baseline
n_attempts: 5            # trials per task, per variant
n_concurrent_trials: 10  # sandboxes running at once (the Hobby max)

environment:
  type: vercel

agents:
  - name: claude-code
    model_name: anthropic/claude-opus-5.5
    env:
      ANTHROPIC_AUTH_TOKEN: ${VERCEL_OIDC_TOKEN}  # visible to the agent, fine for a demo
      ANTHROPIC_API_KEY: ""
      ANTHROPIC_BASE_URL: https://ai-gateway.vercel.sh/claude-code
  - name: codex
    model_name: openai/gpt-6-astra
    env:
      OPENAI_API_KEY: ${VERCEL_OIDC_TOKEN}
      OPENAI_BASE_URL: https://ai-gateway.vercel.sh/codex/v1
  # Same pattern for anthropic/claude-sonnet-5.5 and openai/gpt-6.1-sol

datasets:
  - path: tasks/
배리언트는 두 개만 표시했습니다. 전체 80회 트라이얼을 돌리려면 같은 패턴으로 Sonnet과 GPT-6.1 Sol을 추가하세요.
그다음 Harbor를 설치하고 Vercel 프로젝트를 연결한 뒤 job을 실행합니다.
uv tool install --python 3.12 'harbor[vercel]==0.24.0' --with 'vercel==0.10.0'  # versions we tested

vercel login      # authenticate
vercel link       # pick the team + project
vercel env pull   # writes VERCEL_OIDC_TOKEN to .env.local (valid 12h)

harbor run -c job.yaml   # 4 tasks × 4 variants × 5 attempts = 80 trials, 10 at a time
harbor view jobs         # browse results and trajectories
Harbor를 설치하고, Vercel 프로젝트를 연결하고, job을 실행한 뒤 결과를 확인합니다.
이 정도 실행은 Hobby 플랜으로 충분합니다. 동시 샌드박스 10개가 Hobby 플랜의 한도이고, 각 트라이얼은 45분인 세션 상한에 한참 못 미칩니다. Pro 플랜에서는 n_concurrent_trials을 최대 10,000까지 올릴 수 있습니다(Sandbox 한도).
예시를 단순하게 하려고 OIDC 토큰을 환경 변수로 각 샌드박스에 전달했고, 에이전트가 이를 읽을 수 있습니다. 데모를 넘어서는 환경이라면 수명이 짧은 토큰을 쓰고, Harbor의 Vercel 통합으로 Sandbox 방화벽 규칙을 설정해 각 트라이얼이 AI Gateway처럼 꼭 필요한 호스트에만 접근하도록 제한하세요.
Vercel 내부에서는 한 걸음 더 나아가 자격 증명 브로커링(credentials brokering)을 사용합니다. 외부로 나가는 요청에 자격 증명을 붙여 주는 방식이라, API 키가 에이전트의 환경 밖에 머뭅니다.
5단계: 트레이스 분석하기
이제 핵심인 트레이스 분석입니다. 점수는 에이전트가 얼마나 자주 실패하는지 알려 주고, 트레이스는 왜 실패하는지 알려 줍니다. 실패한 트라이얼은 물론, 통과한 트라이얼도 일부 읽어 보세요. 통과는 검증기가 만족했다는 뜻일 뿐이니까요.
예시
4단계에서 실행한 런은 jobs/sfbeans-baseline/에 트라이얼 폴더 80개를 남깁니다. 각 폴더에는 트라이얼의 결과, 에이전트의 trajectory, 검증기 점수가 들어 있고, task.toml이 아티팩트로 저장하기 때문에 에이전트가 넣은 주문도 함께 들어 있습니다.
├── result.json                     # results across all variants and tasks
├── iced-latte-mission__Ab3dE7x/    # one trial, with a generated suffix
│   ├── config.json                 # which agent, model and task
│   ├── result.json                 # trial scores, cost and timing
│   ├── trial.log                   # runner logs, useful if the trial breaks
│   ├── agent/
│   │   └── trajectory.json         # what the agent saw, said and did
│   ├── verifier/
│   │   ├── reward.json             # did the order meet every constraint?
│   │   └── test-stdout.txt         # verifier output
│   └── artifacts/
│       └── opt/sfbeans/orders.json # the order the agent actually placed
└── …                               # the other 79 trials
각 트라이얼 폴더에는 점검에 필요한 트레이스, 검증기 점수, 저장된 아티팩트가 모여 있습니다.
harbor view jobs를 실행하면 결과를 둘러볼 수 있습니다. 네 배리언트가 보고할 법한 결과는 다음과 같습니다(수치는 예시입니다).
각 배리언트에 대해 태스크별로 성공률을 계산하고 pass^5를 추정한 뒤, 각 지표를 네 태스크에 걸쳐 평균 냈습니다. 태스크는 모두 같은 비중으로 계산합니다.
배리언트 | 성공률 | Pass^5 | 평균 단계 수(성공 기준) | 성공 1건당 비용(실패 트라이얼 포함) |
|---|---|---|---|---|
Claude Code + Opus 5.5 | 85% | 60% | 9 | $0.61 |
Claude Code + Sonnet 5.5 | 75% | 52% | 11 | $0.27 |
Codex + GPT-6 Astra | 80% | 43% | 8 | $0.48 |
Codex + GPT-6.1 Sol | 65% | 14% | 13 | $0.22 |
이것이 우리의 베이스라인입니다. 2단계에서 선택한 지표인 pass^5 기준으로 보면, 가장 좋은 배리언트조차 신뢰할 만한 수준과는 거리가 멉니다. 하지만 점수만으로는 무엇을 고쳐야 하는지 알 수 없습니다. 그러려면 실패한 트라이얼을 열어 봐야 합니다.
2단계의 트라이얼 2를 살펴보겠습니다. Claude Code + Opus 5.5가 24th St Beans에서 9.27달러에 주문했습니다. 어떤 제약 조건을 어겼는지는 검증기가 알려 줍니다.
{
  "one_order": 1,
  "right_drink": 1,
  "on_time": 1,
  "on_budget": 0,
  "reward": 0
}
주문은 음료와 픽업 요건을 충족하지만 예산을 초과합니다.
음료는 맞고 시간도 맞지만 예산을 넘겼고, 저장된 orders.json도 총액이 9.27달러임을 확인해 줍니다. 이제 agent/trajectory.json를 읽어 봅니다. 에이전트는 미션 지구에서 라테를 검색해 메뉴 가격 7.50달러를 확인하고 곧바로 order로 넘어갑니다. quote은 없었습니다. 메뉴 가격을 최종 가격으로 착각한 것입니다.
같은 배리언트의 트라이얼 1은 카페 세 곳의 견적을 받고, 24th St Beans를 제외한 뒤 Valencia Grind에서 7.42달러에 주문합니다. 즉 CLI는 주문을 제대로 처리할 수 있지만, 에이전트가 사용자의 돈을 쓰기 전에 총액을 확인하는 일이 안정적이지 않다는 뜻입니다.
그런 다음 다른 실패 트라이얼에서도 같은 패턴이 나타나는지 찾아봅니다. 계속 보인다면 고칠 구체적인 대상이 생깁니다. 총액을 더 눈에 띄게 만들거나, --max-total 플래그를 추가해서 order이 예산을 넘는 주문을 거부하게 하는 것입니다. "Opus가 85%를 받았다"보다 훨씬 쓸모 있는 결론입니다.
이 데모를 처음 실행했을 때는 트레이스에서 평가가 무엇을 측정하는지에 관한 문제도 드러났습니다.
첫 실행에서는 모든 배리언트가 0%를 받았습니다. 에이전트들이
sfbeans의 존재를 몰라서 시도조차 하지 않은 것입니다(당연한 결과죠). 퍼널의 발견 단계가 우리 평가 안에서 실패한 셈입니다. 지시문에 도구 이름을 적어 넣자 해결됐는데, 발견될 수 있다는 점이 제품의 일부라는 점을 다시 확인시켜 줍니다. 실제 환경에서는 스킬, 문서, MCP server, AEO가 그 역할을 합니다.Codex는
sfbeans을 연결된 도구로 계속 찾기만 하고 셸에서 실행해 볼 생각은 하지 않았습니다. 이는 성공이 아니라 접근의 문제입니다.Codex는
impossible-request거의 매번 통과했지만, 트레이스를 읽어 보니 통과 10건 중 9건은 에이전트가 찾아보지도 않고 포기한 경우였습니다. 검증기는 주문이 들어가지 않았는지만 확인했으므로, 에이전트가 먼저 검색했는지도 확인하도록 조건을 강화했습니다. 트레이스를 읽지 않았다면 이 결과들을 성공으로 집계했을 것입니다.
트레이스 분석 자동화
규모가 큰 런에서는 트라이얼을 하나하나 직접 살펴보기가 금세 느려지므로 이 과정을 자동화합니다.
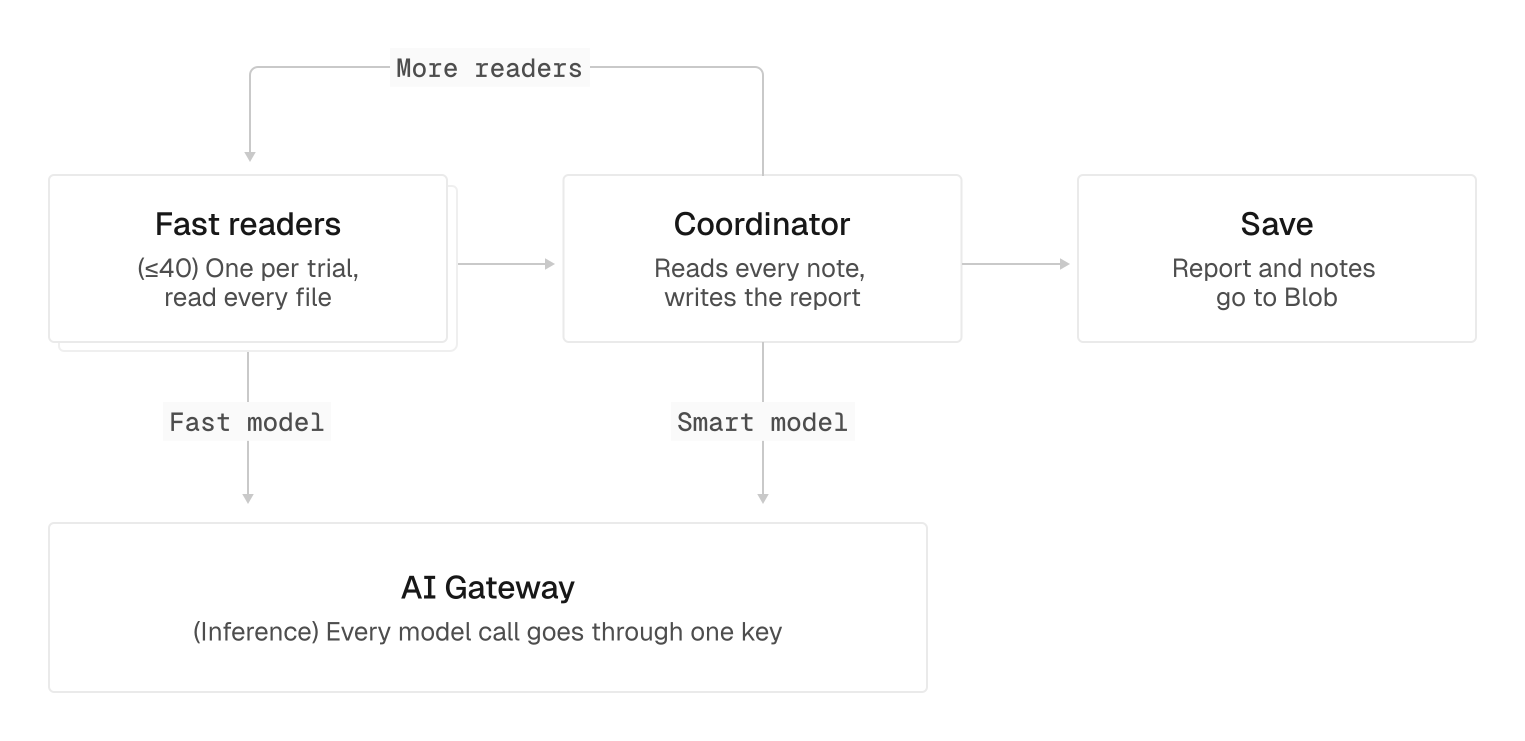
deepseek/deepseek-v4.1-flash 같은 빠른 모델을 쓰는 리더 에이전트를 최대 40개까지 병렬로 띄워 트라이얼 기록을 읽고 발견한 내용을 요약하게 합니다. 더 똑똑한 코디네이터 에이전트가 그 요약을 검토하고, 필요하면 리더에게 맥락을 더 확인하도록 다시 보내며, 최종 보고서를 작성합니다. 코디네이터가 무엇을 찾아야 하는지는 analysis.md 파일에 적어 두므로, 이 워크플로를 여러 런에서 재사용할 수 있습니다.
모델 호출은 AI Gateway를 거칩니다. 분석하는 동안 트라이얼 아티팩트는 Vercel Drives에 두고, 트레이스는 장기 보관을 위해 Vercel Blob으로 보냅니다.
반복해서 완성도 높이기
첫 번째 평가 런은 베이스라인이 됩니다. 이제 이를 바탕으로 행동에 나설 차례입니다.
--max-total 플래그처럼 트레이스가 가리키는 수정안을 하나 골라 같은 job을 다시 실행하고, 베이스라인과 비교하세요. 목표로 한 실패가 줄었는지, 새로운 실패가 생기지는 않았는지 확인한 다음, 그 결과로 변경 사항을 배포해도 될지 판단합니다.
평가를 한 번 만들어 두면 여러 용도로 계속 쓸모가 있습니다. 릴리스마다 다시 실행해 회귀를 잡아내고, 배포 전에 프롬프트·스킬·모델 변경을 테스트하고, 에이전트가 제품을 어떻게 쓰는지 파악하고, 그 위에 자동 최적화 루프를 얹을 수도 있습니다.
시간이 지나면서 더 어려운 태스크를 추가하게 될 것입니다. 모델과 제품이 좋아지면 평가가 포화되어, 에이전트가 모든 태스크를 통과하기 시작합니다. 회귀를 감지하는 데는 좋은 일이지만, 다음에 무엇을 개선해야 하는지는 알려 주지 못합니다.
평가는 제품을 거듭 개선하는 데 쓰는 인프라입니다. Vercel에는 이를 한곳에서 구축하는 데 필요한 요소가 갖춰져 있습니다. 여러 제공자의 모델을 호출하는 AI Gateway, 트라이얼을 대규모로 실행하는 Sandbox, 모든 트레이스를 보관하는 Drives와 Blob입니다.
첫 평가를 실행해 볼 준비가 되셨나요? 아래 프롬프트를 코딩 에이전트에 붙여 넣으면, 에이전트가 여러분과 함께 Vercel에서 제품용 평가를 만들고 실행해 줍니다.
코딩 에이전트용 프롬프트
Read https://vercel.com/blog/wtf-are-evals and help me build and run an end-to-end Harbor eval for this repo on Vercel, following the post’s 5 steps. References: - Harbor: https://github.com/harbor-framework/harbor - Harbor on Vercel Sandbox + AI Gateway setup: https://vercel.com/kb/guide/run-terminal-bench-harbor-benchmarks-vercel-sandbox - AI Gateway with Claude Code / Codex: https://vercel.com/docs/ai-gateway/coding-agents/claude-code, https://vercel.com/docs/ai-gateway/coding-agents/openai-codex - Sandbox firewall + limits: https://vercel.com/docs/sandbox/concepts/firewall, https://vercel.com/docs/sandbox/pricing 1. Goal: explore the repo, ask me which user task and failure mode matter most, propose one measurable goal. 2. Metrics: pick success rate, pass@k or pass^k based on what a failure costs my users, plus steps, time and cost on successful trials. 3. Tasks: write 3-5 Harbor tasks in tasks/, including one impossible request (its verifier should also check the agent searched before giving up). Name the tool in each instruction and state the current time if it matters. Seed data so every trial starts the same. Have verifiers check the required outcomes and write per-constraint scores to /logs/verifier/reward.json. Protect seed data and verifier code from agent writes, and require changes to the checked state to go through the product’s tools. 4. Run: ask me which Vercel team and project to use before creating anything. Write job.yaml (vercel environment, the variants I want to compare via AI Gateway). First run cheap, fast smoke tests to prove the setup works: run any provided known-good solutions, then one trial of one variant. Then propose the full run with trial count, estimated cost (from the smoke test) and time, and wait for my go-ahead before running it. 5. Analyze: report results per task and variant, read failed trajectories and a sample of passing ones, group failures by root cause with evidence, flag misleading passes, and propose one fix to rerun against the baseline.