Hamel Husain블로그
"평가(eval)하기 어렵다"는 말 자체가 제품 문제의 신호다
좋은 제품이라면 AI 출력 결과를 쉽게 검증할 수 있어야 한다.
"지난 분기 제품 A의 순매출은 얼마인가요?"
요약 답변: $4.21M. 이 노트북은 해당 수치가 어떻게 산출됐는지, 그리고 신뢰할 수 있는 출처와 어떻게 대조했는지를 보여준다.
1. 지표 정의
순매출은 gross − returns − discounts로 정의한다. 재무 보고 기준과 일치하도록 관리 지표 레이어에서 정의를 읽어온다.
[1]
Python▶코드 접힘✦ AI에게 묻기 ⌘K
import yaml

defn = yaml.safe_load(open("metrics/net_revenue.yml"))
defn["expr"], defn["source"]
('gross - returns - discounts', 'finance.order_lines')
2. 제품 A 순매출
주문 내역에서 직접 해당 분기 제품 A의 순매출을 뽑는다.
[2]
SQL▶코드 접힘✦ AI에게 묻기 ⌘K
SELECT SUM(gross - returns - discounts) AS net_revenue
FROM   finance.order_lines
WHERE  product = 'Product A'
  AND  fiscal_quarter = 'Q4-FY25';
| net_revenue |
|---|
| 4,210,442 |
채팅 답변에서 제시한 $4.21M이 이 수치다.
3. 분포 sanity-check
제품 A를 지역별로 분해한 뒤 차트로 시각화한다. 지난 분기 비중과 비교했을 때 이상한 부분이 없어야 한다.
[3]
SQL▶코드 접힘✦ AI에게 묻기 ⌘K
SELECT region,
       SUM(gross - returns - discounts) AS net_revenue
FROM   finance.order_lines
WHERE  product = 'Product A'
  AND  fiscal_quarter = 'Q4-FY25'
GROUP BY region;
| region | net_revenue |
|---|---|
| West | 1,740,000 |
| Central | 1,160,000 |
| East | 890,000 |
| Intl | 420,000 |
[4]
Python▶코드 접힘✦ AI에게 묻기 ⌘K
m = by_region.set_index("region")["net_revenue"] / 1e6
m.plot.barh(title="Net revenue by region · Q4 FY25")
지역별 순매출 · FY25 Q4
West1.74
Central1.16
East0.89
Intl0.42
00.51.01.52.0
순매출 ($M)
West와 Central이 매출 대부분을 차지하며, International은 소규모 비중이다.
4. 검증하지 못한 항목
비교할 신뢰 가능한 출처가 없는 입력값이 두 가지 있다. 확정된 것처럼 처리하는 대신, 각각을 직접 실행하고 수정할 수 있는 셀로 남겨둔다.
[5]
SQL▶코드 접힘✦ AI에게 묻기 ⌘K
-- the agent's -$0.7M returns figure is an estimate;
-- check the returns table for Q4 rows to back it
SELECT COUNT(*) AS n_rows, SUM(amount) AS returns
FROM   finance.returns
WHERE  product = 'Product A'
  AND  fiscal_quarter = 'Q4-FY25';
| n_rows | returns |
|---|---|
| 0 | NULL |
# Q4 반품 데이터가 아직 로드되지 않아 −$0.7M은 추정값임
따라서 −$0.7M은 아직 대조할 출처가 없다. 또 다른 미확인 항목은 고객 조인이다.
[6]
SQL▶코드 접힘✦ AI에게 묻기 ⌘K
-- 183 of 12,480 unique customers are in Billing, not CRM,
-- so some revenue can't be attributed. Pull them:
SELECT b.customer_id, b.amount
FROM   billing.invoices b
LEFT JOIN crm.customers c USING (customer_id)
WHERE  c.customer_id IS NULL
ORDER BY b.amount DESC
LIMIT 5;
| customer_id | amount |
|---|---|
| BIL-44821 | 18,400 |
| BIL-39105 | 12,950 |
| BIL-50277 | 9,310 |
| … | … |
# 183행 · $61,540 귀속 불명
고객 귀속이 불확실한 매출 $61,540이 명시적으로 표시되어 있어, 담당자가 합계를 신뢰하기 전에 직접 해결할 수 있다.
목차
✦어시스턴트
새 스레드✕
지난 분기 제품 A의 순매출은 얼마인가요?
✦
재무의 공식 정의를 기준으로 주문 내역에서 제품 A 순매출을 뽑고, 지역별로 분해한 뒤, 검증하지 못한 항목을 표시했습니다. 각 셀은 왼쪽에 있습니다.
✓ 이 노트북의 셀 생성 완료
추가 질문을 입력하세요…
노트북은 위에서 아래로 읽힌다. 에이전트가 세운 가정, 실행한 쿼리, 그리고 검증하지 못한 항목 목록이 순서대로 담겨 있다.
여기서 주목할 변화가 여럿 있다.
- 에이전트가 검증된 분석에서 선택적으로 데이터를 가져오며, 인터페이스는 어떤 분석이 사용됐는지와 작성자를 함께 보여준다.
- 정보를 단계적으로 공개한다. 채팅 답변에는 출처, 가정, 이슈 등 핵심 정보만 표시되고, 사용자가 원하면 인터랙티브 노트북을 열어 전체 맥락을 확인할 수 있다.
- AI가 생성한 노트북(위의 노트북 탭 참고)은 검증을 돕는 구조로 구성된다. 에이전트가 세운 가정, 예컨대 지표 정의와 그 출처부터 시작해, 실행한 쿼리와 반환된 수치를 순서대로 보여준다. 전체 합계를 분해해 분포를 확인할 수 있게 하고, 마지막에는 검증하지 못한 항목 목록을 직접 실행 가능한 셀 형태로 남긴다.
- 노트북 안에서도 AI 에이전트에게 추가 질문을 할 수 있다. 또한 사용자는 작성한 노트북을 지식 베이스에 게시할 수 있으며, 이후 분석에서 이를 참조해 선순환 구조가 만들어진다.
이 설계 시안이 완벽하다고 말하는 것은 아니다. 핵심은, 제품이 도메인 전문가처럼 답을 검증할 수 있도록 사용자를 도와야 한다는 것이다. 수치만 출력하던 초기 방식과 비교해보라.
이런 데이터 에이전트는 먼 미래 이야기가 아니다. 이 분야에서 내가 가장 좋아하는 제품은 Hex4다. 노트북과 채팅을 이보다 잘 통합한 제품은 아직 보지 못했다. 랜딩 페이지에서 가져온 스크린샷을 보자.
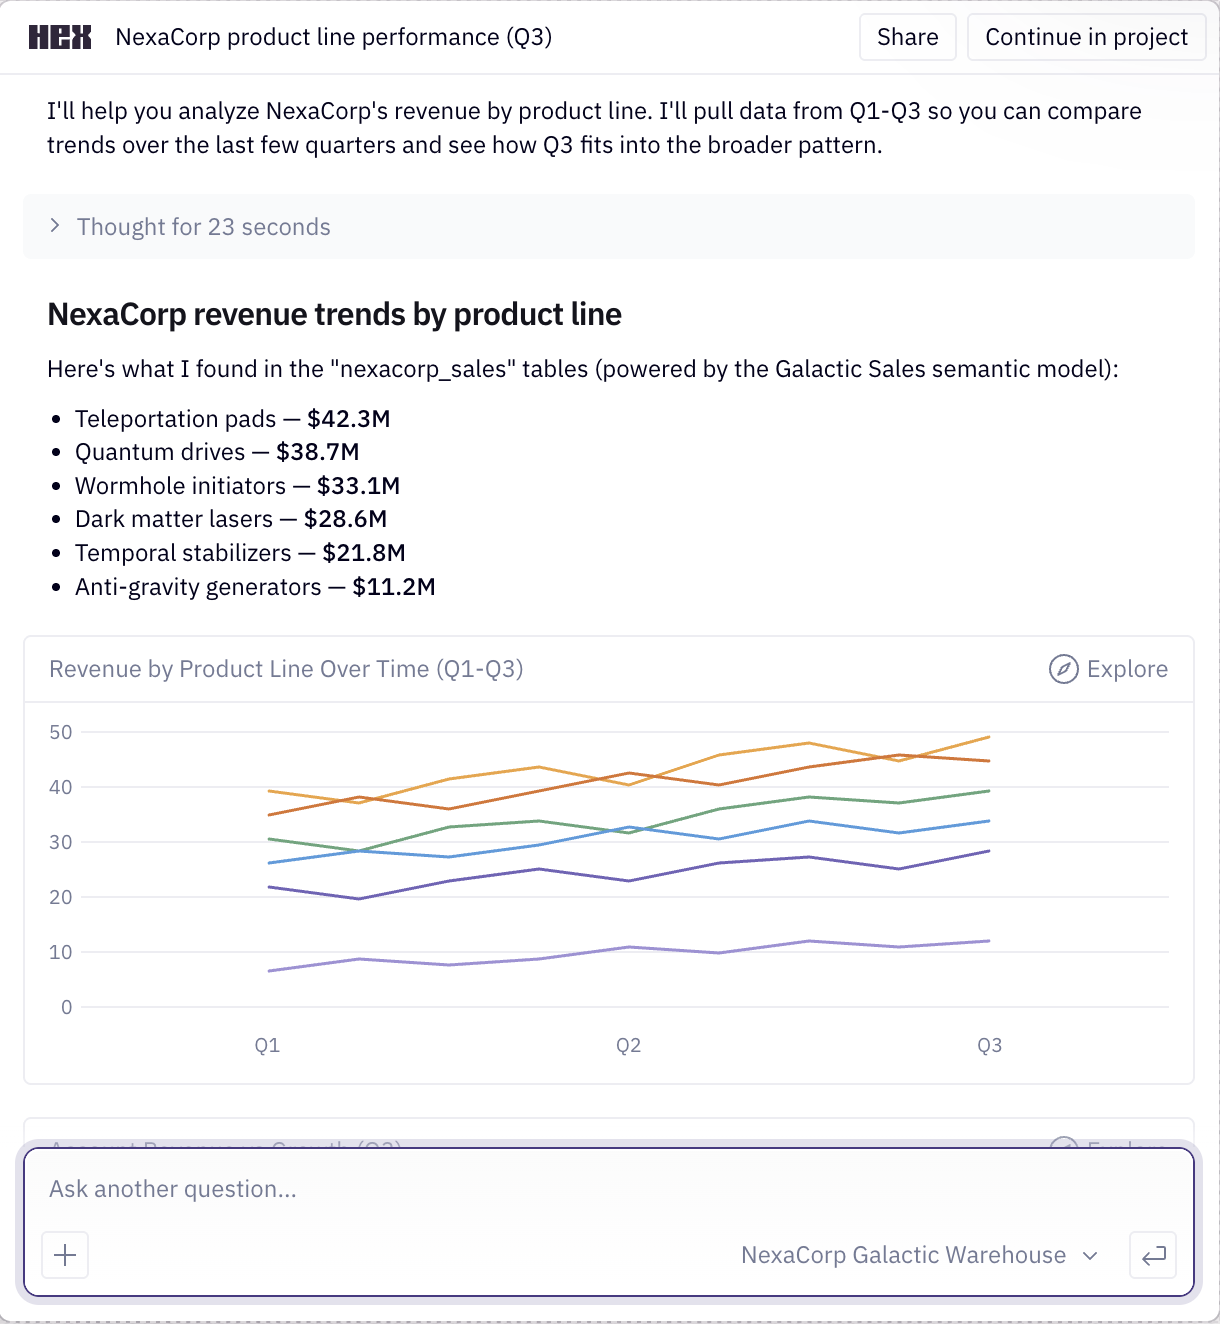
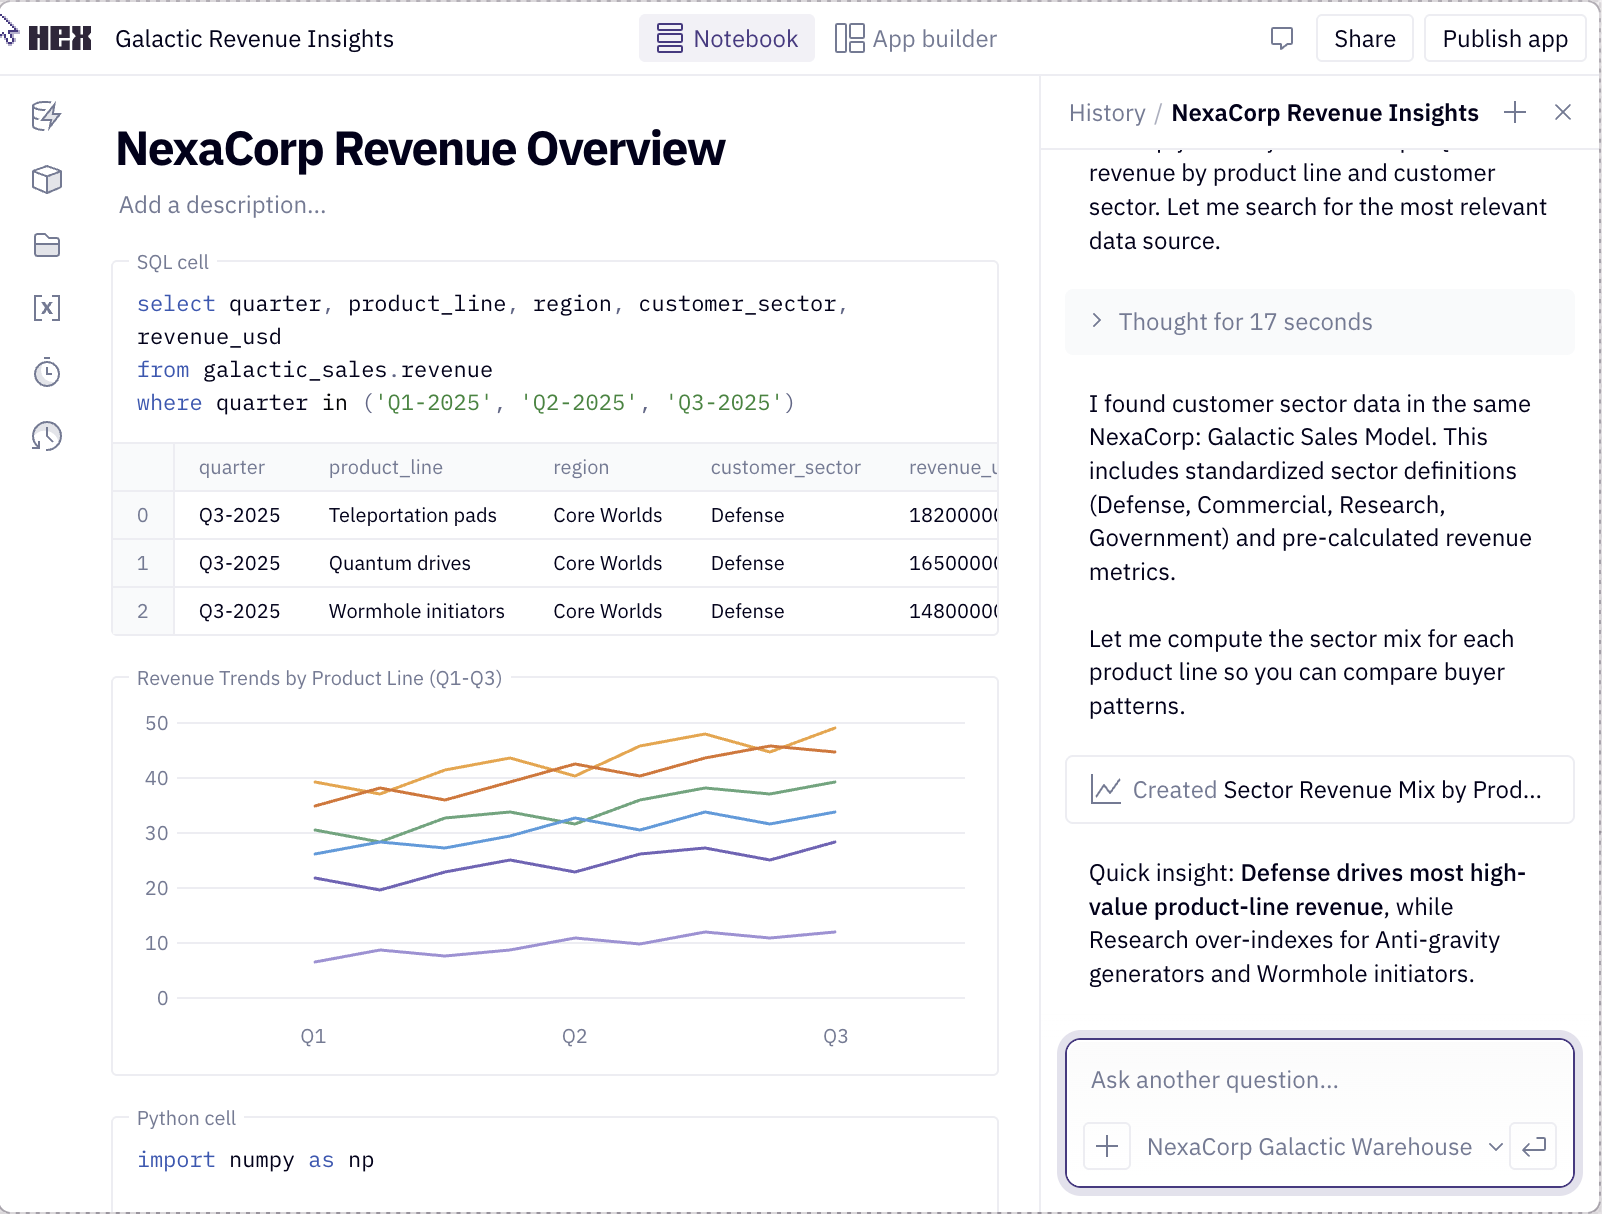
그런데 이것이 평가와 무슨 관계일까? 검증하기 쉬운 제품을 설계하면 레이블링 비용이 낮아지고, 평가가 참조할 수 있는 신호의 질도 높아진다. 무엇보다, 사용자에게 더 나은 제품을 제공하게 된다.
사례 2: 체육 수업 계획 빌더
내가 자문한 창업자 중 한 명은 유치원~고등학교(K-12) 교사를 위해 체육 수업 지도안을 작성해주는 AI 도구를 만들고 있었다. 교사가 학년, 수업 시간, 실내외 여부, 보유 기자재 같은 조건을 입력하면 도구가 해당 조건에 맞는 지도안을 작성한다. 수업 계획에 드는 시간을 줄이고 현실에 맞는 지도안을 제공하는 것이 목적이다. 제품의 모습을 시안으로 살펴보자.
수업 정보
학년
4학년▾
수업 시간
45분▾
장소
실외▾
기자재
콘 12개, 공 6개
수업 계획 생성
공 다루기
8차시 중 1차시
생성된 계획
준비 운동 · 8분
운동장 외곽을 달린 뒤 동적 스트레칭: 팔 돌리기, 런지, 하이 니. 마지막으로 손을 풀기 위해 파트너와 캐치볼.
주요 활동 · 30분
학생을 2인 1조로 나누고 콘을 3m 간격으로 세운다. 파트너끼리 언더핸드, 오버핸드 순으로 던지기를 연습한다. 반대쪽 발을 내딛고 팔을 끝까지 뻗도록 지도한다. 정확도가 높아지면 간격을 늘리고 5분마다 파트너를 바꾼다.
마무리 운동 · 7분
정적 스트레칭과 던지기 포인트 복습: 발 내딛기, 목표 향해 팔 뻗기, 팔로스루.
평가 · 메모
반대쪽 발을 내딛고 목표를 바라보며 던지는지 확인한다. 다음 수업에서 거리를 줄여야 할 학생을 메모한다.
기자재
콘 12개, 폼 공 6개, 구역 표시 3개.
교사가 조건을 입력하면 도구가 처음부터 계획을 작성한다. 출력이 계획서뿐이라 검증하기 어렵다.
창업자는 수업 지도안을 어떻게 평가할지 물었다. 나는 질문을 바꿔 되물었다. 교사가 진짜 신경 쓰는 것은 무엇인가?
지도안을 빠르게 신뢰하는 가장 좋은 방법은 자신과 비슷한 교사가 이미 사용하고 있다는 것을 확인하는 것이다. 또한 교사들은 다른 교사의 수업 방식을 보며 새로운 접근법을 배우고 싶어 한다. 따라서 더 나은 설계는, 실제 학교에서 활발히 쓰이는 검증된 지도안에서 출발하는 것이다. 도구가 지도안을 생성할 때 어떤 검증된 계획을 기반으로 했는지, 누가 사용하는지, 이 교사의 조건에 맞게 무엇을 바꿨는지를 함께 보여주는 방식이다.
그러면 교사는 처음 보는 지도안 전체를 처음부터 판단하는 대신, 이미 신뢰하는 계획서와 비교해 소수의 변경 사항만 검토하면 된다. 더 나은 인터페이스는 이런 모습이 될 수 있다.
공 다루기
8차시 중 1차시
생성된 계획
전체 계획
준비 운동 · 8분
1먼 콘까지 1바퀴 달린 뒤 동적 스트레칭: 팔 돌리기, 런지, 하이 니.
파트너와 캐치볼 10회로 마무리.
주요 활동 · 30분
2콘을 목표물로 3개 스테이션 구성. 2인 1조로 공 6개를 이용해 언더핸드, 오버핸드 순으로 던지기를 연습하며 5분마다 파트너 교체.
반대쪽 발을 내딛고 목표를 향해 팔을 끝까지 뻗도록 지도한다.
정확도가 높아지면 파트너 간 거리를 늘린다.
마무리 운동 · 7분
정적 스트레칭과 던지기 포인트 복습: 발 내딛기, 목표 향해 팔 뻗기, 팔로스루.
평가 · 메모
반대쪽 발을 내딛고 목표를 바라보며 던지는지 확인한다.
다음 수업에서 거리를 줄여야 할 학생을 메모한다.
기자재
콘 12개, 폼 공 6개, 구역 표시 3개.
변경 사항 · 2건모두 수락모두 거절
1 준비 운동
−2바퀴 달리기, 동적 스트레칭 (10분)
+1바퀴 달리기, 동적 스트레칭 (8분)
45분 수업에 맞게 시간 단축
수락 ⌘⏎
거절 ⌘⌫
2 주요 활동
−4개 스테이션, 공 8개, 훌라후프를 목표물로 사용
+3개 스테이션, 공 6개, 콘을 목표물로 사용
보유 기자재에 맞게 조정
수락 ⌘⏎
거절 ⌘⌫
계획서가 다른 교사가 쓰는 검증된 계획서에 기반한다. 변경 사항이 표시돼 있어 교사가 신뢰하는 원본 계획과 비교해 확인할 수 있다.
이 버전에서는 지도안 대부분이 검증된 계획서를 그대로 가져온다. 교사는 변경 사항 몇 가지만 검토하면 되고, 각 변경에는 수정 이유가 함께 표시된다. 전체 계획을 처음부터 판단하는 것보다 인지 부담이 훨씬 낮다.
이런 설계는 제품을 더 단순하게 만들기도 한다. 수백 개의 예시를 프롬프트에 억지로 넣는 대신, 도구가 핵심 조건을 파악하고 가장 유사한 계획서를 찾아 조정하면 된다. 평가해야 할 범위도 좁아져 자동 평가가 수월해진다. 예를 들어, 검색된 기준 계획서가 적절한지, 각 변경 사항이 조건을 잘 반영하는지를 검증하면 된다.
사례 3: 산재 의료 보고서
마지막 사례는 한 창업자가 자문을 요청한 산재(workers' compensation) 도구다. 환자 차트(접수 서류, 영상 판독 결과, 물리치료 기록, 이전 검진 결과)를 읽고 전문가 의견서를 생성하는데, 분량이 50페이지를 넘을 때도 많다. 제품의 모습을 시안으로 살펴보자.
원본 기록 · 18건
접수 설문지
MRI, 요추
X-ray 판독 결과
물리치료 기록
주치의 메모
이전 IME
업무 제한 사항
+ 11건 더
청구인 J. Doe청구 번호 #WC-20259417부상일 2025년 3월 3일검진의 Dr. A. Patel
독립적 의료 평가
영구적 및 고정 상태 보고서
1. 부상 경위
청구인은 47세 창고 작업자로, 2025년 3월 3일 약 27kg의 박스를 들다 요추 부상을 입었다고 진술한다. 즉각적인 요통과 우측 하지 방사통이 발생했으며, 이후 외측 종아리를 따라 저림 증상이 나타났다.
2. 기록 검토
검토한 기록: 접수 설문지, 2025년 3월 18일 요추 MRI, 물리치료 기록 12건, 2025년 8월까지의 주치의 경과 보고서.
3. 신체 검진
검진 결과, 요추 굴곡이 통증을 동반하며 40도로 제한됨. 우측 50도에서 하지직거상 검사 양성. 우측 장무지신근 근력 5점 만점 중 4점, L5 분포 감각 저하 소견.
4. 진단
L5-S1 요추 추간판 탈출증 및 우측 L5 신경근병증. 영상 소견 및 검진 결과로 뒷받침됨.
5. 인과관계 분석
합리적 의학적 개연성 범위 내에서, 추간판 탈출증은 2025년 3월 3일 업무 중 물건을 들다 발생한 사건과 인과관계가 있다. 청구인은 해당일 이전 요추 치료 기록이 없다.
1 / 52 페이지18건의 기록으로 생성
출력이 50페이지짜리 서술 보고서뿐이다. 신뢰하려면 의사가 전체 차트를 다시 읽으며 모든 주장을 확인해야 하는데, 이는 처음부터 직접 보고서를 작성하는 것과 시간이 비슷하다.
문제는 앞선 사례들과 같지만, 이 경우 위험 부담이 더 크다. 출력이 보고서뿐이고, 그 내용에 대한 책임은 의사가 진다. 신뢰하려면 차트를 처음부터 다시 검토하며 사실과 추론을 직접 확인해야 한다. 이는 처음부터 직접 작성하는 것과 시간이 비슷해 도구를 쓰는 의미가 없어진다.
50페이지짜리 의견서는 검증하기 어렵다는 반론이 있을 수 있다. 맞는 말이고, 제품이 그 사실을 외면해선 안 된다. 의사가 근거를 이해하도록 돕는 것이 완성된 문서를 넘겨주는 것보다 오히려 더 가치 있다고 본다. 그래서 나는 창업자에게 제품을 보고서 생성기가 아닌 리서치 어시스턴트처럼 작동하도록 설계하라고 조언했다.
예를 들어, 제품이 모든 기록을 읽고 관련 사실을 추출하되 의사가 각 항목을 직접 확인할 수 있도록 해당 페이지 링크를 함께 제공하는 방식이다. 두 검진 결과가 엇갈리거나 차트에 미해결 의문이 있으면 이를 명시적으로 보여줘야 한다. 의사가 모순을 해결하고 빈칸을 채우면, 마지막에 제품이 이미 검토한 내용을 토대로 최종 보고서를 만들어낸다. 이런 모습이 될 수 있다.
청구인 J. Doe청구 번호 #WC-20259417부상일 2025년 3월 3일검진의 Dr. A. Patel
기록 · 18건
MRI, 요추✓
물리치료 기록✓
주치의 메모✓
이전 IME○
접수 설문지○
X-ray 판독 결과○
18건 중 9건 검토 완료
3미결 사항
2025년 3월 18일 이후 영상 자료가 없어 추간판 탈출 현재 상태 확인 불가.
메모 추가
24건 중 6건 검토 필요보고서 초안 생성
제품이 의사를 근거 검토 과정으로 안내하며, 각 소견에 차트 링크를 제공한다. 최종 보고서는 의사가 검토한 사실들을 바탕으로 작성된다.
리서치 어시스턴트 방식의 제품을 사용하면, 의사는 사실을 확인해가며 신뢰를 쌓을 수 있다. 앞선 사례들과 마찬가지로, 이 설계는 구축과 평가가 더 쉽다. 이제는 평가할 단위가 명확해진다. 예컨대 모순이 실제로 존재하는지, 인용한 출처가 주장을 뒷받침하는지를 개별적으로 검증할 수 있다.
패턴의 일반화
사용자가 제품의 AI 결과물을 어떻게 검증하는지 이해하는 것이 중요하다. 경우에 따라 뒷받침할 근거를 모아 제시하는 것으로 충분할 수 있고, 산재 의료 보고서 사례처럼 사용자가 작업 흐름에 직접 참여하도록 전체 워크플로를 재설계해야 할 수도 있다.
검증을 고려한 제품 설계에 도움이 되는 질문들이다.
- 사용자가 실제로 확인해야 하는 것은 무엇인가?
- 그것을 비교할 수 있는 신뢰할 만한 기준이 있는가?
- 전문가가 검증에 활용하는 신호나 경험 법칙이 있는가?
- 수락, 편집, 거절할 수 있는 더 작은 단위로 나눌 수 있는가?
이 사례들을 관통하는 공통점은 출처 추적이다. 출력을 검증 가능하게 만드는 가장 빠른 방법은 각 부분이 어디에서 왔는지를 상세 정보 링크와 함께 보여주는 것이다. 또한 정보의 단계적 공개를 통해 출처가 사용자를 압도하지 않도록 할 수 있다.
검증이 필요한 부분은 사용자의 신뢰가 쌓이면서 달라진다. 초기에는 데이터 에이전트가 지표 정의를 어디서 가져왔는지 같은 출처를 명확히 보여줘야 한다. 사용자가 에이전트를 신뢰하게 되면, 그 정보는 기본적으로 접힌 상태로 보여줘도 된다. 좋은 설계는 모든 것을 한꺼번에 보여주는 대신 사용자가 있는 위치에서 만난다.
이 원칙은 평가하기 쉬워 보이는 제품에도 마찬가지로 적용된다. 코딩이 좋은 예다. 테스트, 타입, 코드 비교(diff)가 있어 결과를 검증하기 가장 쉬운 작업 중 하나지만, 일부 코딩 에이전트는 검증을 한 단계 더 쉽게 만든다. Cursor와 Devin은 UI 변경 사항을 짧은 영상으로 기록해, 직접 재현하지 않아도 작업 결과가 맞는지 확인할 수 있다.5
이 이야기는 사실 새로운 것이 아니다
평가에 대한 사고방식은 좋은 제품 설계와 맥을 같이한다. 뒷받침 데이터를 모으고 워크플로를 작은 단위로 나누면 자동 평가가 쉬워진다. 다만, 여기서 이야기한 것이 새로운 지혜인 척하고 싶지는 않다.
이 모든 아이디어는 오래전부터 확립된 설계 원칙에서 비롯된다. 예를 들어, 무언가를 만들기 전에 전문가가 무엇을 확인하는지 배우기 위해 그들의 작업을 관찰하는 것은 니즈파인딩(needfinding)이라고 부른다.6 의료 사례 같은 리서치 집약적 작업에서는 센스메이킹(sensemaking)이라는 설계 목표가 있는데, 이는 추론의 기반이 될 수 있도록 방대한 근거를 구조화된 이해로 만들어가는 작업이다.7 관련 개념은 더 많지만, 요점은 충분히 전달됐을 것이다.
이런 아이디어들이 확립된 것임에도 불구하고, AI 시대에 다시 한 번 되새길 필요가 있다. AI 이전에는 검증이 작업물을 만드는 과정에서 자연스럽게 이뤄졌다. AI 시대에는 검증 자체가 병목이 됐다. 이제는 검증을 더 명시적으로 생각할 때다.
이 글에 피드백을 준 Shreya Shankar와 Isaac Flath에게 감사드린다.
각주
평가에 관한 내 다른 글과 강의: Your AI Product Needs Evals, A Field Guide to Rapidly Improving AI Products, Using LLM-as-a-Judge for Evaluation, LLM Evals: Everything You Need to Know, Selecting the Right AI Evals Tool, Evals Skills for Coding Agents, The Revenge of the Data Scientist. AI Evals for Engineers & PMs 과정도 공동으로 강의하고 있으며, O'Reilly 도서 Evals for AI Engineers를 공동 집필했다.↩︎
Lenny Rachitsky가 최근 트윗한 내용: 한 데이터 과학 팀의 업무 상당 부분이 이제 PM과 엔지니어가 AI로 만들어온 미완성 분석 결과를 검토하는 일로 채워지고 있으며, 그 절반은 틀린 내용이라고 한다.↩︎
Airbnb에서 일할 때 Knowledge Repo라는 내부 도구가 있었다. 데이터 과학자들이 분석, 모델링 등에 관한 딥다이브 노트북을 게시하는 공간이었다(관련 글이 여기 있다). 새 프로젝트에 빠르게 맥락을 파악하는 가장 좋은 방법 중 하나였는데, 누군가 이미 정리해둔 내용을 읽을 수 있었기 때문이다. 지금도 사용되는지는 모르지만, 이 패러다임 자체는 여전히 훌륭하다.↩︎
Bryan Bischof가 Hex의 AI 기능 개발을 이끌었다. Bryan은 직접 데이터 과학자로 일했던 사람으로, 이 제품이 잘 설계된 이유 중 하나가 바로 그 점이라고 생각한다.↩︎
Dev Patnaik and Robert Becker, "Needfinding: The Why and How of Uncovering People's Needs", Design Management Journal.↩︎
Daniel M. Russell, Mark J. Stefik, Peter Pirolli, and Stuart K. Card, "The Cost Structure of Sensemaking".↩︎


