Hamel Husain블로그
AI 제품을 빠르게 개선하는 실전 가이드
30개 이상의 프로덕션 구현 사례를 바탕으로, 평가 방법론과 데이터 기반 개선 전략, 실험 기법을 총정리합니다.
대부분의 AI 팀은 엉뚱한 것에 집중합니다. 제 컨설팅 현장에서 자주 목격하는 장면이 있습니다:
AI 팀
저희 에이전트 아키텍처를 보여드릴게요. 여기에 RAG를 붙이고, 저쪽엔 라우터를 달았고, 이 새로운 프레임워크로…
나
[손을 들어 열변을 토하는 기술 리더를 멈추며]
"그래서 이게 실제로 잘 작동하는지는 어떻게 측정하고 계세요?"
… 순간 정적이 흐른다
지난 2년간 이런 장면이 수십 번 반복됐습니다. 팀들은 몇 주를 쏟아부어 복잡한 AI 시스템을 구축하지만, 정작 자신들이 한 변경이 도움이 되는지 해가 되는지조차 알지 못합니다.
이는 놀라운 일이 아닙니다. 새로운 도구와 프레임워크가 매주 쏟아지는 상황에서 어떤 벡터 데이터베이스를 쓸지, 어떤 LLM 제공업체를 선택할지, 어떤 에이전트 프레임워크를 도입할지 같은 눈에 보이는 것들에 집중하는 건 자연스러운 반응입니다. 하지만 30개 이상의 기업이 AI 제품을 만드는 것을 도우면서, 성공하는 팀들이 도구 얘기를 거의 하지 않는다는 사실을 발견했습니다. 그 대신 그들은 측정과 반복 개선에 집착합니다.
이 글에서는 성공하는 팀들이 실제로 어떻게 일하는지 구체적으로 살펴봅니다. 다음 내용을 다룹니다:
- 오류 분석이 어떻게 최고의 ROI를 내는 개선점을 지속적으로 찾아주는지
- 단순한 데이터 뷰어가 왜 AI 팀의 가장 중요한 투자인지
- 엔지니어가 아닌 도메인 전문가도 AI 개선에 기여할 수 있게 하는 방법
- 합성 데이터가 생각보다 훨씬 효과적인 이유
- 평가 시스템에 대한 신뢰를 유지하는 방법
- AI 로드맵이 기능이 아닌 실험 횟수를 기준으로 삼아야 하는 이유
각 주제를 실제 사례와 함께 설명합니다. 상황마다 다르지만, 도메인이나 팀 규모와 관계없이 적용할 수 있는 패턴을 발견하게 될 것입니다.
먼저 팀들이 가장 많이 저지르는 실수, 즉 AI 프로젝트를 시작도 하기 전에 방향을 잃게 만드는 함정부터 살펴보겠습니다.
1. 가장 흔한 실수: 오류 분석 건너뛰기
'도구 우선' 사고방식은 AI 개발에서 가장 흔한 실수입니다. 팀들은 아키텍처 다이어그램, 프레임워크, 대시보드에 빠져들면서 정작 무엇이 잘 되고 있고 무엇이 문제인지 파악하는 과정을 소홀히 합니다.
한 클라이언트가 자랑스럽게 이런 평가 대시보드를 보여줬습니다:
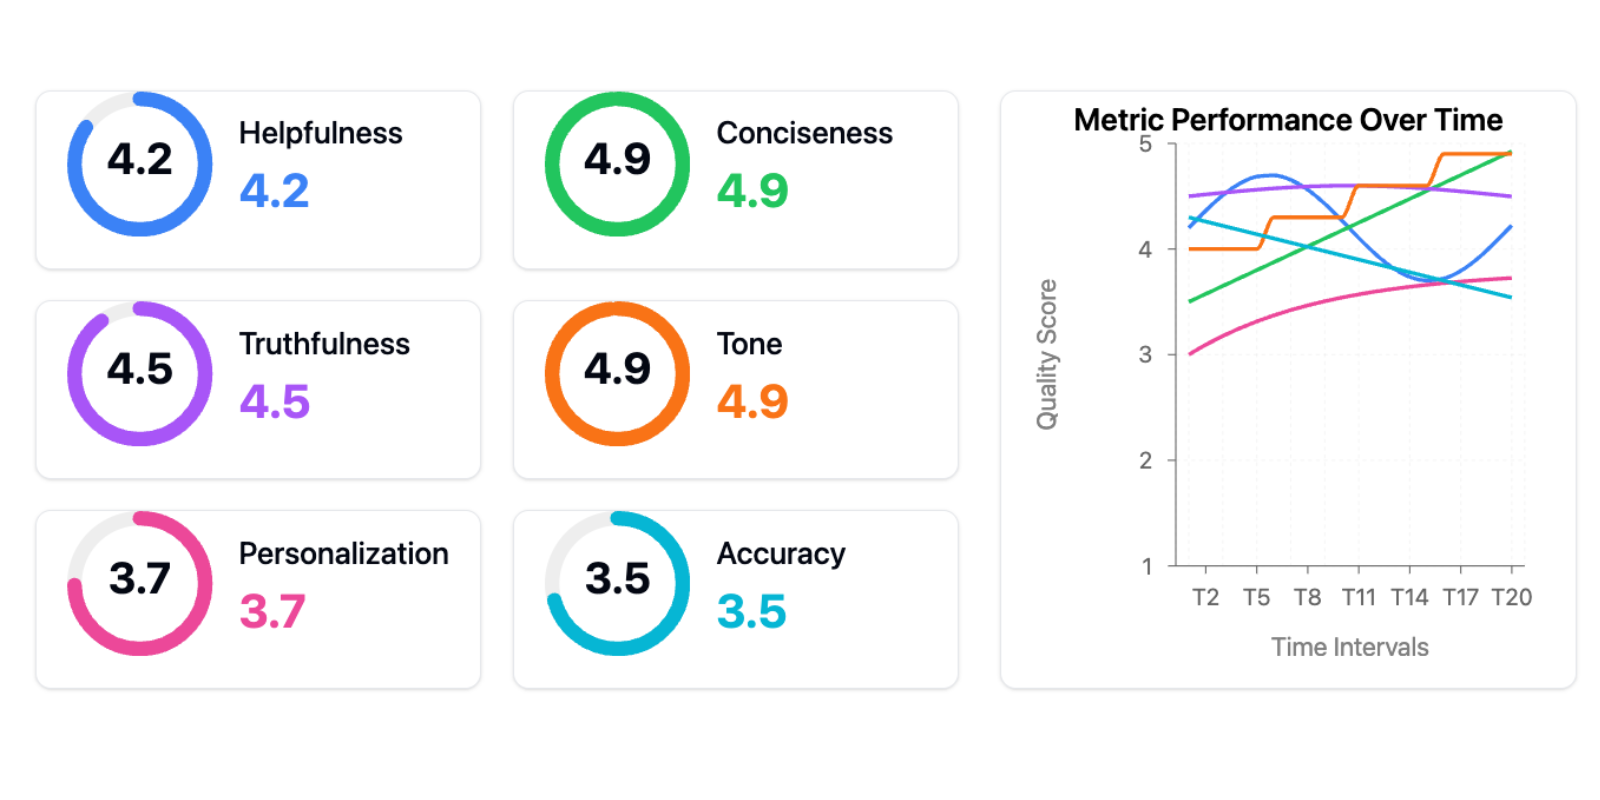
이것이 바로 '도구의 함정'입니다. 적절한 도구나 프레임워크(이 경우에는 범용 지표)를 도입하면 AI 문제가 해결된다는 믿음이죠. 범용 지표는 단순히 무용지물이 아닙니다. 두 가지 방식으로 오히려 발전을 가로막습니다:
첫째, 측정과 진척에 대한 착각을 만들어냅니다. 대시보드가 있으니 데이터 기반으로 일한다고 생각하지만, 실제 사용자 문제와 무관한 허영 지표만 추적하고 있을 뿐입니다. '도움도(helpfulness score)'가 10% 향상됐다고 자축하는 동안 실제 사용자들이 기본 기능조차 제대로 쓰지 못하는 경우를 여러 번 봤습니다. 결제 프로세스가 망가져 있는데 웹사이트 로딩 속도만 최적화하는 것과 같습니다. 엉뚱한 것에서 잘하고 있는 셈이죠.
둘째, 지표가 너무 많으면 주의가 분산됩니다. 해당 사용 사례에서 실제로 중요한 몇 가지 지표에 집중하는 대신, 여러 차원을 동시에 최적화하려 합니다. 모든 것이 중요하면, 아무것도 중요하지 않습니다.
대안은 무엇일까요? 바로 오류 분석(error analysis)입니다. AI 개발에서 단연 가장 가치 있는 활동이자 지속적으로 가장 높은 ROI를 내는 활동입니다. 실제로 효과적인 오류 분석이 어떤 모습인지 보여드리겠습니다.
오류 분석 프로세스
Nurture Boss의 창업자 Jacob이 부동산(아파트) 업계용 AI 어시스턴트를 개선해야 했을 때, 그의 팀은 AI와 사용자 간의 대화를 살펴볼 수 있는 간단한 뷰어를 만들었습니다. 각 대화 옆에는 실패 패턴에 대한 자유로운 메모를 남길 수 있는 공간이 마련됐습니다.
수십 건의 대화에 주석을 달고 나자 명확한 패턴이 드러났습니다. 사용자가 '2주 후에 투어를 잡고 싶어요'처럼 말할 때 AI가 날짜를 제대로 처리하지 못해 66%의 확률로 실패하고 있었습니다.
새 도구를 찾는 대신, 팀은 이렇게 접근했습니다: 1. 실제 대화 로그 확인 2. 날짜 처리 실패 유형 분류 3. 해당 문제를 잡아낼 테스트 구축 4. 지표 기반 개선 측정
결과는 어땠을까요? 날짜 처리 성공률이 33%에서 95%로 뛰어올랐습니다.
Jacob이 직접 이 과정을 설명합니다:
상향식 vs. 하향식 분석
오류 유형을 파악할 때는 '하향식(top-down)'과 '상향식(bottom-up)' 두 가지 접근법을 쓸 수 있습니다.
하향식 접근법은 '환각(hallucination)'이나 '유해성(toxicity)' 같은 일반 지표에 태스크 고유의 지표를 추가하는 방식입니다. 편리하지만 도메인 특화 문제를 놓치는 경우가 많습니다.
더 효과적인 상향식 접근법은 실제 데이터를 먼저 들여다보고, 지표가 자연스럽게 도출되도록 합니다. NurtureBoss의 경우, 각 행이 하나의 대화를 나타내는 스프레드시트로 시작했습니다. 바람직하지 않은 행동이 발견되면 자유롭게 메모를 남겼습니다. 그런 다음 LLM을 활용해 주요 실패 패턴의 분류 체계를 구성하고, 각 행에 특정 실패 패턴 레이블을 매핑한 뒤 발생 빈도를 집계했습니다.
결과는 놀라웠습니다. 단 세 가지 문제가 전체 문제의 60% 이상을 차지했습니다:
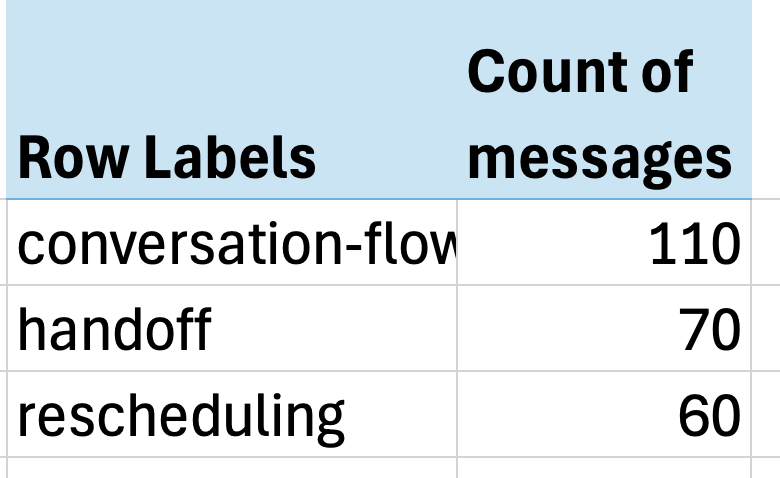
- 대화 흐름 문제 (맥락 누락, 어색한 응답)
- 인계 실패 (사람에게 전환해야 할 시점을 인식하지 못함)
- 일정 변경 문제 (날짜 처리 어려움)
효과는 즉각적이었습니다. Jacob의 팀은 실행 가능한 인사이트를 너무 많이 발견한 나머지, 이미 찾아낸 문제들을 수정하는 데만 몇 주가 필요했습니다.
오류 분석이 실제로 어떻게 진행되는지 보고 싶다면, 실습 영상을 여기서 확인하세요.
이는 핵심 질문으로 이어집니다. 팀이 데이터를 손쉽게 들여다볼 수 있도록 하려면 어떻게 해야 할까요? 그 답이 곧 AI 팀이 할 수 있는 가장 중요한 투자로 이어집니다…
2. AI 팀의 가장 중요한 투자: 단순한 데이터 뷰어
AI 팀이 할 수 있는 가장 효과 높은 투자는 화려한 평가 대시보드가 아닙니다. AI가 실제로 무엇을 하는지 누구나 살펴볼 수 있는 맞춤형 인터페이스를 구축하는 것입니다. 맞춤형을 강조하는 이유는, 도메인마다 기성 도구로는 충족하기 어려운 고유한 니즈가 있기 때문입니다. 아파트 임대 대화를 검토할 때는 전체 채팅 기록과 일정 맥락을 한눈에 볼 수 있어야 합니다. 부동산 문의라면 매물 정보와 출처 문서가 바로 옆에 있어야 하죠. 메타데이터를 어디에 배치할지, 어떤 필터를 노출할지처럼 사소한 UX 결정조차 실제로 쓰이는 도구와 외면받는 도구를 가르는 기준이 됩니다.
범용 레이블링 인터페이스와 씨름하며, 하나의 인터랙션을 이해하기 위해 여러 시스템을 뒤지는 팀들을 지켜봐 왔습니다. 마찰은 쌓입니다. 맥락을 보려고 다른 시스템으로 이동하고, 오류 내용을 별도 추적 시트에 복사하고, 정보를 확인하기 위해 도구를 번갈아 사용해야 합니다. 이 마찰은 단순히 팀의 속도를 늦추는 데 그치지 않고, 미묘한 문제를 잡아낼 수 있는 체계적인 분석 자체를 막아버립니다.
잘 설계된 데이터 뷰어를 갖춘 팀은 그렇지 않은 팀보다 10배 빠르게 반복 개선을 수행합니다. 중요한 점은, 이러한 도구를 Cursor나 Loveable 같은 AI 보조 개발 도구를 활용하면 몇 시간 만에 만들 수 있다는 것입니다. 투자 대비 수익을 생각하면 비용은 미미한 수준입니다.
구체적으로 보여드리겠습니다. 앞서 언급한 NurtureBoss를 위해 만든 데이터 뷰어입니다:
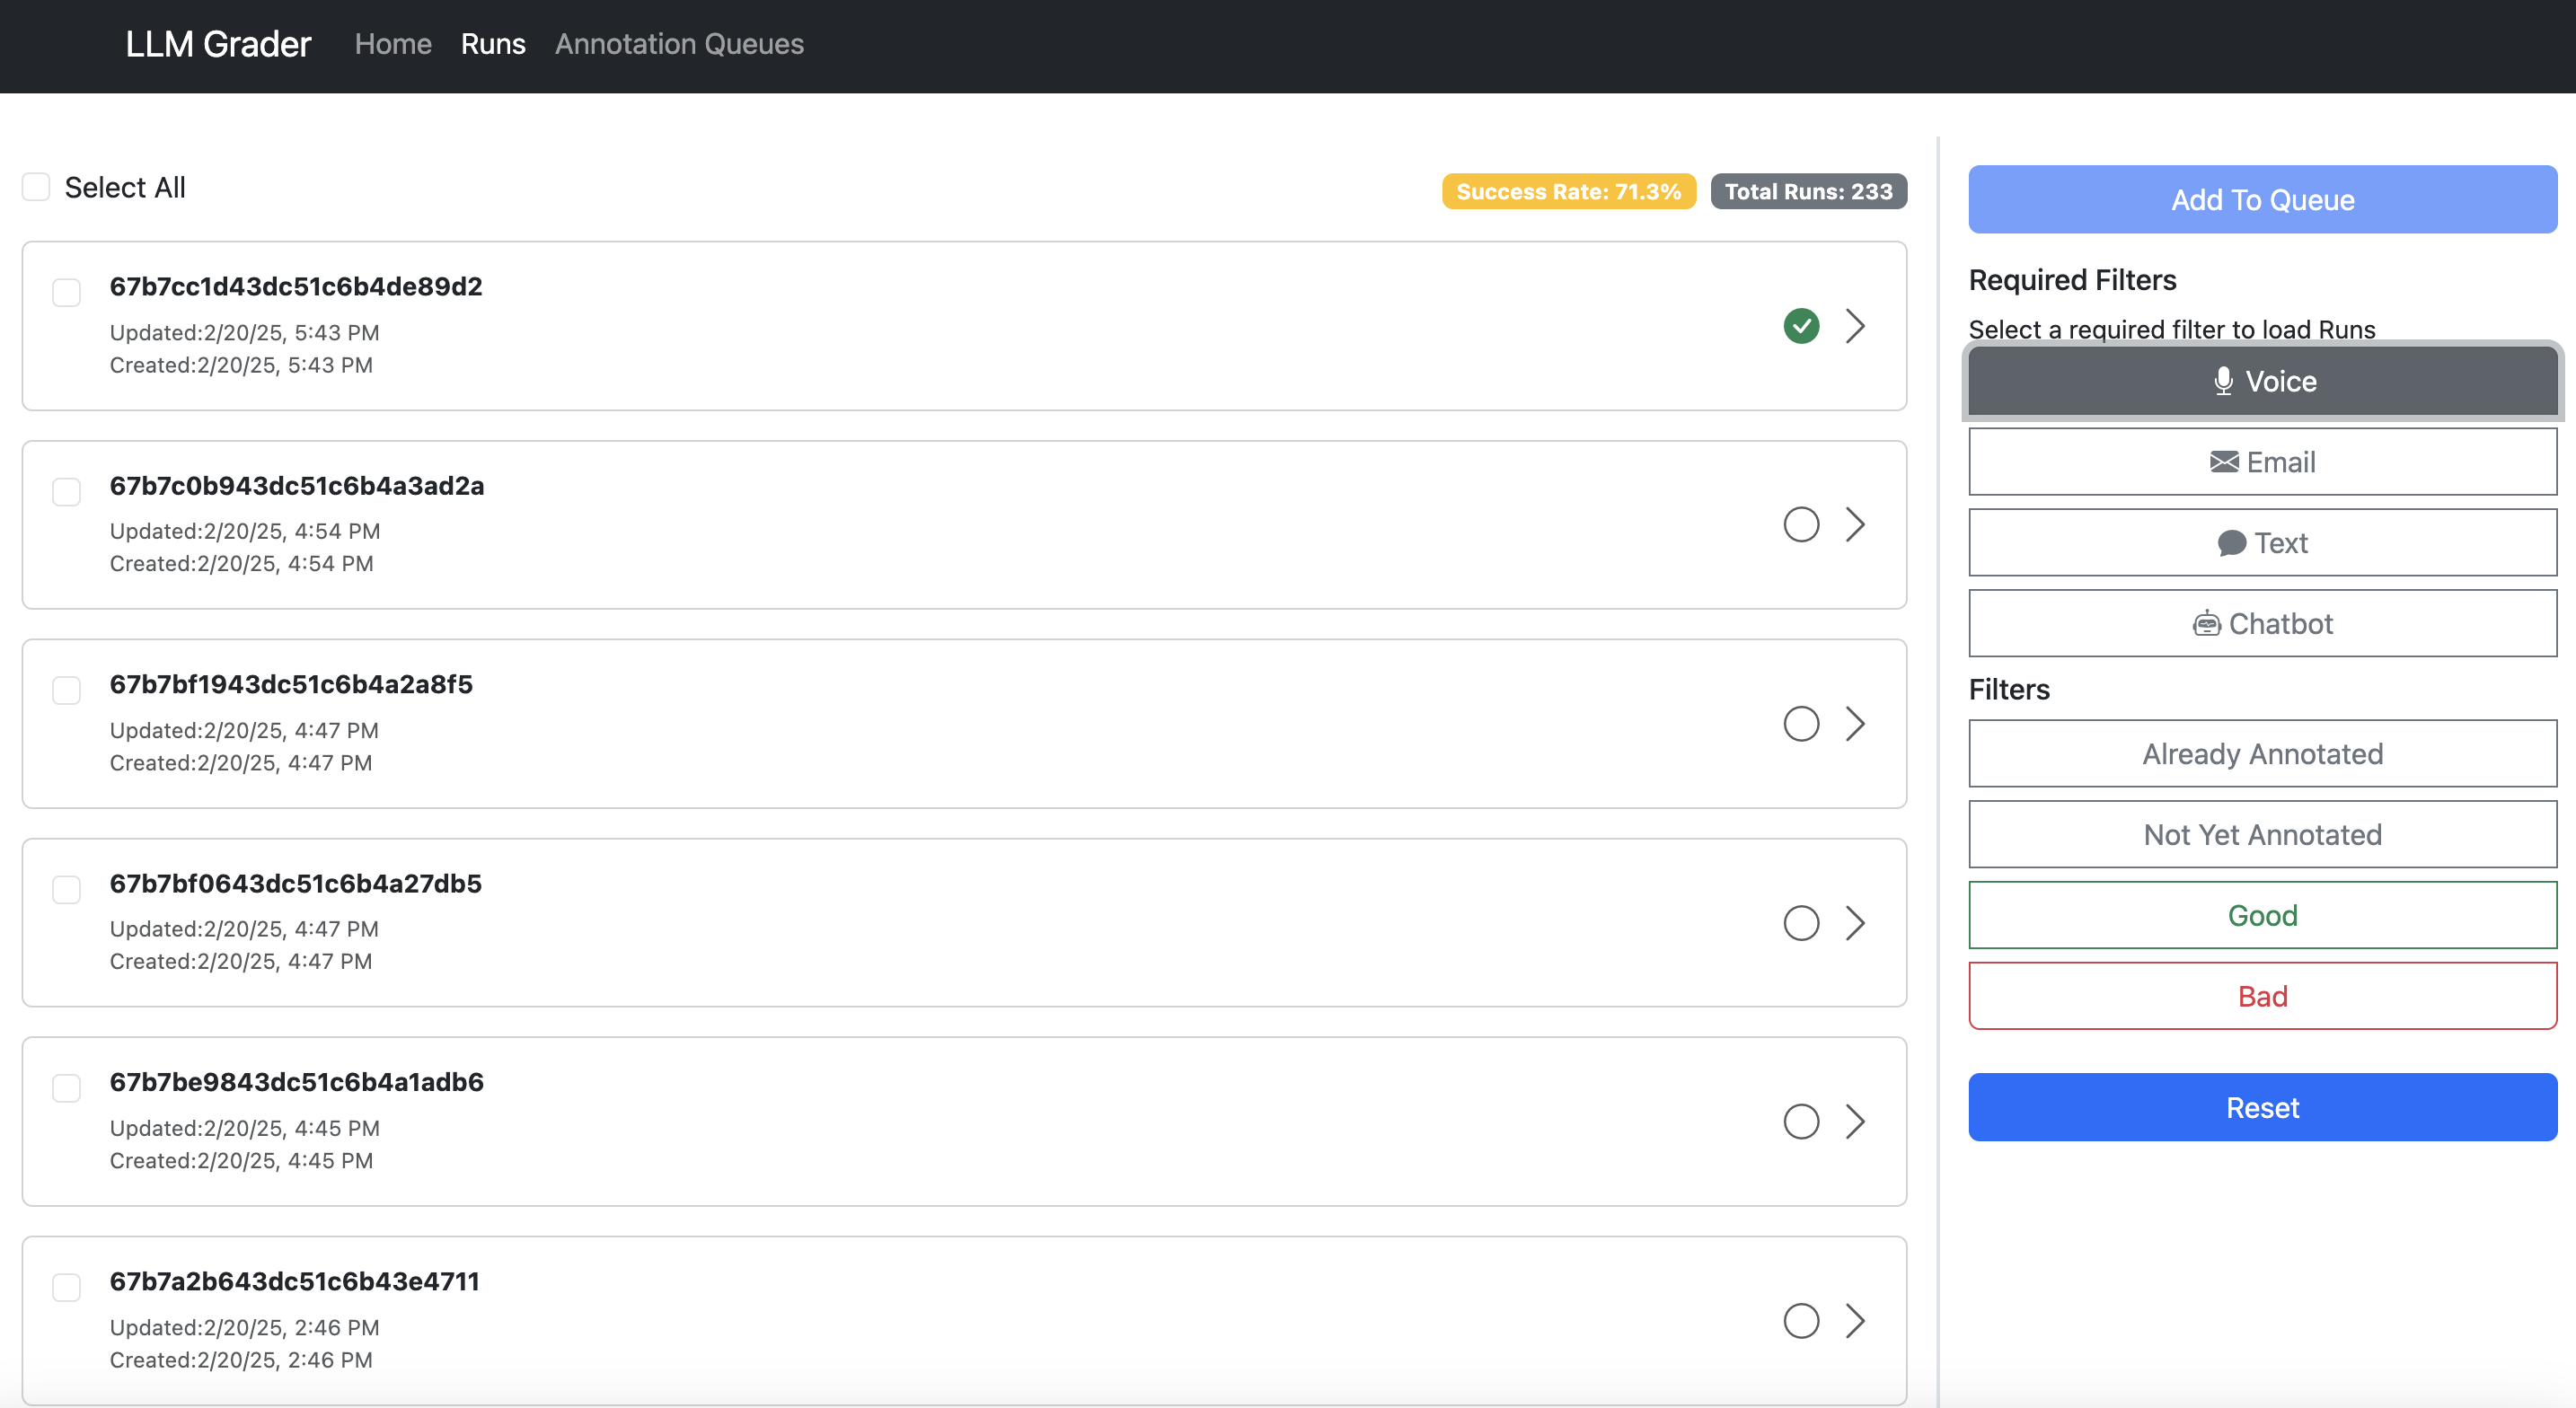
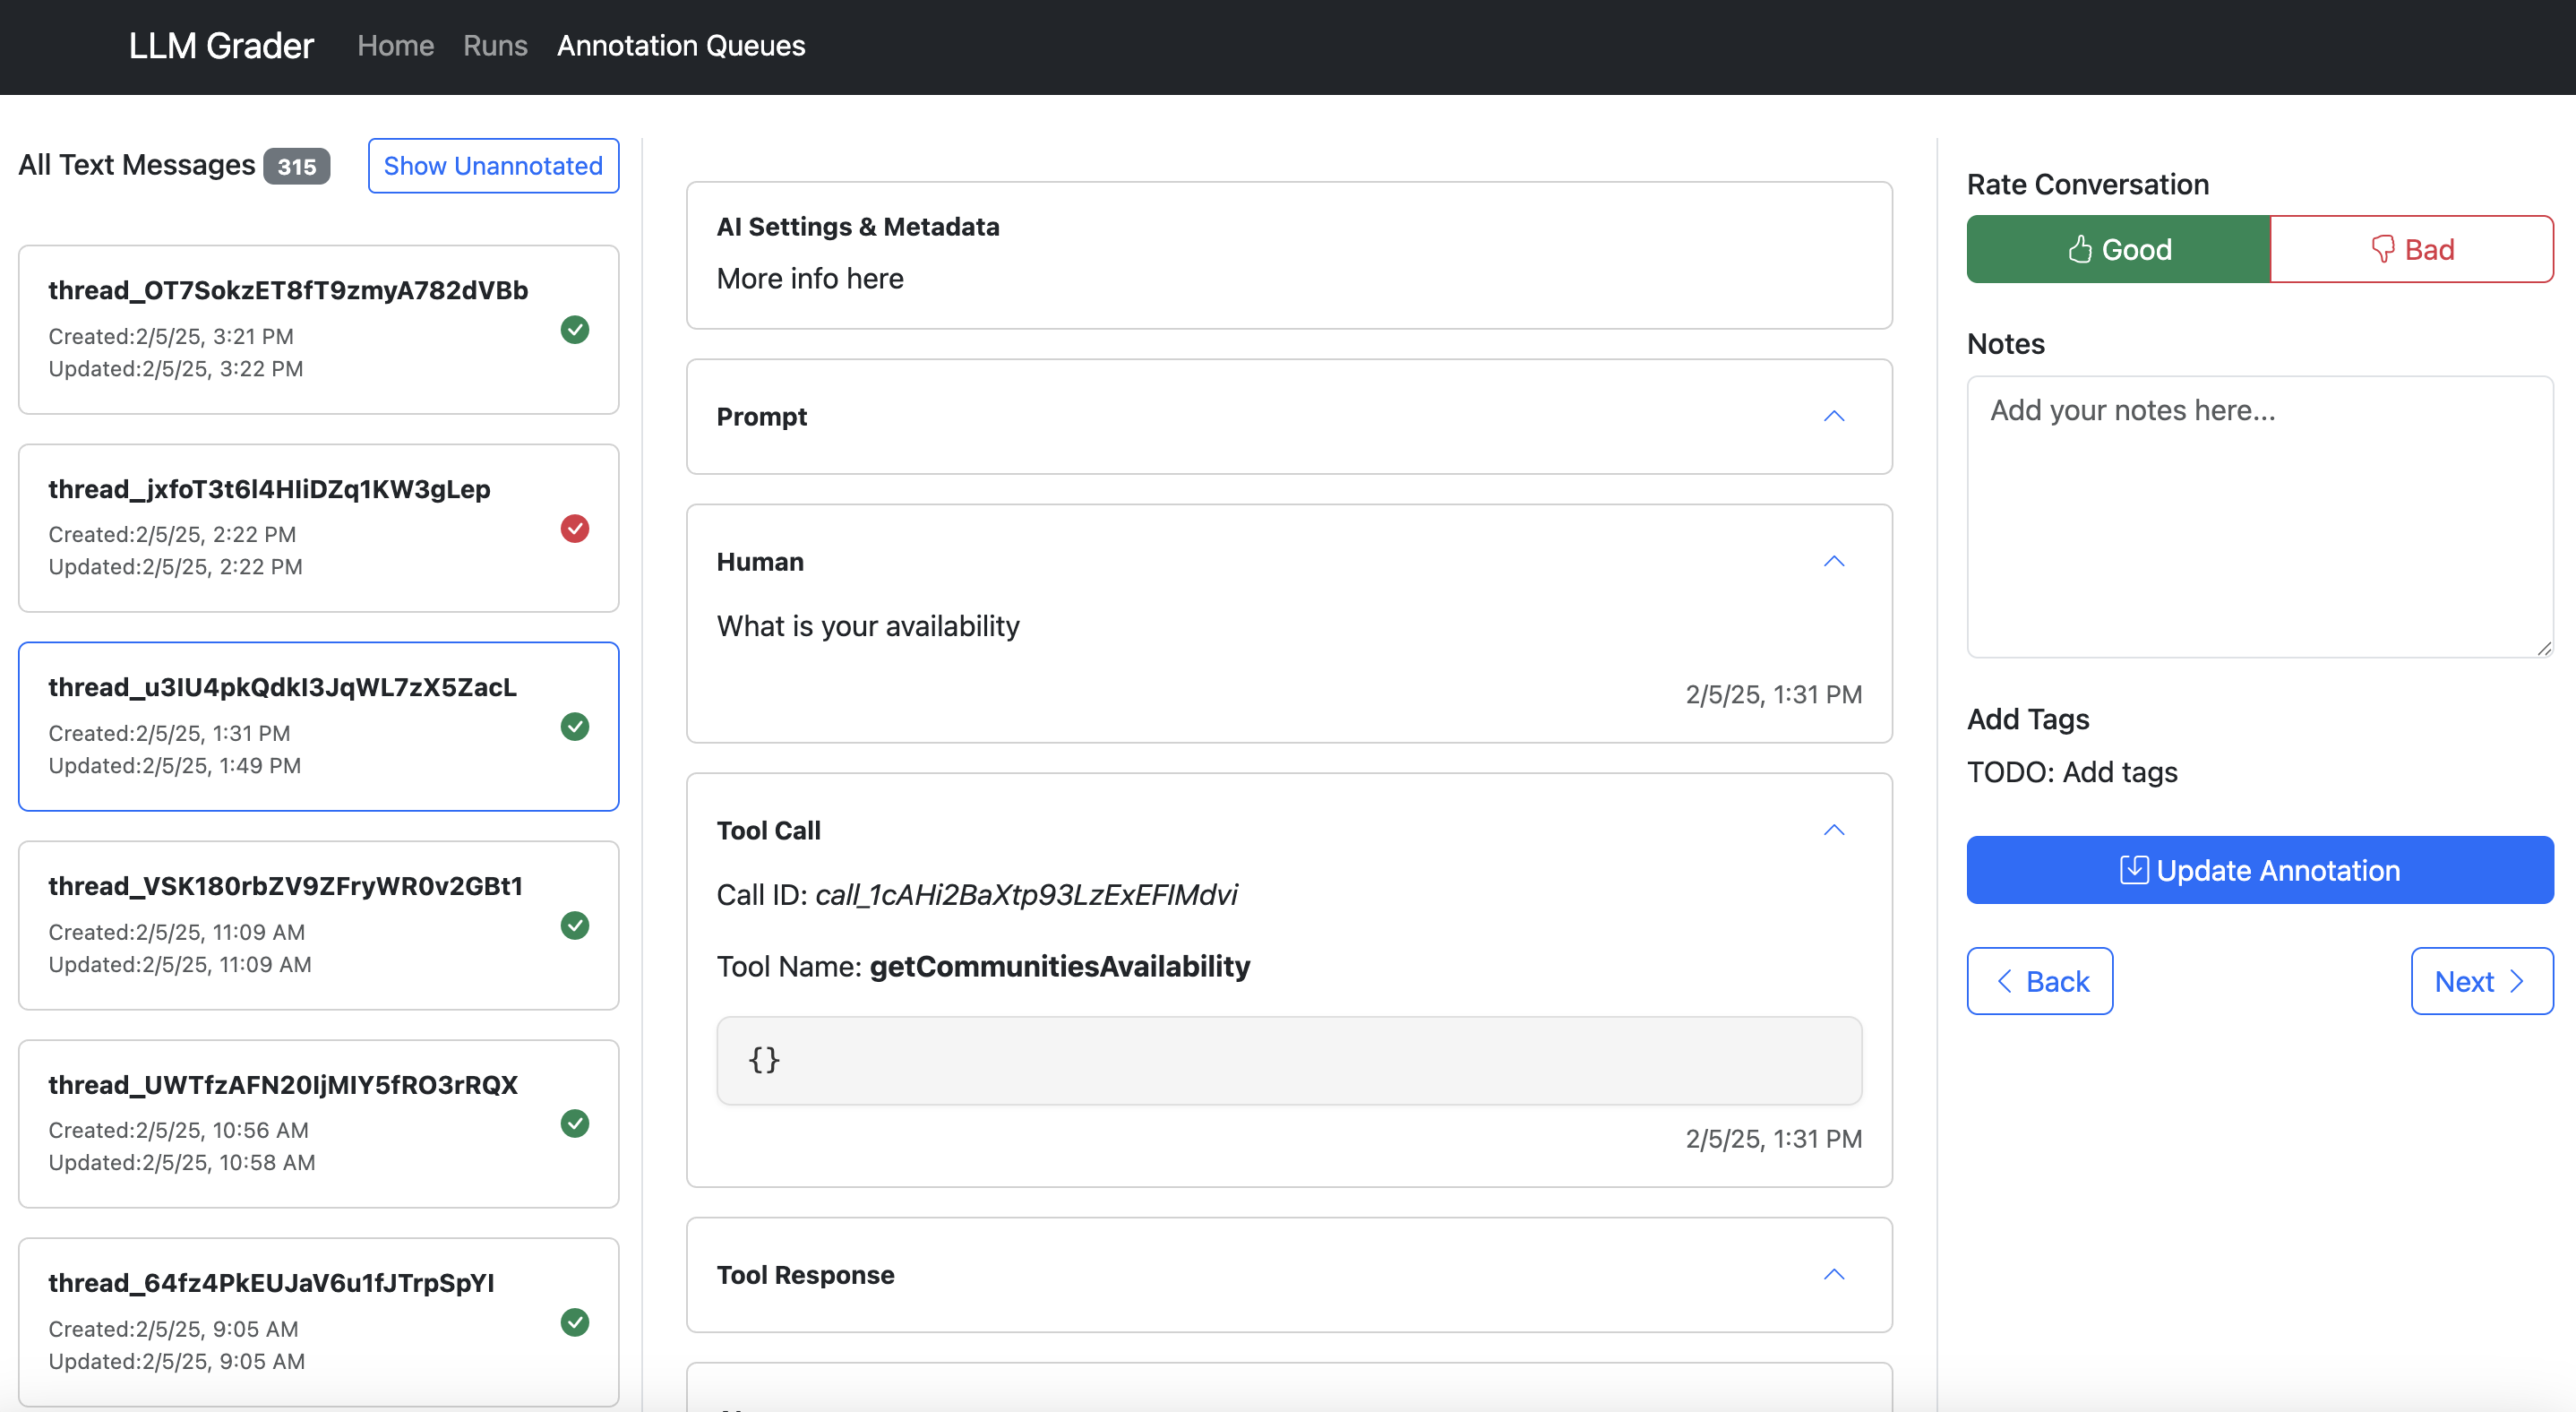
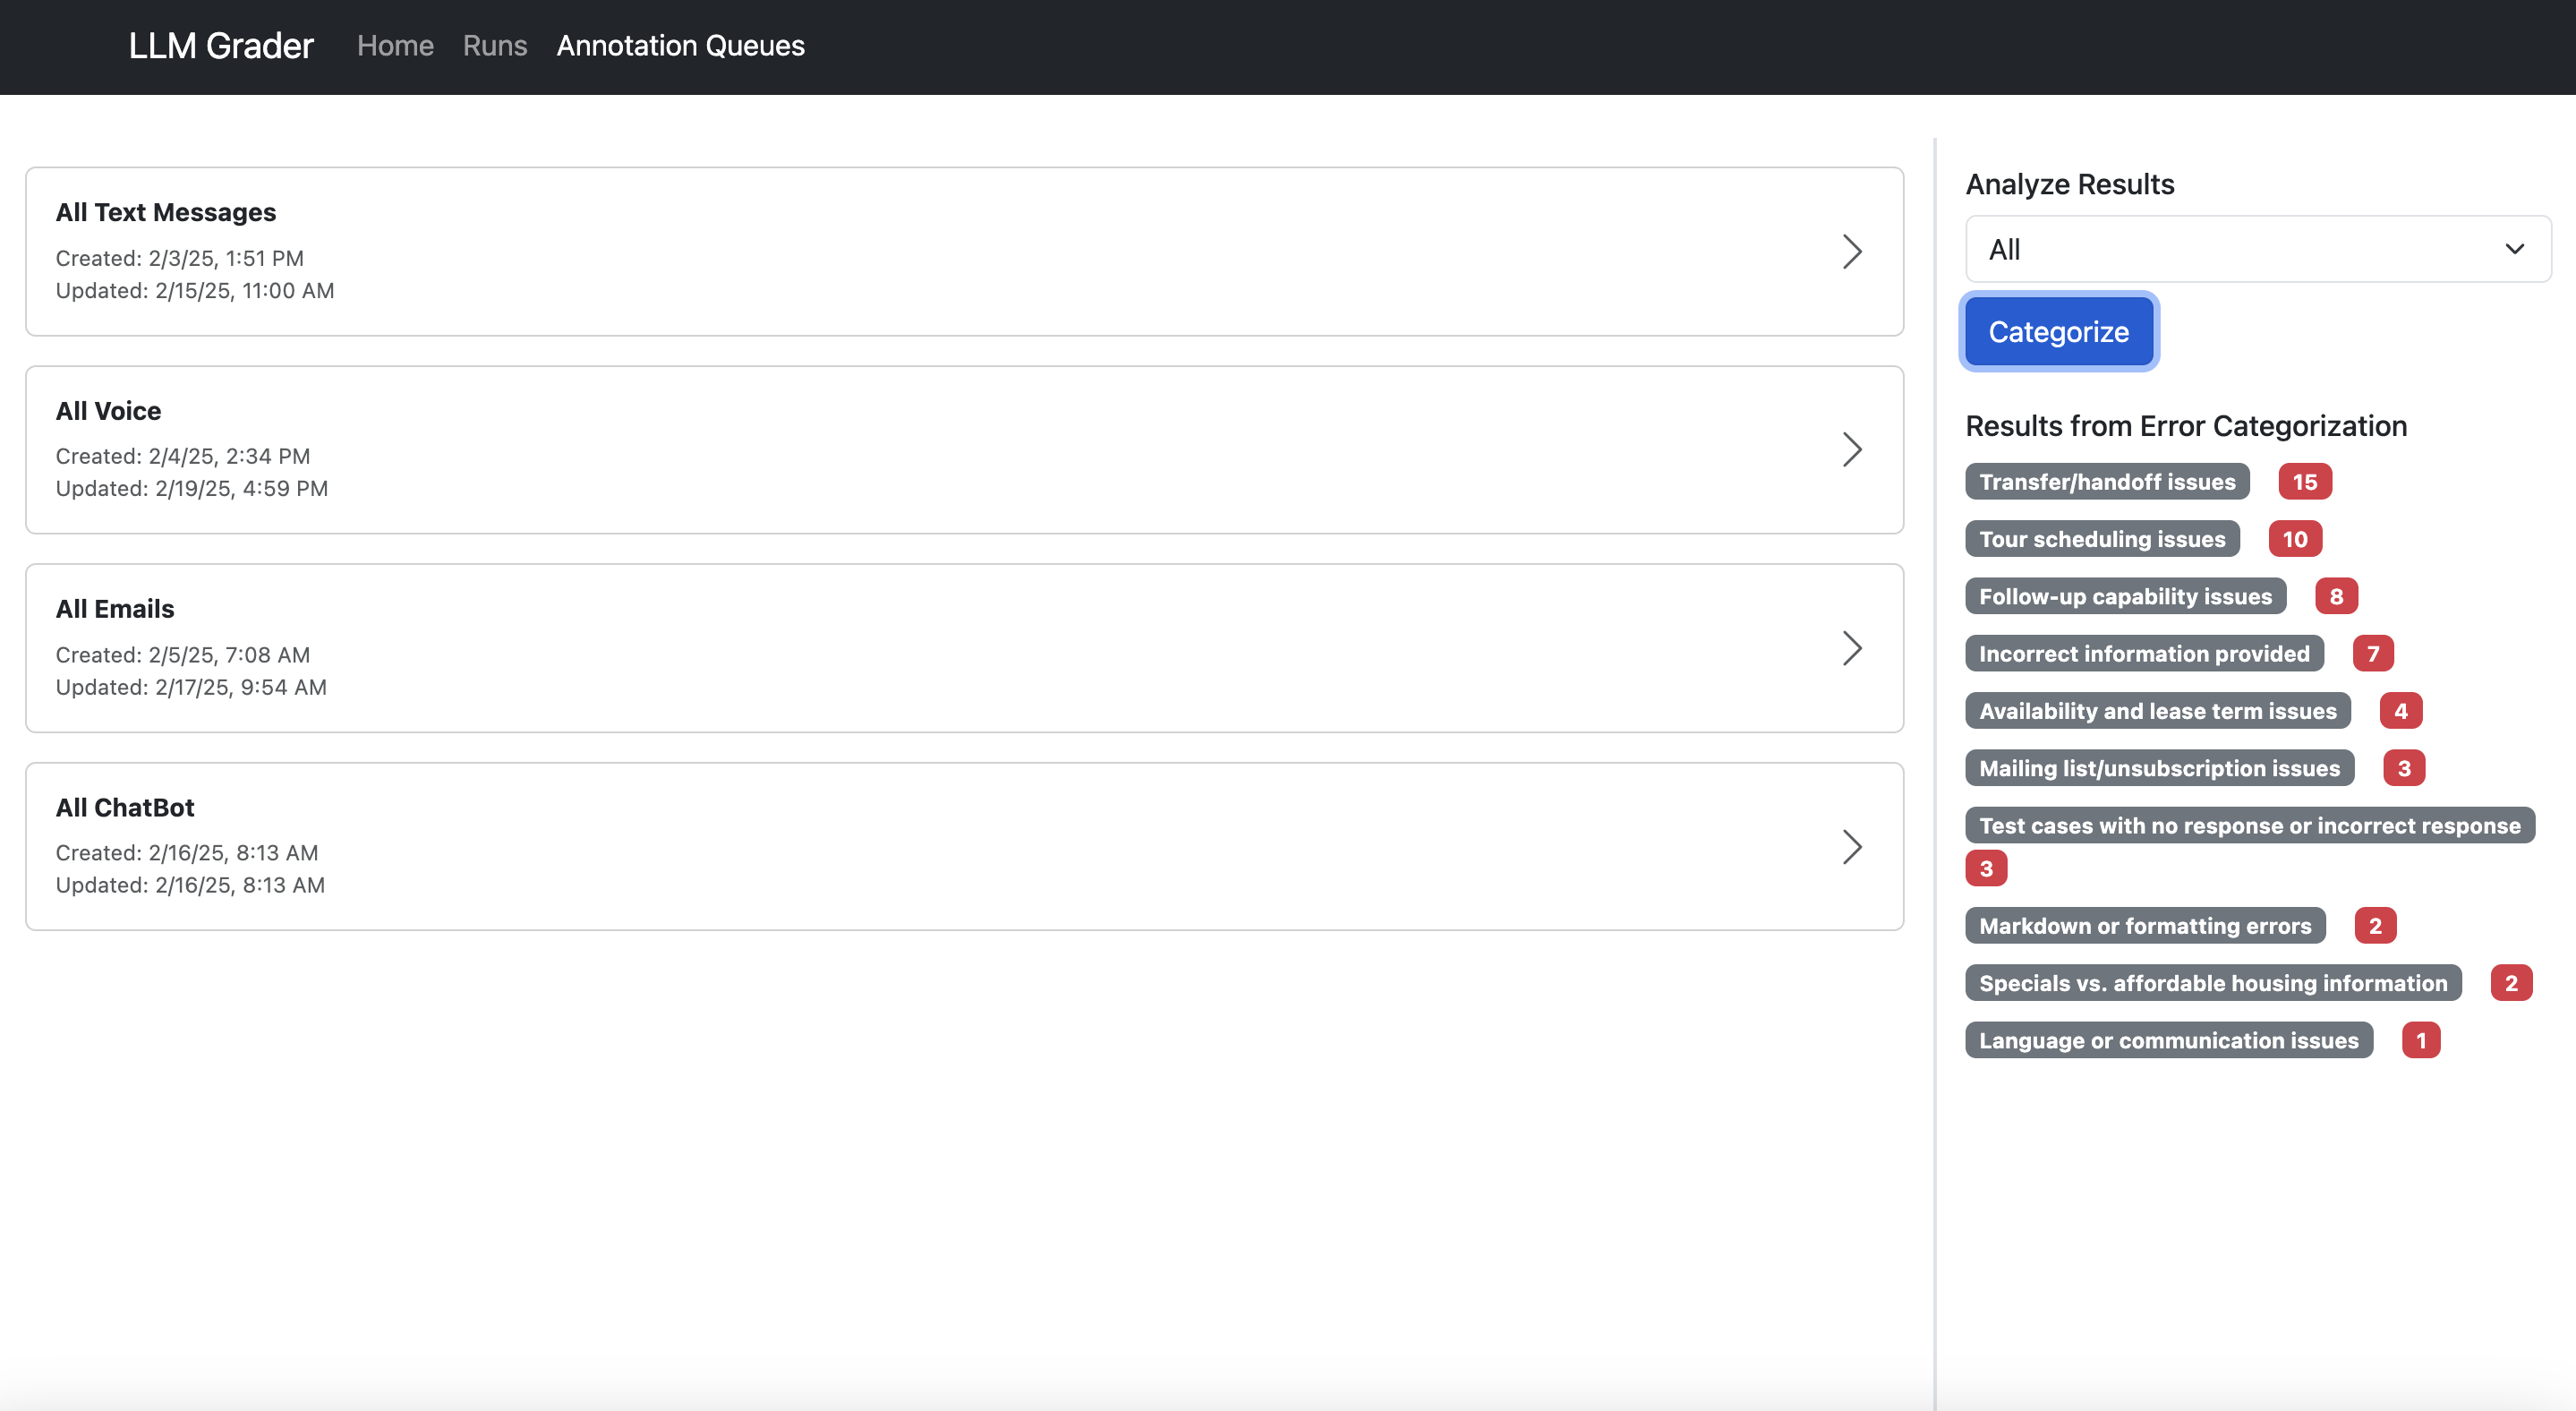
좋은 데이터 주석 도구의 조건은 다음과 같습니다:
- 모든 맥락을 한 곳에 표시하세요. 사용자가 상황을 파악하기 위해 여러 시스템을 뒤지게 만들지 마세요.
- 피드백을 최대한 쉽게 수집하세요. 버튼 한 번으로 정답/오답을 표시할 수 있는 방식이 긴 양식보다 훨씬 낫습니다.
- 자유형 피드백을 수집하세요. 미리 정의된 분류 체계에 맞지 않는 미묘한 문제들을 포착할 수 있습니다.
- 빠른 필터링과 정렬 기능을 제공하세요. 팀이 특정 오류 유형을 쉽게 파고들 수 있어야 합니다. 위 예시에서 NurtureBoss는 채널(음성, 문자, 채팅)이나 특정 매물로 빠르게 필터링할 수 있습니다.
- 클릭 없이 데이터 예시를 탐색하고 주석을 달 수 있는 단축키를 제공하세요.
어떤 웹 프레임워크를 사용하든 상관없습니다. 익숙한 것을 쓰면 됩니다. 저는 파이썬 개발자이기 때문에 현재 FastHTML과 MonsterUI를 즐겨 씁니다. 작은 파이썬 파일 하나로 백엔드와 프론트엔드 코드를 모두 정의할 수 있기 때문입니다.
중요한 건 어디서든 시작하는 것입니다. 설령 단순하더라도요. 맞춤형 웹 앱이 가장 좋은 경험을 제공하지만, 처음이라면 스프레드시트만 해도 없는 것보다는 훨씬 낫습니다. 필요가 커지면 도구도 그에 맞게 발전시키면 됩니다.
이는 또 다른 역설적인 교훈으로 이어집니다. AI 시스템을 가장 잘 개선할 수 있는 사람은 종종 AI에 대해 가장 모르는 사람일 수 있습니다.
3. 도메인 전문가에게 프롬프트 작성 권한을
최근 LLM 기반 인터랙티브 학습 플랫폼을 만드는 교육 스타트업과 작업했습니다. 학습 설계 전문가인 이 회사의 프로덕트 매니저는 교수법 원칙과 예시 대화를 담은 상세한 파워포인트 자료를 만들어 엔지니어링 팀에 전달했고, 엔지니어들은 그것을 프롬프트로 변환했습니다.
그런데 생각해보면, 프롬프트는 그냥 자연어입니다. 학습 전문가가 파워포인트로 교수법을 전달하고, 엔지니어가 그것을 다시 자연어 프롬프트로 번역하는 과정 자체가 불필요한 마찰입니다. 성공하는 팀들은 이 모델을 뒤집어 도메인 전문가가 직접 프롬프트를 작성하고 반복 개선할 수 있는 도구를 제공합니다.
장벽이 아닌 다리를 놓으세요
프롬프트 플레이그라운드가 이를 위한 좋은 출발점입니다. Arize, Langsmith, Braintrust 같은 도구를 사용하면 팀이 다양한 프롬프트를 빠르게 테스트하고, 예시 데이터셋을 입력해 결과를 비교할 수 있습니다. 아래는 이 도구들의 스크린샷입니다:
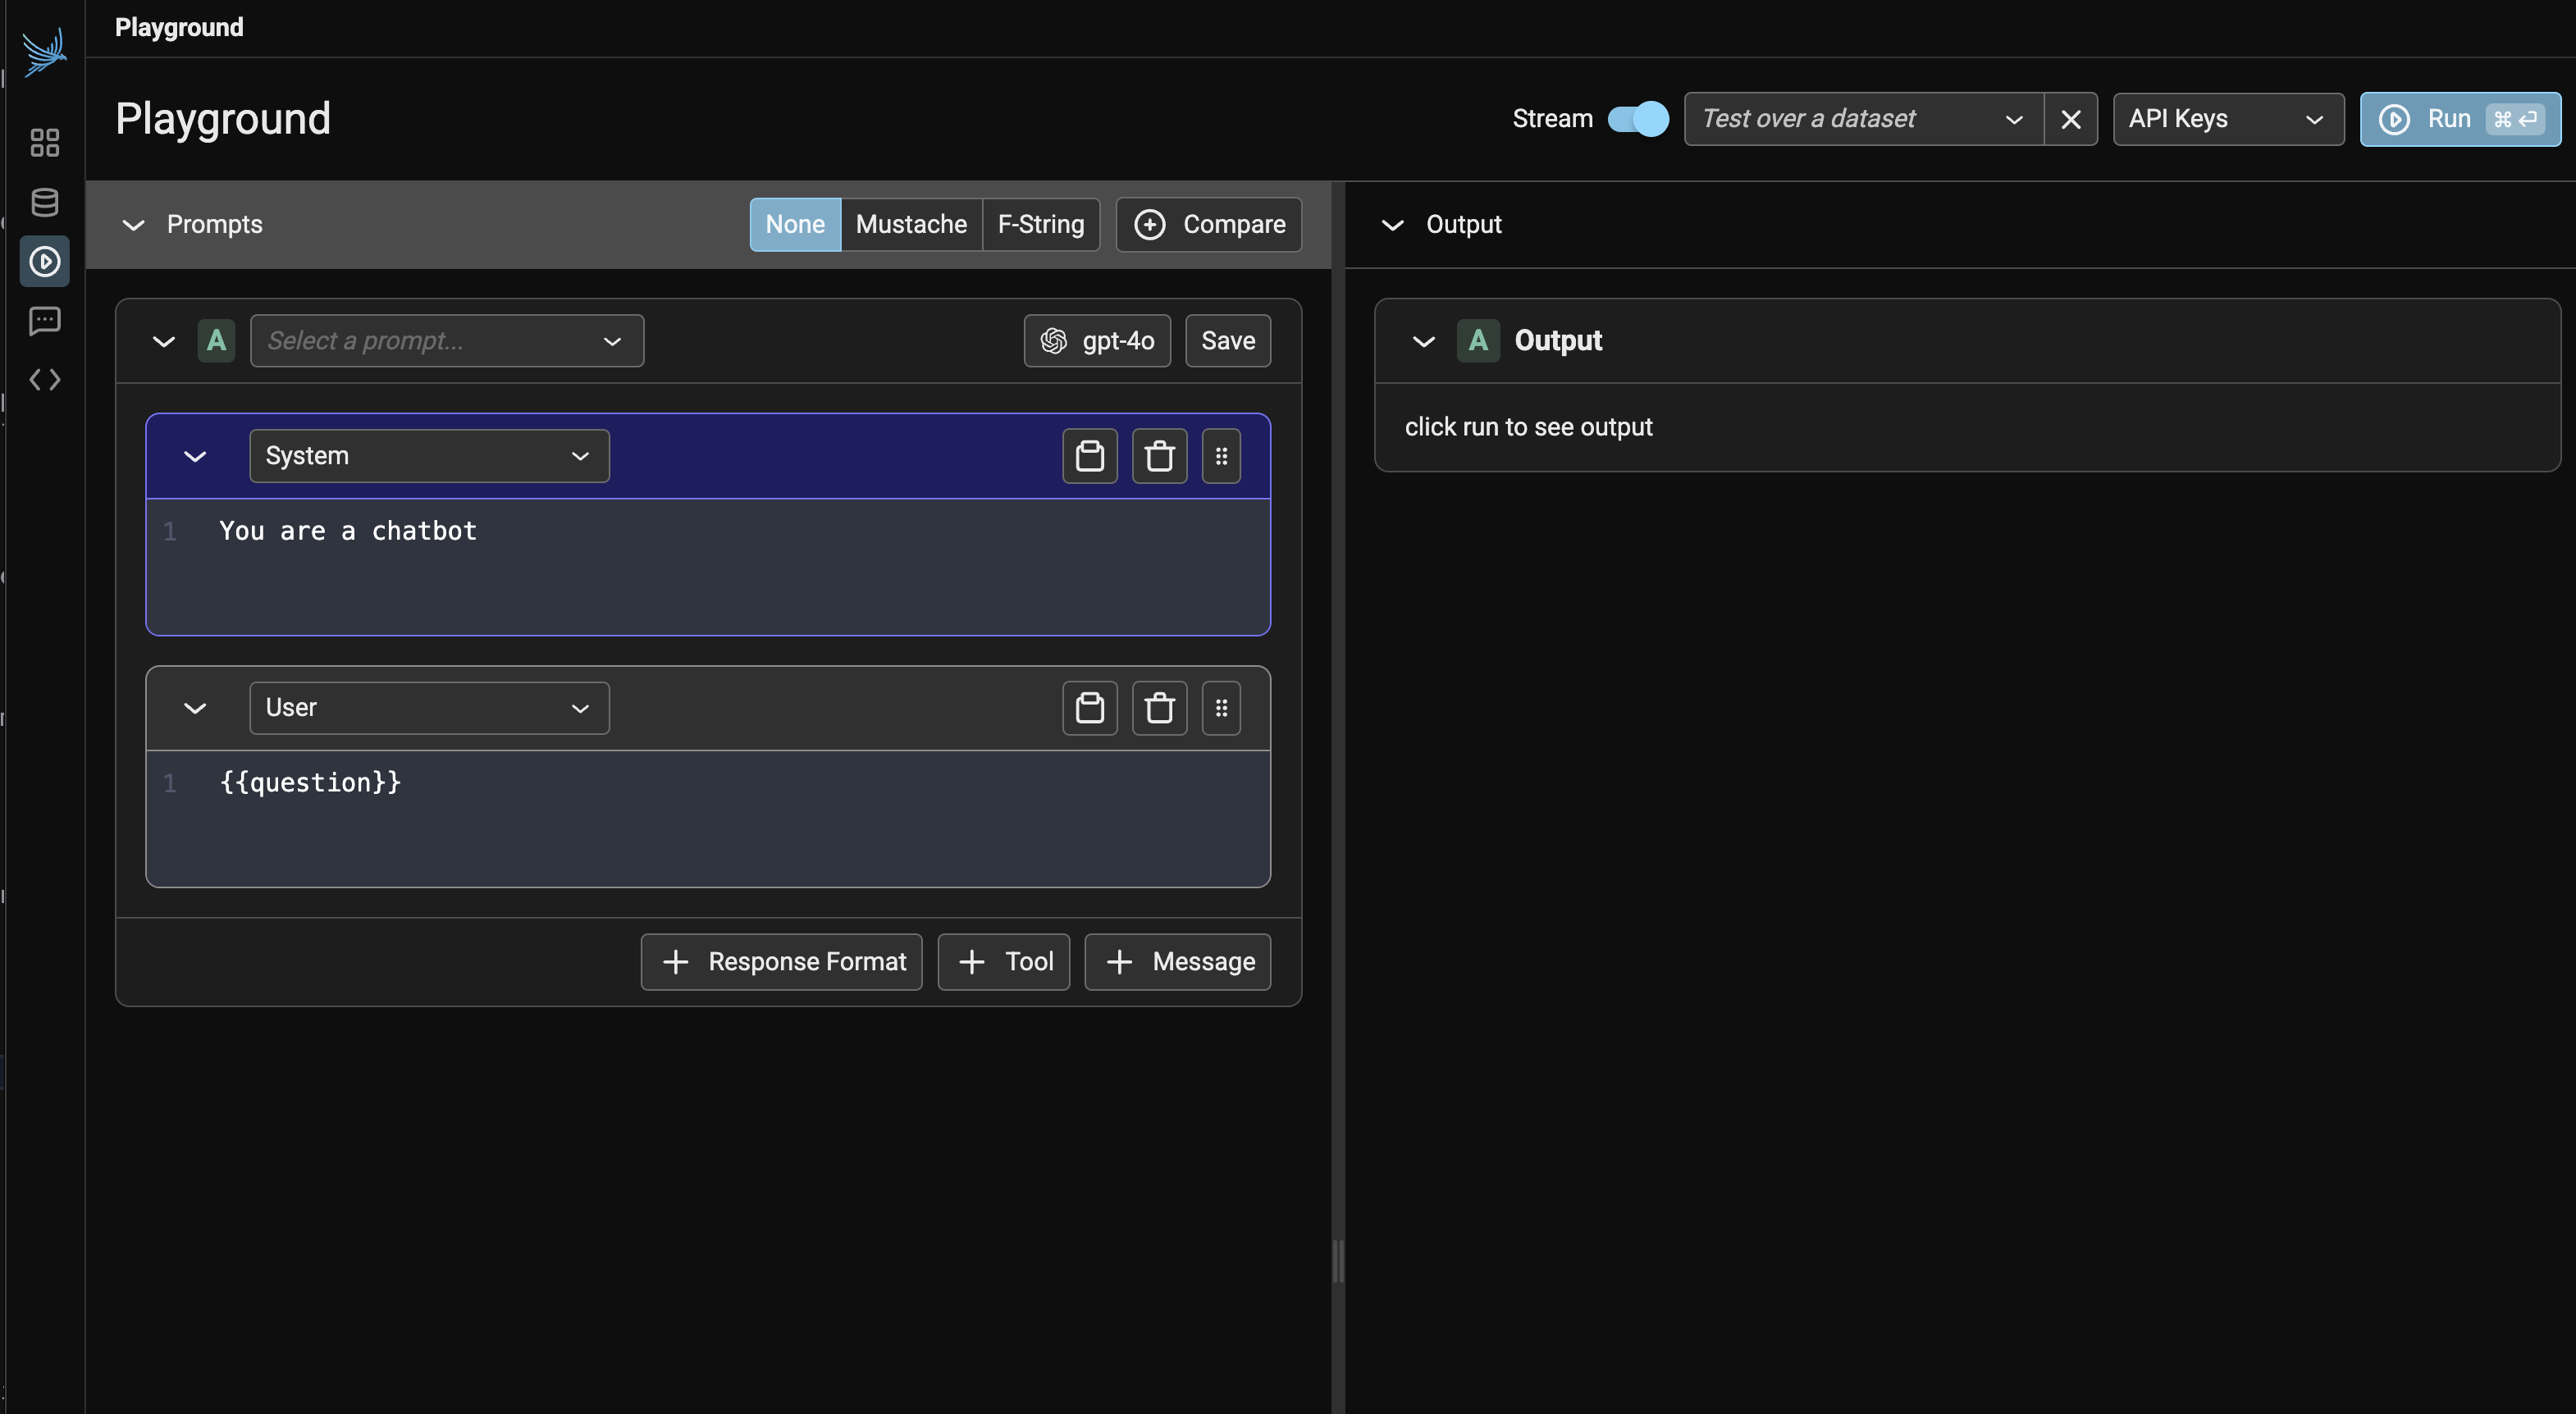
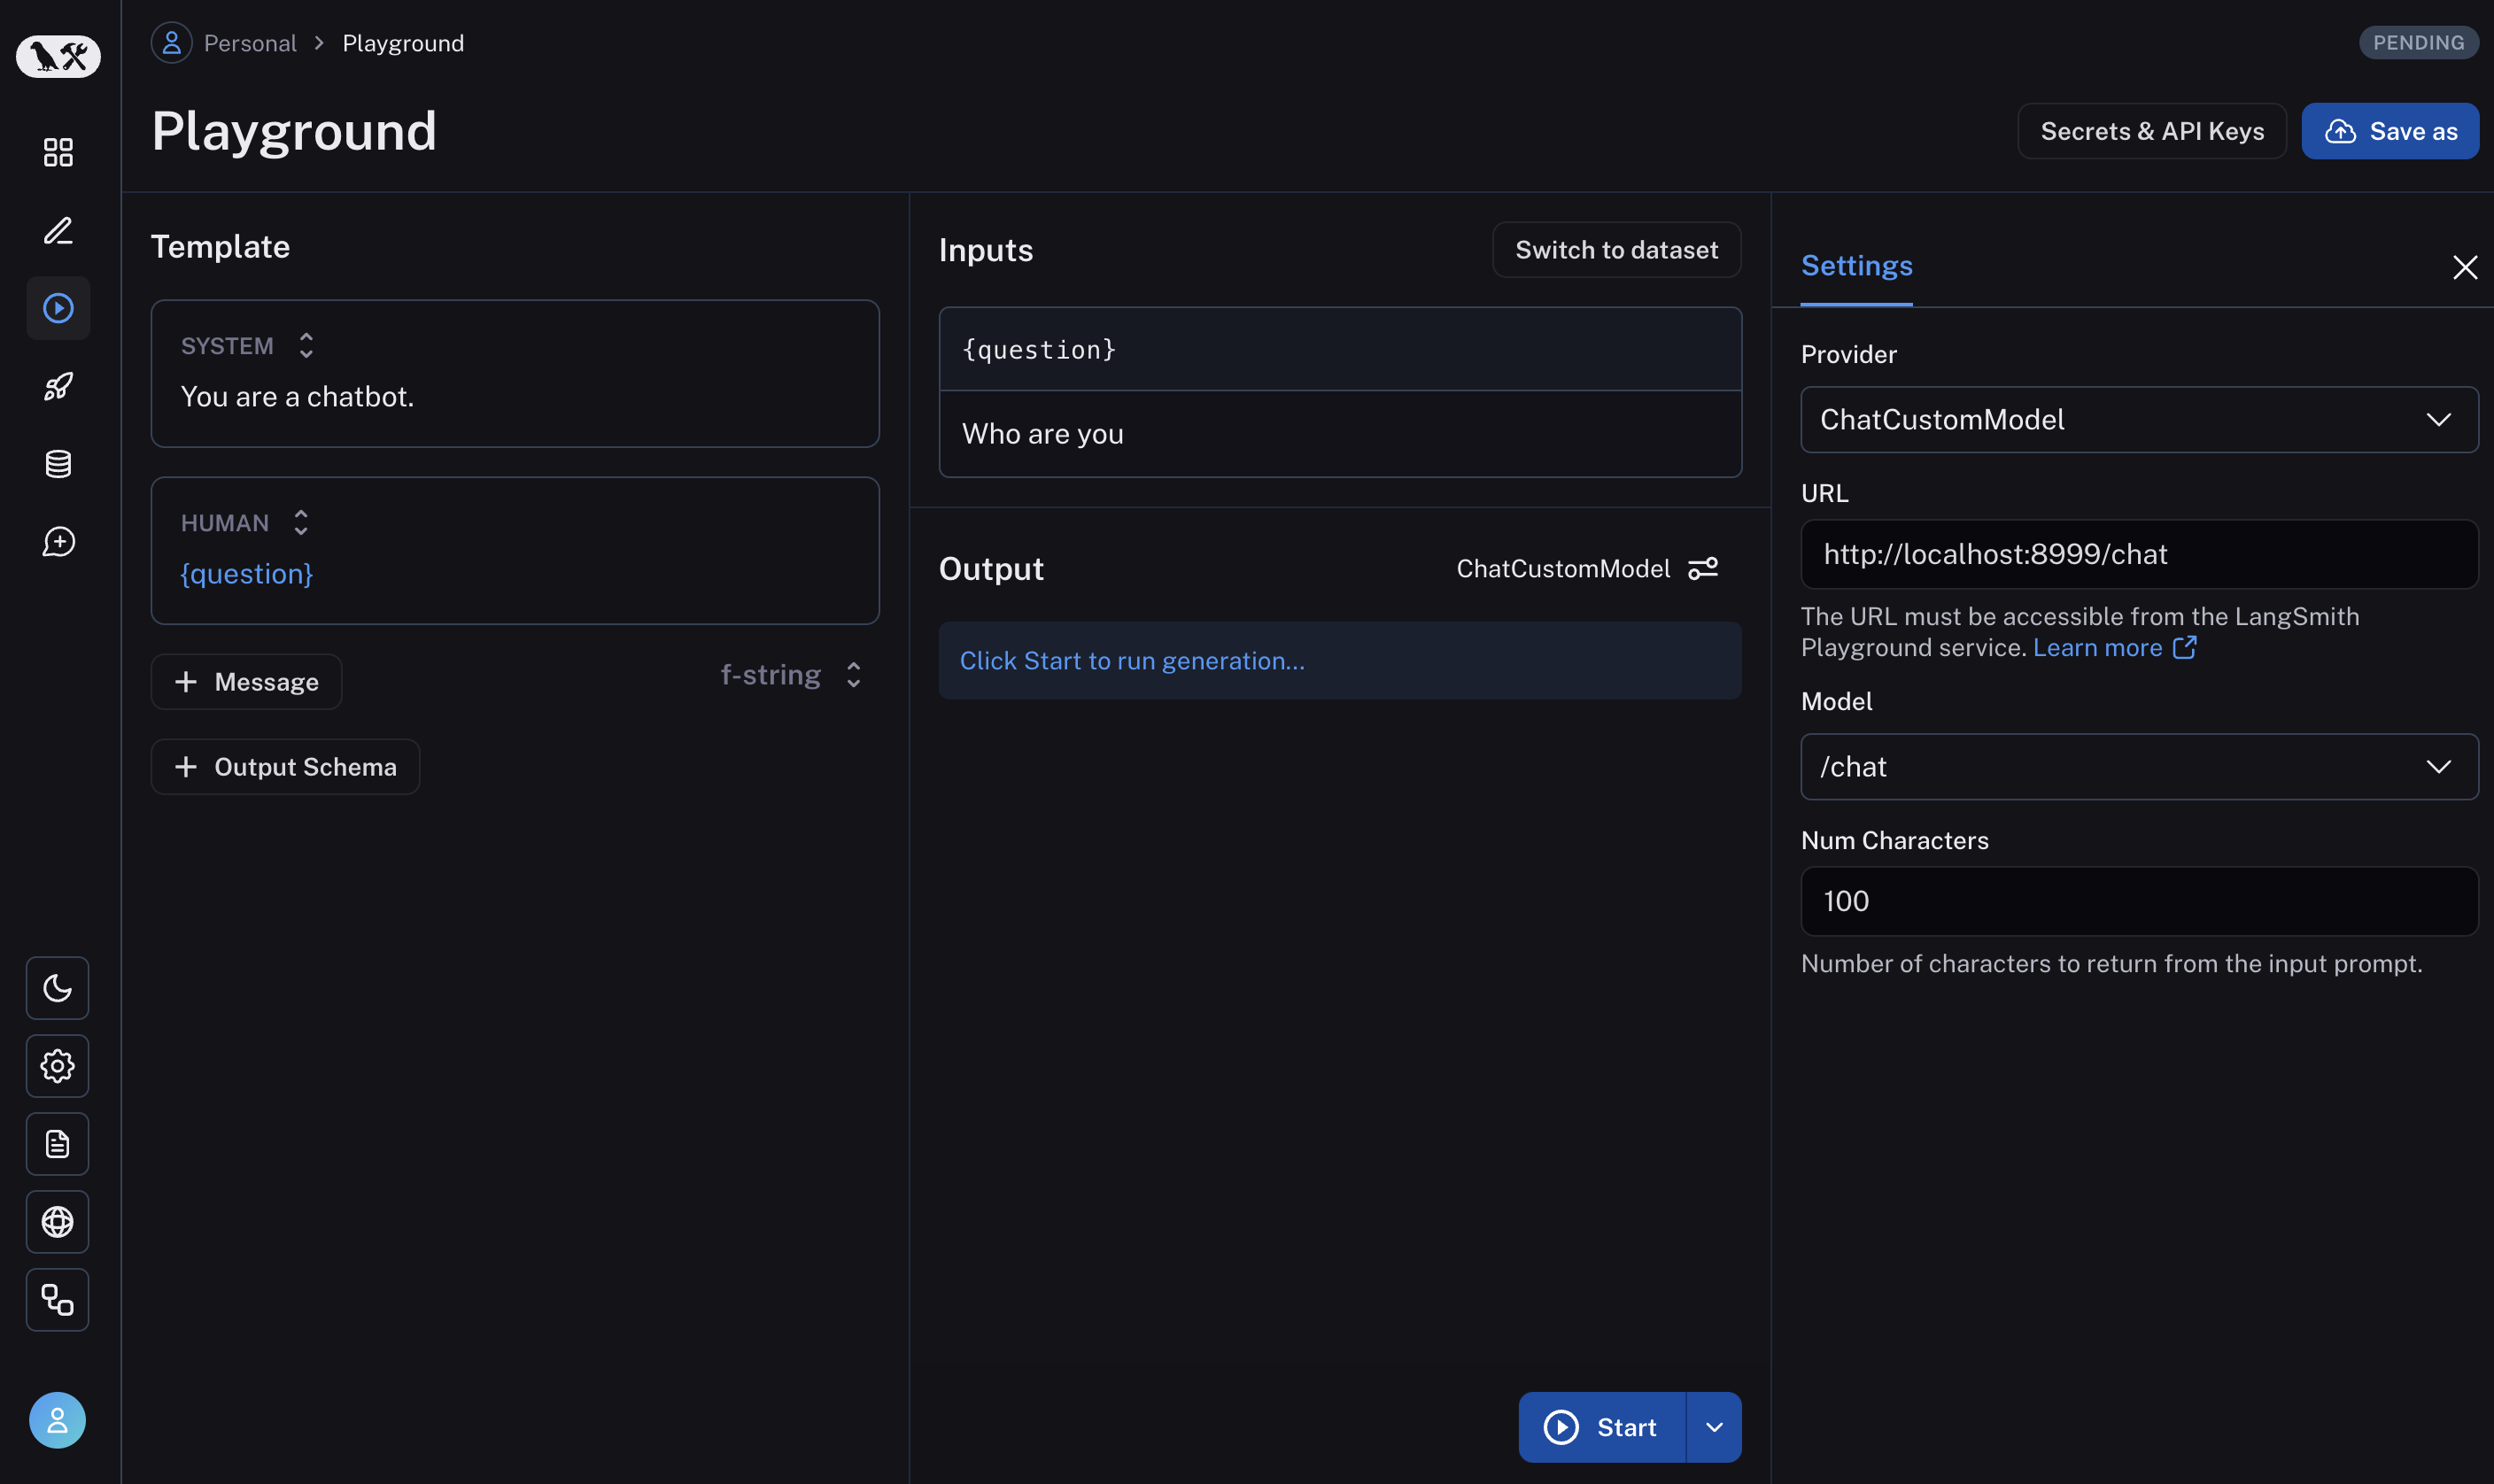
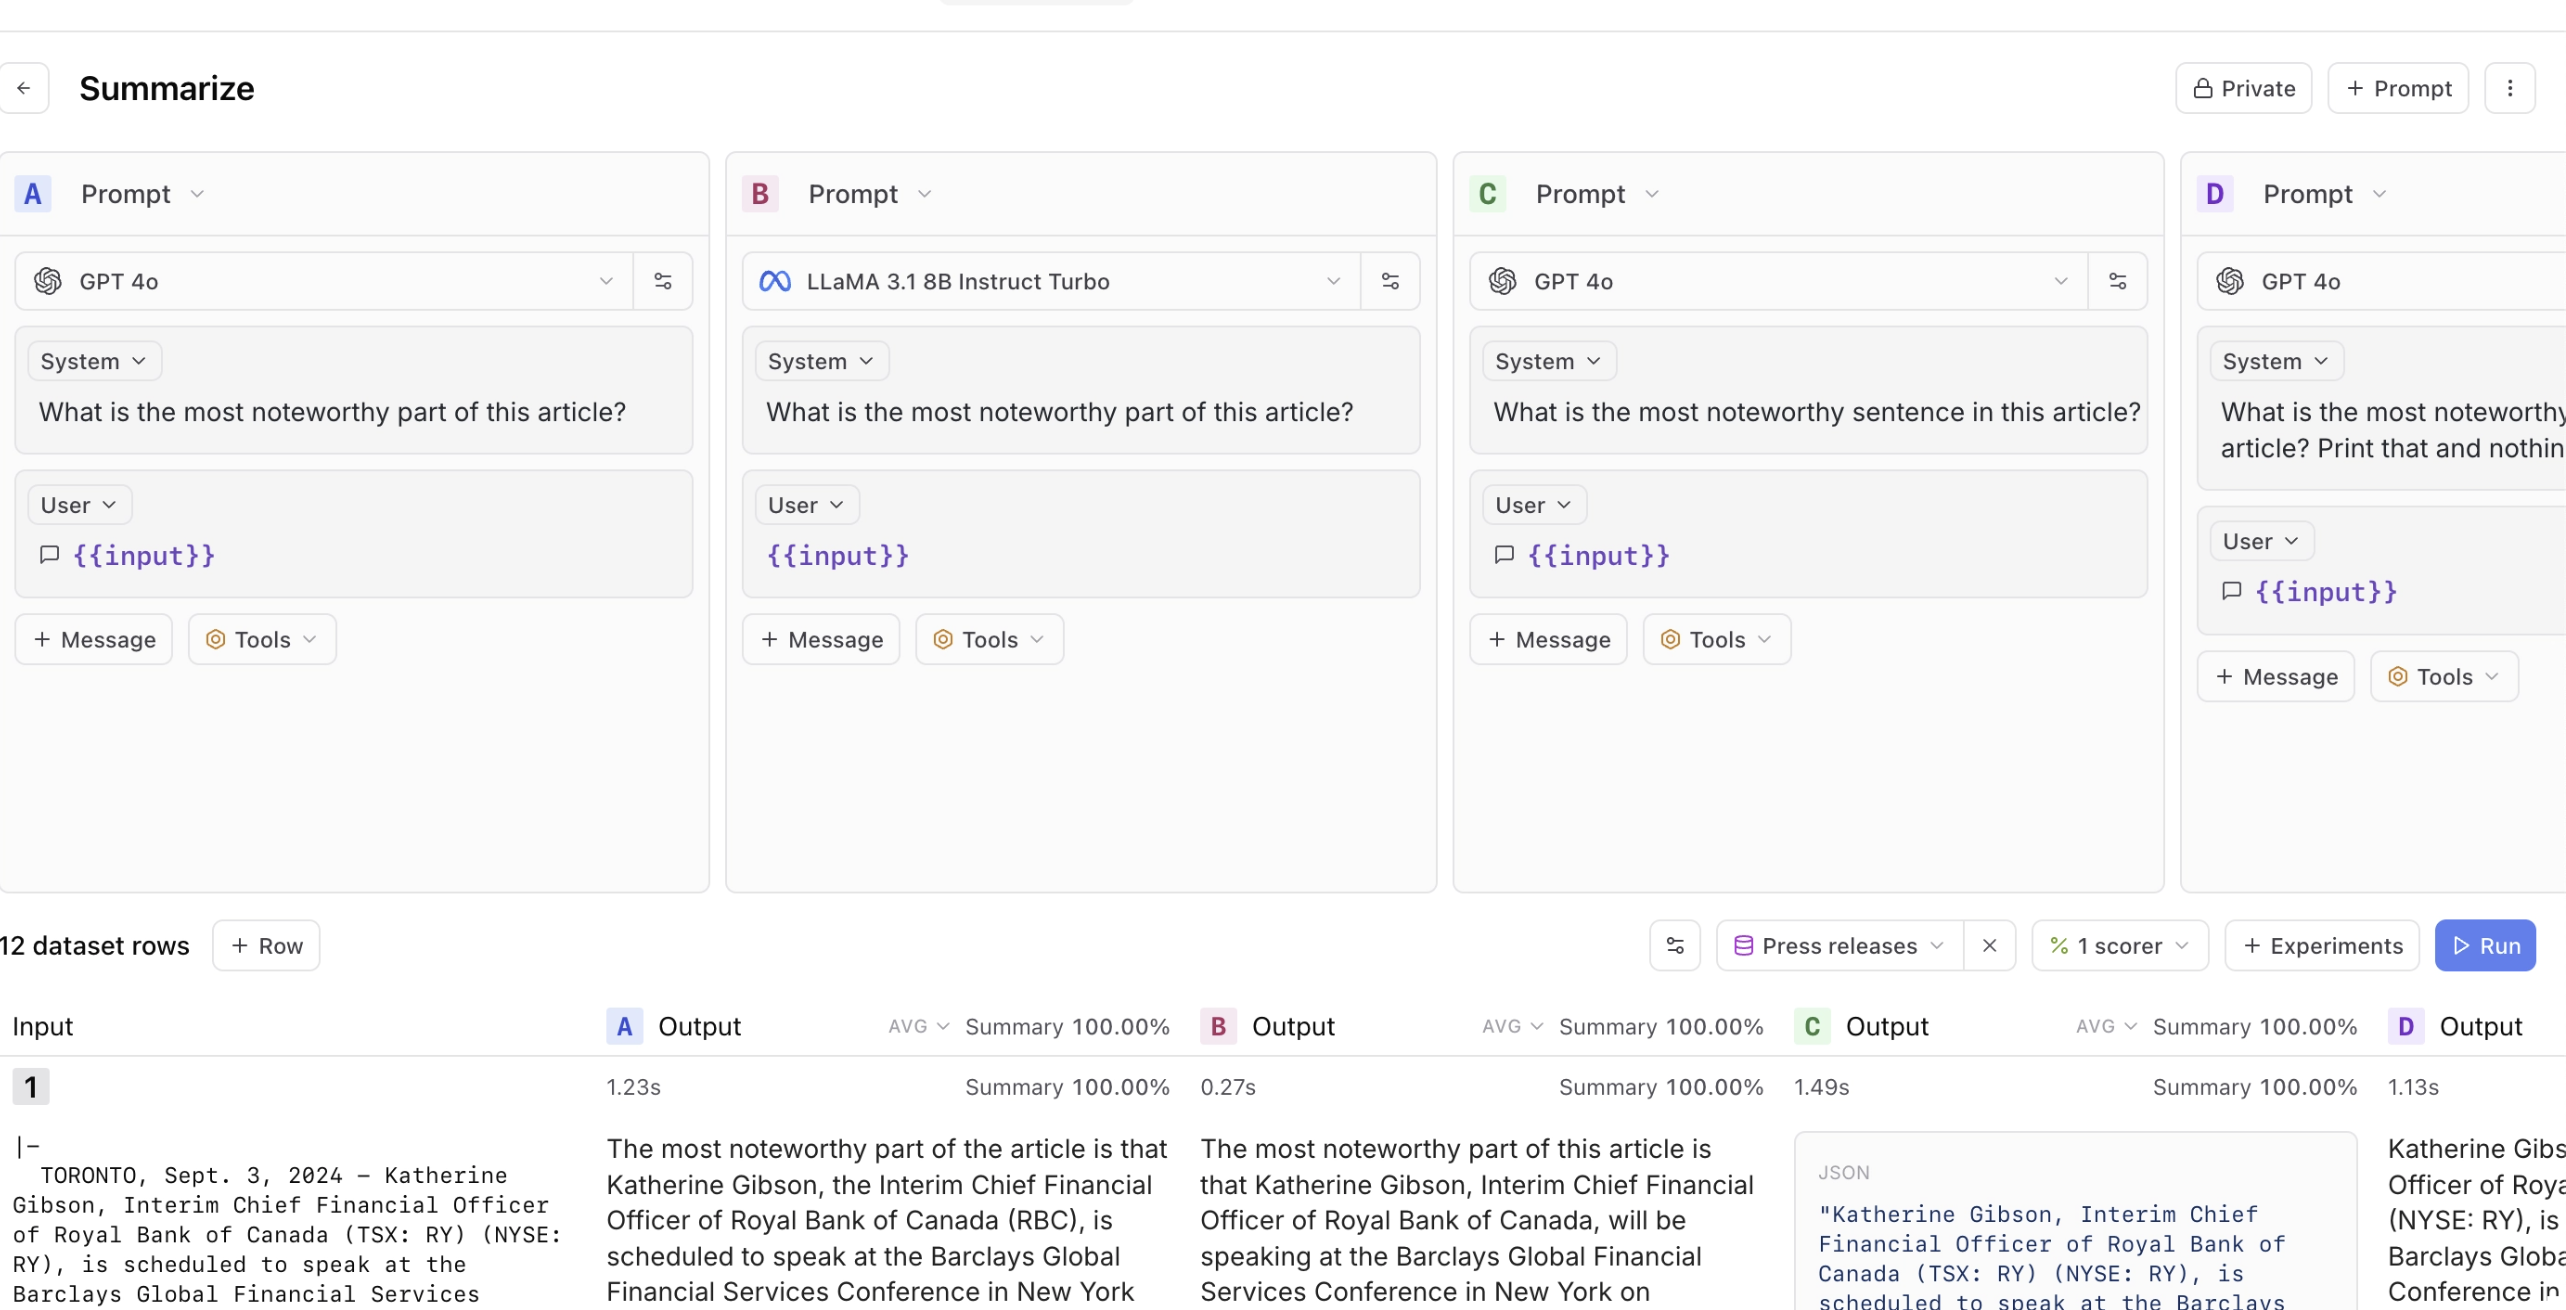
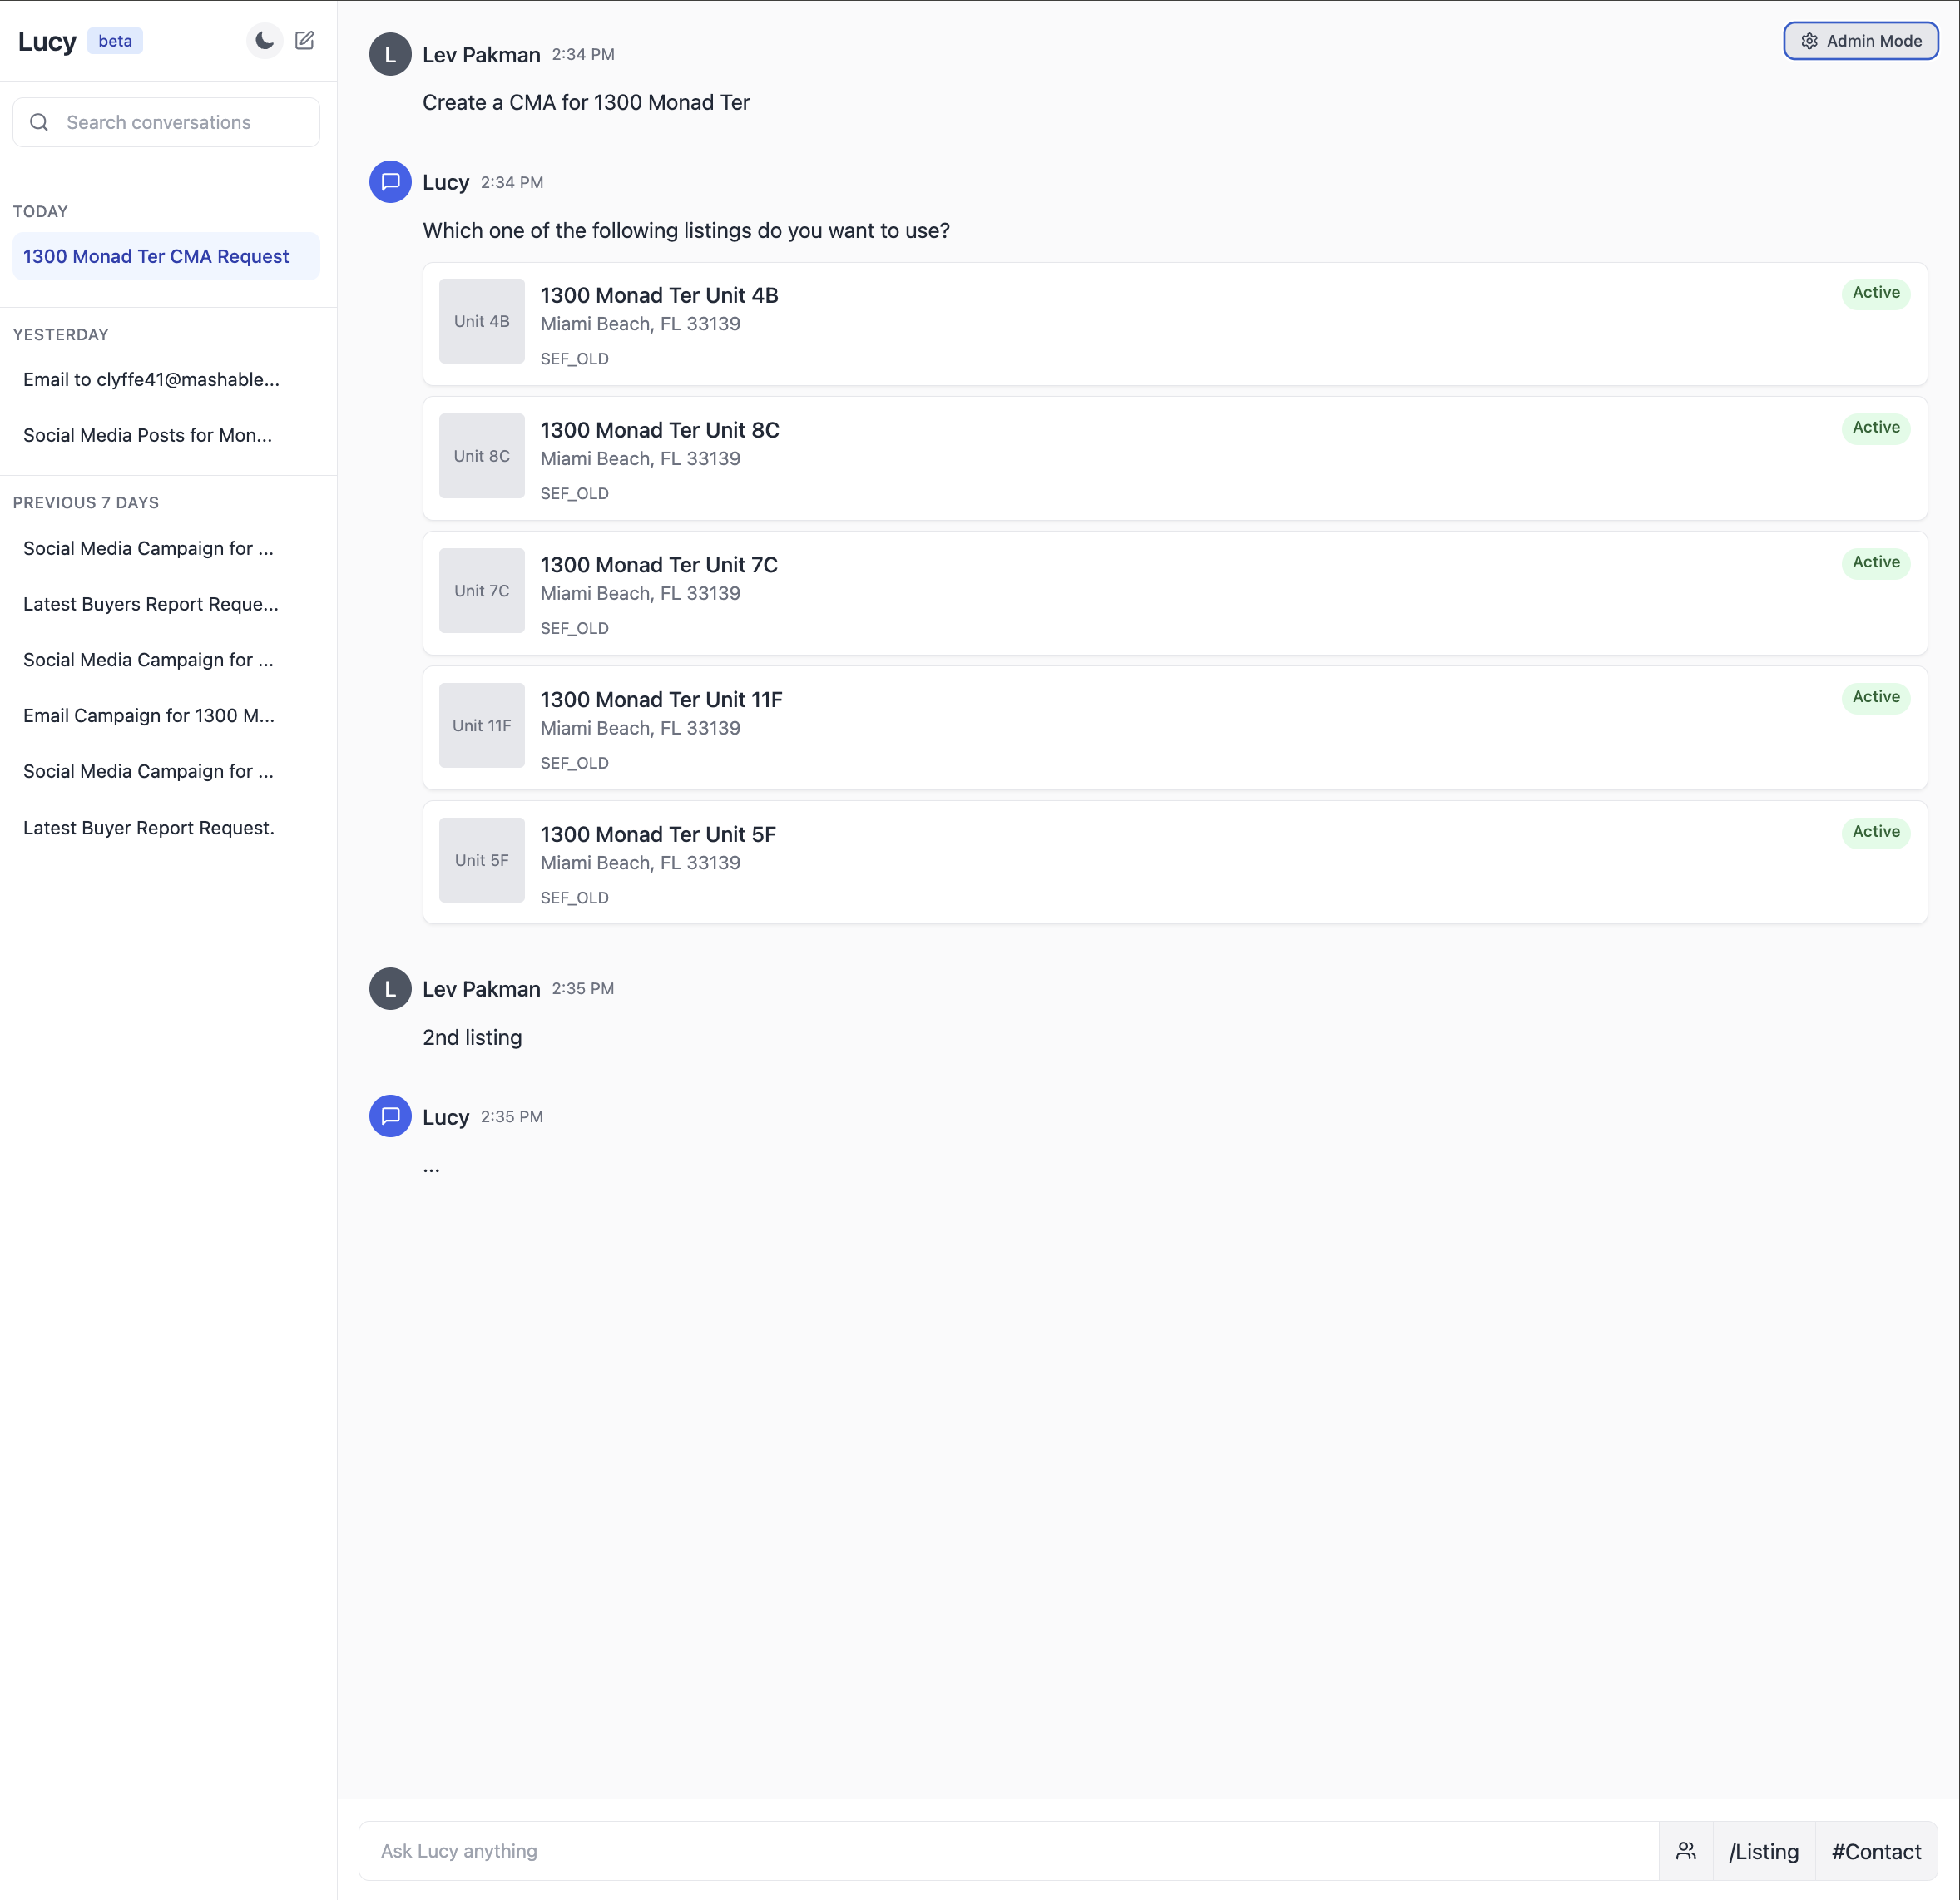
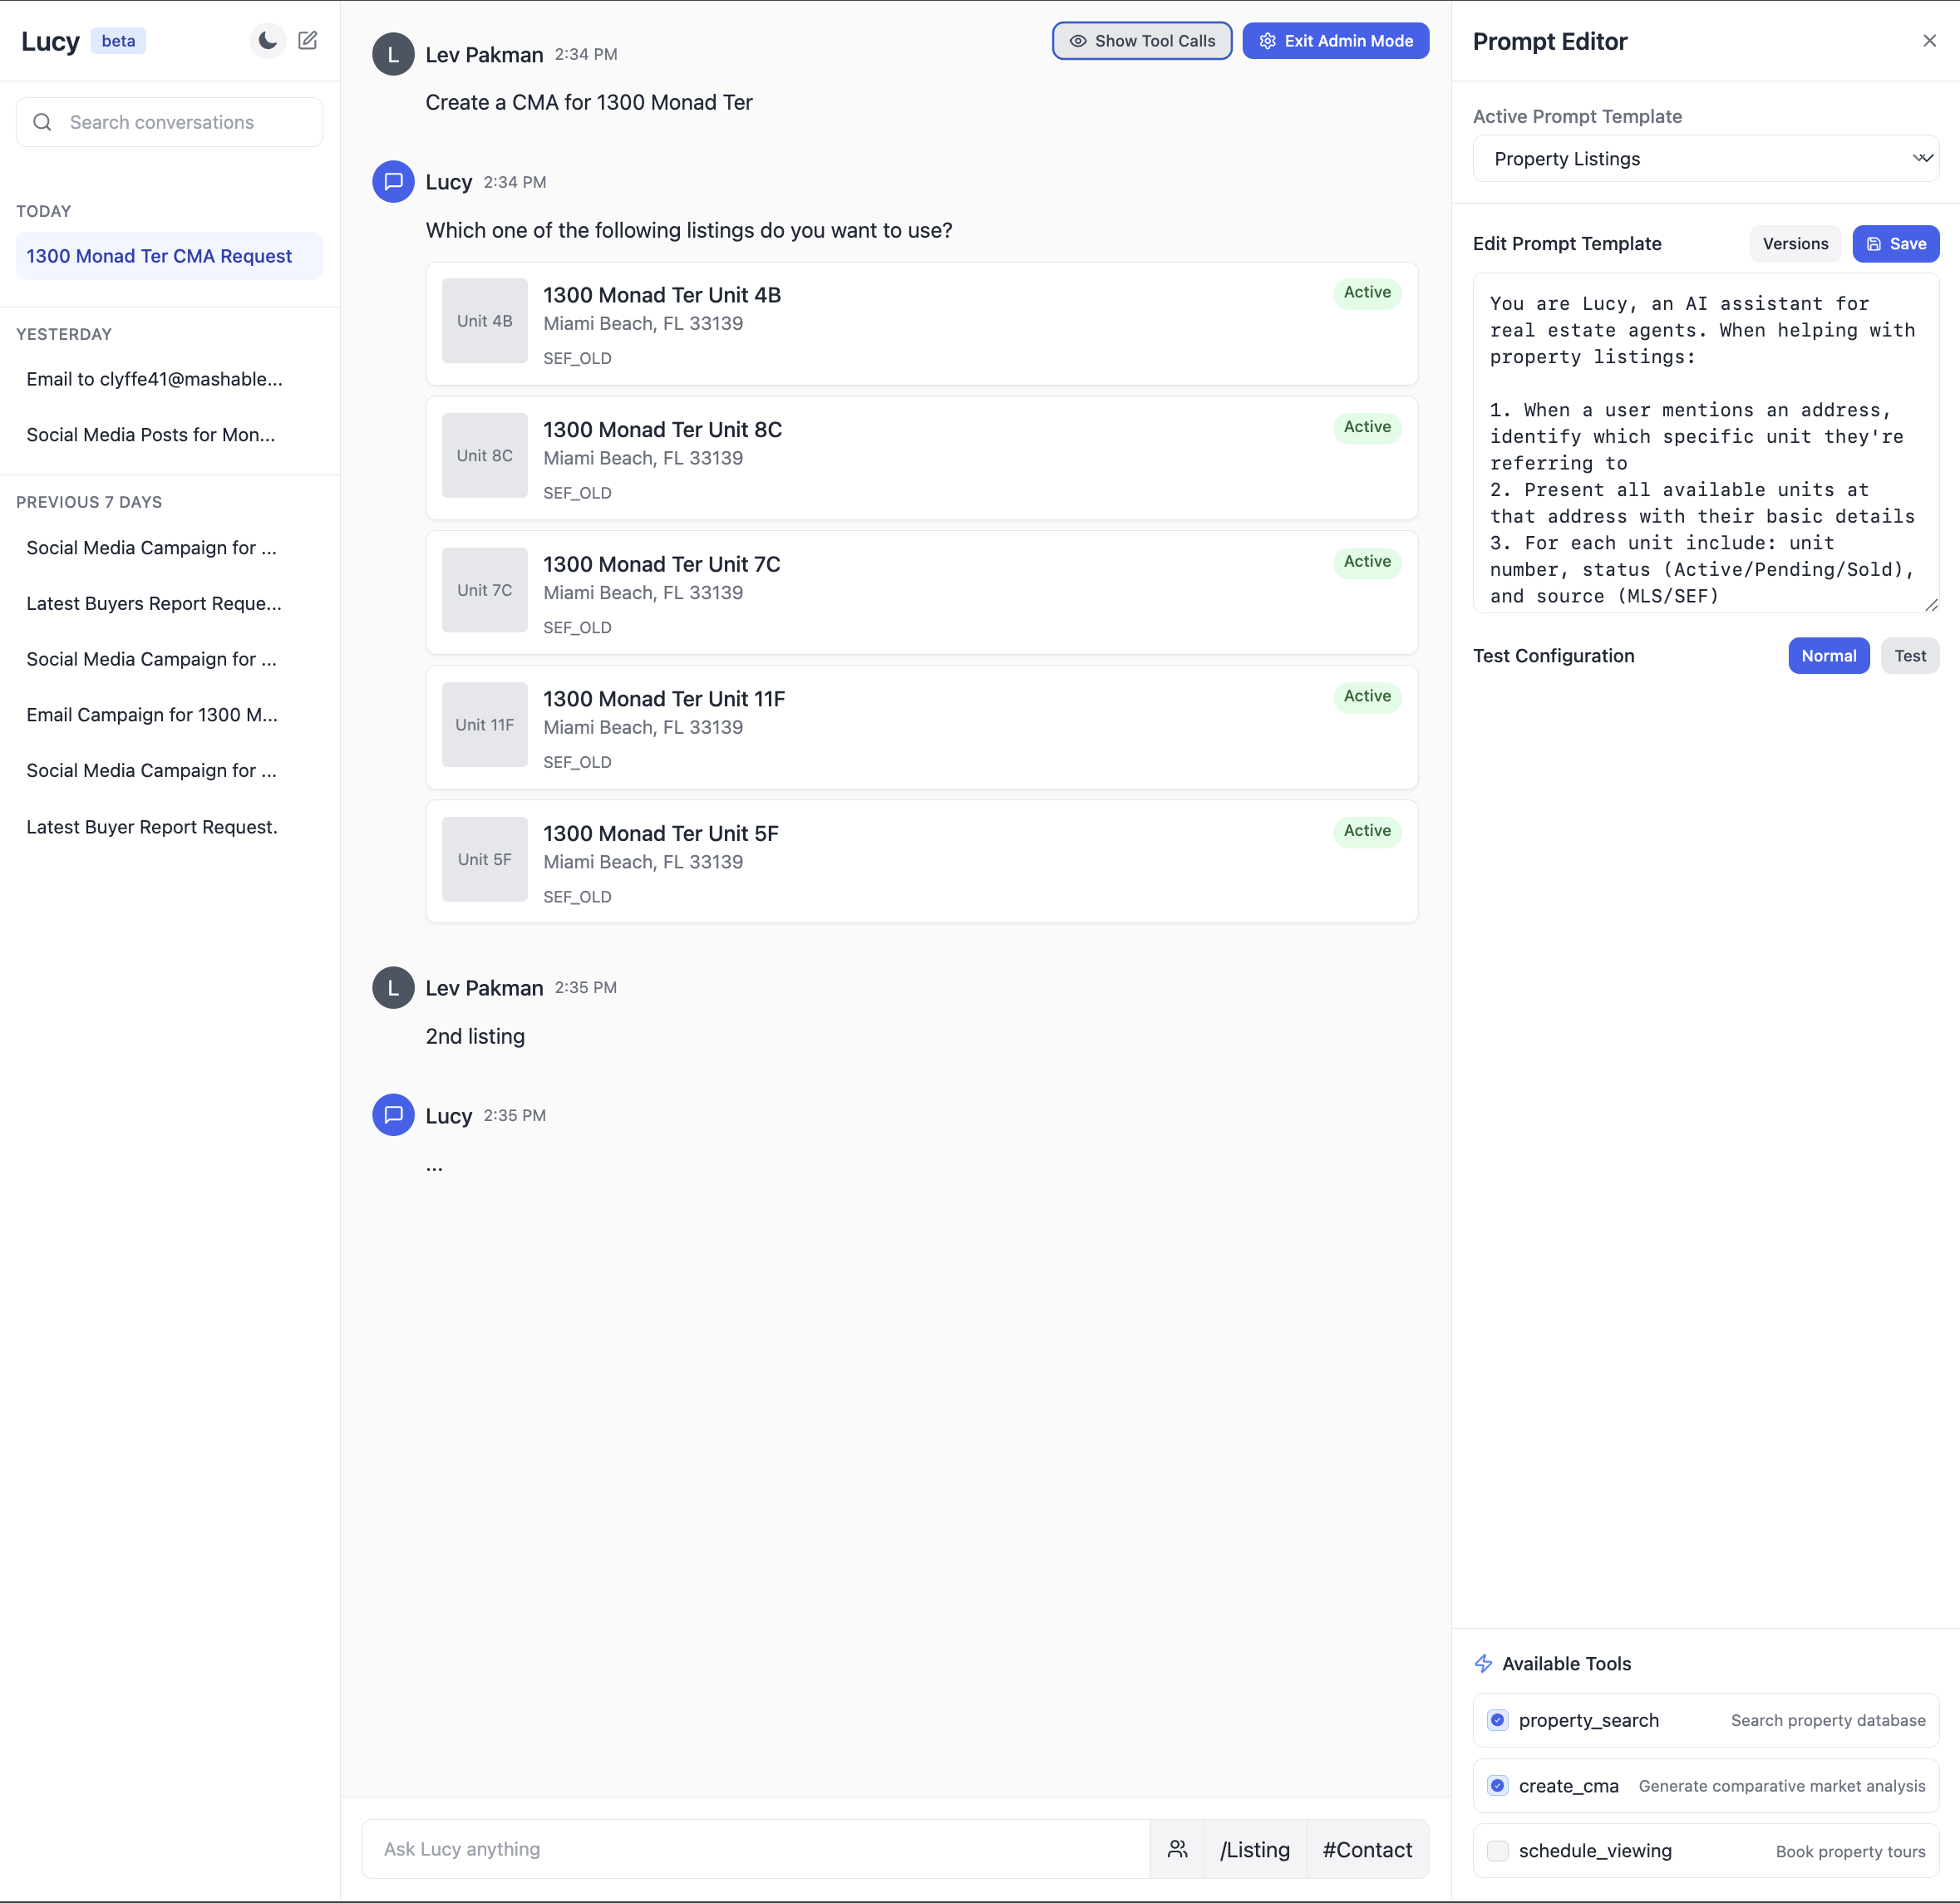
하지만 많은 팀이 놓치는 중요한 다음 단계가 있습니다. 바로 프롬프트 개발을 실제 애플리케이션 컨텍스트에 통합하는 것입니다. 대부분의 AI 애플리케이션은 단순한 프롬프트 이상입니다. 지식 베이스에서 정보를 가져오는 RAG 시스템, 여러 단계를 조율하는 에이전트 오케스트레이션, 애플리케이션별 비즈니스 로직이 복합적으로 얽혀 있습니다. 제가 함께 일한 가장 효과적인 팀들은 독립형 플레이그라운드를 넘어섭니다. 이들은 제가 통합 프롬프트 환경(integrated prompt environment)이라고 부르는 것, 즉 프롬프트 편집 기능이 노출된 실제 사용자 인터페이스의 관리자 버전을 구축합니다.
부동산 AI 어시스턴트의 통합 프롬프트 환경이 어떤 모습일지 예시로 보여드리겠습니다:
도메인 전문가와 소통하는 법
도메인 전문가의 효과적인 기여를 막는 또 다른 장벽이 있습니다. 바로 불필요한 전문 용어입니다. 교육 스타트업과 일할 때 엔지니어, 프로덕트 매니저, 학습 전문가들이 회의에서 서로 다른 언어를 쓰는 상황을 목격했습니다. 엔지니어들은 실제로 해야 할 일이 프롬프트 작성인데도 계속 'XYZ를 수행하는 에이전트를 만들겠다'고 했습니다. 이것이 인위적인 장벽을 만들었고, 실제 도메인 전문가인 학습 전문가들은 '에이전트'가 뭔지 몰라서 자신은 기여할 수 없다고 느꼈습니다.
이런 일은 어디서나 일어납니다. 법률 테크 기업의 변호사, 정신 건강 스타트업의 심리학자, 헬스케어 기업의 의사들에게서도 똑같이 봤습니다. LLM의 진정한 가치는 자연어를 통해 AI를 누구나 접근 가능하게 만든다는 것인데, 우리는 종종 모든 것을 기술 용어로 감싸버려 그 장점을 스스로 망가뜨립니다.
흔한 AI 전문 용어를 어떻게 바꿔 말할 수 있는지 간단한 예시를 보여드립니다:
| 이렇게 말하는 대신… | 이렇게 말하세요… |
|---|---|
| "저희는 RAG 방식을 구현하고 있습니다" | "모델이 질문에 답하기 위한 올바른 맥락을 갖출 수 있도록 합니다" |
| "프롬프트 인젝션을 방지해야 합니다" | "사용자가 AI를 속여 우리 규칙을 무시하게 만들 수 없도록 해야 합니다" |
| "우리 모델은 환각 문제를 겪고 있습니다" | "AI가 가끔 사실을 꾸며낼 수 있으니, 답변을 검토해야 합니다" |
이것은 수준을 낮추자는 게 아닙니다. 실제로 하고 있는 일을 정확하게 표현하자는 것입니다. '에이전트를 만들고 있다'고 할 때, 구체적으로 어떤 기능을 추가하는 건가요? 함수 호출인가요? 도구 사용인가요? 아니면 그냥 더 나은 프롬프트인가요? 구체적으로 말할수록 모두가 실제로 무슨 일이 일어나고 있는지 이해할 수 있습니다.
물론 맥락에 따라 다릅니다. 기술 용어는 이유가 있어 존재합니다. 다른 기술 관계자들과 대화할 때는 정확성을 높여줍니다. 핵심은 대상에 따라 언어를 조율하는 것입니다.
많은 팀이 이 지점에서 이런 의문을 제기합니다. "다 좋은데, 아직 데이터가 없으면 어떻게 하나요? 이제 막 시작하는 단계에서 어떻게 예시를 보고 프롬프트를 반복 개선할 수 있나요?" 바로 그 이야기를 다음에 하겠습니다.
4. 합성 데이터로 AI 시작하기: 사용자가 없어도 효과적입니다
팀들에게서 가장 자주 듣는 장벽 중 하나는 이것입니다. "실제 사용자 데이터가 충분하지 않아서 제대로 된 평가를 할 수 없어요." 이는 닭과 달걀의 문제를 만들어냅니다. AI를 개선하려면 데이터가 필요하지만, 데이터를 생성하는 사용자를 얻으려면 어느 정도 완성된 AI가 필요합니다.
다행히 놀랍도록 잘 작동하는 해결책이 있습니다. 바로 합성 데이터(synthetic data)입니다. LLM은 AI가 마주칠 다양한 시나리오를 포괄하는 현실적인 테스트 케이스를 생성할 수 있습니다.
제 LLM-as-a-Judge 블로그 포스트에서 썼듯이, 합성 데이터는 평가에 놀랍도록 효과적입니다. Hex의 전 AI 총괄 Bryan Bischof는 이를 이렇게 표현했습니다:
"LLM은 훌륭하고 다양한 사용자 프롬프트 예시를 생성하는 데 놀랍도록 탁월합니다. 이는 애플리케이션 기능을 구동하는 데도, 그리고 살짝 의외지만 평가 시스템(Eval)을 구축하는 데도 쓸 수 있습니다. 마치 대형 언어 뱀이 자기 꼬리를 먹는 것처럼 들린다면, 저도 처음엔 똑같이 놀랐습니다! 하지만 한 가지만 말씀드리겠습니다. 실제로 효과가 있으니 바로 써보세요."
현실적인 테스트 데이터 생성 프레임워크
효과적인 합성 데이터의 핵심은 테스트할 올바른 차원을 선택하는 것입니다. 구체적인 필요에 따라 달라지지만, 세 가지 큰 범주로 생각하면 도움이 됩니다:
- 기능(Features): AI가 지원해야 하는 기능은 무엇인가요?
- 시나리오(Scenarios): 어떤 상황을 마주치게 되나요?
- 사용자 페르소나(User Personas): 누가 어떻게 사용하나요?
이것이 전부는 아닙니다. 말투나 기술 수준, 또는 다양한 지역과 언어를 테스트하고 싶을 수도 있습니다. 중요한 것은 자신의 사용 사례에서 실제로 중요한 차원을 파악하는 것입니다.
Rechat과 함께 작업한 부동산 CRM AI 어시스턴트의 경우, 다음과 같이 차원을 정의했습니다:
features = [
    "property search",      # Finding listings matching criteria
    "market analysis",      # Analyzing trends and pricing
    "scheduling",          # Setting up property viewings
    "follow-up"           # Post-viewing communication
]

scenarios = [
    "exact match",         # One perfect listing match
    "multiple matches",    # Need to help user narrow down
    "no matches",         # Need to suggest alternatives
    "invalid criteria"     # Help user correct search terms
]

personas = [
    "first_time_buyer",    # Needs more guidance and explanation
    "investor",           # Focused on numbers and ROI
    "luxury_client",      # Expects white-glove service
    "relocating_family"   # Has specific neighborhood/school needs
]
하지만 이 차원들을 정의하는 것은 절반에 불과합니다. 진짜 과제는 합성 데이터가 실제로 테스트하려는 시나리오를 트리거하도록 만드는 것입니다. 이를 위해서는 두 가지가 필요합니다:
- 시나리오를 뒷받침할 충분한 다양성을 갖춘 테스트 데이터베이스
- 생성된 쿼리가 실제로 의도한 시나리오를 트리거하는지 검증하는 방법
Rechat의 경우, 다양한 엣지 케이스를 트리거할 것으로 알고 있는 매물 테스트 데이터베이스를 유지했습니다. 익명화된 프로덕션 데이터 복사본을 쓰는 팀도 있지만, 어떤 방식이든 중요한 시나리오를 충분히 다룰 수 있을 만큼 다양한 테스트 데이터가 필요합니다.
다음은 실제 데이터와 함께 이 차원들을 활용해 매물 검색 기능의 테스트 케이스를 생성하는 예시입니다(예시용 의사 코드입니다):
def generate_search_query(scenario, persona, listing_db):
    """Generate a realistic user query about listings"""
    # Pull real listing data to ground the generation
    sample_listings = listing_db.get_sample_listings(
        price_range=persona.price_range,
        location=persona.preferred_areas
    )

    # Verify we have listings that will trigger our scenario
    if scenario == "multiple_matches" and len(sample_listings) < 2:
        raise ValueError("Need multiple listings for this scenario")
    if scenario == "no_matches" and len(sample_listings) > 0:
        raise ValueError("Found matches when testing no-match scenario")

    prompt = f"""
    You are an expert real estate agent who is searching for listings. You are given a customer type and a scenario.

    Your job is to generate a natural language query you would use to search these listings.

    Context:
    - Customer type: {persona.description}
    - Scenario: {scenario}

    Use these actual listings as reference:
    {format_listings(sample_listings)}

    The query should reflect the customer type and the scenario.

    Example query: Find homes in the 75019 zip code, 3 bedrooms, 2 bathrooms, price range $750k - $1M for an investor.
    """
    return generate_with_llm(prompt)
이를 통해 다음과 같은 현실적인 쿼리들이 생성됩니다:
| 기능 | 시나리오 | 페르소나 | 생성된 쿼리 |
|---|---|---|---|
| 매물 검색 | 다중 결과 | first_time_buyer | "Riverside 지역에서 50만 달러 이하의 방 3개짜리 집을 찾고 있어요. 어린 아이들이 있어서 공원 근처면 좋겠어요." |
| 시장 분석 | 결과 없음 | investor | "123 Oak St의 비교 매물이 필요합니다. 특히 2마일 반경 내 유사 매물과의 임대 수익률 비교가 필요합니다." |
유용한 합성 데이터의 핵심은 실제 시스템 제약 조건을 기반으로 하는 것입니다. 부동산 AI 어시스턴트의 경우 다음을 의미합니다:
- 데이터베이스의 실제 매물 ID와 주소 사용
- 실제 중개사 일정과 가용 시간대 반영
- 보여주기 제한이나 사전 고지 기간 같은 비즈니스 규칙 준수
- HOA 요구 사항이나 지역 규정 같은 시장별 세부 사항 포함
이 테스트 케이스들을 Lucy에 입력하고 인터랙션을 로깅했습니다. 이를 통해 실제 시스템 제약 조건 하에서 AI가 다양한 상황을 어떻게 처리하는지 정확히 보여주는 풍부한 데이터셋을 확보할 수 있었습니다. 이 방식 덕분에 실제 사용자에게 영향을 미치기 전에 문제를 수정할 수 있었습니다.
특히 신규 제품의 경우 프로덕션 데이터베이스에 접근할 수 없을 때도 있습니다. 이 경우 LLM을 활용해 테스트 쿼리와 기반 테스트 데이터 모두를 생성하세요. 부동산 AI 어시스턴트라면 시장 가격대에 맞는 가격, 실제 도로명이 포함된 유효한 주소, 각 매물 유형에 적합한 편의시설 같은 현실적인 속성을 갖춘 합성 매물 목록을 만드는 것을 의미할 수 있습니다. 핵심은 합성 데이터를 실제 세계의 제약 조건에 기반해 테스트에 유용하게 만드는 것입니다. 견고한 합성 데이터베이스를 생성하는 구체적인 방법은 이 글의 범위를 벗어납니다.
합성 데이터 활용 가이드라인
합성 데이터를 생성할 때 효과를 극대화하려면 다음 핵심 원칙을 따르세요:
데이터셋을 다양화하세요: 다양한 기능, 시나리오, 페르소나를 포괄하는 예시를 만드세요. 제 LLM-as-a-Judge 포스트에서 썼듯이, 이 다양성이 예상치 못했을 엣지 케이스와 실패 패턴을 발견하는 데 도움이 됩니다.
출력이 아닌 사용자 입력을 생성하세요: LLM을 활용해 AI의 예상 응답이 아닌 현실적인 사용자 쿼리나 입력을 생성하세요. 이렇게 하면 합성 데이터가 생성 모델의 편향이나 한계를 그대로 물려받는 것을 방지할 수 있습니다.
실제 시스템 제약 조건을 반영하세요: 합성 데이터를 실제 시스템 제한 사항과 데이터에 기반하세요. 예를 들어, 일정 예약 기능을 테스트할 때는 실제 가용 시간대와 예약 규칙을 사용하세요.
시나리오 커버리지를 검증하세요: 생성된 데이터가 실제로 테스트하려는 시나리오를 트리거하는지 확인하세요. '결과 없음'을 테스트하기 위한 쿼리는 시스템에서 실행했을 때 실제로 결과가 0건이어야 합니다.
단순하게 시작해서 복잡도를 높이세요: 복잡성을 더하기 전에 간단한 테스트 케이스부터 시작하세요. 이렇게 하면 엣지 케이스를 다루기 전에 문제를 분리하고 기준선을 확립하는 데 도움이 됩니다.
이 접근법은 이론에 그치지 않습니다. 수십 개 기업의 프로덕션 환경에서 검증됐습니다. 임시방편으로 시작한 것이 실제 사용자 데이터가 확보된 후에도 평가 인프라의 영구적인 부분이 되는 경우가 많습니다.
이제 규모를 키우면서도 평가 시스템에 대한 신뢰를 유지하는 방법을 살펴보겠습니다…
5. 평가(Eval)에 대한 신뢰 유지가 핵심입니다
반복적으로 목격하는 패턴이 있습니다. 팀들이 평가 시스템을 구축한 후 점차 신뢰를 잃어버리는 것입니다. 때로는 지표가 프로덕션에서 관찰하는 것과 일치하지 않기 때문이고, 때로는 평가가 너무 복잡해져 해석하기 어렵기 때문입니다. 어느 쪽이든 결과는 같습니다. 팀은 직감과 일화적 피드백에 의존해 결정을 내리게 되고, 평가 시스템을 가진 목적 자체가 무너집니다.
평가 시스템에 대한 신뢰를 유지하는 것은 처음부터 구축하는 것만큼이나 중요합니다. 성공하는 팀들이 이 과제에 어떻게 접근하는지 살펴보겠습니다:
기준 표류(Criteria Drift) 이해하기
AI 평가에서 가장 교묘한 문제 중 하나는 '기준 표류(criteria drift)'입니다. 모델 출력을 더 많이 관찰할수록 평가 기준이 진화하는 현상입니다. Shankar 등은 논문 "Who Validates the Validators?"에서 이 현상을 다음과 같이 설명합니다:
"출력을 평가하려면 평가 기준을 외부화하고 정의해야 합니다. 그런데 출력을 평가하는 과정 자체가 그 기준을 정의하는 데 도움이 됩니다."
이는 역설을 만들어냅니다. 다양한 출력을 보기 전까지는 평가 기준을 완전히 정의할 수 없지만, 그 출력들을 평가하려면 기준이 필요합니다. 다시 말해, LLM 출력에 대한 인간의 판단이 이루어지기 전에 평가 기준을 완전히 결정하는 것은 불가능합니다.
Honeycomb의 Phillip Carter와 함께 Query Assistant 기능을 개발하면서 이를 직접 목격했습니다. AI의 데이터베이스 쿼리 생성 능력을 평가하던 중 Phillip이 흥미로운 점을 발견했습니다:
"LLM이 추론을 분해하는 방식을 보면서, 특정 엣지 케이스를 판단하는 데 일관성이 없었다는 것을 깨달았습니다."
AI 출력을 검토하는 과정이 그가 자신의 평가 기준을 더 명확하게 표현하는 데 도움이 됐습니다. 이는 부실한 계획의 징표가 아닙니다. 다양하고 때로는 예상치 못한 출력을 생성하는 AI 시스템을 다룰 때 나타나는 고유한 특성입니다.
평가 시스템에 대한 신뢰를 유지하는 팀들은 이 현실에 저항하는 대신 받아들입니다. 평가 기준을 문제 공간에 대한 이해와 함께 진화하는 살아있는 문서로 취급합니다. 또한 다양한 이해관계자가 서로 다른, 때로는 모순된 기준을 가질 수 있다는 점을 인식하고, 단일 기준을 강요하는 대신 이러한 관점들을 조율하기 위해 노력합니다.
신뢰할 수 있는 평가 시스템 구축하기
그렇다면 기준 표류에도 불구하고 신뢰를 유지하는 평가 시스템을 어떻게 구축할까요? 제가 가장 효과적이라고 생각하는 접근법을 소개합니다:
1. 임의적인 척도 대신 이진 판단을 선호하세요
제 LLM-as-a-Judge 포스트에서 썼듯이, 이진 판단은 복잡한 척도가 종종 가리는 명확성을 제공합니다. 1~5점 척도를 앞에 두면 평가자들은 3점과 4점의 차이에서 자주 고민하게 되고, 이는 일관성 부재와 주관성을 낳습니다. '약간 도움됨'과 '도움됨'의 정확한 차이는 무엇일까요? 이런 경계 케이스들은 불균형적인 정신적 에너지를 소모하고 평가 데이터에 노이즈를 만들어냅니다. 또한 기업들이 1~5점 척도를 사용하더라도 결국 '충분히 좋음'이나 개입 기준을 어디에 그을지 묻게 되어, 어차피 이진 결정을 강요받게 됩니다.
반면, 이진 합격/불합격 방식은 평가자가 명확한 판단을 내리도록 합니다. 이 출력이 목적을 달성했는가, 아닌가? 이 명확성은 진척 측정에도 이어집니다. 합격 출력이 10% 증가하면 즉각적으로 의미가 있지만, 5점 척도에서 0.5점 향상은 해석이 필요합니다.
이진 평가를 거부하는 팀들은 대개 뉘앙스를 포착하고 싶어서라는 것을 발견했습니다. 하지만 뉘앙스가 사라지는 게 아닙니다. 판단과 함께 제공되는 정성적 비평으로 옮겨갈 뿐입니다. 비평은 왜 합격 또는 불합격인지, 어떤 구체적인 측면을 개선할 수 있는지에 대한 풍부한 맥락을 제공하는 한편, 이진 결정은 개선이 필요한지 여부에 대한 실행 가능한 명확성을 만들어냅니다.
2. 상세한 비평으로 이진 판단을 보완하세요
이진 판단은 명확성을 제공하지만, 합격 또는 불합격인 이유의 뉘앙스를 담아내는 상세한 비평과 짝을 이룰 때 가장 잘 작동합니다. 이 조합은 두 가지 장점을 모두 제공합니다. 명확하고 실행 가능한 지표와 풍부한 맥락적 이해입니다.
예를 들어, 사용자의 질문에 정확히 답변하지만 불필요한 정보가 포함된 응답을 평가할 때, 좋은 비평은 다음과 같을 수 있습니다:
"AI가 요청한 시장 분석을 성공적으로 제공했습니다(합격). 그러나 투자 질문과 관련 없는 지역 인구 통계에 대한 과도한 세부 정보가 포함되어 있습니다. 이로 인해 응답이 필요 이상으로 길어지고 산만해질 수 있습니다."
이러한 비평은 단순한 설명 이상의 기능을 합니다. 도메인 전문가들이 암묵적인 지식을 표면화하도록 강제합니다. 법률 전문가들이 '왠지 이상한 느낌'이라는 모호한 감에서 인용 형식이나 추론 패턴의 구체적인 문제를 체계적으로 표현하게 되는 것을 목격했습니다.
판단자 프롬프트에 퓨샷(few-shot) 예시로 포함될 때, 이러한 비평은 LLM이 복잡한 엣지 케이스를 추론하는 능력을 향상시킵니다. 예시 비평이 없는 프롬프트에 비해 인간과 LLM 평가 간 일치율이 15~20% 더 높은 경우가 많다는 것을 발견했습니다. 비평은 또한 고품질 합성 데이터를 생성하기 위한 훌륭한 원자재를 제공해 개선의 플라이휠을 만들어냅니다.
3. 자동화된 평가와 인간 판단 간의 일치도를 측정하세요
출력을 평가하기 위해 LLM을 사용한다면(규모가 커지면 종종 필요합니다), 이러한 자동화된 평가가 인간 판단과 얼마나 잘 일치하는지 정기적으로 확인하는 것이 중요합니다.
이는 AI 시스템을 과신하는 우리의 자연스러운 경향을 감안할 때 특히 중요합니다. Shankar 등이 "Who Validates the Validators?"에서 지적하듯, 평가자 품질을 검증하는 도구의 부재는 우려스럽습니다.
"연구에 따르면 사람들은 AI 시스템에 과도하게 의존하고 신뢰하는 경향이 있습니다. 예를 들어, 한 유명한 사건에서 MIT 연구자들이 GPT-4가 MIT EECS 시험을 통과할 수 있다고 주장하는 사전 인쇄본을 arXiv에 게시했습니다. 몇 시간 만에 이 연구는 GPT-4가 스스로를 채점하는 데 과도하게 의존하는 문제를 지적하며 반박됐습니다."
이 과신 문제는 자기 평가를 넘어섭니다. 연구에 따르면 LLM은 옵션의 순서나 프롬프트의 무해해 보이는 포맷 변경 같은 단순한 요인에 의해서도 편향될 수 있습니다. 엄격한 인간 검증 없이는 이러한 편향이 평가 시스템을 조용히 훼손할 수 있습니다.
Honeycomb와 작업할 때, LLM-as-a-judge와 Phillip의 평가 간 일치율을 추적했습니다:
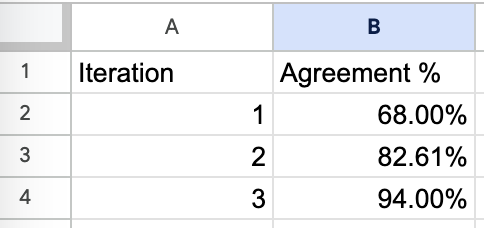
90% 이상의 일치율을 달성하는 데 세 번의 반복이 필요했지만, 이 투자는 팀이 신뢰할 수 있는 시스템으로 보답했습니다. 이 검증 단계 없이는 특히 입력의 분포가 변화하면서 자동화된 평가가 시간이 지남에 따라 인간의 기대에서 벗어나는 경우가 많습니다. 자세한 내용은 여기서 확인하세요.
Eugene Yan의 AlignEval 같은 도구는 이 정렬 과정을 잘 보여줍니다. 데이터를 업로드하고, 예시에 이진 '좋음' 또는 '나쁨' 레이블을 붙인 후, LLM 기반 판단자를 그 인간 판단과 비교 평가하는 간단한 인터페이스를 제공합니다. 효과적인 이유는 워크플로를 간소화하는 방식에 있습니다. 자동화된 평가가 자신의 선호에서 어디에서 벗어나는지 빠르게 확인하고, 이 인사이트를 바탕으로 기준을 다듬고, 시간 경과에 따른 개선을 측정할 수 있습니다. 이 접근법은 정렬이 일회성 설정이 아니라 인간 판단과 자동화된 평가 간의 지속적인 대화임을 강조합니다.
신뢰를 잃지 않고 규모 확장하기
AI 시스템이 성장하면서 평가에 들어가는 인간의 노력을 줄이라는 압박을 피할 수 없습니다. 많은 팀이 여기서 실수를 합니다. 너무 많은 것을 너무 빠르게 자동화하면서, 평가를 현실에 기반하게 하는 인간적 연결을 잃어버립니다.
성공하는 팀들은 더 신중하게 접근합니다:
높은 인간 참여로 시작하세요: 초기 단계에서 도메인 전문가들이 상당 비율의 출력을 직접 평가하게 하세요.
일치 패턴을 연구하세요: 평가를 자동화하는 것보다 자동화된 평가가 인간 판단과 일치하는 곳과 그렇지 않은 곳을 이해하는 데 집중하세요. 이는 어떤 유형의 케이스에 더 신중한 인간의 주의가 필요한지 파악하는 데 도움이 됩니다.
전략적 샘플링을 활용하세요: 모든 출력을 평가하는 대신, 가장 많은 정보를 제공하는 출력을 샘플링하는 통계적 기법을 사용하세요. 특히 일치율이 가장 약한 영역에 집중하세요.
정기적인 캘리브레이션을 유지하세요: 규모가 커지더라도 자동화된 평가를 인간 판단과 정기적으로 비교하고, 이 비교를 통해 자동화된 평가를 언제 신뢰할지에 대한 이해를 계속 다듬으세요.
평가를 확장하는 것은 단순히 인간의 노력을 줄이는 것이 아닙니다. 가장 가치를 더하는 곳에 그 노력을 집중하는 것입니다. 가장 도전적이거나 정보가 많은 케이스에 인간의 주의를 집중시킴으로써, 시스템이 성장하더라도 품질을 유지할 수 있습니다.
평가에 대한 신뢰를 유지하는 방법을 살펴봤으니, 이제 AI 개발 로드맵에 접근하는 방식의 근본적인 변화에 대해 이야기해 보겠습니다…
6. AI 로드맵은 기능이 아닌 실험 횟수를 세야 합니다
소프트웨어 개발 경험이 있다면 전통적인 로드맵에 익숙할 것입니다. 목표 출시일이 붙은 기능 목록이죠. 팀들은 특정 기한까지 특정 기능을 출시하겠다고 약속하고, 성공은 그 목표에 얼마나 근접했는지로 측정됩니다.
이 접근법은 AI에서 처참하게 실패합니다.
'2분기까지 감성 분석 출시' 또는 '연말까지 에이전트 기반 고객 지원 배포' 같은 로드맵에 헌신하는 팀들을 지켜봤는데, 결국 기술이 자신들의 품질 기준을 충족할 준비가 되지 않았다는 것을 발견하게 됩니다. 마감을 맞추기 위해 미달 제품을 출시하거나 마감을 완전히 놓치게 됩니다. 어느 쪽이든 신뢰가 무너집니다.
근본적인 문제는 전통적인 로드맵이 우리가 가능한 것을 안다고 가정한다는 데 있습니다. 일반적인 소프트웨어에서는 그것이 종종 사실입니다. 충분한 시간과 자원이 있으면 대부분의 기능을 안정적으로 만들 수 있습니다. AI, 특히 최첨단에서는 항상 가능성의 경계를 테스트하고 있습니다.
실험 vs. 기능
Hex의 전 AI 총괄 Bryan Bischof는 AI 로드맵에 대한 '역량 깔때기(capability funnel)' 접근법을 소개해 줬습니다. 이 전략은 AI 개발 진척을 바라보는 방식 자체를 재구성합니다.
성공을 기능 출시로 정의하는 대신, 역량 깔때기는 AI 성능을 점진적인 유용성 수준으로 분해합니다. 깔때기 상단에는 가장 기본적인 기능이 있습니다. 시스템이 응답이라도 하는가? 하단에는 사용자의 해결해야 할 일(job to be done)을 완전히 해결하는 것이 있습니다. 이 두 지점 사이에는 유용성이 점차 증가하는 다양한 단계가 있습니다.
예를 들어, 쿼리 어시스턴트에서 역량 깔때기는 다음과 같은 모습일 수 있습니다: 1. 문법적으로 유효한 쿼리 생성 (기본 기능) 2. 오류 없이 실행되는 쿼리 생성 3. 관련 결과를 반환하는 쿼리 생성 4. 사용자 의도와 일치하는 쿼리 생성 5. 사용자의 문제를 해결하는 최적 쿼리 생성 (완전한 솔루션)
이 접근법은 AI 발전이 이진적이지 않다는 것을 인정합니다. 여러 차원에 걸쳐 역량을 점진적으로 개선하는 것이기 때문입니다. 최종 목표에 도달하지 못했더라도 진척을 측정할 수 있는 프레임워크를 제공한다는 점도 장점입니다.
제가 함께 일한 가장 성공적인 팀들은 기능보다 실험을 중심으로 로드맵을 구조화합니다. 특정 결과물을 약속하는 대신, 실험·학습·반복의 리듬에 헌신합니다.
Amazon의 응용 과학자 Eugene Yan은 리더십과 함께 ML 프로젝트 계획을 세우는 방법을 공유했습니다. 전통적인 머신러닝을 위해 개발됐지만 현대 LLM 개발에도 동등하게 적용되는 프로세스입니다:
"일반적인 타임라인은 이렇습니다. 먼저 2주를 데이터 타당성 분석에 씁니다. '올바른 데이터가 있는가?'를 확인하는 것이죠. […] 그런 다음 추가로 한 달을 기술 타당성 분석에 씁니다. 'AI가 이것을 해결할 수 있는가?'입니다. 그 후에도 여전히 가능성이 있으면 A/B 테스트를 할 수 있는 프로토타입을 만드는 데 6주를 씁니다."
LLM이 전통적인 ML과 같은 종류의 피처 엔지니어링이나 모델 학습을 요구하지 않을 수 있지만, 기본 원칙은 동일합니다. 탐색에 시간 박스를 설정하고, 명확한 결정 지점을 수립하고, 전면 구현에 헌신하기 전에 타당성을 먼저 증명하세요. 이 접근법은 리더십에게 자원이 무한정 탐색에 낭비되지 않을 것이라는 확신을 주면서, 팀에게는 진행하면서 배우고 적응할 자유를 줍니다.
토대: 평가 인프라
실험 기반 로드맵을 작동시키는 열쇠는 견고한 평가 인프라를 갖추는 것입니다. 없으면 실험이 효과가 있는지 그냥 추측하는 것입니다. 있으면 빠르게 반복하고, 가설을 테스트하고, 성공을 토대로 구축할 수 있습니다.
GitHub Copilot 초기 개발 당시 이를 직접 목격했습니다. 대부분의 사람들이 깨닫지 못하는 것은 팀이 정교한 오프라인 평가 인프라를 구축하는 데 막대한 투자를 했다는 것입니다. GitHub의 방대한 저장소 코퍼스에 대해 코드 완성을 테스트할 수 있는 시스템을 만들었고, 고품질 코드베이스에 이미 존재하는 유닛 테스트를 완성 정확도를 검증하는 자동화된 수단으로 활용했습니다. 이것은 대규모 엔지니어링 작업이었습니다. 저장소를 대규모로 클론하고, 환경을 설정하고, 테스트 스위트를 실행하고, 결과를 분석하는 시스템을 만들어야 했습니다. 그 모든 것이 프로그래밍 언어, 프레임워크, 테스트 접근법의 놀라운 다양성을 처리하면서 이루어졌습니다.
이것은 낭비된 시간이 아니었습니다. 모든 것을 가속화한 토대였습니다. 견고한 평가가 갖춰지면서 팀은 수천 번의 실험을 실행하고, 효과가 있는 것을 빠르게 파악하고, 직감에 의존하는 대신 '이 변경으로 품질이 X% 향상됐다'고 자신 있게 말할 수 있었습니다. 평가에 대한 선행 투자가 처음에는 더디게 느껴질 수 있지만, 변경이 도움이 되는지 해가 되는지에 대한 끝없는 논쟁을 방지하고 장기적으로는 혁신을 극적으로 가속화합니다.
이해관계자에게 전달하기
물론 과제는 경영진이 종종 확실성을 원한다는 것입니다. 기능이 언제 출시되고 무엇을 할지 알고 싶어합니다. 이 간극을 어떻게 메울 수 있을까요?
핵심은 대화를 산출물에서 결과로 전환하는 것입니다. 특정 날짜까지 특정 기능을 약속하는 대신, 원하는 비즈니스 결과를 달성할 가능성을 극대화하는 프로세스에 헌신하세요.
Eugene은 이러한 대화를 어떻게 처리하는지 공유했습니다:
"저는 타임박스로 리더십을 안심시키려 합니다. 3개월 후에 잘 되면 프로덕션으로 이동합니다. 과정의 어느 단계에서든 잘 안 되면 방향을 전환합니다."
이 접근법은 AI 개발의 본질적인 불확실성을 인정하면서도 이해관계자들에게 명확한 결정 지점을 제공합니다. 타임라인에 대한 기대를 관리하는 데도 도움이 됩니다. 6개월 후 기능을 약속하는 대신, 3개월 후에 그 기능이 실현 가능한지에 대한 명확한 답을 약속하는 것입니다.
Bryan의 역량 깔때기 접근법은 또 다른 강력한 소통 도구를 제공합니다. 최종 솔루션이 준비되지 않았더라도 팀이 깔때기 단계를 통한 구체적인 진척을 보여줄 수 있습니다. 또한 경영진이 문제가 발생하는 지점을 이해하고 자원을 어디에 투자할지 정보에 입각한 결정을 내리는 데 도움이 됩니다.
실패 공유를 통한 실험 문화 구축
이 접근법에서 가장 역설적인 측면은 실패에서 배우는 것을 강조한다는 것입니다. 전통적인 소프트웨어 개발에서 실패는 종종 숨겨지거나 축소됩니다. AI 개발에서는 실패가 학습의 주요 원천입니다.
Eugene은 자신이 '15-5'라고 부르는 것을 통해 이를 조직에서 실행합니다. 작성하는 데 15분, 읽는 데 5분이 걸리는 주간 업데이트입니다:
"15-5에서 저는 실패와 성공을 모두 기록합니다. 팀 내에서는 우리가 작업해온 것과 배운 것을 논의하는 주간 '무준비 공유 세션'도 있습니다. 이때 저는 일부러 실패를 공유하려 합니다."
이 관행은 실패를 학습 과정의 일부로 정상화합니다. 경험 많은 실무자들도 막다른 길에 부딪힌다는 것을 보여주고, 그 경험을 공개적으로 공유함으로써 팀 학습을 가속화합니다. 결과만이 아닌 실험 과정을 축하함으로써, 팀들은 사람들이 위험을 감수하고 실패에서 배우는 것을 안전하게 느끼는 환경을 만들어냅니다.
더 나은 앞으로의 길
그렇다면 실험 기반 로드맵은 실제로 어떤 모습일까요? Eugene이 작업한 콘텐츠 모더레이션 프로젝트의 단순화된 예시를 살펴보겠습니다:
"콘텐츠 모더레이션을 해달라는 요청을 받았습니다. 저는 이렇게 말했습니다. '그 목표를 달성할 수 있을지 불확실합니다. 우리 데이터로 그 목표가 실현 가능한지, 어떤 머신러닝 기법이 효과가 있을지도 불확실합니다. 하지만 여기 제 실험 로드맵이 있습니다. 시도할 기법들이고, 2주 주기로 업데이트하겠습니다.'"
로드맵은 특정 기능이나 역량을 약속하지 않았습니다. 대신 가능한 접근법에 대한 체계적인 탐색과, 진척을 평가하고 필요하면 방향을 바꾸기 위한 정기적인 체크인에 헌신했습니다.
결과는 시사하는 바가 컸습니다:
"처음 2~3개월 동안은 아무것도 효과가 없었습니다. […] 그러다가 [돌파구]가 나왔습니다. […] 한 달 안에 그 문제가 해결됐습니다. 1분기, 심지어 4개월 동안은 어디로도 가지 못하는 것처럼 보였죠. […] 하지만 갑자기 새로운 기술, 새로운 패러다임, 새로운 재구성이 나타나 [문제의] 80%를 단번에 [해결]하는 것을 볼 수 있습니다."
이 패턴, 즉 오랜 기간의 외견상 실패 후 돌파구가 찾아오는 것은 AI 개발에서 흔합니다. 전통적인 기능 기반 로드맵이었다면 몇 달간의 '실패' 후 프로젝트를 종료했을 것이고, 결국의 돌파구를 놓쳤을 것입니다.
기능보다 실험에 집중함으로써 팀들은 이러한 돌파구가 나타날 공간을 만들어냅니다. 또한 돌파구를 더 가능성 있게 하는 인프라와 프로세스, 즉 데이터 파이프라인, 평가 프레임워크, 빠른 반복 사이클을 구축합니다.
제가 함께 일한 가장 성공적인 팀들은 특정 기능에 헌신하기 전에 평가 인프라를 구축하는 것부터 시작합니다. 반복을 빠르게 하는 도구를 만들고 빠른 실험을 지원하는 프로세스에 집중합니다. 처음에는 더 느리게 보일 수 있지만, 팀이 빠르게 배우고 적응할 수 있게 함으로써 장기적으로는 개발을 극적으로 가속화합니다.
AI 로드맵의 핵심 지표는 출시된 기능이 아닙니다. 실행된 실험 횟수입니다. 승리하는 팀은 경쟁자보다 더 많은 실험을 실행하고, 더 빠르게 배우고, 더 빠르게 반복할 수 있는 팀입니다. 이 빠른 실험의 토대는 항상 동일합니다. 모든 사람에게 결과에 대한 확신을 주는 견고하고 신뢰할 수 있는 평가 인프라입니다.
기능보다 실험을 중심으로 로드맵을 재구성함으로써, 자신의 조직에서도 유사한 돌파구를 위한 조건을 만들어낼 수 있습니다.
결론
이 글 전반에 걸쳐 수십 개의 AI 구현에서 관찰한 패턴을 공유했습니다. 가장 성공적인 팀들은 가장 정교한 도구나 가장 발전된 모델을 가진 팀이 아닙니다. 측정, 반복, 학습의 기본을 완전히 익힌 팀들입니다.
핵심 원칙들은 놀랍도록 단순합니다:
데이터를 직접 들여다보세요. 실제 예시를 살펴보는 것에서 얻는 인사이트를 대체할 수 있는 것은 없습니다. 오류 분석은 지속적으로 가장 높은 ROI의 개선점을 드러냅니다.
마찰을 제거하는 단순한 도구를 만드세요. AI 출력을 쉽게 검토할 수 있는 맞춤형 데이터 뷰어는 범용 지표를 가진 복잡한 대시보드보다 더 많은 인사이트를 제공합니다.
도메인 전문가들에게 권한을 주세요. 도메인을 가장 잘 이해하는 사람들은 기술적 배경과 관계없이 AI를 가장 효과적으로 개선할 수 있는 사람들인 경우가 많습니다.
합성 데이터를 전략적으로 활용하세요. AI를 테스트하고 개선하기 시작하는 데 실제 사용자가 필요하지 않습니다. 신중하게 생성된 합성 데이터로 평가 프로세스를 시작할 수 있습니다.
평가에 대한 신뢰를 유지하세요. 상세한 비평과 함께하는 이진 판단은 뉘앙스를 보존하면서 명확성을 만들어냅니다. 정기적인 일치도 확인은 자동화된 평가가 신뢰할 수 있는 상태로 유지되도록 합니다.
기능이 아닌 실험을 중심으로 로드맵을 구조화하세요. 특정 날짜까지의 특정 결과보다 실험과 학습의 리듬에 헌신하세요.
이 원칙들은 도메인, 팀 규모, 기술 스택에 관계없이 적용됩니다. 초기 스타트업부터 대형 기술 기업까지, 고객 지원부터 코드 생성까지 다양한 사용 사례에서 효과가 입증됐습니다.
더 깊이 파고들기 위한 자료
이 주제들을 더 탐색하고 싶다면, 도움이 될 자료들을 소개합니다:
제 블로그에서 AI 평가와 개선에 대한 더 많은 콘텐츠를 확인하세요. 다른 포스트들은 효과적인 LLM 판단자 구성, 평가 시스템 구현, AI 개발의 기타 측면 같은 주제를 더 깊이 다룹니다1. Shreya Shankar와 Eugene Yan의 블로그도 이 주제들에 대한 훌륭한 정보 소스이니 함께 확인해 보세요.
제가 Shreya Shankar와 함께 진행하는 강좌: 평가로 AI 제품을 빠르게 개선하기. 오류 분석, 합성 데이터 생성, 신뢰할 수 있는 평가 시스템 구축 같은 기법을 실습할 수 있습니다. 오피스 아워를 통한 맞춤형 지도도 포함됩니다.
조직의 특정 니즈에 맞는 실질적인 지도를 찾고 있다면, Parlance Labs에서 저와 함께하는 방법을 더 알아볼 수 있습니다.
각주
저는 머신러닝, AI, 소프트웨어 개발에 대해 폭넓게 글을 씁니다. 이 주제들을 더 깊이 다루는 포스트로는 당신의 AI 제품에는 평가가 필요합니다, 비즈니스 결과를 이끄는 LLM-as-a-Judge 만들기, LLM으로 1년간 구축하면서 배운 것이 있습니다. 모든 포스트는 hamel.dev에서 확인할 수 있습니다.↩︎


