Hamel Husain블로그
AI 제품에 평가(Evals) 체계는 필수입니다
도메인 특화 LLM 평가 체계를 구축하는 방법을 소개합니다.
소프트웨어 엔지니어링과 마찬가지로, AI에서도 성패는 얼마나 빠르게 반복할 수 있느냐에 달려 있습니다. 이를 위해 반드시 갖춰야 할 프로세스와 도구가 있습니다.
- 품질 평가 (예: 테스트)
- 문제 디버깅 (예: 로깅 및 데이터 검토)
- 시스템 동작 변경 (프롬프트 엔지니어링, 파인튜닝, 코드 작성)
많은 사람들이 세 번째 항목에만 집중하는데, 그러면 LLM 제품이 데모 수준에서 벗어나지 못합니다.1 세 가지를 모두 잘 해낼 때 비로소 선순환이 만들어지고, 이것이 평범한 AI 제품과 뛰어난 AI 제품을 가르는 기준이 됩니다(아래 다이어그램 참고).
평가 프로세스를 효율화하면 나머지 활동들은 자연스럽게 따라옵니다. 소프트웨어 엔지니어링에서 초기 투자가 필요하더라도 테스트가 장기적으로 엄청난 가치를 발휘하는 것과 같은 이치입니다.
이 글에서는 실제 사례를 통해 빠른 개선 체계를 어떻게 구축했는지 살펴보겠습니다. 가장 핵심적인 요소인 평가를 중심으로 이야기하겠습니다.
사례 연구: 부동산 AI 어시스턴트 Lucy
Rechat은 부동산 전문가들이 계약 관리, 매물 검색, 홍보 자료 제작, 일정 관리 등 다양한 업무를 한 곳에서 처리할 수 있는 SaaS 플랫폼입니다. 여러 도구를 오가며 컨텍스트를 전환할 필요 없이 모든 것을 한 플랫폼에서 해결한다는 것이 Rechat의 핵심 가치입니다.
Rechat의 AI 어시스턴트 Lucy는 클릭, 타이핑, 화면 이동 없이 대화만으로 소프트웨어를 사용할 수 있게 해주는 전형적인 AI 제품입니다. 초기에는 프롬프트 엔지니어링으로 빠른 성과를 거뒀지만, Lucy의 기능 범위가 넓어지면서 AI 성능이 정체되기 시작했습니다. 당시 나타난 증상들은 다음과 같습니다.
- 한 가지 문제를 해결하면 다른 문제가 불거지는, 두더지 잡기 게임 같은 상황이 반복됐습니다.
- 직관적인 감에 의존할 뿐, AI 시스템이 각 태스크에서 얼마나 잘 동작하는지를 객관적으로 파악하기 어려웠습니다.
- 수많은 엣지 케이스와 예시를 담으려다 보니 프롬프트가 걷잡을 수 없이 길고 복잡해졌습니다.
문제: AI를 어떻게 체계적으로 개선할 것인가?
이 정체를 돌파하기 위해, 저희는 평가를 중심에 둔 체계적인 Lucy 개선 방법론을 수립했습니다. 아래 다이어그램이 이 접근 방식을 보여줍니다.
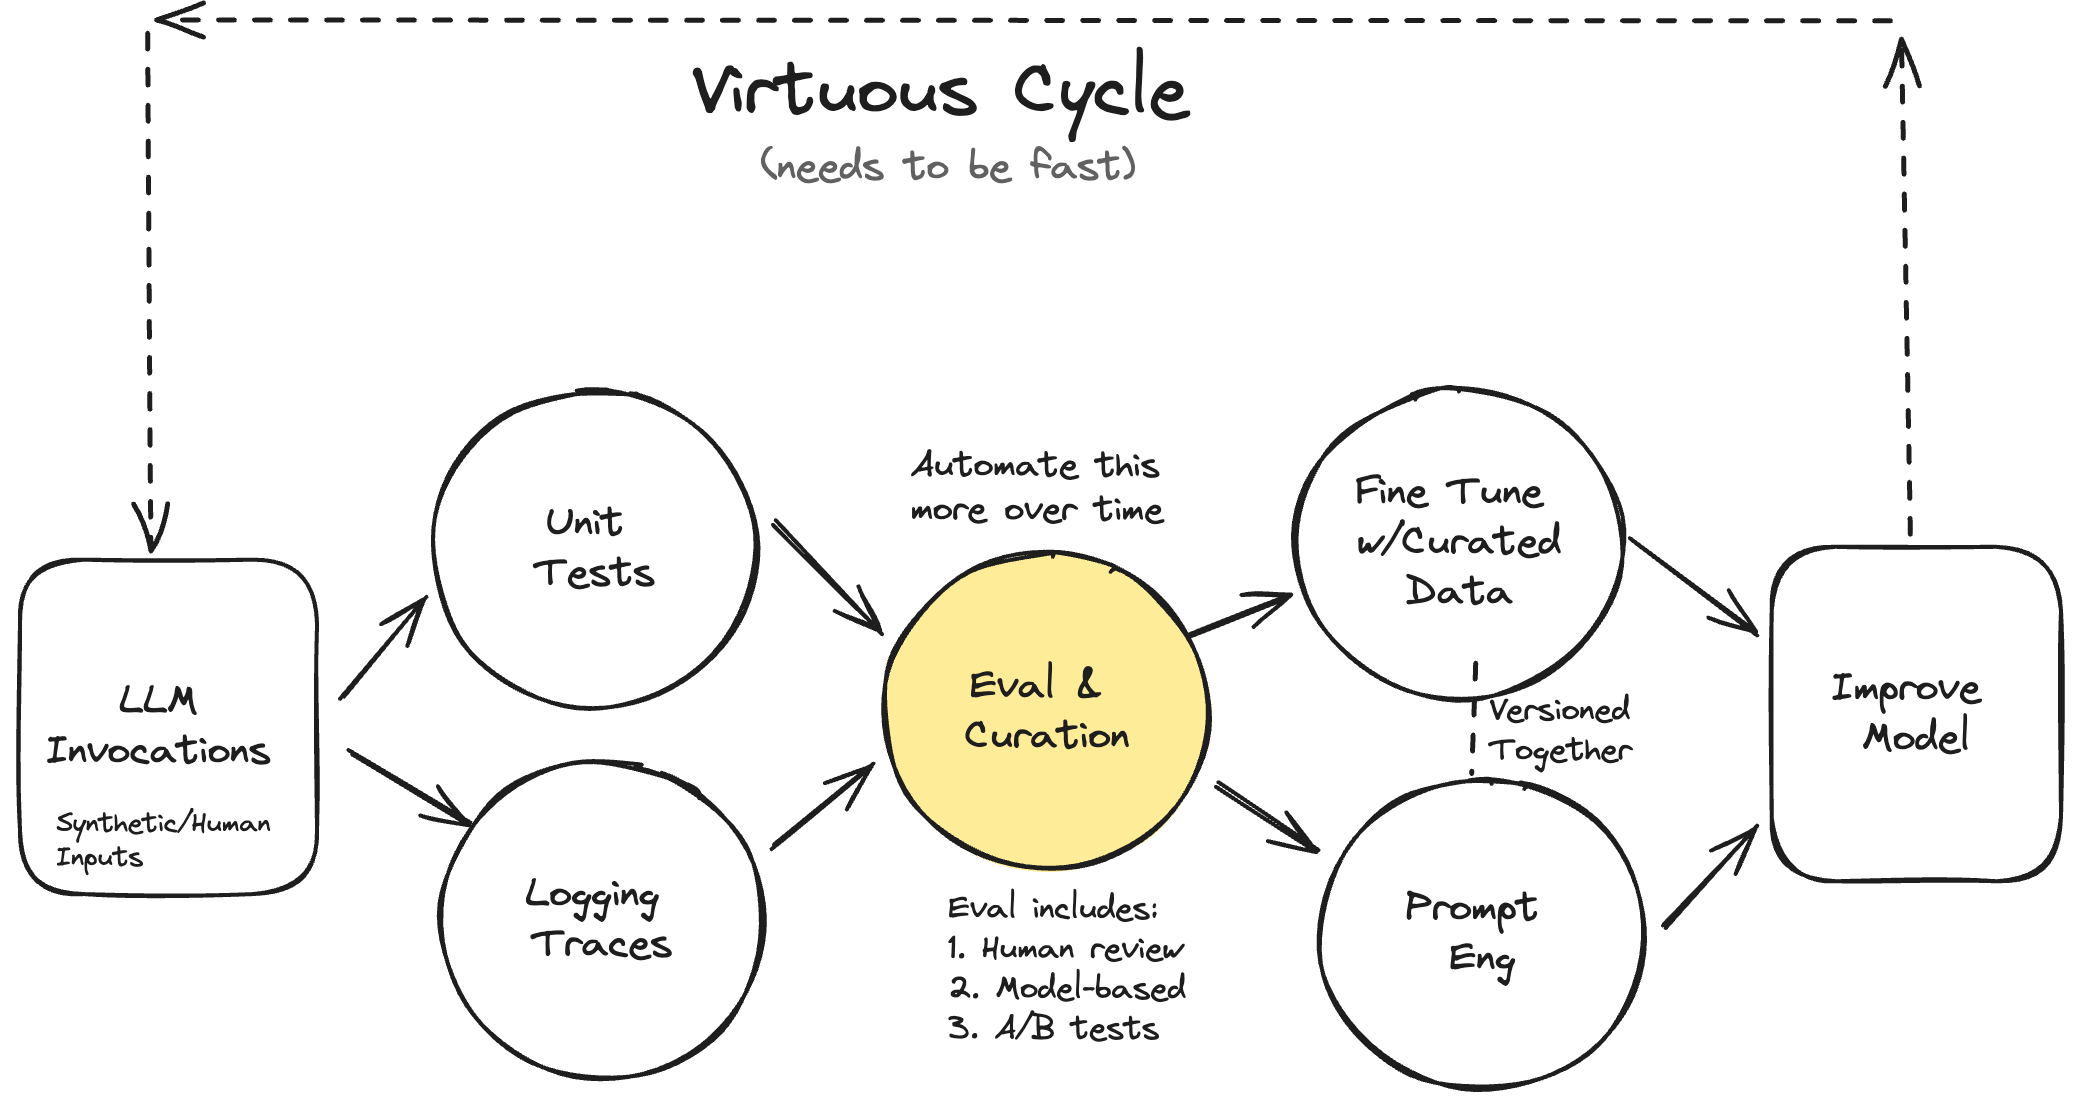
이 다이어그램은 AI 시스템 개선에 대한 저의 사고 모델을 최대한 충실하게 시각화한 것입니다. 실제 과정은 비선형적이며, 이 다이어그램과 다른 형태를 띠기도 합니다.
이 시스템의 각 구성 요소를 평가 관점에서 아래에서 설명하겠습니다.
평가의 유형
엄격하고 체계적인 평가야말로 전체 시스템에서 가장 중요한 부분입니다. 다이어그램에서 "평가(Eval) 및 큐레이션"이 노란색으로 중앙에 강조된 이유가 바로 그 때문입니다. 평가를 더 견고하고 효율적으로 만드는 데 대부분의 시간을 투자해야 합니다.
고려해야 할 평가의 단계는 세 가지입니다.
- 레벨 1: 유닛 테스트
- 레벨 2: 모델 평가 및 휴먼 평가 (디버깅 포함)
- 레벨 3: A/B 테스트
비용은 레벨 3 > 레벨 2 > 레벨 1 순입니다. 이 비용 구조가 각 평가를 실행하는 주기와 방식을 결정합니다. 예를 들어 저는 코드가 변경될 때마다 레벨 1 평가를 실행하고, 레벨 2는 정해진 주기에 따라, 레벨 3은 제품에 큰 변화가 있을 때만 진행합니다. 또한 모델 기반 테스트로 넘어가기 전에 레벨 1 테스트를 충분히 쌓아두는 것이 좋습니다. 모델 기반 테스트는 준비와 실행에 더 많은 시간과 노력이 필요하기 때문입니다.
각 레벨의 테스트를 언제 도입할지에 대한 정해진 공식은 없습니다. 사용자 피드백을 빠르게 얻는 것과 사용자 경험 관리, 그리고 AI 제품의 목표 사이에서 균형을 잡아야 합니다. 일반적인 제품을 만들 때의 트레이드오프와 크게 다르지 않습니다.
레벨 1: 유닛 테스트
LLM을 위한 유닛 테스트는 pytest에서 작성하는 것과 같은 단언문(assertion)입니다. 다만 일반적인 유닛 테스트와 달리, 이 단언문은 유닛 테스트 외에도 데이터 클리닝이나 모델 추론 중 자동 재시도(단언문 오류를 통해 방향을 수정) 등 다양한 곳에서 활용할 수 있도록 구성해야 합니다. 핵심은 애플리케이션을 개발하면서 코드가 바뀔 때마다 빠르고 저렴하게 실행할 수 있어야 한다는 것입니다. 어떤 단언문을 작성해야 할지 막막하다면, 트레이스(trace)와 실패 패턴을 꼼꼼히 분석해 보세요. LLM을 활용해 단언문 아이디어를 브레인스토밍하는 것도 적극 추천합니다!
1단계: 범위를 좁힌 테스트 작성
유닛 테스트를 가장 효과적으로 접근하는 방법은 LLM의 기능을 세부 기능(feature)과 시나리오로 나누는 것입니다. 예를 들어, Lucy의 기능 중 하나인 부동산 매물 찾기는 다음과 같이 시나리오로 분류할 수 있습니다.
기능: 매물 검색
테스트 대상 기능은 사용자의 매물 검색 요청에 응답하는 함수 호출입니다. 예를 들어 "캘리포니아 산호세에서 침실 3개 이상, 200만 달러 이하인 매물을 찾아줘"와 같은 요청이 해당됩니다.
LLM은 이 요청을 CRM에서 실행할 쿼리로 변환하고, 단언문은 기대한 수의 결과가 반환되는지 검증합니다. 저희 테스트 스위트에서는 아래 각 시나리오를 트리거하는 사용자 입력을 세 가지씩 준비해두고, 각각에 대응하는 단언문을 실행합니다(설명을 위해 단순화한 예시입니다).
| 시나리오 | 단언문 |
|---|---|
| 사용자 쿼리와 일치하는 매물이 하나뿐인 경우 | len(listing_array) == 1 |
| 사용자 쿼리와 일치하는 매물이 여러 개인 경우 | len(listing_array) > 1 |
| 사용자 쿼리와 일치하는 매물이 없는 경우 | len(listing_array) == 0 |
특정 기능에 한정되지 않는 범용 테스트도 있습니다. 예를 들어, 아래는 출력 결과에 UUID가 포함되지 않도록 검증하는 범용 테스트 코드입니다.
const noExposedUUID = message => {
  // Remove all text within double curly braces
  const sanitizedComment = message.comment.replace(/\{\{.*?\}\}/g, '')

  // Search for exposed UUIDs
  const regexp = /[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12}/ig
  const matches = Array.from(sanitizedComment.matchAll(regexp))
  expect(matches.length, 'Exposed UUIDs').to.equal(0, 'Exposed UUIDs found')
}
LLM에 반환되는 CRM 결과에는 항목의 UUID처럼 사용자에게 노출돼서는 안 되는 필드가 포함되어 있습니다. LLM 프롬프트에서 UUID를 포함하지 말라고 지시하고, 간단한 정규식으로 LLM 응답에 UUID가 없는지 확인합니다.
Rechat에는 이런 유닛 테스트가 수백 개 있으며, 사용자들이 AI를 사용하면서 새로운 실패 사례가 발견되거나 제품이 발전함에 따라 지속적으로 업데이트합니다. 이 유닛 테스트들은 프롬프트 엔지니어링이나 RAG 개선 등 AI 시스템을 반복적으로 개선할 때 빠른 피드백을 얻는 데 핵심적인 역할을 합니다. 많은 사람들이 제품이 성숙해지면 유닛 테스트를 넘어 다른 평가 방식으로 나아가지만, 이 단계를 건너뛰는 것은 절대 금물입니다!
2단계: 테스트 케이스 만들기
단언문을 테스트하려면 원하는 시나리오를 모두 트리거할 테스트 케이스, 즉 입력값을 만들어야 합니다. 저는 주로 LLM을 활용해 이 입력값을 합성적으로 생성합니다. 다음은 Rechat에서 연락처 생성 및 조회 기능을 위한 합성 입력값을 만들 때 사용하는 프롬프트 예시입니다.
Write 50 different instructions that a real estate agent can give to his assistant to create contacts on his CRM. The contact details can include name, phone, email, partner name, birthday, tags, company, address and job.

For each of the instructions, you need to generate a second instruction which can be used to look up the created contact.

. The results should be a JSON code block with only one string as the instruction like the following:


[
  ["Create a contact for John (johndoe@apple.com)",
  "What's the email address of John Smith?"]
]
위 프롬프트를 사용하면 다음과 같은 테스트 케이스들이 생성됩니다.
[
    [
        'Create a contact for John Smith (johndoe@apple.com) with phone number 123-456-7890 and address 123 Apple St.',
        'What\'s the email address of John Smith?'
    ],
    [
        'Add Emily Johnson with phone 987-654-3210, email emilyj@email.com, and company ABC Inc.',
        'What\'s the phone number for Emily Johnson?'
    ],
    [
        'Create a contact for Tom Williams with birthday 10/20/1985, company XYZ Ltd, and job title Manager.',
        'What\'s Tom Williams\' job title?'
    ],
    [
        'Add a contact for Susan Brown with partner name James Brown, and email susanb@email.com.',
    'What\'s the partner name of Susan Brown?'
    ],
…
]
각 테스트 케이스에서 첫 번째 사용자 입력을 실행해 연락처를 생성하고, 두 번째 쿼리로 해당 연락처를 조회합니다. CRM에서 정확히 1개의 결과가 반환되지 않으면 연락처 생성 또는 조회 과정에서 문제가 발생한 것으로 판단합니다. UUID가 응답에 포함되지 않는지 확인하는 것과 같은 범용 단언문도 함께 실행할 수 있습니다. 휴먼 평가와 디버깅을 통해 데이터를 관찰하면서 이 테스트들을 꾸준히 업데이트해야 합니다. 핵심은 실제 사용자 상호작용을 반영하면서도 최대한 까다로운 테스트를 만드는 것입니다.
프로덕션 데이터가 없어도 테스트를 시작할 수 있습니다. 사용자가 제품을 어떻게 사용할지 합리적으로 추측하고 합성 데이터를 생성하면 됩니다. 소수의 사용자에게 먼저 제품을 공개하고 그 사용 패턴을 바탕으로 합성 데이터 생성 전략을 다듬는 방법도 있습니다. 좋은 테스트를 작성하고 있다는 신호는 모델이 테스트를 통과하는 데 어려움을 겪을 때입니다. 이런 실패 패턴들이 이후 파인튜닝 같은 기법으로 해결할 수 있는 문제가 됩니다.
관련하여 한 가지 짚고 넘어가자면, 일반적인 유닛 테스트와 달리 반드시 100%의 통과율을 목표로 할 필요는 없습니다. 통과율 기준은 어느 수준의 실패를 허용할 것인가에 대한 제품적 판단에 따라 결정됩니다.
3단계: 테스트를 정기적으로 실행하고 추적하기
레벨 1 테스트를 운영하는 방법은 다양합니다. Rechat은 GitHub Actions, GitLab Pipelines 같은 CI 인프라를 활용해 테스트를 실행하고 있습니다. 다만 이 부분의 툴링은 아직 초기 단계이며 빠르게 발전하는 중입니다.
제가 권하는 방식은 기존 기술 스택에서 가장 마찰이 적은 방법으로 테스트를 운영하는 것입니다. 테스트 실행뿐 아니라 결과를 시간에 따라 추적해야 개선 여부를 확인할 수 있습니다. CI를 사용하는 경우, CI 시스템 외부에 테스트 및 프롬프트 버전과 함께 지표를 별도로 수집해두면 분석과 추적이 훨씬 수월합니다.
처음에는 단순하게 시작하고, 기존 분석 시스템을 활용해 테스트 결과를 시각화하는 것을 추천합니다. Rechat은 Metabase를 사용해 LLM 테스트 결과를 시간에 따라 추적하고 있습니다. 아래는 Rechat이 Metabase로 구축한 대시보드 스크린샷입니다.
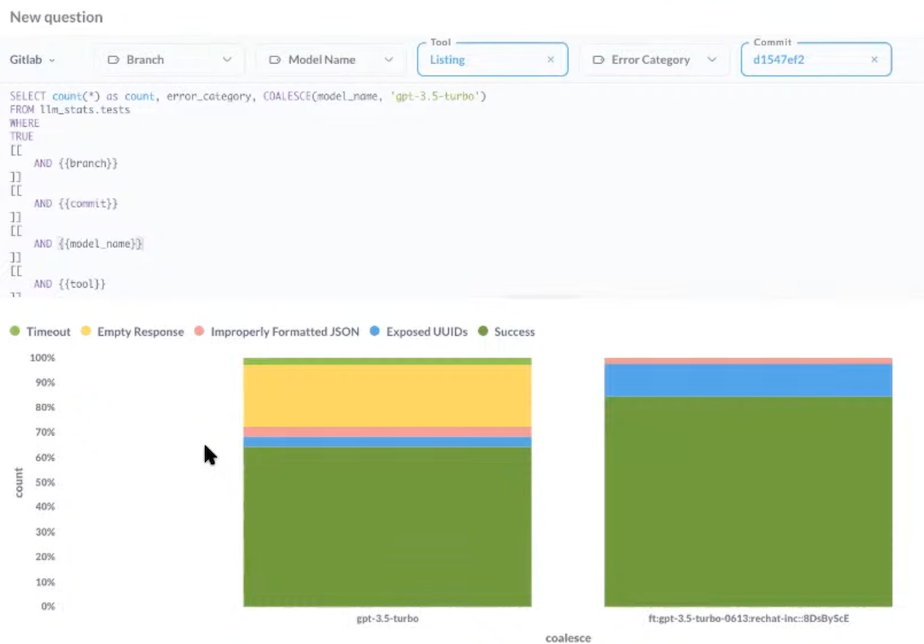
이 스크린샷은 Lucy에서 특정 오류(노란색)가 발생한 빈도를 수정 전(왼쪽)과 수정 후(오른쪽)로 비교해 보여줍니다.
레벨 2: 휴먼 평가 및 모델 평가
레벨 1 테스트로 탄탄한 기반을 쌓았다면, 단언문만으로는 검증하기 어려운 영역으로 나아갈 수 있습니다. 휴먼 평가와 모델 기반 평가를 수행하려면 먼저 트레이스를 로깅하는 것이 선행되어야 합니다.
트레이스 로깅
트레이스(trace)는 소프트웨어 엔지니어링에서 오래전부터 쓰이던 개념으로, 사용자 세션이나 분산 시스템의 요청 흐름 같은 일련의 이벤트 로그를 의미합니다. 쉽게 말해 로그를 논리적으로 묶어 놓은 것입니다. LLM 맥락에서는 주로 대화 흐름을 가리킵니다. 예를 들어 사용자 메시지, AI 응답, 그 다음 사용자 메시지로 이어지는 흐름이 하나의 트레이스가 됩니다.
LLM 트레이스를 로깅하는 솔루션은 점점 늘어나고 있습니다.2 Rechat은 LangSmith를 사용하는데, 트레이스를 기록하고 사람이 읽기 좋은 형태로 보여주며 프롬프트를 직접 수정해볼 수 있는 인터랙티브 플레이그라운드도 제공합니다. 트레이스 로깅 시 코드를 직접 계측(instrument)해야 하는 경우도 있는데, Rechat은 LangChain을 사용하고 있어 트레이스 이벤트가 LangSmith에 자동으로 기록됩니다. 아래는 그 화면입니다.
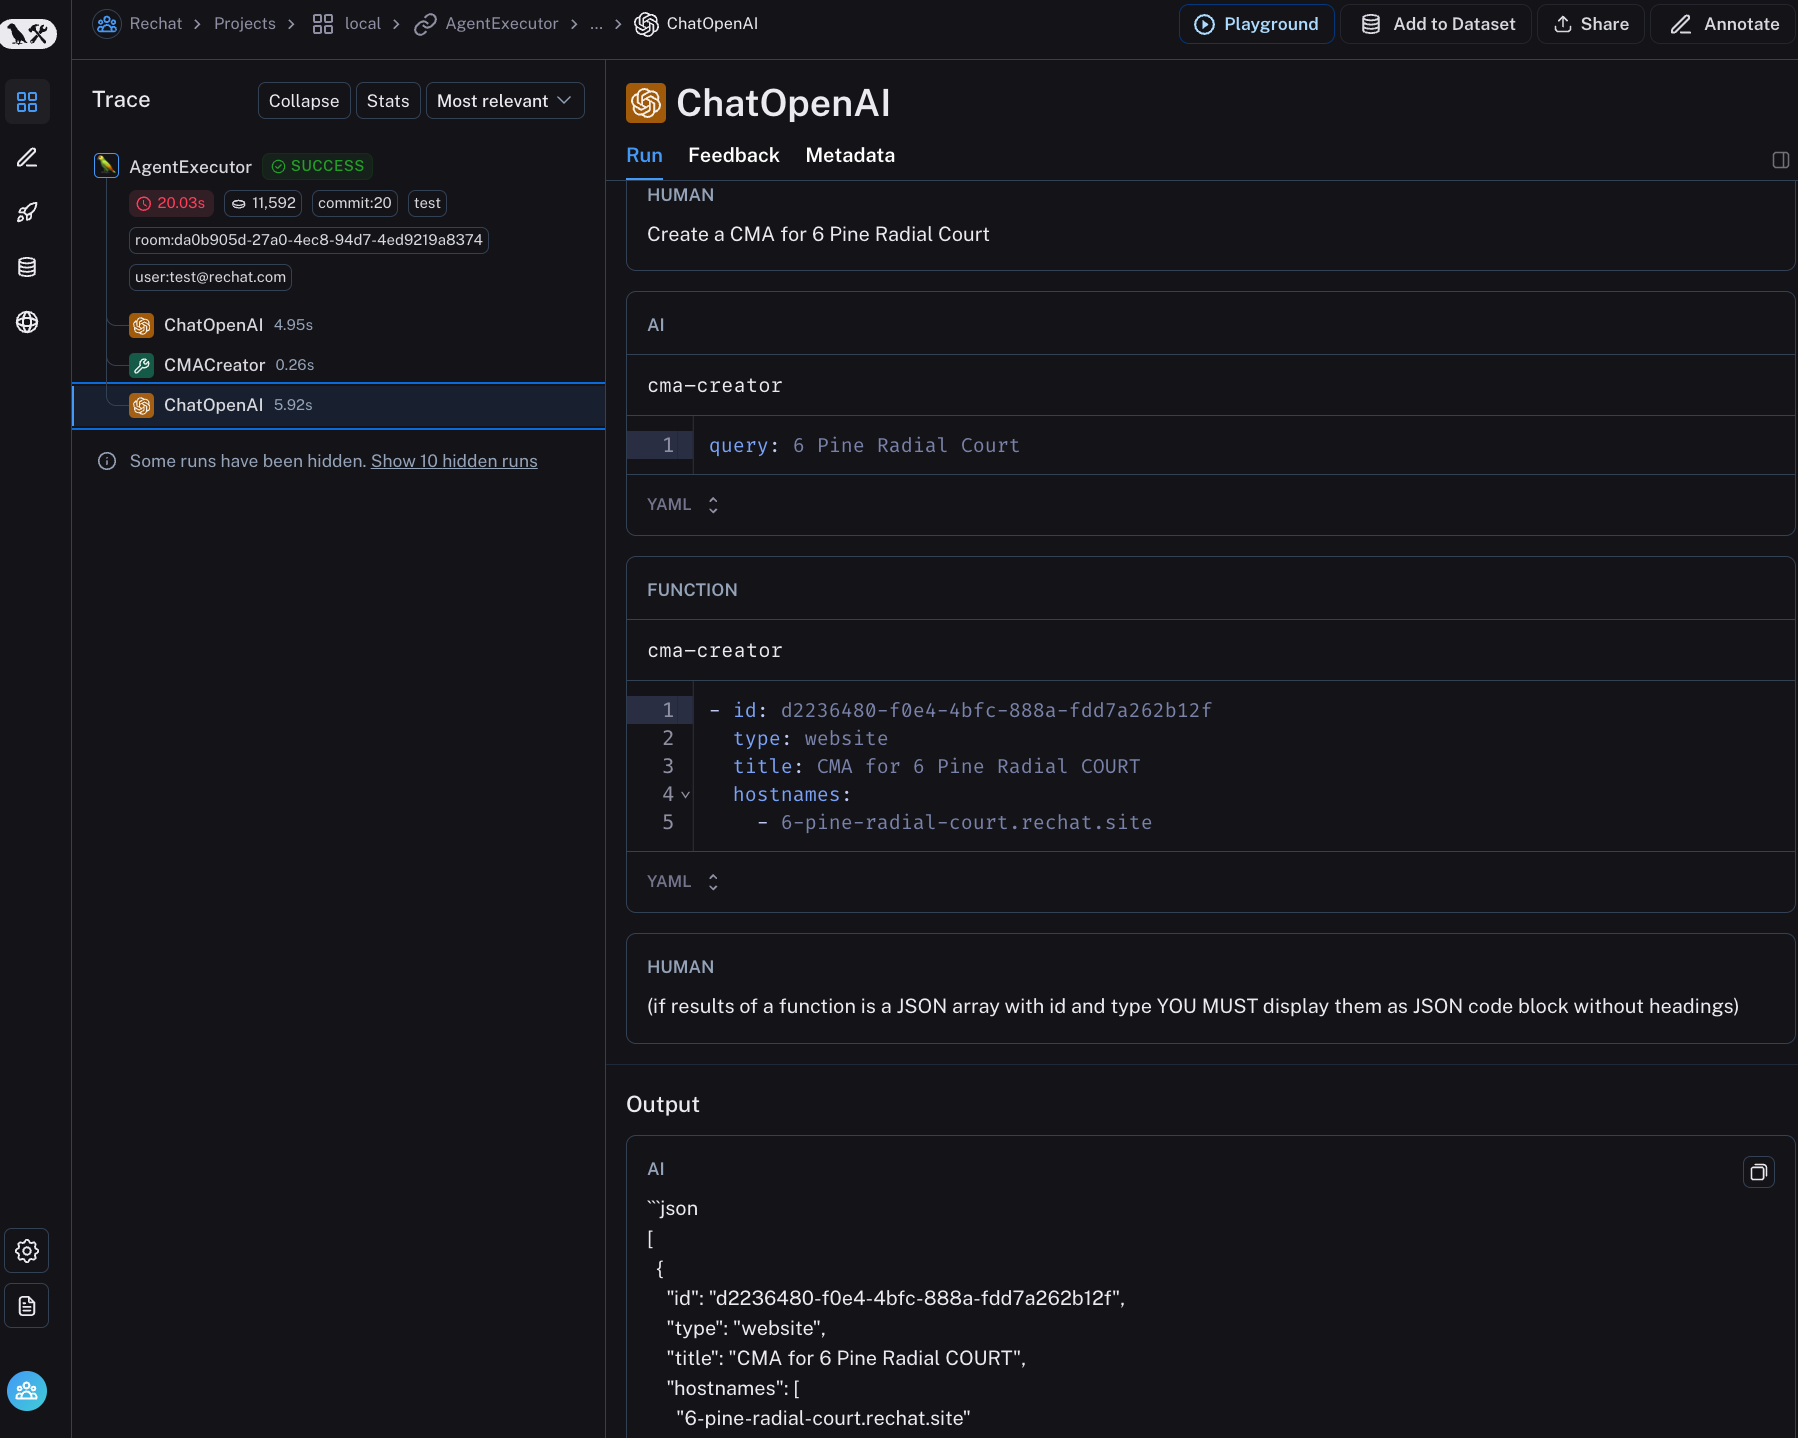
저는 LangSmith를 선호합니다. LangChain 없이도 사용할 수 있고, 직관적이며 사용하기 쉽습니다. 어떤 솔루션을 선택하든 트레이스 검색, 필터링, 조회 기능은 반드시 갖춰야 합니다. 이 기본 기능조차 제대로 구현하지 못한 도구들도 있으니 주의하세요!
트레이스 들여다보기
데이터를 살펴보는 과정에서 발생하는 모든 마찰을 제거해야 합니다. 이는 트레이스를 도메인에 맞는 방식으로 렌더링한다는 것을 의미합니다. 저는 필요한 모든 정보를 한 화면에서 볼 수 있도록 데이터 조회 및 레이블링 도구를 직접 만드는 편이 낫다는 것을 경험으로 깨달았습니다. Lucy의 경우 AI가 무엇을 했는지 파악하려면 트레이스 로그, CRM 등 여러 정보 출처를 동시에 봐야 했습니다. 이런 마찰을 없애는 것이 핵심입니다. Rechat의 경우, 다음과 같은 정보를 한 곳에서 볼 수 있도록 했습니다.
- 평가 중인 도구(기능)와 시나리오
- 해당 트레이스가 합성 입력에서 비롯됐는지, 실제 사용자 입력에서 비롯됐는지 여부
- 다양한 도구와 시나리오 조합 간 이동을 위한 필터
- 현재 레코드의 CRM 및 트레이스 로깅 시스템으로 연결되는 링크
저는 작업마다 이 도구의 변형 버전을 새로 만들어 왔습니다. 때로는 사용자 인터랙션이 어떻게 보이는지 확인하기 위해 다른 애플리케이션을 직접 임베드해야 할 때도 있었습니다. 아래는 Rechat 트레이스 평가를 위해 구축한 도구의 스크린샷입니다.
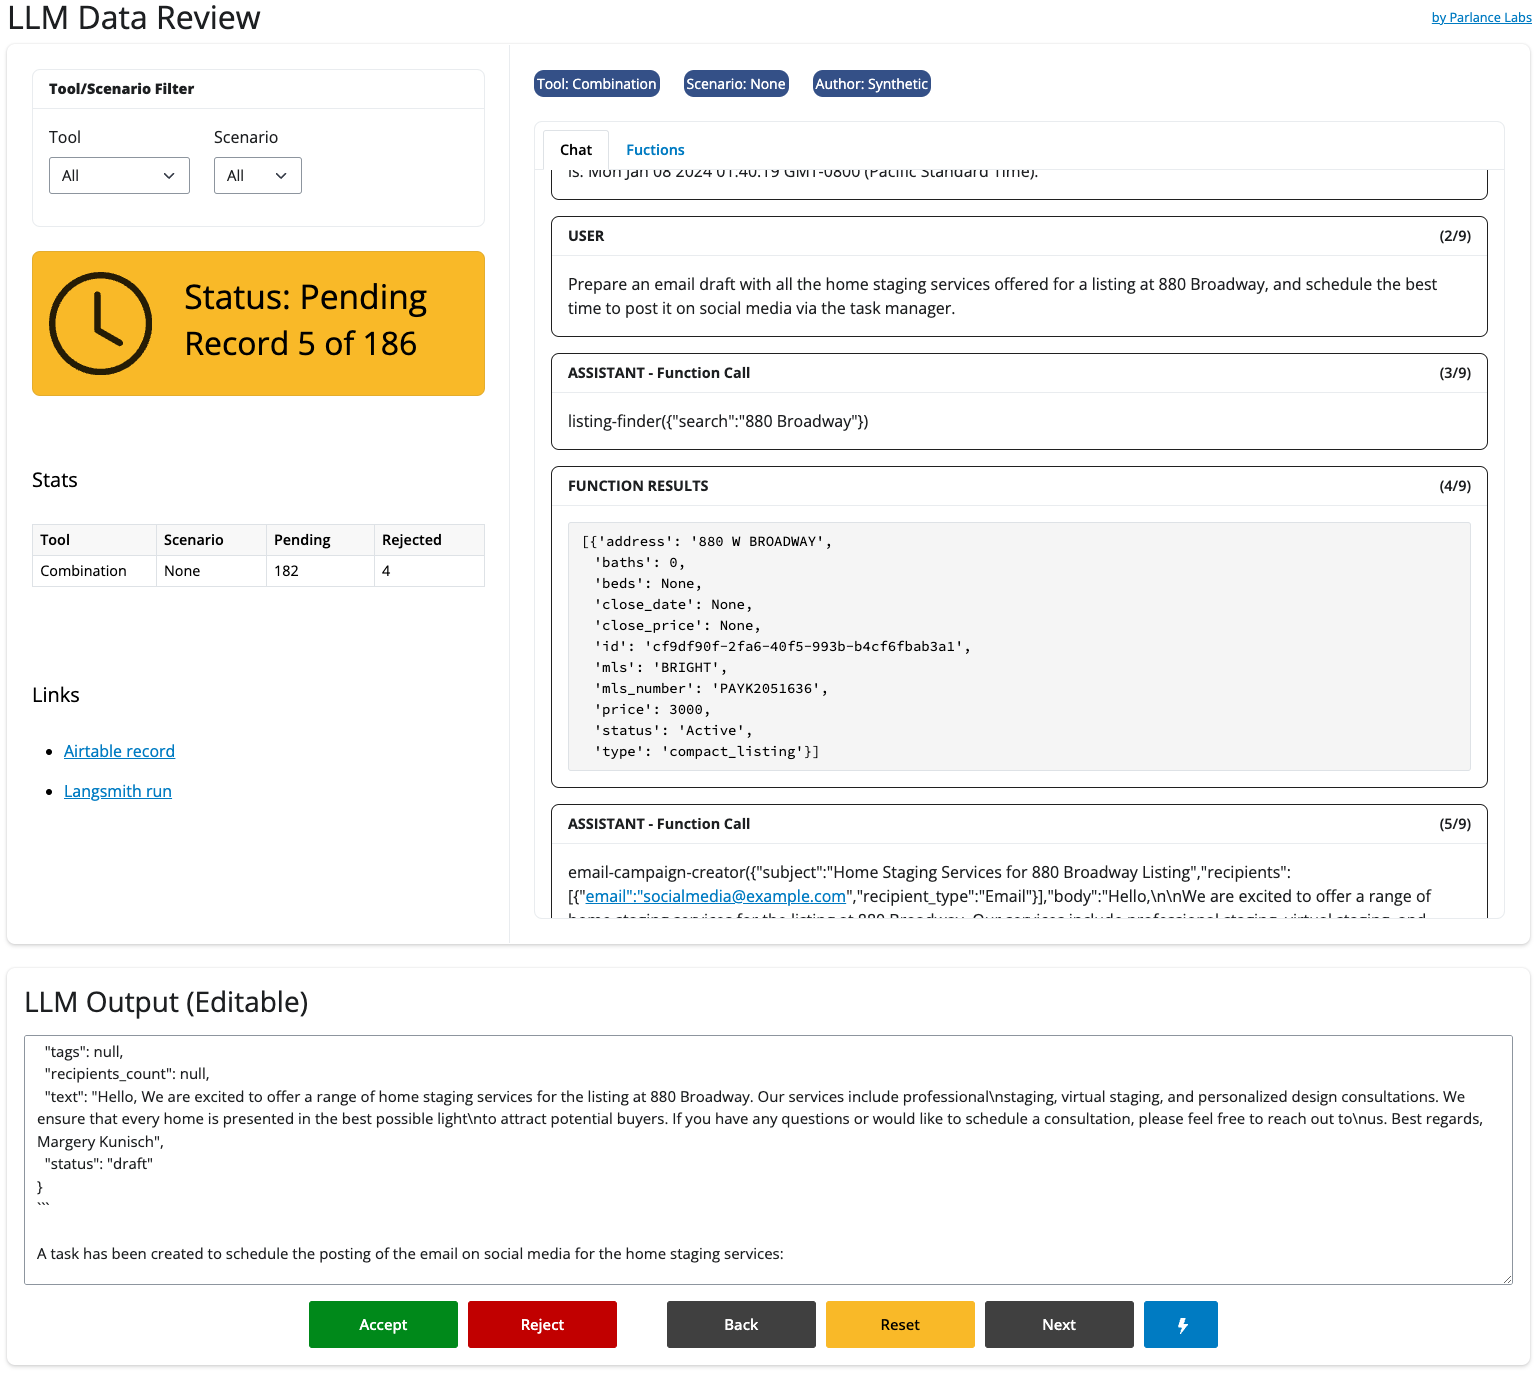
Lucy에서 주목할 만한 설계 결정 중 하나는, 많은 실패 사례가 LLM 최종 출력의 사소한 오류(형식, 내용 등)에서 비롯된다는 점을 발견한 것입니다. 이에 사람이 최종 출력을 직접 수정할 수 있도록 해, 파인튜닝을 위한 데이터를 큐레이션하고 수정할 수 있게 했습니다.
이런 도구는 Gradio, Streamlit, Panel, Shiny 같은 가벼운 프론트엔드 프레임워크로 하루도 안 걸려 만들 수 있습니다. 위 도구는 Shiny for Python으로 제작했습니다. 또한 Lilac처럼 AI를 활용해 데이터를 의미적으로 검색하고 필터링하는 도구도 있어, 문제를 디버깅하면서 유사한 데이터 포인트를 찾을 때 매우 유용합니다.
저는 보통 예시를 좋음/나쁨으로 이진 분류하는 것부터 시작합니다. 점수나 세부 등급을 매기는 것보다 이진 평가가 관리하기 훨씬 수월하다는 것을 경험으로 알게 됐습니다. 휴먼 평가를 더 효율적이고 정확하게 만드는 고급 기법들(능동 학습(active learning), 합의 투표(consensus voting) 등)도 있지만, 단순한 것부터 시작하길 권합니다. 유닛 테스트와 마찬가지로, 휴먼 평가 결과도 정리하고 분석해서 시간이 지남에 따라 개선이 이루어지고 있는지 확인해야 합니다.
이렇게 레이블링된 예시들은 뒤에서 다시 설명하겠지만, 시스템 품질 측정, 자동 평가 검증, 파인튜닝을 위한 고품질 합성 데이터 큐레이션에 모두 활용됩니다.
데이터를 얼마나 봐야 할까요?
얼마나 많은 데이터를 살펴봐야 하는지 자주 질문을 받습니다. 초반에는 가능한 한 많은 데이터를 보는 것이 좋습니다. 저는 보통 최소한 모든 테스트 케이스에서 생성된 트레이스와 실제 사용자 트레이스를 모두 검토합니다. 데이터를 보는 것을 멈출 수 있는 때는 없습니다. 공짜 점심은 없으니까요. 다만 시간이 지나면서 샘플링 비율을 높여 부담을 줄일 수 있습니다. 3
LLM을 활용한 자동 평가
많은 벤더들이 사람이 데이터를 직접 볼 필요를 없애준다고 주장하는 도구를 팔려고 합니다. 하지만 사람이 주기적으로 트레이스의 적어도 일부를 평가하는 것은 여전히 중요합니다. '정확성'은 상당 부분 주관적이기 때문에, 모델을 사람의 판단에 맞게 조정하는 과정이 반드시 필요합니다.
모델 기반 평가와 휴먼 평가 간의 상관관계를 추적하면, 자동 평가를 얼마나 신뢰할 수 있는지 파악하는 데 도움이 됩니다. 또한 레이블러(labeler)로부터 판단 근거에 대한 피드백을 수집하면, 프롬프트 엔지니어링이나 파인튜닝을 통해 평가 모델을 사람의 판단에 더 가깝게 정렬할 수 있습니다. 저는 평가 모델 정렬에는 파인튜닝보다 프롬프트 엔지니어링을 더 선호합니다.
저는 엑셀 같은 단순한 도구를 이용해 모델 기반 평가와 휴먼 평가를 맞추는 작업을 합니다. 예를 들어 자연어 쿼리 생성기와 관련된 다른 프로젝트에서는, 동료 Phillip에게 며칠마다 다음과 같은 스프레드시트를 전달해 점수를 매기도록 했습니다. 스프레드시트에는 다음 정보가 포함됩니다.
- 모델 응답(model response): LLM이 생성한 예측값
- 모델 피드백(model critique): 원래 LLM의 예측에 대해 (보통 더 강력한) LLM이 작성한 비평
- 모델 판정(model outcome): 비평 모델이
model response를 "좋음" 또는 "나쁨"으로 이진 분류한 결과
Phillip은 동일한 정보에 대해 자신의 버전, 즉 비평, 판정, 원하는 응답을 25~50개씩 작성합니다(아래에서 "phillip_" 접두사가 붙은 열들입니다).
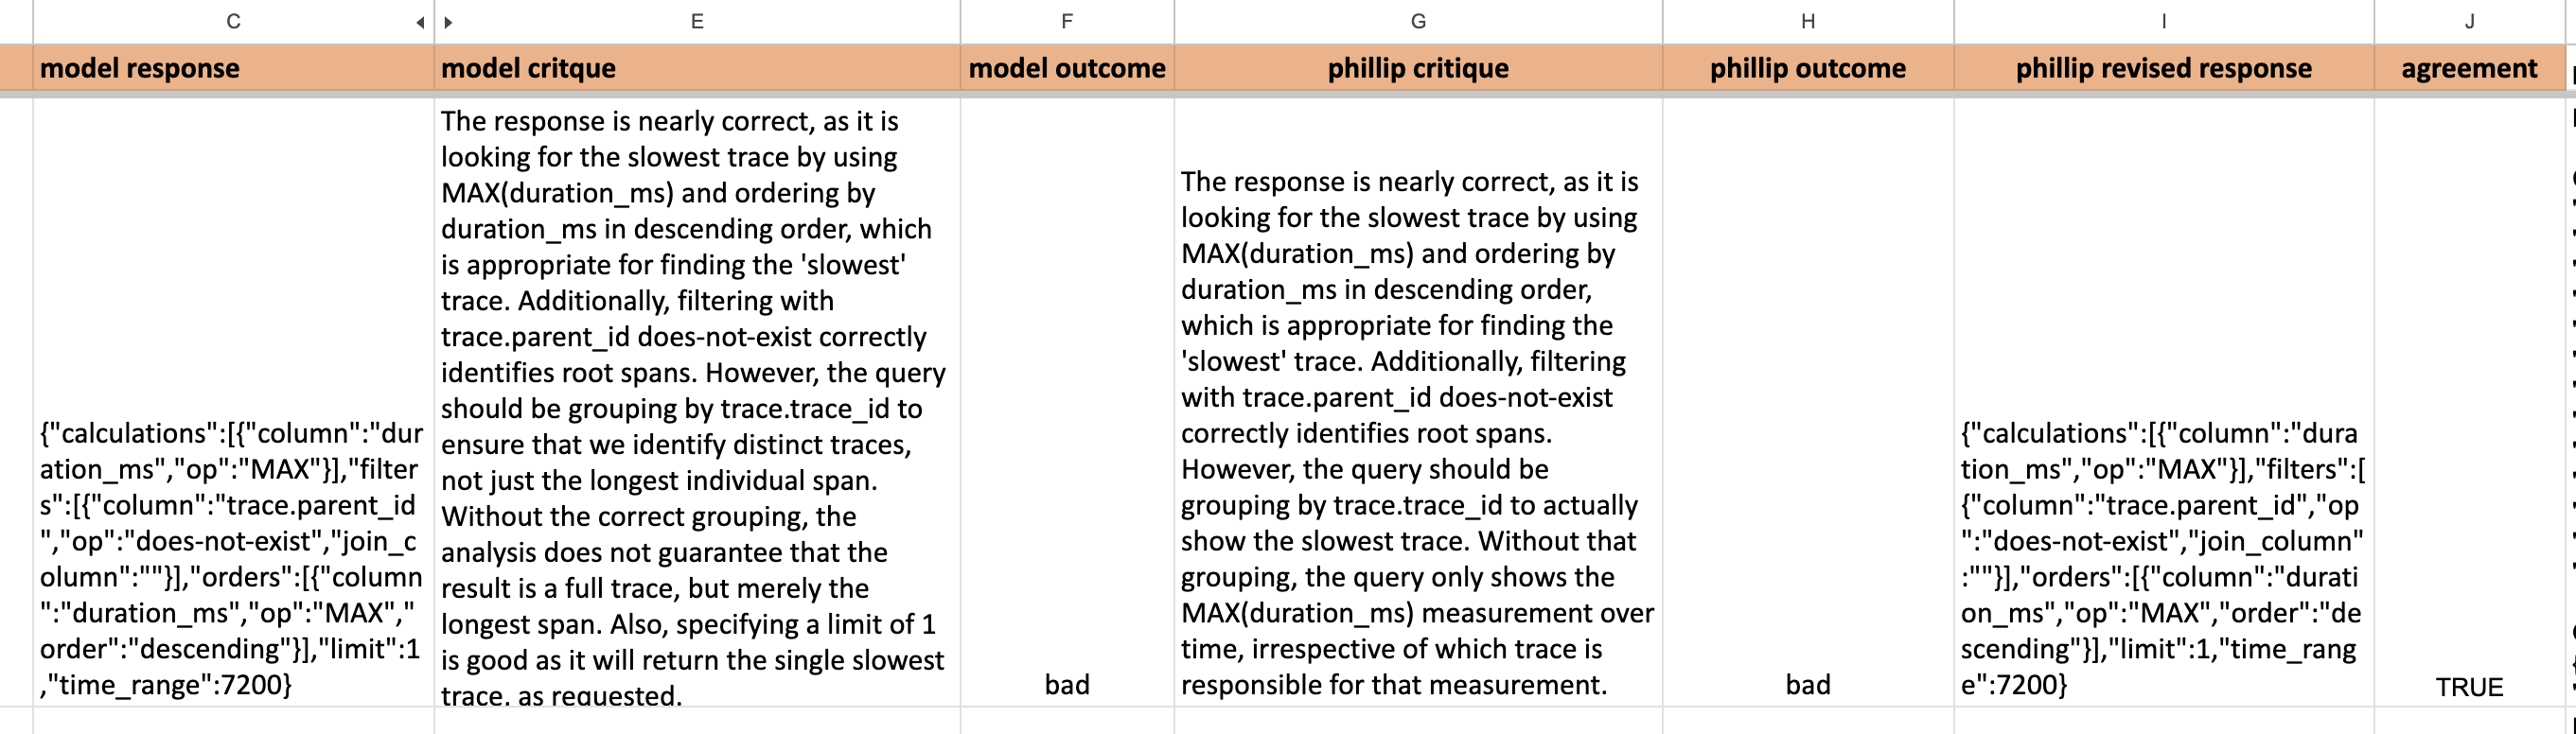
이 정보를 바탕으로 비평 모델의 프롬프트를 반복적으로 개선해, 점차 Phillip의 판단과 일치하도록 맞춰 나갔습니다. 이 과정도 스프레드시트로 간단하게 추적할 수 있습니다.
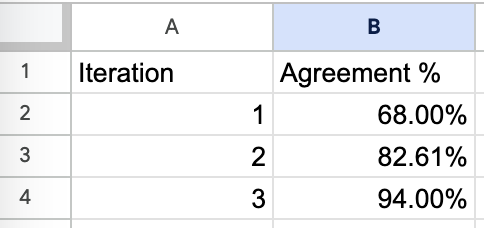
모델 기반 평가를 휴먼 평가자의 판단에 맞추는 시도들을 기록한 스프레드시트 스크린샷입니다.
모델 기반 평가에 대한 일반적인 팁입니다.
- 감당할 수 있는 범위에서 가장 강력한 모델을 사용하세요. 비평에는 높은 수준의 추론 능력이 필요한 경우가 많습니다. 프로덕션에 사용하는 모델보다 느리더라도 더 강력한 모델을 비평용으로 사용하는 경우가 많습니다.
- 모델 기반 평가는 더 큰 문제 안에 존재하는 메타 문제입니다. 그 품질을 추적하기 위한 소규모 평가 체계를 별도로 유지해야 합니다. 이 단계에서 모델을 파인튜닝한 적도 있지만, 가능하면 피하려고 합니다.
- 모델 기반 평가자를 사람의 판단에 맞게 조정한 후에도, 모델과 사람 간의 일치도를 지속적으로 모니터링해야 합니다.
주의일치율을 지표로 사용할 때 주의할 점
이 예시에서는 데이터셋이 대략 균형 잡혀 있었기 때문에(실패 사례가 약 50%) 모델과 휴먼 평가자 간의 일치율을 사용했습니다. 그러나 일반적으로 단순 일치율은 권장하지 않으며, 클래스 불균형이 있을 경우 오해를 불러일으킬 수 있습니다. 평가자의 정렬 상태를 더 정확하게 파악하려면 정밀도(precision)와 재현율(recall)을 각각 측정하는 것이 좋습니다.
좋은 평가 모델을 만들었을 때 제가 가장 좋아하는 점은, 그 모델의 비평이 고품질 합성 데이터를 큐레이션하는 데 그대로 활용된다는 것입니다. 이 부분은 뒤에서 더 다루겠습니다.
레벨 3: A/B 테스트
마지막으로, AI 제품이 원하는 사용자 행동이나 결과를 실제로 이끌어내고 있는지 확인하기 위해 A/B 테스트를 수행하는 것이 좋습니다. LLM의 A/B 테스트는 다른 유형의 제품과 크게 다르지 않습니다. A/B 테스트에 대해 더 알고 싶다면 Eppo 블로그를 추천합니다(함께 일했던 동료들이 운영하는 곳으로, A/B 테스트 분야의 최고 전문가들입니다).
이 단계는 AI 제품이 실제 사용자에게 보여줄 만큼 충분히 준비됐다고 확신이 설 때까지 미뤄도 괜찮습니다. 레벨 3 평가는 대개 어느 정도 성숙한 제품에 적합합니다.
RAG 평가
시스템 전체를 평가하는 것 외에도, RAG처럼 AI의 하위 구성 요소를 별도로 평가할 수 있습니다. RAG 평가는 이 글의 범위를 벗어나는 주제이므로, 더 알고 싶다면 Jason Liu의 포스트를 참고하세요.
평가 체계가 만들어주는 강력한 부수 효과
빠른 반복 외에도, 평가 체계는 파인튜닝과 디버깅 역량을 함께 키워주어 AI 제품을 한 단계 끌어올릴 수 있습니다.
파인튜닝
Rechat은 프롬프트 엔지니어링만으로는 해결할 수 없었던 많은 실패 패턴들을 파인튜닝을 통해 개선했습니다. 파인튜닝은 문법, 스타일, 규칙을 학습시키는 데 효과적이며, RAG 같은 기법은 모델에 맥락이나 최신 정보를 제공하는 역할을 합니다.
파인튜닝에 투입되는 노력의 99%는 AI 제품의 전체 기능 범위를 커버하는 고품질 데이터를 모으는 데 쓰입니다. 그런데 Rechat처럼 탄탄한 평가 체계가 있다면, 이미 견고한 데이터 생성 및 큐레이션 엔진을 갖추고 있는 셈입니다! 파인튜닝 프로세스에 대해서는 추후 별도 포스트에서 더 자세히 다루겠습니다.4
데이터 합성 및 큐레이션
평가 체계가 갖춰지면 데이터 큐레이션과 합성이 거의 자동으로 따라온다는 것을 이해하기 위해, 앞서 언급한 매물 검색 기능의 파인튜닝 데이터를 추가로 생성하는 경우를 살펴보겠습니다. 우선 다음과 같은 프롬프트로 LLM이 합성 데이터를 생성하게 할 수 있습니다.
Imagine if Zillow was able to parse natural language. Come up with 50 different ways users would be able to search listings there. Use real names for cities and neighborhoods.

You can use the following parameters:

<omitted for confidentiality>

Output should be a JSON code block array. Example:

[
"Homes under $500k in New York"
]
테스트 케이스를 만드는 과정과 거의 동일합니다! 이후 레벨 1 및 레벨 2 테스트를 활용해 단언문을 통과하지 못하거나 비평 모델이 잘못됐다고 판단하는 데이터를 걸러낼 수 있습니다. 또한 기존 휴먼 평가 도구로 트레이스를 직접 검토해 파인튜닝 데이터셋으로 쓸 트레이스를 선별할 수도 있습니다.
디버깅
AI 제품과 관련한 불만 사항이나 오류가 발생했을 때 빠르게 디버깅할 수 있어야 합니다. 견고한 평가 체계가 있다면 이미 다음을 갖추고 있는 것입니다.
- 검색과 필터링이 가능한 트레이스 데이터베이스
- 오류와 비정상적인 동작을 감지하는 단언문 및 테스트 등의 메커니즘
- 오류의 근본 원인을 찾는 데 도움이 되는 로그 검색 및 탐색 도구. 예를 들어 문제가 RAG에 있는지, 코드 버그인지, 아니면 모델 성능 저하인지 파악할 수 있습니다.
- 오류에 대응해 수정하고 그 효과를 신속하게 검증하는 능력
결국, 평가에 필요한 인프라와 디버깅에 필요한 인프라는 매우 큰 폭으로 겹쳐 있습니다.
마치며
평가 체계는 빠른 반복을 가능하게 하는 플라이휠을 만들어냅니다. AI 제품을 구축할 때 막히는 지점은 거의 항상 여기입니다. 이 글이 여러분만의 평가 체계를 구축하는 데 방향을 잡는 데 도움이 되길 바랍니다. 핵심 요점을 정리하면 다음과 같습니다.
- 데이터를 보는 과정의 모든 마찰을 제거하세요.
- 단순하게 유지하세요. 비싼 LLM 도구를 살 필요 없습니다. 가진 것부터 활용하세요.
- 데이터를 충분히 보지 않고 있다면, 뭔가 잘못하고 있는 겁니다.
- AI 품질을 측정하는 데 범용 평가 프레임워크에 의존하지 마세요. 여러분의 문제에 특화된 평가 체계를 직접 만드세요.
- 테스트를 많이 작성하고 자주 업데이트하세요.
- LLM을 활용하면 평가 체계 구축에 드는 수고를 크게 줄일 수 있습니다. 예를 들어 LLM으로 다음을 할 수 있습니다.
- 테스트 케이스 생성 및 단언문 작성
- 합성 데이터 생성
- 데이터 비평 및 레이블링 등
- 평가 인프라를 디버깅과 파인튜닝에도 재활용하세요.
이 글이 도움이 됐거나 궁금한 점이 있다면 연락 주세요. 이메일은 hamel@parlance-labs.com입니다.
이 글은 Vanishing Gradients 팟캐스트에서 Emil Sedgh, Hugo Browne-Anderson과 나눈 대화를 바탕으로 재구성했습니다. 이 글을 검토해준 Jeremy Howard, Eugene Yan, Shreya Shankar, Jeremy Lewi, Joseph Gleasure에게 감사드립니다.
각주
사람들이 게을러서가 아닙니다. 평가 체계를 어떻게 구축해야 하는지 몰라 이 단계를 건너뛰는 경우가 대부분입니다.↩︎
대표적인 예로 arize, human loop, openllmetry, honeyhive 등이 있습니다.↩︎
합리적인 기준은 로그를 읽으면서 더 이상 새로운 것을 배우지 못한다고 느껴질 때까지 계속 보는 것입니다.↩︎


