Vercel기술 블로그engineering
의사결정 모델이 요청의 26% 차지, Anthropic은 신규 팀 선택에서 2대 1로 앞서
2026년 10월 데이터를 바탕으로 한 11월 AI Gateway 프로덕션 인덱스입니다. 의사결정 모델이 전체 요청의 4분의 1을 처리하지만 비용은 1달러당 0.5센트에 불과합니다. 신규 팀은 Anthropic을 거의 2대 1 비율로 선택했고, AI 트래픽 대부분은 출시 두 달이 채 되지 않은 최신 모델에서 처리됩니다.
AI Gateway 프로덕션 인덱스 — 2026년 11월
AI Gateway는 매달 100조 개가 넘는 토큰을 프로덕션 애플리케이션과 AI 랩 사이에서 중계합니다. 이 트래픽을 보면 언어, 의사결정, 음성, 이미지, 영상 모델 전반에서 오늘날 기업과 스타트업이 AI를 어떻게 쓰는지 알 수 있습니다. 이 인덱스는 매달 이곳에 공개합니다. 지난 보고서는 8월, 9월, 10월 편에서 확인하세요.
2026년 11월 요약
의사결정 모델은 6주 만에 게이트웨이 요청의 4분의 1까지 늘었지만, 전체 지출에서 차지하는 비중은 1달러당 0.5센트에 그쳤습니다. 10월에 유료 팀의 3분의 1에 가까운 팀이 의사결정 모델을 사용했습니다. 월 100억 토큰 이상을 처리하는 팀으로 좁히면 10곳 중 7곳이 의사결정 모델을 썼습니다.
10월에 음성 모델을 사용한 유료 팀은 약 11%로, 7월의 4%에서 늘었습니다.
OpenAI와 Anthropic을 쓰는 유료 팀의 비율은 이제 비슷한 수준이며, 10월 신규 팀은 Anthropic을 거의 2대 1 비율로 선택했습니다. 한편 게이트웨이 지출에서 OpenAI가 차지하는 비중은 12월 이후 3분의 2만큼 늘었습니다.
언어 모델 요청의 절반 이상이 출시 두 달이 안 된 모델로 향했습니다. 이전에는 이 비율이 30%를 넘은 적이 없었습니다. 일반적인 모델은 사용량이 정점에 이르고 한 달이 지나면, 그 모델을 쓰던 팀의 4분의 3이 다른 모델로 옮겨 갑니다.
의사결정 모델이 전체 요청의 26% 차지
프로덕션 AI의 역할이 생성과 판단 두 갈래로 나뉘고 있습니다. 얼마 전까지만 해도 소프트웨어가 빠르게 판단을 내려야 할 때 팀이 택할 수 있는 방법은 두 가지였습니다. 저렴하지만 융통성 없는 고정 규칙, 또는 똑똑하지만 느리고 비싼 언어 모델입니다.
이제 의사결정 모델이라는 세 번째 선택지가 생겼습니다. 의사결정 모델은 텍스트를 생성하는 대신 분류하거나 점수를 매기거나 선택지 중 하나를 고르며, 요청당 비용은 언어 모델의 약 70분의 1입니다.
의사결정 모델은 9월 중순 AI Gateway에 도입되었고, 현재 8개 벤더의 모델 15종을 쓸 수 있습니다. 10월에는 AI Gateway의 유료 팀 가운데 3분의 1 가까이가 의사결정 모델을 사용했습니다. 텍스트 생성 모델에는 요청을 단 한 건도 보내지 않고 의사결정 모델만 쓴 유료 팀도 약 11%였습니다.
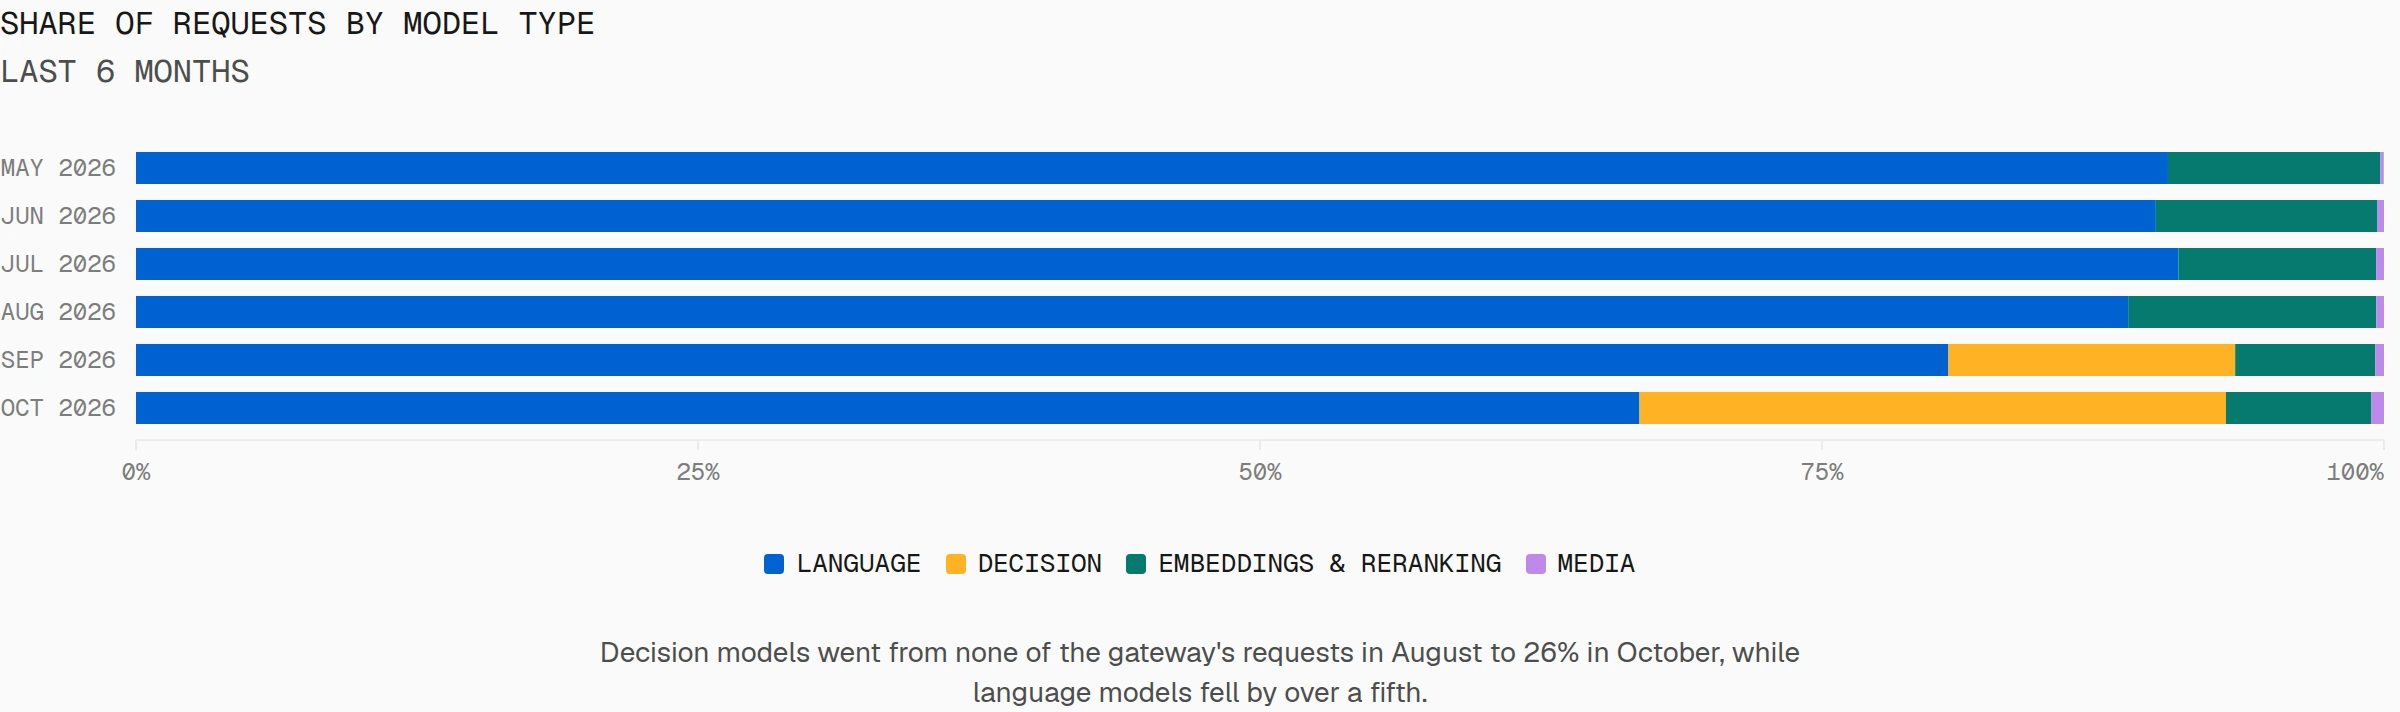
의사결정 모델은 토큰당 비용이 훨씬 낮고 답변도 아주 짧습니다. 그래서 10월 게이트웨이 요청의 약 4분의 1을 받았는데도 전체 지출에서는 0.53%만 차지했습니다.
이 요청량은 거의 대부분 TypeSafe AI의 Jev에 몰렸으며, Jev 한 모델이 받은 요청만 Anthropic 전체 요청의 4배에 가깝습니다. 팀들이 Jev에 1달러를 쓰는 동안 Anthropic 모델에는 64달러를 썼습니다.
의사결정 모델은 AI를 가장 많이 쓰는 팀에서 가장 흔합니다. 10월에 토큰 사용량이 1,000만 개 미만인 팀 중에서는 5곳 중 1곳 남짓이 의사결정 모델을 썼습니다. 1억~10억 토큰 구간에서는 절반 가까이, 100억 토큰 이상에서는 10곳 중 7곳이 썼습니다.
규모가 큰 팀은 모든 모델을 더 많이 쓰기 때문이기도 합니다. 지출 상위 1% 팀은 중앙값 기준으로 29종의 모델을 쓰는 반면, 하위 10%는 한 종만 씁니다. 요청량의 영향도 있습니다. 보내는 요청이 많을수록 단순한 판단을 더 빠르고 훨씬 저렴하게 처리하는 모델에서 얻는 이득도 커집니다.
음성 모델 도입, 7월 이후 2.6배 증가
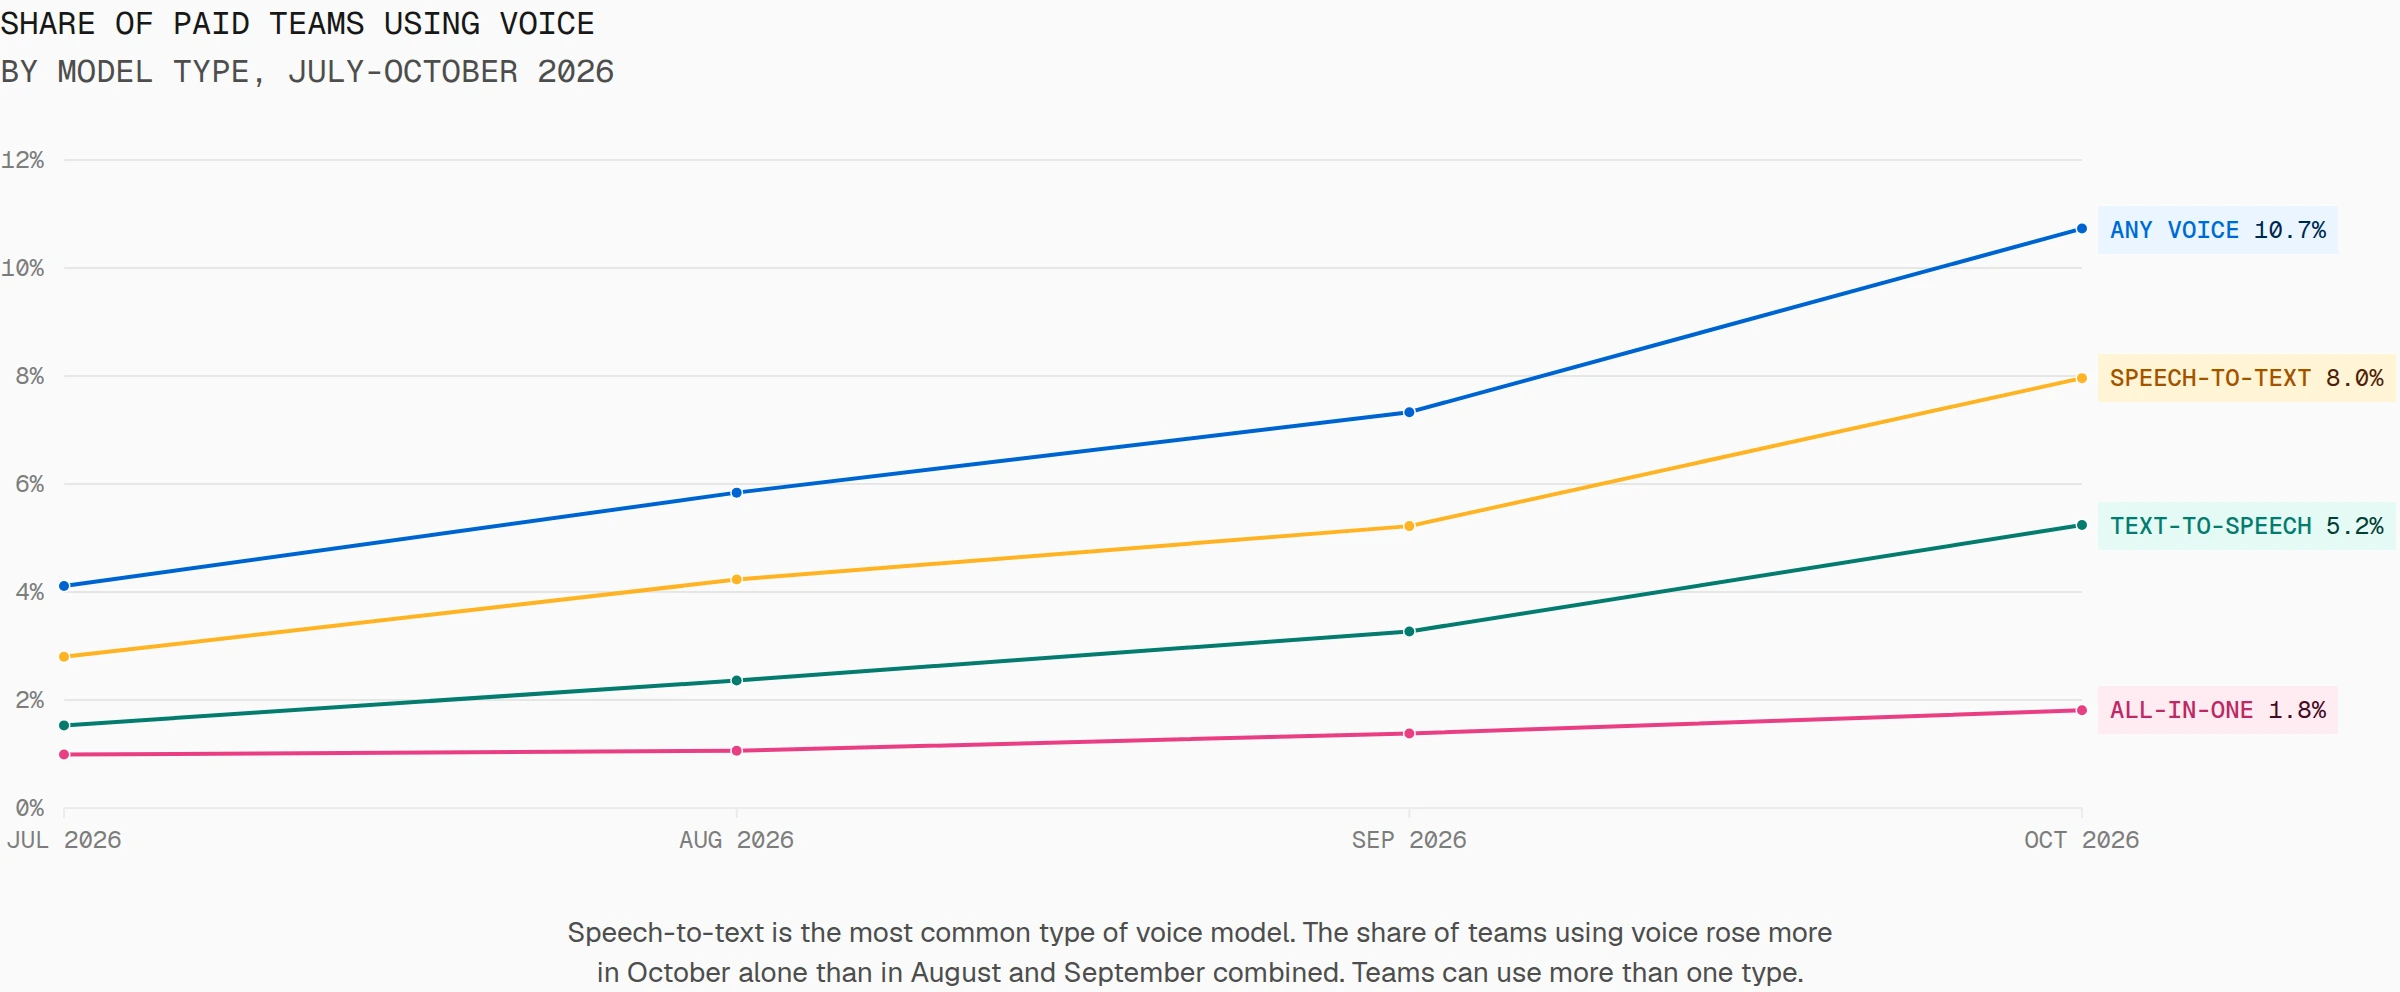
10월에 음성 모델을 쓴 유료 팀은 약 9곳 중 1곳으로, 7월의 24곳 중 1곳에서 161% 늘었습니다.
신규 팀이 음성을 쓰기 시작했고, 기존 팀도 음성을 추가하고 있습니다. 7월과 10월 모두 비용을 지불한 팀 가운데 음성 모델 사용 비율은 5%에서 14%로 올랐습니다.
음성을 쓰는 팀은 사용량도 늘고 있습니다. 월 음성 요청이 100건 이상인 팀의 비율은 5배로 늘었고, 9월에 음성을 쓴 팀 중 10월에도 쓴 팀은 10곳 중 6곳으로, 7월의 절반 미만에서 높아졌습니다.
AI 앱과 음성으로 대화하려면 세 단계를 거칩니다.
음성 모델이 사용자의 말을 텍스트로 변환합니다
언어 모델이 답변을 작성합니다
또 다른 음성 모델이 답변을 사용자에게 읽어 줍니다
대부분의 음성 팀은 이 가운데 한두 단계만 씁니다. 음성 인식(speech-to-text) 모델 사용은 7월 이후 3배 가까이, 음성 합성(text-to-speech) 모델 사용은 3배 넘게 늘었습니다.
세 단계를 혼자 처리하는 모델도 있습니다. 7월에는 음성 팀의 약 4분의 1이 이런 올인원 모델을 썼고 6분의 1은 각 단계를 직접 조합해 썼는데, 10월에는 이 비율이 서로 뒤바뀌었습니다.
대부분의 팀에게 음성은 이미 운영 중인 앱이나 에이전트에 사용자가 말로 접근하는 새로운 방법입니다. 팀이 선호하는 언어 모델은 중간에 그대로 두고, 앞단이나 뒷단 또는 양쪽에 음성을 붙이면 됩니다.
Anthropic, 신규 팀 선택에서 2대 1로 앞서고 OpenAI의 지출 비중은 3분의 2 증가
지난 12월 AI Gateway의 유료 팀 100곳 중 70곳이 OpenAI 모델을, 48곳이 Anthropic 모델을 썼습니다. 10월에는 OpenAI 55곳, Anthropic 54곳으로 두 랩이 거의 대등해졌습니다.
12월부터 게이트웨이를 써 온 팀에서는 두 랩 모두 이용 비율이 올랐지만, Anthropic의 증가폭이 더 컸습니다. Anthropic을 쓰는 팀은 절반 정도에서 3분의 2로, OpenAI를 쓰는 팀은 4분의 3 정도에서 5분의 4로 늘었습니다.
Anthropic의 성장은 대부분 신규 팀에서 나왔습니다. 10월에 Anthropic을 첫 번째로 선택한 신규 팀은 OpenAI를 택한 팀의 거의 두 배였습니다.
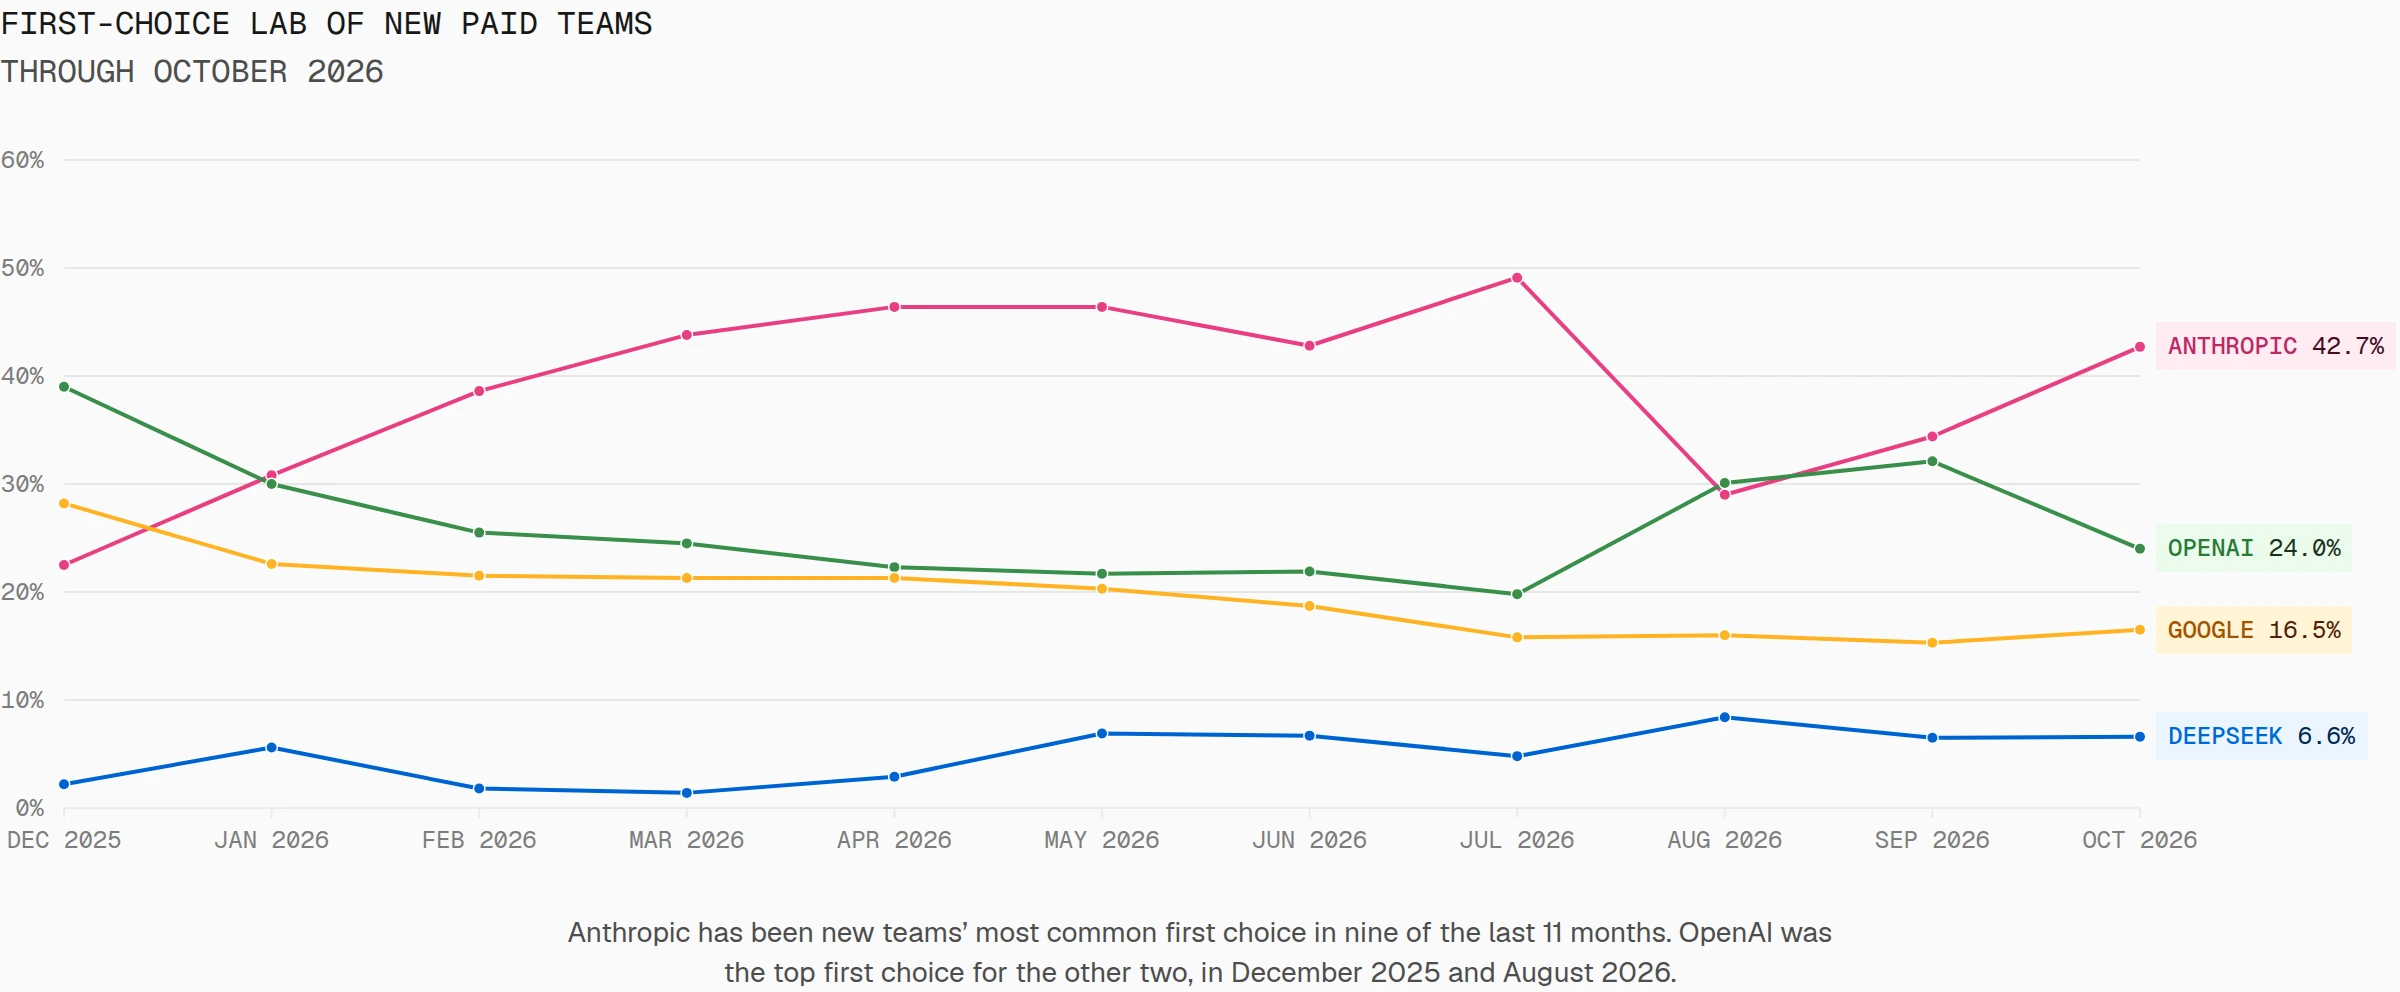
하지만 가장 큰 팀들은 이미 두 랩을 거의 모두 쓰고 있습니다. 지출 상위 1% 팀의 90% 이상이 Anthropic과 OpenAI를 함께 씁니다. 이 팀들에서는 두 랩이 이제 얼마나 많은 작업을 가져가느냐를 두고 경쟁합니다.
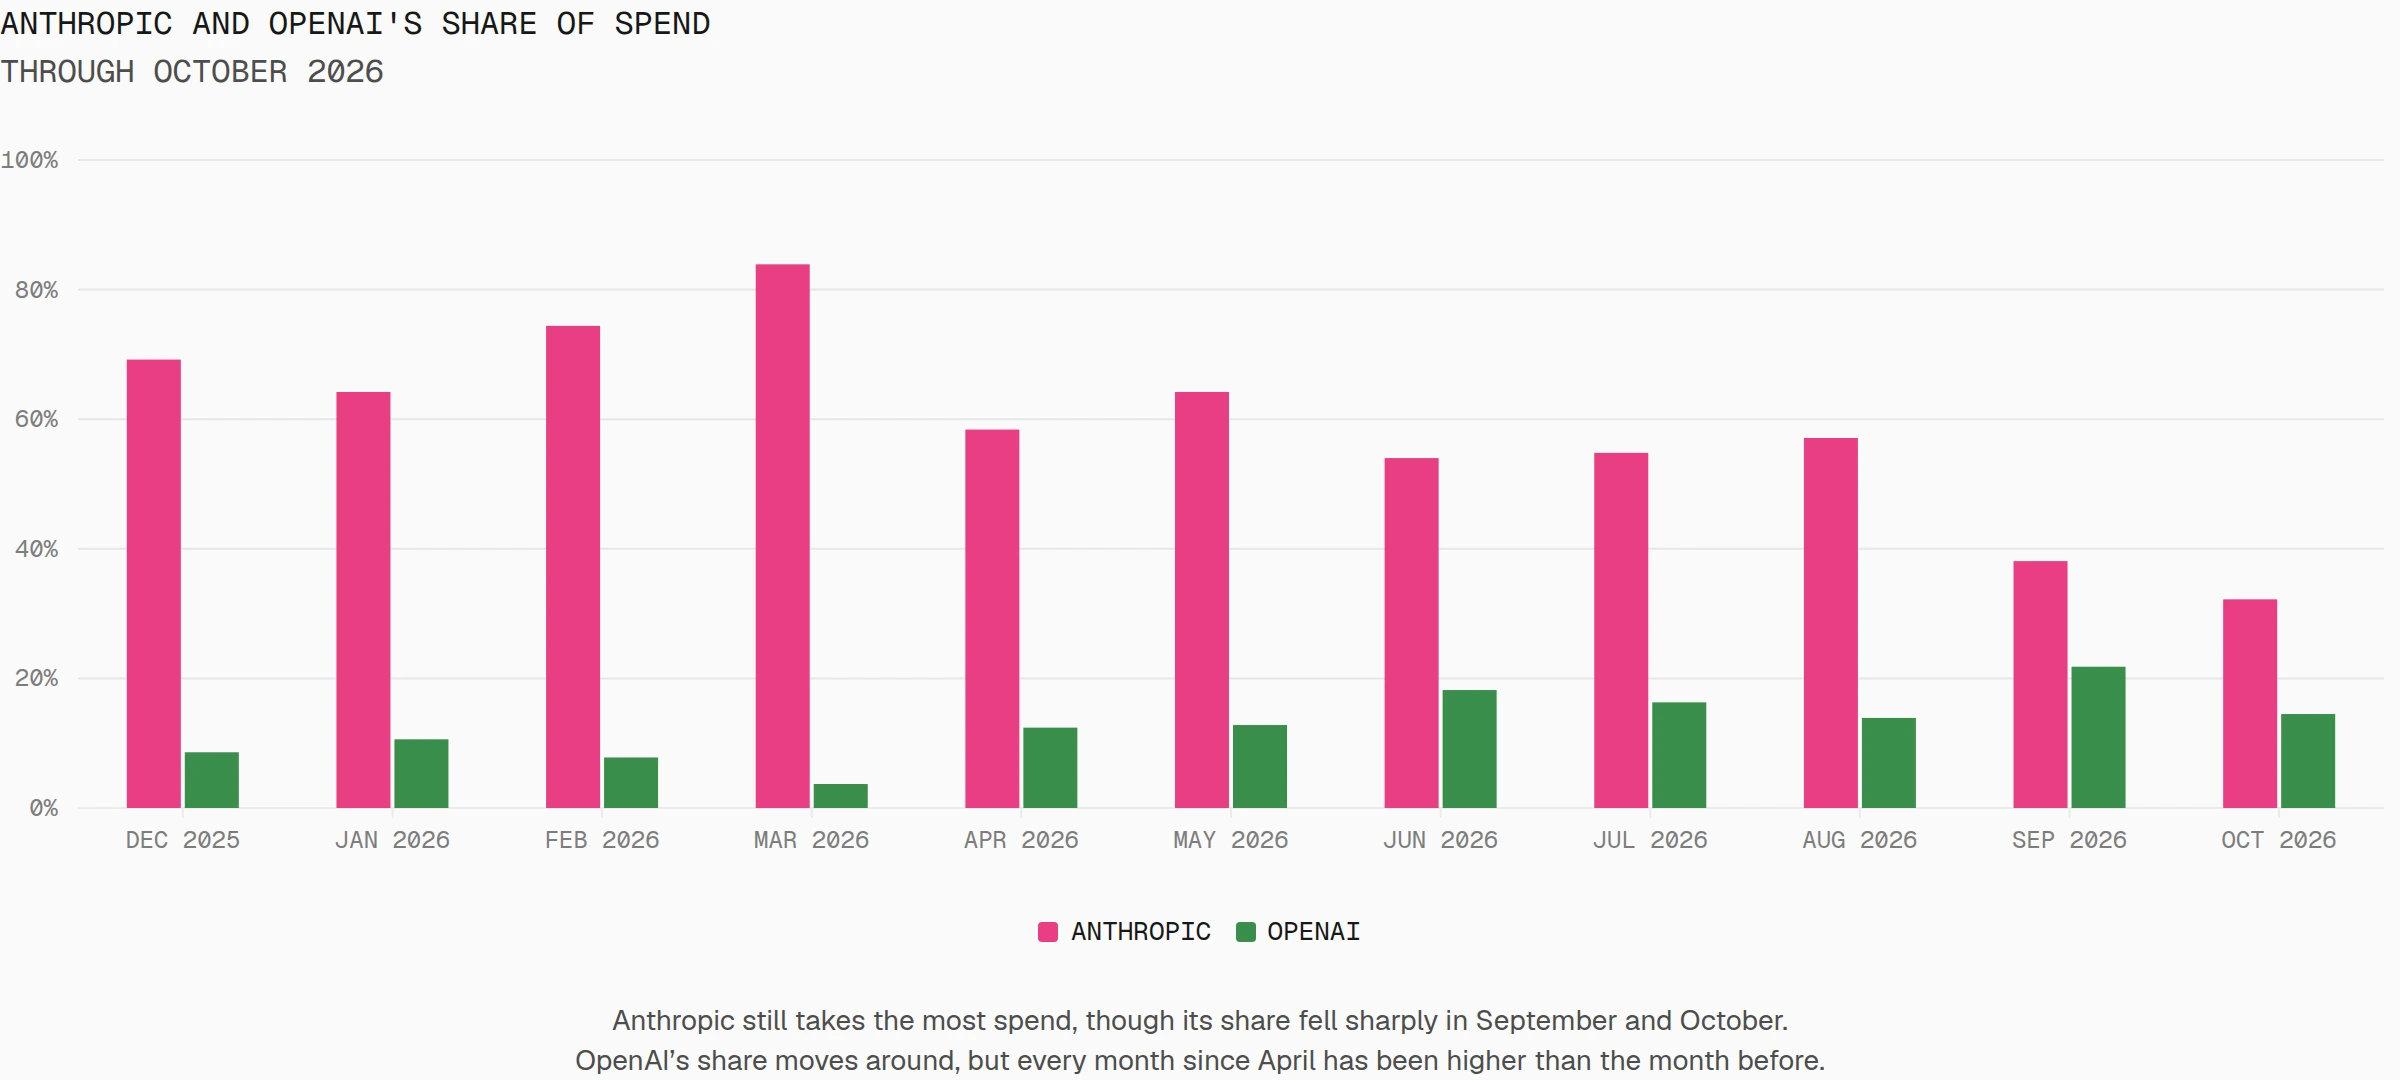
이 기준으로는 여전히 Anthropic이 앞서지만 OpenAI가 격차를 좁혔습니다. 게이트웨이 지출 1달러 중 OpenAI의 몫은 12월 약 9센트에서 15센트 가까이로 늘었고, 같은 기간 Anthropic의 몫은 절반으로 줄어 약 32센트가 되었습니다.
AI 트래픽 대부분이 출시 두 달이 안 된 모델에서 처리
팀들은 랩이 새 모델을 내놓는 속도와 거의 비슷하게 새 모델로 옮겨 가고 있습니다. 10월 언어 모델 요청의 절반 이상이 출시 60일이 안 된 모델로 향했습니다. 9월 이전에는 이 비율이 30%를 넘은 적이 없었습니다.
모델 패밀리별로 보면 중앙값 기준 61일마다 새 버전이 나오고, 일반적인 모델은 출시 후 한 달 안에 사용량이 정점에 이릅니다. 그로부터 4주가 지나면 정점에 그 모델을 쓰던 팀의 4분의 3은 더 이상 쓰지 않으며, 같은 패밀리에서 후속 모델이 나왔는지는 상관없습니다. 이 팀들은 대부분 AI Gateway에 남아 다른 모델을 씁니다.
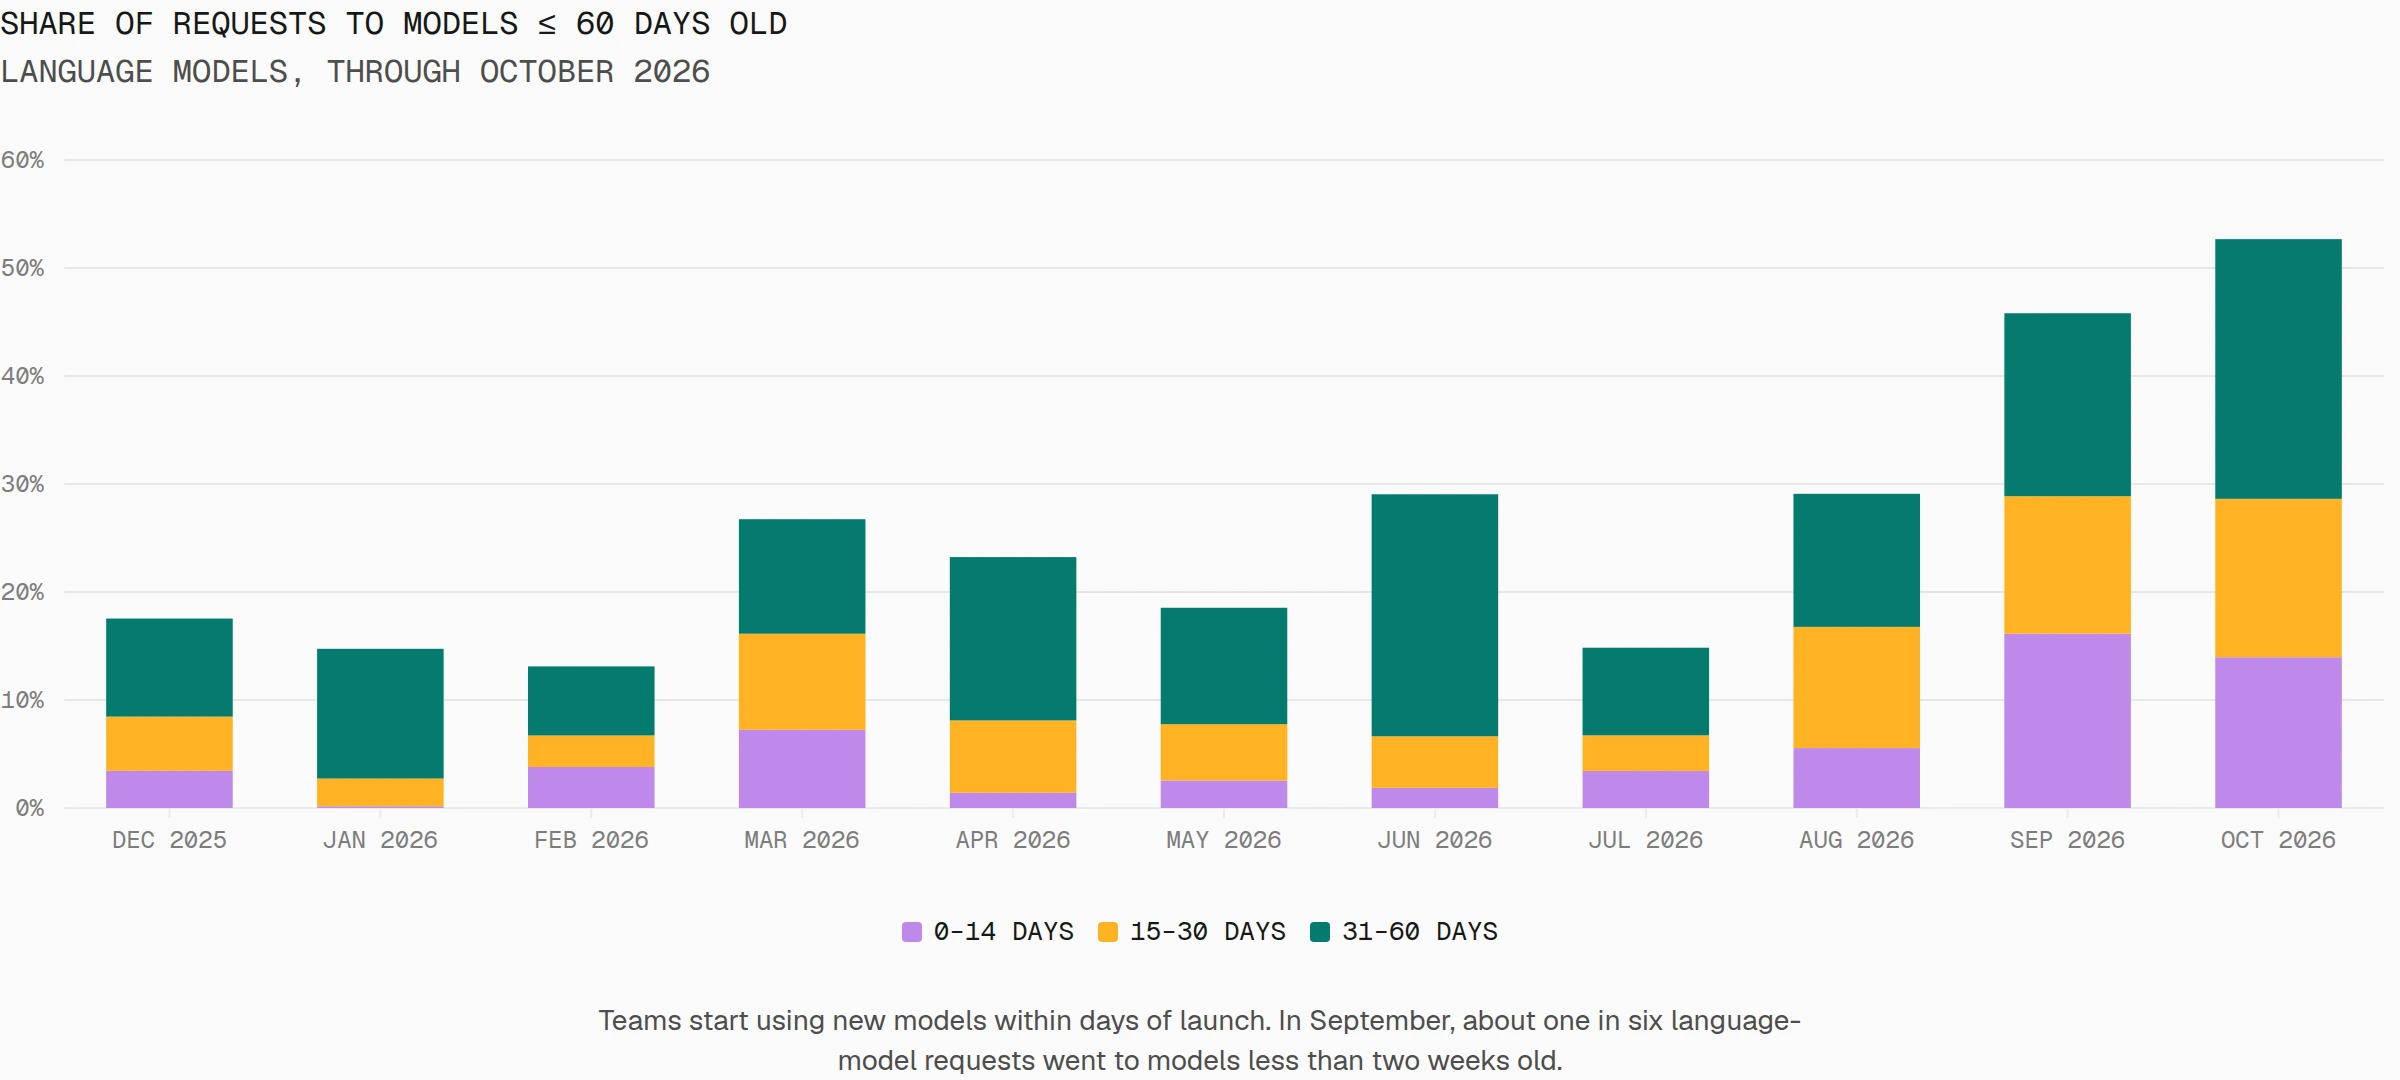
팀들은 주로 더 최신 모델로, 때로는 다른 랩의 모델로 자주 갈아탑니다. 10월에 월 1,000만 토큰 이상을 쓰는 팀의 약 절반이 가장 많이 쓰는 모델을 바꿨습니다. 이 가운데 5곳 중 4곳은 더 최근에 나온 모델로, 10곳 중 6곳은 다른 랩의 모델로 옮겼습니다.
오래된 모델도 최신 주력 모델과 함께 계속 쓰입니다. 월 1,000만 토큰 이상을 쓰는 팀의 10곳 중 7곳은 10월에도 출시 10개월이 넘은 모델을 썼지만, 일반적인 팀에서 그 모델이 처리한 토큰은 3%도 되지 않았습니다.
이제 AI 모델의 반감기는 약 6주입니다. 모델을 쓰는 팀 입장에서 랩은 가장 최근에 내놓은 모델만큼만 평가받으며, 새 모델이 나올 때마다 거래를 새로 따내야 한다는 뜻입니다.
10월 데이터의 다른 주요 내용
Opus 5.5는 출시 후 첫 한 달을 온전히 채운 달에 지출 기준 1위 모델이 되었고, 전체 팀 지출의 약 7분의 1을 차지했습니다. AI Gateway에서 가장 널리 쓰인 모델 6종 가운데 4종은 Anthropic 모델로, Sonnet 5.5(유료 팀의 26%), Haiku 5.5(22%), Haiku 4.5(20%), Opus 5.5(18%)입니다. 나머지 두 모델은 Jev(28%)와 GPT-6 Luna(19%)입니다.
이미지와 영상 모델은 모두 AI Gateway에서 역대 최고의 한 달을 보냈습니다. 이 모델에 지출하는 팀이 어느 때보다 많아졌고, 가장 큰 팀들이 가장 빠르게 도입하고 있습니다. 지출 상위 1% 팀의 약 3분의 1이 이미지 모델을 쓰며, 7월의 4분의 1에서 늘었습니다. 영상 모델을 쓰는 팀은 6곳 중 1곳으로, 10곳 중 1곳에서 늘었습니다.
OpenAI의 최신 이미지 모델 GPT-Image-2.5 Sunburst는 출시 후 첫 한 달을 온전히 채운 달에 이미지 지출 1위에 올랐고, 같은 OpenAI의 Flare와 GPT-Image-2가 뒤를 이었습니다. 영상 지출에서는 ByteDance의 Seedance 2.5가 3개월 연속 1위를 지켰고, Google의 Veo 3.1과 Kuaishou의 Kling 3.0이 그 뒤를 따랐습니다.
데이터 안내
이 보고서는 2026년 10월까지 Vercel AI Gateway를 거친 트래픽을 익명화하고 집계한 데이터를 사용했습니다.
측정 방식에 관한 참고 사항입니다.
지출은 공시된 정가 기준으로 추정한 값이며, 실제 청구 금액과 다를 수 있습니다.
유료 팀은 해당 월에 유료 요청이 한 건 이상 있는 팀입니다. 팀 규모는 해당 월에 팀이 사용한 총 토큰 수로 측정합니다.
의사결정 모델은 AI Gateway 모델 목록에서 의사결정 모델로 분류된 모델입니다.
모델 버전은 각각 별개로 집계합니다. 모델의 출시 경과 기간은 해당 버전이 AI Gateway에 처음 등장한 날부터 계산하며, 게이트웨이 기록은 2025년 10월 20일부터 시작됩니다.
모델 전환율은 9월과 10월 모두 토큰 사용량이 1,000만 개 이상인 유료 팀을 비교한 값입니다. 팀이 가장 많이 쓰는 모델은 토큰 기준으로 측정합니다.
음성 관련 수치는 2026년 6월 22일부터 집계합니다. "각 단계를 직접 조합한" 팀은 같은 날 음성 인식, 언어 모델, 음성 합성을 모두 사용한 팀입니다.
신규 팀의 첫 번째 선택 랩은 가입 후 첫 달에 언어 모델 요청을 가장 많이 보낸 랩입니다.
모든 수치는 현재 시점에서 가장 최신인 데이터와 프로토콜을 따르며, 방법론이 업데이트되면 이전 달 수치도 수정될 수 있습니다.
자세한 내용은 방법론을 참고하시고, 공개 데이터는 여기에서 살펴보거나 내려받을 수 있습니다.