Anthropic연구Economics
과학자들은 Claude를 어떻게 활용할까
이 보고서는 프라이버시를 보호하는 인프라를 활용해 Claude, Claude Code, Claude Science가 과학 연구에 쓰이는 방식을 분석했습니다. 과학 분야와 연구 작업에 따라 사용 양상이 어떻게 달라지는지 정리하고, 이런 패턴이 나타나는 원인을 짚었습니다. 또한 AI가 연구를 가속화할 수 있는 시나리오도 제시합니다.
Johannes Hermle*, Ben Jones*, Lukas Althoff*, Ryan Heller, Thomas Lyttelton, Carolyn Stein, Nathan Wilmers, Maxim Massenkoff, Peter McCrory
*보고서 주저자
요약
- 측정 대상. AI는 과학적 발견의 속도를 높일 수 있습니다. 하지만 얼마나 빨라질지는 AI가 무엇을 할 수 있는지, 그리고 과학자들이 AI를 어떻게 쓰는지에 달려 있습니다. 우리는 프라이버시를 보호하는 방식으로 Claude와 Claude Code의 연구 세션 20만 7천 건을 분석해, 과학 분야와 연구 작업별로 Claude가 어떻게 쓰이는지 살폈습니다. 이번 연구는 과학 분야에서 AI가 어느 수준까지 활용되고 있는지 대중이 더 잘 이해하고, AI가 앞으로 과학적 발견에 미칠 영향을 가늠하는 데 도움이 되고자 진행했습니다.
- 과학자들은 어디에 Claude를 쓸까. 분야별 연구자 수와 비교하면, Claude는 컴퓨터과학·수학·통계학 같은 형식과학에서 더 많이 쓰이고, 보건 분야와 실험 중심의 물리과학에서는 덜 쓰입니다. 과학자들은 주로 데이터 분석과 글쓰기에 Claude를 활용합니다. 데이터 분석만 해도 Claude 세션의 약 3분의 1, Claude Code 세션의 거의 절반을 차지합니다. 반면 아이디어 도출과 데이터 수집에는 덜 쓰는데, 함께 진행한 설문에서 과학자들은 이 두 작업을 과학적 발견에 가장 중요한 작업으로 꼽았습니다. 다만 과학 연구용으로 설계된 전문 AI 도구를 쓰면, 과학자들이 AI를 쓰는 작업과 가장 중요하게 여기는 작업 사이의 간극이 좁혀질 수 있습니다. 예를 들어 Claude Science에서는 아이디어 도출이 차지하는 비중이 Claude의 약 두 배입니다.
- Claude 사용은 AI 역량과 어떻게 맞물릴까. 우리는 AI가 이론적으로 각 연구 작업을 얼마나 잘 수행할 수 있는지를 나타내는 지표를 만들었습니다. 이 지표에서 AI에 가장 잘 맞는 상위 20% 작업은 연구자가 그 작업에 쓰는 시간으로 예상되는 수준보다 Claude 사용량이 두 배에서 네 배 많았습니다. AI에 가장 맞지 않는 하위 20% 작업에는 대부분의 물리적 작업이 포함되며, 사용량이 거의 없었습니다. 분야별로도 같은 패턴이 나타납니다. 컴퓨터과학과 통계학처럼 AI가 많은 작업을 잘 수행할 수 있는 분야일수록 Claude를 더 많이 씁니다.
- 과학적 발견의 속도에는 어떤 의미가 있을까. 간단한 모델을 사용해 AI가 연구 속도를 얼마나 높일 수 있는지 시나리오를 살펴봤습니다. 현재의 AI 역량이 널리 도입되면 일부 분야에서는 연구 성과가 두 배로 늘 수 있습니다. AI가 물리적이지 않은 연구 작업을 모두 수행할 수 있다면, 컴퓨터과학과 통계학 같은 분야의 성과는 최대 15배까지 늘 수 있습니다. 반면 화학과 생물학처럼 물리적 병목이 있는 실험 중심 분야는 3~4배 증가에 그칩니다. AI를 적극적으로 쓰는 연구자 대상 설문에서는 약 40%가 2030년까지 AI 모델이 연구 프로젝트 전체를 독자적으로 수행하리라고 예상했습니다.
들어가며
과학은 '끝없는 개척지'로 불려 왔습니다(Bush 1945). 그러나 이 개척지를 얼마나 빨리 탐험할 수 있는지는 역사적으로 한정된 자원, 즉 연구자의 시간과 재능에 좌우되었습니다. AI는 연구자의 역량을 증폭해 이 한계를 완화하고, 발견의 과정과 탐구의 속도를 모두 바꿀 수 있습니다(Wang et al. 2023; Amodei 2024). 인류의 복지에 이보다 더 중요할 수 있는 AI 활용 분야는 드뭅니다. 연구는 다른 경제 부문에 비해 인지적 성격이 매우 강한 활동이므로, 이 영역에서는 AI의 영향이 특히 크고 일찍 나타날 수도 있습니다.
최근 사례를 보면 AI는 과학적 발견에서 점점 더 큰 역할을 하고 있습니다. 구조생물학에서는 AlphaFold가 2억 개가 넘는 단백질의 3차원 구조를 예측했고(Jumper et al. 2021; Varadi et al. 2024), 개발자들은 2024년 노벨 화학상을 공동 수상했습니다. 재료과학에서는 GNoME이 안정적인 새 결정 38만 개를 예측했습니다(Merchant et al. 2023). 수학에서는 연구자들이 AI 시스템의 도움으로 수십 년 묵은 에르되시 문제를 해결하고, 밀레니엄 문제에 대한 잠재적 증명을 만들어 냈으며, 미해결 추측부터 기념비적 증명의 검증까지 여러 주요 문제에서 진전을 이뤘습니다(Anthropic 2026a, 2026b; OpenAI 2026a, 2026b; Tsoukalas et al. 2026).
하지만 이런 성과를 넘어, 대부분의 과학적 진전은 서로 얽힌 수많은 전문 연구 작업으로 이루어지며 그 작업은 분야마다 크게 다릅니다. AI가 과학적 발견을 얼마나 가속할지는 AI의 역량뿐 아니라, 이런 작업 전반에서 AI가 얼마나 도입되느냐에도 달려 있습니다. 이 보고서는 프라이버시를 보호하는 인프라를 활용해 Claude, Claude Code, Claude Science가 과학 연구에 쓰이는 방식을 분석했습니다. 분야와 작업에 따라 사용 양상이 어떻게 달라지는지 정리하고, 이런 패턴이 나타나는 원인을 짚었습니다. 또한 AI가 연구를 가속화할 수 있는 시나리오도 제시합니다.
과학 분야에서 Claude를 쓰는 양상은 분야마다 다릅니다. 연구자 수와 비교하면 컴퓨터과학, 수학, 통계학 같은 형식과학에서 Claude를 더 많이 쓰고, 보건 분야와 실험 중심의 물리과학에서는 덜 씁니다. 연구 작업별로는 데이터 분석과 글쓰기에 Claude를 많이 쓰고, 데이터 수집이나 아이디어·가설 도출에는 덜 씁니다. 과학자 대상 설문에서 응답자가 직접 밝힌 AI 사용 양상도 이와 일치합니다.
이런 차이를 이해하기 위해 우리는 이론적 AI 역량 지표를 개발했습니다. 이 지표 점수가 높은 작업과 분야일수록 Claude 사용량도 많았습니다. 이런 작업과 분야는 대체로 인지적 성격이 강하고, AI가 반복 시도에 대한 피드백으로 학습하는 강화학습에도 더 적합합니다. 요컨대 과학자들은 AI가 가장 잘 작동하는 곳에 AI를 쓰고 있는 것으로 보입니다.
이 결과를 토대로 AI가 과학 발전을 가속할 수 있는 시나리오를 그려 봤습니다. 현재 역량으로도 일부 분야에서는 연구 성과가 최대 두 배까지 늘 수 있으며, 이는 주로 작업 단위의 보강에서 나옵니다. 설문에 응한 연구자들은 AI 역량이 앞으로 훨씬 높아지리라 기대합니다. AI가 물리적이지 않은 작업을 모두 자동화하는 가상의 시나리오에서는 컴퓨터과학이나 통계학처럼 인지적 성격이 강한 분야의 성과가 최대 15배까지 늘 수 있습니다. 가속 잠재력이 가장 큰 분야에는 AI 자체를 만드는 분야도 포함되므로, 이런 성과는 추가적인 피드백 루프를 만들 수도 있습니다. AI 연구가 빨라지면 더 뛰어난 AI가 나오고, 그 AI가 다시 연구를 더 가속하는 선순환입니다.
과학적 발견이 빨라지면 인류에게 큰 이익이 될 수 있지만, AI 주도 연구에는 위험과 불확실성도 따릅니다. 사람의 감독이 줄면 위험하거나 비윤리적인 연구가 추진될 수 있습니다. 또한 AI는 연구자의 커리어를 바꿔 연구 업무를 더 보람 있게 또는 덜 보람 있게 만들 수 있고, 인간이 지식을 추구하는 일에 부여해 온 목적의식도 바꿀 수 있습니다.
연구 방법
이번 연구의 목표는 과학자들의 작업 내용을 보호하면서, 이들이 Claude를 쓰는 다양한 방식을 측정하는 것입니다. 이를 위해 프라이버시를 보호하는 인프라로 개인 사용자용 요금제에서 이뤄진 Claude의 과학 분야 사용을 분석했습니다. 여기서 '분류기'로 쓰인 언어 모델이 각 세션 대화록을 읽고, 사전에 정의된 분류 체계(Alamos와 Althoff 2026의 SciNet 분류 체계)에 따라 해당 세션이 속한 분야와 연구 작업 같은 정해진 범주를 붙입니다. '화학', '데이터 정제'와 같은 이 라벨이 이번 보고서를 위해 연구팀이 대화에서 보관하고 분석한 유일한 정보입니다. 이번 연구에 쓰인 어떤 분류기도 연구 데이터셋, 가설, 실험 방법, 초기 결과, 미발표 논문 등 연구 내용에 관한 개방형 정보나 세부 사항을 추출하거나 저장하지 않습니다. 결과는 집계 형태로만 보고하며, 서로 다른 계정이 최소 기준 수 이상인 셀에 대해서만 공개합니다. 이번 연구에 도입한 모든 분류기는 부록에 정리했습니다.
측정은 두 단계로 이뤄집니다. 먼저 첫 번째 분류기가 세션 대화록이 과학 연구와 관련 있는지 판별합니다. 그런 다음 두 번째 분류기가 해당 대화록을 SciNet 분류 체계의 분야, 세부 분야, 작업에 각각 배정합니다. SciNet에는 34개 분야와 318개 세부 분야에 걸쳐 7,262개의 작업이 있습니다. 논문 초고 작성처럼 모든 분야에 공통되는 작업도 있고, 특정 분야나 세부 분야에만 해당하는 작업도 있습니다. 예를 들어 광흡수 및 방출 스펙트럼 예측은 분류 체계상 재료과학에만 해당합니다. 이 작업들을 합치면 새로운 연구 결과를 내놓는 전 과정을 아우릅니다.
주요 표본은 2026년 8월 2일부터 9월 30일까지 개인 사용자용 요금제에서 발생한 세션 중 과학 분야와 연구 작업이 배정된 207,049건입니다. 이 중 128,914건은 대화와 지식 업무를 위한 범용 인터페이스인 Chat과 Cowork에서 나온 것으로, 이하 'Claude'라고 부릅니다. 나머지 78,135건은 사용자의 파일을 직접 다루며 코드를 작성하고 실행하는 에이전트형 코딩 도구인 Claude Code에서 나온 것입니다. 보조 표본으로 Claude Science 세션도 분석했습니다. 표본 구성에 관한 자세한 내용은 부록을 참고하세요.
사용 데이터와 체계적인 연구 작업 분류 체계를 결합하면, 어떤 분야가 연구 과정의 어느 부분에 Claude를 도입하는지 살펴볼 수 있습니다. 이번 연구는 과학적 발견을 위한 AI 기술 도입을 측정하려는 연구의 흐름을 잇는 것입니다(Kobak et al. 2025; Liang et al. 2025; Hao et al. 2026; Codreanu et al. 2026).
과학 분야별 Claude 사용 양상
먼저 과학 분야별로 Claude 사용이 어떻게 다른지 살펴보겠습니다. 그림 1은 각 분야의 세션 비중과 전 세계 연구자 중 해당 분야 연구자의 비중을 비교해, 분야별 상대적 사용 수준을 보여 줍니다.1 Claude에서 세션 비중이 가장 큰 세 분야는 컴퓨터과학(11.9%), 공학(8.4%), 의학(7.7%)이며, 이들은 전 세계 연구자 수 기준으로도 큰 분야에 속합니다.2 전반적으로 연구자 비중이 큰 분야가 Claude 세션 비중도 큰 경향이 있습니다(로그-로그 상관계수 0.79).
그러나 분야별 Claude 사용량을 연구자 수만으로 설명할 수는 없습니다. 그림 1에서 45도 선 위쪽에 있는 분야는 규모에 비해 사용량이 많고, 아래쪽에 있는 분야는 적습니다. 컴퓨터과학, 수학, 통계학을 포함한 형식과학은 상대적 사용량이 특히 높습니다. 사회과학도 사용량이 높은 편입니다. 반면 실험실에서 작업하는 경우가 많은 화학 같은 물리과학은 상대적 사용량이 낮은 경향을 보입니다. 세션 규모로 세 번째로 큰 분야인 의학도 마찬가지인데, 연구자들이 시간의 상당 부분을 환자와 함께 보내기 때문입니다.
Claude Code에서는 사용량과 분야 규모의 관련성이 더 약하고(연구자 수와의 로그-로그 상관계수 0.62), 사용이 정량적 성격이 강한 분야에 집중됩니다. 컴퓨터과학은 전 세계 연구자의 4.3%에 불과하지만, Claude Code 세션의 32.7%를 차지합니다.3 수학과 통계학 같은 다른 형식과학도 상대적 사용량이 높습니다. 예술·인문학과 사회과학은 상대적 사용량이 낮은데, 비교적 정량적인 분야인 경제학만 예외입니다.
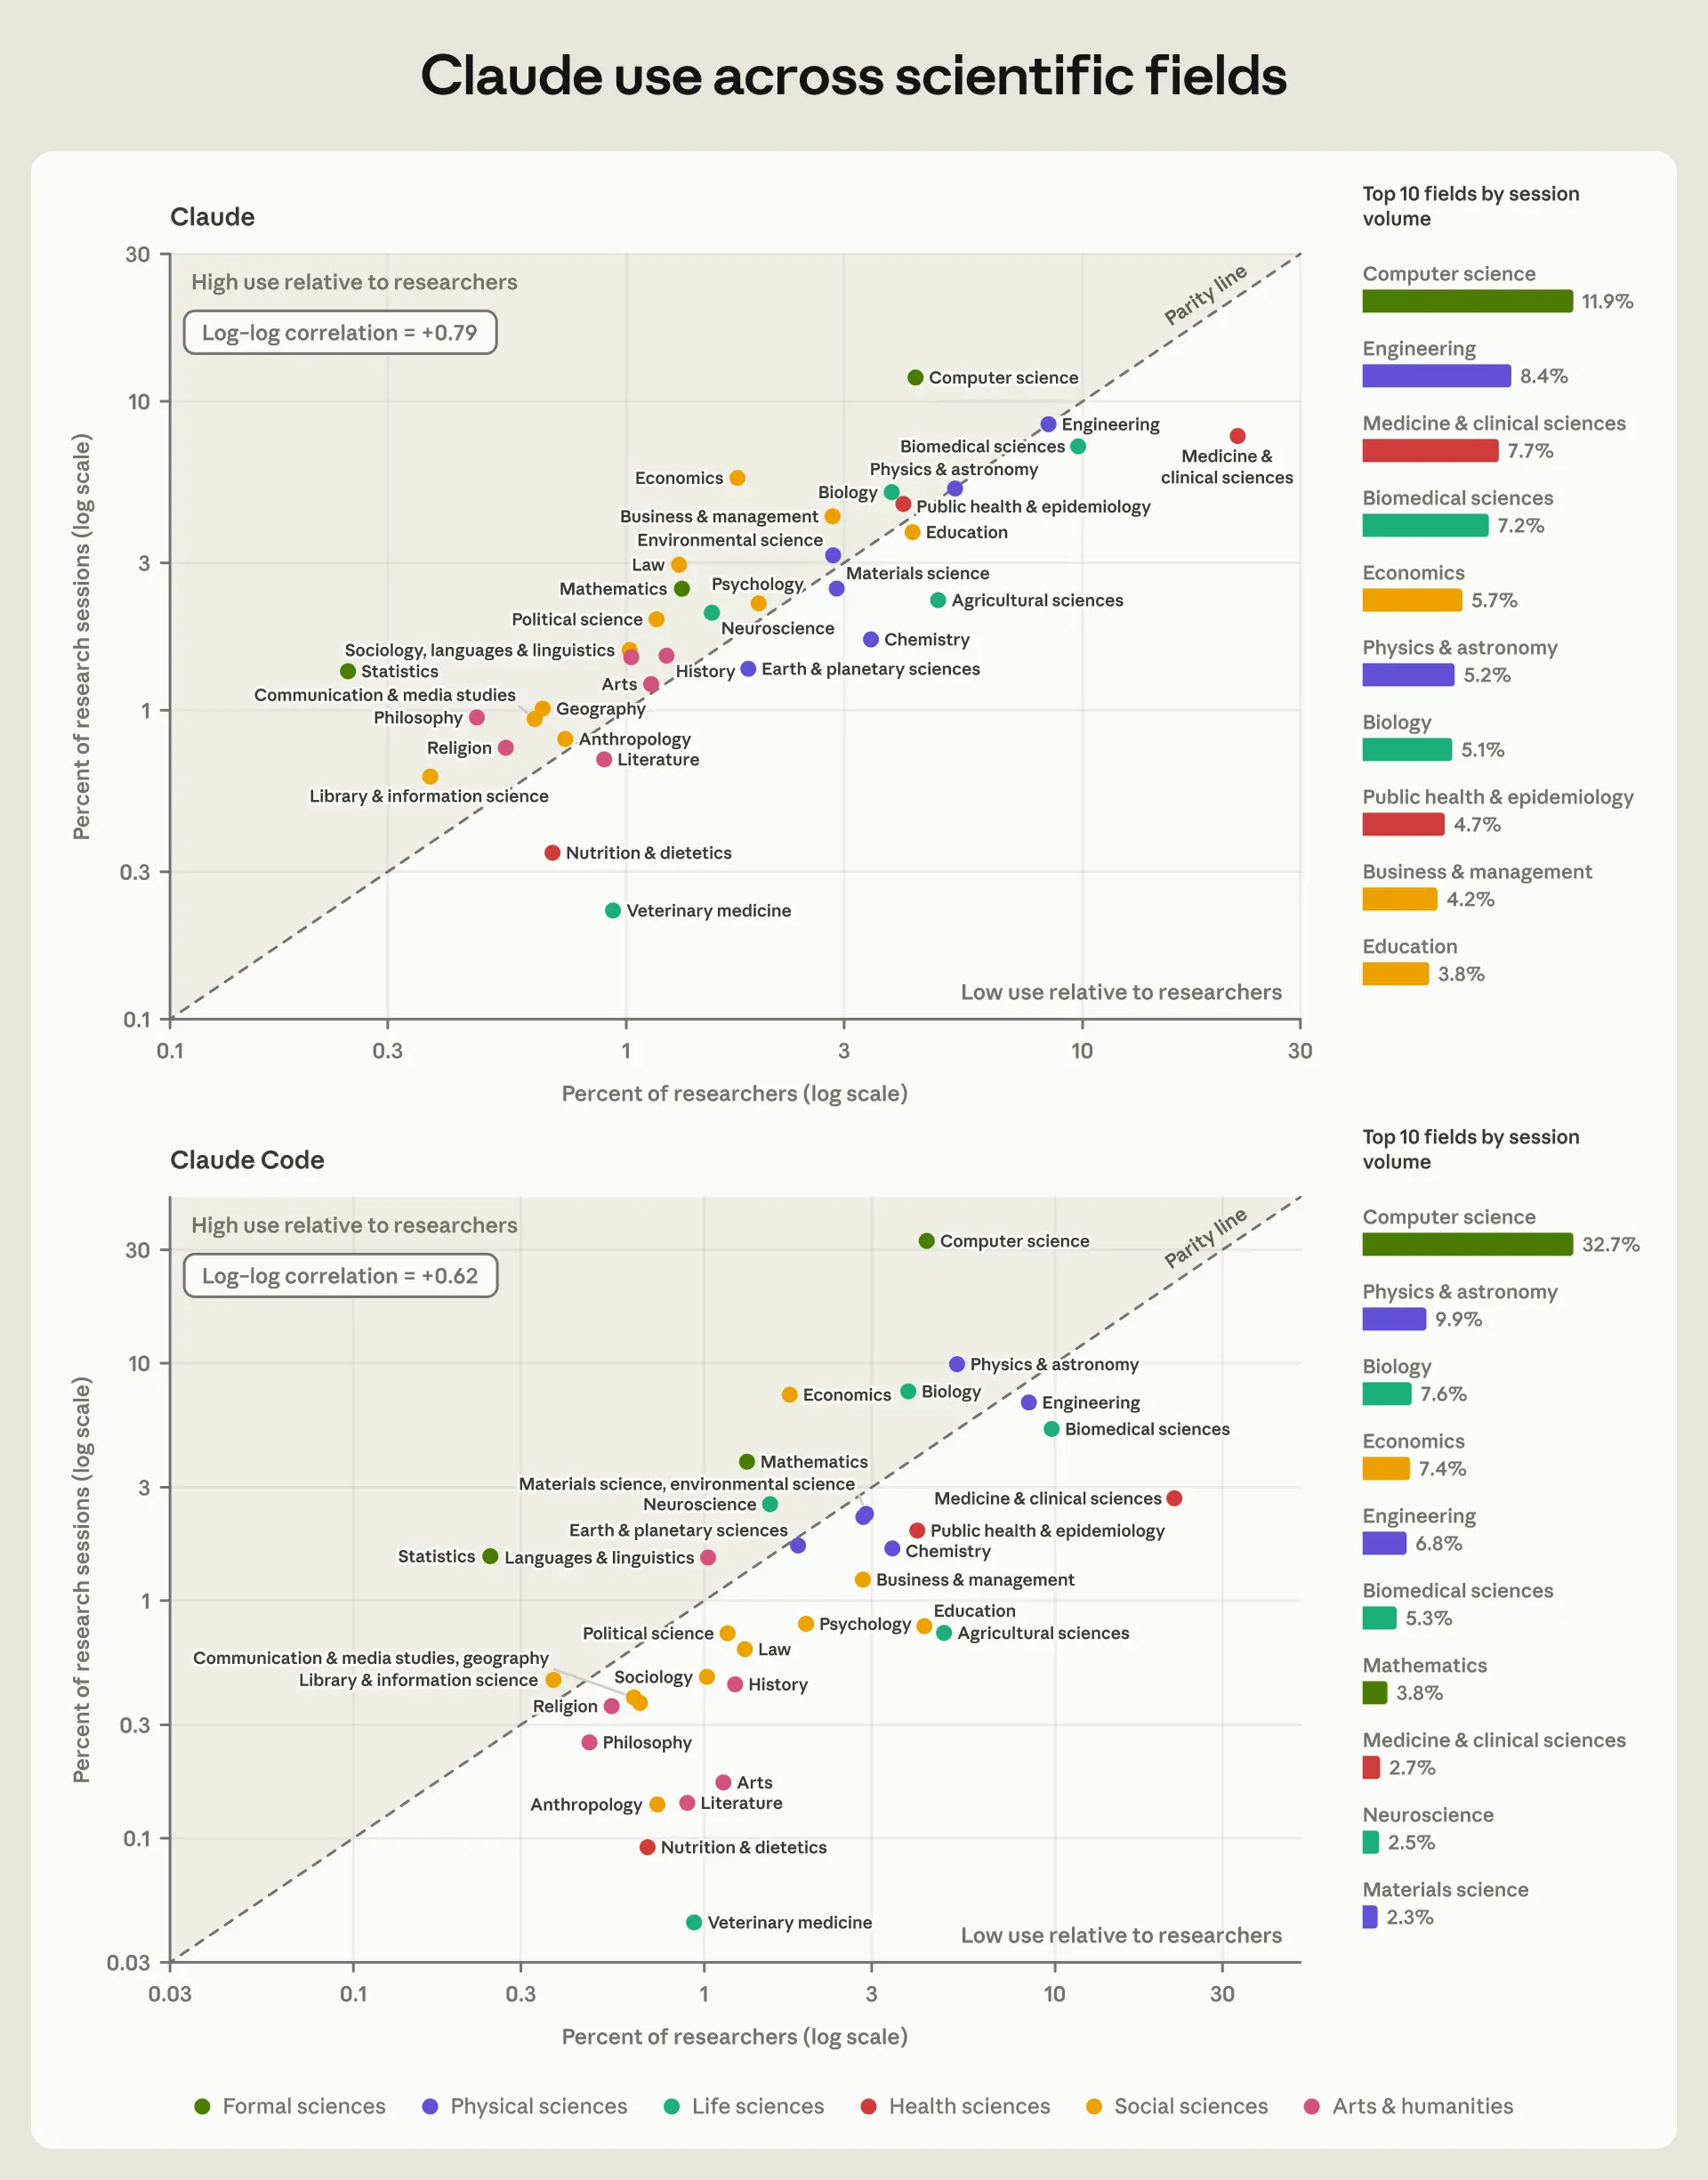
과학 분야별 Claude 사용. 각 점은 하나의 분야를 나타냅니다. 가로축은 해당 분야의 연구자 비중, 세로축은 해당 분야의 연구 세션 비중이며, 둘 다 로그 눈금입니다. 위쪽 패널은 Claude 세션, 아래쪽 패널은 Claude Code 세션을 보여 줍니다.
34개 분야 안의 318개 세부 분야별 사용량을 비교해도 비슷한 패턴이 나타납니다(그림 2).4 세부 분야로 더 자세히 보면 인공지능·머신러닝이 눈에 띕니다. 전 세계 연구자의 1.2%에 불과한데도 세션 비중이 Claude에서 5.0%, Claude Code에서 15.2%에 달합니다. 더 일반적으로는, 큰 과학 영역과 관계없이 계산 중심 세부 분야가 가장 적극적으로 도입하는 축에 속합니다. 계산생물학, 계산언어학, 계산신경과학 등이 여기에 해당합니다. 로보틱스도 상대적 사용량이 높은데, 물리적 시스템을 다루면서도 계산 기법에 크게 의존하기 때문으로 보입니다.
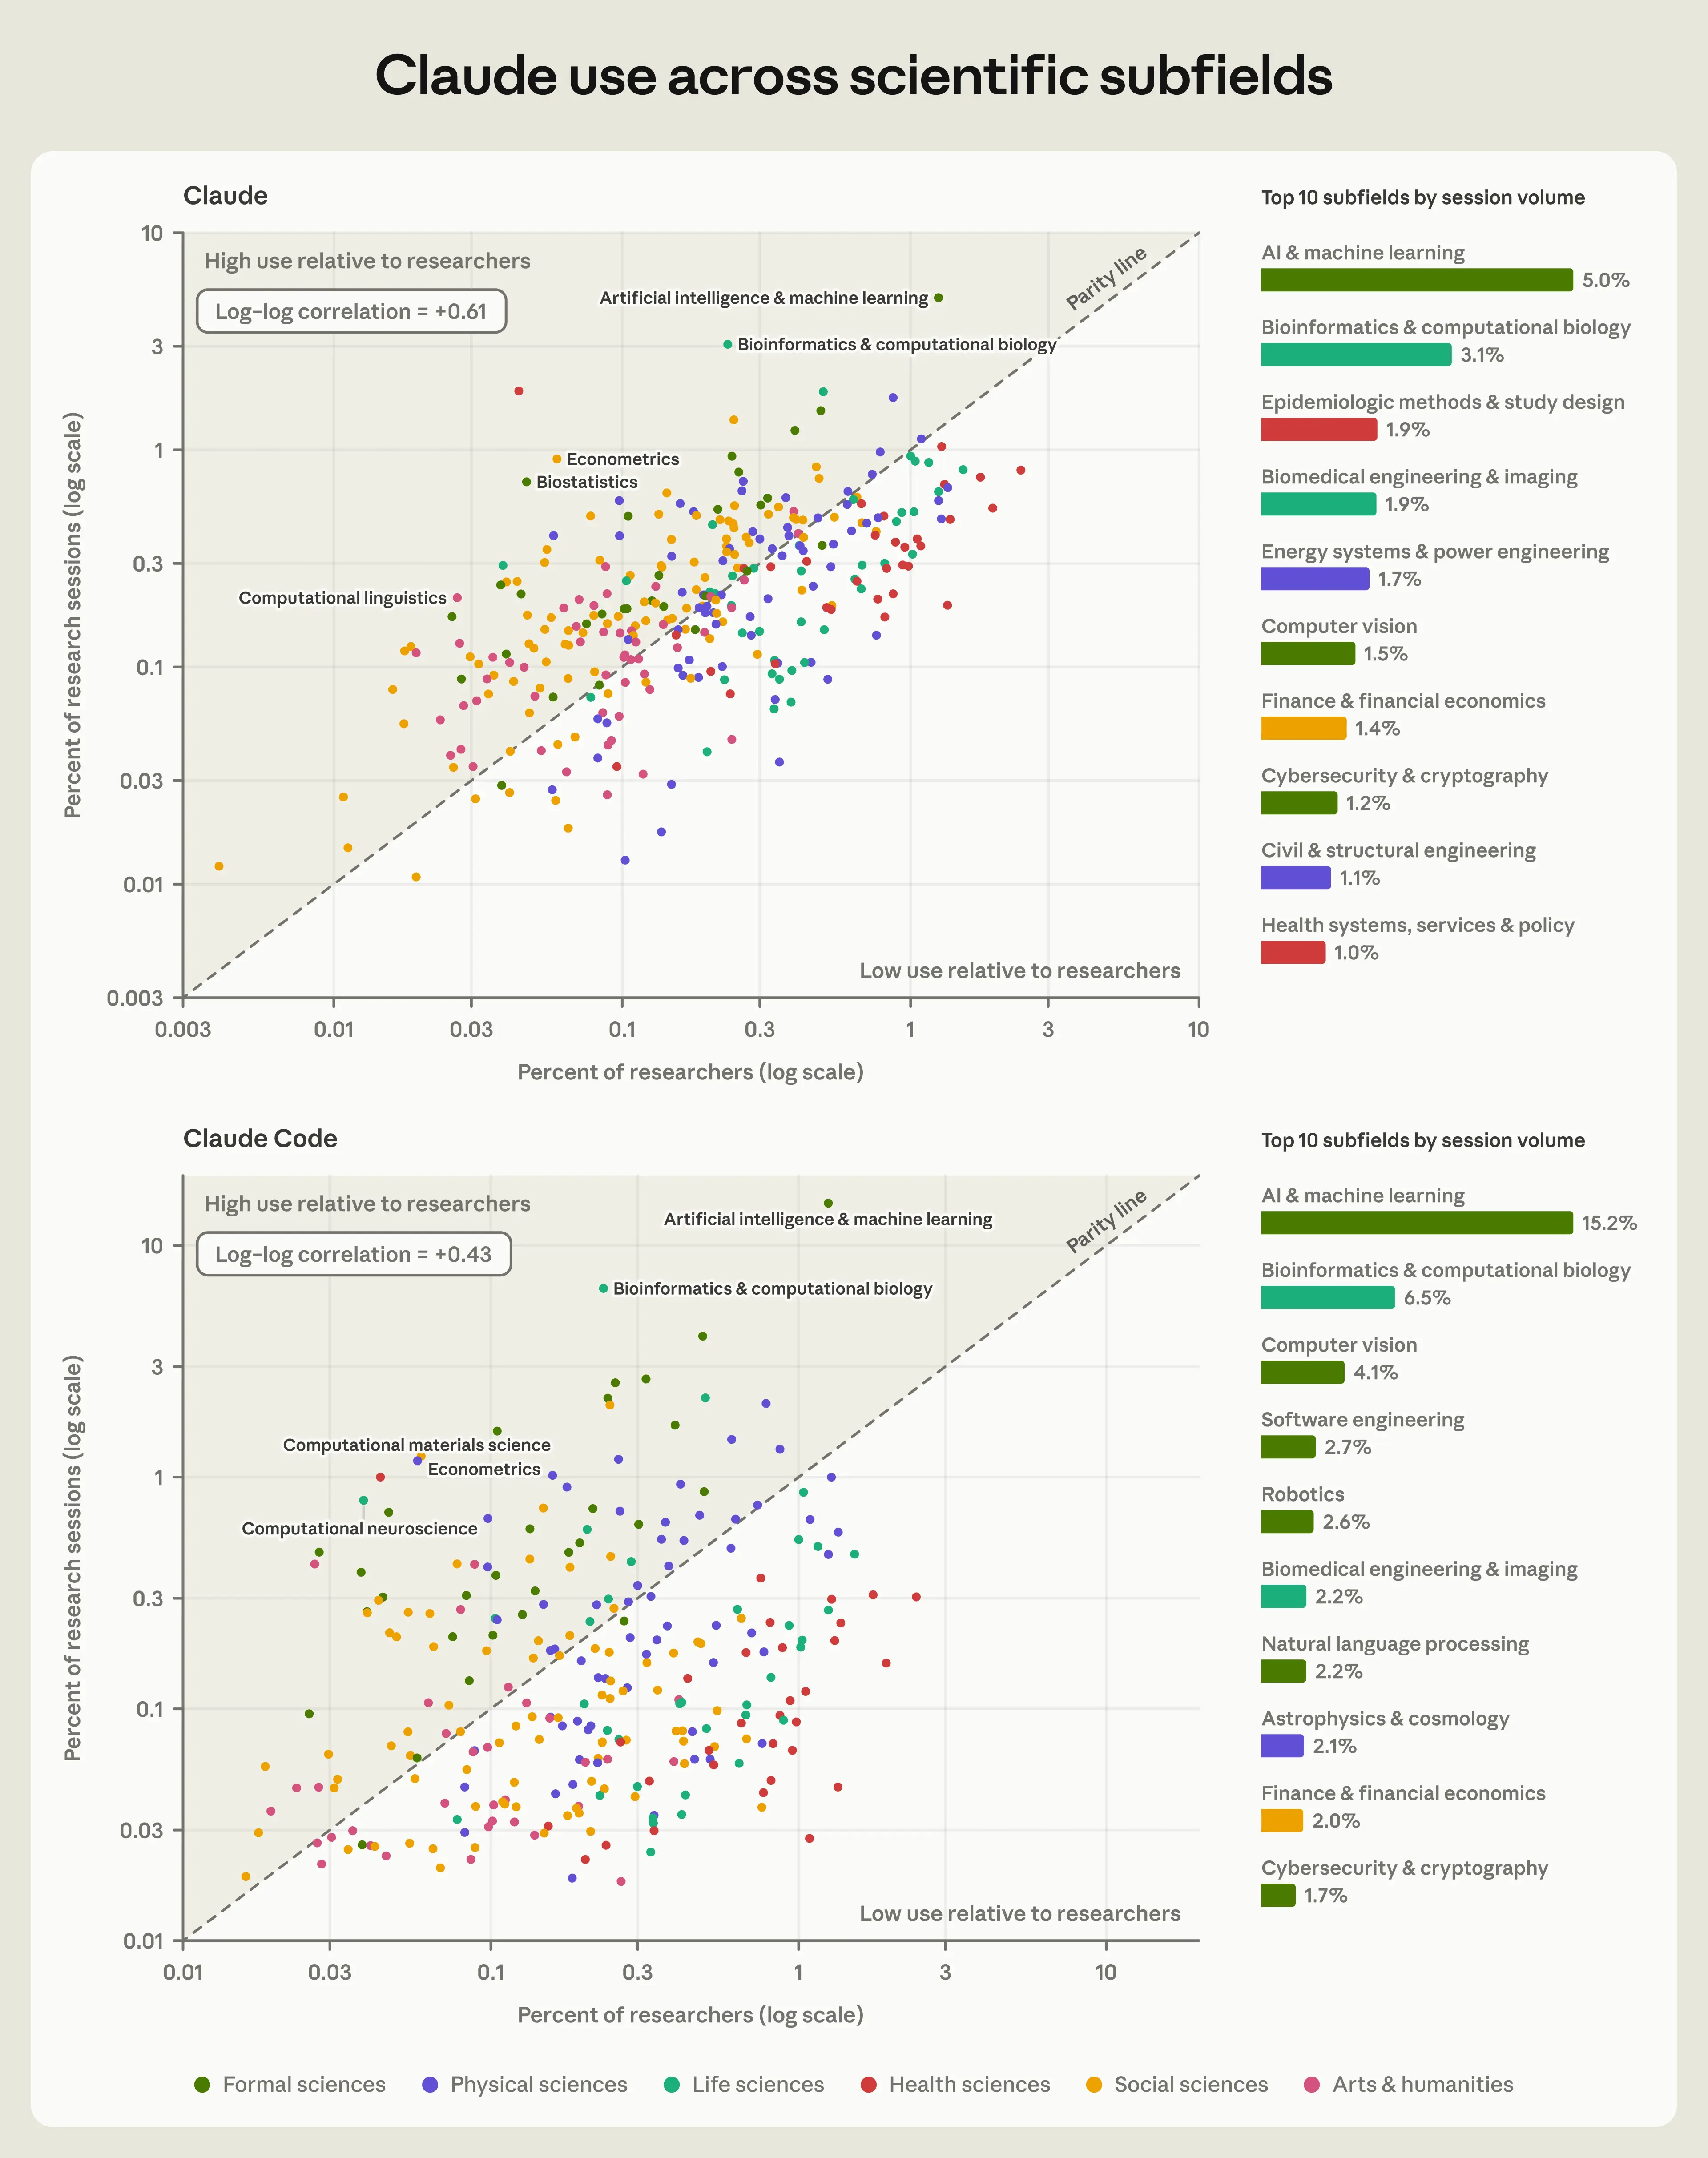
과학 세부 분야별 Claude 사용. 각 점은 하나의 세부 분야를 나타냅니다. 가로축은 해당 세부 분야의 연구자 비중, 세로축은 해당 세부 분야의 연구 세션 비중이며, 둘 다 로그 눈금입니다. 위쪽 패널은 Claude 세션, 아래쪽 패널은 Claude Code 세션을 보여 줍니다. 계정 수가 너무 적은 세부 분야는 프라이버시 보호를 위해 표시하지 않았습니다.
연구 작업별 Claude 사용 양상
어떤 분야에서 Claude를 쓰는지에 더해, 과학자들이 Claude를 무엇에 쓰는지도 알아보고자 했습니다. 연구에는 가설 수립, 데이터 분석, 논문 작성에 이르기까지 다양한 작업이 있습니다. Claude가 과학적 발견을 어떻게 뒷받침하는지 더 명확히 파악하기 위해, 이런 작업별로 사용량이 어떻게 달라지는지 분석했습니다. 이를 위해 각 세션을 SciNet의 7,262개 작업 중 하나에 배정했습니다. 작업은 논문 초고 작성처럼 모든 분야에 공통될 수도 있고, 암 생물학과 관련된 '종양 아형을 비교하기 위한 차등 유전자 발현 분석 수행'처럼 특정 분야나 세부 분야에만 해당할 수도 있습니다. 분류 체계는 연구자가 새로운 과학적 발견을 만들어 내기 위해 수행하는 연구 작업과, 강의, 동료 심사, 학과나 학계에 대한 봉사 같은 비연구 작업을 구분합니다.5 분석은 연구 작업만 대상으로 하며, 여덟 개 범주로 나눴습니다. (1) 데이터 분석, (2) 글쓰기와 커뮤니케이션, (3) 데이터 수집, (4) 읽기와 지식 습득, (5) 이론적 분석, (6) 설계와 개발(소프트웨어, 소재, 창작물), (7) 아이디어 도출과 가설 수립, (8) 연구 관리 등 기타입니다.
각 작업 범주가 Claude와 Claude Code 세션에서 차지하는 비중은 따로 계산했습니다. 범주별 사용량이 많은지 적은지 판단하기 위해, SciNet이 추정한 연구자의 범주별 평균 시간 비중과 비교했습니다. 이 시간 추정치는 LLM 분류기를 기반으로 하며, 작업별 연구자 소요 시간을 기록한 습식 실험 프로토콜과 수천 편의 학술 논문에 나타난 작업 빈도를 이용해 검증했습니다(부록 참고). 이렇게 하면 작업 범주별 Claude 사용 비중이 연구자의 시간 배분을 따르는지, 벗어나는지 판단할 기준이 생깁니다.
작업 범주별 사용량. 데이터 분석 작업은 절대적인 사용량이 가장 많고, 연구자의 시간 비중에 비해서도 과대 반영되어 있습니다. 데이터 분석이 차지하는 비중은 Claude 세션의 33.7%, Claude Code 세션의 48.1%인데, 연구자의 시간 비중은 27.6%입니다. 글쓰기와 커뮤니케이션 작업도 사용량이 많고, 특히 Claude에서 두드러집니다(32.0%, 연구자 시간 비중은 16.0%).6 데이터 수집 작업은 상대적 사용량이 낮습니다. 연구자 시간의 28.6%를 차지하지만, 세션 비중은 Claude에서 11.5%, Claude Code에서 11.9%에 그칩니다. 임상 데이터나 생화학 데이터 수집처럼 물리적 장벽이 있는 작업에서 데이터 수집의 과소 반영이 특히 큽니다. 기록 보관소 문서나 텍스트 검색처럼 디지털 과정에 더 기댈 수 있는 데이터 수집은 과소 반영 정도가 덜하고, 온라인 데이터 수집처럼 순수하게 디지털인 작업은 오히려 과대 반영되기도 합니다. 아이디어 도출과 가설 수립 작업도 사용량이 낮아서, 연구자 시간의 7.1%를 차지하지만 세션 비중은 Claude에서 4.2%, Claude Code에서 2.1%입니다.
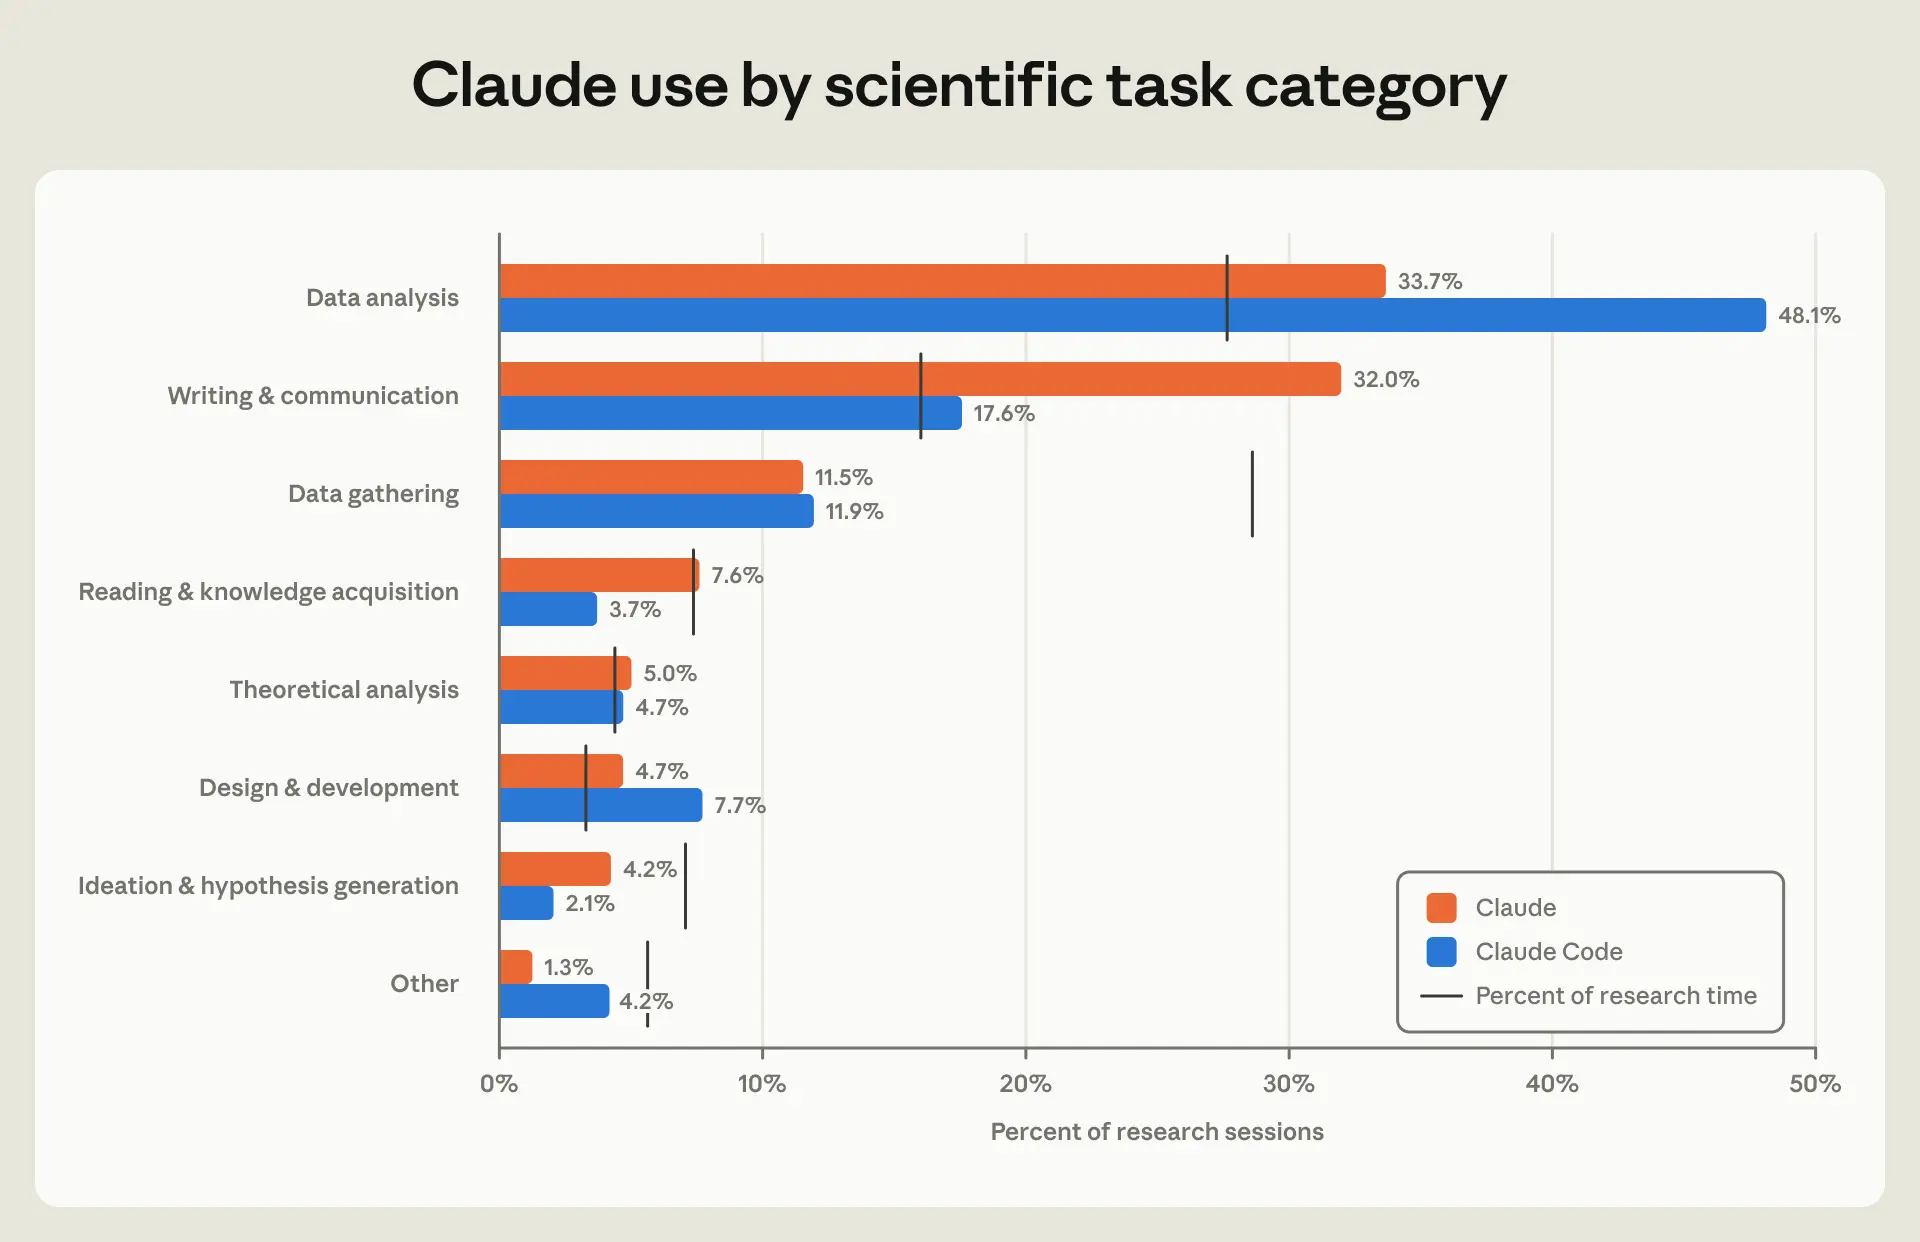
과학 작업 범주별 Claude 사용. 각 행은 여덟 개 작업 범주 중 하나를 나타냅니다. 주황색 막대는 각 범주에 할애된 Claude 연구 세션의 비중, 파란색 막대는 Claude Code 연구 세션의 같은 비중입니다. 검은 선은 SciNet으로 계산한 연구 시간 비중의 추정치입니다(부록 참고).
관측된 사용량과 설문 결과 비교. Claude와 Claude Code 세션 분석과 별도로 과학자 528명을 대상으로 설문을 진행했는데, 응답자가 직접 밝힌 AI 사용 양상은 세션에서 관찰한 패턴과 일치했습니다. 표본은 AI를 적극적으로 도입한 생명과학·보건과학 분야 연구자가 중심입니다.7 그림 3의 Claude 사용 패턴과 마찬가지로, 설문 응답자들이 밝힌 AI 사용은 데이터 분석과 글쓰기·커뮤니케이션에서 가장 높고, 아이디어·가설 도출과 데이터 수집에서는 낮았습니다. 또한 응답자들은 데이터 분석과 글쓰기·커뮤니케이션에서 AI와 작업을 분담하거나 위임하는 경우가 더 많다고 답했습니다(그림 4).
설문에서는 중요한 연구 성과를 내는 데 어떤 범주가 가장 중요한지도 물었습니다. 응답자들은 아이디어·가설 도출을 1위, 데이터 수집을 2위로 꼽았습니다. 주목할 점은 이 두 범주가 응답자가 밝힌 사용량과 Claude 세션 양쪽에서 모두 과소 반영되어 있다는 것입니다. 다만 과소 반영의 이유는 서로 다를 가능성이 큽니다. 데이터 수집은 상당 부분이 물리적 작업이지만, 아이디어 도출은 그렇지 않습니다. 아이디어 도출의 경우 과학자들이 직접 아이디어를 내는 쪽을 선호하거나, AI의 역량이 제한적이라고 판단할 수 있습니다. 또한 아이디어 도출은 다른 여러 연구 작업에 섞여 있어 분류하기 어렵기 때문에, 우리 데이터가 실제보다 적게 집계했을 수도 있습니다. 하지만 어떤 연구 질문을 추구할지 고르고 그에 답할 연구를 설계하는 것 같은 고차원적 아이디어 도출에서는 AI가 실제로 더 약할 수도 있습니다.
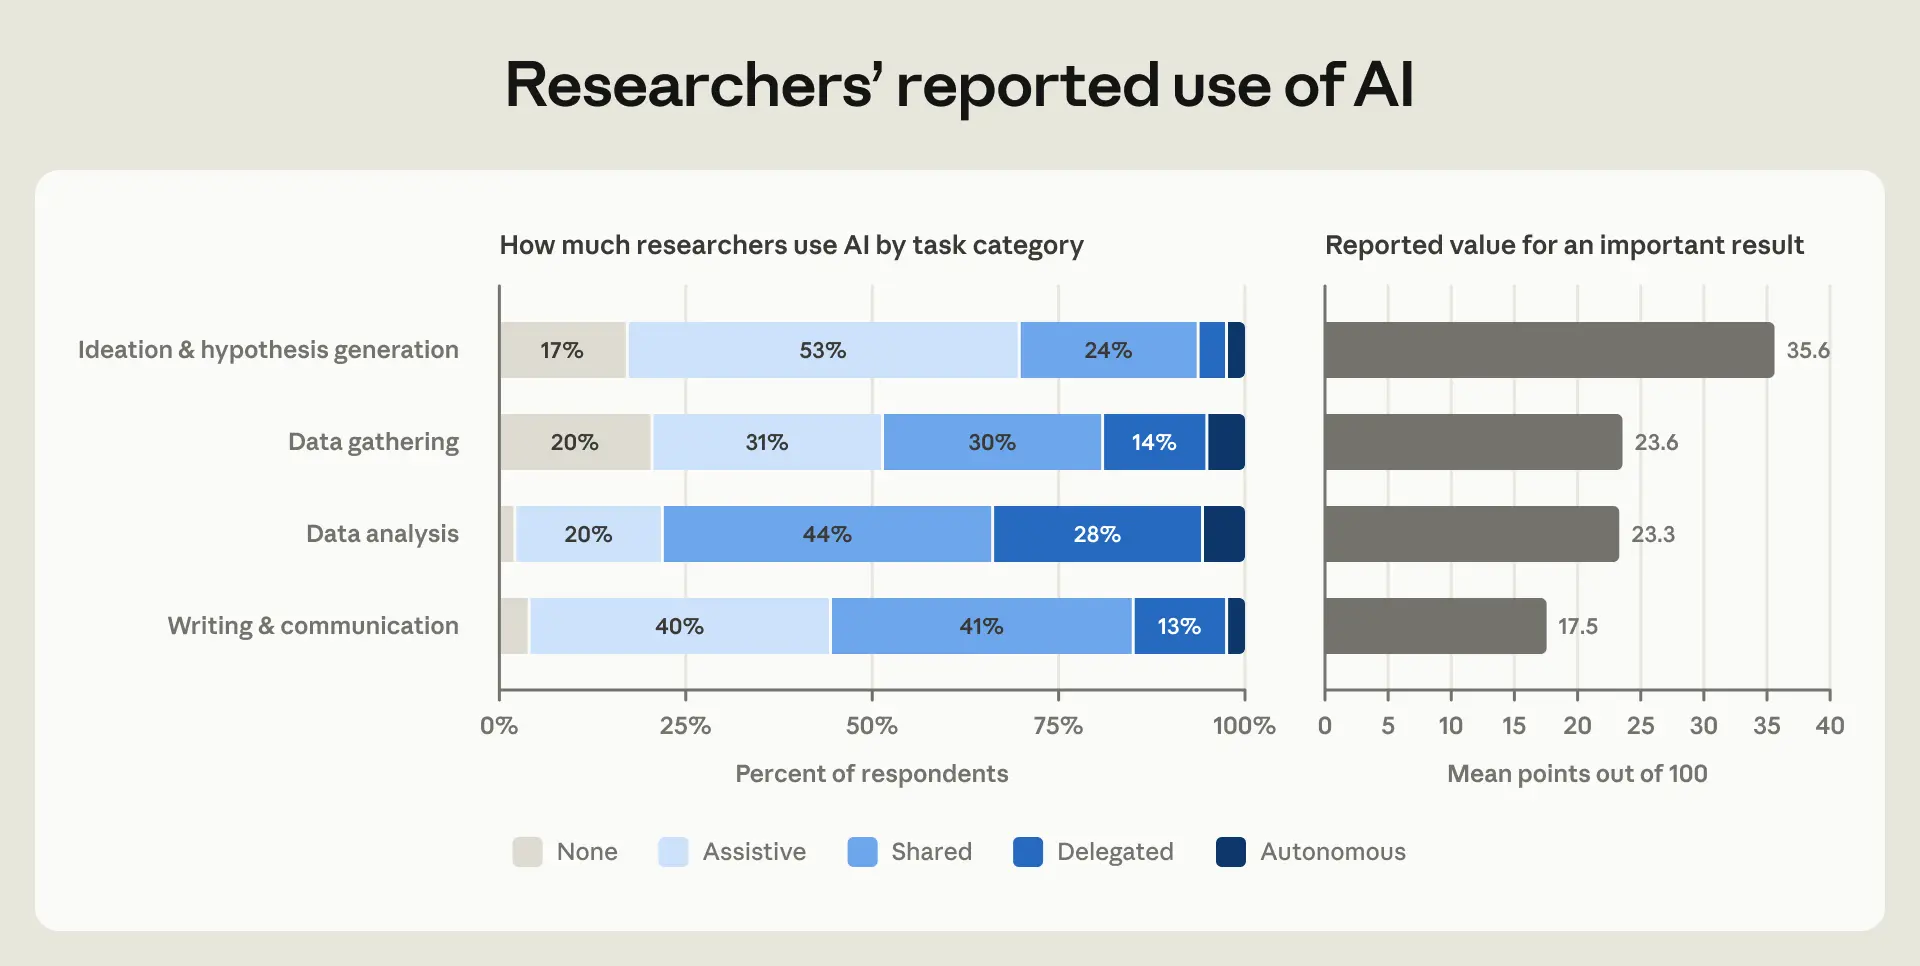
연구자들이 밝힌 AI 사용 수준. 왼쪽 패널은 네 가지 연구 작업 범주에서 AI 사용 수준(전혀 안 씀부터 자율 수행까지)별로 설문 응답자가 차지하는 비율을 보여 줍니다. 오른쪽 패널은 응답자가 각 범주가 중요한 연구 성과를 내는 데 얼마나 중요하다고 평가했는지를 나타냅니다(네 범주에 100점을 배분).
Claude Science의 생물학·생의학 활용. Claude와 Claude Code는 범용 인터페이스이지만, 과학 전용 AI 도구도 점점 늘고 있습니다. 이런 도구가 더 전문적이고 까다로운 연구를 뒷받침하는지 알아보기 위해, 프라이버시를 보호하는 분석 인프라로 Claude Science의 생물학·생의학 작업을 Claude와 Claude Code의 같은 분야 작업과 비교했습니다.
Claude Science는 Claude를 여러 연구 도구와 데이터베이스에 연결합니다. 이들은 원래 흩어져 있는데, Claude Science가 이를 통합해 과학 워크플로를 가속합니다. 과학자들은 연구에서 서로 다른 도구와 데이터베이스를 조합하려고, 데이터 구조나 쿼리 언어가 제각각인 여러 플랫폼을 써야 하는 경우가 많습니다. 예를 들어 기존 약물이 특정 단백질에 작용할 수 있는지 연구하는 생물학자는 보통 단백질의 기능, 구조, 해당 단백질에 대해 이미 시험된 화합물, 관련 임상시험이나 논문을 각각 다른 데이터베이스에서 찾아봐야 합니다. Claude Science는 이를 하나의 워크플로로 묶어 줍니다.
Claude Science 사용은 생명과학에 집중되어 있습니다. 상위 두 분야는 생의학과 생물학이며, 둘을 합치면 세션의 50%가 넘습니다. 이 분야들 안에서, Claude에서 수행되는 작업과 비교했을 때 어떤 작업이 가장 과대 반영되어 있는지 살펴봤습니다.
분석 결과 연구자들은 Claude보다 더 전문적인 작업에 Claude Science를 쓰고 있었습니다(그림 5). 예를 들어 '단백질-단백질 또는 단백질-리간드 상호작용에 대한 기전 모델 제안' 작업은 Claude보다 Claude Science에서 등장할 가능성이 5.6배 높습니다. 이 작업은 단백질이 다른 단백질이나 약물 같은 작은 분자와 어떻게 결합하는지를 개별 분자 접촉 수준에서 설명하는 일입니다. Claude Science는 연결된 여러 데이터베이스에서 단백질 구조와 결합 데이터를 모아 검증 가능한 상호작용 모델로 조합할 수 있어, 이 작업에 잘 맞습니다. 반면 논문 초고 작성이나 공동 연구자와의 조율 같은 일반적인 작업에서는 Claude Science의 사용이 상대적으로 적습니다. 또한 아이디어·가설 도출이 Claude Science 세션의 8%를 차지해 이 작업들이 연구자 시간에서 차지하는 비중과 대략 비슷했는데, 이는 과학 전용 AI 도구가 더 복잡하고 창의적인 작업을 뒷받침할 수 있음을 시사합니다.
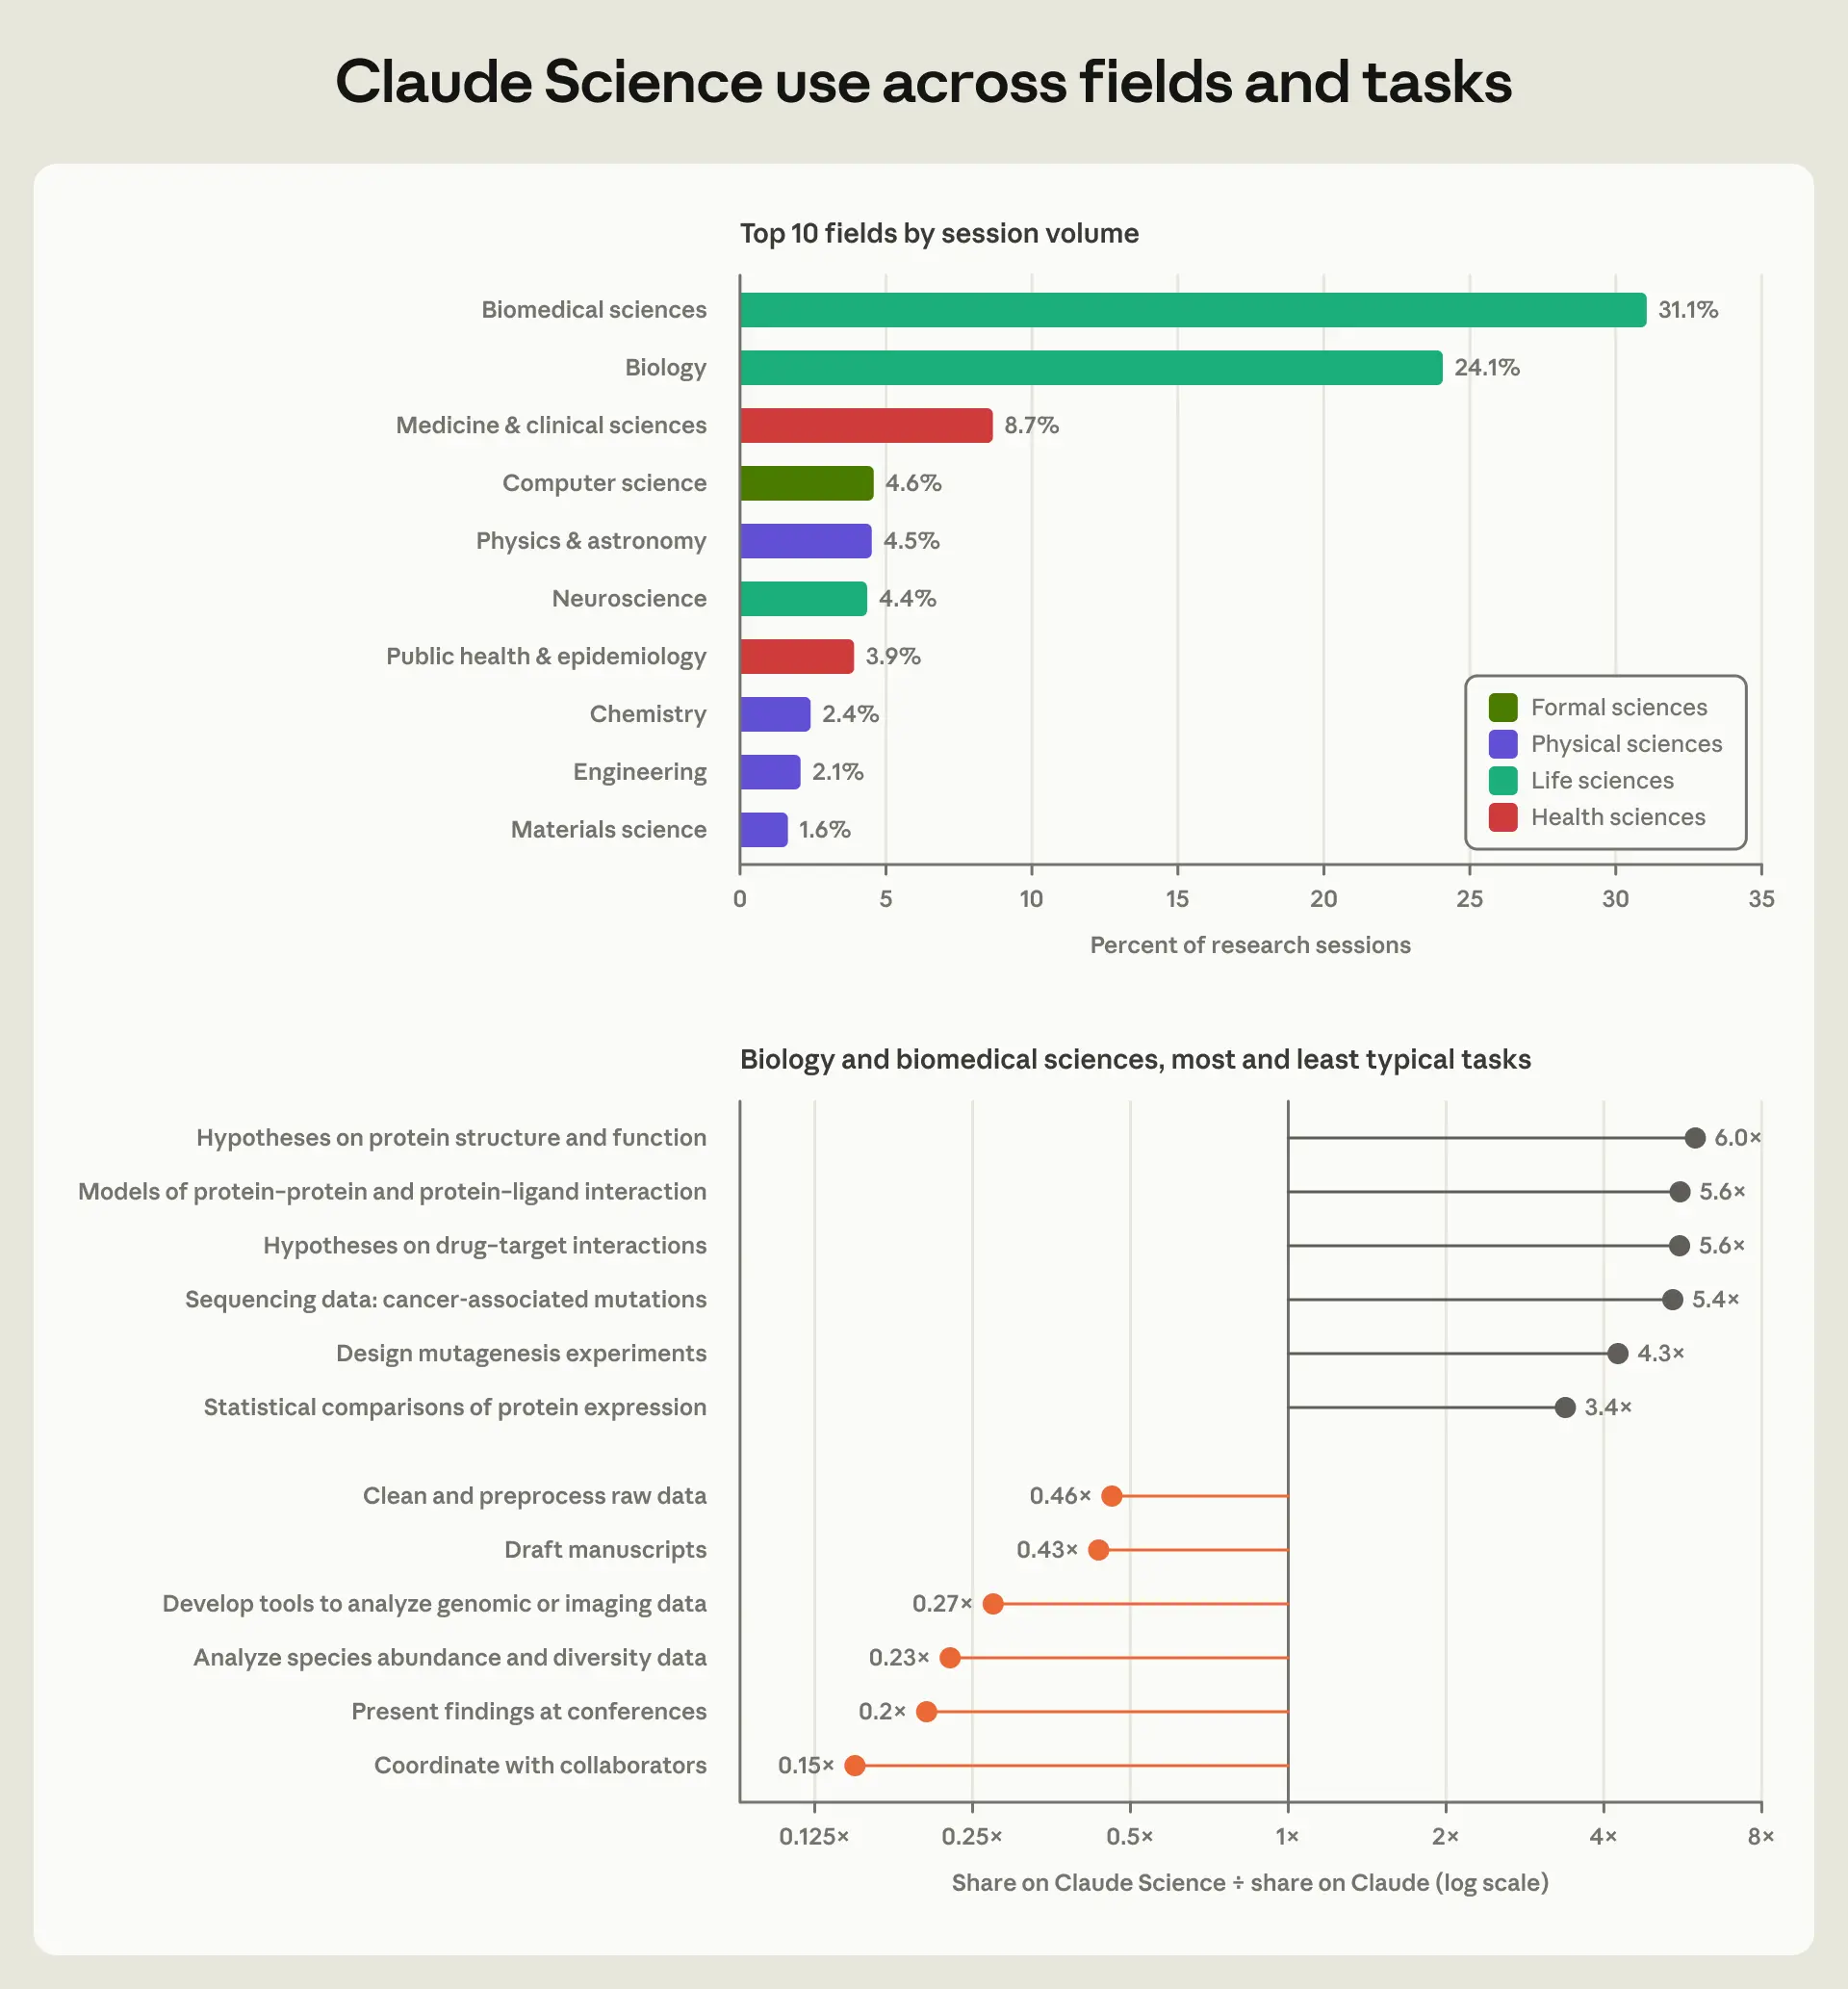
분야와 작업별 Claude Science 사용. 위쪽 패널은 전체 Claude Science 연구 세션에서 비중이 큰 상위 10개 분야를 보여 줍니다. 아래쪽 패널은 생물학과 생의학 분야에서 Claude 대비 Claude Science에서 가장 전형적인 작업과 가장 덜 전형적인 작업을 보여 주며, 계산식은 (이 분야들에서 해당 작업이 Claude Science 연구 세션에서 차지하는 비중) / (같은 분야에서 해당 작업이 Claude 연구 세션에서 차지하는 비중)입니다.
생의학과 생물학에 초점을 맞추고 이전 연구(Appel et al. 2026)에서 소개한 경제적 기본 요소 프레임워크의 지표를 사용해 분석한 결과, Claude Science의 작업은 Claude나 Claude Code의 작업보다 더 길고 정교하며 더 자율적으로 수행되었습니다(그림 6). 이는 전문 AI 도구가 더 까다로운 작업에 쓰이고 있음을 보여 줍니다.8 Claude Science 세션에는 AI 없이 사람이 하면 Claude와 Claude Code의 작업보다 거의 두 배 많은 시간이 걸릴 작업이 담겨 있습니다. 세션의 내용도 더 고급 수준입니다. Claude Science 사용의 80% 이상이 박사급 훈련(교육 연수 20년)이 필요한 것으로 추정되는데, 다른 인터페이스는 약 50~70%입니다. Claude Science 세션의 70% 이상은 AI의 자율성이 높은 상태로 수행되었으며, 이는 Claude(23.7%)보다 훨씬 높고 Claude Code(64.1%)보다도 다소 높습니다.
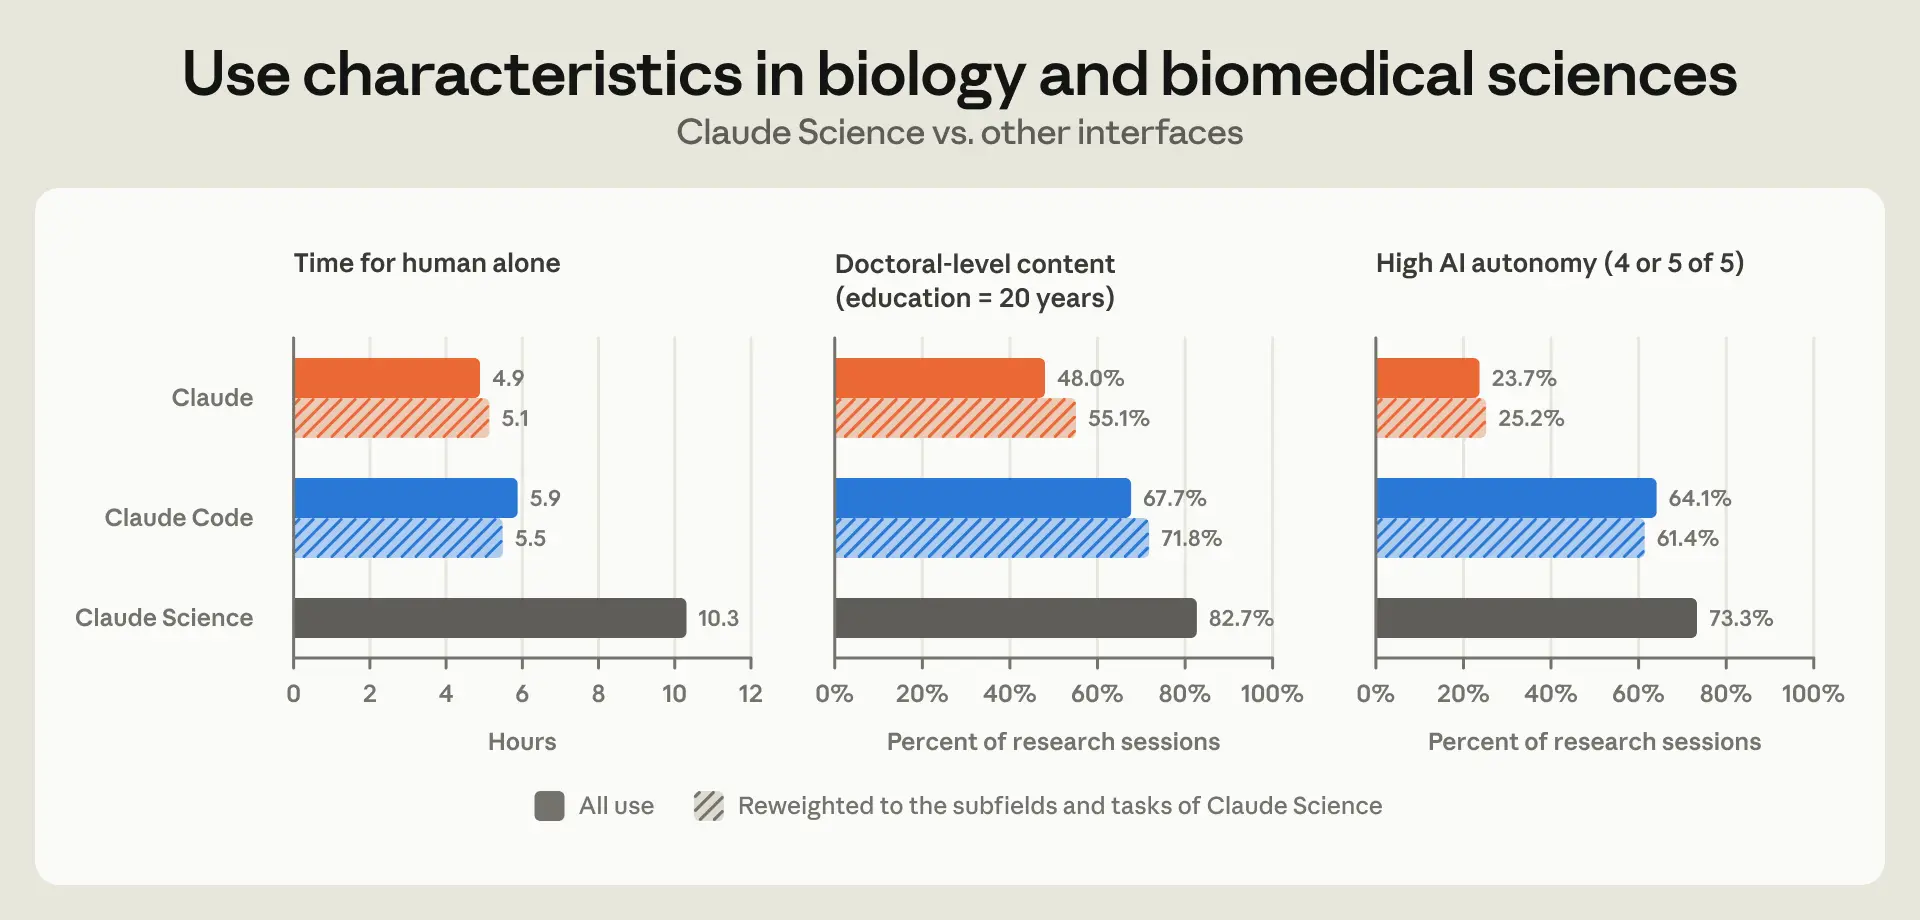
생물학·생의학의 사용 특성. 생물학과 생의학 분야에서 Claude, Claude Code, Claude Science로 수행한 작업의 사람 기준 소요 시간, 박사급 내용 비중, 자율성 수준을 비교했습니다. 빗금 친 주황색과 파란색 막대는 Claude와 Claude Code가 수행한 세부 분야와 작업의 가중치를 Claude Science가 수행한 것에 맞춰 다시 조정한 결과입니다.
Claude 사용의 산출물. 마지막으로, Claude로 만든 산출물은 분야별로 뚜렷한 차이를 보입니다(그림 7).9 문서, 보고서, 학술 논문 같은 글 형태의 산출물은 자연과학이나 형식과학보다 사회과학과 인문학에서 더 흔합니다. 반대로 코드, 소프트웨어 출력물, 데이터 같은 기술적 산출물은 자연과학과 형식과학에서 더 자주 나타납니다. 보건과학은 전체적으로 산출물 면에서 사회과학과 더 비슷합니다. 기술적 산출물은 Claude Code에서 Claude보다 약 두 배 흔하지만, 분야별 전반적인 패턴은 비슷합니다(부록 참고).
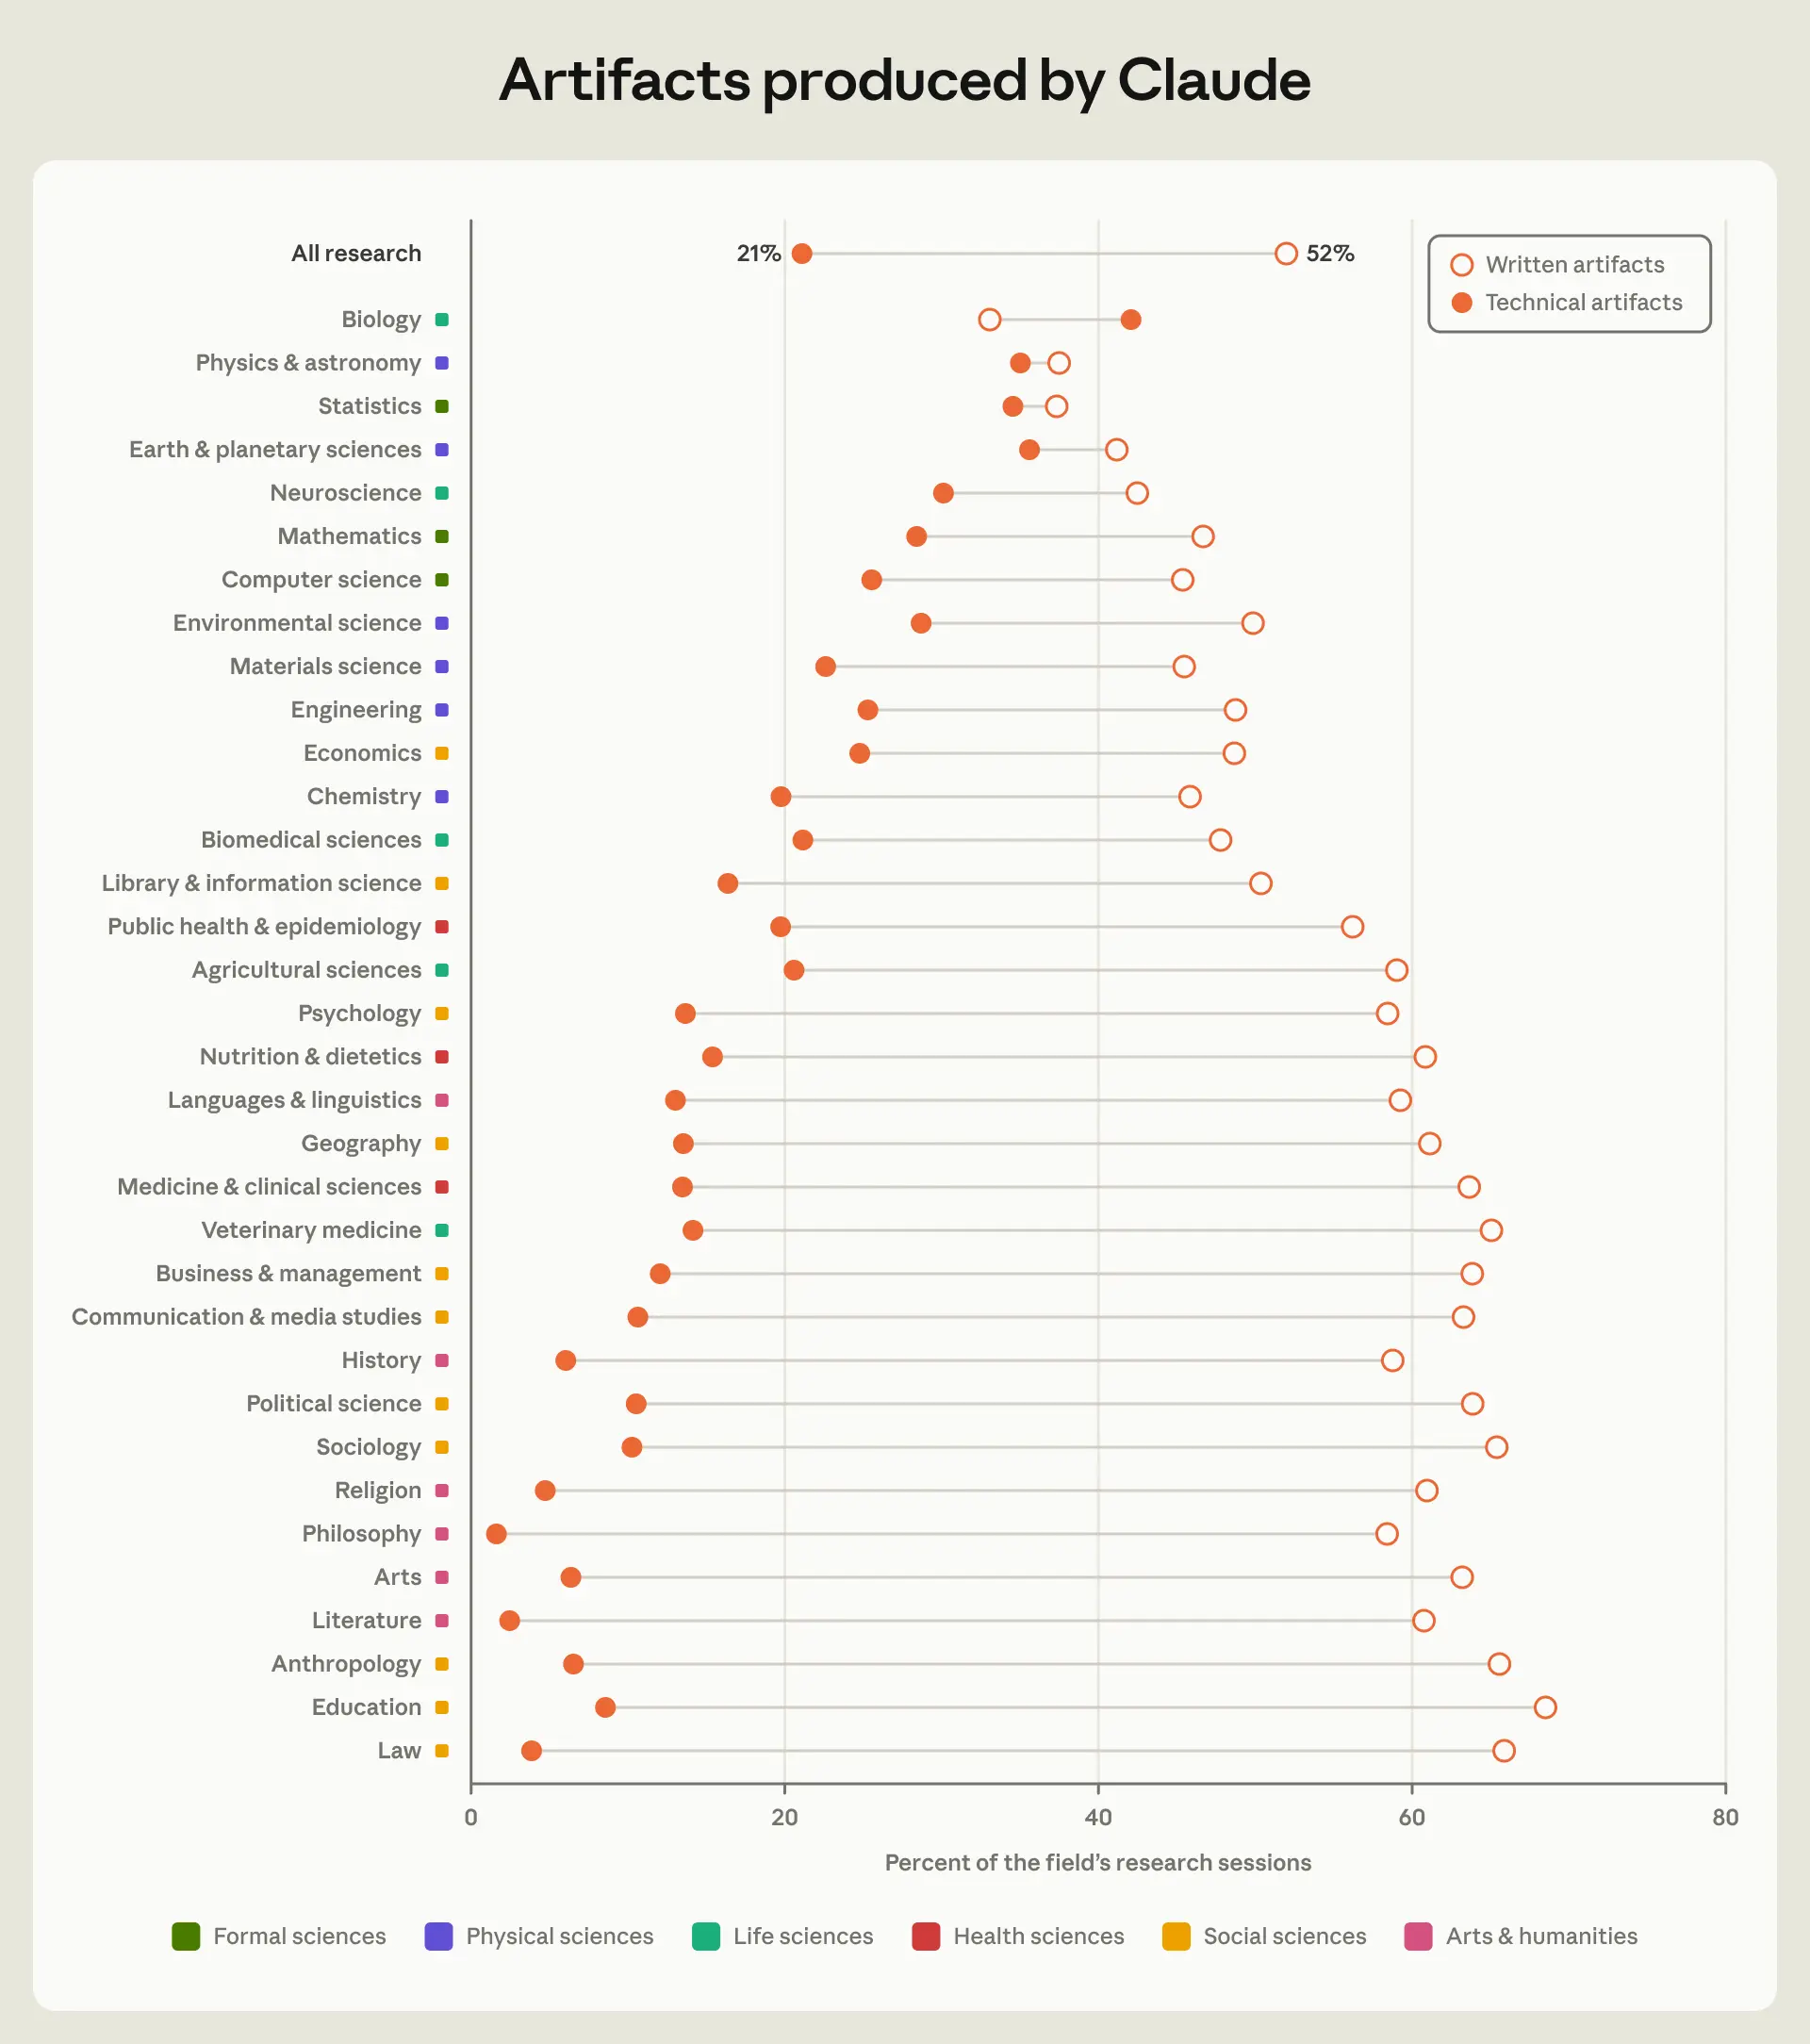
Claude로 만든 산출물. 분야별로 Claude 세션 중 글 형태 산출물과 기술적 산출물을 만든 세션의 비중입니다. 분야는 글 형태 산출물 비중과 기술적 산출물 비중의 차이에 따라 정렬했습니다.
사용과 AI 역량의 관계
AI 사용은 AI의 역량을 따라갈까요? 분야의 규모로 Claude 사용량의 차이를 일부 설명할 수는 있지만 전부는 아닙니다. 예컨대 컴퓨터과학 연구자들은 분야 규모로 예상되는 것보다 훨씬 많이 Claude를 쓰고, 영양학 연구자들은 훨씬 적게 씁니다. 마찬가지로 연구자가 직접 시간을 쓰는 곳이 Claude를 가장 많이 쓰는 곳을 온전히 예측해 주지는 않습니다. 데이터 분석과 글쓰기 같은 일부 큰 작업 범주는 연구 시간 비중보다 사용 비중이 훨씬 크고, 데이터 수집이나 아이디어·가설 도출 같은 범주는 훨씬 작습니다. 여기서는 이런 사용량 차이가 AI가 실제로 할 수 있는 일을 반영하는지 검증합니다.
작업별 AI 역량을 측정하기 위해 먼저 LLM 분류기로 역량 점수를 만들었습니다. SciNet은 각 작업마다 과학자가 그 작업을 끝내려면 거쳐야 하는 개별 단계의 목록을 제공합니다. 예를 들어 화학에는 반응 혼합물 정제라는 작업이 있고, 이 작업의 한 단계는 크로마토그래피 컬럼 충전입니다. 분류기에는 분류 체계 전반에서 뽑은 단계 쌍을 보여 주고, AI가 어느 쪽을 더 잘 수행할 수 있는지 물었습니다. 이 비교 결과는 Bradley–Terry 모델로 종합했는데, 이는 체스 선수들의 맞대결 결과로 순위를 매기는 Elo 레이팅의 바탕이 되는 모델과 같습니다. 단계는 비교에서 이기면 점수가 오르고 지면 내려갑니다. 그다음 각 작업에 속한 단계들의 점수를 평균 내 작업 수준의 점수를 구했습니다(자세한 내용은 부록 참고). 이 지표를 이론적 AI 역량이라 부르고, 개별 작업의 점수는 AI 역량 점수라 부르겠습니다.
작업 간 사용량을 비교하기 위해, 연구자가 해당 작업에 쓰는 시간에 비해 Claude 사용이 많은지 적은지를 살펴봤습니다. 예를 들어 연구자 시간의 5%를 차지하는 작업이 Claude 세션의 10%를 차지한다면, 예상보다 두 배 많이 쓰이는 것이며 비율은 2입니다. 비율이 1이면 Claude 사용이 해당 작업에 쓰는 연구자 시간과 일치한다는 뜻입니다. 비율이 1보다 작으면 그 작업에 드는 연구자 시간으로 예상되는 것보다 Claude를 덜 쓴다는 뜻입니다.
그림 8을 보면 이 사용 비율은 작업의 AI 역량 점수가 높아질수록 가파르게 상승합니다. 반응 혼합물 정제나 참여 관찰 수행처럼 역량 점수가 하위 20%인 작업에서는 Claude를 거의 쓰지 않습니다. 중간 수준의 점수에서는 비율이 대략 1이어서, 사용량이 연구자 시간과 맞아떨어집니다. 데이터 시각화나 통계 검정 적용처럼 상위 20%인 작업에서는 연구자가 해당 작업에 보통 쓰는 시간에 비해 사용량이 Claude에서 약 두 배, Claude Code에서 약 네 배 높았습니다. 이런 패턴은 과학자들의 Claude 사용이 AI 역량 점수를 밀접하게 따라간다는 것을 시사합니다. Claude Code의 기울기가 더 가파른 것은 역량 점수가 더 높은 계산 작업에 집중되어 있기 때문입니다.
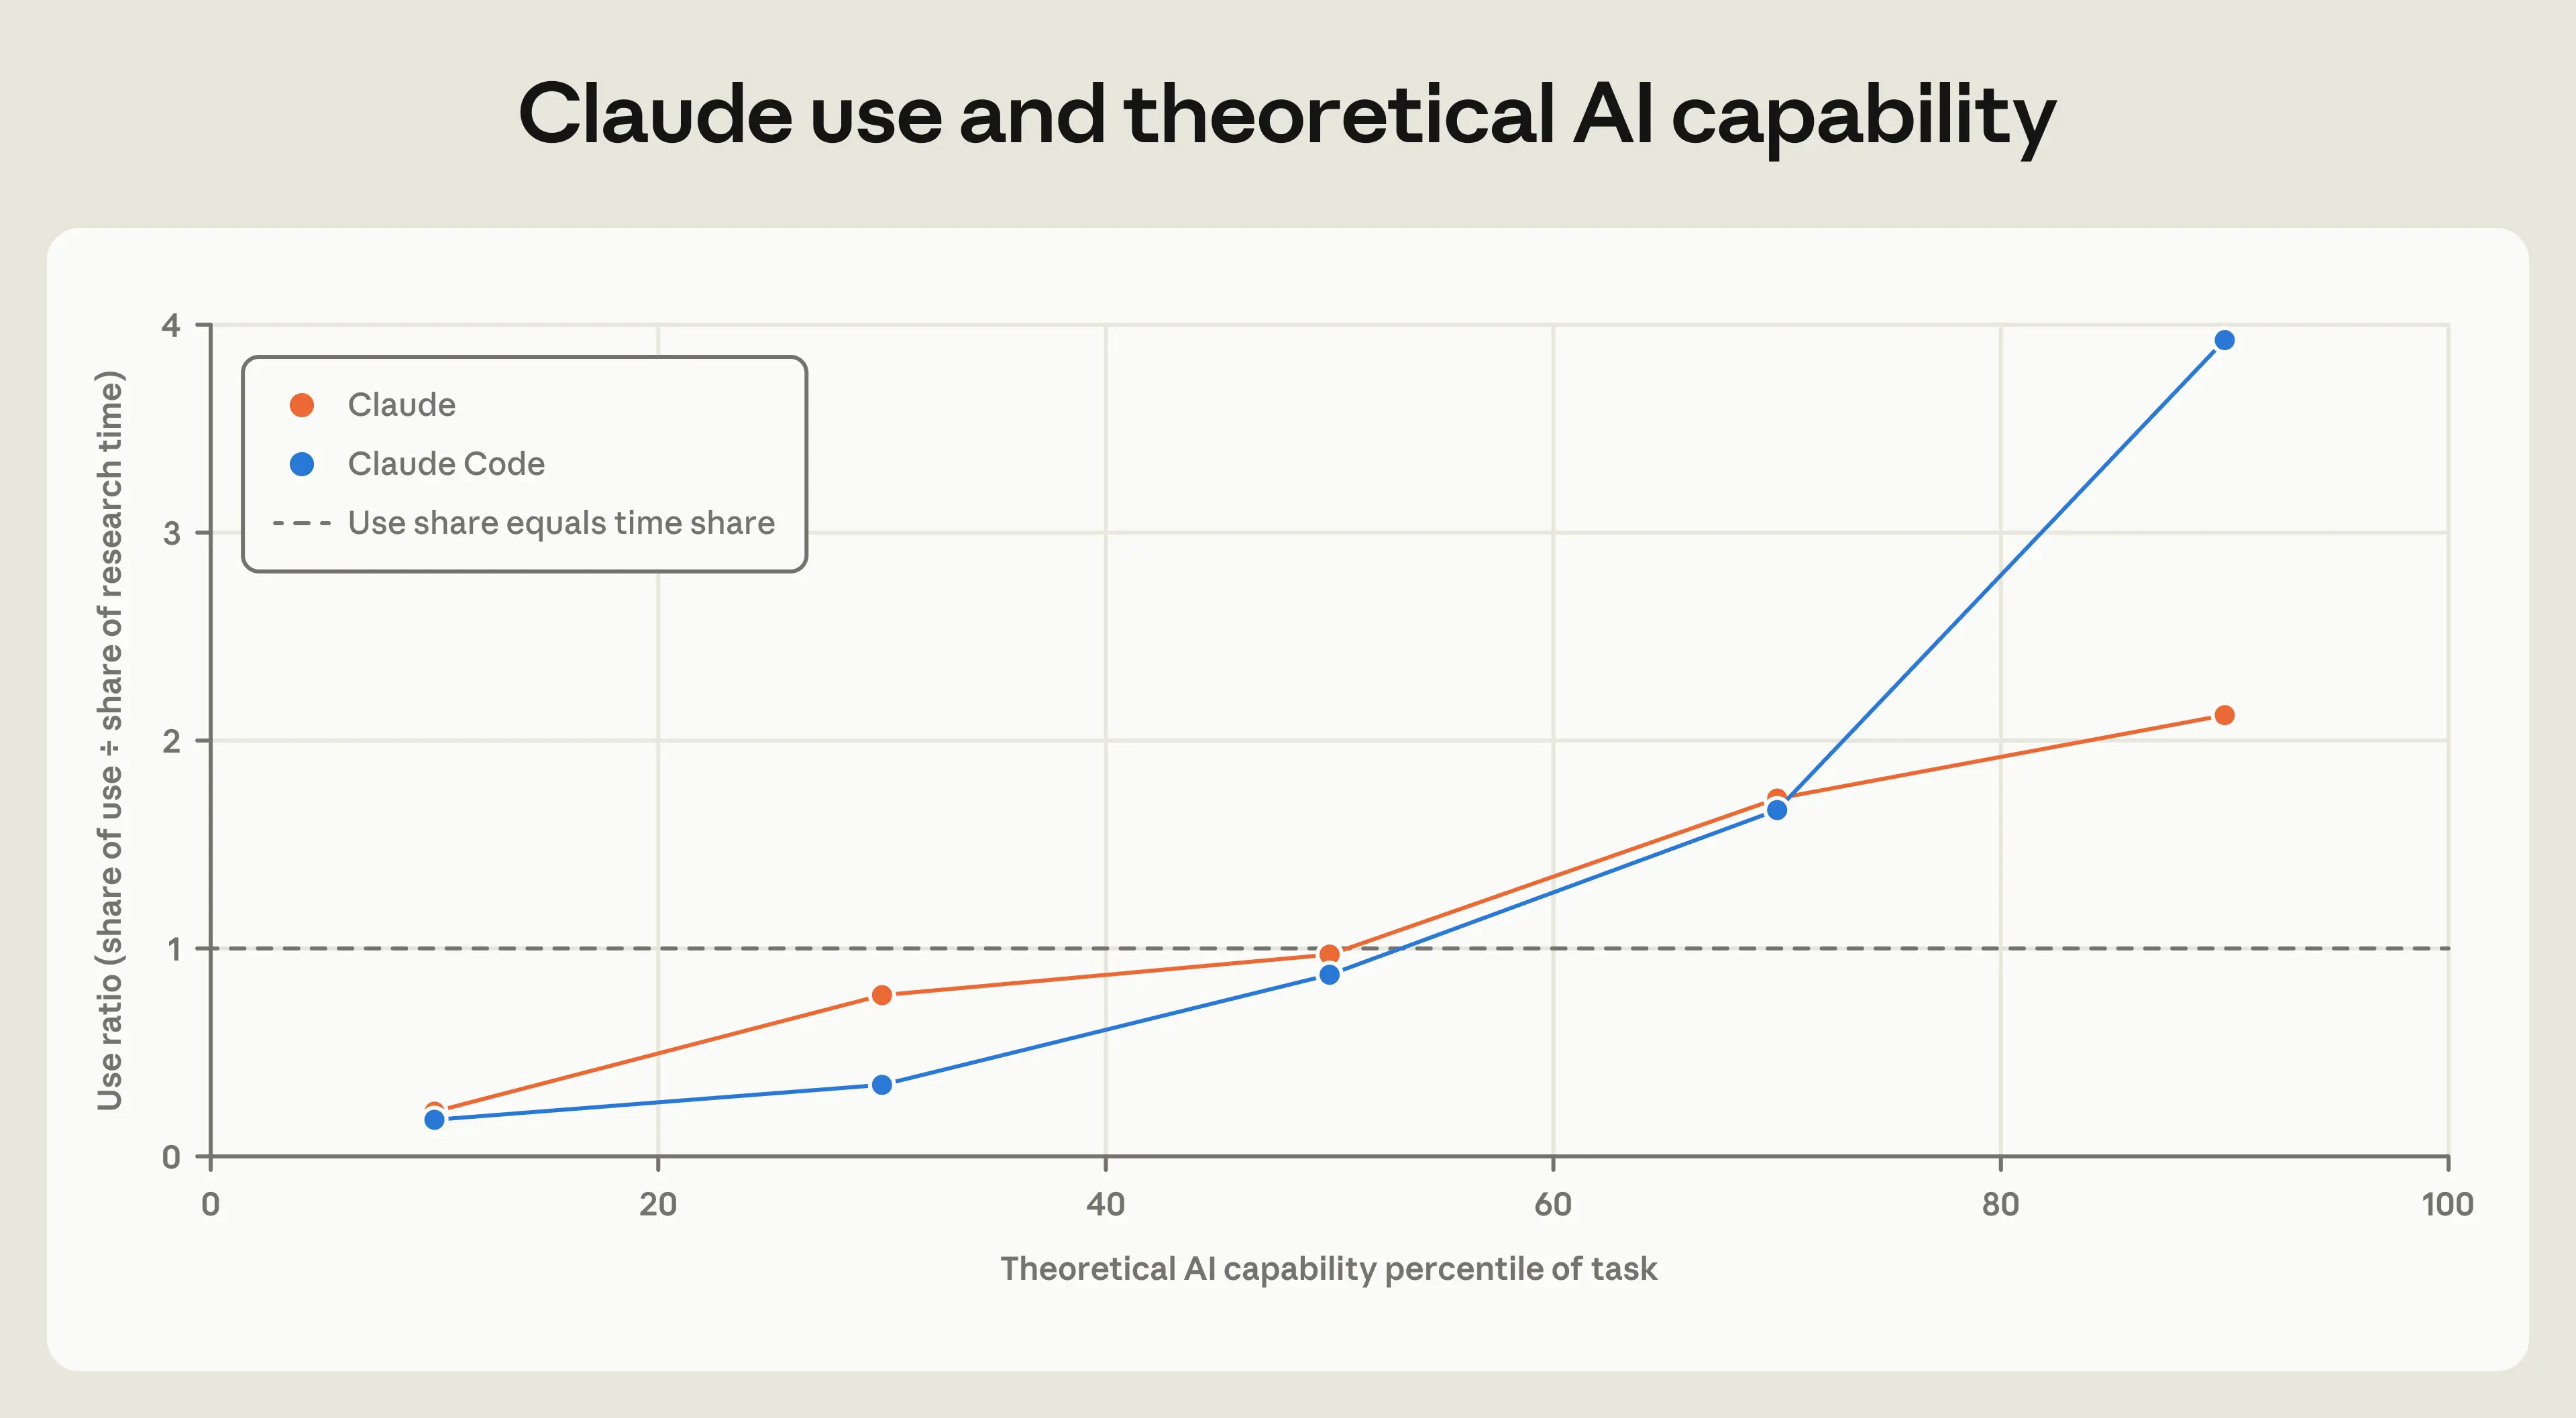
Claude 사용과 이론적 AI 역량. 세로축은 역량 5분위별 작업의 사용 비율로, 해당 작업에 할애된 연구 세션의 비중을 SciNet으로 추정한 연구 시간 비중으로 나눈 값입니다. 가로축은 작업의 AI 역량 점수(백분위)입니다. 주황색 점은 Claude에서 각 AI 역량 5분위 작업의 평균 사용 비율, 파란색 점은 Claude Code의 같은 값을 나타냅니다.
이론적 AI 역량은 여러 이유로 작업마다 다를 수 있습니다. 이런 차이를 이해하기 위해 각 작업의 AI 역량 점수를 LLM이 도출한 세 가지 작업 특성 그룹과 연결해 봤습니다. 첫째는 강화학습(RL)에 대한 적합성, 둘째는 작업이 주로 인지적인지, 대인 관계적인지, 물리적인지, 셋째는 규제로 인해 AI 사용이 제한되는지입니다(그림 9, 정의와 데이터 출처는 부록 참고).
먼저 RL 적합성을 보겠습니다. RL에서 AI 모델은 작업을 반복해서 시도하고 성공하면 보상을 받으며, 이를 통해 그 작업을 수행하는 법을 학습합니다. 성공 여부를 쉽게 검증할 수 있고, 컴퓨팅 환경에서 많은 사례를 시뮬레이션할 수 있고, 피드백을 빠르게 줄 수 있는 작업이 특히 RL에 적합합니다(Lambert et al. 2024; Guo et al. 2025). 이 세 가지 RL 관련 요소에 대해서는 SciNet의 작업별 지표를 사용하고, 이를 하나의 지수로 요약했습니다. 작업의 역량 점수는 따로 분류한 RL 지수 점수와 상관관계가 높습니다(상관계수 0.78). 이는 RL을 적용하기 가장 쉬운 연구 작업에서 AI가 가장 뛰어나다는 뜻입니다.
작업의 성격과 관련된 다른 중요한 특성도 있습니다. 어떤 연구 작업은 본질적으로 인지적이고, 어떤 작업은 물리적 행동이나 대인 접촉이 필요합니다. 순수하게 인지적인 기계는 물리적 작업까지 할 수 없습니다. AI 사용을 제한하는 규제가 있을 수도 있습니다. AI 역량 점수는 인지적 작업이라는 특성이 강한 작업일수록 높았습니다(상관계수 0.69). 반대로 물리적 작업이 많은 연구 작업은 AI 역량 점수가 낮았습니다(−0.57). 대인 업무가 포함된 연구 활동(−0.31)이나 AI 사용에 규제가 있는 연구 활동(−0.38)도 점수가 낮은 경향이 있습니다.
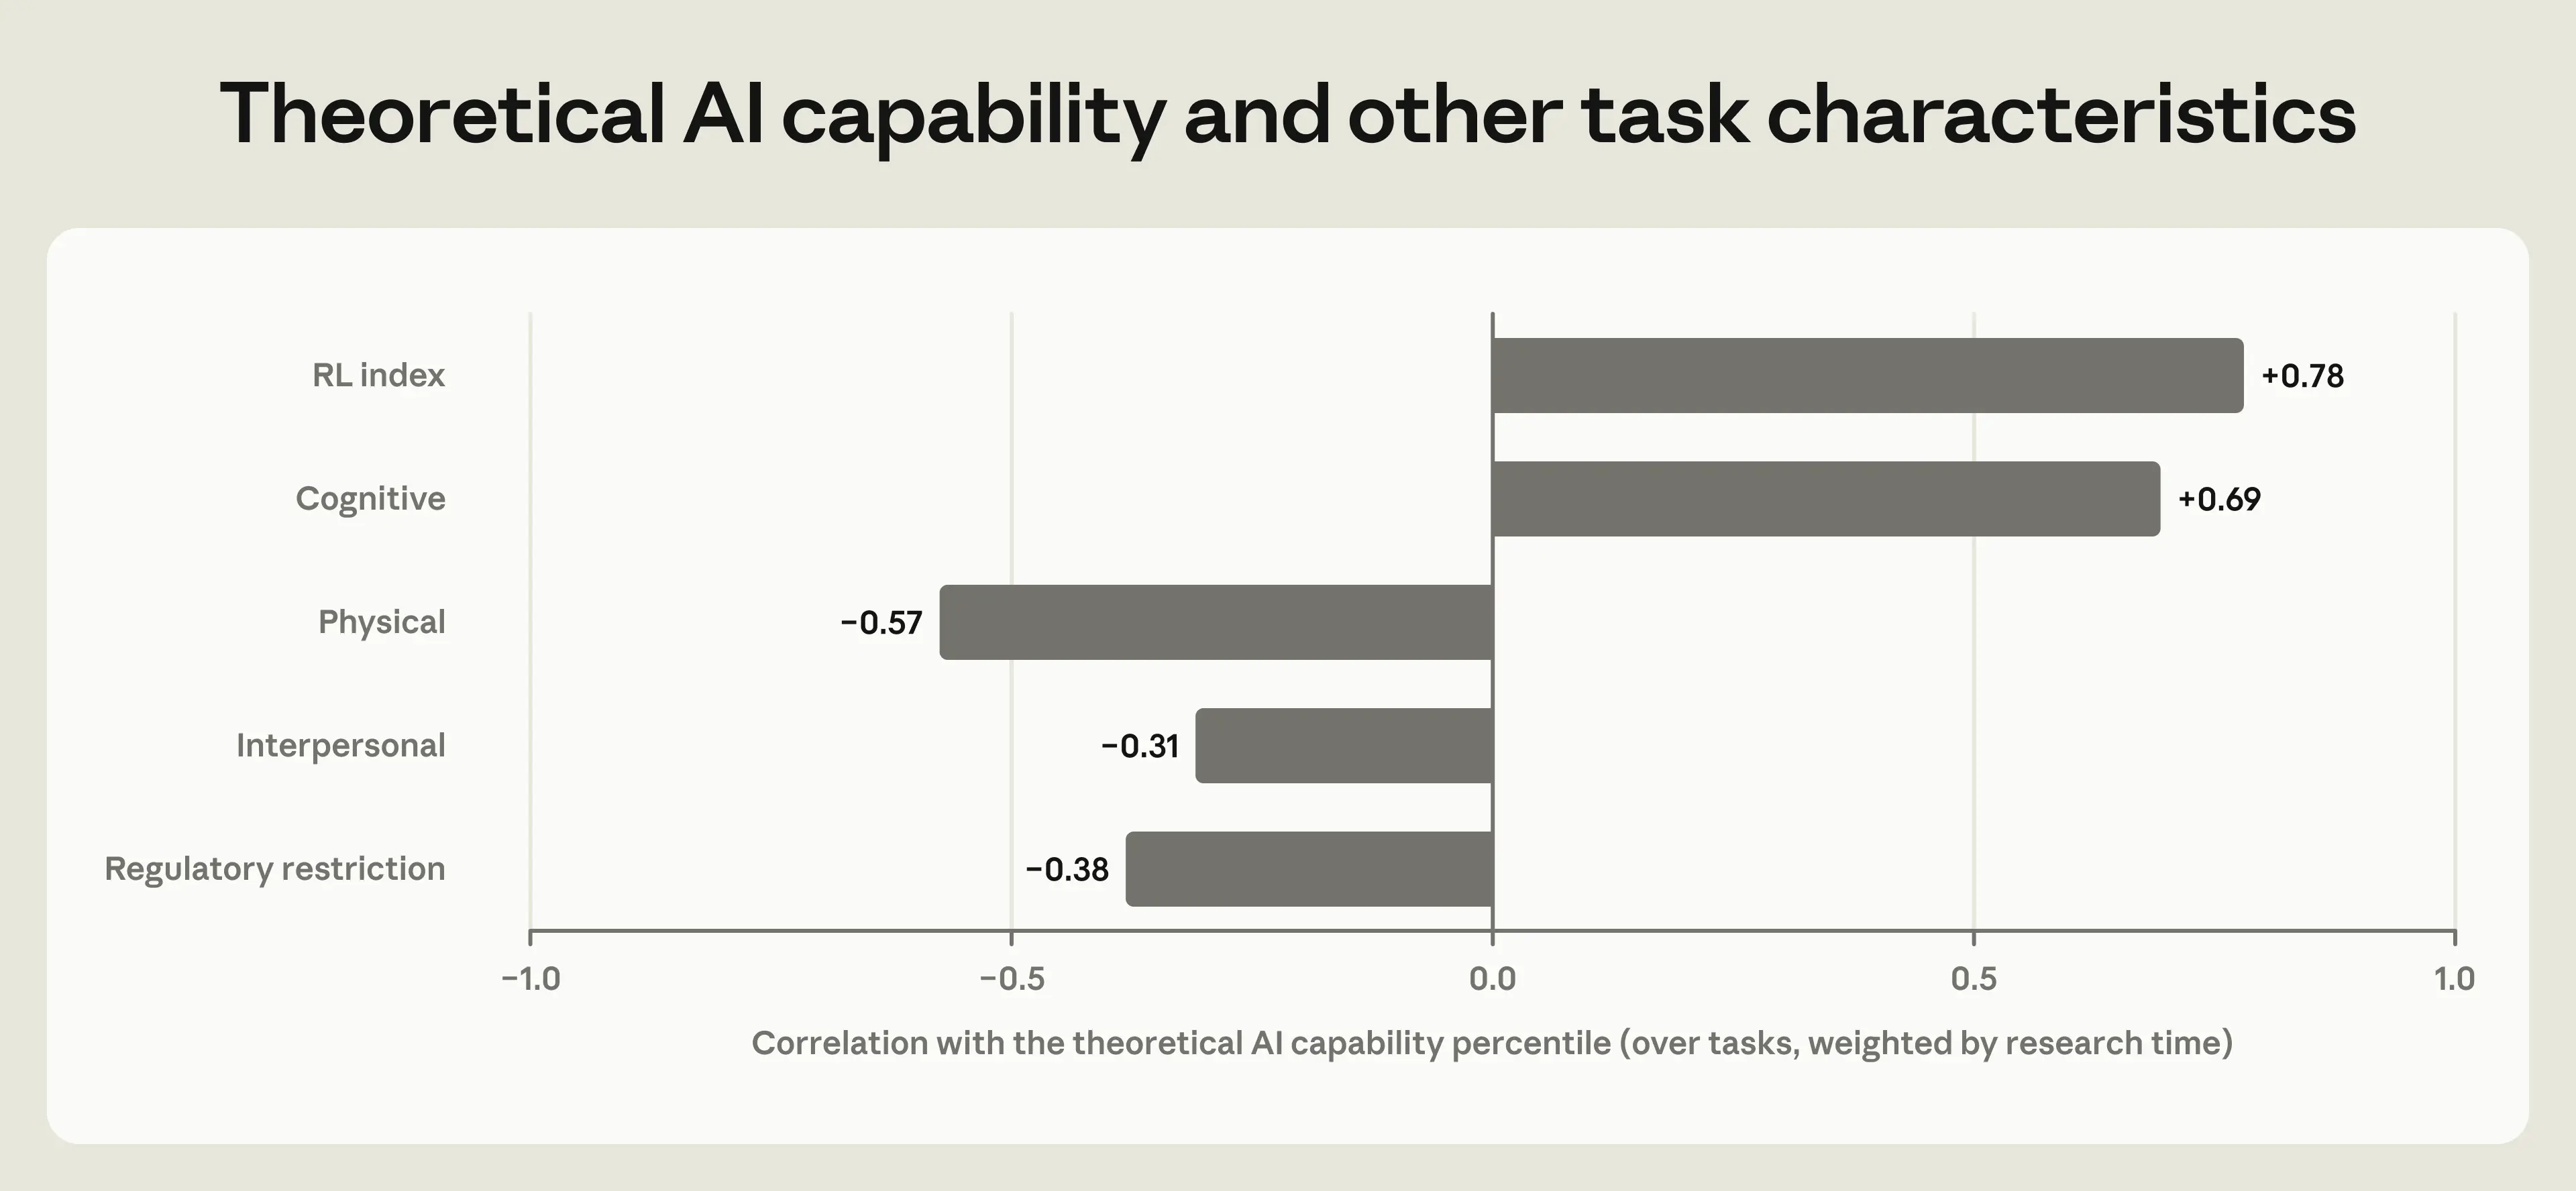
이론적 AI 역량과 기타 작업 특성. 연구 작업의 AI 역량 점수 백분위와 그 작업의 다른 특성 간 상관관계입니다.
같은 작업 특성으로 연구자가 특정 작업에 Claude를 얼마나 쓰는지도 예측할 수 있습니다(그림 10). RL 적합성이 하위 5분의 1인 작업에서는 Claude를 거의 쓰지 않습니다. 상위 5분의 1인 작업에서는 연구자가 쓰는 시간에 비해 Claude 사용이 유난히 많아서, Claude에서는 두 배, Claude Code에서는 네 배입니다. 이는 상위 20% 작업이 예상 사용량의 두 배에서 네 배를 끌어들인, AI 역량 점수 전반과 Claude 사용 사이의 관계와 비슷합니다.
주로 인지적인 작업에서도 Claude 사용이 유난히 많습니다. 반면 물리적 작업과 대인 작업에서는 Claude 사용이 적습니다. 규제 장벽 때문에 AI의 지원이 제한되는 작업에서도 Claude 사용이 낮습니다. 전체적으로, 고도로 전문화된 연구 작업 전반에서 사용량과 역량 지표는 강한 관련성을 보입니다.
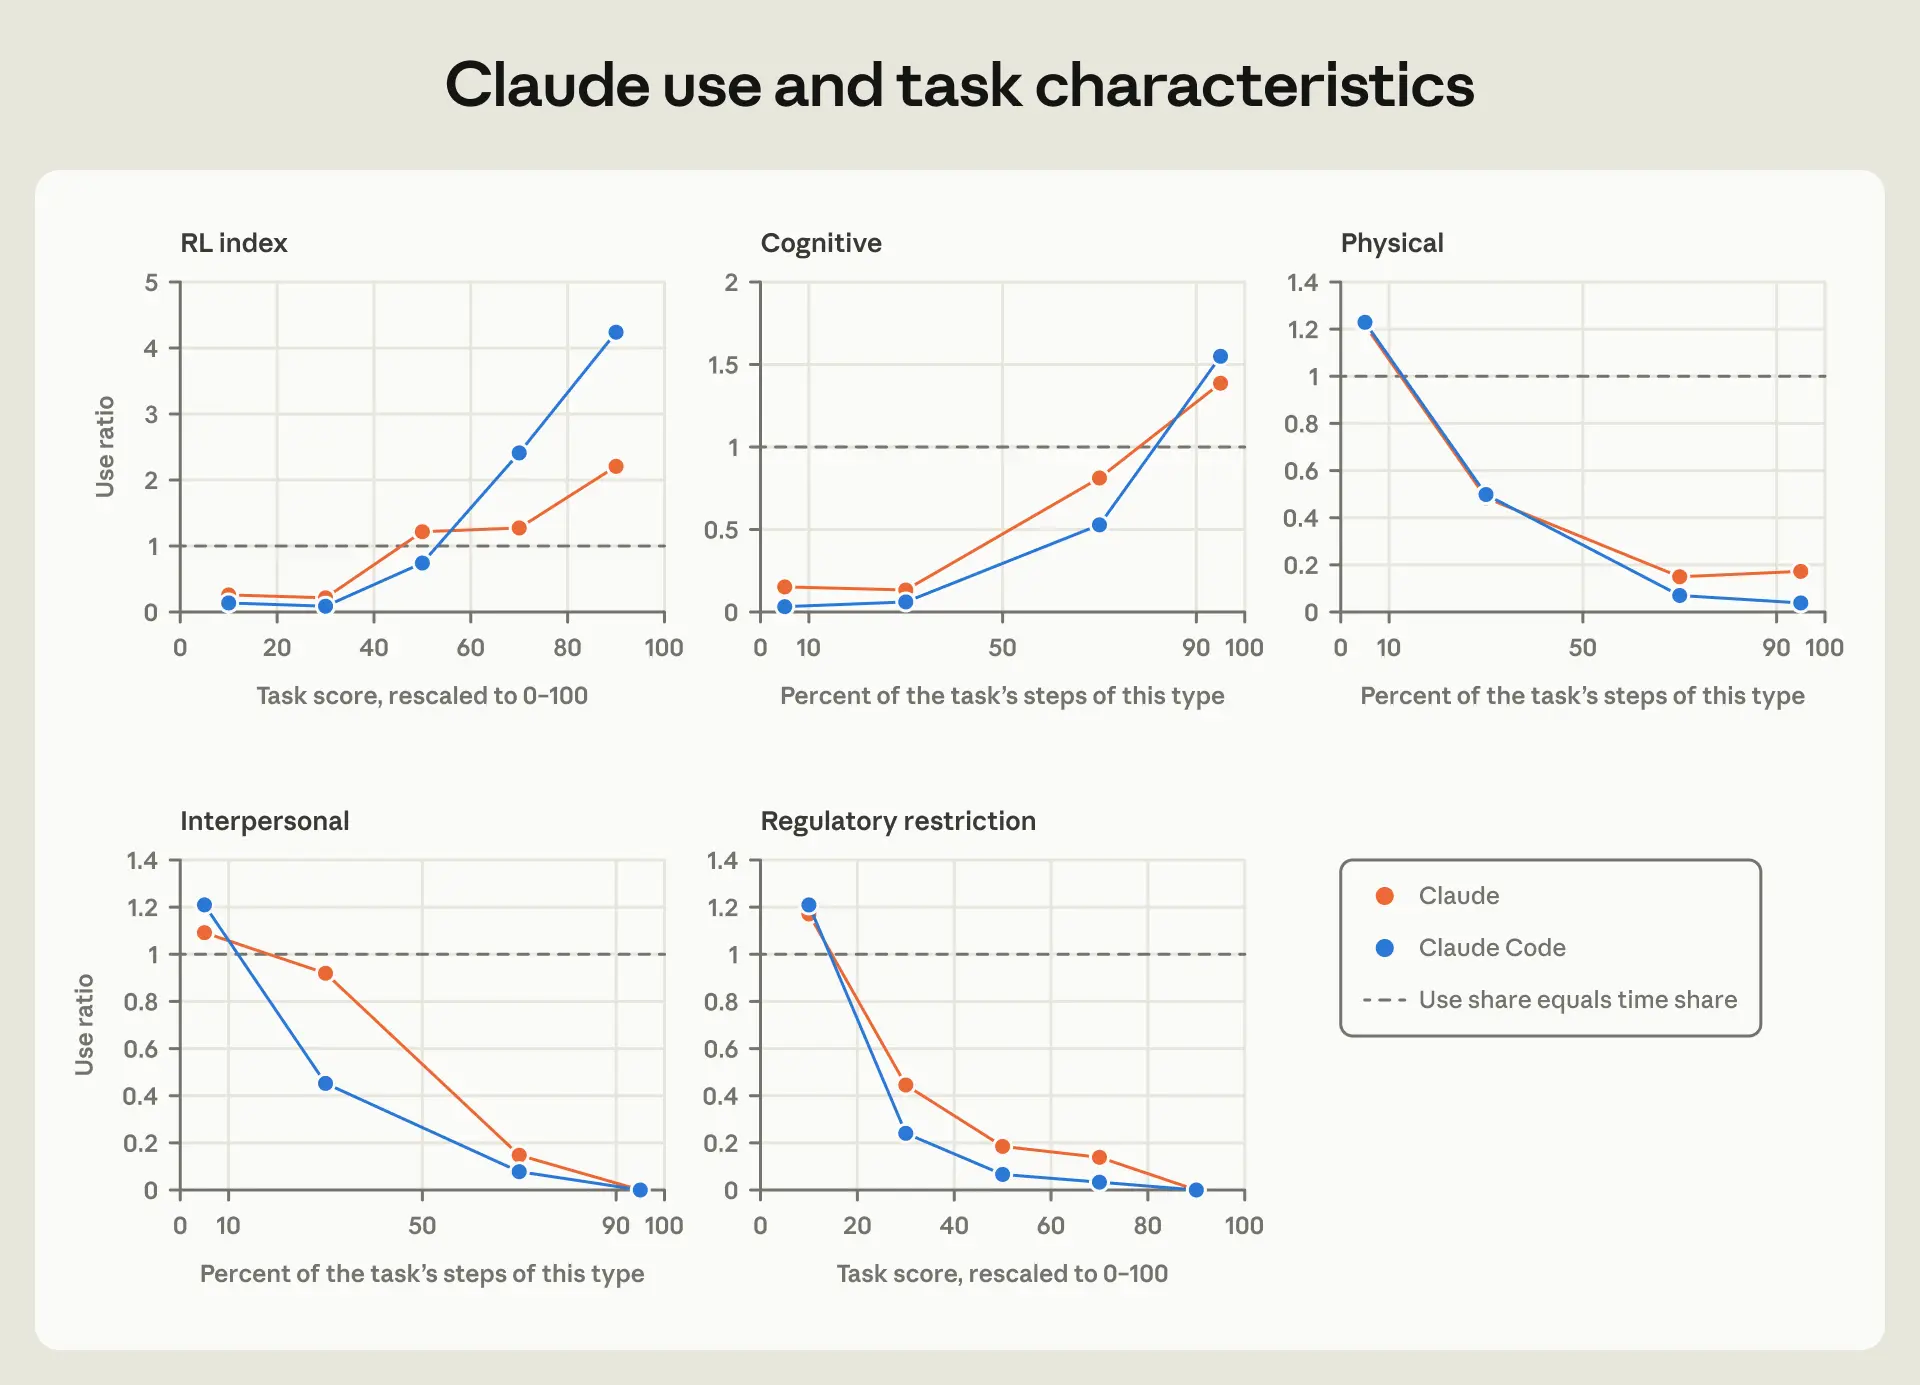
Claude 사용과 작업 특성. 각 패널은 서로 다른 작업 특성을 다룹니다. 세로축은 해당 특성 점수가 서로 다른 작업 그룹('구간')의 사용 비율입니다. 가로축은 해당 특성의 강도를 나타내는 지표입니다. 주황색 점은 Claude에서 각 구간 작업의 평균 사용 비율, 파란색 점은 Claude Code의 같은 값입니다. 0에 있는 점은 해당 사용을 만든 계정이 너무 적어 프라이버시 보호를 위해 가린 구간입니다.
과학 분야마다 연구 활동의 구성은 다릅니다. 세부 연구 작업에서 나타난 사용량과 역량 점수의 상관관계는, 왜 어떤 분야가 다른 분야보다 Claude를 더 많이 쓰는지 설명하는 데 도움이 될까요? 데이터를 보면 그렇습니다. 그림 11처럼 세부 분야의 연구자 1인당 Claude 사용량은 해당 분야 작업의 평균 AI 역량 점수가 높을수록 늘어나는 경향이 있습니다(상관계수는 Claude 0.45, Claude Code 0.57).
영역별로도 편차가 상당한데, 이는 Claude 사용이 AI가 할 수 있는 일 외의 요인에도 영향을 받는다는 뜻입니다. 보건과학 연구자들은 작업의 AI 역량 점수에 비해 Claude를 비교적 적게 쓰는데, 의료 데이터와 연구에 대한 규제가 AI 사용을 제한하거나 통합을 어렵게 하기 때문일 수 있습니다. 형식과학, 사회과학, 예술·인문학 연구자들은 AI 역량 점수로 예상되는 것보다 Claude를 더 많이 씁니다. 이 분야들의 작업은 상당 부분이 텍스트와 코드로 이뤄져 있어 AI 도구 도입이 쉬운 것으로 보입니다. 물리과학과 생명과학에서는 대체로 Claude 사용이 AI 역량 점수를 더 가깝게 따라가지만, 개별 세부 분야는 여기서 벗어나기도 합니다.
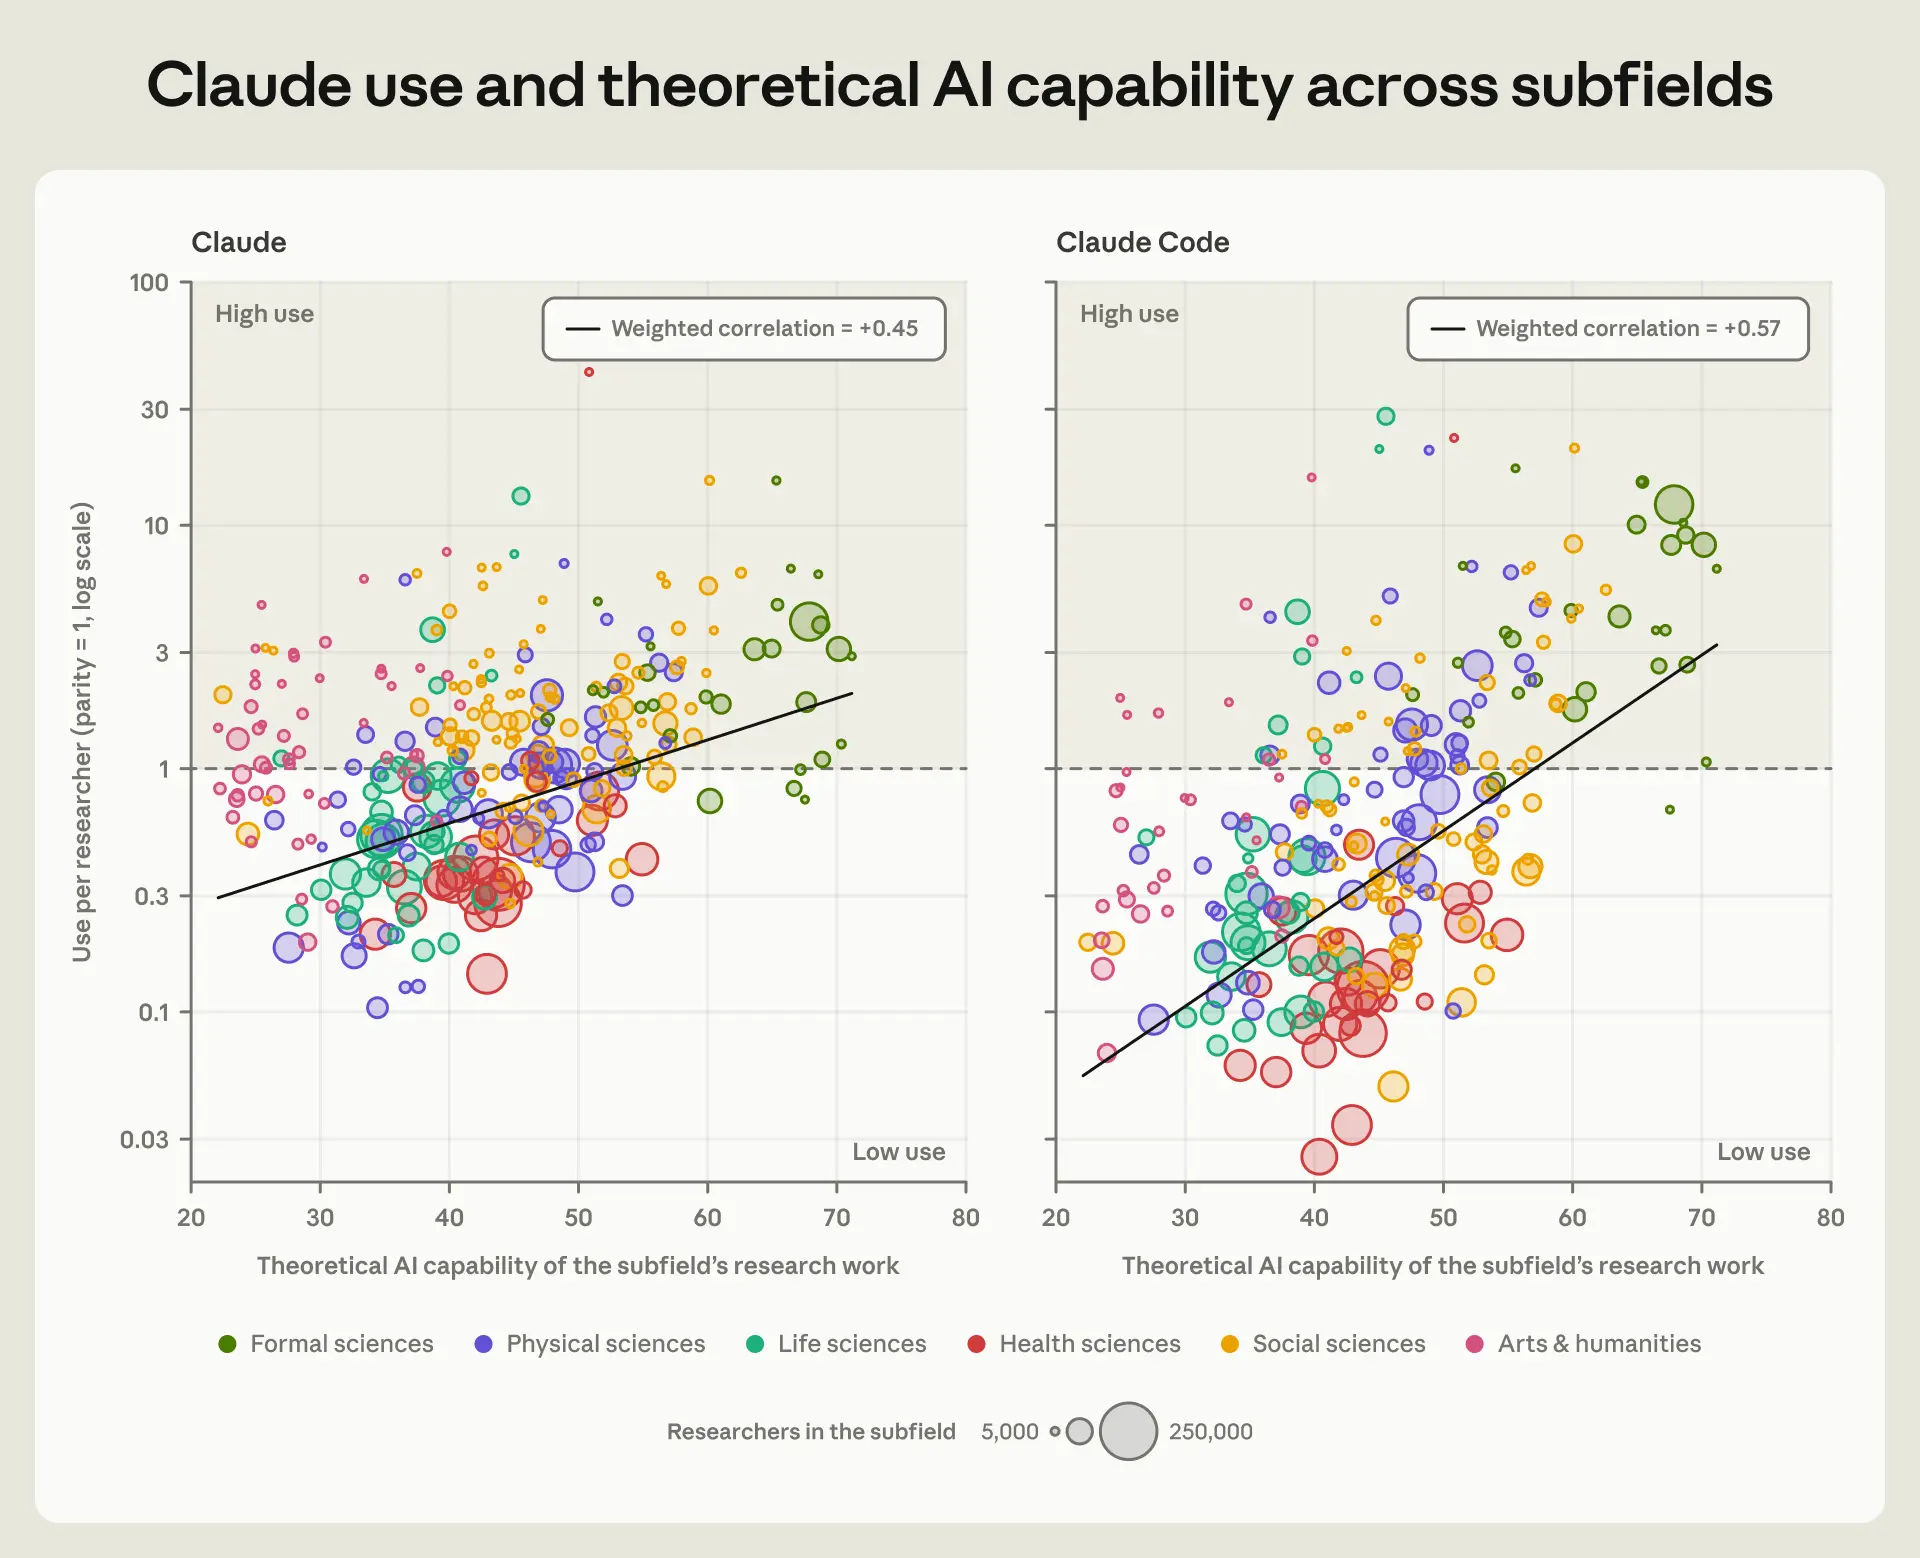
세부 분야별 Claude 사용과 이론적 AI 역량. 두 패널 모두 각 세부 분야를 점으로 나타내며, 점의 크기는 해당 세부 분야의 연구자 수를 뜻합니다. 세로축은 연구자 1인당 사용량이며 로그 눈금입니다. 1인당 사용량은 세부 분야의 연구 세션 비중을 전체 연구자 중 해당 세부 분야 연구자의 비중으로 나눠 계산했습니다. 가로축은 세부 분야의 AI 역량 점수로, 해당 세부 분야의 모든 연구 작업을 연구자 시간으로 가중해 종합한 값입니다. 검은 선은 최적 적합선이며, 각 패널에는 세부 분야 규모로 가중한 상관관계를 표시했습니다. 왼쪽 패널은 Claude의 연구 세션, 오른쪽 패널은 Claude Code의 연구 세션 결과입니다.
이론적 AI 역량은 연구자가 Claude에게 얼마나 자율적으로 일하도록 맡기는지도 예측해 줍니다. 그림 12를 보면 자율적 사용은 세부 분야의 이론적 AI 역량과 상관관계가 있습니다. 즉 이론적 AI 역량이 높은 세부 분야일수록 AI를 더 많이 쓸 뿐 아니라, 더 자율적인 방식으로 씁니다.
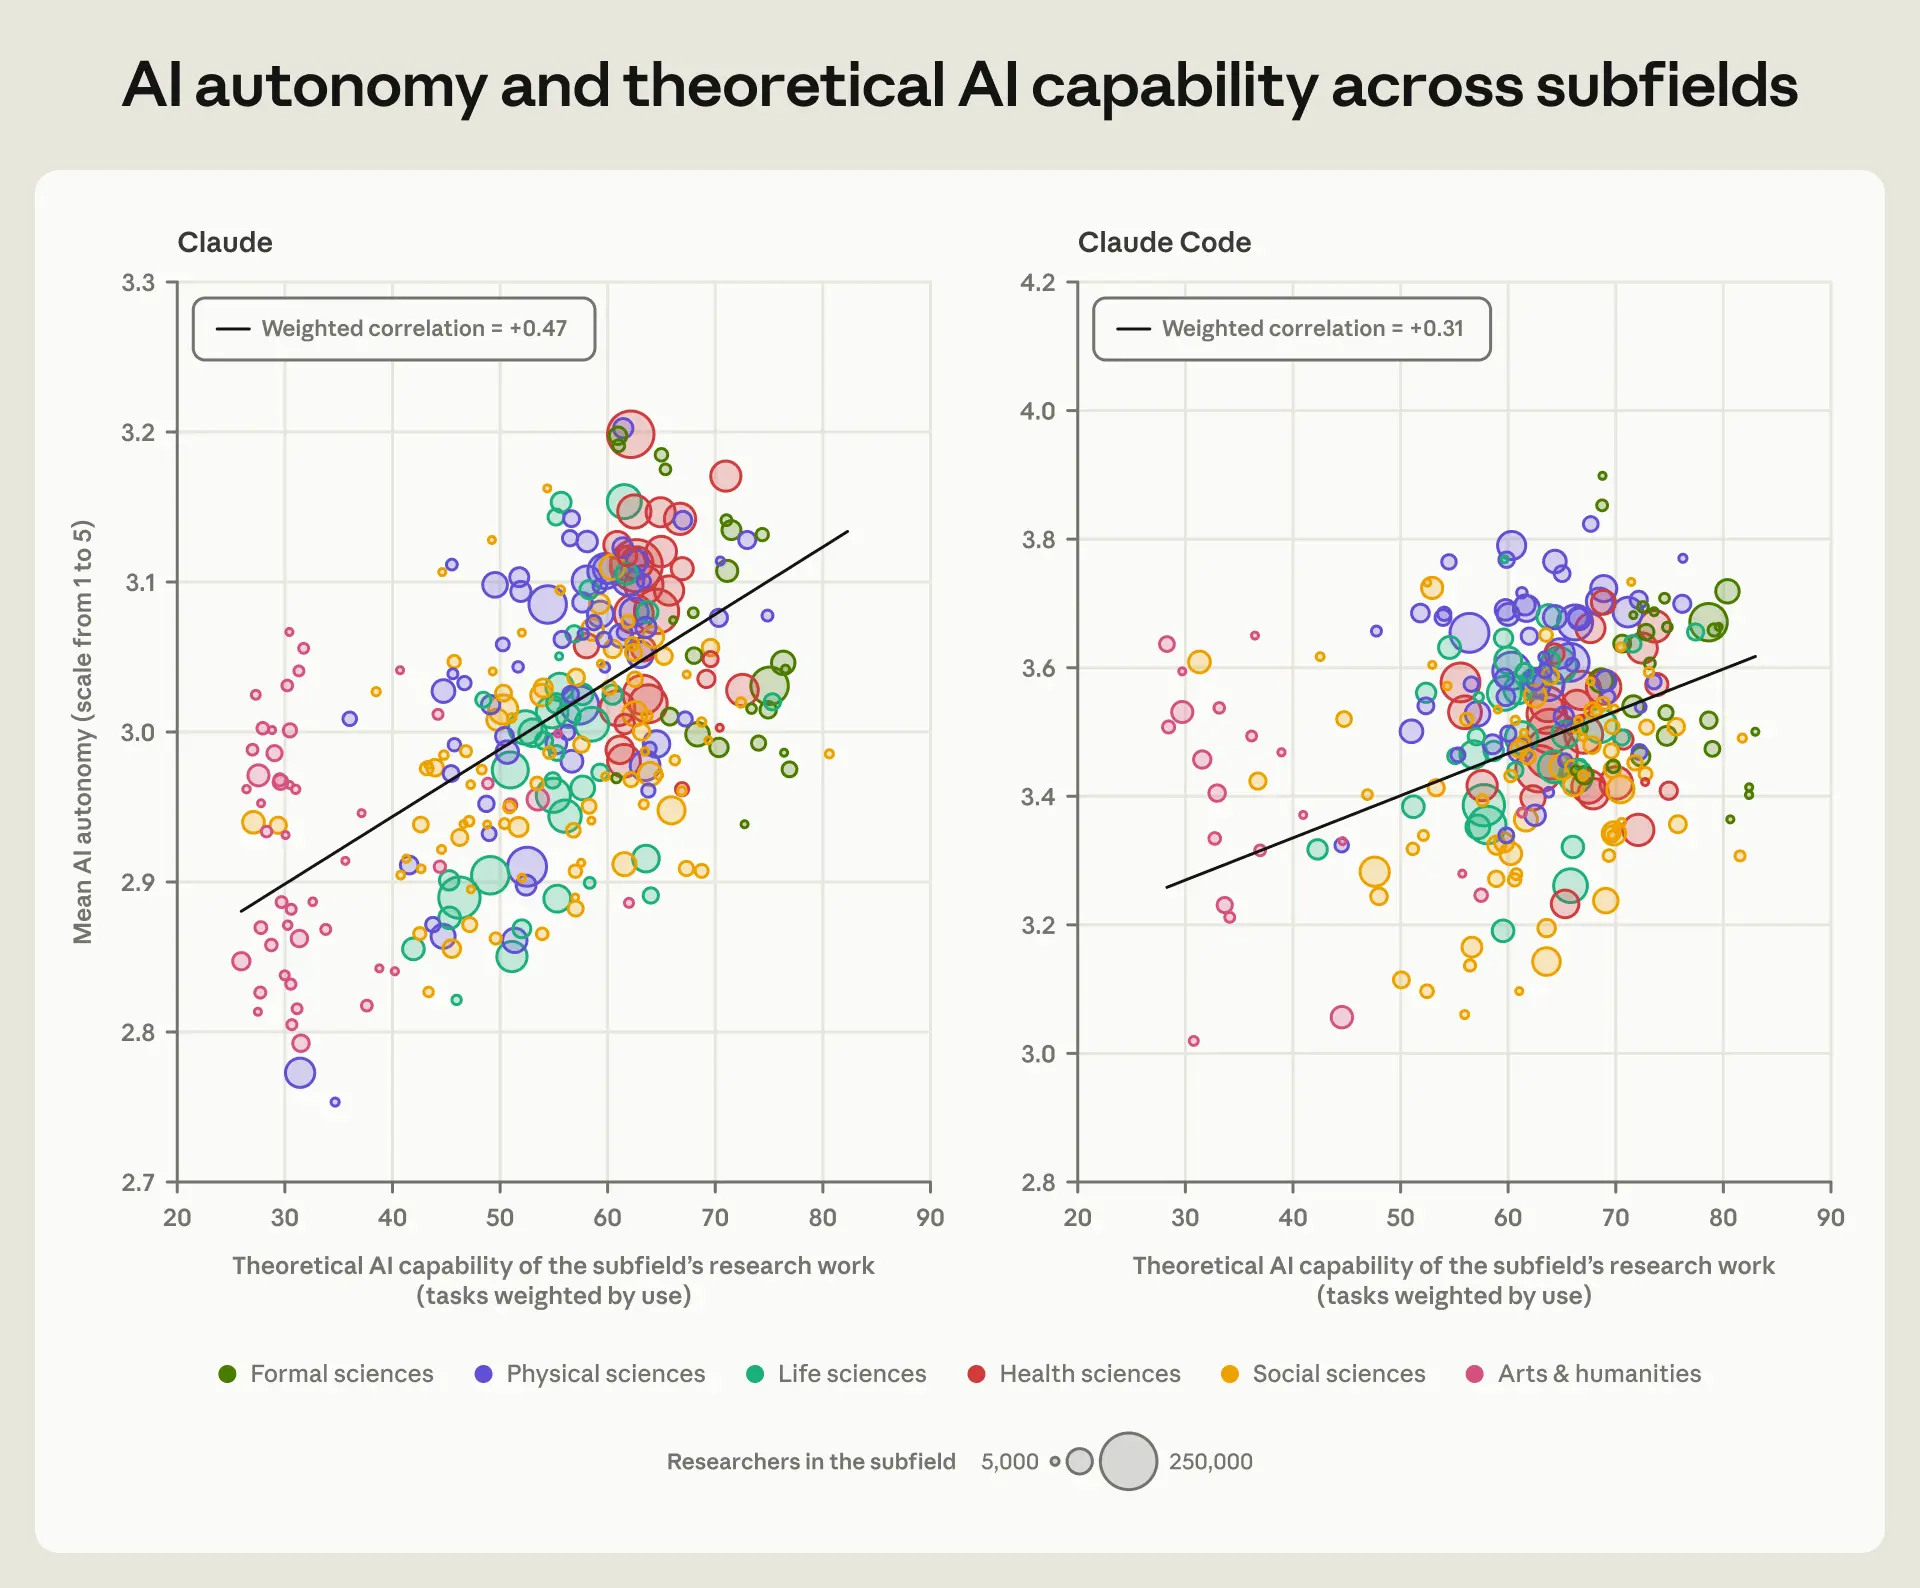
세부 분야별 AI 자율성과 이론적 AI 역량. 두 패널 모두 각 세부 분야를 점으로 나타내며, 점의 크기는 해당 세부 분야의 연구자 수를 뜻합니다. 왼쪽 패널은 Claude의 연구 세션, 오른쪽 패널은 Claude Code의 연구 세션입니다. 세로축은 세부 분야 세션의 평균 자율성 점수로, 세션 수로 가중했습니다. 가로축은 해당 세부 분야 작업의 평균 이론적 역량이며, 이 역시 사용량으로 가중했습니다. 어떤 세션에도 포함되지 않은 작업은 자율성 점수를 매길 수 없으므로 분석에서 제외했습니다. 보기 쉽게 하려고 이상치 세부 분야는 그림에서 뺐지만, 최적 적합선과 상관관계 계산에는 포함했습니다. 상관관계는 세부 분야 규모로 가중했습니다.
AI를 통한 연구 가속 시나리오
과학과 기술이 발전하는 속도는 좋은 아이디어와 이를 추구할 수단에 달려 있습니다. 역사적으로 이 둘은 모두 인간의 능력에 제약을 받아 왔습니다. 연구자의 수는 한정되어 있고, 각자 가설을 세우고, 알맞은 실험을 설계하고, 분석을 수행하고, 결과를 종합할 시간도 한정되어 있습니다.
AI는 두 가지 방식으로 이런 제약을 완화할 수 있습니다. 첫째, 연구자가 지금 하는 일을 대신 맡아 더 많은 아이디어를 추구할 수 있게 해 줍니다. 둘째, 연구자가 스스로는 떠올리지 못했을 아이디어를 내놓을 수 있습니다. 궁극적으로는 둘째가 더 중요할 수 있지만 측정하기가 훨씬 어려워, 이번 분석은 첫째에 초점을 맞췄습니다.
접근 방식
AI를 통한 과학 가속의 시나리오를 세 가지로 설정했습니다. 시나리오 1은 설문과 AI 역량 점수로 추정한 현재 AI 역량이 널리 도입된다고 가정합니다. 시나리오 2와 3은 AI가 물리적이지 않은 연구 단계(SciNet에서 각 연구 작업을 구성하는 개별 행동)의 75% 또는 100%를 완전히 자동화하는 가상의 미래입니다. AI 역량 점수가 가장 높은 단계부터 자동화된다고 봅니다. 세 시나리오 모두 연구자가 물리적 단계는 계속 수행합니다. 이는 예측이 아니라 예시를 위한 시나리오입니다. 물리적 작업, 이론적 AI 역량, AI 비용이 연구 가속에 어떤 영향을 미칠 수 있는지, 그리고 어떤 분야가 가장 크게 가속할 수 있는지를 보여 주기 위한 것입니다.
각 시나리오에서 두 가지 지표를 보고합니다. 첫 번째는 AI 비중으로, 연구자가 한 편의 연구에 쓰는 시간 중 AI가 맡을 수 있는 비율입니다. 연구자들이 현재 시간을 배분하는 방식을 감안할 때, AI가 사람의 연구 시간을 얼마나 절약해 줄 수 있는지를 나타내며, 앞서의 분석에서 곧바로 도출됩니다. 연구자는 이렇게 확보한 시간을 다른 일에 돌려 연구 성과를 늘릴 수 있습니다. 두 번째 지표인 가속 배율은 이 효과를 추정한 값으로, 연구 예산이 같을 때 AI가 없는 경우에 비해 연구 성과가 얼마나 늘어나는지를 나타냅니다. 같은 예산으로 연구 결과를 몇 배 더 낼 수 있는지를 알려 줍니다. 절약한 시간이 성과 증가로 일대일로 이어지지는 않습니다. 연구자들이 AI가 덜 도움이 되는 작업으로 노력을 옮기고, AI에도 비용이 들기 때문입니다.
시나리오 1의 AI 비중은 설문에서 구했습니다. 설문은 AI 사용 수준을 안 씀, 보조, 분담, 위임, 자율의 다섯 단계로 기록합니다. 이 단계가 각각 AI가 특정 작업 단계에서 연구자 시간의 0%, 25%, 50%, 75%, 100%를 맡는 것에 해당한다고 가정했습니다. 각 작업 범주 안에서 작업 단계를 AI 역량 점수 순으로 정렬한 뒤, 설문에서 나타난 비율대로 각 작업 단계에 AI 사용 수준을 배정하고, 높은 수준은 점수가 높은 단계에 줍니다. 예를 들어 아이디어·가설 도출에서는 응답의 17%가 AI를 쓰지 않는다고 답했고 53%가 보조적으로 쓴다고 답했습니다. 따라서 AI 역량 점수가 가장 낮은 아이디어 도출 단계의 17%에는 AI 비중을 0으로, 그다음 53%에는 25%로 배정하는 식으로 단계를 올려 갑니다. 응답자들은 AI를 적극적으로 쓰는 사람일 가능성이 높으므로, 이들이 밝힌 사용 수준을 현재 AI가 할 수 있는 일의 근사치로 봤습니다. 마지막으로 AI 덕분에 절약되는 연구자 시간을 단계에서 분야 수준으로 합산했습니다(부록 참고).
가속 배율을 계산하기 위해서는 연구자 시간 같은 연구 투입 요소가 연구 성과로 바뀌는 과정을 설명하는 표준 경제 모델인 아이디어 생산 함수를 사용했습니다. 이 모델에서 논문 한 편에는 여러 연구 작업이 필요합니다(Jones 2026). 작업들은 서로 보완적이어서 한 작업이 강하다고 다른 작업의 약점을 완전히 메울 수는 없습니다. AI로 일부 작업이 저렴해지면 연구자는 AI가 덜 도움이 되는 작업으로 노력을 옮기게 되고, 이는 전체 성과 증가를 가로막는 병목을 완화합니다. 예를 들어 연구자는 새로운 질문을 구상하는 데 더 많은 시간을 쓰거나, 실증적 증거를 넓히기 위해 물리적 실험을 더 많이 할 수 있습니다. 이런 병목이 전체 성과 증가를 얼마나 제한하는지는 Ahmadpoor와 Jones(2019)를 이용해 보정했습니다. AI 비용은 AI 에이전트의 1시간당 비용을 30달러, 연구자 1시간당 비용을 95달러로 가정하고, AI가 연구자 1시간을 절약할 때마다 0.2시간 가동된다고 가정했습니다. 이는 예시를 위한 가정이며, AI 비용은 현재 공개된 정가를 기준으로 합니다. 아래에서 논의하듯이 이 비용이 작을수록 같은 예산으로 더 많은 연구를 할 수 있어 가속 배율은 커집니다. 모델과 가정은 부록에 설명했습니다.
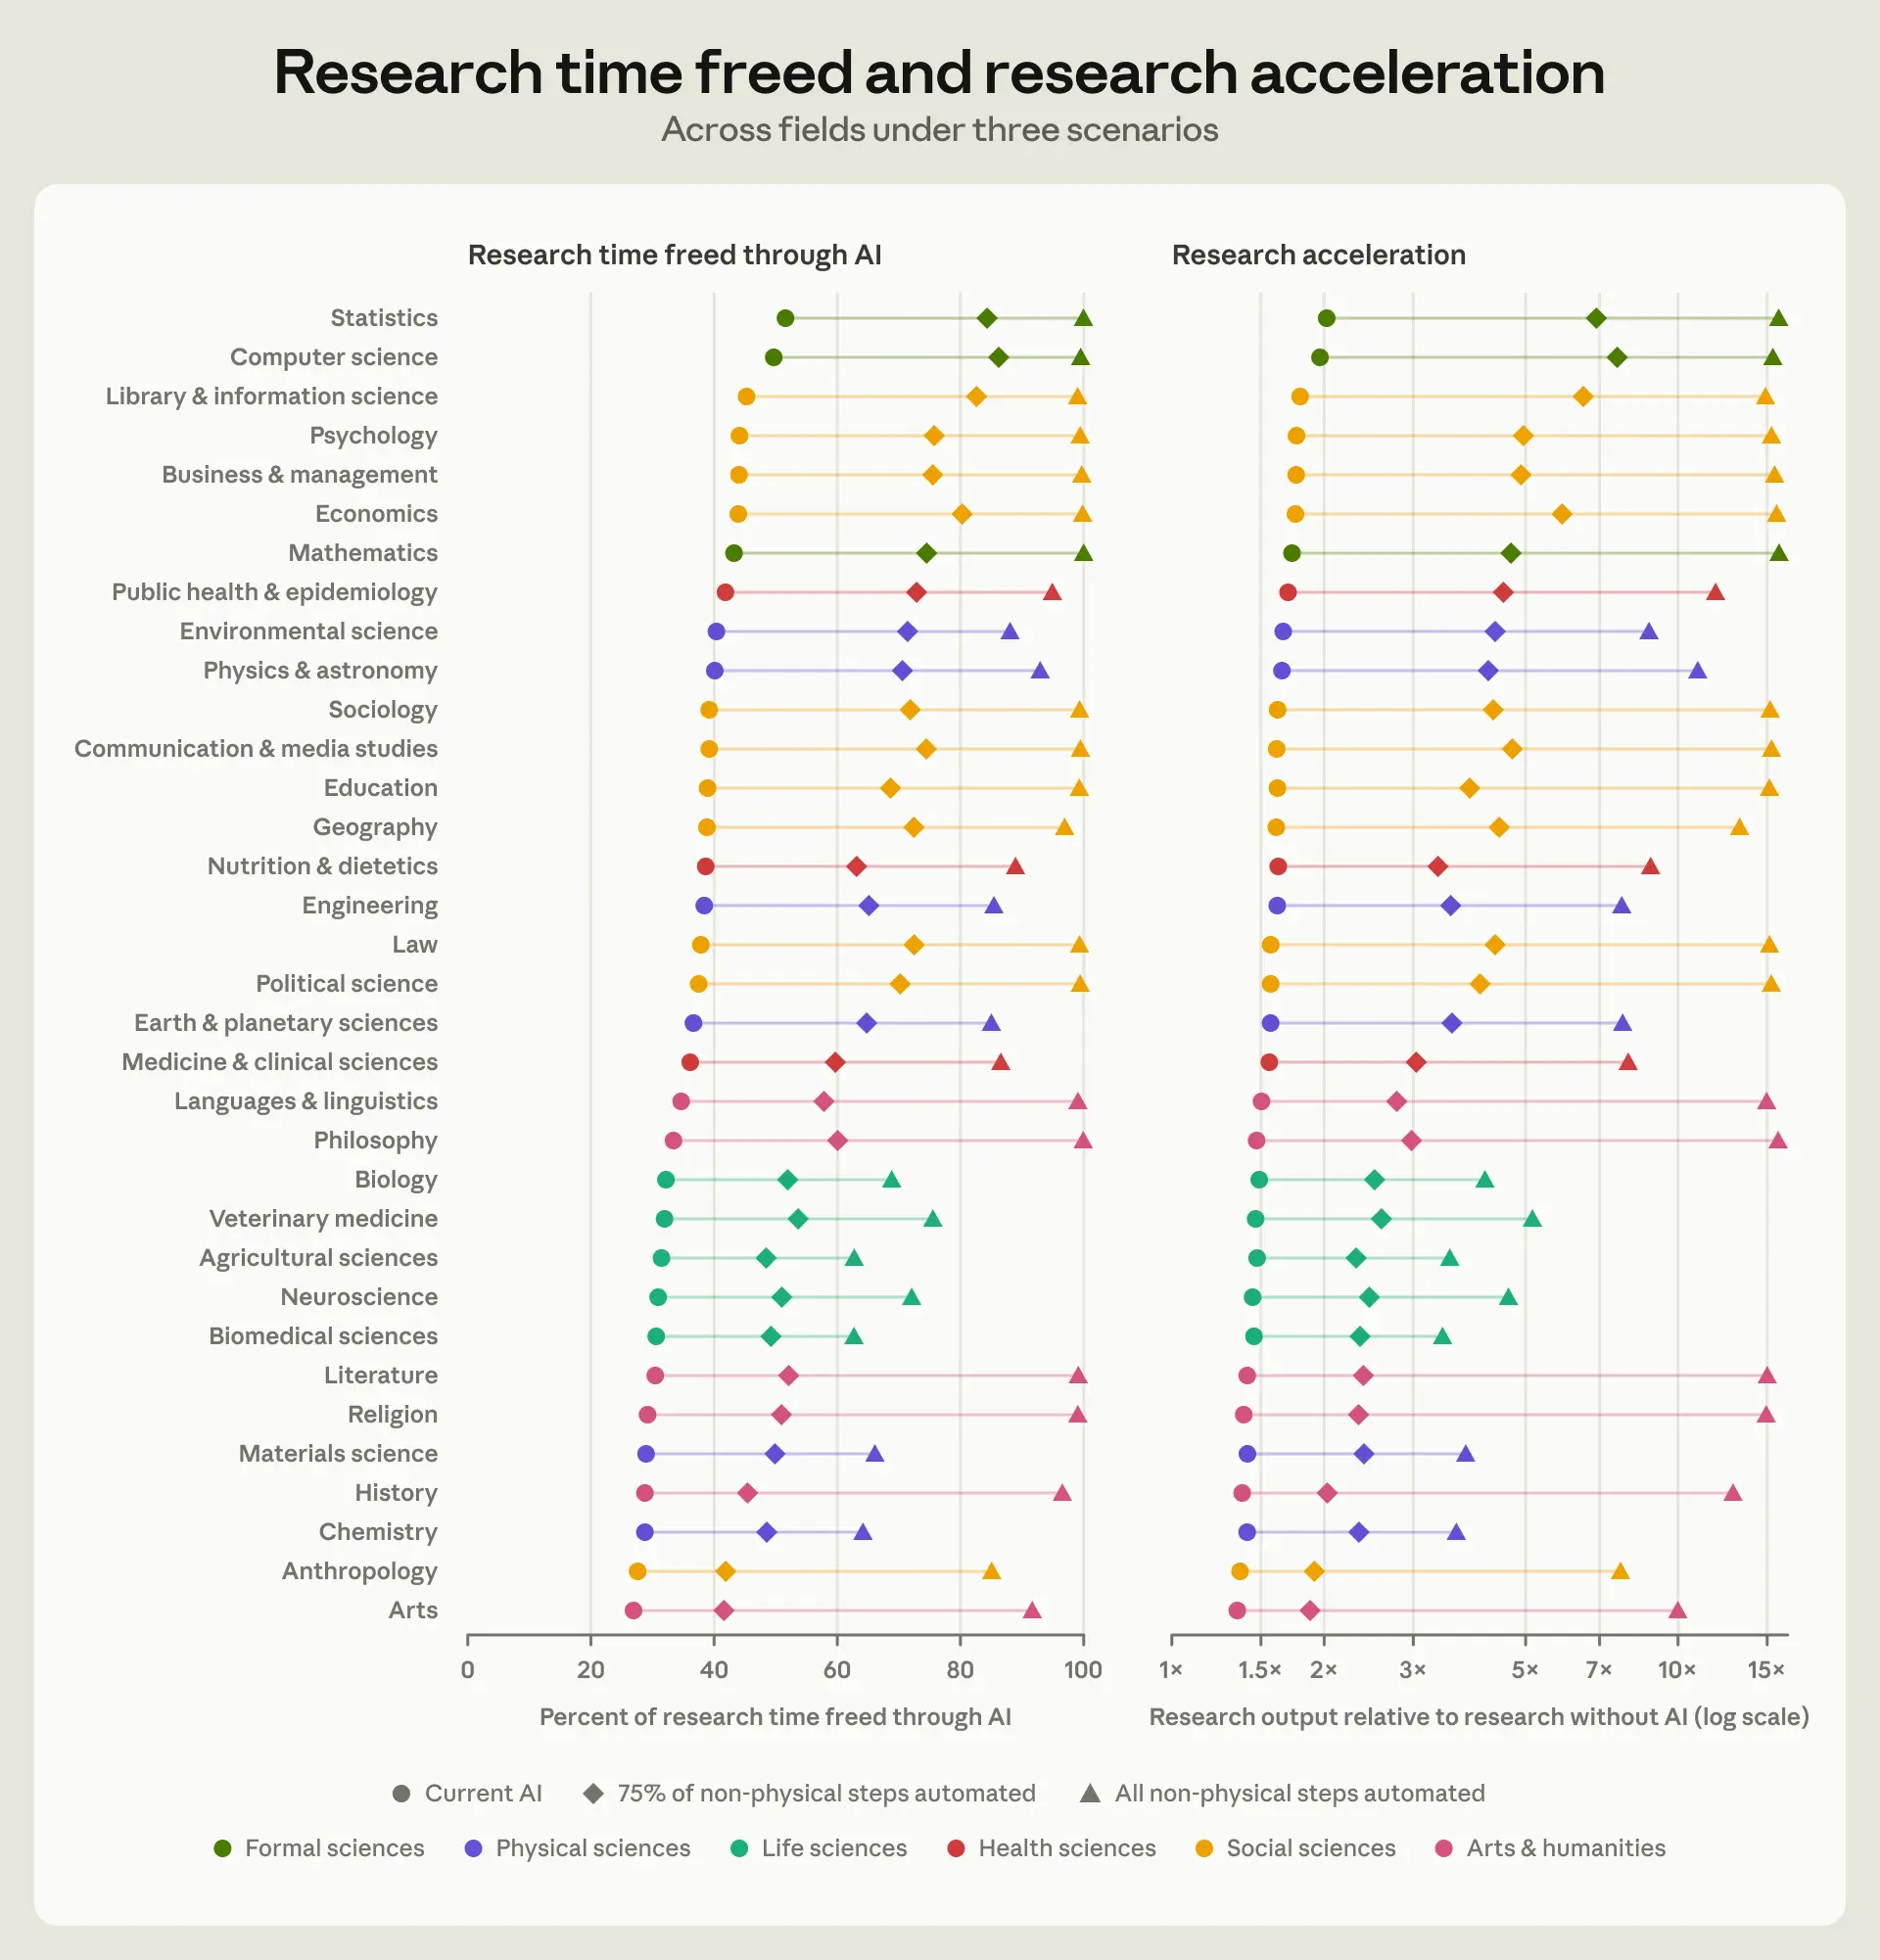
AI로 절약되는 연구 시간과 연구 가속. 각 행은 하나의 분야입니다. 왼쪽 패널은 AI가 맡을 수 있는 연구자 시간의 추정 비중에 따라 분야를 순위별로 보여 줍니다. 원은 현재 역량 기준 추정치, 마름모는 물리적이지 않은 단계의 75%가 자동화될 때 절약되는 시간의 추정 비중, 삼각형은 100%가 자동화될 때의 추정 비중입니다. 오른쪽 패널은 분야별 연구 예산을 고려한 연구 가속을 나타냅니다. 가로축은 세 시나리오에서 AI를 활용한 연구 성과가 AI가 없을 때 성과의 몇 배인지를 보여 줍니다(1배 = 변화 없음).
시나리오 1: 현재 역량
현재 역량이 널리 도입된다면 AI는 새로운 연구 한 편을 내는 데 필요한 연구자 시간의 27~52%를 맡을 수 있으며, 분야별 중앙값은 38%입니다(그림 13 왼쪽 패널). 이 비중에 따른 연구 가속 배율은 예술 1.35배, 인류학 1.36배, 화학 1.41배에서 컴퓨터과학 1.96배, 통계학 2.02배까지 분포합니다(그림 13 오른쪽 패널). 가속 배율이 제한적인 것은 오늘날 AI의 작업이 대부분 자율적이기보다 보조적이거나 분담하는 방식이어서, 연구자가 거의 모든 단계에 여전히 상당한 시간을 쓰기 때문입니다. 작업이 거의 전적으로 인지적이어서 AI에 가장 잘 맞는 분야조차 가속 배율은 약 2배에 그칩니다. 이 추정은 AI가 널리 확산되고, 연구자들이 지금 AI가 유용한 모든 단계에 이를 적용한다고 가정한 것입니다.
분야마다 차이가 나는 이유는 대부분 두 가지 요인으로 설명됩니다. 첫째는 물리적 작업입니다. 물리적 연동 없이는 AI가 맡을 수 없는 일이지요. 농학, 생의학, 화학, 재료과학처럼 실험실이나 현장에서 이뤄지는 분야는 연구자 시간의 38~41%를 물리적 단계에 씁니다. 분야별 중앙값이 4%인 것과 비교하면 매우 높은 수치입니다. 물리적 작업의 비중만으로 AI 비중 차이의 약 3분의 1이 설명됩니다. 둘째는 인지적 작업 안에서 AI 역량 점수가 어떻게 분포하는가입니다. 예술과 역사는 물리적 단계에 쓰는 시간이 적지만(각각 10%, 4%), 인지적 단계의 AI 역량 점수가 낮습니다. 정성적이고 해석적인 작업은 강화학습에 상대적으로 맞지 않기 때문일 수 있습니다. 반면 컴퓨터과학과 통계학은 점수가 높고 AI 비중도 큽니다. 데이터 분석이 큰 몫을 차지하는데, 이는 분야를 통틀어 AI 역량 점수가 가장 높은 작업 유형입니다.
Claude 사용 비율이 높은 분야일수록 AI 비중도 큰 경향이 있습니다(그림 14). AI 비중은 Claude 사용 데이터를 전혀 쓰지 않고 계산한 값이므로, 이 관계는 AI 사용이 이론상의 AI 역량을 따라간다는 또 하나의 근거입니다.
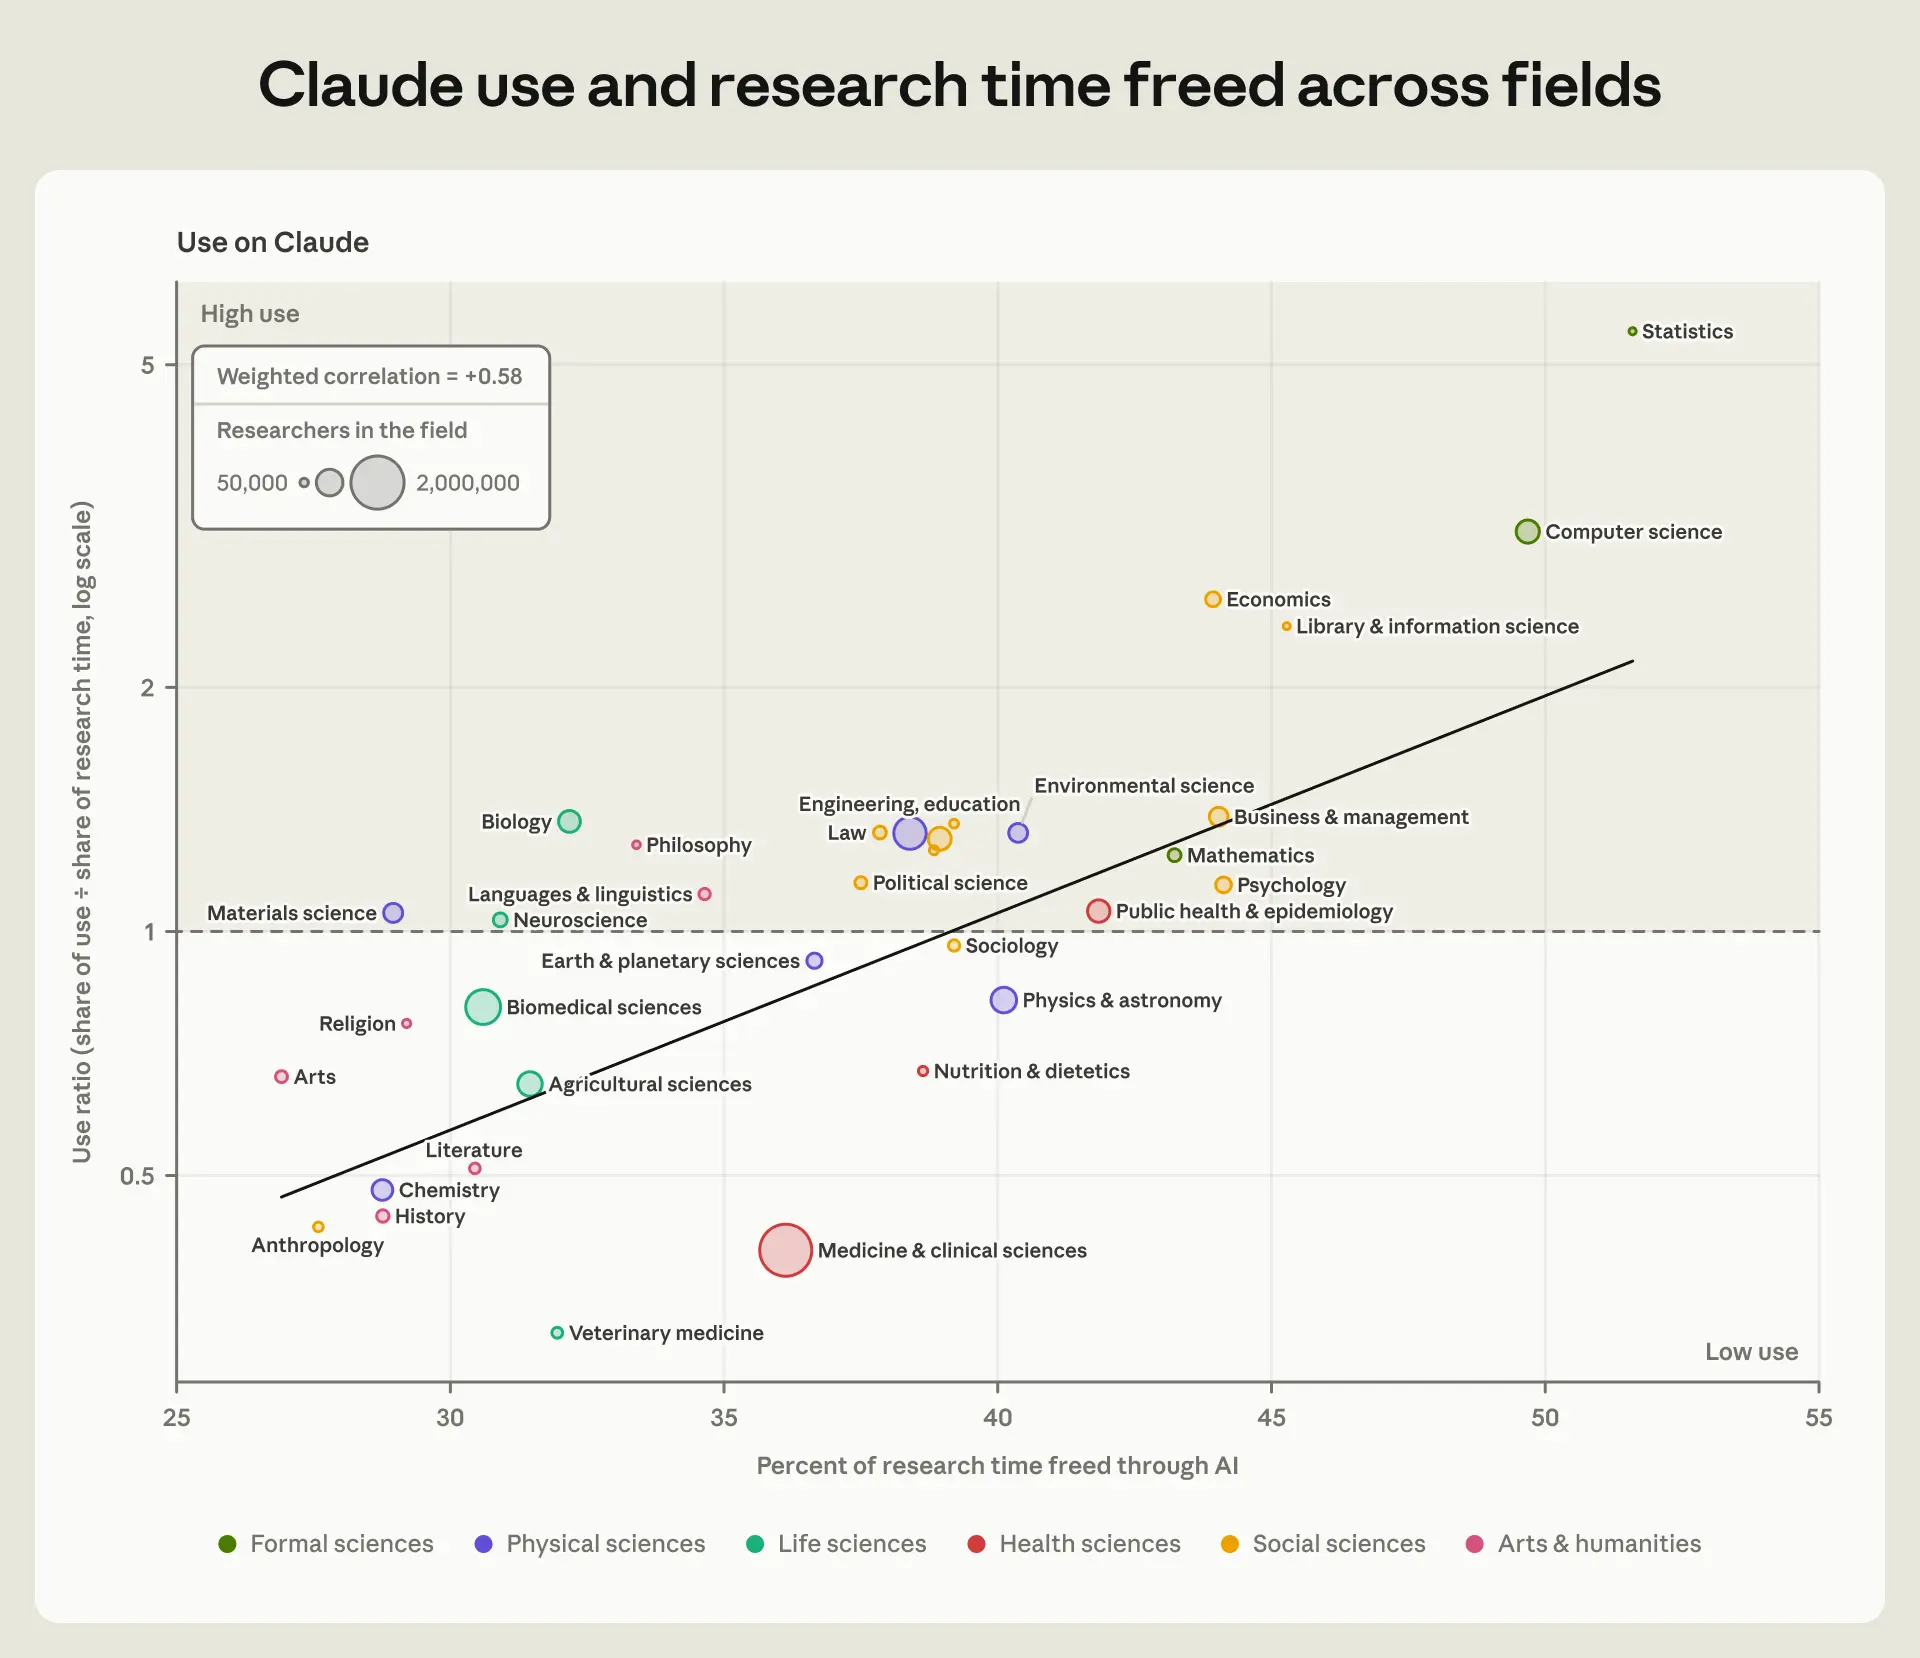
분야별 Claude 사용과 AI로 절약되는 연구 시간. 분야별로 실제 Claude 사용량과 AI 비중 사이의 상관관계를 나타냈습니다. 점 하나가 한 분야이며, 크기는 연구자 수에 비례합니다. 세로축은 해당 분야의 Claude 사용 비율(로그 척도)입니다. 가로축은 현재 역량으로 AI가 대신 해낼 수 있는 연구자 시간의 추정 비중입니다.
시나리오 2와 3: 자동화가 더 진전된 경우
아래 두 시나리오는 AI의 적용 범위와 비용에 대한 가정에 크게 좌우되므로 더 추측에 가깝습니다. 자동화가 더 진전되면 AI 비중과 연구 가속 배율이 모두 가파르게 오르고, 분야 간 격차도 벌어집니다.
물리적이지 않은 단계의 75%를 AI가 맡는 시나리오 2에서는 컴퓨터과학이 약 8배, 통계학과 문헌정보학이 7배, 경제학이 6배까지 가속됩니다. 그 밖의 사회과학 대부분과 수학, 물리학·천문학은 4~5배, 실험 중심 분야와 의학 분야는 약 2~3배에 이릅니다. 실험 중심 분야와 인문·예술 분야는 얻는 이득이 가장 작지만 이유는 서로 다릅니다. 실험 중심 분야는 작업 상당 부분이 물리적이어서 여전히 연구자가 직접 해야 합니다. 인문·예술 분야는 작업 대부분이 인지적이지만 AI 역량 점수가 낮아, 자동화되는 단계가 많지 않습니다. 물리적이지 않은 연구자 시간 가운데 자동화되는 단계의 비중은 컴퓨터과학이 82%인 데 비해 예술은 28%에 그칩니다. 역사학, 인류학, 예술은 가속 배율이 약 2배 이하입니다.
시나리오 3에서는 인문·예술 분야가 앞서 나가는 반면 실험 중심 분야는 계속 뒤처집니다. 물리적이지 않은 단계를 AI가 모두 자동화하면 낮은 AI 역량 점수가 더는 인지적 작업의 걸림돌이 되지 않고, 많은 분야에서 AI가 연구 작업 거의 전부를 맡을 수 있습니다(그림 13 왼쪽 패널). 이 추측성 시나리오에서 통계학, 컴퓨터과학, 경제학, 수학, 심리학, 그리고 대부분의 사회과학과 인문·예술처럼 물리적 작업이 적은 분야는 약 15~16배에 이릅니다. 반면 생물학, 화학, 재료과학, 농학, 생의학처럼 실험실이나 현장 작업이 많은 분야는 3~4배에 그칩니다. 자동화된 실험실이 없다면 연구자 시간의 약 40%를 차지하는 물리적 단계가 계속 병목으로 남기 때문입니다.
이 시나리오에서 두 가지 교훈을 얻을 수 있습니다. 첫째, 물리적 병목의 영향력은 여전히 강력합니다. 물리적 연동 없이는 AI가 수행할 수 없는 단계가 연구자의 시간과 예산에서 대부분을 차지하게 되어 가속 배율에 상한을 둡니다. 둘째, 그런 병목이 없는 분야에서는 비약적인 속도의 발전이 가능해지고, 이때는 AI 비용이 한계로 작용합니다. 이 분석의 가정에서는 AI가 완전히 자동화한 작업이라도 연구자가 직접 할 때 드는 비용의 약 16분의 1이 듭니다. 그래서 가속 배율은 약 16배에 가까워지다가 거기서 멈춥니다. AI 비용이 낮아지면 이 상한도 비례해서 올라가, 예컨대 비용이 절반이 되면 발전 속도는 두 배가 됩니다. AI가 나중에 자동화하는 더 어려운 작업까지 포함해 비용이 크게 떨어진다면, 물리적 병목이 없는 분야는 이 추정치를 훌쩍 넘어 가속할 수 있습니다.
이 계산에는 결과를 양쪽 방향으로 바꿀 수 있는 중요한 한계가 있습니다. 먼저 연구팀이 아니라 분야 차원에서 작용하는 제약은 고려하지 않았습니다. 예를 들어 대형 강입자 충돌기 같은 시설에서는 돌릴 수 있는 실험 수에 한계가 있습니다. 또 연구자와 AI의 시간 비용만 계산하고, 보건·물리·생명과학에서 상당할 수 있는 장비나 실험 재료 비용은 반영하지 않았습니다. 물리적 실험을 시뮬레이션으로 대체할 가능성도 다루지 않았는데, 이는 일부 분야의 병목을 완화할 수 있습니다. 마지막으로 아이디어의 질도 고려하지 않았습니다. AI가 성공 확률이 더 높은 가설을 찾아낸다면 연구는 더 빨라질 수 있고, 연구 감각(research taste)이 끝까지 인간 고유의 영역으로 남는다면 가속은 더 느려질 것입니다.
연구자들의 전망
위 시나리오는 가능한 범위를 보여 줄 뿐입니다. 연구자 본인의 전망은 전문성에 뿌리를 둔 독자적인 지표가 될 수 있습니다. 이들의 견해를 알아보기 위해 생명과학·보건과학 연구자 대상 설문에서 연구 작업 범주별로, AI가 단독으로 자신의 분야 최고 연구자에 필적하는 시점이 언제일지 물었습니다(그림 15). 가까운 미래에 대한 기대는 높습니다. 응답자의 절반 이상이 2027년까지 AI가 데이터 분석에서 최고 연구자에 필적하리라 예상했고, 38%는 이미 그 수준에 도달했다고 답했습니다. 2030년까지는 94%가 데이터 분석, 89%가 글쓰기, 72%가 아이디어 구상과 데이터 수집에서 각각 AI가 최고 연구자에 필적하리라 예상합니다. 아이디어 구상과 데이터 수집에 대한 기대는 상대적으로 낮은데, 오늘날 이 작업에서 Claude 사용이 적은 것과 일치합니다.
사람이 개입하지 않는 AI의 종단간(end-to-end) 연구에 대한 전망은 더 보수적이지만, 연구자들은 그래도 놀라운 진전을 예상합니다. 응답자의 약 40%는 2030년까지, 약 64%는 2035년까지 AI가 연구 프로젝트 전체를 수행하리라 보지만, 16%는 그런 일이 결코 일어나지 않으리라 답했습니다. AI가 과학적 돌파구를 자율적으로 만들어 낼 것이라는 기대는 더 신중합니다. 연구자의 약 절반은 이 일이 일어난다 해도 2035년 이후일 것으로 봅니다. 전반적으로 많은 연구자가 향후 10년 안에 높은 수준의 자동화를 예상하며, 이는 자동화가 더 진전된 시나리오와 대체로 맞닿아 있습니다. 이런 기대가 얼마나 빠르게, 어느 정도까지 실현될지는 소프트웨어 기술로서의 AI 발전뿐 아니라 물리적 장벽을 넘어서는 자동화 실험실 구축 노력에도 달려 있습니다.
과거 설문 결과를 실제 성과와 비교해 보면, AI 발전은 번번이 크게 과소평가되어 왔습니다(Rosenberg et al. 2026). 예를 들어 2022년 중반 설문에서 AI가 국제수학올림피아드 금메달 수준에 도달하는 시점의 중앙값 추정치는 해당 분야 전문가가 2030년, 슈퍼포캐스터가 2035년이었습니다(Karger et al. 2023). 그러나 AI는 2025년에 이 이정표를 달성해, 예측보다 5~10년가량 앞섰습니다. 예측가들은 AI 역량의 발전을 일관되게 과소평가했지만, 생물학의 AI 보조 실험 작업처럼 물리적 세계에서의 실행이 필요한 분야를 중심으로 몇 가지 예외도 있습니다.
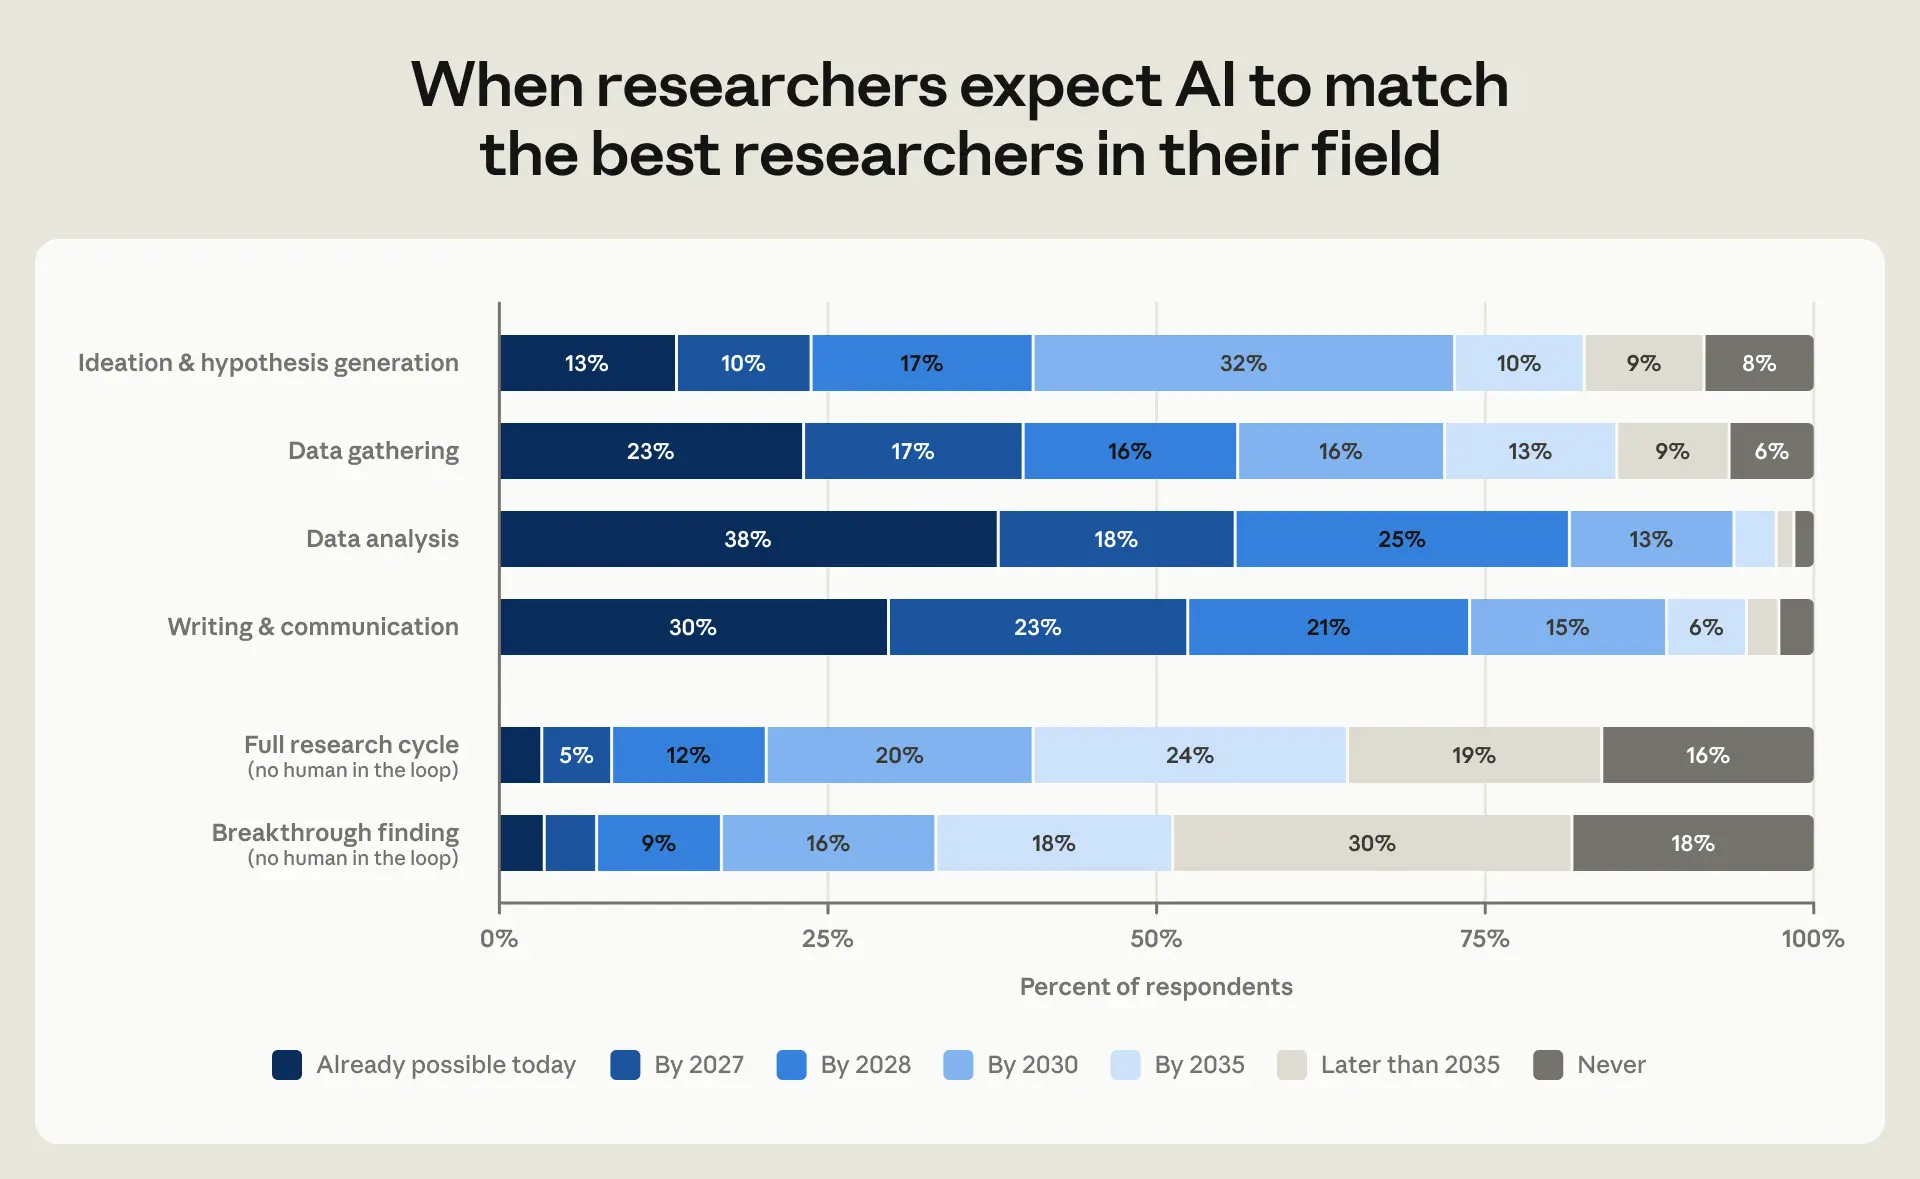
연구자들이 AI가 자기 분야 최고 연구자에 필적하리라 예상하는 시점. 결과는 자체 설문에서 얻었습니다. 위쪽 네 행은 연구자들이 작업 범주별로 AI가 단독으로 자기 분야 최고 연구자에 필적하리라 예상하는 시점입니다. 아래쪽 두 행은 인간 과학자의 개입 없이 AI가 각자의 분야에서 '질문에서 발견까지' 해내는 시점과 '해당 분야에서 중대한 진전으로 여길 만한 발견'을 내놓는 시점에 대한 예상입니다.
논의
AI가 과학적 발견을 앞당긴다면 생활 수준 향상과 질병 치료 속도 단축에 기여할 수 있습니다. 이번 추정에 따르면 잠재적 이득은 상당합니다. 하지만 AI의 연구 역량이 발전한다고 해서 저절로 빠른 진보로 이어지지는 않으며, 이런 가속을 이루려면 몇 가지 제약에 어떻게 대응하느냐도 중요합니다.
첫째, 도입 속도가 역량 발전 속도를 크게 따라가지 못할 수 있습니다. 새로운 기술의 확산은 대체로 느리고(Comin and Hobijn 2010), 생산성 향상은 조직이 그 기술에 맞춰 재편된 뒤에야 나타나는 경향이 있습니다(David 1990; Brynjolfsson, Rock, and Syverson 2021). 개인의 학습 과정, 조직·시스템 차원의 마찰, AI 접근성이나 인프라의 제약이 모두 도입을 늦출 수 있습니다.
둘째, AI가 해소하지 못하는 병목이 연구에 계속 남을 수 있습니다. 비용과 시간이 많이 드는 물리적 실험은 AI가 아무리 뛰어나도 진보를 크게 제약할 수 있습니다. 위 시나리오에서도 특히 실험 중심 분야에서 이런 모습이 나타납니다. 무엇을 연구할지 정하는 일도 또 다른 병목일 수 있습니다. 연구의 가치는 대체로 연구 질문이 결정하는데, AI가 좋은 질문을 만들어 낼 수 있을지는 아직 불분명합니다. 아이디어 구상이 병목이라면 주어진 질문에 답하는 비용이 크게 줄어도 가속에는 한계가 생깁니다. 반대로 AI가 고품질 가설을 세우는 데서 인간을 앞선다면, 특히 가설 검증 비용이 큰 분야에서는 가속이 훨씬 커질 수 있습니다.
셋째, AI 기반 연구는 연구 성과의 양을 늘릴 수도, 질을 높일 수도 있으며 과학에 미치는 영향은 서로 다릅니다. 새 논문이 쏟아지면 분야가 더 빨리 발전할 수도 있지만, 과학자들이 결과를 소화하고 검증할 역량을 넘어설 수도 있습니다. 한편 현미경과 망원경에서 통계 소프트웨어에 이르기까지 새로운 기술은 역사적으로 과학적 통찰의 질을 높여 왔고, AI도 더 포괄적인 분석과 더 야심 찬 프로젝트를 가능하게 할 수 있습니다. 논문 작성이 쉬워질수록 연구 커뮤니티는 특히 참신하거나 질 높은 연구를 더 높이 평가하게 될지도 모릅니다. 더 효율적인 연구가 양의 확대로 이어질지 질의 향상으로 이어질지는 연구자의 선택과 학술지·연구비 지원 기관·연구 기관이 마련하는 인센티브에 달려 있습니다.
넷째, 연구가 조직되는 방식이 예측하기 어려운 쪽으로 바뀔 수 있습니다. AI가 더 유능해지고 자율성이 높아지면 AI 시스템이 검증, 심사, 주요 결과의 전달을 주도하게 되어 앞서 말한 소화 문제가 완화될 수 있습니다. 더 먼 미래에는 AI 연구 에이전트가 로봇공학과 자동화 실험실을 활용해, 인간과 무관하게 자체적인 대규모 커뮤니티를 이루어 과학의 최전선을 넓힐 수도 있습니다. 이런 자율적인 AI 연구는 인간이 새로운 지식을 어떻게 파악하고, 이해할 수 있으며, 그 지식이 어떻게 만들어지는지에 대한 의문을 낳을 것입니다.
다섯째, AI 시스템의 자율성이 높아질수록 AI 주도 연구가 인간의 목표에서 벗어나지 않도록 하기가 더 어려워질 수 있습니다. AI 에이전트가 더 강력하고 창의적으로 되어 가는 만큼, 어떤 질문을 어떻게 탐구할지 같은 핵심 연구 결정에 사람이 계속 관여하는 것이 안전과 인간의 복지를 위해 중요할 수 있습니다. 발견 자체나 연구의 부산물이 위험을 안길 수도 있습니다. 특히 생물학에서는 의학 발전을 앞당기는 바로 그 역량이 위험한 지식이나 물질을 만들어 낼 수도 있습니다. 이런 경우에는 연구 과정에 의도적인 점검 지점을 두는 것이 타당할 수 있으며, 위험을 줄이기 위해 더딘 진보를 감수해야 할 수도 있습니다.
마지막으로, 연구자가 하는 일 자체가 크게 달라질 수 있습니다. 그 영향 중 하나가 연구자의 직무 만족도 변화입니다. AI가 즐겁거나 보람 있는 작업을 가져가면 만족도가 떨어지고 연구직을 택하는 사람도 줄 수 있습니다. 반대로 연구자가 지루해하는 작업을 AI가 맡는다면 만족도는 오를 수 있습니다. 행정 업무가 그 후보 중 하나입니다. 미국에서 연방 정부 지원 프로젝트의 연구책임자들은 연구 시간의 약 44%를 연구가 아닌 행정 요건 충족에 쓴다고 답했습니다(Schneider et al. 2020). 이 부담을 덜어 주면 시간을 아끼고 전반적인 만족도도 높일 수 있어 큰 도움이 될 것입니다. 결국 순효과는 불확실하며 AI의 역량이 발전함에 따라 달라질 수 있습니다. 낙관적으로 보면 AI는 발견의 기회를 넓힐 것이고, 발견은 연구직을 보람 있게 만드는 핵심입니다. 과학이 '끝없는 프런티어'를 향한 항해라면, AI는 연구자들이 방대한 연구 질문과 발견의 바다를 더 멀리 건너게 해 줄 새로운 배일지 모릅니다.
부록
참고문헌
Ahmadpoor, Mohammad and Benjamin F. Jones, “Decoding Team and Individual Impact in Science and Invention,” Proceedings of the National Academy of Sciences, 2019, 116 (28), 13885–13890.
Alamos, Cristian and Lukas Althoff, “SciNet: The Anatomy of Science,” dataset, 2026. https://www.anatomyofscience.com/
Amodei, Dario, “Machines of Loving Grace: How AI Could Transform the World for the Better,” essay, October 2024. https://darioamodei.com/essay/machines-of-loving-grace
Anthropic, “Learning More about Claude’s Mathematical Capabilities,” research post, August 10, 2026a. https://www.anthropic.com/research/riemann-zeta
Anthropic, “Formalizing Fermat’s Last Theorem,” research post, September 4, 2026b. https://www.anthropic.com/research/formalizing-fermats-last-theorem
Appel, Ruth et al., “Anthropic Economic Index Report: Economic Primitives,” research post, January 15, 2026. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Brynjolfsson, Erik, Daniel Rock, and Chad Syverson, “The Productivity J-Curve: How Intangibles Complement General Purpose Technologies,” American Economic Journal: Macroeconomics, 2021, 13 (1), 333–372.
Bush, Vannevar, Science, the Endless Frontier: A Report to the President, Washington, DC: United States Government Printing Office, 1945.
Codreanu, Mihai et al., “AI in Science: Early Insights,” arXiv preprint arXiv:2609.28504, 2026. https://arxiv.org/abs/2609.28504
Comin, Diego and Bart Hobijn, “An Exploration of Technology Diffusion,” American Economic Review, 2010, 100 (5), 2031–2059.
David, Paul A., “The Dynamo and the Computer: An Historical Perspective on the Modern Productivity Paradox,” American Economic Review, 1990, 80 (2), 355–361.
Eloundou, Tyna et al., “GPTs Are GPTs: Labor Market Impact Potential of LLMs,” Science, 2024, 384 (6702), 1306–1308.
Guo, Daya et al., “DeepSeek-R1 Incentivizes Reasoning in LLMs through Reinforcement Learning,” Nature, 2025, 645 (8081), 633–638.
Hao, Qianyue et al., “Artificial Intelligence Tools Expand Scientists’ Impact but Contract Science’s Focus,” Nature, 2026, 649 (8099), 1237–1243.
Jones, Benjamin F., “Artificial Intelligence in Research and Development,” in Ajay Agrawal, Erik Brynjolfsson, and Anton Korinek, eds., The Economics of Transformative AI, Chicago: University of Chicago Press, 2026, 37–61.
Jumper, John et al., “Highly Accurate Protein Structure Prediction with AlphaFold,” Nature, 2021, 596 (7873), 583–589.
Karger, Ezra et al., “Forecasting Existential Risks: Evidence from a Long-Run Forecasting Tournament,” Forecasting Research Institute Working Paper 1, 2023. https://forecastingresearch.org/research/existential-risk-persuasion-tournament
Kobak, Dmitry et al., “Delving into LLM-Assisted Writing in Biomedical Publications through Excess Vocabulary,” Science Advances, 2025, 11 (27), eadt3813.
Lambert, Nathan et al., “Tülu 3: Pushing Frontiers in Open Language Model Post-Training,” arXiv preprint arXiv:2411.15124, 2024. https://arxiv.org/abs/2411.15124
Liang, Weixin et al., “Quantifying Large Language Model Usage in Scientific Papers,” Nature Human Behaviour, 2025, 9 (12), 2599–2609.
Liu, Yinhong et al., “Aligning with Human Judgement: The Role of Pairwise Preference in Large Language Model Evaluators,” in Proceedings of the First Conference on Language Modeling (COLM), 2024.
Mantiuk, Rafał K., Anna Tomaszewska, and Radosław Mantiuk, “Comparison of Four Subjective Methods for Image Quality Assessment,” Computer Graphics Forum, 2012, 31 (8), 2478–2491.
Massenkoff, Maxim et al., “Anthropic Economic Index Report: Cadences,” research post, June 26, 2026. https://www.anthropic.com/research/economic-index-june-2026-report
Merchant, Amil et al., “Scaling Deep Learning for Materials Discovery,” Nature, 2023, 624 (7990), 80–85.
OpenAI, “An OpenAI Model Has Disproved a Central Conjecture in Discrete Geometry,” research post, May 20, 2026a. https://openai.com/index/model-disproves-discrete-geometry-conjecture/
OpenAI, “On the Navier–Stokes Millennium Prize Problem,” research post, September 8, 2026b. https://openai.com/index/navier-stokes-solution/
Parshall, Daniel and Andrea Lopez-Luzuriaga, “Measuring AI’s Economic Reach: A Multi-Dimensional Task Taxonomy,” George Washington University Center for Economic Research Working Paper 2026-005, 2026. https://www2.gwu.edu/~forcpgm/2026-005.pdf
Robinson-Garcia, Nicolas et al., “Meta-Research: Task Specialization Across Research Careers,” eLife, 2020, 9, e60586.
Rosenberg, Josh et al., “How Accurate Have AI Progress Forecasts Been So Far?” research post, Forecasting Research Institute, September 22, 2026. https://forecastingresearch.org/research/ai-progress-accuracy-update
Schneider, Sandra L. et al., “2018 FDP Faculty Workload Survey: Report of Primary Findings,” Federal Demonstration Partnership, 2020. https://thefdp.org/wp-content/uploads/FDP-FWS-2018-Primary-Report.pdf
Shah, Nihar B. et al., “When Is It Better to Compare than to Score?” arXiv preprint arXiv:1406.6618, 2014. https://arxiv.org/abs/1406.6618
Tomei, Philip Moreira and Bouke Klein Teeselink, “What Jobs Can AI Learn? Measuring Exposure by Reinforcement Learning,” arXiv preprint arXiv:2605.02598, 2026. https://arxiv.org/abs/2605.02598
Tsoukalas, George et al., “Advancing Mathematics Research with AI-Driven Formal Proof Search,” Science, 2026, 394 (6820), 234–239.
Varadi, Mihaly et al., “AlphaFold Protein Structure Database in 2024: Providing Structure Coverage for over 214 Million Protein Sequences,” Nucleic Acids Research, 2024, 52 (D1), D368–D375.
Wang, Hanchen et al., “Scientific Discovery in the Age of Artificial Intelligence,” Nature, 2023, 620 (7972), 47–60.