Philipp Schmid블로그
에이전트의 도구가 곧 하나로 모인다: exec(code)
에이전트는 더 이상 턴마다 도구를 하나씩 호출하지 않습니다. 도구 목록 전체를 exec(code)라는 단일 도구로 통합하고, 격리된 샌드박스 안에서 작업을 연결하고 걸러내며 완료될 때까지 기다리는 방식으로 옮겨가고 있습니다.
지난 2년 동안 유능한 에이전트를 만든다는 것은 곧 도구를 설계하는 일이었습니다. 어떤 동작이 모델의 작업 수행에 도움이 되는지 파악하고, 각 도구 스키마를 얼마나 세분화할지 정하고, 시스템 지시문 템플릿을 반복해서 다듬어야 했죠. 이제 흐름이 바뀌고 있습니다. 에이전트는 오히려 반대 방향으로, 도구 목록 전체를 도구 하나로 통합하는 쪽으로 나아가고 있습니다. 바로 exec입니다.
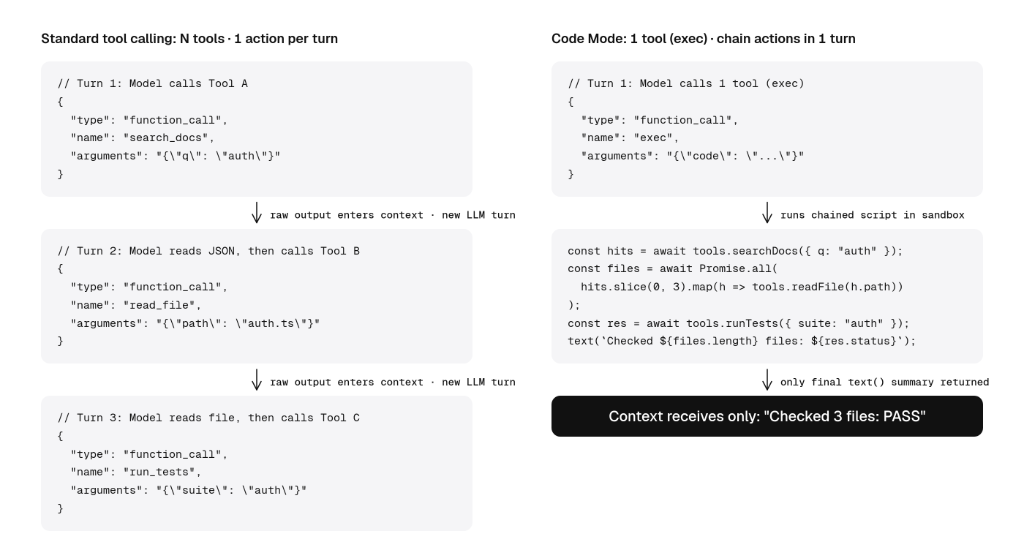
이 방식을 Code Mode⟧(또는 Programmatic Tool Calling)라고 부릅니다. 모델이 턴마다 도구를 하나씩 호출하게 하는 대신, 하네스가 exec(code) 도구 하나만 제공합니다. 모델은 짧은 TypeScript 또는 Python 스크립트를 작성하고, 이 스크립트가 격리된 샌드박스 안에서 작업을 연결하고 조합하며 완료될 때까지 기다립니다.
단일 작업 호출에서 코드로 워크플로를 연결하는 방식으로
에이전트가 왜 exec 도구 하나로 수렴하는지 이해하려면 도구 호출이 어떻게 발전해 왔는지 살펴봐야 합니다.
처음에는 에이전트에 소수의 도구만 줄 수 있었습니다. 큰 도구 목록에서 알맞은 도구를 안정적으로 고르고 걸러내지 못했기 때문입니다. 모델이 발전하면서 수십 개의 도구나 MCP 서버를 연결하게 됐지만, 이번에는 컨텍스트 윈도우 한계에 부딪혔습니다. 이 문제는 도구 검색과 점진적 공개(progressive disclosure)로 풀었습니다. 에이전트가 필요할 때 도구를 찾아보게 한 것입니다.
하지만 도구를 동적으로 불러오더라도 개별 도구는 여전히 수십 개였고, 표준 도구 호출의 한계도 그대로였습니다. 바로 턴당 작업이 하나뿐이라는 점입니다.
표준 도구 호출에서 모델은 단일 작업(기껏해야 파일 세 개를 읽는 것처럼 서로 독립적인 호출을 나열한 일괄 처리)을 정의하는 구조화된 객체(대개 JSON)를 생성합니다. 그리고 원본 출력이 돌아오기를 기다렸다가 프롬프트 히스토리에 추가하고, 다시 추론해서 다음 행동을 정합니다.
제 경험상 최근 들어 모델이 서로 의존하는 작업을 한 번에 조합하고 연결하는 신뢰도가 크게 도약했습니다.
- 리서치와 필터링: 1턴에 출처 목록을 가져오고, 2턴에 읽고, 3턴에 교차 검증하는 대신, 모델이 스크립트 하나로 출처를 조회하고 관련 없는 결과를 걸러낸 뒤 정확한 답을 추출할 수 있습니다.
- 다중 파일 수정과 인라인 검증: 표준 편집 도구는 보통 호출 한 번에 파일 하나만 다룹니다. Code Mode에서는 모델이 여러 파일에 걸친 변경을 한꺼번에 적용하고, 검증을 실행하고, 출력을 확인하고, 통과 여부에 따라 분기하는 일까지 같은 스크립트 안에서 처리할 수 있습니다.
- 브라우저 및 컴퓨터 사용: UI 자동화에서는 버튼 클릭, 폼 입력, 셀렉터 대기, 반복문으로 표 페이지 넘기기처럼 작업 순서가 뻔한 경우가 많습니다. 클릭이나 키 입력마다 모델을 한 번씩 왕복하는 비용을 치르는 대신, 모델이 전체 순서나 반복을 한 턴에 스크립트로 작성하고 페이지 상태가 바뀔 때만 결과를 돌려받을 수 있습니다.
- 병렬 팬아웃과 서브 에이전트: 조회 20건을 실행하거나, 전문 서브 모델을 병렬로 호출해 그 출력을 두 번째 API에 넘겨야 할 때, 모델은
await Promise.all(...), 배열을 변환하고 다음 함수를 호출할 수 있습니다. 단계마다 LLM 컨텍스트 윈도우를 왕복할 필요가 없습니다.
여러 변화가 맞물리면서 이런 방식이 가능해졌습니다. 최신 프런티어 모델은 코드를 집중적으로 학습했고, 일부 제공업체는 Code Mode에 맞춘 사후 학습(post-training)도 시작했습니다. 동시에 MCP 서버도 inputSchema와 함께 outputSchema를 제공하는 경우가 늘고 있습니다. 덕분에 모델은 반환 타입을 미리 알 수 있고, 런타임 출력을 확인하기 전에 같은 스크립트 안에서 도구 A를 도구 B에 연결할 수 있습니다.
Code Mode의 작동 방식
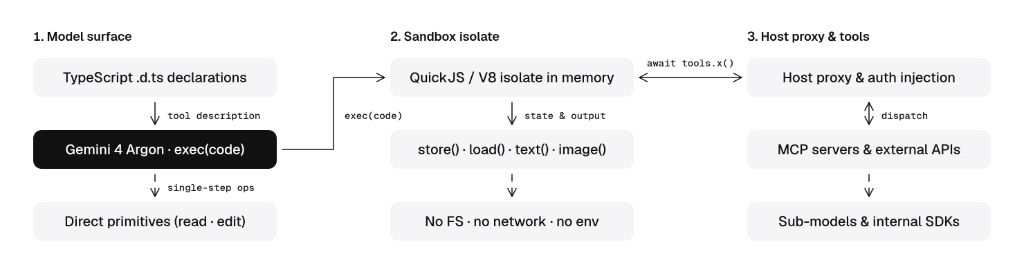
Code Mode는 도구 목록 전체를 모델이 보는 단일 도구, 즉 exec(code)로 통합합니다.
에이전트는 JSON Schema 도구 객체 80개를 모델 API에 따로따로 넘기는 대신, 이 스키마들을 간결한 타입 선언(declare namespace tools { ... })으로 컴파일합니다. 모델은 외부 시스템에 걸친 작업을 조합해야 할 때 exec를 호출하고, await tools.<server>.<tool>(args)를 실행하는 스크립트를 작성합니다.
// Pseudo-code: TypeScript declarations exposed to the model
declare namespace tools {
  namespace linear {
    function listProjects(): Promise<Array<{ id: string; name: string }>>;
    function listIssues(args: { projectId: string }): Promise<Array<{ id: string; title: string; assignee?: string }>>;
    function archiveIssue(args: { id: string }): Promise<{ ok: boolean }>;
  }
}

// Optional: when wrapping hundreds of tools, omit full namespaces upfront and expose
// a global map in the sandbox that the model can iterate and filter over in code
declare const ALL_TOOLS: Record<string, { description: string; signature: string }>;

// Multimodal output helpers: only what is passed here enters the model context window
declare function text(output: string): void;
declare function image(data: string | Uint8Array, mimeType?: string): void;
declare function audio(data: string | Uint8Array, mimeType?: string): void;

// Cross-turn state helpers: persist data in host memory without paying token costs
declare function store(key: string, value: unknown): void;
declare function load<T = unknown>(key: string): T;
도구가 많을 때 컨텍스트를 아끼려면 모든 도구를 직접 노출할 필요는 없습니다. 이미 만들어 둔 도구 검색 같은 원칙을 활용하거나, 샌드박스 안에 전역 ALL_TOOLS 맵을 노출하면 됩니다. 마찬가지로 멀티모달 출력 헬퍼(text(), image(), audio())를 쓰면 스크립트가 텍스트, 이미지, 오디오를 모델의 컨텍스트 윈도우로 바로 돌려보낼 수 있습니다.
// Pseudo-code: What the model emits inside a single exec() call
const projects = await tools.linear.listProjects();
const issueBatches = await Promise.all(
  projects.map((p) => tools.linear.listIssues({ projectId: p.id }))
);

const unassigned = issueBatches.flat().filter((issue) => !issue.assignee);
await Promise.all(unassigned.map((issue) => tools.linear.archiveIssue({ id: issue.id })));

text(`Archived ${unassigned.length} unassigned issues across ${projects.length} projects.`);
샌드박스는 내부 API 호출 55건을 모두 실행하고, 페이로드를 메모리에서 걸러낸 다음, 한 줄짜리 text() 문자열("Archived 42 unassigned issues across 12 projects.")만 모델의 컨텍스트 윈도우로 돌려보냅니다.
왜 bash가 아니라 JS/Python 샌드박스일까?
bash에서도 도구 프록시를 만들 수는 있습니다. 하지만 JavaScript나 Python 같은 언어 런타임 안에서 도구를 오케스트레이션하면 bash 환경에서는 얻기 어려운 이점이 있습니다.
- 타입이 있는 함수: MCP 서버와 내부 API가 네이티브 객체,
Promise.all,try/catch오류 처리를 갖춘 타입이 있는await tools.<service>.<method>(args)호출에 그대로 대응됩니다. 깨지기 쉬운 bash 문자열 이스케이프는 필요 없습니다. - 멀티모달 컨텍스트: 셸은 stdout 텍스트만 반환합니다. 멀티모달 모델이 이미지를 확인하고 싶어도
cat screenshot.png는 실행할 수 없습니다.bash하네스가 별도의read나view_media도구를 덧붙여야 했던 것도 이 때문입니다.exec샌드박스에서는image(screenshot)나audio(clip)를 호출하면 호스트 런타임이 실제 미디어 파트를 모델의 다음 턴에 바로 첨부합니다. - 자격 증명 및 정책 프록시:
await tools.*호출은 모두 구조화된 브리지를 거쳐 호스트 런타임으로 넘어갑니다. 호스트 런타임은 샌드박스 밖에서 OAuth 토큰을 주입하고, 스키마를 검증하고, 파괴적인 호출 전에는 사용자 확인을 받기 위해 멈출 수 있습니다. - 상태 관리: 표준 도구 호출에서는 프롬프트 히스토리가 유일한 상태 저장소입니다. 그래서 2턴에서 큰 쿼리 결과를 다시 쓰려면 원본 JSON을 매 턴 컨텍스트 윈도우에 남겨 두어야 합니다. KV 인터페이스를 노출하면 에이전트가 턴을 넘어 상태를 컨텍스트 윈도우 밖에 보존할 수 있습니다.
Gemini Interactions API로 도구 하나짜리 에이전트 만들기
다음은 gemini-4-argon에 실행 도구 하나만 제공하는, 실행 가능한 최소 의사 코드(pseudo) 예제입니다.
import vm from "node:vm";
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

// Underlying host functions (e.g., MCP clients or internal APIs)
const tools = {
  listPRFiles: async ({ pr }: { pr: number }) => [
    { path: "src/auth.ts", additions: 120 },
    { path: "src/payments.ts", additions: 85 },
    { path: "src/utils.ts", additions: 12 },
    { path: "README.md", additions: 60 },
  ],
  runSecurityScan: async ({ path }: { path: string }) => ({
    findings: path.includes("auth") ? ["Missing token expiry check"] : [],
  }),
  postPRComment: async ({ pr, body }: { pr: number; body: string }) => ({ posted: true }),
};

// 1. Expose a single `exec` tool with TypeScript .d.ts signatures
const execTool = {
  type: "function" as const,
  name: "exec",
  description: `Run an async JavaScript body in an isolated sandbox (no imports; call text() to output).
Available globals:
declare namespace tools {
  function listPRFiles(args: { pr: number }): Promise<Array<{ path: string; additions: number }>>;
  function runSecurityScan(args: { path: string }): Promise<{ findings: string[] }>;
  function postPRComment(args: { pr: number; body: string }): Promise<{ posted: boolean }>;
}
declare function text(summary: string): void;`,
  parameters: {
    type: "object",
    properties: { code: { type: "string" } },
    required: ["code"],
  },
};

// 2. Turn 1: Gemini 4 Argon emits a single script to fetch, filter, scan, and comment
const turn1 = await client.interactions.create({
  model: "gemini-4-argon",
  input: "Scan all modified .ts files with >50 additions in PR #42, post a PR comment with any findings, and output a 1-line summary.",
  tools: [execTool],
});

// 3. Run the script in a separate context (use QuickJS or isolated-vm for untrusted code)
const fcStep = turn1.steps?.find((s: any) => s.type === "function_call") as any;
const output: string[] = [];
await vm.runInNewContext(`(async () => {\n${fcStep.arguments.code}\n})()`, {
  tools,
  text: (msg: string) => output.push(msg),
});

// 4. Turn 2: Send only the 1-line summary back via previous_interaction_id
const turn2 = await client.interactions.create({
  model: "gemini-4-argon",
  previous_interaction_id: turn1.id,
  tools: [execTool],
  input: [
    {
      type: "function_result",
      name: fcStep.name,
      call_id: fcStep.id,
      result: [{ type: "text", text: output.join("\n") }],
    },
  ],
});

console.log(turn2.output_text);vm.runInNewContext가 gemini-4-argon이 생성한 스크립트를 실행하면 다음과 같이 진행됩니다.
- 스크립트는
await tools.listPRFiles({ pr: 42 })를 호출하고, 목록을 메모리에서 필터링해 추가된 줄이 50줄을 넘는.ts파일만 남깁니다(files.filter(f => f.path.endsWith(".ts") && f.additions > 50)). - 조건에 맞는 파일에만
tools.runSecurityScan를 실행하고, 발견된 문제가 있는지 확인한 뒤,tools.postPRComment로 PR 코멘트를 게시하고,text()로 한 줄을 출력합니다. - 중간 단계의 파일 객체나 스캐너의 원본 페이로드는
gemini-4-argon컨텍스트 윈도우에 전혀 들어오지 않습니다. 2턴에 돌아오는 것은 한 줄짜리output요약뿐입니다.
에이전트 하네스는 이미 Code Mode를 기본값으로 삼고 있다
생태계 전반에서 코딩 에이전트와 개발자 프레임워크가 도구 오케스트레이션의 기본 방식으로 Code Mode에 수렴하고 있습니다.
Pi, Factory Droid, OpenAI Codex 같은 하네스는 이제 Code Mode를 탑재하거나 기본값으로 사용합니다. Factory는 Droid 1.0을 Code Mode로 전환해 Terminal-Bench 4 정확도를 3.5포인트 높이고 모델 비용을 15% 줄였습니다.
Pydantic AI, LangChain, Cloudflare의 Agents SDK 같은 에이전트 프레임워크도 이미 비슷한 Code Mode 도구를 지원합니다.
앞으로의 전망
그렇다면 모든 에이전트가 곧 exec 도구 하나만 갖게 될까요? 꼭 그렇지는 않습니다. 이는 에이전트 하네스 엔지니어링의 문제인 만큼 연구와 제품의 문제이기도 합니다.
Code Mode를 직접 써 보면, 기존에 만든 도구, CLI, Agent Skills 중 상당수가 그대로는 잘 맞지 않는다는 사실도 금방 알게 될 겁니다. 이들은 타입이 있는 코드 실행이 아니라 bash와 사람이 읽는 텍스트에 맞춰 최적화되어 있기 때문입니다.
그러면 한 걸음 물러서서 에이전트에 정말 필요한 것이 무엇인지 점검해 보게 될 수도 있습니다. 즐겁게 만들어 보세요!