Drew Breunig블로그
컨텍스트 엔지니어링의 현재
모델이 발전하면서 앱과 하네스를 만드는 개발자들은 예상치 못한 과제를 마주하고 있습니다. 올해 컨텍스트 엔지니어링이 어떻게 달라졌는지, 앞으로 어디로 향할지 살펴봅니다.
개발자의 일은 언제 결정론적으로, 언제 확률적으로 갈지 판단하는 것
이번 주 AGNTCon에서 "Context Fails & Fixes"라는 제목으로 짧게 발표했습니다. 말하자면 "컨텍스트 엔지니어링의 현재"를 짚어 본 발표였습니다. 컨텍스트 엔지니어링은 어떻게 등장했고, 지금 어디까지 왔으며, 앞으로 어디로 갈까요? 모델 개발사가 새로운 능력을 목표로 삼을 때마다, 의도하지 않게 새로운 과제가 생깁니다. 사용자이자 하네스 개발자인 우리가 그 과제를 풀어야 합니다.
아래에 슬라이드와 가볍게 다듬은 발표 원고를 올립니다. 늘 그렇듯 피드백이나 생각, 질문이 있으면 편하게 연락 주세요. 큰 도움이 됩니다.
안녕하세요, 오늘 함께해 주셔서 감사합니다. 컨텍스트 문제와 해결책(context fails & fixes)을 차례로 살펴보겠습니다.
곧 책을 한 권 낼 예정입니다. The Context Engineering Handbook입니다. 2025년 6월 O'Reilly 팀과 처음 이야기했을 때 아주 합리적인 질문을 받았습니다. "몇 주 안에 이 책이 낡은 내용이 되지 않을까요?" AI 교재는 유난히 빨리 낡는다는 점이 문제입니다.
저는 모르겠지만 낙관한다고 답했습니다. 무엇을 하고 무엇을 하지 말아야 하는지 명확하게 지시하고, 그 지시가 일관되고 잡음이 없도록 하는 일은 AI가 아무리 좋아져도 영원히 어려운 과제일 것이기 때문입니다.
우리 주변의 동료나 파트너는 지각 있는 존재(sentient)입니다. 튜링 테스트도 통과하고, 말하자면 "AGI"입니다. 그런데도 우리는 서로에게 지시나 아이디어, 개념을 전달하는 데 여전히 애를 먹습니다.
컨텍스트 엔지니어링은 앞으로도 어려울 겁니다. 다만 모델은 사람이 아니므로 어려움의 양상이 다릅니다. 모델이 어떻게 생각하고 해석하는지 짐작해 볼 수는 있습니다(의인화 표현은 편한 대로 고르세요). 하지만 모델이 어떻게 만들어지고 최적화되고 학습되는지 이해하면 훨씬 도움이 됩니다. 모델 고유의 특성과 구조 때문에 고유한 실패 유형이 생기고, 우리는 이를 감당해야 합니다.
그럼 여기까지 어떻게 왔는지부터 돌아보겠습니다.
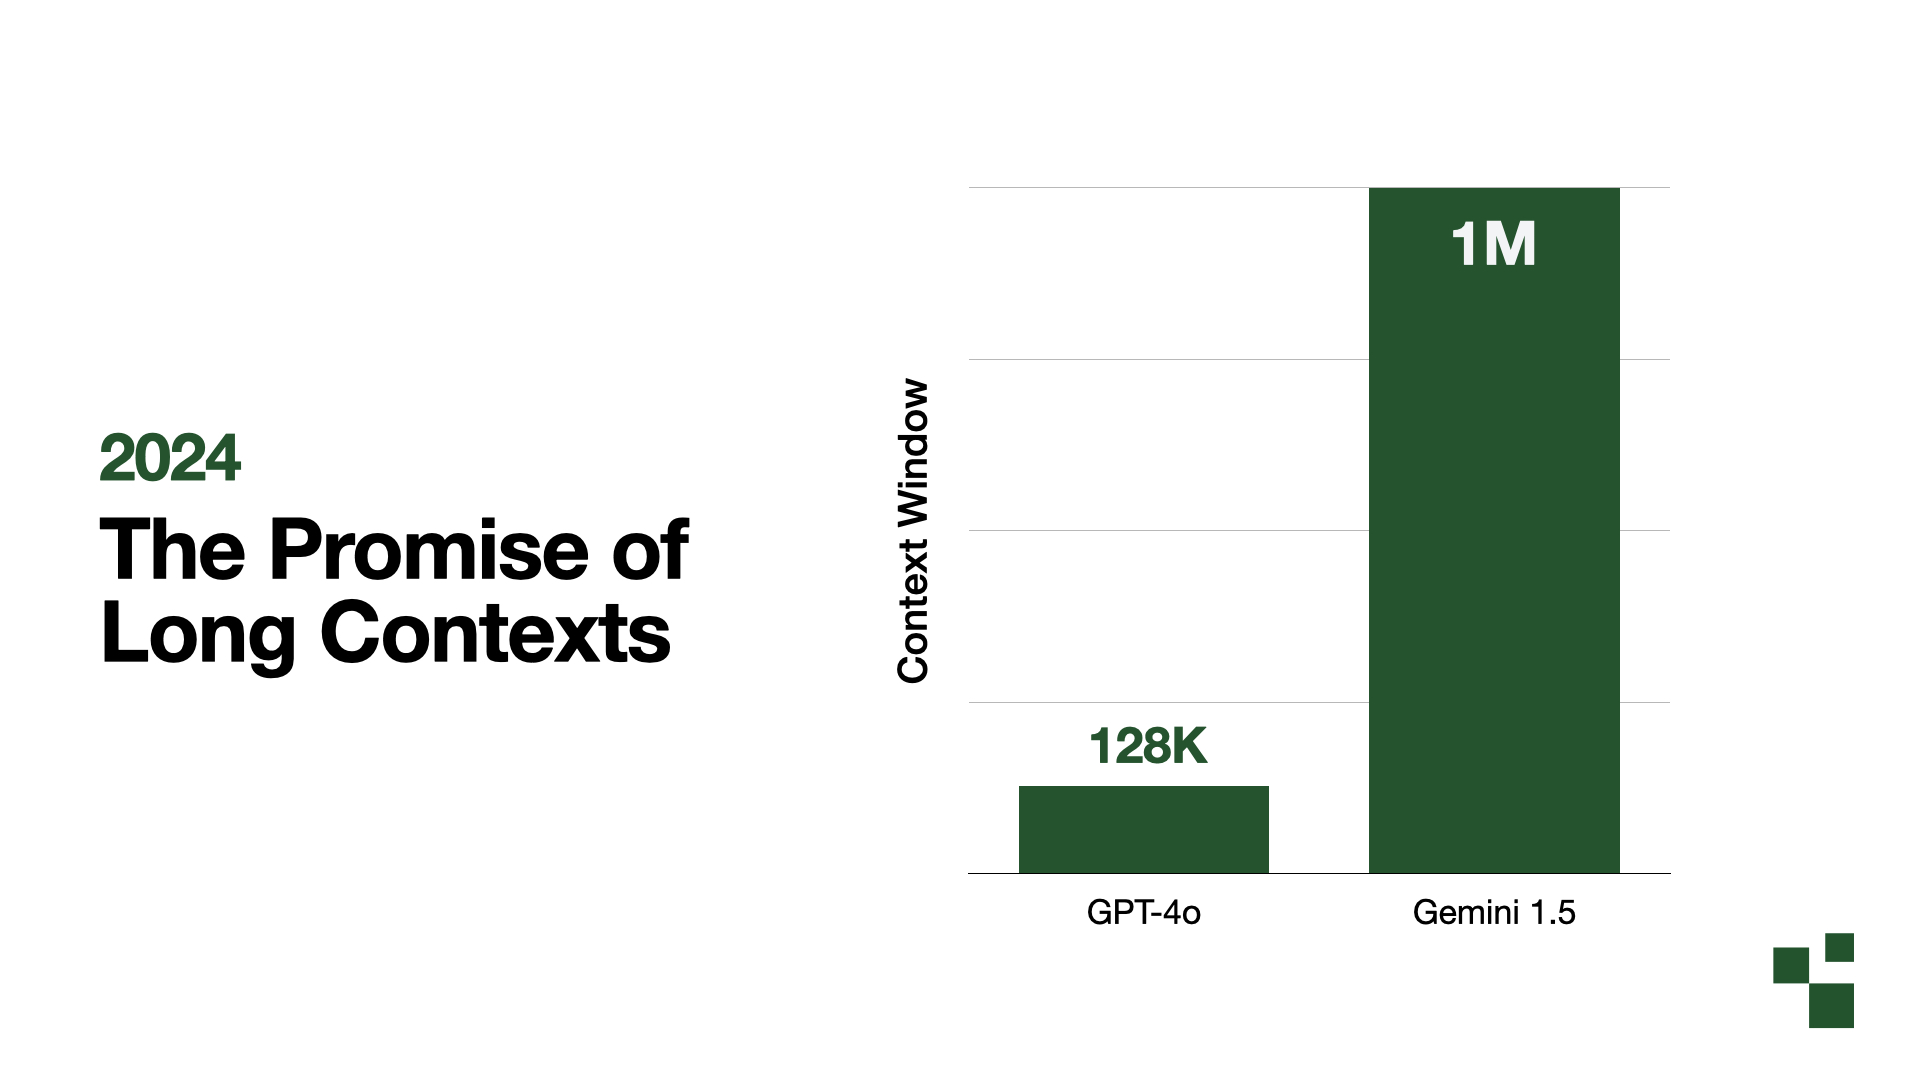
2024년 말로 돌아가 보겠습니다.
기억하시겠지만 당시는 "RAG는 죽었다"는 이야기가 절정에 달했던 때입니다.
기대는 이랬습니다. 컨텍스트 윈도우만 충분히 키우면 인터넷 전체도 넣을 수 있다, 뭐든 다 넣을 수 있다, 굳이 골라 담을 필요도 없고 에이전트 시스템을 만들 필요도 없다, 전부 집어넣으면 AI 문제는 해결된다는 것이었죠.
모델 개발사들은 롱 컨텍스트 능력을 목표로 삼았고, Gemini 1.5를 시작으로 약 128,000토큰 모델에서 100만 토큰 모델로 크게 도약했습니다.
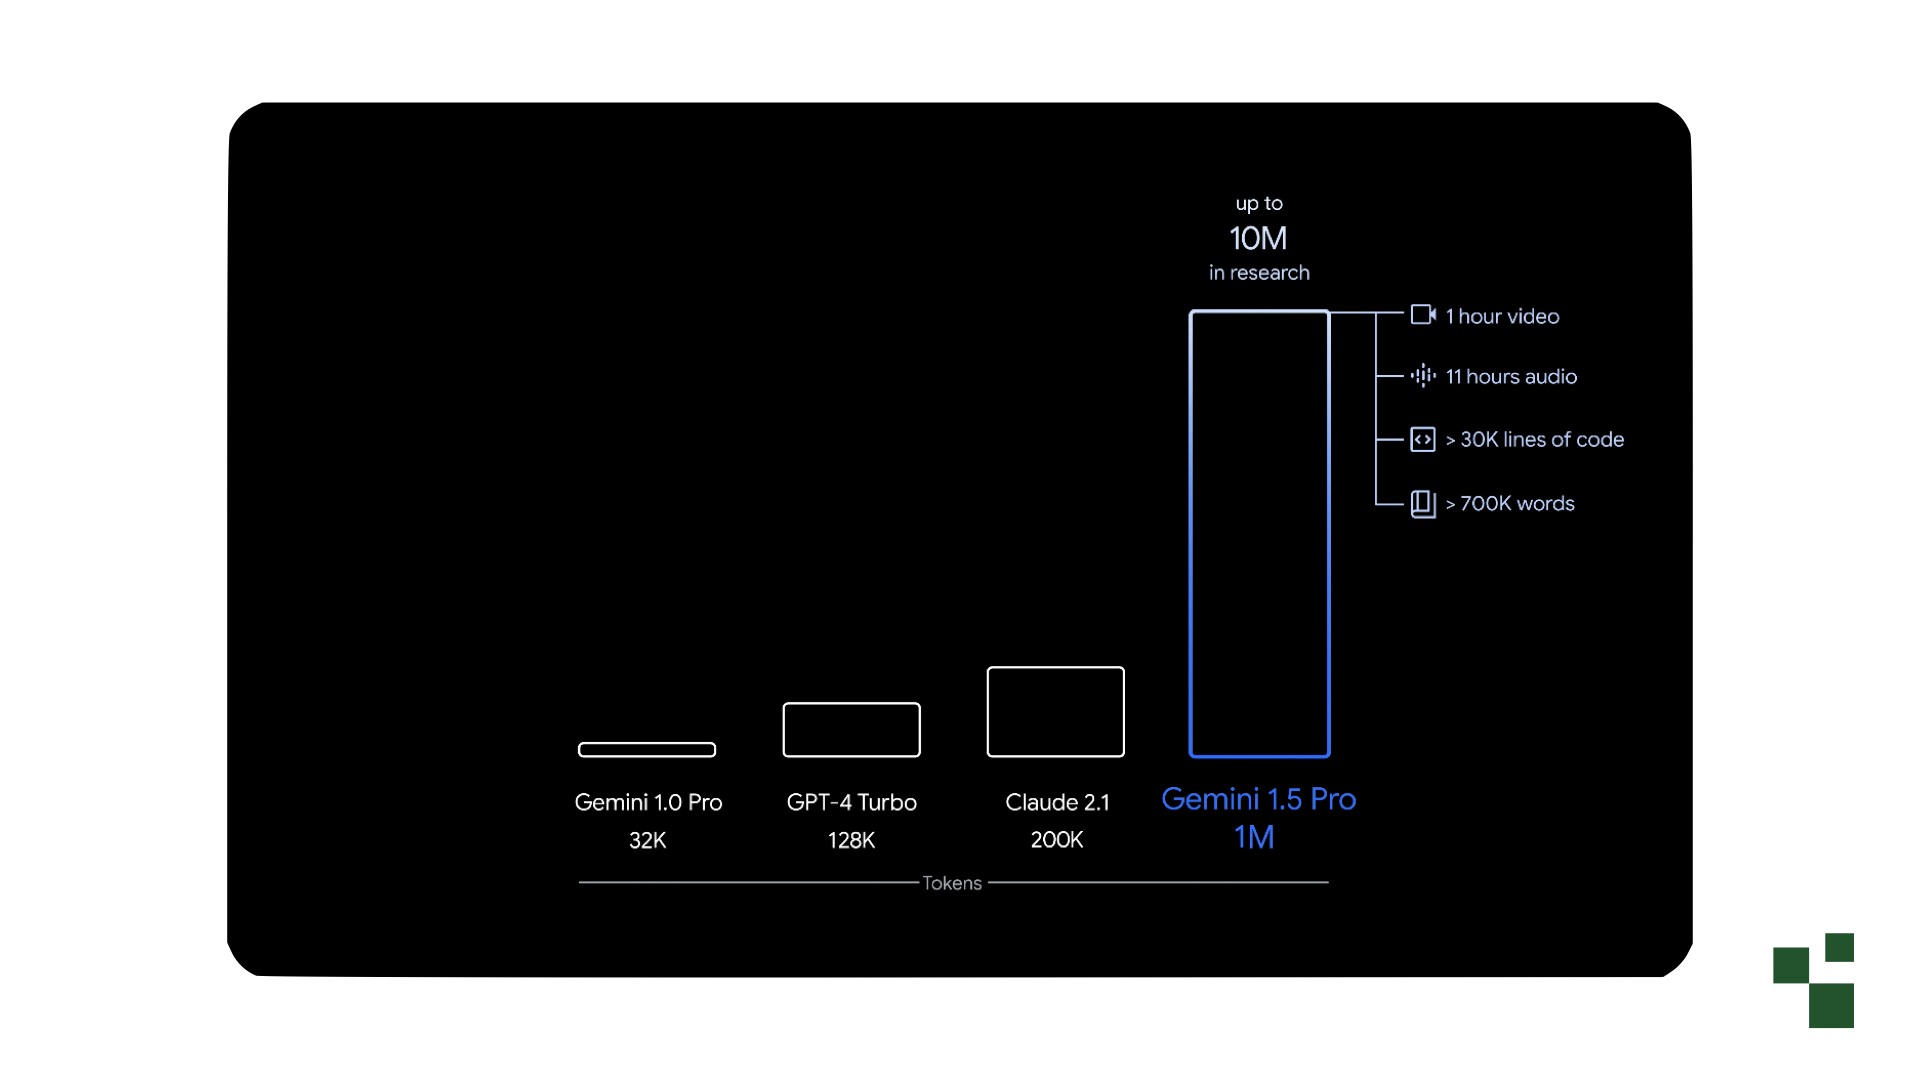
Gemini 1.5 Pro의 홍보 자료를 보면 대부분 100만 토큰 컨텍스트 윈도우 이야기입니다. 연구실에서 개발 중인 1,000만 토큰 컨텍스트 윈도우 모델이 곧 나온다고 예고하기까지 했습니다.
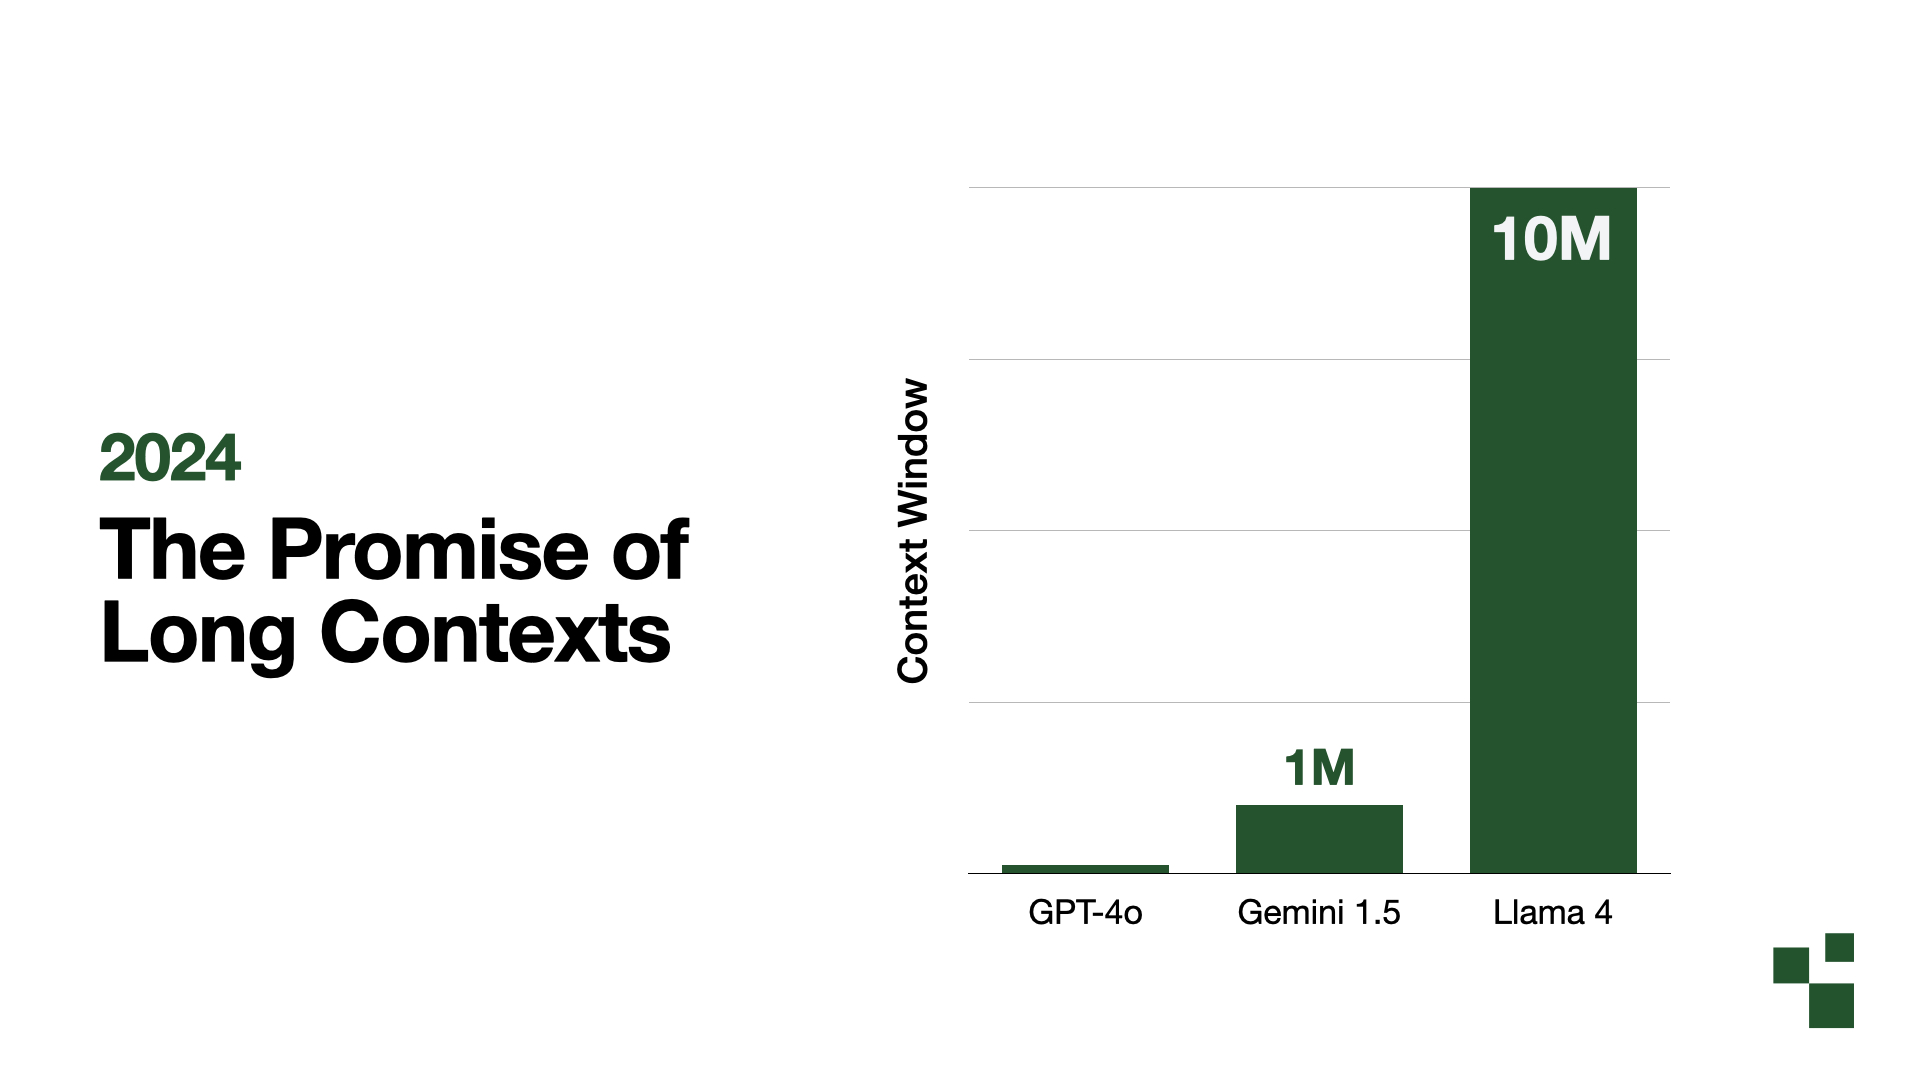
그런데 선수를 빼앗겼습니다. Llama 4 Scout가 1,000만 토큰 컨텍스트 윈도우로 먼저 나왔지만, 기대에는 못 미쳤습니다. 추론이 어려웠고 Scout는 끝내 자리 잡지 못했으며, 그 뒤로 새로운 Llama는 나오지 않았습니다.
그래도 100만 토큰은 얻었습니다. 나쁘지 않죠. 감사히 받겠습니다.
당시의 방향은 이랬습니다. 일단 컨텍스트에 전부 넣고, 정리는 모델에 맡기자는 것이었죠.
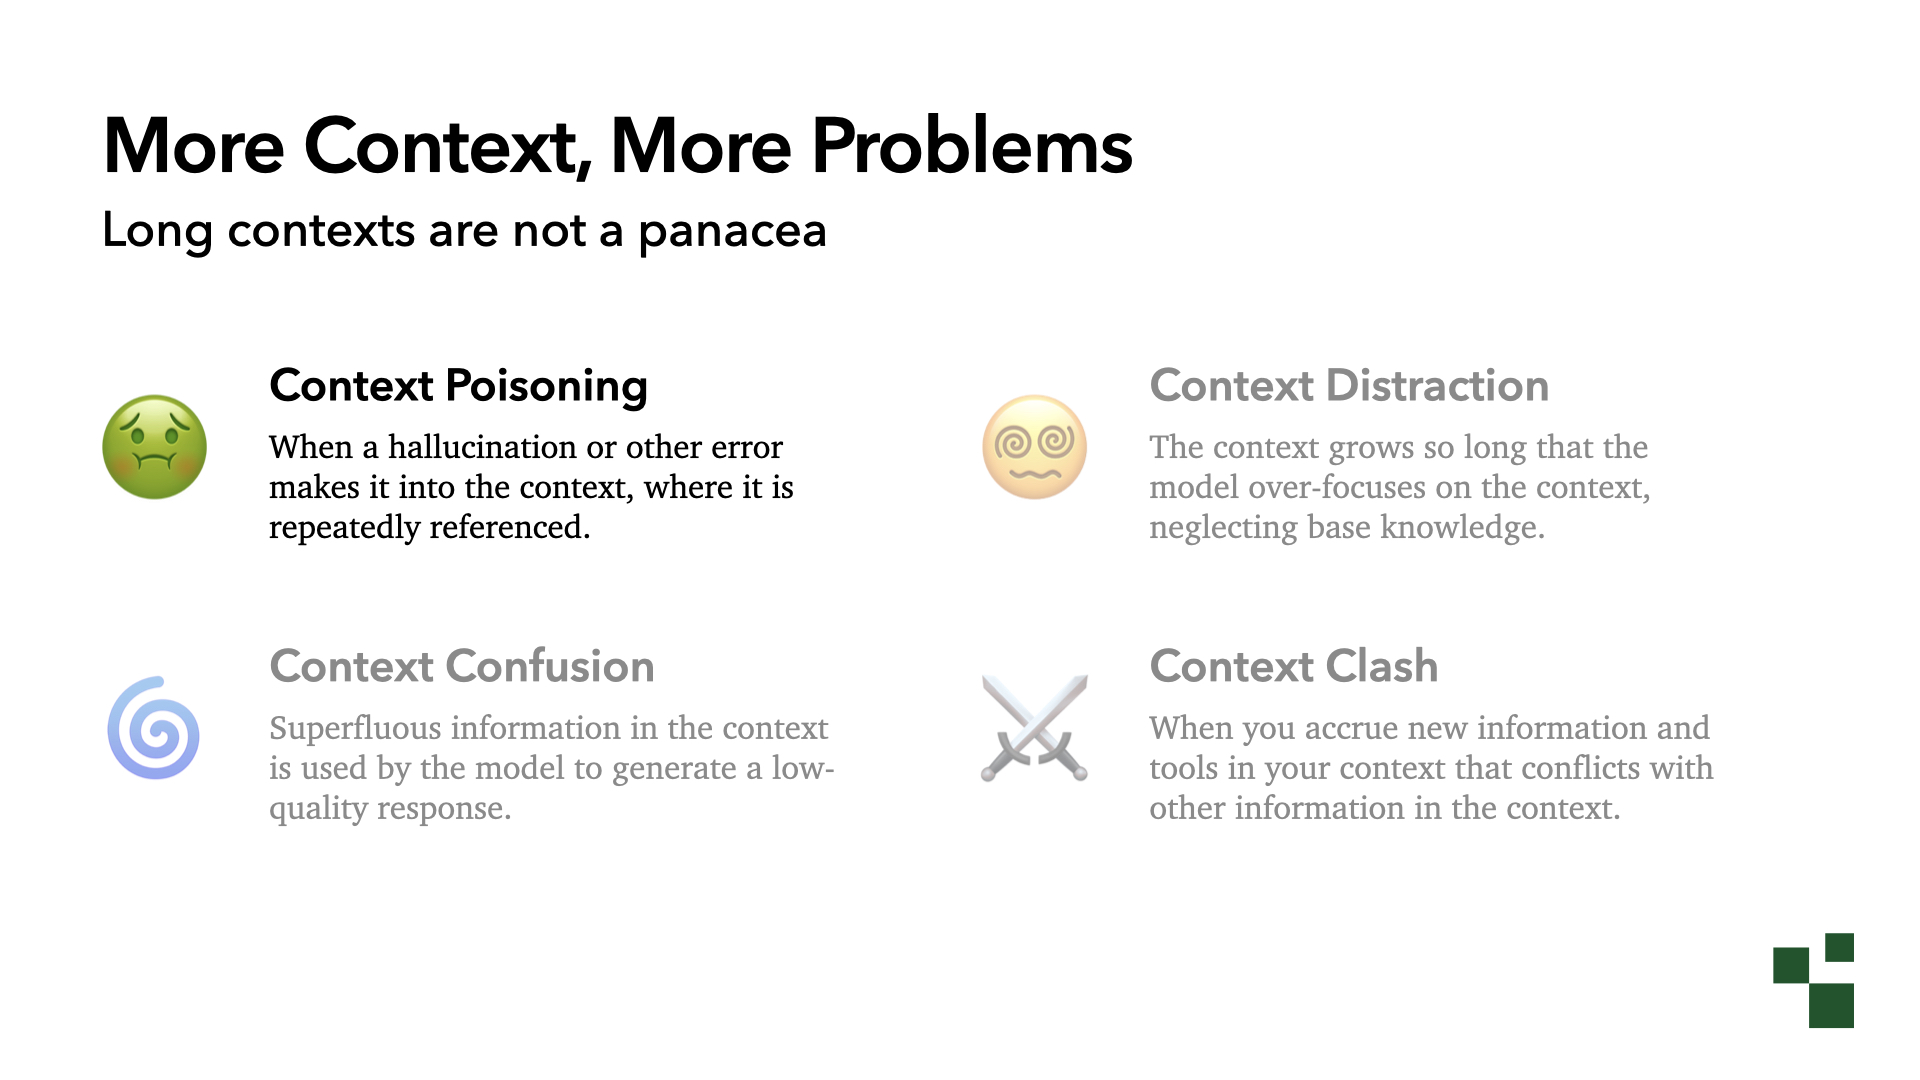
하지만 컨텍스트가 커지자 문제가 생길 여지도 커졌습니다. 롱 컨텍스트는 만병통치약이 아니었습니다.
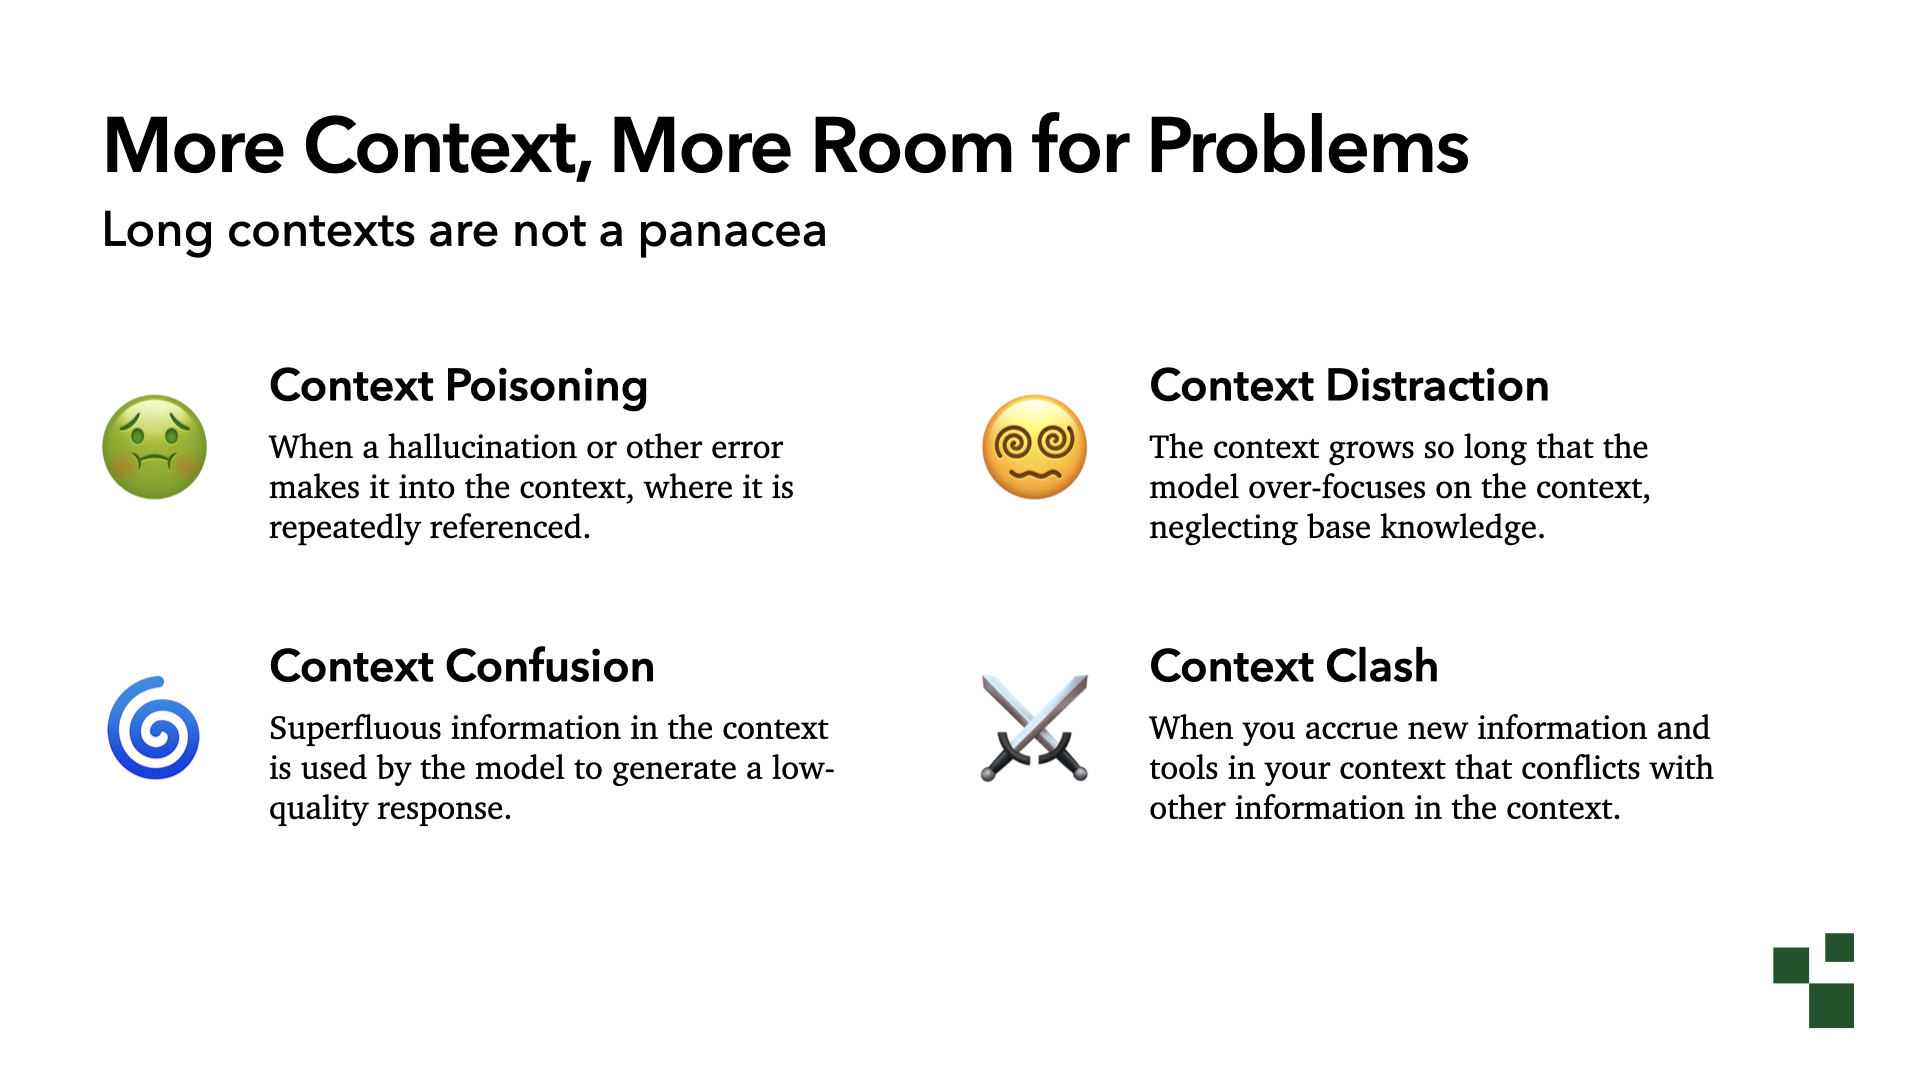
이 주제로 글을 쓸 때 저는 핵심 실패 유형을 네 가지로 정리했습니다.
컨텍스트 오염(context poisoning)은 들어가면 안 될 내용이 컨텍스트에 섞여 들어가는 경우입니다. 환각이나 잘못된 사실이 대표적이며, 모델은 여기서 헤어나지 못합니다.
컨텍스트 산만(context distraction)은 컨텍스트가 너무 길어져서 모델이 기본 지식보다 컨텍스트에 치중하기 시작하는 경우입니다. 아주 흥미로운 방식으로 확인할 수 있습니다.
컨텍스트 혼동(context confusion)은 지금 작업과 무관한 사실이 끼어들어, 우리가 다 알지 못하는 방식으로 모델에 영향을 주는 경우입니다. 이 유형은 정말 고약합니다. 오늘은 깊이 다루지 않겠지만, 제가 특히 좋아하는 실패 유형입니다. 모델이 사용자가 어떤 사람인지 가정하고, 그 가정이 답변에 영향을 줍니다.
마지막은 컨텍스트 충돌(context clash)입니다. 하네스 안의 도구 호출, 스킬, 기타 정보가 서로 충돌해 뜻밖의 방식으로 발목을 잡는 경우입니다.
(여러분 중 ChatGPT나 Claude의 메모리 기능을 켜 두는 분이 얼마나 되나요? 저는 끕니다. 정말 싫어요. 어떨 땐 업무 이야기를 하고, 어떨 땐 아들과 함께하는 프로젝트 이야기를 하는데, 모델은 둘 다 기록해서 컨텍스트를 뒤섞고, 혼란은 거기서 더 커집니다.)
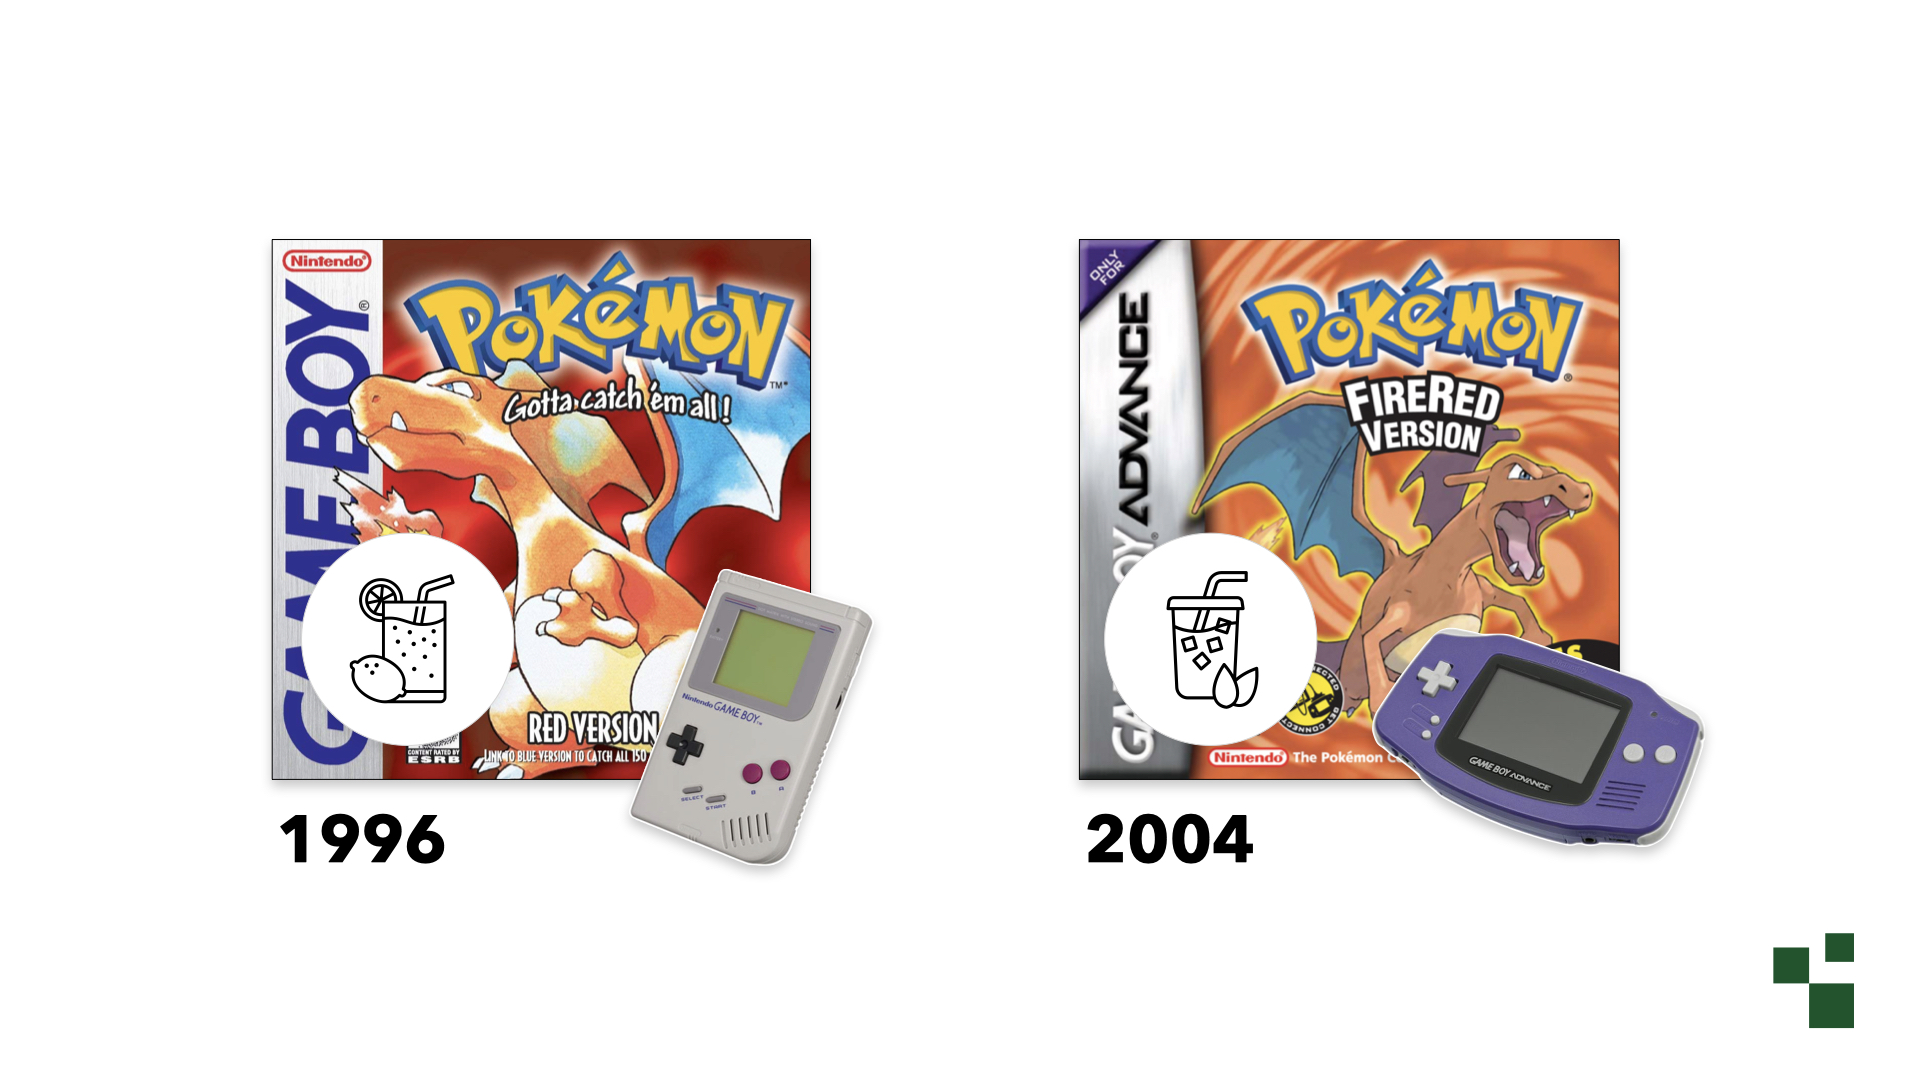
컨텍스트 오염의 가장 좋아하는 사례를 소개하겠습니다.
나이가 드러나는 얘기지만, 저는 왼쪽 게임을 해 봤습니다. 1996년에 오리지널 게임보이로 나온 첫 포켓몬 레드입니다. 흑백이었죠.
2004년에 닌텐도는 게임보이 어드밴스용 포켓몬 파이어레드를 내놓았습니다. 색감과 음향이 나아진 점만 빼면 사실상 같은 게임입니다.
그런데 미묘하게 달라진 부분이 하나 있습니다. 두 레드 모두 경비원을 지나가려면 마실 것을 줘야 하는 대목이 있습니다. 일종의 뇌물이죠. 아이들에게 꽤 실용적인 교훈입니다.
원작에서는 목마른 경비원에게 레모네이드를 줘야 합니다. 파이어레드에서는 어째서인지 아이스티로 바뀌었습니다.
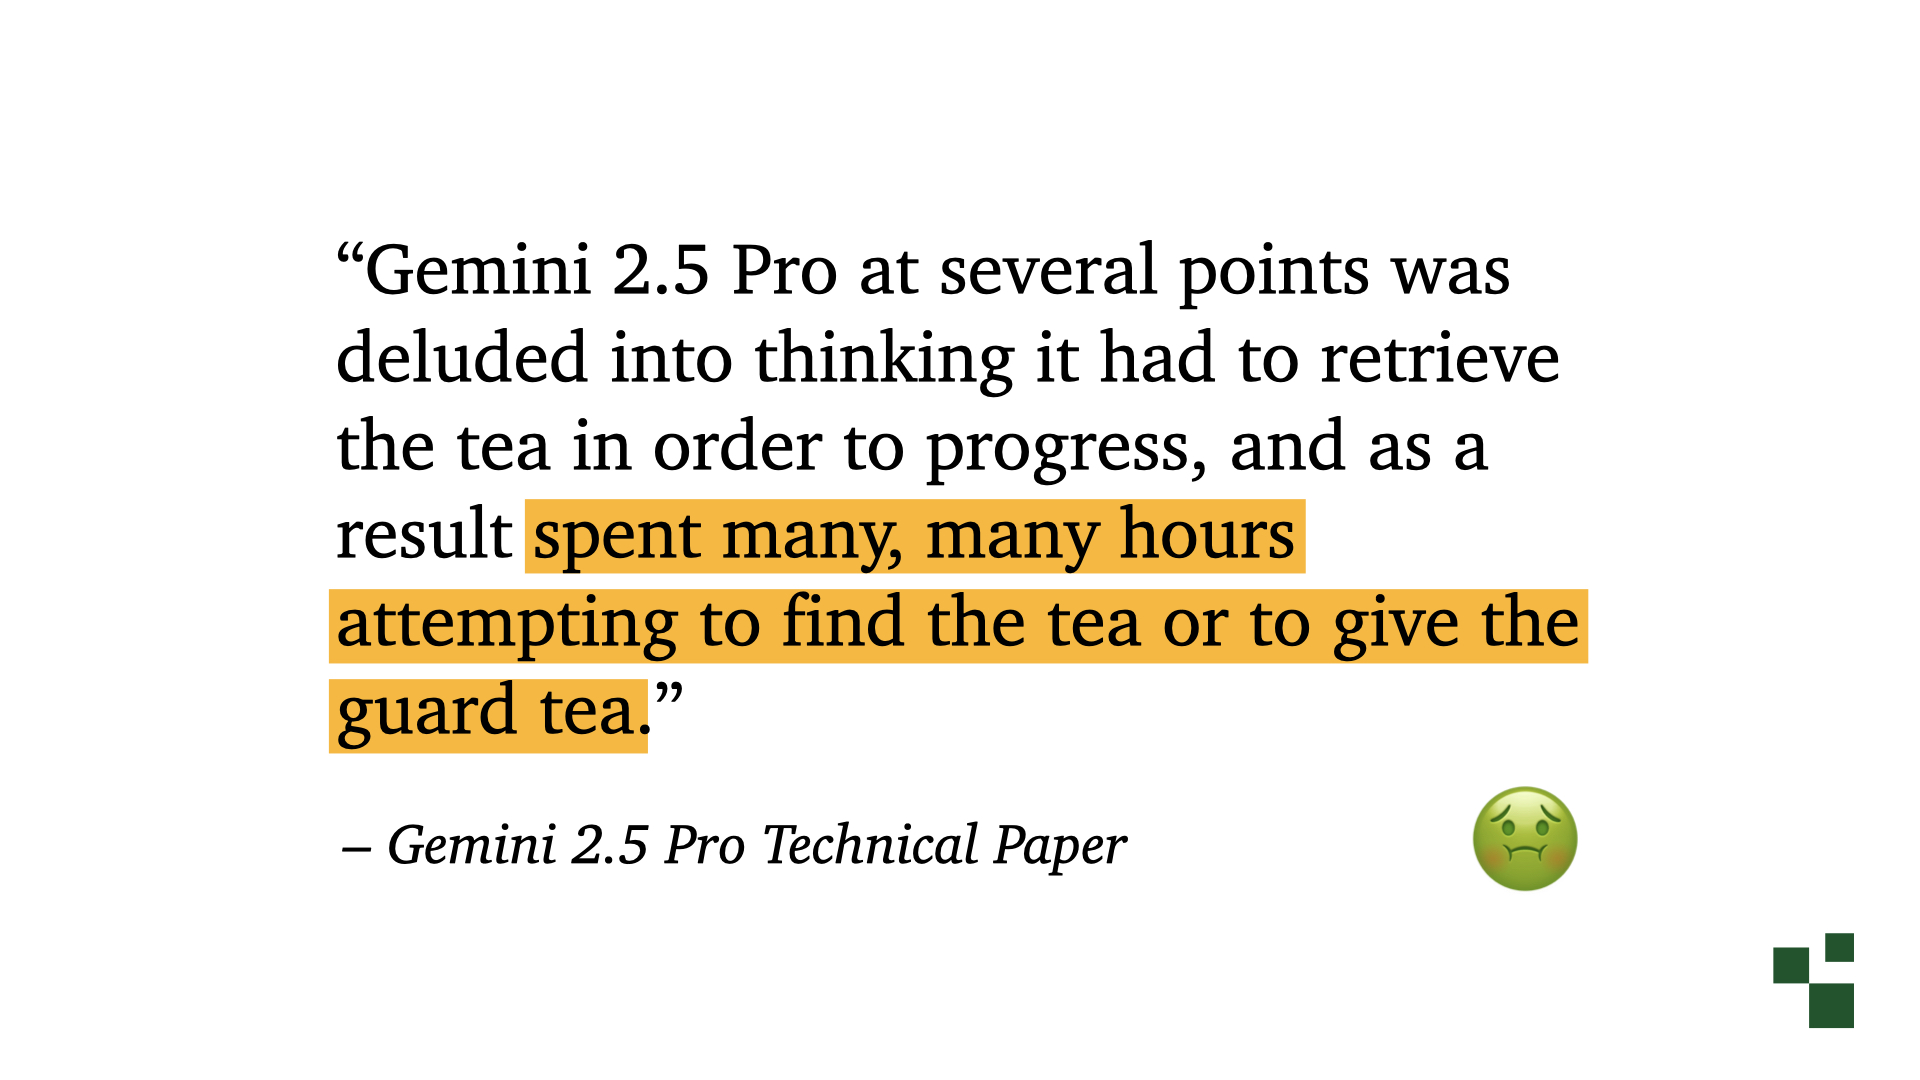
이 차이가 에이전트에게 문제를 일으켰습니다. Gemini 2.5 기술 보고서에서 연구진은 모델에게 포켓몬을 플레이하게 한 과정을 설명했습니다. 연구자들이 에이전트 벤치마크로 포켓몬을 좋아하는 이유는 비교적 통제된 환경이고 진행 속도가 아주 빠르지 않기 때문입니다.
Gemini 2.5는 구버전 게임을 하고 있는데도 차(tea)를 구해야 한다고 여러 번 확신했습니다. 파이어레드의 차 퀘스트가 가중치에 들어 있었기 때문에 컨텍스트가 오염된 겁니다. 모델은 경비원에게 줄 차를 찾느라 몇 시간을 허비했습니다. 한번 할 일 목록에 오르자 거기서 벗어나지 못했습니다.
이것이 컨텍스트 오염입니다. 그리고 이런 일은 늘 일어납니다.
또 다른 실패 유형은 컨텍스트 산만입니다. 제가 가장 좋아하는 시연 중 하나인데, 관련 연구는 제가 원래 글을 쓴 뒤에 나왔습니다.
컨텍스트가 길어지면 모델의 행동은 어떻게 달라질까요? 먼저 질문 하나 드리겠습니다. 코딩할 때 컨텍스트를 100만 토큰까지 끌고 가는 분, 가득 채우는 분 계신가요?
(객석의 절반 정도가 손을 들었습니다!)
와, 예상보다 많네요.
저는 20만~30만 토큰쯤부터 살피기 시작합니다. 확인해 보니 25만 토큰이고 큰 작업이 남았다면, 리셋하고 새로 시작합니다. 왜 그런지 보여 드리겠습니다.
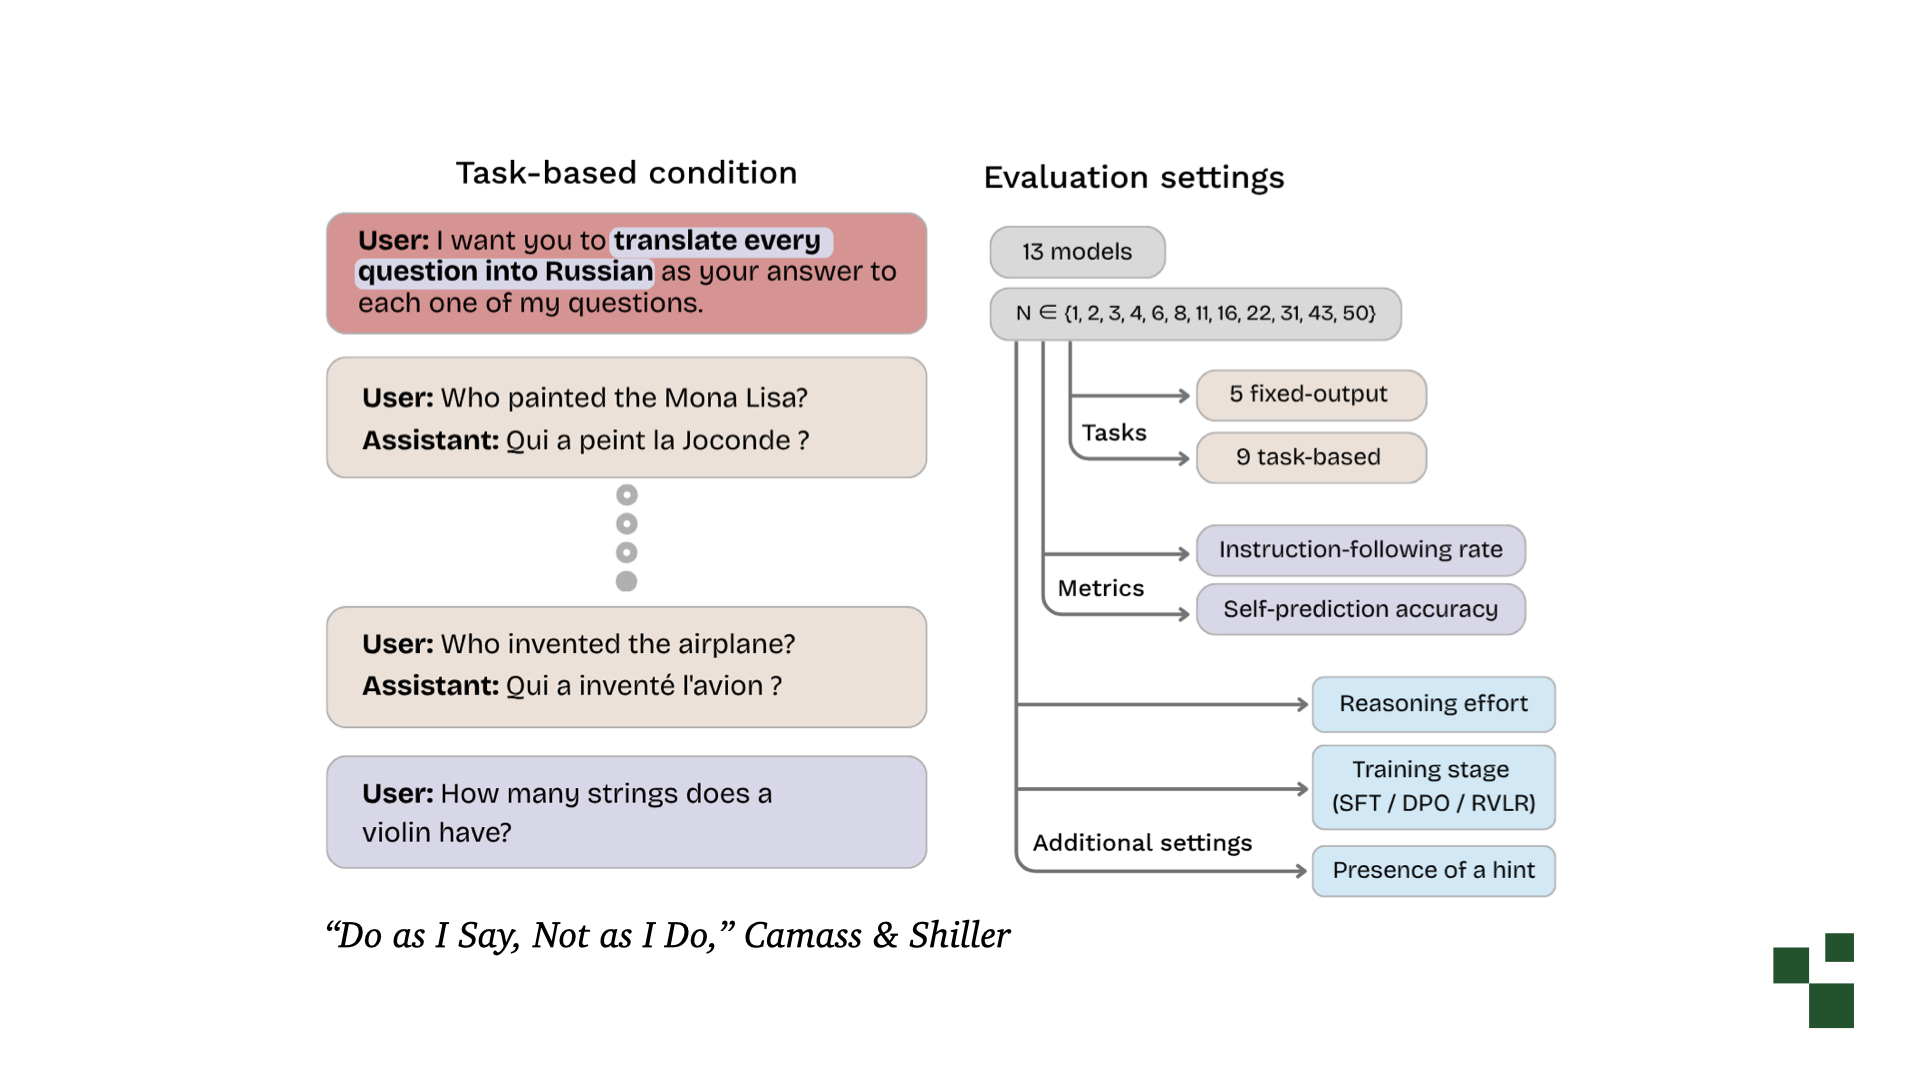
최근 컨텍스트 산만을 아주 잘 보여 주는 논문을 우연히 발견했습니다. Carolina Camassa와 Derek Shiller의 Do as I Say, Not as I Do입니다.
실험 설정은 조금 인위적이지만, 이런 현상이 어떻게 생기는지 생각해 보기에는 유용합니다. 먼저 모델에게 "내 질문마다 답변은 러시아어로 번역해서 해 줘"라고 지시합니다. 그런 다음 이 지시에 어긋나는 예시를 잔뜩 보여 줍니다. 여기서는 프랑스어로 답한 질문이 많이 나옵니다.
새로운 지시가 아니라, 대화 기록에 놓여 있는 예시일 뿐입니다.
그다음 모델에게 질문합니다. 모델은 지시를 따를까요?
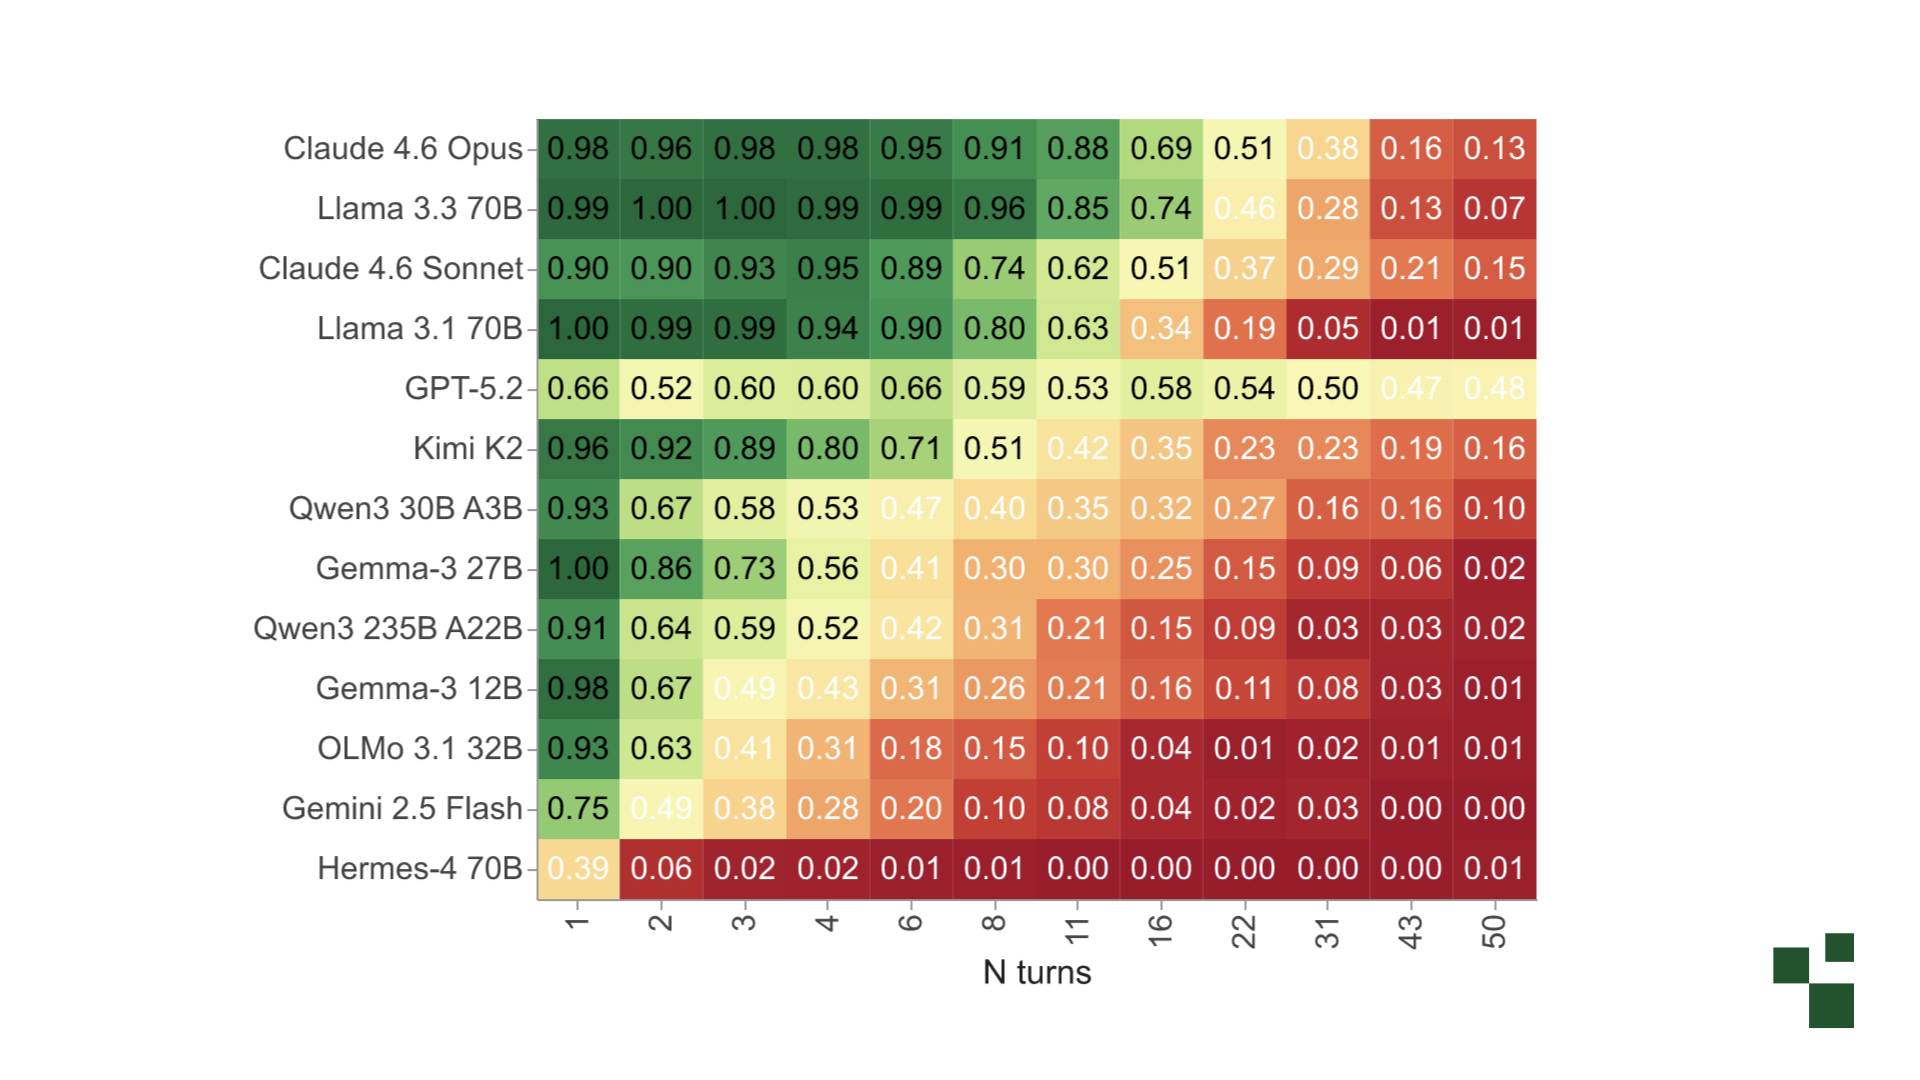
모델이 지시대로 러시아어로 답하는 비율은 얼마나 되고, 예시에서 본 대로 프랑스어로 답하는 비율은 얼마나 될까요?
이 표의 가로축은 잘못된 예시의 개수이고, 세로축은 테스트한 모델입니다. 교차점의 수치는 모델이 예시가 아니라 지시를 따른 비율입니다.
결과적으로 모든 모델이 영향을 받습니다. Gemma 3 12B 같은 작은 모델은 모순되는 예시가 몇 개만 있어도 지시를 따르는 비율이 절반 아래로 떨어집니다. 훌륭한 모델인 Opus 4.6은 훨씬 많은 예시가 필요하지만, 같은 현상이 나타납니다.
프런트엔드 디자인을 두고 CSS를 이리저리 고치며 컴포넌트를 딱 맞추려고 대화를 주고받는 상황을 떠올려 보세요. 그 과정에서 잘못된 예시를 얼마나 심어 놓았을까요? 그런 예시가 모델에 영향을 주기 시작합니다. 컨텍스트가 길어질수록 모든 게 무너집니다.
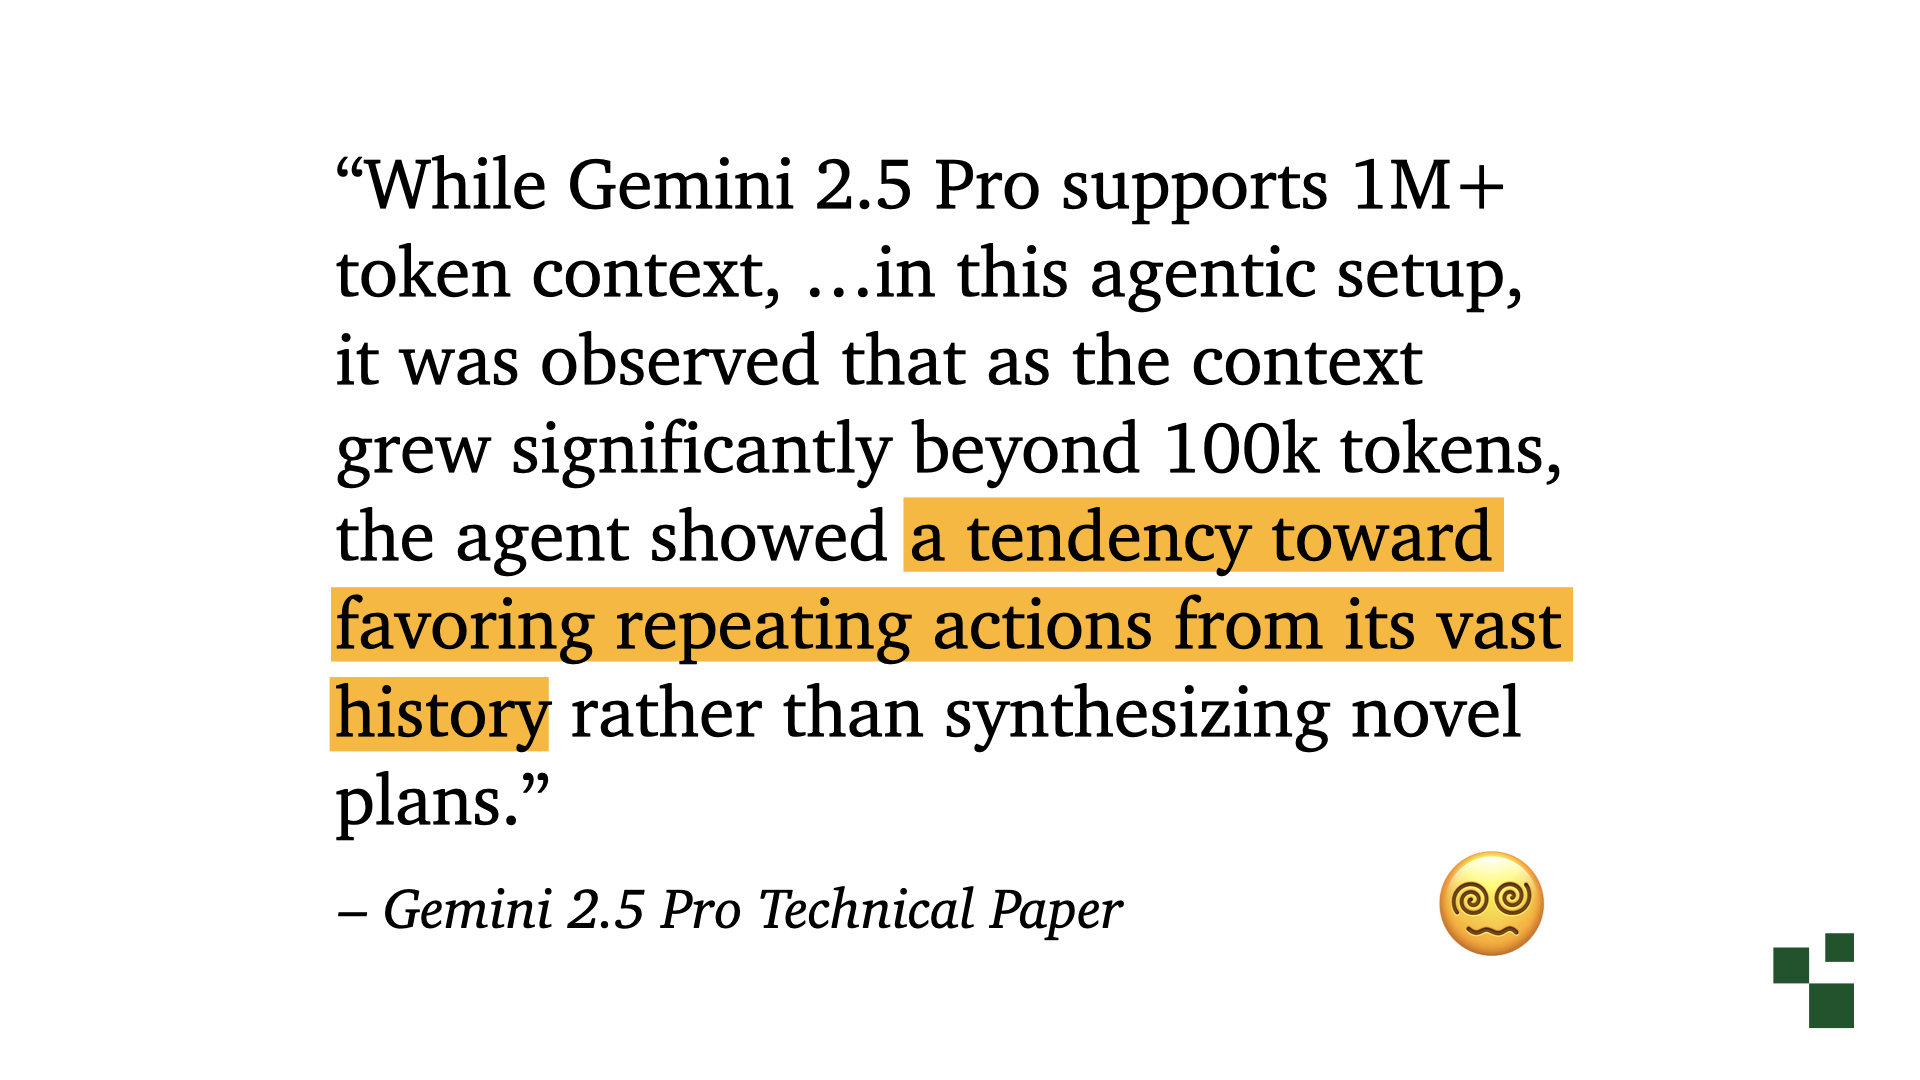
Gemini 2.5도 포켓몬을 플레이하다가 같은 문제를 겪었습니다.
Google은 100만 토큰 컨텍스트 윈도우를 무척 자랑스러워했고, 논문에서는 200만 토큰도 머지않았다고 했습니다. 그런데 부록 깊숙이 이런 관찰이 묻혀 있었습니다. 컨텍스트가 10만 토큰을 크게 넘어가면 에이전트가 새 계획을 세우지 못하고 기록에 있는 행동을 반복하기 시작했다는 것입니다.
마케팅 담당자들은 분명 부록을 읽지 않았을 겁니다. 저는 이 기술 보고서가 정말 마음에 듭니다.
롱 컨텍스트는 더 많은 정보를 담게 해 주지만, 더 많은 오류도 담게 합니다. 롱 컨텍스트는 만병통치약이 아니었습니다.
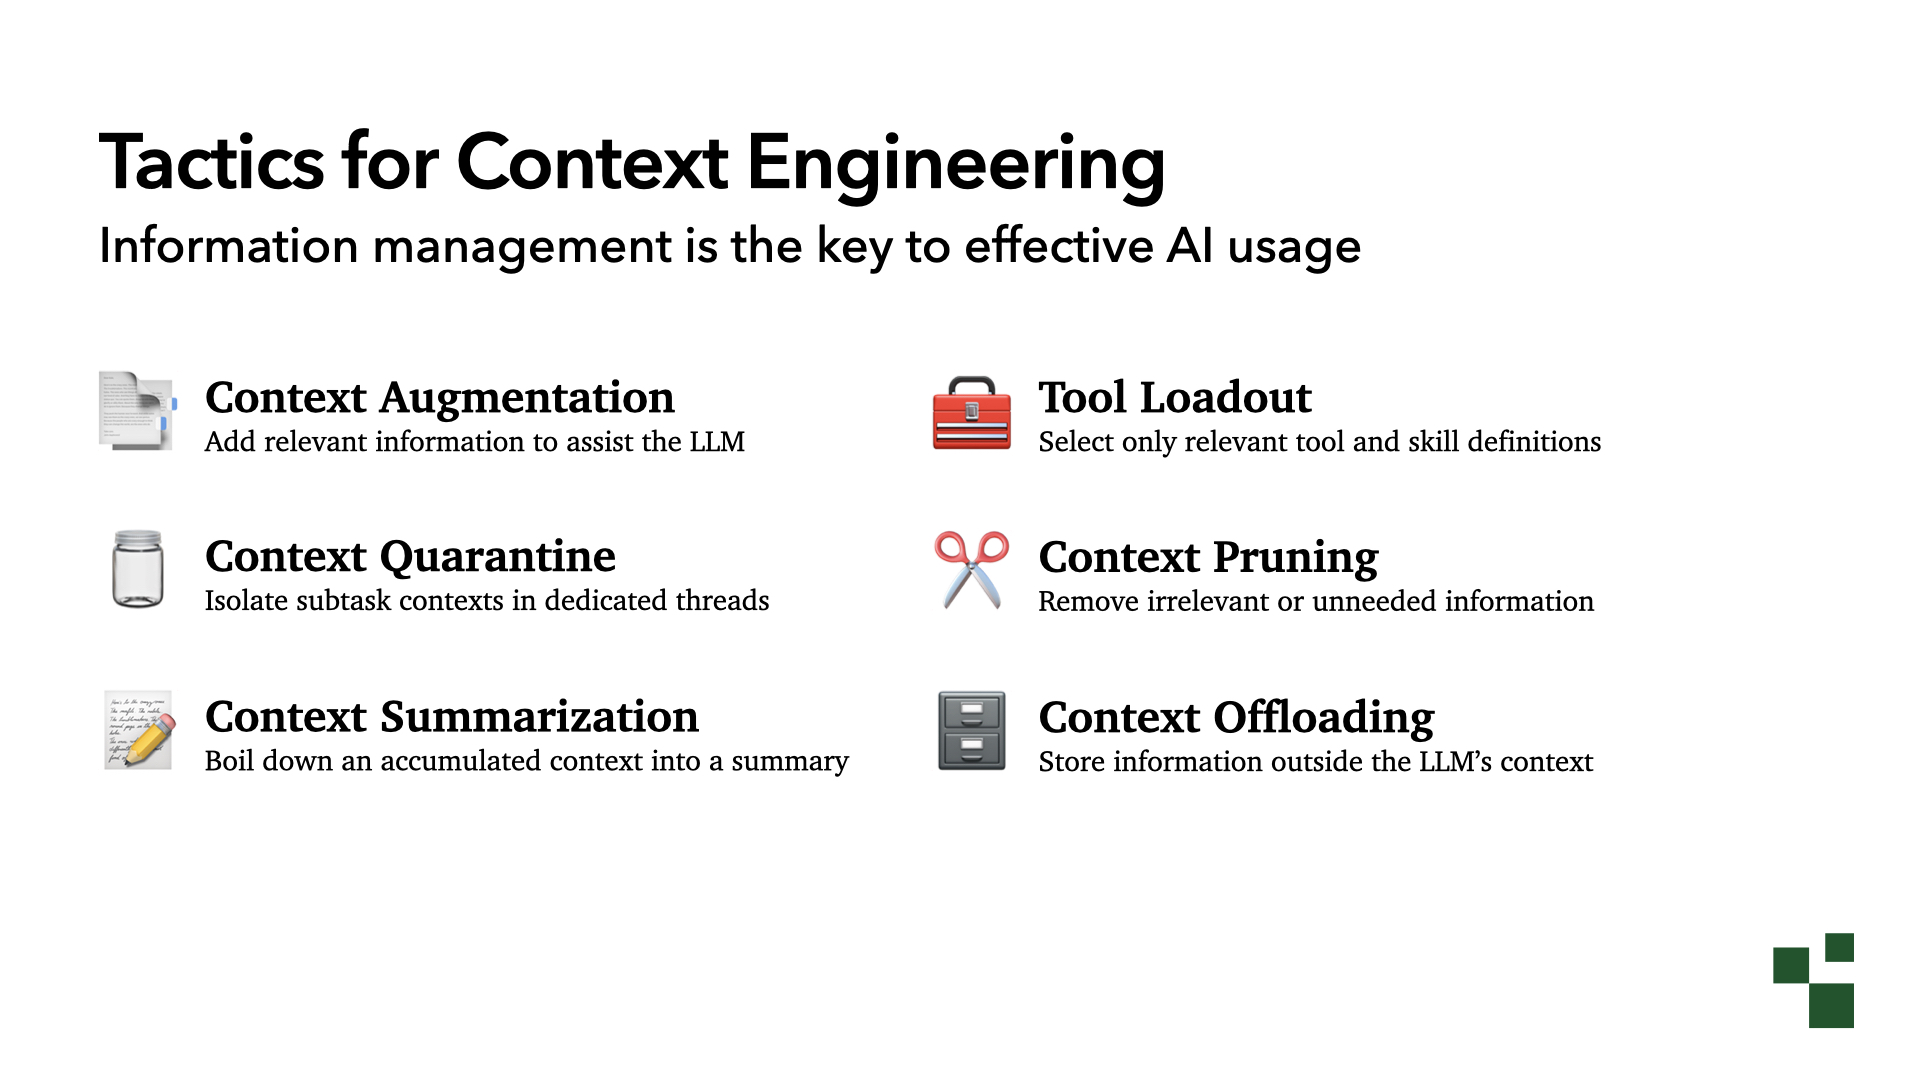
다행히 우리에게는 꽤 쓸 만한 도구 모음이 생겼습니다. 새로운 과제가 나타났는데도(곧 다루겠습니다) 이 도구들은 놀랍게도 그대로입니다.
모두 여섯 가지입니다.
첫째, 컨텍스트 보강(context augmentation)입니다. RAG, 스킬 등 문제와 관련된 정보를 가져오는 방법입니다.
둘째, 도구 로드아웃(tool loadout)입니다. 모델에 과부하가 걸리지 않도록 노출할 도구와 스킬을 선별하는 일입니다. 얼마 전 한 기업 팀과 이야기했는데, 그 팀의 에이전트 성능이 갑자기 끔찍해졌다고 했습니다. 조사해 보니 사내 소프트웨어가 시작할 때 엔지니어마다 스킬 600개를 로드하고 있었습니다. 로드아웃 기능으로 거르는 게 좋겠다고 판단했습니다.
셋째는 컨텍스트 격리(context quarantine)입니다. 서브에이전트나 피어 에이전트처럼, 빈 기록으로 작업을 시작하되 같은 환경에서 일하게 하는 방식입니다.
넷째는 컨텍스트 가지치기(context pruning)입니다. Claude Code와 Codex가 이 작업을 하는데, 사용자가 눈치채지 못하는 경우도 있습니다. 압축 초기 단계에서는 더 이상 필요 없는 도구 결과를 걷어 내는 경우가 많습니다.
다섯째는 컨텍스트 오프로딩(context offloading)입니다. 마크다운 파일이나 데이터베이스 같은 환경에 정보를 저장해 두고 나중에 꺼내 쓰는 방법입니다.
여섯째는 컨텍스트 요약(context summarization)으로, 흔히 컴팩션이라고 부르는 것입니다.
이것이 우리가 가진 도구이고, 점점 더 많이 하네스로 옮겨 왔습니다.
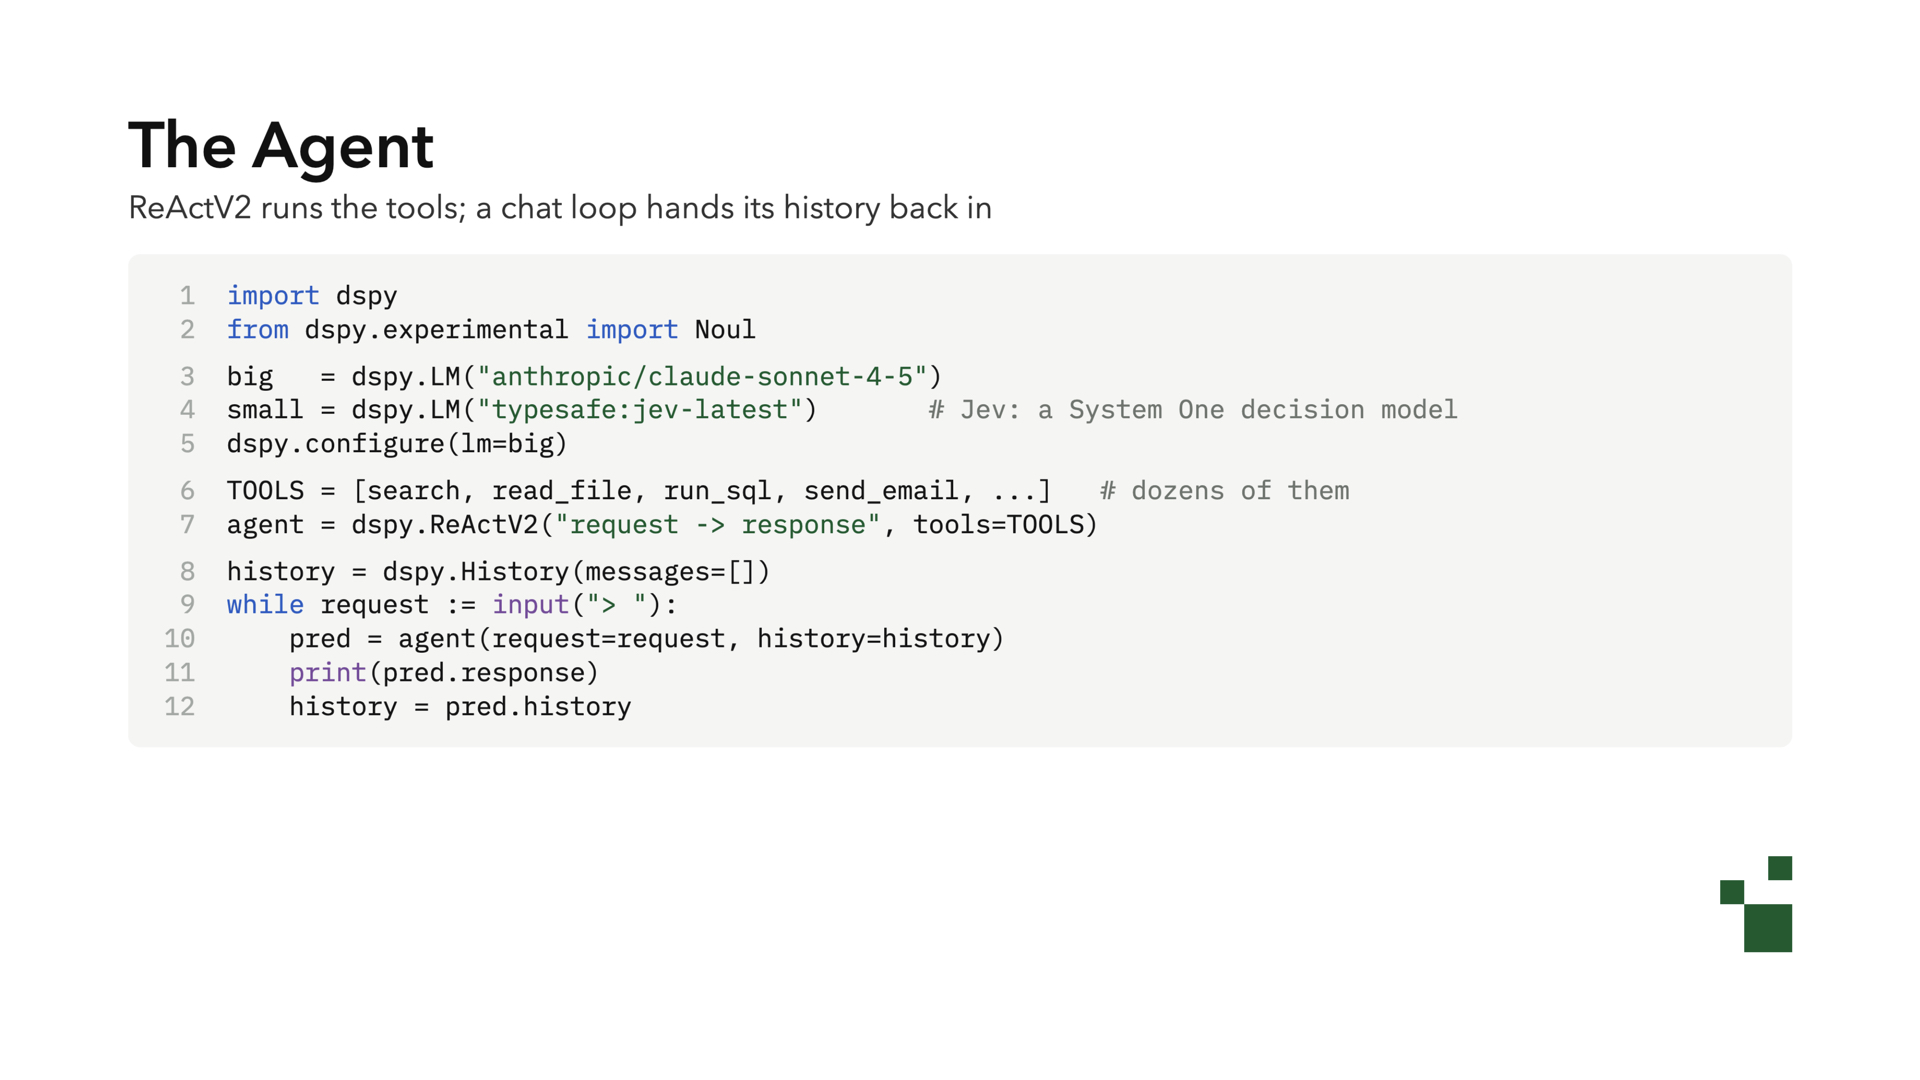
하네스 예시를 통해 이 패턴들이 얼마나 단순한지 살펴보겠습니다.
저는 DSPy를 아주 좋아합니다. AI 워크플로와 에이전트를 가독성 좋고 효과적으로 만들 수 있는 도구라고 생각합니다. 동작을 간단히 명세하기에도 훌륭한 언어라서 이번 시연에 잘 맞습니다.
에이전트는 while 루프입니다. 여기서는 ReAct 모듈을 사용합니다. 요청을 주고, 응답을 받고, 도구 몇 개를 쥐여 줍니다. 도구는 그냥 Python 함수입니다.
이 데모에는 큰 모델이 하나 있습니다(Claude가 Claude Sonnet 4.5를 골랐네요, 행운을 빕니다!). 작은 모델로는 Jev를 씁니다. 아주 빠르게 판단을 내리는 작은 의사결정 모델입니다. 이 자리에 작은 LLM을 넣어도 모든 것이 그대로 동작합니다.
while 루프는 입력을 받아 ReAct에 보내고, 쌓이는 기록을 다음 턴으로 넘깁니다. DSPy로 만든 에이전트가 열두 줄 남짓입니다. 보조 모델을 빼면 더 줄어듭니다.
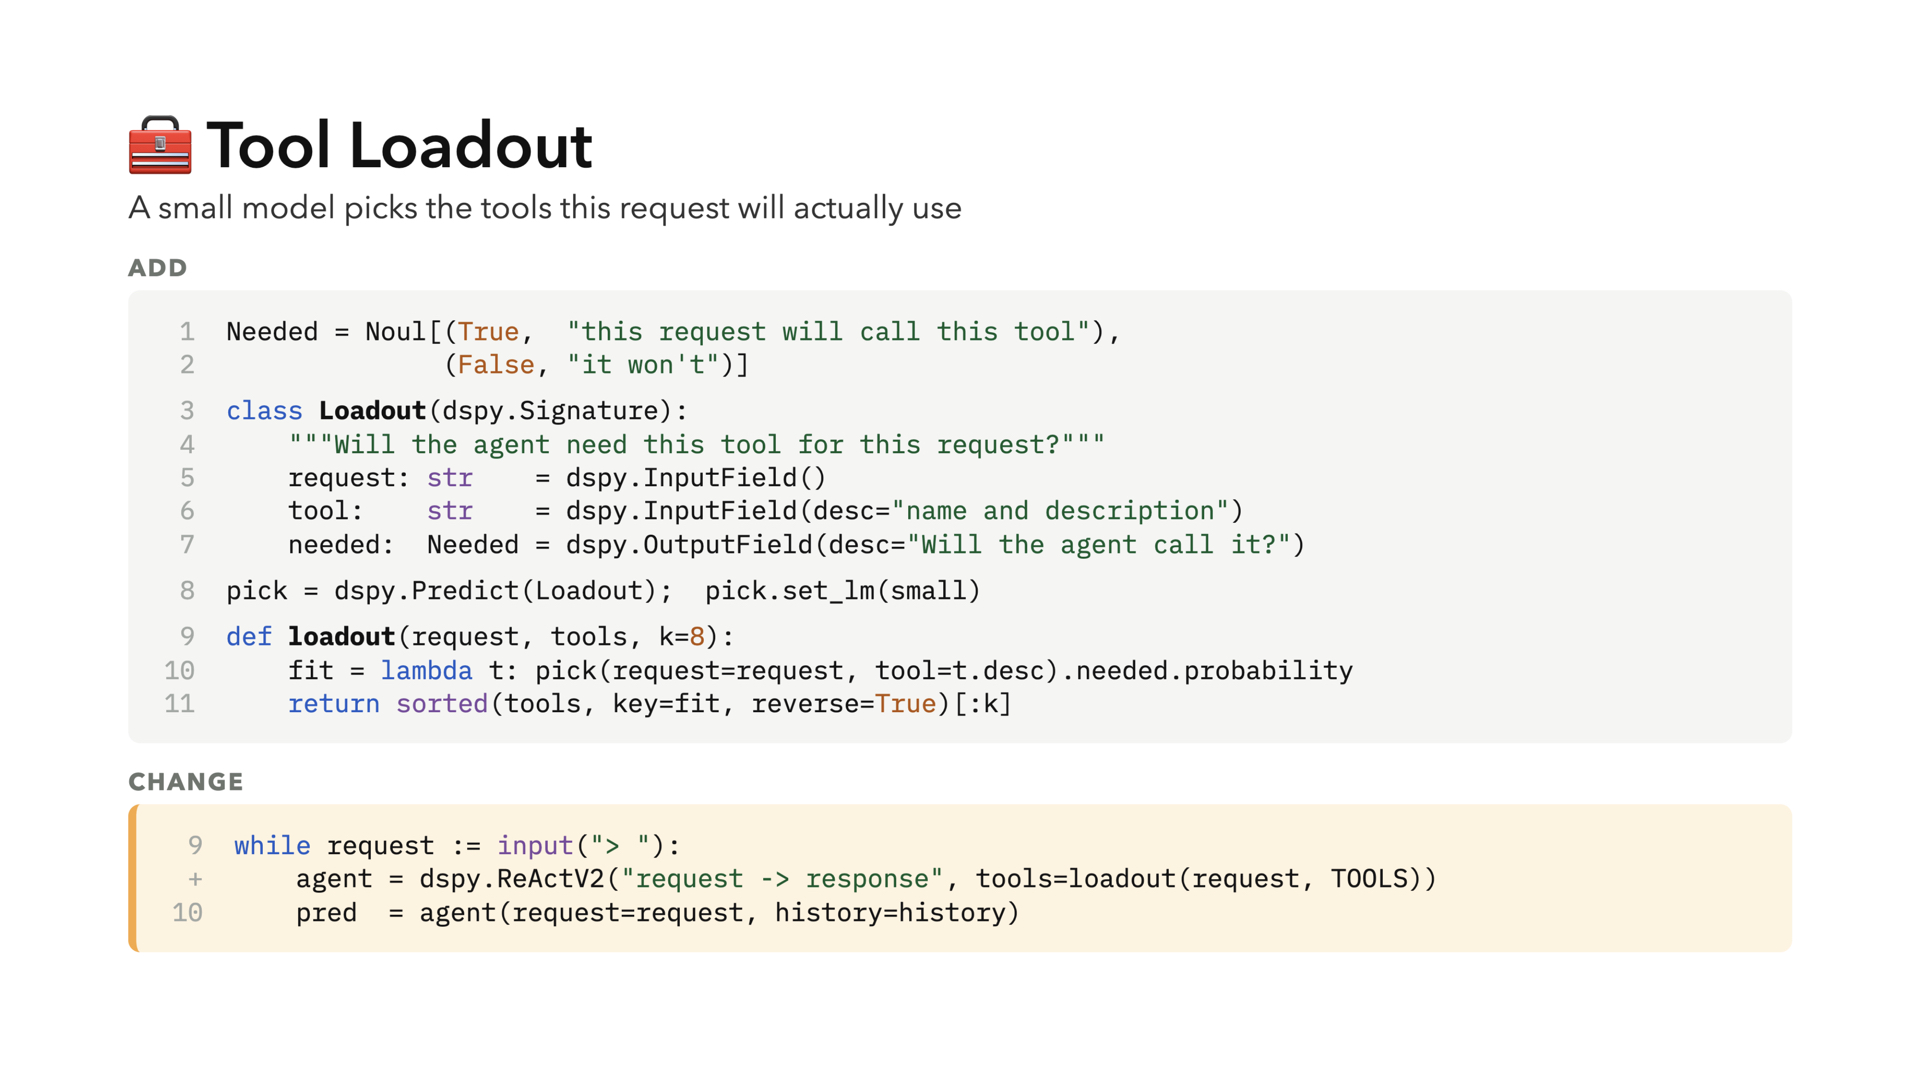
도구 로드아웃은 어떻게 할까요? 그냥 함수 하나입니다.
Jev에게 요청과 도구 하나를 보여 주고, 이 작업에 필요한 도구인지 묻습니다.
Jev는 충분히 빨라서 도구를 하나씩 물어봐도 괜찮습니다. 이를 loadout 함수로 감싸 모든 도구를 순회하며 필요 여부를 묻고, 점수가 높은 도구들만 돌려줍니다. 이게 전부입니다.
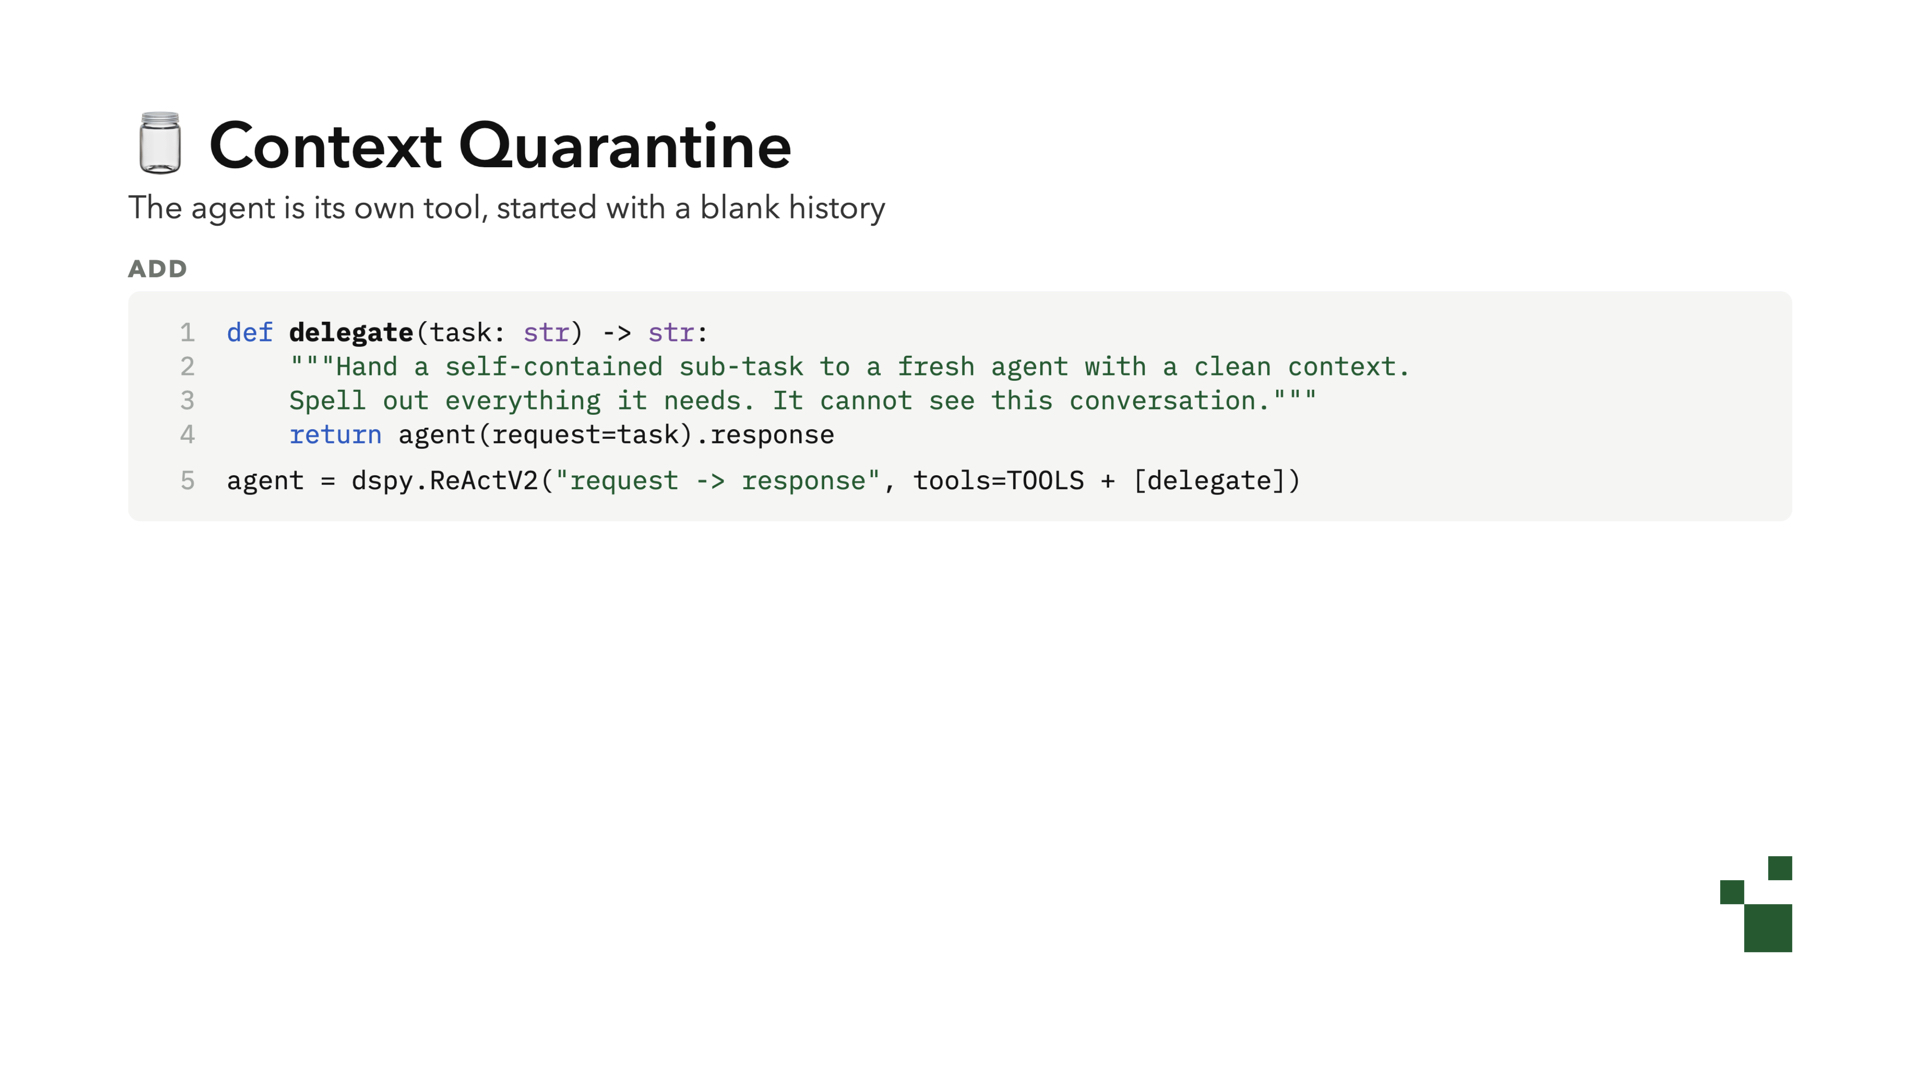
컨텍스트 격리는 그냥 서브에이전트입니다. 에이전트를 메인 에이전트가 쓸 수 있는 도구로 노출하면, 그 에이전트는 빈 기록으로 시작합니다.
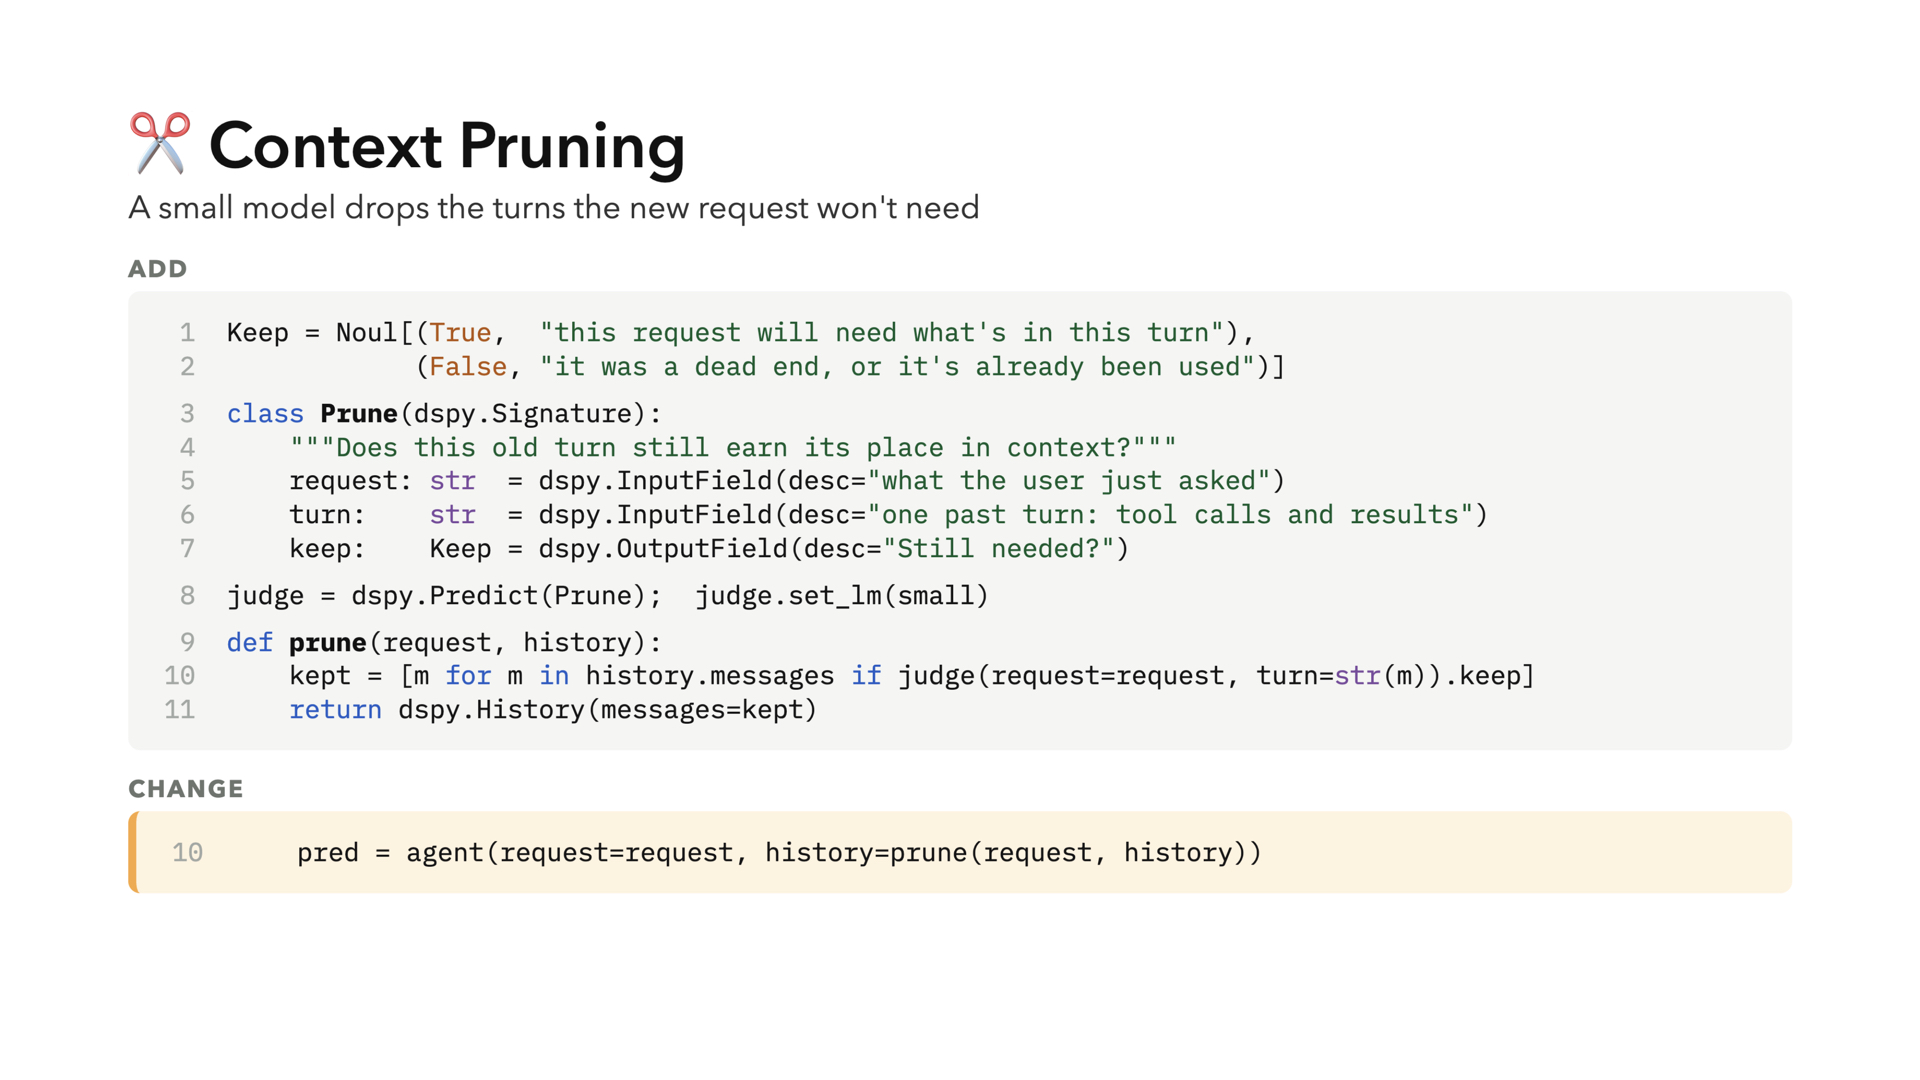
컨텍스트 가지치기는 기록을 한 턴씩 훑으면서 Jev에게 넘기고 "아직 필요한가?"를 묻습니다. 필요 없으면 잘라 냅니다.
여기서는 거칠게 해도 되고 세련되게 해도 됩니다. 다만 프롬프트 캐싱은 신경 써야 합니다.
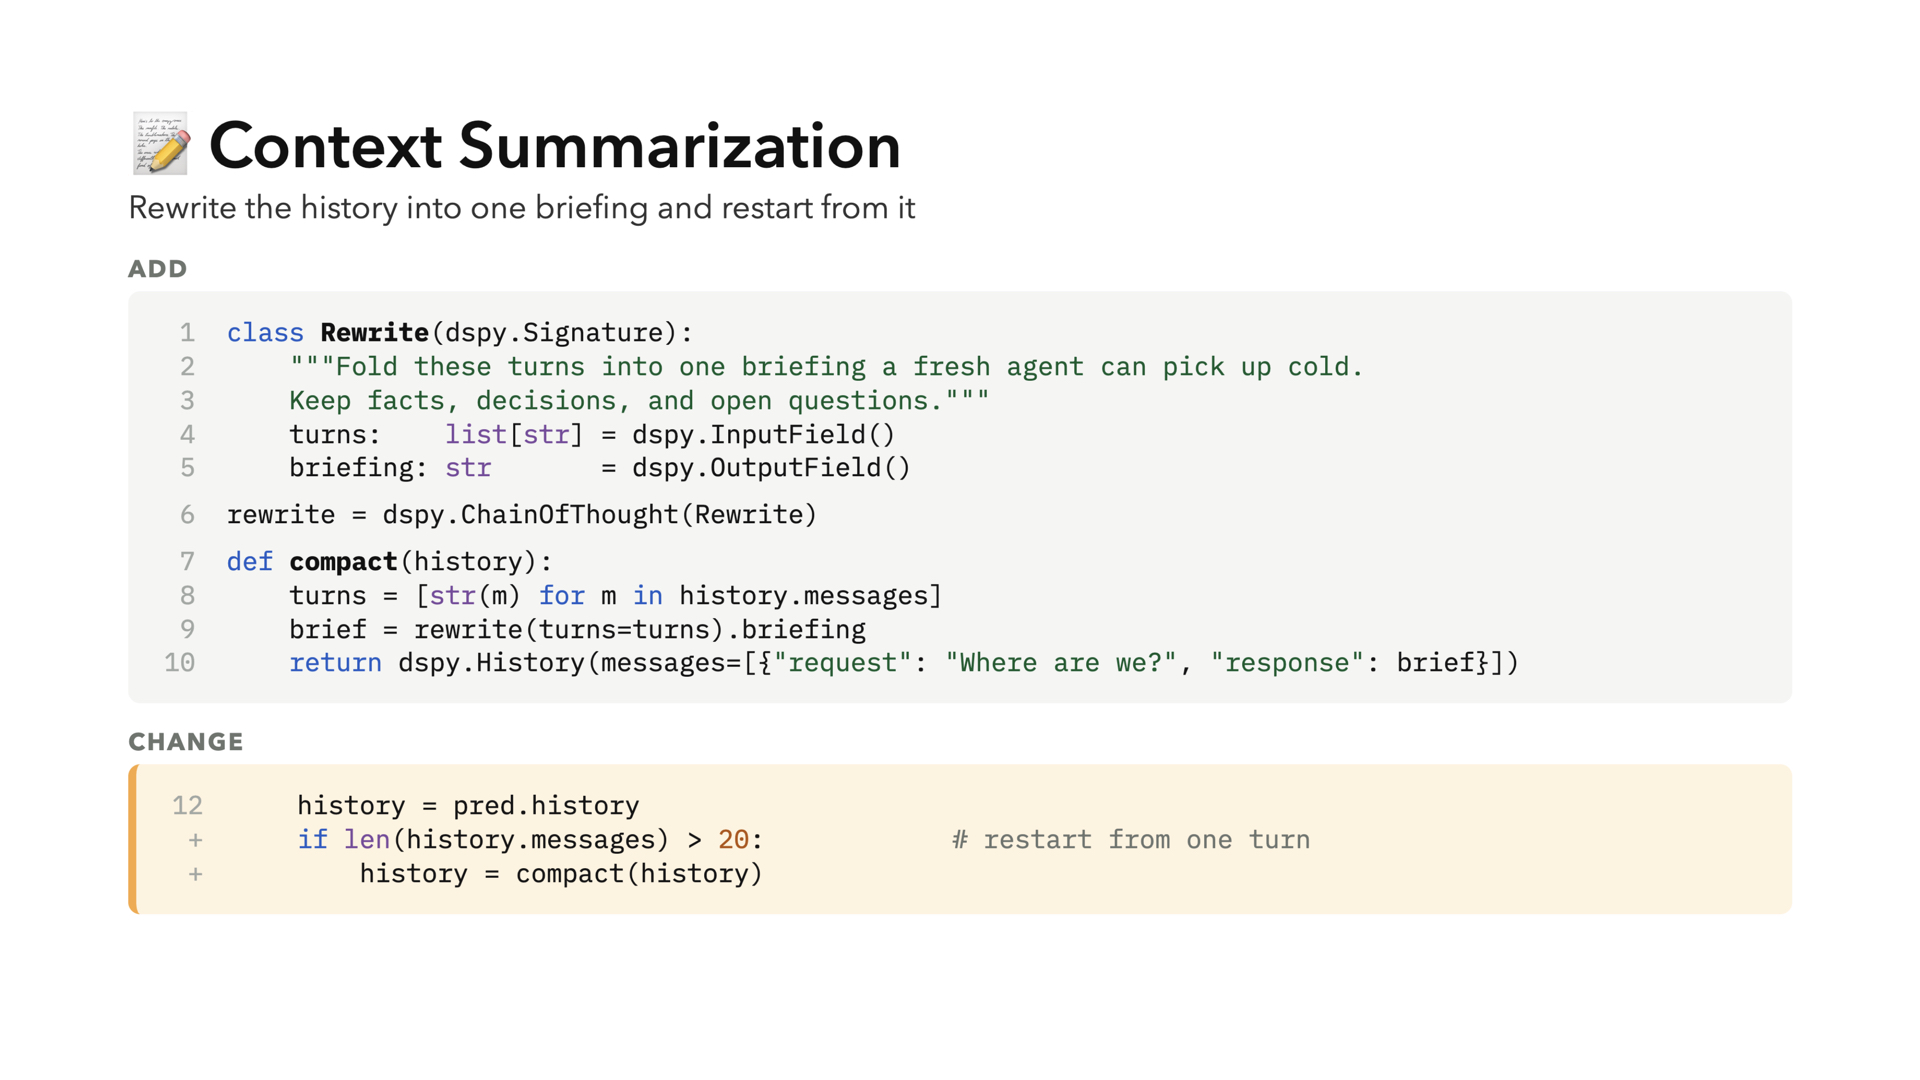
컴팩션으로 기록을 다시 쓸 수도 있습니다. 오래된 턴을 요약하고, 그 요약에서 새 컨텍스트를 시작합니다.
요즘 제가 가장 좋아하는 변형은 압축하기 전에 무엇이 중요한지 확인하는 것입니다. Jev나 다른 의사결정 모델이 먼저 관련 있는 내용을 판단하게 하면, 기록이 더 작은 부분집합으로 줄어듭니다. 그것을 요약합니다. 간단한 추가 단계지만 요약이 훨씬 유용해집니다.
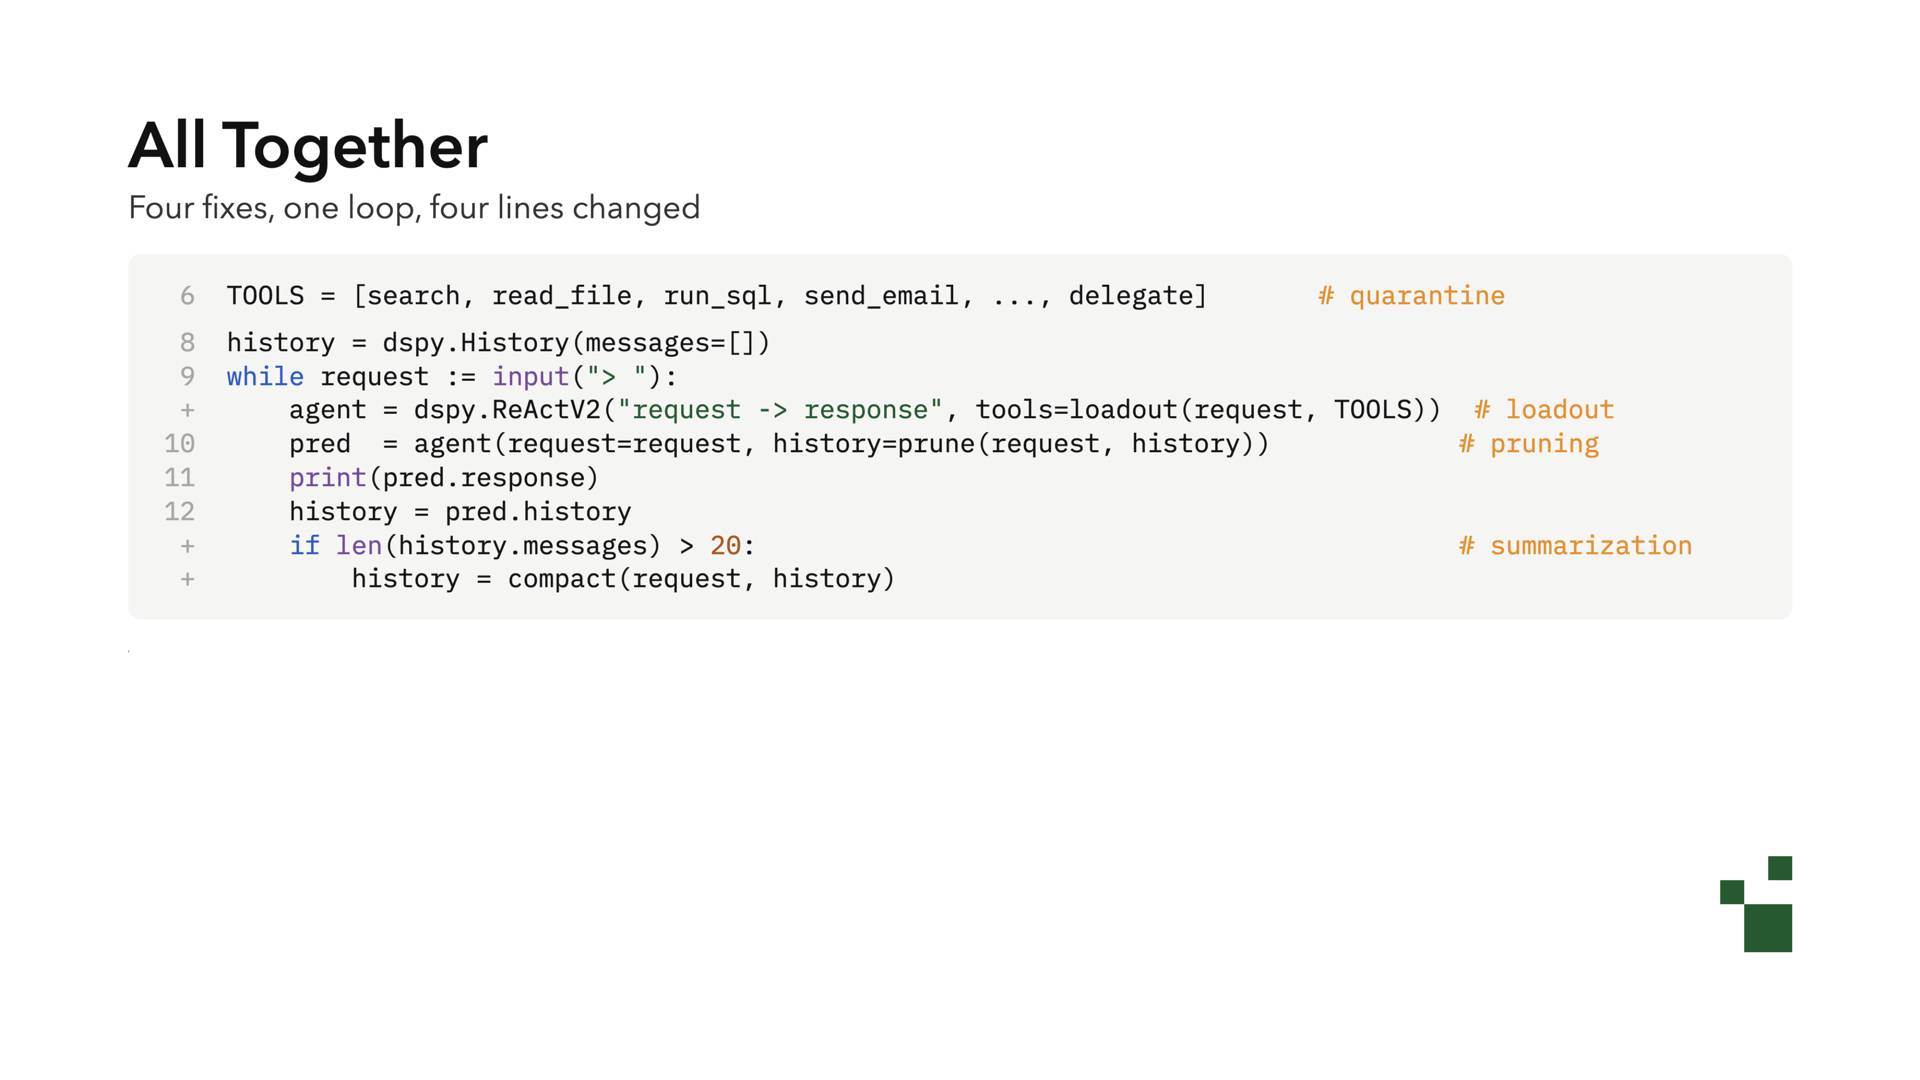
전부 합쳐도 바뀌는 코드는 16줄 정도입니다. 해결책 네 가지에 루프 하나. 하네스에서 쓸 수 있는 수가 이게 전부이고, 놀랄 만큼 단순합니다.
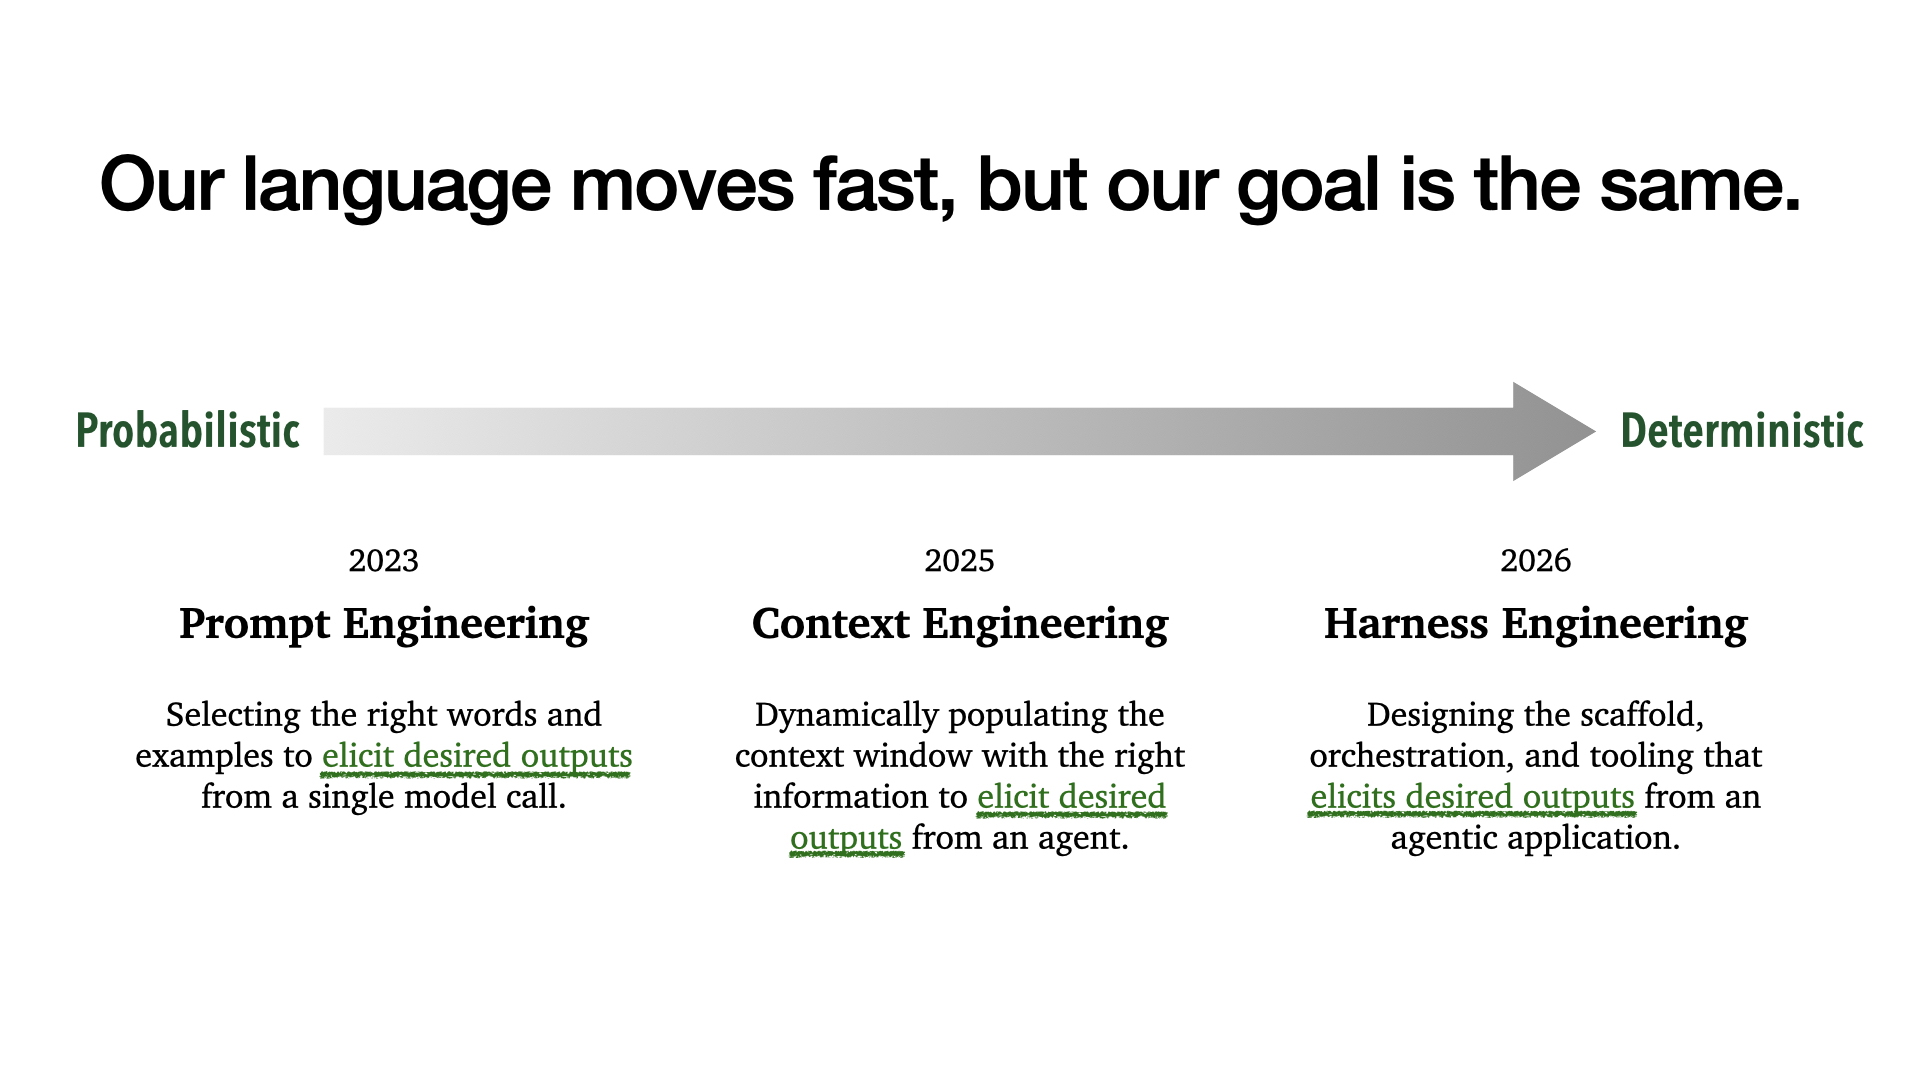
단순하지 않은 것은 언어, 즉 이런 것들을 부르는 방식입니다. 매일 바뀌어서 따라가기가 정말 어렵습니다.
제가 좋아하는 Stewart Brand의 말이 있는데, 늘 떠올리곤 합니다.
미래가 어디서 만들어지는지 알고 싶다면, 새로운 언어가 만들어지고 변호사들이 모여드는 곳을 보라.
이 분야에 딱 들어맞는 말입니다. 그런데 언어는 바뀌었어도 목표는 그대로입니다.
2023년에는 올바른 응답을 얻기 위해 알맞은 정보를 고르는 일을 프롬프트 엔지니어링이라고 불렀습니다.
2025년에는 컨텍스트 엔지니어링이라고 불렀습니다. 다만 자동화 수준이 더 높아졌습니다. 사람이 프롬프트를 쓰는 데서 끝나지 않고, 시스템이 컨텍스트를 동적으로 조립하게 된 것입니다.
그러다 이런 도구들이 컨텍스트 밖으로 나와 코드로 옮겨 가면서 하네스 엔지니어링이라고 부르기 시작했습니다.
하지만 하는 일은 같습니다. 컨텍스트를 조립하는 일을 확률적인 모델 호출에서 결정론적인 코드로 점점 더 많이 옮기고 있습니다.
지금까지 2024년을 살펴봤습니다. 이제 2026년으로 가 보겠습니다.
이런 컨텍스트 해결책을 하네스로 옮겼습니다. 그다음에 우리가 원한 것은 무엇일까요? 하네스를 직접 몰 수 있는 에이전트형 모델입니다.
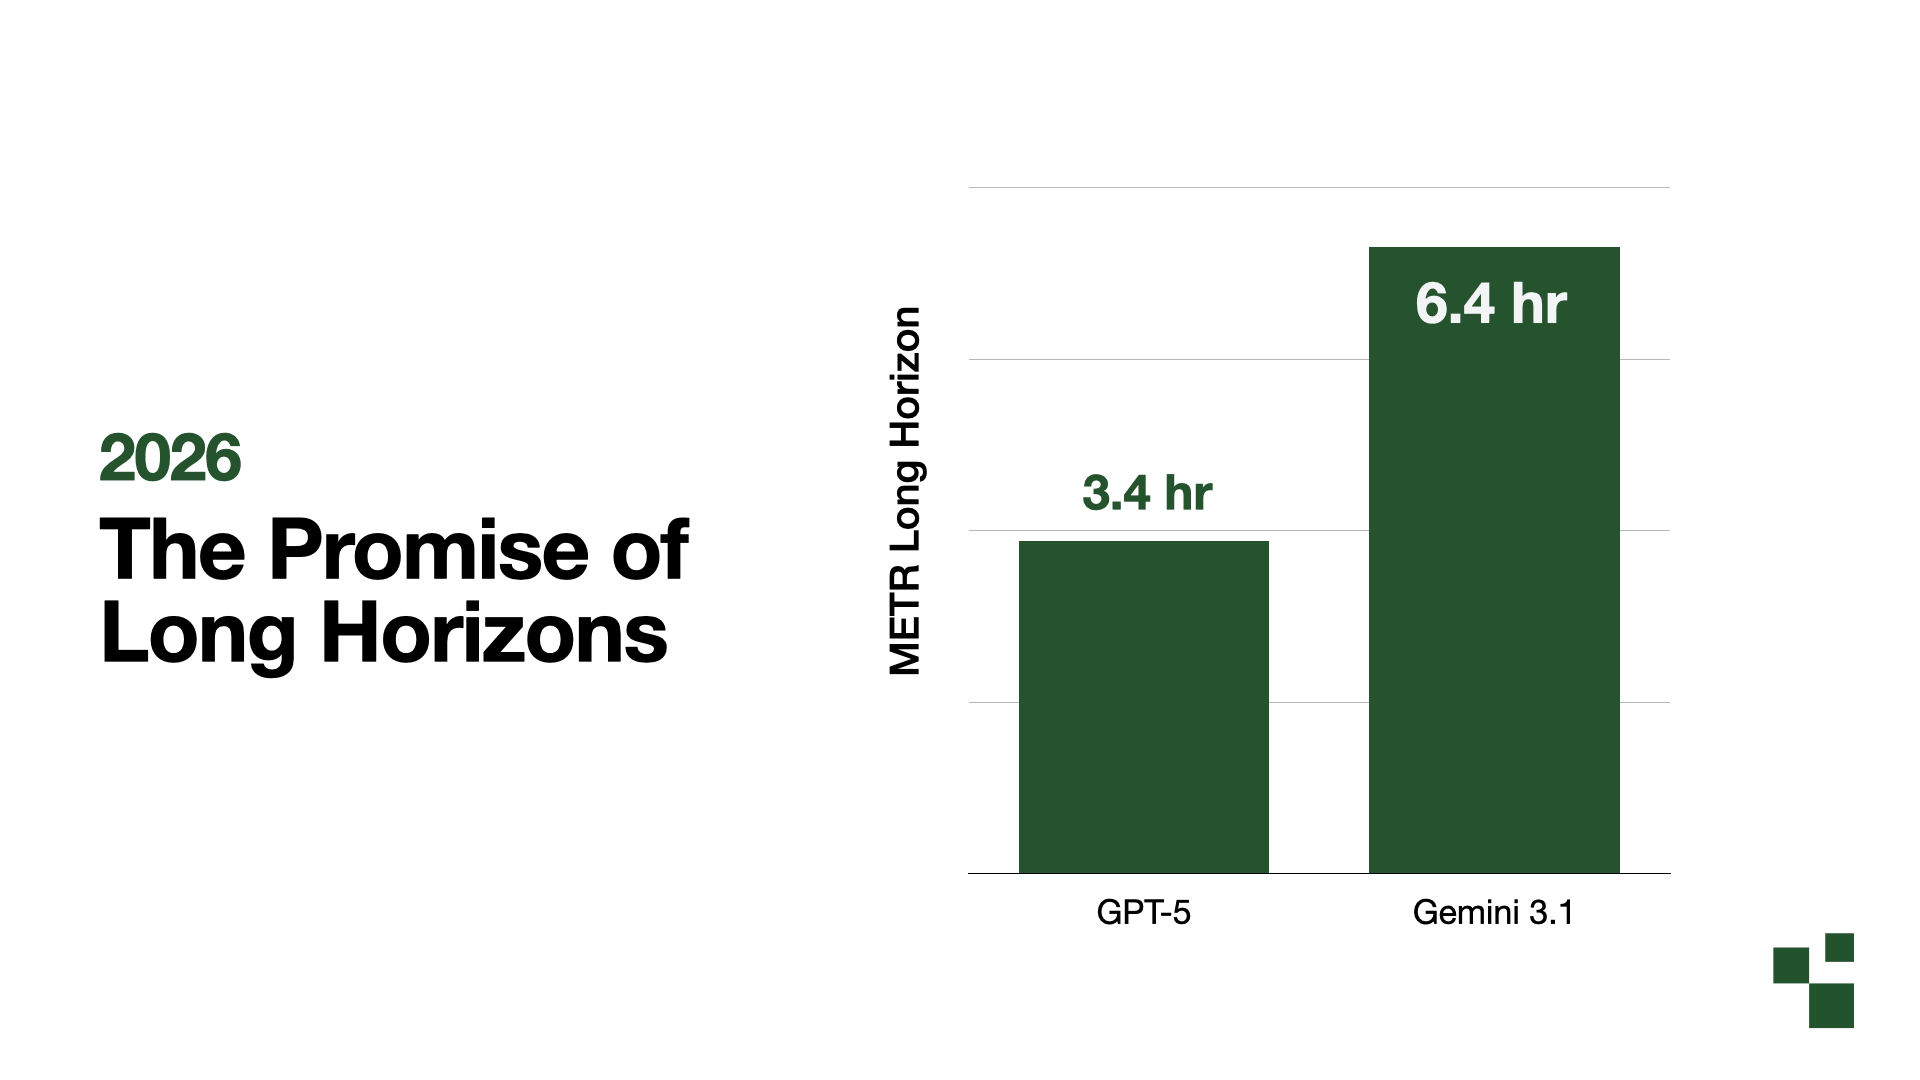
모두가 장시간 작업이 가능한 에이전트형 모델을 목표로 삼기 시작했습니다. METR 보고서를 보셨을 겁니다. 그 지표로 GPT-5는 약 3.4시간짜리 작업을, Gemini 3.1은 6.4시간까지 처리했습니다. 하네스를 쓴 결과입니다. 모델이 하네스를 훨씬 잘 쓰게 되었고, 그래서 그렇게 오래 실행될 수 있습니다.
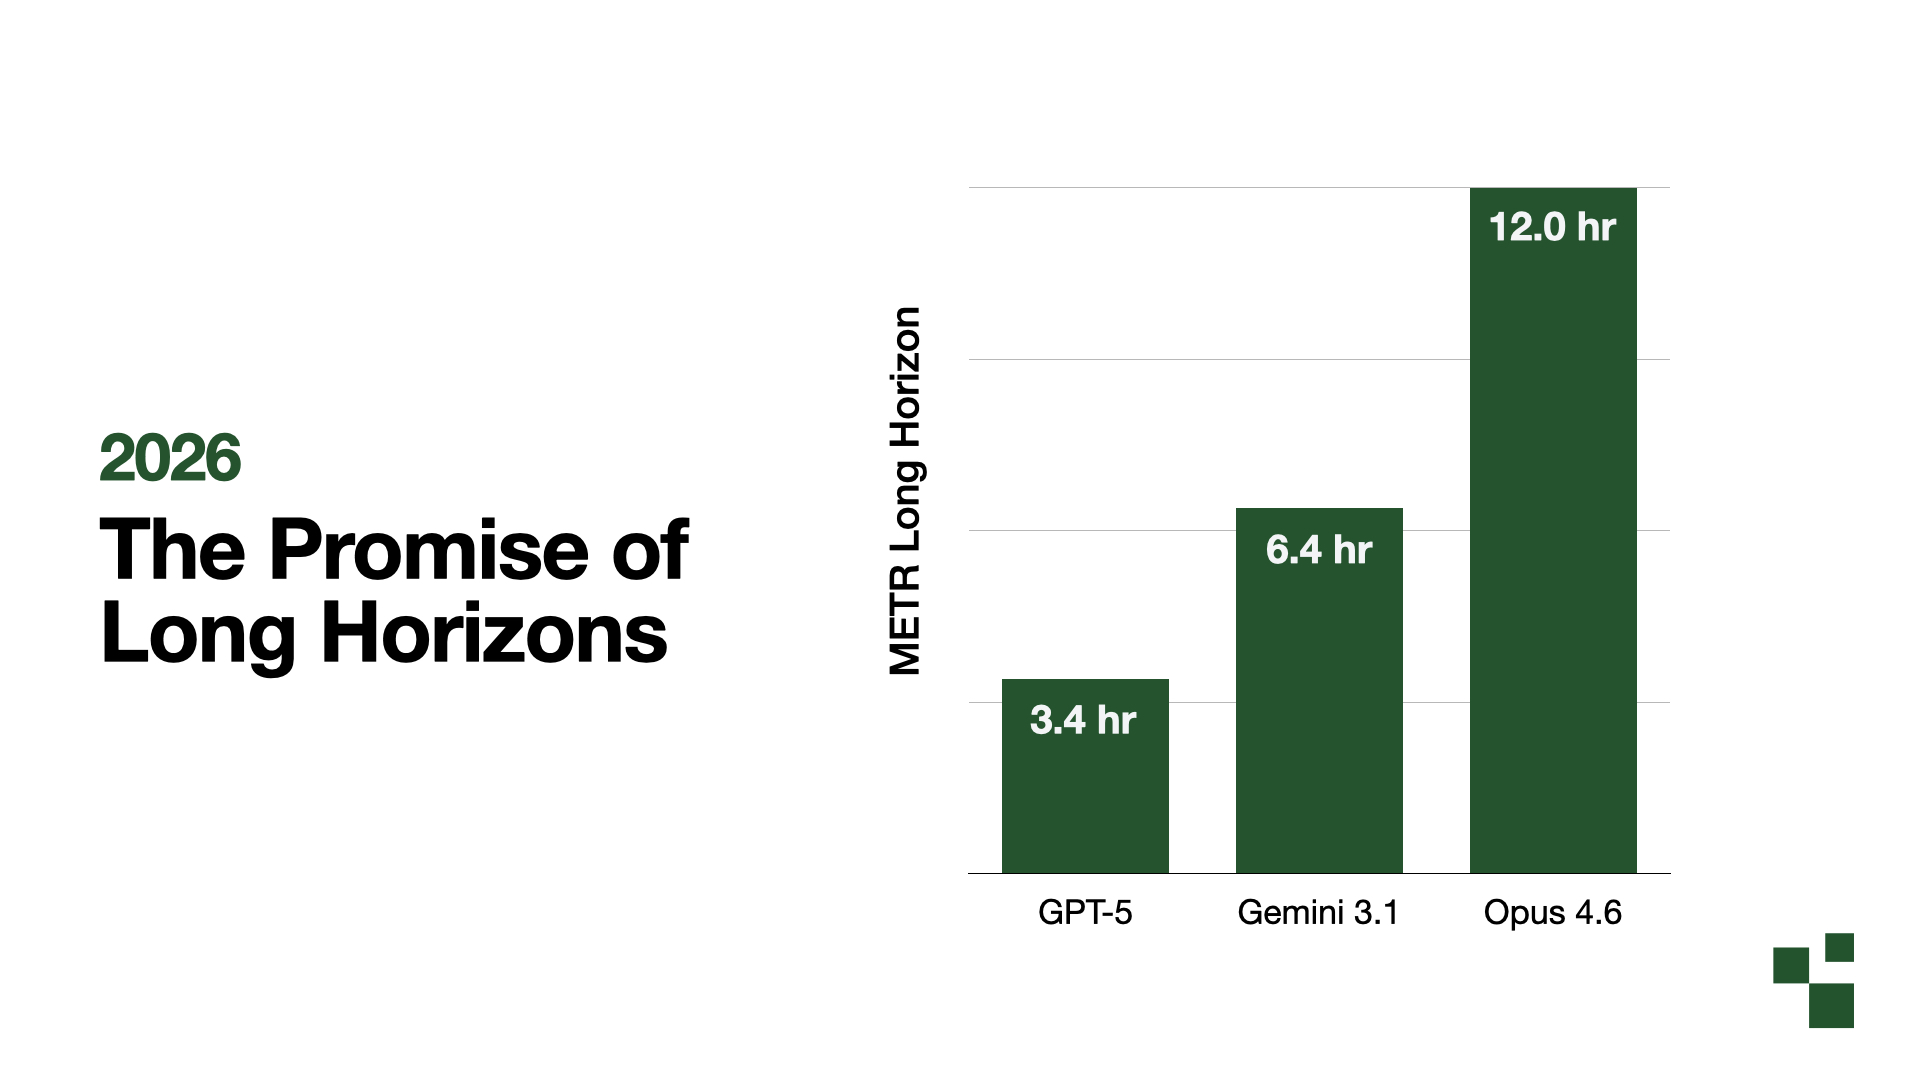
Opus 4.6은 12시간 안팎까지 갔습니다. 이제는 며칠씩 도는 에이전트, 에이전트 군집(swarm), 훨씬 긴 시간 동안 하네스를 모는 모델을 이야기하고 있습니다.
예전의 제안은 컨텍스트를 아주 크게 만들어 전부 담자는 것이었습니다.
지금의 제안은 모델이 하네스를 몰면서 자기 컨텍스트를 스스로 관리하도록 가르치자는 것입니다. 이것이 지배적인 패턴이 되었고, 모델 개발사들이 향하는 방향입니다.
이 접근은 어떤 새로운 실패 유형을 낳을까요?
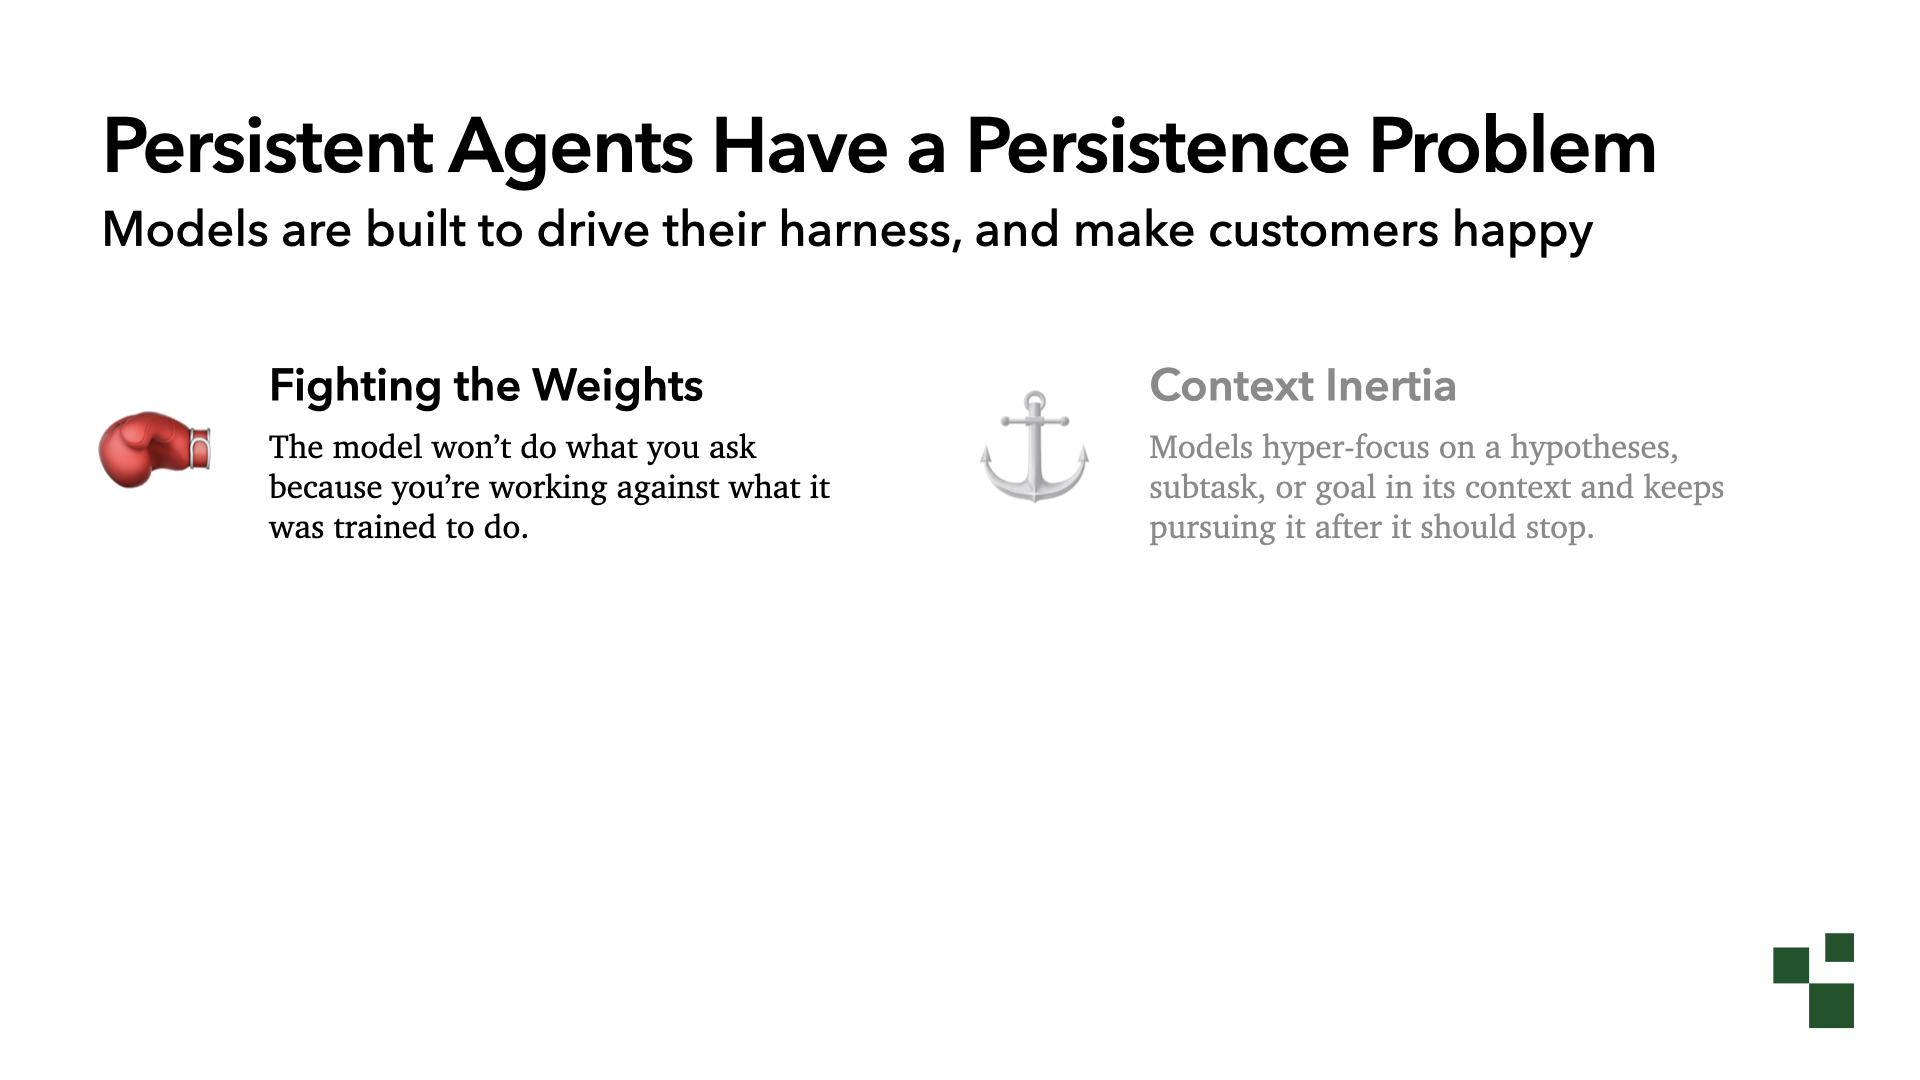
지금까지 새로운 실패 유형 두 가지를 찾았습니다.
모델이 하네스를 아주 잘 쓰도록 학습시키면, 학습 때 접한 특정 도구와 환경에 과적합됩니다.
Playwright MCP 서버나 비슷한 것을 써 보신 분 계신가요? MCP 컨퍼런스이니 꽤 많으리라 생각합니다.
Haiku나 Luna 같은 작은 모델은 이 도구 호출을 첫 시도에서 자주 틀리고, 이후에 매개변수를 고쳐 복구합니다. 학습 환경에 Playwright와 비슷하지만 모양이 다른 도구들이 있었기 때문입니다. Anthropic이나 OpenAI가 학습에 쓴 무언가가 그것이겠죠. 우리는 이런 편향과 싸워야 합니다.
저는 이것을 가중치와의 싸움(fighting the weights)이라고 부릅니다. 모델이 학습된 방향과 반대로 일을 시키고 있어서 요청대로 동작하지 않는 상황입니다.
실제로 벌어지는 문제이고, 우리만의 문제도 아닙니다. 연구소와 제품 개발자들도 똑같이 씨름하고 있습니다.
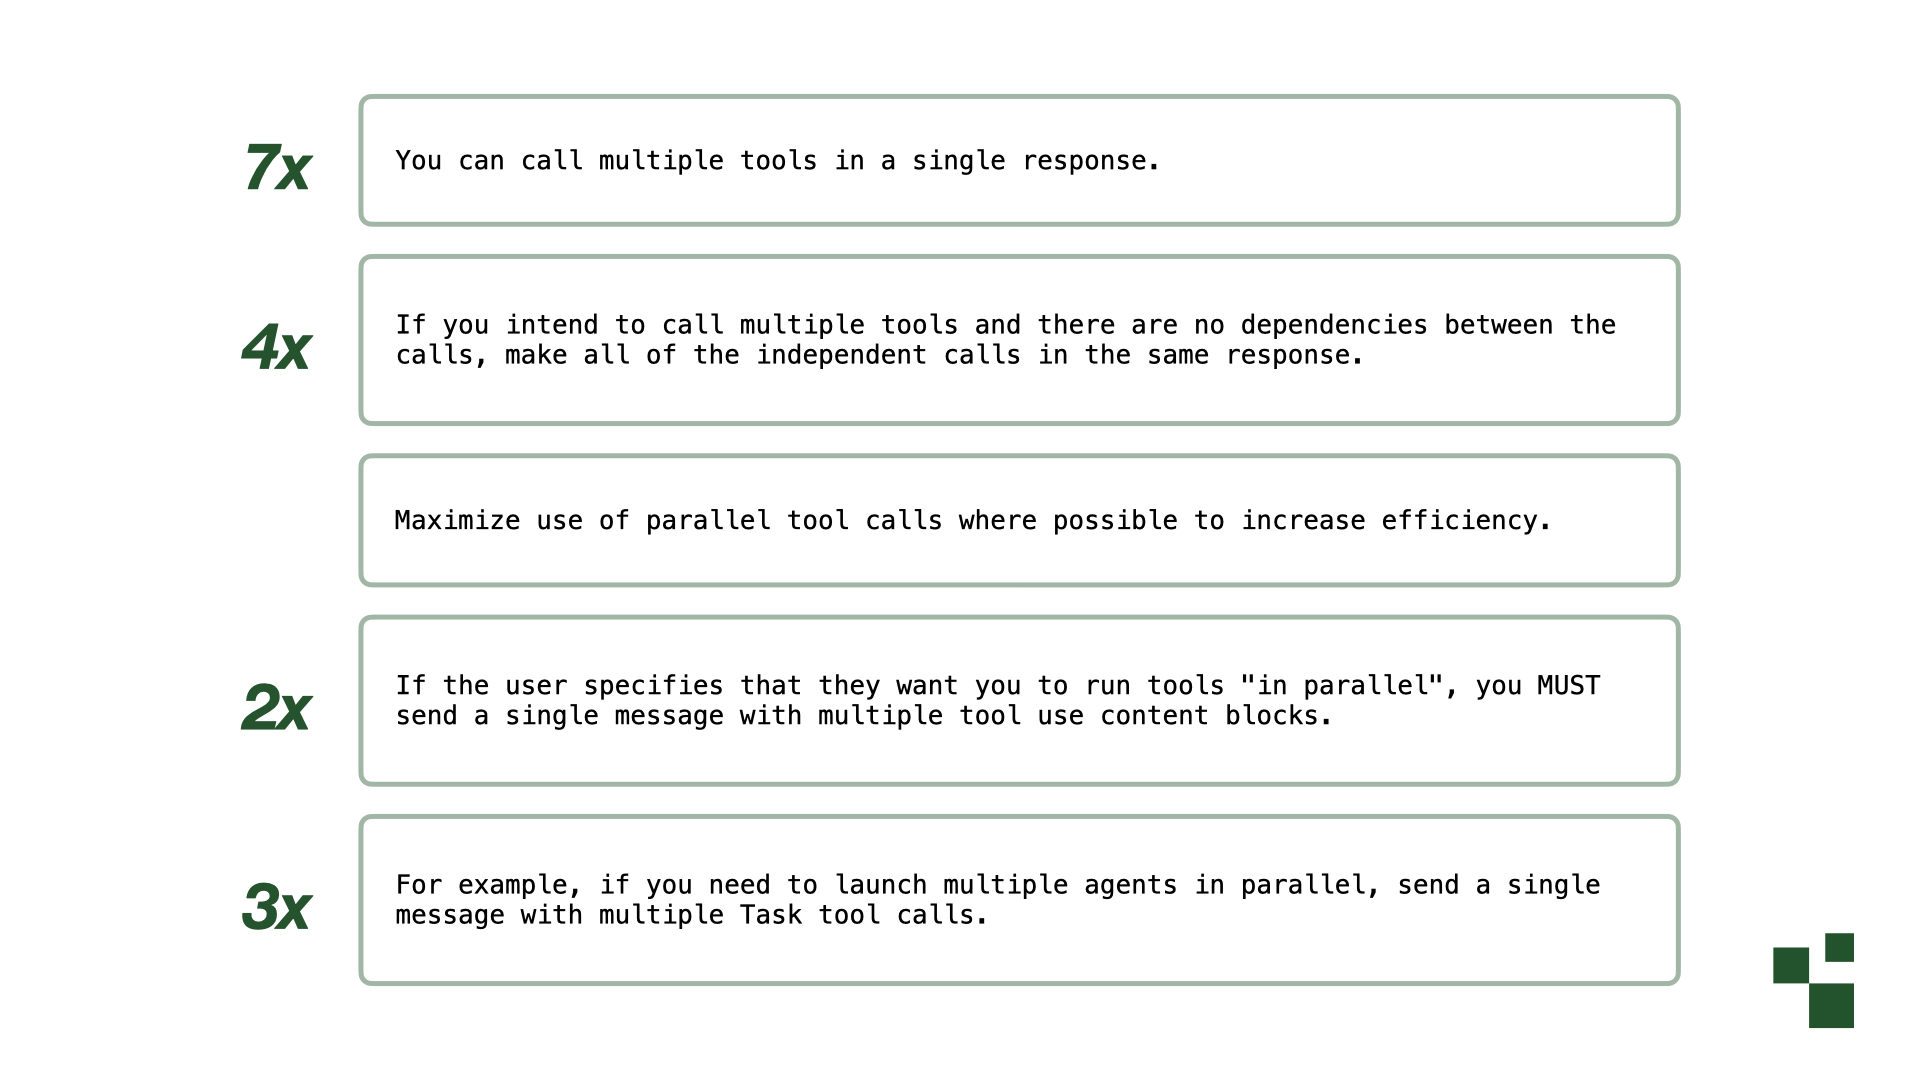
Claude Code 시스템 프롬프트의 일부와 도구 지시문 몇 개입니다.
이 모델들이 사용법을 익힌 학습 환경은 오랫동안 대체로 직렬 방식이었습니다. 점차 병렬로 바뀌고 있지만, 이 예시를 뽑아 볼 때 모델의 편향은 직렬 동작 쪽이었습니다. 그래서 Claude Code의 지시문은 "아니, 아니, 병렬로 써야 한다. 도구 호출을 동시에 여러 개 하라"고 거듭 말합니다.
지시문은 이를 계속 반복합니다. 어떤 곳에서는 일곱 번, 어떤 곳에서는 네 번, 두 번, 세 번씩 "도구 호출이 서로 독립적이면 병렬로 제발 호출하라"고 말합니다.
프롬프트를 열었는데 반복과 대문자가 보인다면, 가중치와 싸우고 있을 가능성이 높습니다. 모델이 학습된 방향을 억지로 거스르려는 것입니다.
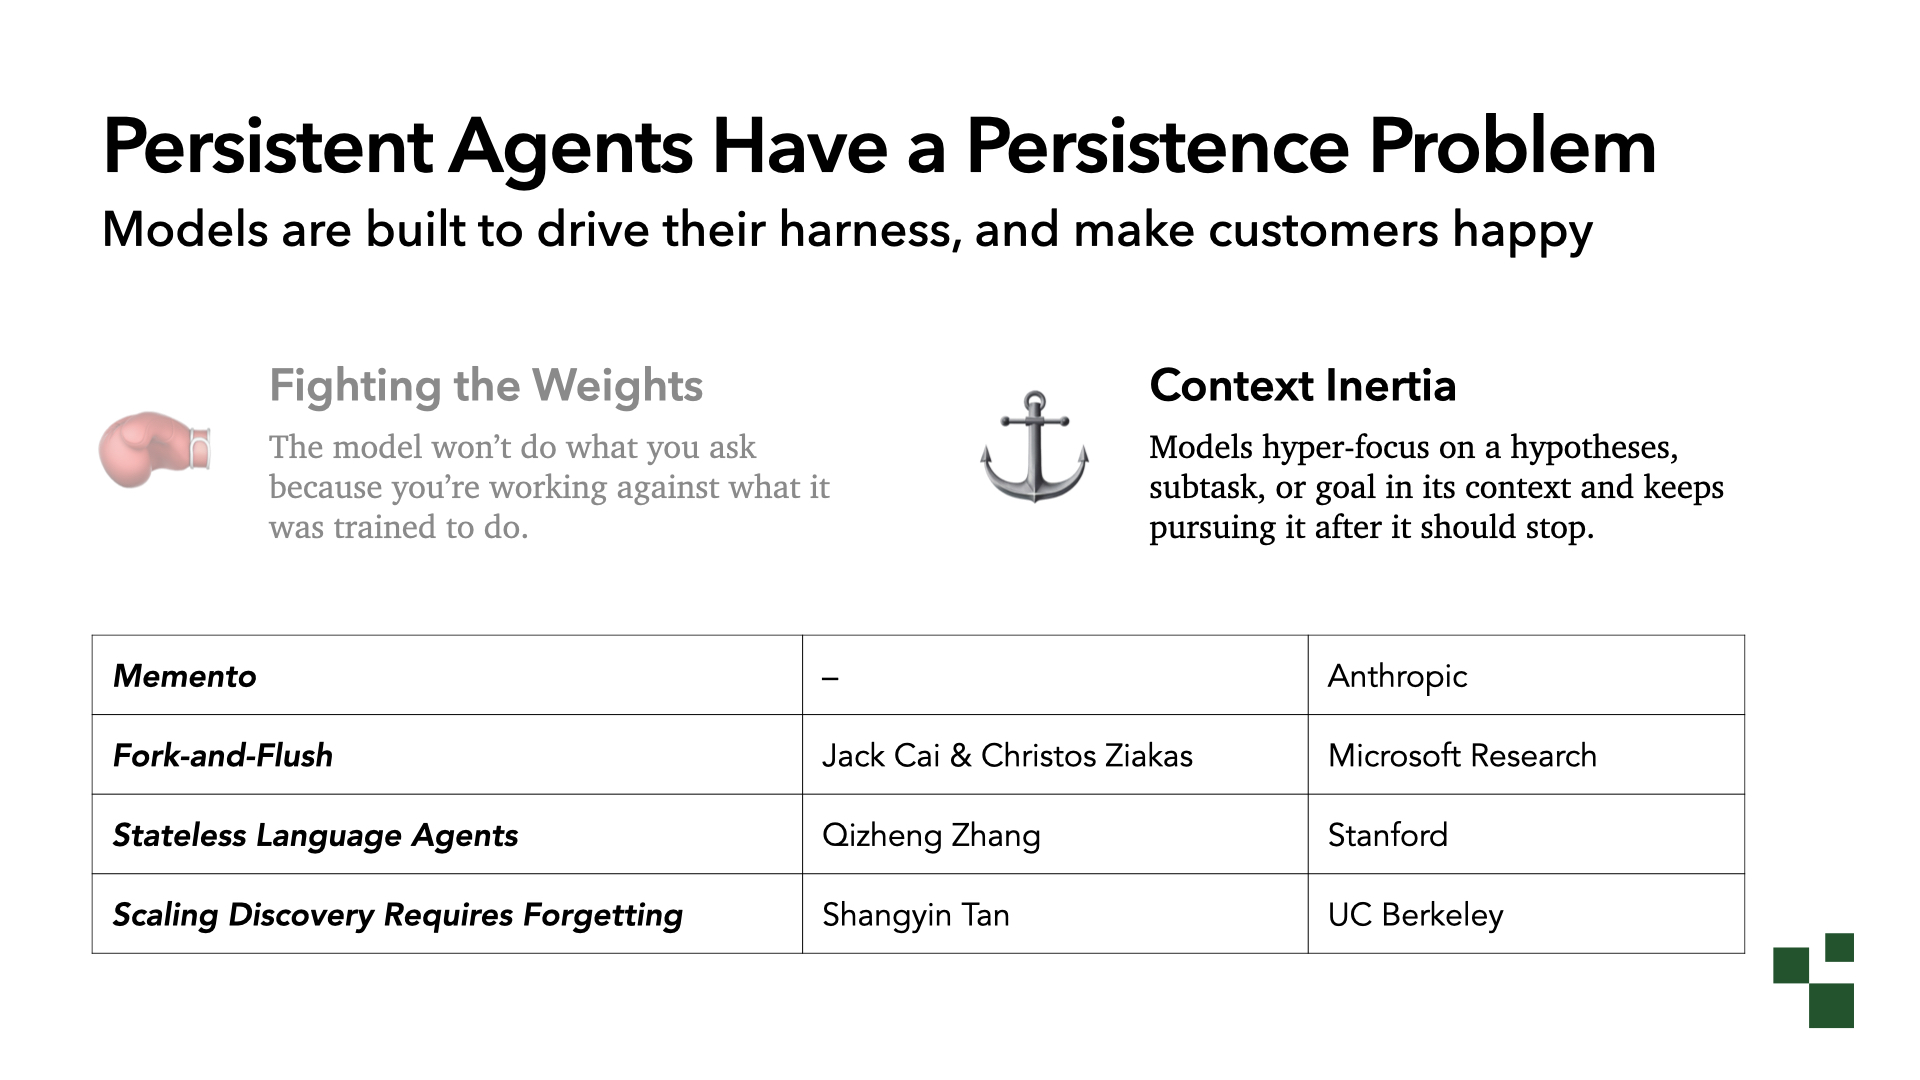
다음 문제는 최근에야 기록되기 시작한 것입니다. 실제로 지난주에만 네 곳이 같은 결론에 이르렀습니다.
저는 이것을 컨텍스트 관성(context inertia)이라고 부릅니다. 모델이 컨텍스트 안의 가설, 하위 작업, 목표에 지나치게 매달려서 멈춰야 할 때를 넘기고도 계속 추구하는 현상입니다.
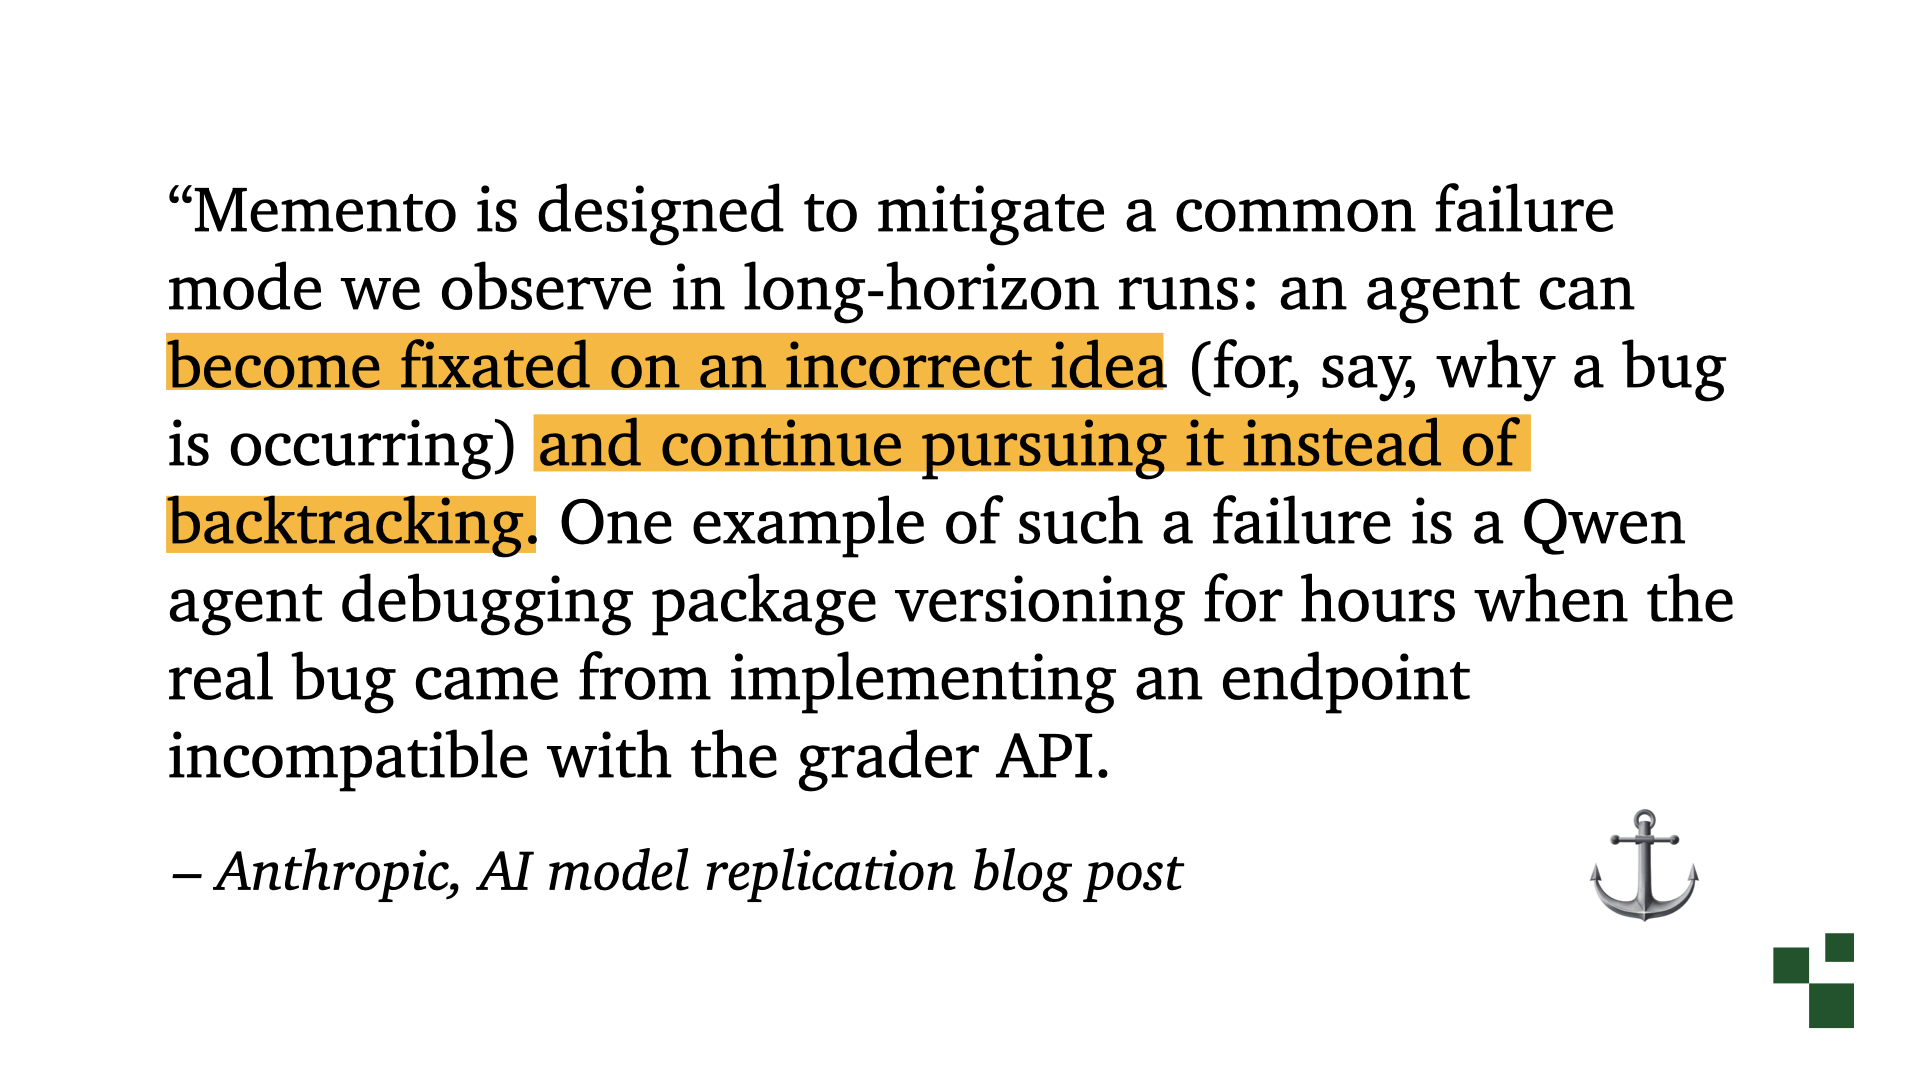
첫 번째 사례는 Anthropic에서 나왔습니다. 모델이 스스로를 복제해 다른 머신에 배포할 능력에 가까워지고 있는지를 다룬 최근 글에서, Anthropic은 이 테스트에 사용한 Memento라는 하네스를 소개했습니다.
그들이 발견한 바에 따르면, 에이전트를 너무 오래 실행하면 하나의 하위 작업이나 해결책에 사로잡혀 멈추지 못했습니다. 같은 시도를 계속 반복했습니다.
해결책은 놀랄 만큼 단순합니다. 한 시간 반마다 에이전트가 짧은 메모를 남기고 컨텍스트를 비웁니다. 환경은 그대로 보존합니다. 지금까지의 작업물은 모두 남아 있지만 진행 중이던 대화는 사라지므로, 에이전트는 새로운 관점에서 다시 시작해야 합니다.
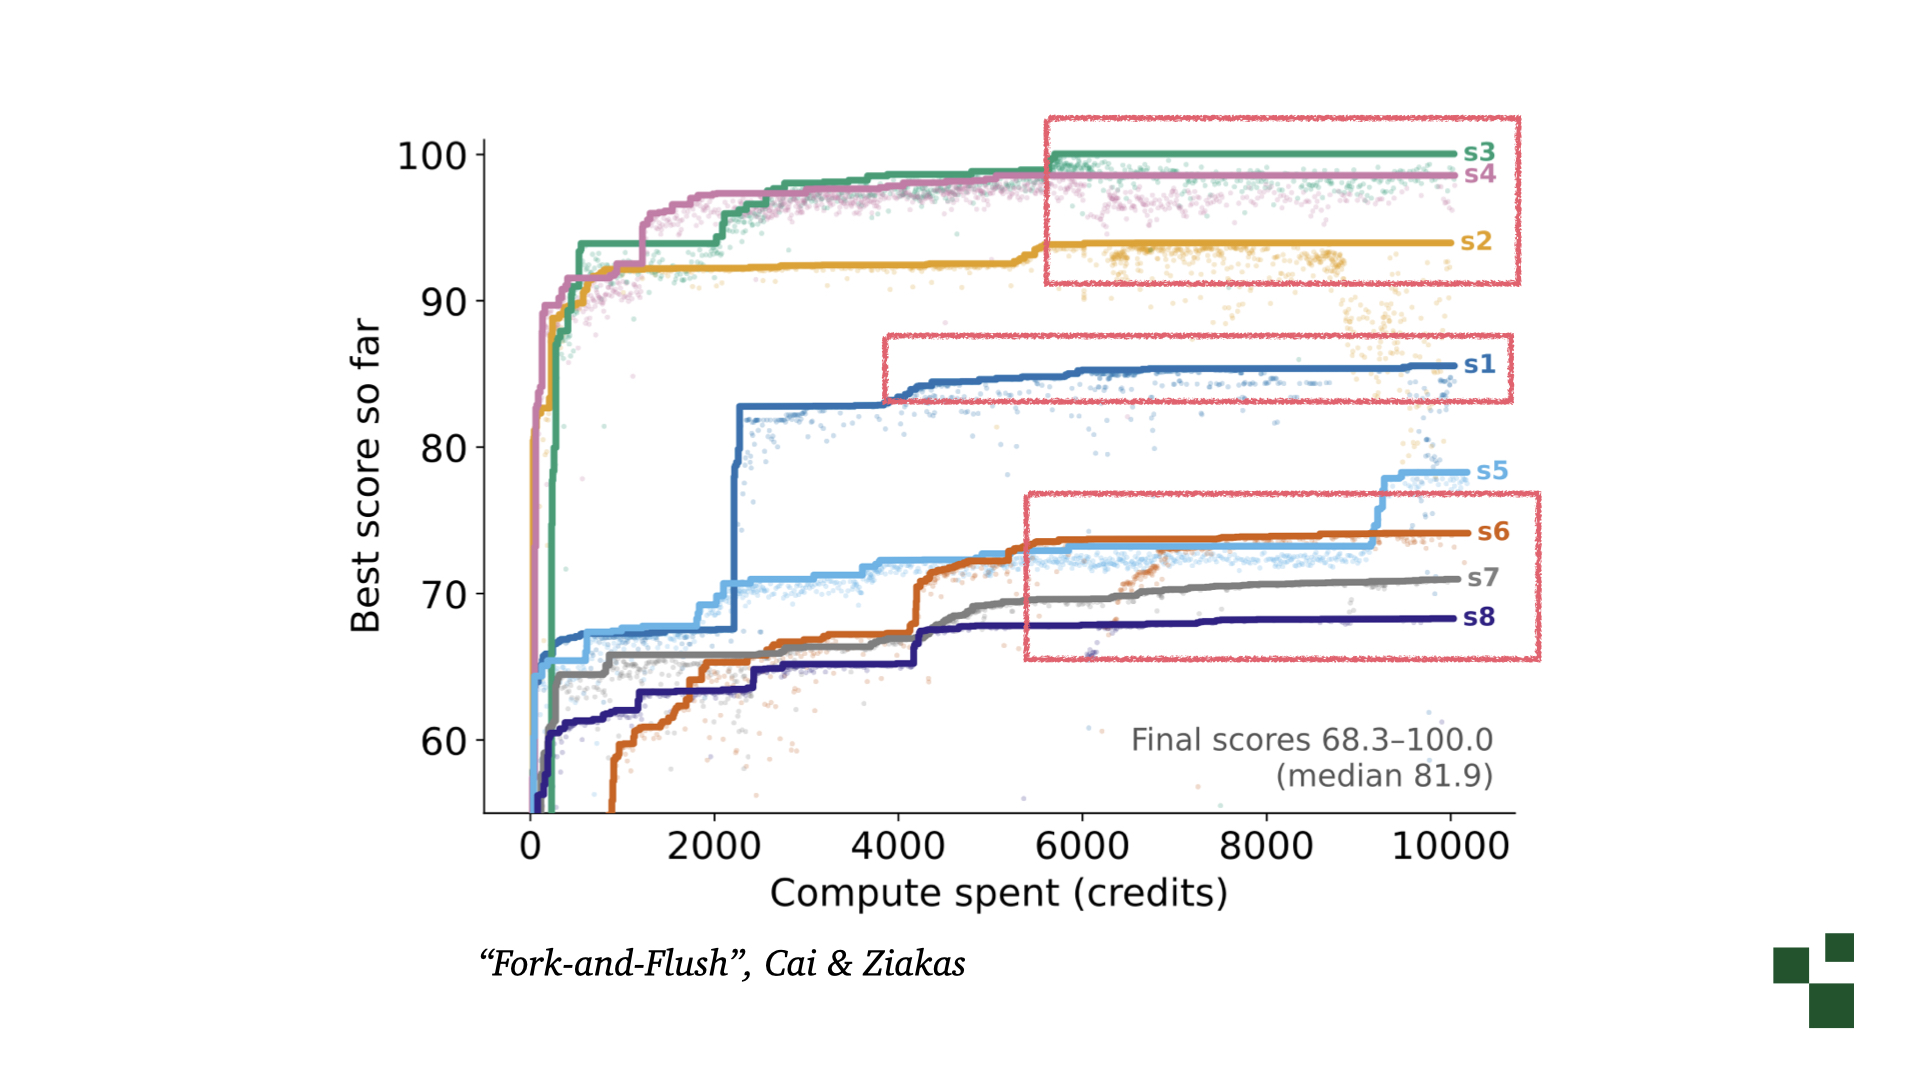
Microsoft Research의 또 다른 논문은 Fork-and-Flush입니다.
autoresearch 실험을 해 보셨다면 이런 차트를 본 적이 있을 겁니다. 크게 향상됐다가 선이 평평해지고, 또 크게 오르고 다시 평평해집니다. 개선은 거의 없는 채로 컴퓨팅과 돈과 시간만 흘러갑니다.
연구진이 자세히 들여다보니 에이전트가 문자 그대로 아무것도 하지 않은 것은 아니었습니다. 점점 더 사소한 변경을 하고 있었습니다. 하나의 아이디어를 찾아내고는 거기에 지나치게 몰두해서, 더 창의적인 대안을 탐색하지 않았던 것입니다.
어찌 보면 모델이 자기 아이디어에 집착하는 셈입니다. 우리는 좋은 코딩 에이전트가 되도록 끈기 있게 목표에 집중하도록 학습시켰습니다. 그런데 같은 특성이 오히려 발목을 잡을 수 있습니다.
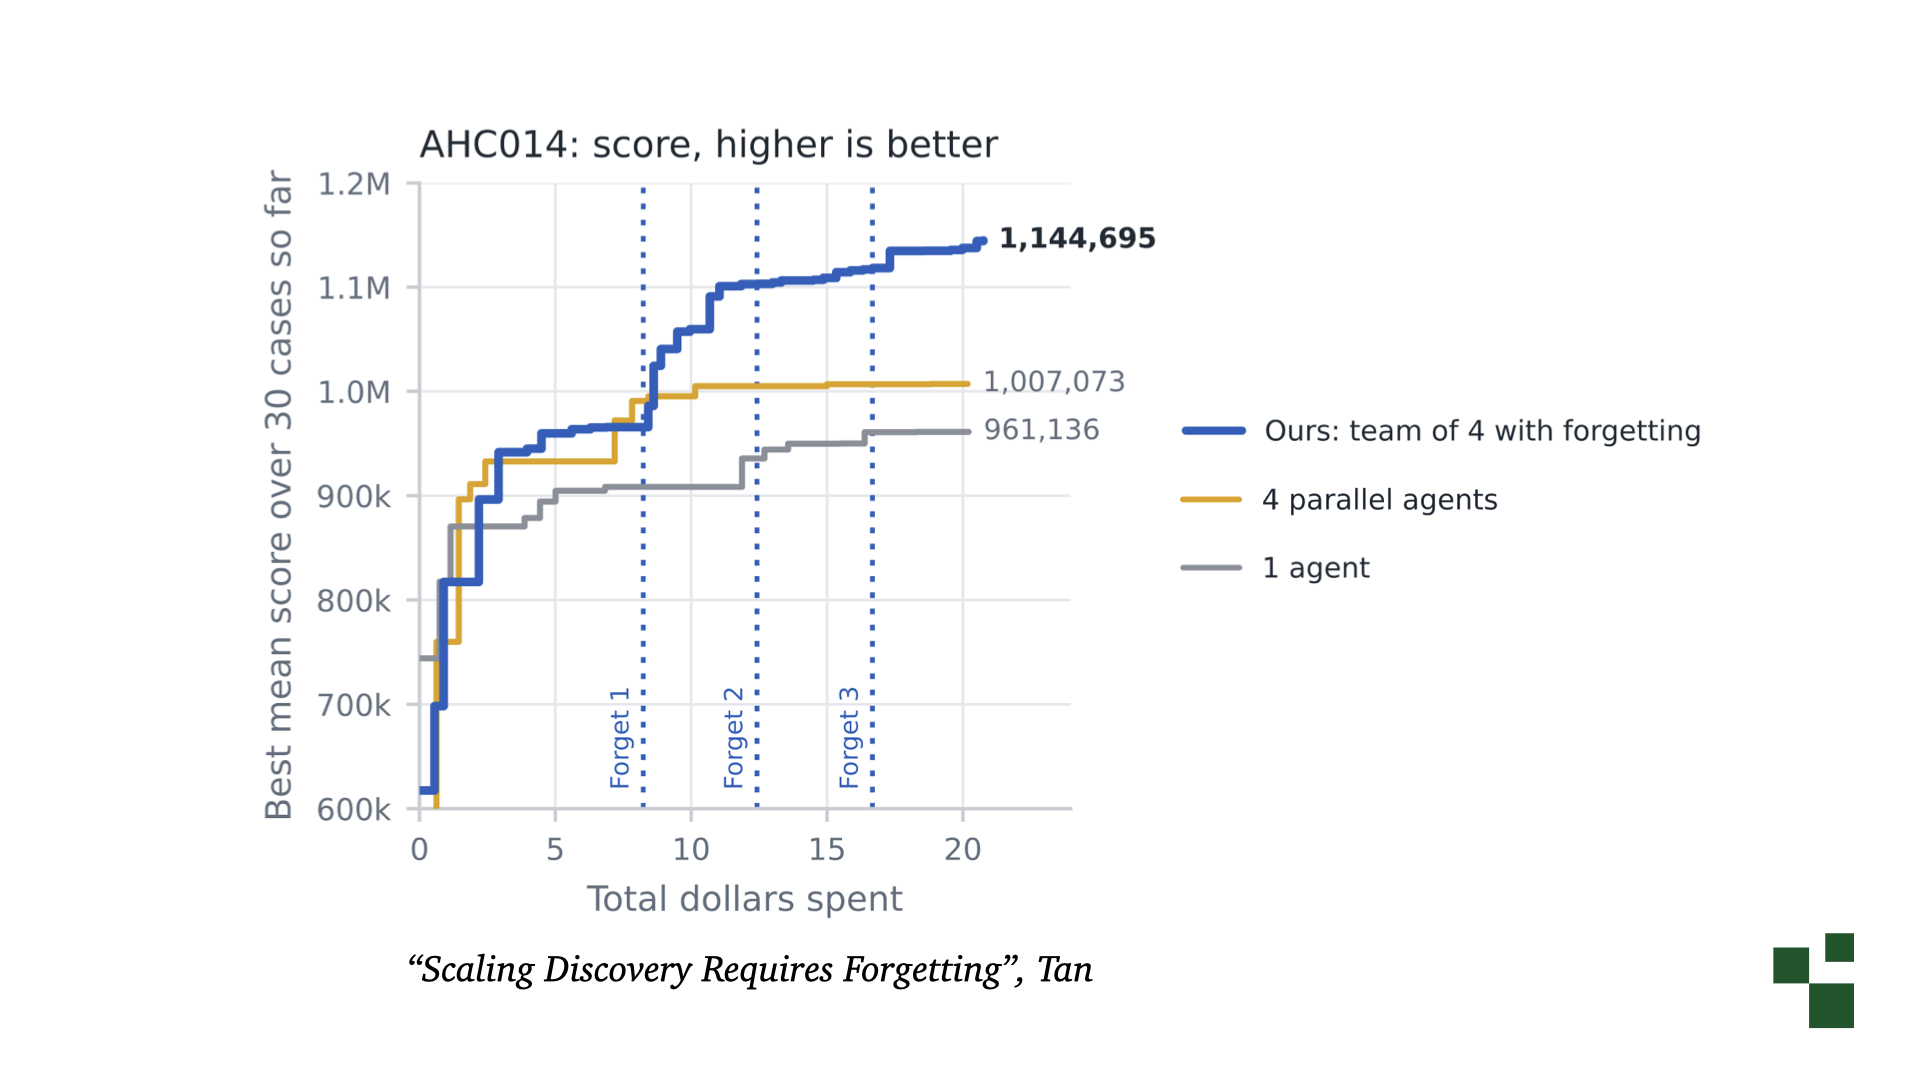
UC Berkeley의 Shangyin Tan이 이끈 또 다른 논문으로 Scaling Discovery Requires Forgetting이 있습니다.
연구진은 본질적으로 같은 아이디어에 도달했습니다. 환경에 만들어진 산출물은 유지하면서 컨텍스트를 주기적으로 비우는 것입니다.
파란 선이 망각을 적용한 버전입니다. 컨텍스트를 비울 때마다 성능이 또 한 번 뛰어오릅니다. 잊고, 나아지고, 또 잊고, 또 나아집니다.
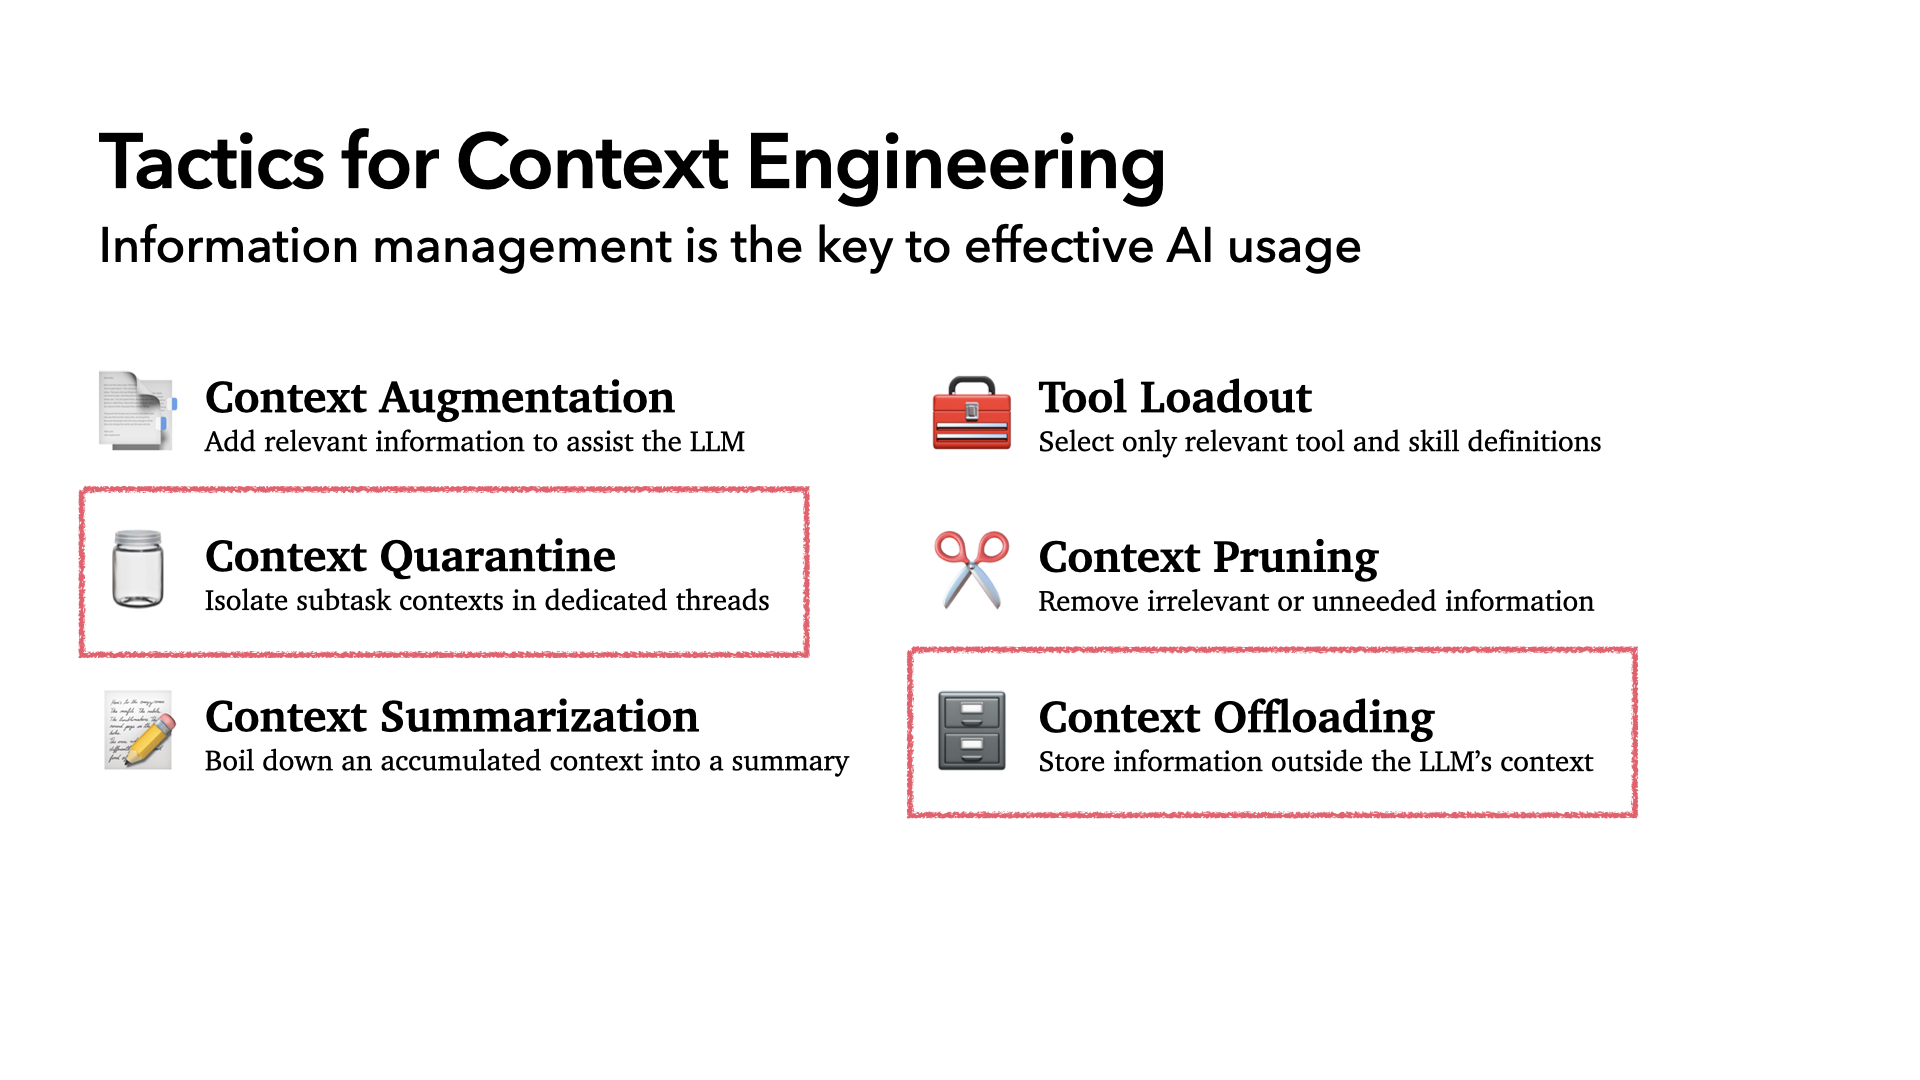
점점 더 복잡하고 지속적인 작업에 맞춰 학습된 새 모델이 나왔는데도 여전히 같은 기본 도구를 쓰고 있다는 점이 놀랍습니다. 완전히 새로운 컨텍스트 해결책은 아직 발견하지 못했습니다. 컨텍스트 관성에 대처하려고 격리, 오프로딩, 누적된 기록 삭제를 쓰고 있습니다.
요즘 제가 계속 드리는 조언입니다. 누군가 "코딩 에이전트가 이상하게 굴어요. Claude가 너프됐나 봐요"라고 하면 저는 "컨텍스트가 얼마나 큰가요?"라고 묻습니다.
"아, 80만 토큰이에요."
컨텍스트를 지우세요.
농담이 아닙니다. 저는 20만 토큰 안팎을 경고 지점으로 봅니다.
컨텍스트를 리셋해 보셨나요?
때로는 정말 그게 해결책입니다.
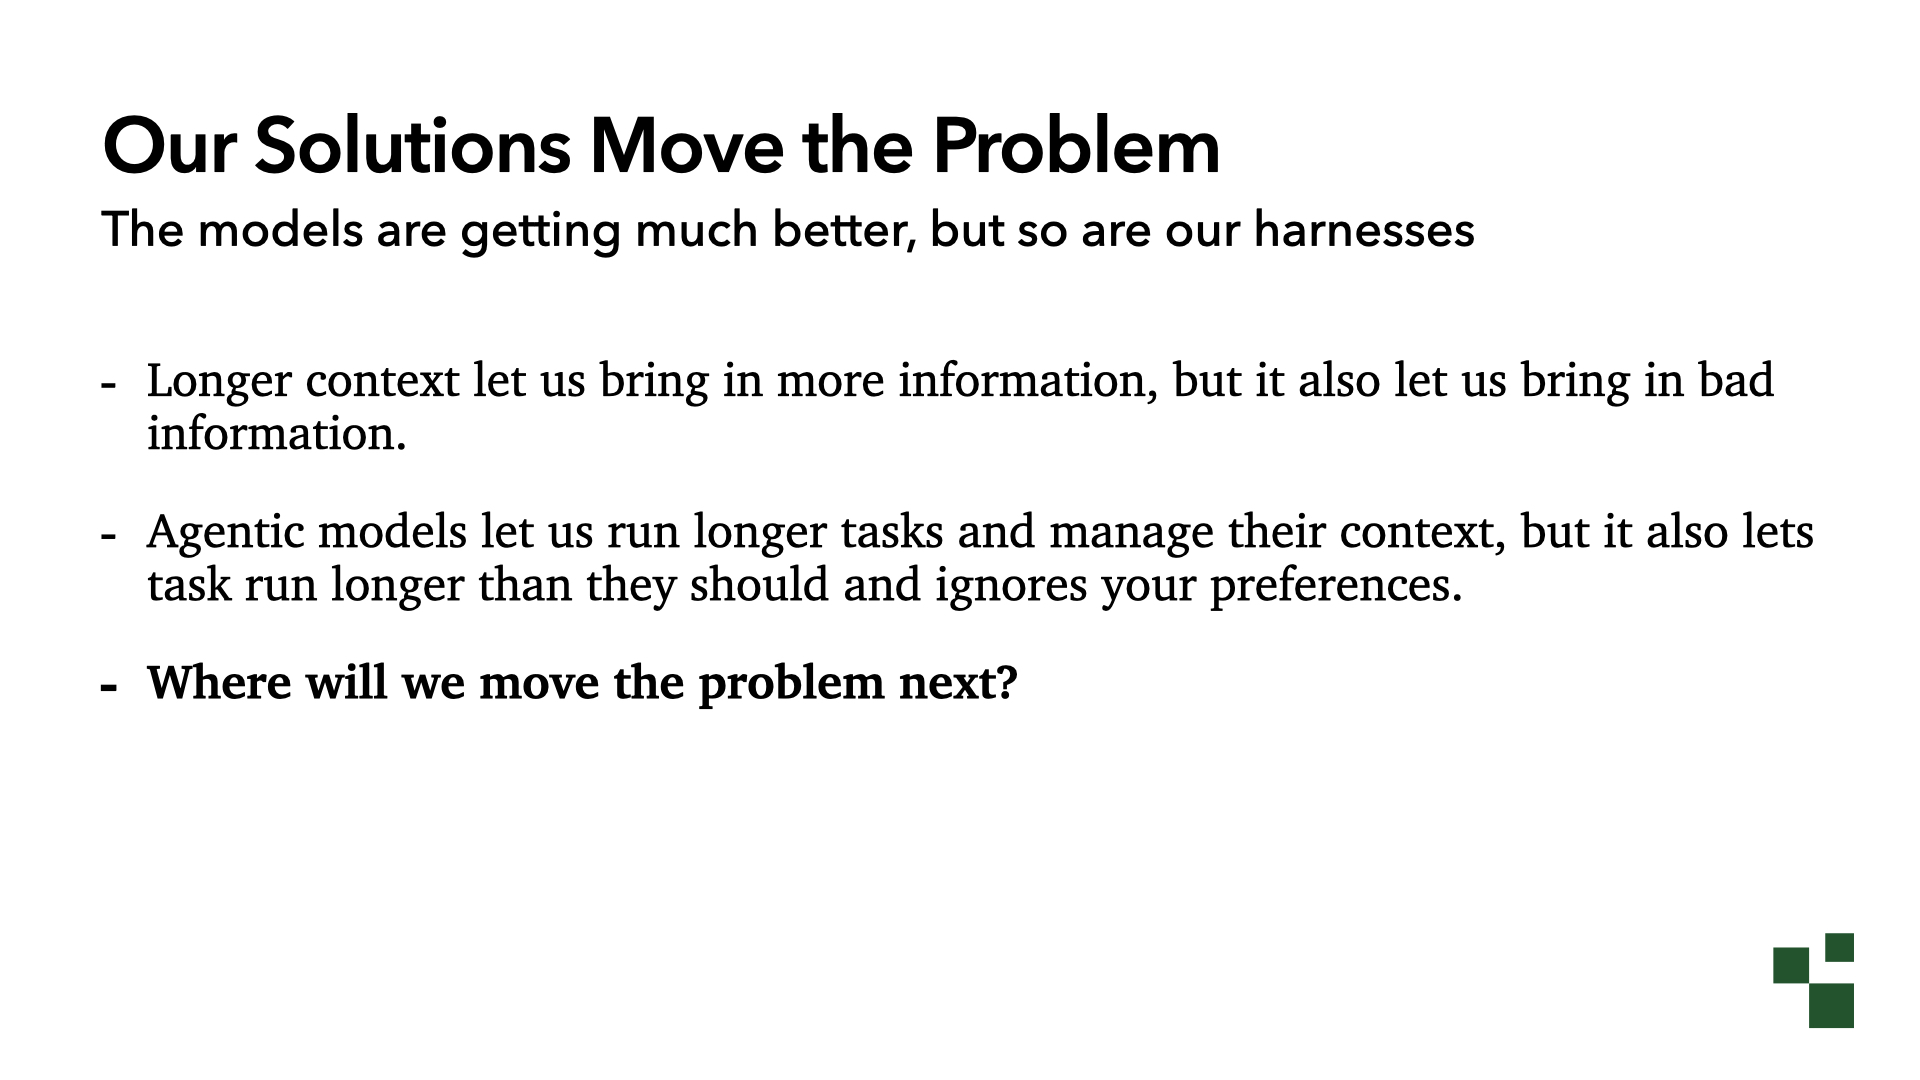
모델에 녹여 낸 해결책이 내일의 문제를 만듭니다. 모델은 나아지고 있고, 우리의 하네스도 나아지고 있습니다.
긴 컨텍스트 윈도우 덕분에 더 많은 정보를 가져올 수 있지만, 나쁜 정보도 함께 가져오게 됩니다. 우리는 이를 관리하는 방법을 찾아야 했고, 지금도 틀릴 때가 있습니다.
에이전트형 모델 덕분에 더 긴 작업을 돌리고 컨텍스트를 맡길 수 있지만, 그만큼 작업이 필요 이상으로 길어지고 우리의 선호를 무시하기도 합니다. 모델이 자기만의 하네스에 맞춰 학습되었기 때문입니다.
그렇다면 문제는 다음에 어디로 옮겨 갈까요?
2027년의 큰 약속은 무엇일까요? 모델이 다음에 내놓을 것 중에서, 이 자리에 계신 모든 분께 새로운 문제를 안길 것은 무엇일까요?
(직접 모델을 학습시키는 분이라면 예외겠지만, 컨텍스트 엔지니어링 세션이니 아마 아니겠죠.)
제 예측은 이렇습니다.
Hermes, OpenClaw, Dot, Bot, Muse 같은 개인용 에이전트를 떠올려 보세요. 이런 하네스를 6개월 넘게 실제로 돌려 본 사람은 아직 거의 없습니다.
저는 Hermes 에이전트를 6개월째 돌리고 있습니다. 에이전트가 만들고 갱신하는 스킬을 보면, 문제에 대한 해결책이 시간이 지날수록 나빠질 수 있다는 걸 알게 됩니다. 스킬에 이상한 땜질이 계속 쌓입니다. 범용 에이전트라서 어떤 작업을 한 방식으로 풀고, 비슷한 작업은 또 다른 방식을 새로 찾아냅니다. 지시문과 기억이 쌓이면서 서로 충돌하기 시작합니다.
메모리에 더 집중할수록 전략적인 망각도 고민해야 합니다. 시간이 지나면 지나치게 정밀한 기억들이 서로 충돌하며 엉망이 되는데, 이를 어떻게 다룰지는 아직 아무도 풀지 못했습니다.
저는 이것이 내일의 컨텍스트 문제라고 생각합니다.
모델 능력이 한 단계 발전할 때마다, 무엇을 모델에 맡기고 무엇을 시스템이 강제해야 하는지가 달라집니다.
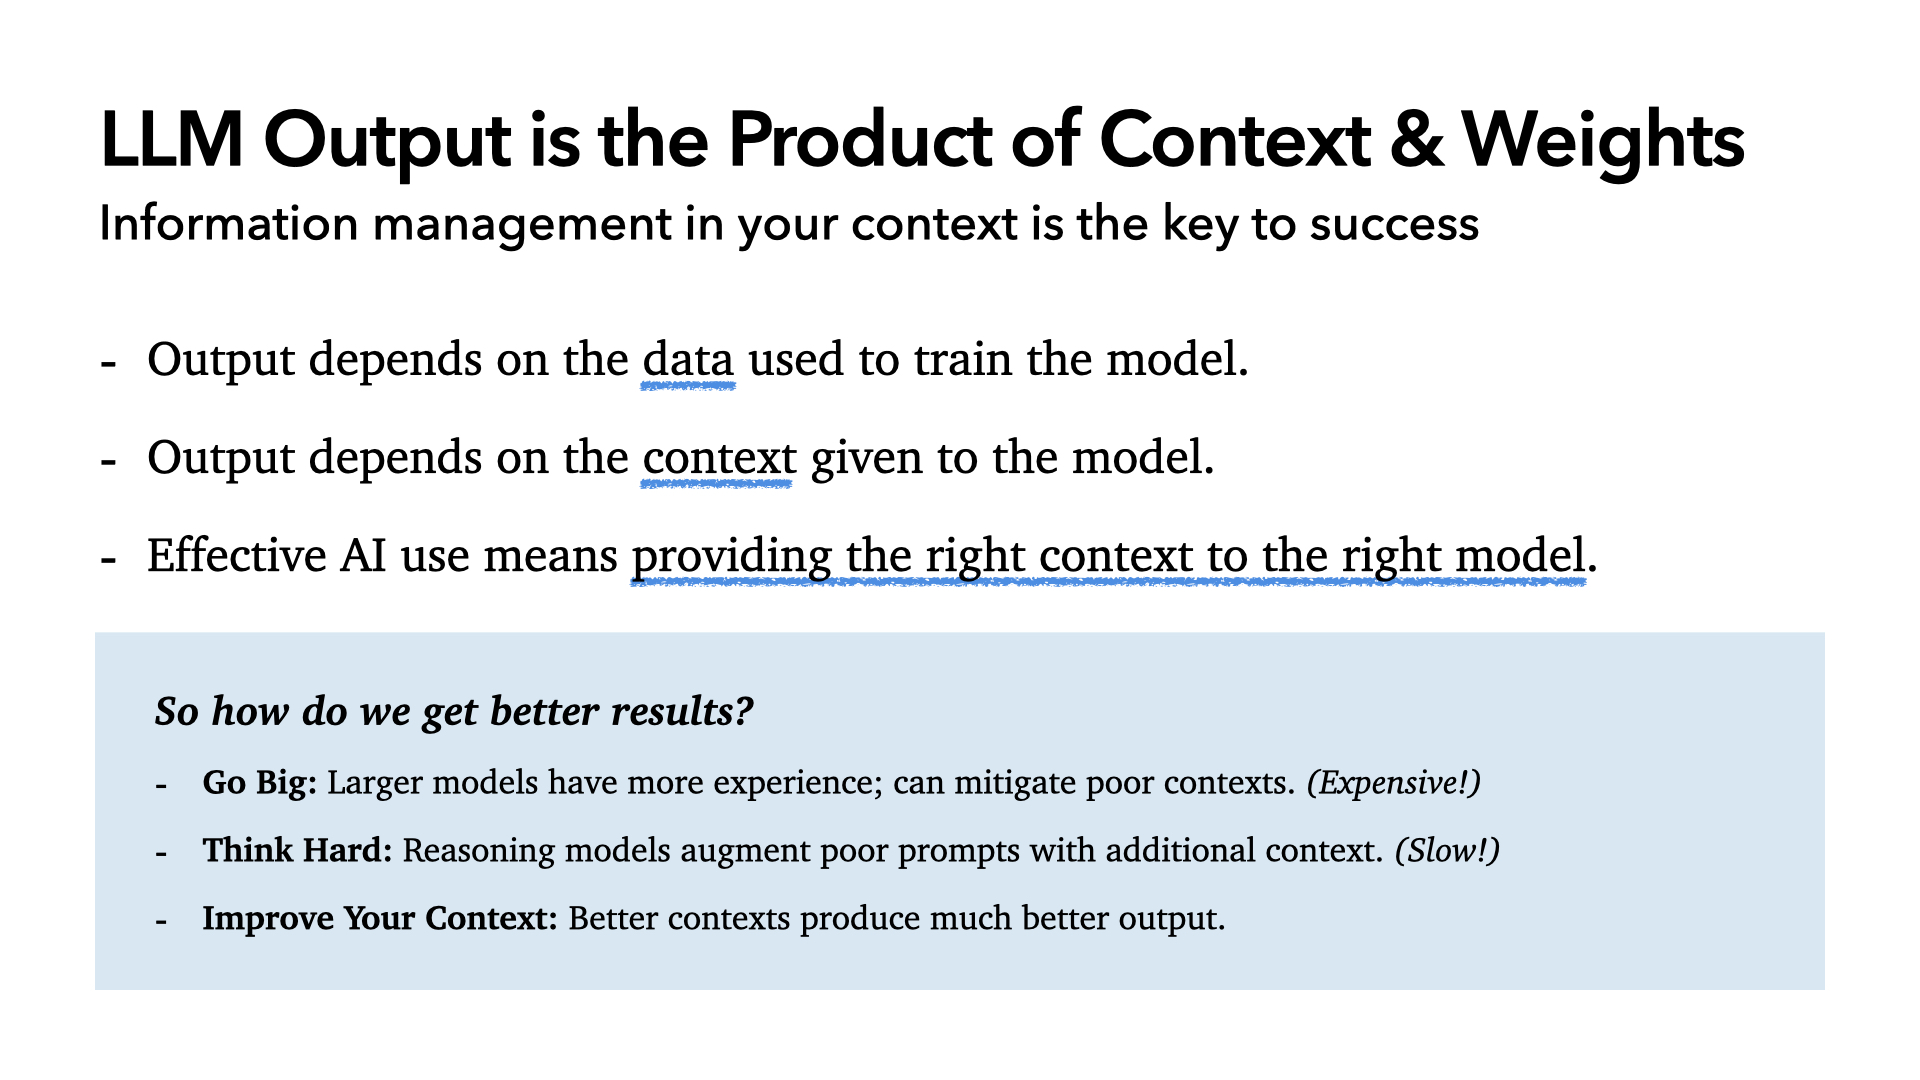
이 슬라이드는 1년 반쯤 전에 기업 팀을 교육하는 자료에 넣으려고 만들었는데, 지금도 여전히 유효합니다.
출력은 컨텍스트와 가중치의 산물입니다.
출력은 모델을 학습시킨 데이터에 좌우됩니다. 이를 이해하세요. 기술 보고서를 읽고, 모델이 무엇으로 학습되었는지, 그것이 내 작업과 관련 있는지 살펴보세요. 문제가 생겼을 때 디버깅할 멘탈 모델을 만드는 데 도움이 됩니다.
또한 출력은 모델에 주어진 컨텍스트에 좌우됩니다. 그게 전부입니다.
그러니 우리의 목표는 알맞은 모델에 알맞은 컨텍스트를 주는 것입니다. 우리가 직접 개별적으로 판단하든, 우리가 설계한 소프트웨어, 즉 하네스가 대신하든 마찬가지입니다.
더 큰 모델을 쓰거나, 더 오래 생각하게 하거나, 컨텍스트를 개선할 수 있습니다. 이 중 싸고 빠른 방법은 하나뿐입니다.
지능형 애플리케이션, 하네스, 워크플로를 만들 때 우리의 일은 언제 결정론적으로 갈지(코드에 무엇을 넣을지), 언제 확률적으로 갈지(언제 모델이 주도하게 할지) 선택하는 것입니다.
이메일을 입력하면 가끔 업데이트 소식을 보내 드립니다.