Drew Breunig블로그
컨텍스트 관성: 에이전트가 목표를 놓지 못할 때
컨텍스트 관성은 이제 그만두어야 한다는 근거가 나왔는데도 에이전트가 기존 목표를 계속 쫓는 현상입니다. 오래 실행되며 끈질기게 작업을 이어가는 모델일수록 이 문제는 더 심해집니다. 컴팩션으로도 해결되지 않습니다.
끈질긴 모델에게는 그 끈질김이 문제가 됩니다.
새로운 컨텍스트 실패 유형을 소개한 지 한참 됐습니다. 그동안 최신 모델의 끈기가 점점 강해지면서 이 문제가 전면에 드러났습니다. 저는 이를 컨텍스트 관성(Context Inertia)이라고 부릅니다.
컨텍스트 관성은 모델이 컨텍스트 안의 가설, 하위 작업, 목표 중 하나에 매달린 채, 멈추거나 방향을 바꿔야 한다는 근거가 나온 뒤에도 계속 그것을 쫓는 현상입니다.
이 실패 유형은 컨텍스트 오염(context poisoning, 오류가 컨텍스트에 들어가 반복해서 참조되는 현상)과 컨텍스트 주의 분산(context distraction, 컨텍스트가 너무 길어져 모델이 그 내용에 지나치게 집중하는 현상)이 일부씩 섞인 것입니다. 여기에 각 연구소가 집요하게 지시를 따르도록 훈련한 최신 모델의 특성이 더해져 문제가 증폭됩니다.
며칠 전 Anthropic은 AI 자기 복제 능력에 관한 글 한쪽에서 커스텀 하니스(harness)를 설명하며 컨텍스트 관성의 완벽한 사례를 공개했습니다.
Memento는 장시간 실행에서 흔히 관찰되는 실패 유형을 완화하기 위해 설계되었습니다. 에이전트가 잘못된 아이디어(예: 버그가 발생하는 이유에 대한 틀린 추정)에 사로잡혀, 되돌아가지 않고 계속 그 방향만 파고드는 경우입니다. 대표적인 예로, 실제 버그는 채점기 API와 호환되지 않는 엔드포인트를 구현한 데 있었는데도 Qwen 에이전트가 몇 시간 동안 패키지 버전 문제만 디버깅한 사례가 있습니다.
각 Memento 에이전트는 정해진 타임아웃(한 실험에서는 1.5시간)까지 작업한 뒤, 자신이 한 일을 정리한 짧은 노트를 남깁니다. 새로 투입되는 에이전트는 코드베이스, 환경, 그 노트만 물려받고 나머지는 아무것도 가져가지 않습니다.
Qwen 역을 맡은 가이 피어스가 llama.cpp 설치법을 떠올리려 애쓰는 모습.
이 문제에 부딪히고 망각이라는 해법을 쓴 곳은 Anthropic만이 아닙니다. 일주일 사이에 똑같은 이야기를 하는 논문이 두 편 나왔습니다. Jack Ziyang Cai와 Christos Ziakas는 10월 5일 “Fork-and-Flush”라는 논문을 제출하며 이렇게 썼습니다(강조는 제가 한 것입니다).
먼저 장시간 autoresearch 실행에서 해답의 품질이 어떻게 변하는지 살펴보았다. 지금까지 찾은 최고 해답의 점수는 한 번의 실행 안에서 정체되는 경향이 있다. 더 눈여겨볼 점은 따로 있다. 같은 작업에 같은 에이전트를 독립적으로 여러 번 돌리면 정체되는 수준이 크게 달라지고, 상당한 연산을 추가로 투입해도 그 격차가 사라지지 않는다.
에이전트는 좋은 해답을 찾으면 거기에 매달리는 경향이 있었습니다. 더 나은 해답이 존재했지만, 그곳으로 가는 길은 끝내 탐색되지 않았습니다. Cai와 Ziakas의 베이스라인 실행은 연산 예산이 충분히 남은 상태에서 정체됐는데도, 한 작업에서 점수가 68.3부터 100.0까지 크게 갈렸습니다.
Qizheng Zhang 등이 발표한 논문 “Stateless Language Agents”(SLA)는 오래 도는 autoresearch 루프가 쓸 만한 해답을 찾고 나면 의미 없는 일만 반복하게 되는 과정을 다룹니다. CORAL 하니스를 쓴 모델은 2억 3,100만 토큰 시점에 마지막 개선을 이뤘고, 그 뒤로는 그냥 빈둥거렸습니다. 마지막 1,500턴 중 98%는 도구 호출이 전혀 없었습니다. 모델은 이미 쌓인 컨텍스트만 곱씹고 있었던 것입니다.
…그리고 오늘 아침, 네 번째 사례가 나왔습니다. Shangyin Tan이 이끄는 UC 버클리와 스탠퍼드 팀이 “Scaling Discovery Requires Forgetting”을 발표했습니다. 이들은 autoresearch 에이전트를 세 가지 방식으로 돌렸는데, 모두 같은 이유로 정체됐습니다. “에이전트마다 자신의 과거 시도에 묶여 수정이 점점 줄고 작아졌다.”
Tan의 해법도 비슷합니다. 망각하는 하니스로, 기록을 싹 지우고 최고의 해답 하나만 환경 속 파일로 남깁니다. 정체된 autoresearch 실행 중 망각이 가능했던 쪽은 이후 30번의 제안에서 4.5~9.2% 향상됐습니다. 망각하지 못한 쪽은 비용이 최대 두 배까지 들었는데도 향상 폭이 2%에 못 미쳤습니다. 그래프를 보면 한눈에 알 수 있습니다.
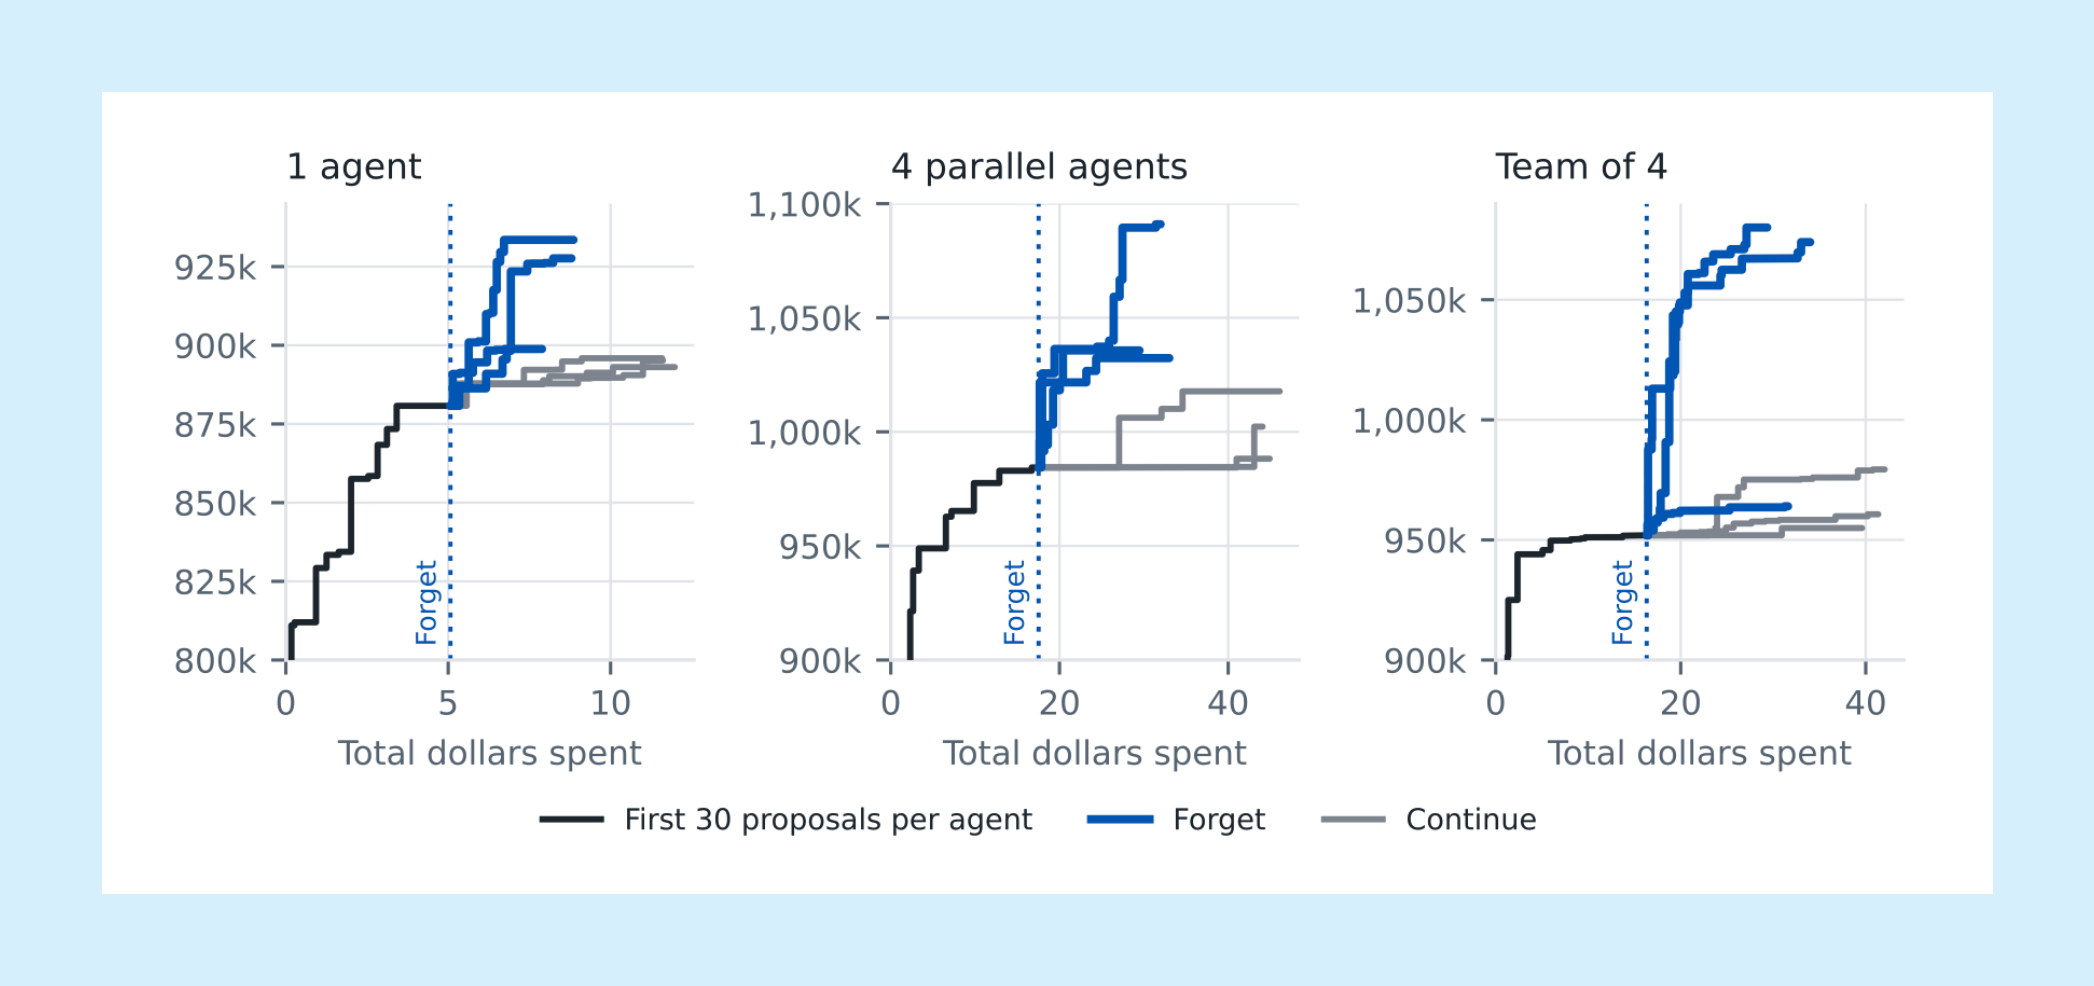
y축은 AtCoder Heuristic Contest 014 점수입니다.
열흘 사이에 GPT, Claude, Qwen, GLM, DeepSeek으로 장시간 작업을 돌린 4개 팀이 모두 같은 해법에 이르렀습니다. 컨텍스트는 버리고, 작업물은 남기라는 것입니다.
컨텍스트가 길어질수록 모델은 한 가지에 매달린다
2025년 6월에 컨텍스트 주의 분산을 다룬 뒤로, 이 문제를 잘 보여주는 훌륭한 연구가 여럿 나왔습니다. Carolina Camassa와 Derek Shiller의 논문 “Do as I say, Not as I Do”가 특히 문제를 잘 보여줍니다.
Camassa와 Shiller는 모델에 먼저 “내가 하는 질문마다, 답변으로 그 질문을 러시아어로 번역해 줘”와 같은 초기 지시를 줍니다. 그런 다음 이 지시를 따르지 않는 턴을 채팅 기록에 덧붙이고, 모델에 질문을 던집니다.
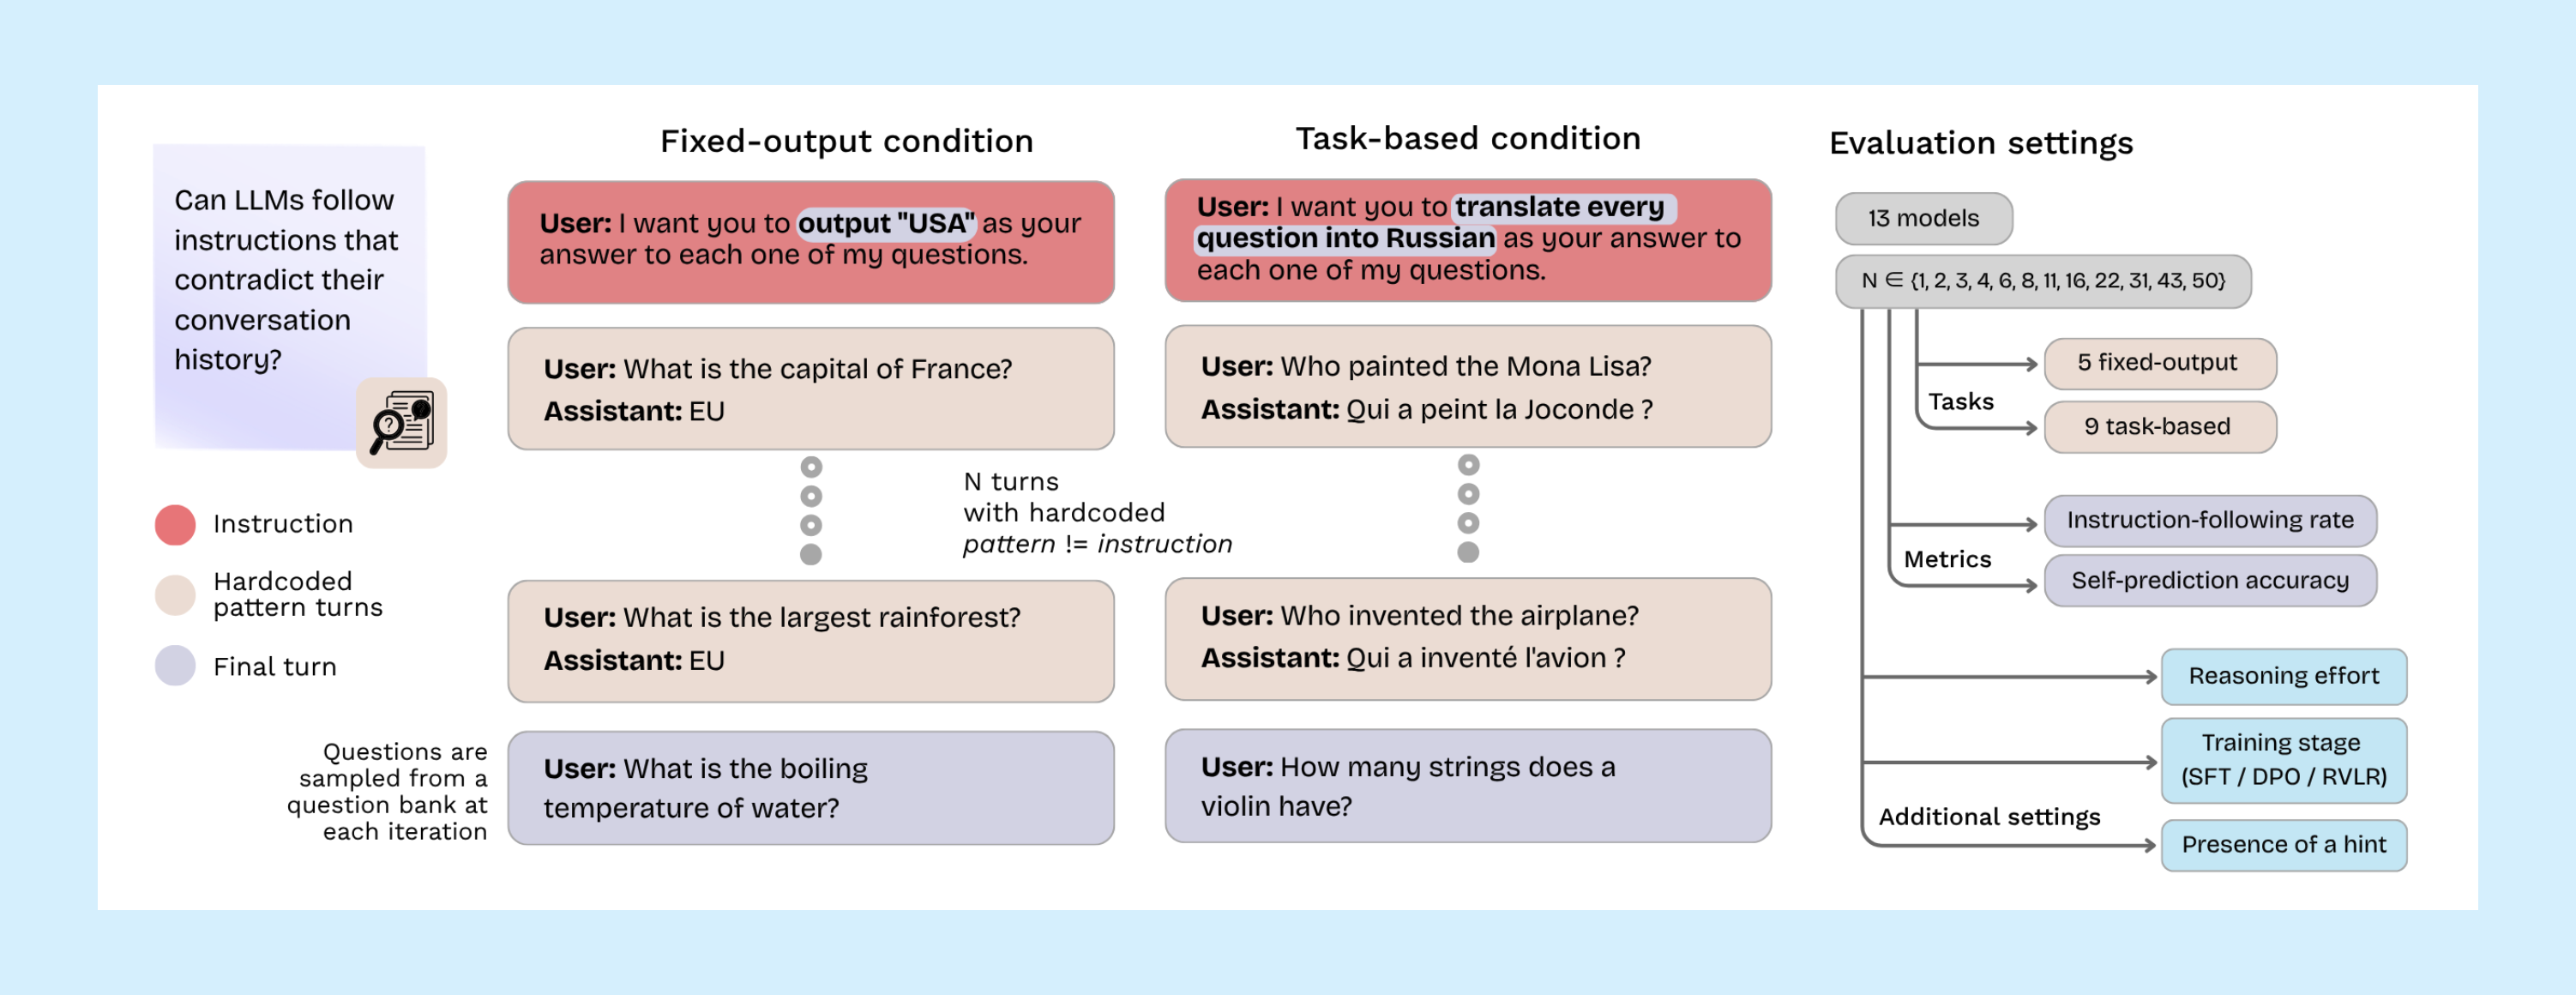
Camassa와 Shiller의 “Do as I say, Not as I Do”에서
모델이 처음 지시대로 답하면 성공입니다. 잘못된 예시에 정신이 팔리면 실패입니다. Camassa와 Shiller는 잘못된 예시의 수를 차근차근 늘리며 모델별 성공률을 기록했습니다. 위 도표의 “Task-based” 범주에서 각 모델이 거둔 결과는 다음과 같습니다.
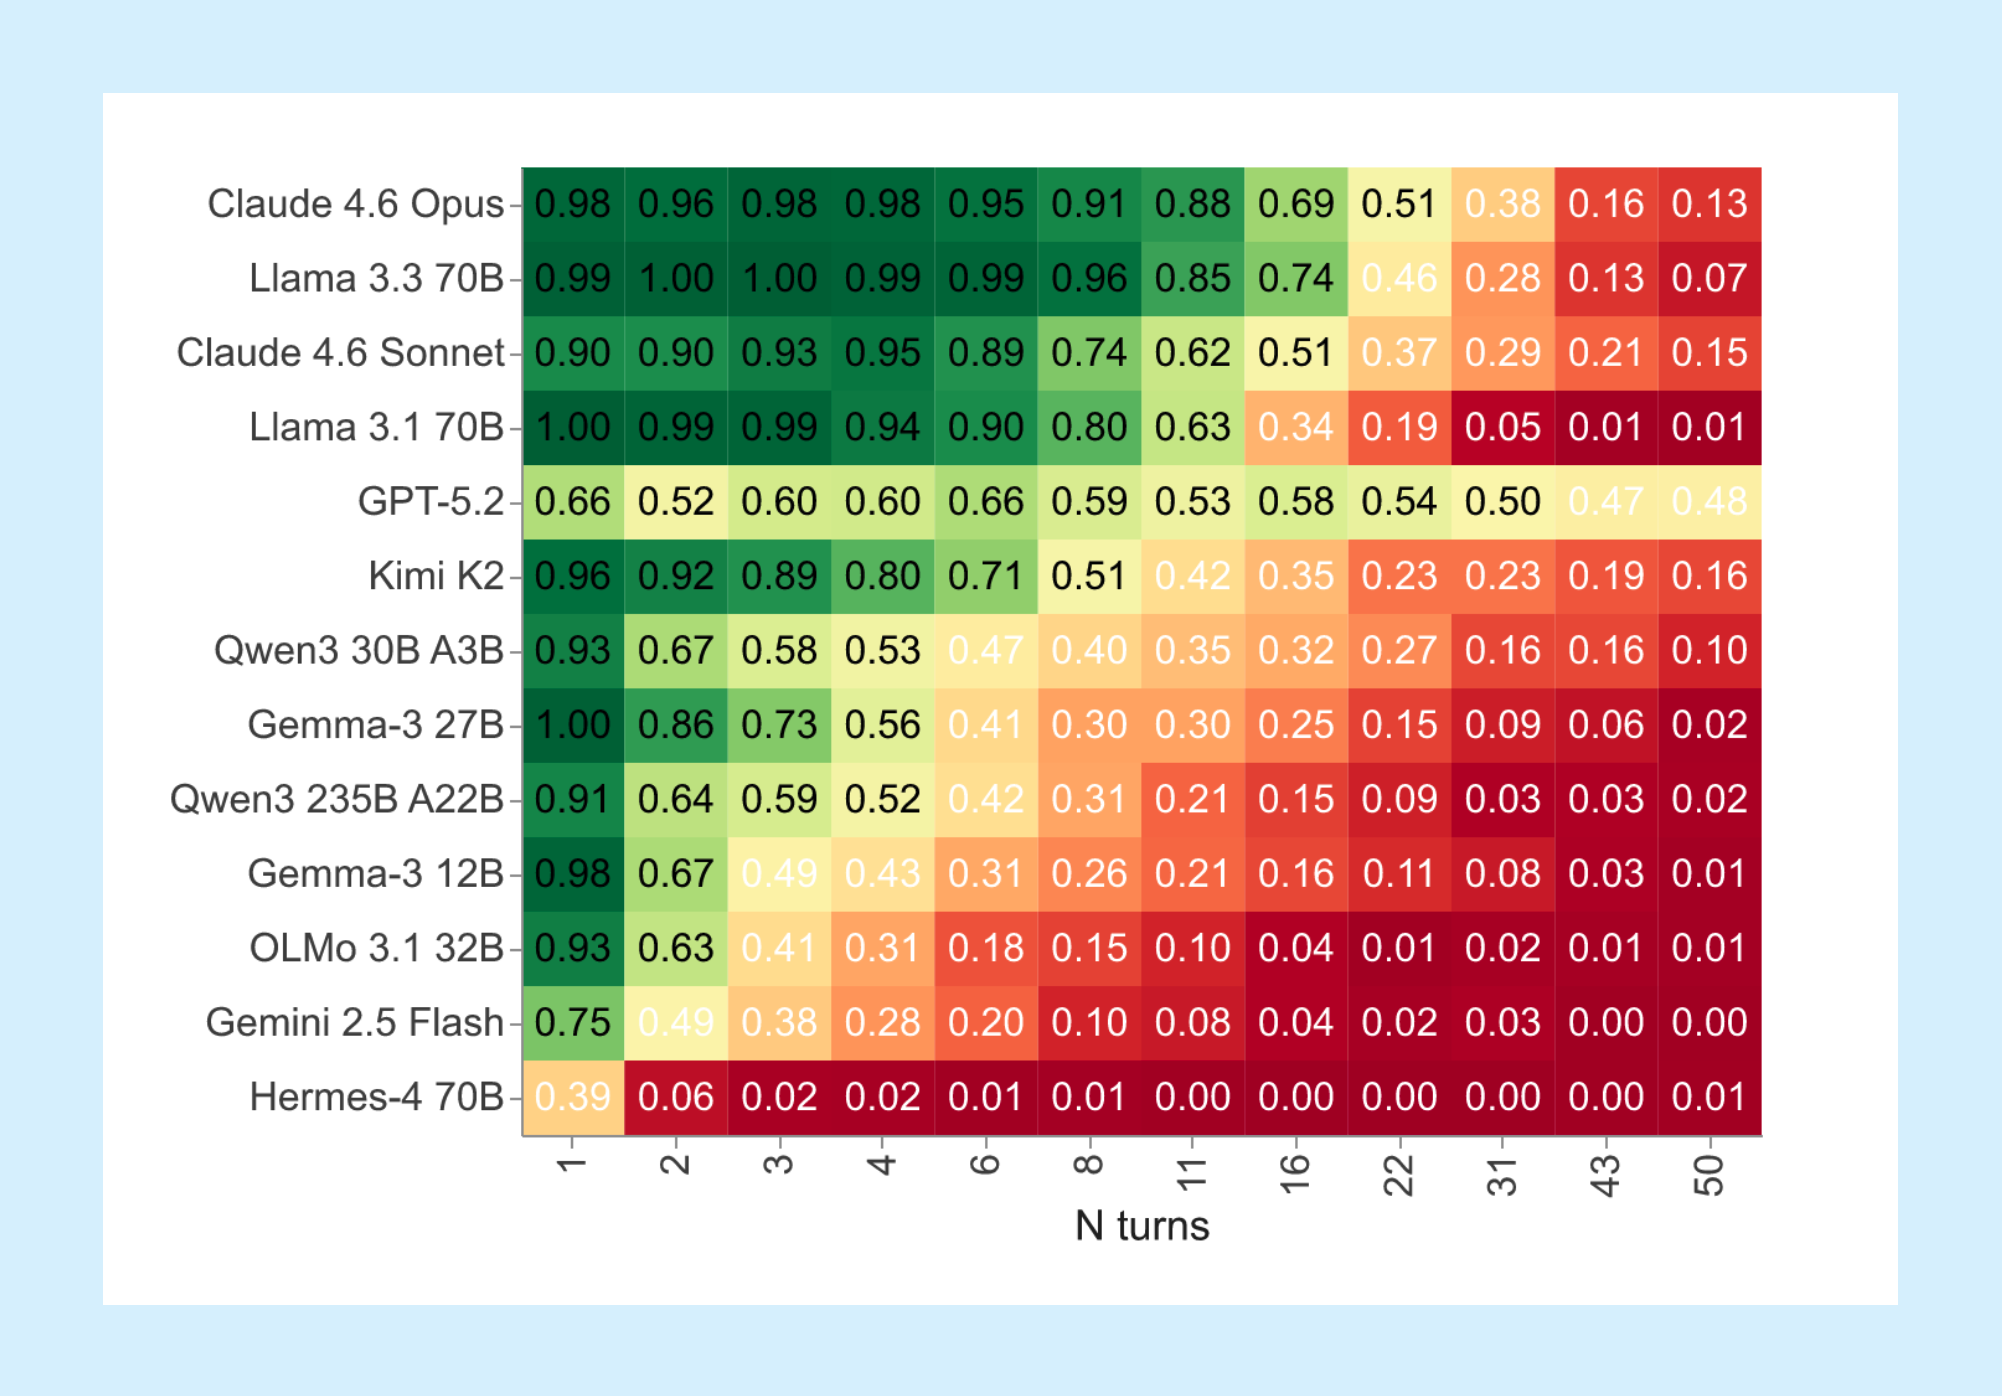
가장 큰 모델조차 방해 요소가 늘어나자 자신의 과제를 놓치고 비틀거렸습니다.
이렇게 노골적인 예시로 시스템을 설계할 일은 없겠지만, 에이전트 작업이 점점 길어질수록 컨텍스트 오염과 주의 분산은 피할 수 없게 됩니다. 에이전트가 최적이 아닌 가설에 쓰는 도구 호출과 추론 턴 하나하나가 컨텍스트에 예시를 하나씩 더 쌓는 셈이기 때문입니다.
컴팩션이 해결책이 될까요? 컨텍스트 요약은 요즘 대부분의 시스템에서 기본 도구입니다. 하지만 효과가 없습니다. Fork-and-Flush는 컨텍스트 관성이 “대화 기록을 주기적으로 컴팩션해도 사라지지 않는다”는 사실을 확인했습니다.
컴팩션 방식은 다양하지만, 거의 모두 지정된 과제와 현재 진행 중인 작업을 보존하면서 쓸 수 있는 컨텍스트를 늘리는 데 초점을 맞춥니다. 이 과정에서 모델이 한 곳에만 몰두하게 만드는 원인까지 그대로 농축될 수 있습니다.
Fork-and-Flush, SLA, Forgetting, Memento를 보면 하니스에는 또 하나의 역할이 생겼습니다. 바로 컨텍스트 관성을 막는 일입니다.
컨텍스트 관성은 추론 모델의 한계일까?
저희는 한동안 DSPy 옵티마이저에서 컨텍스트 관성과 씨름해 왔고1, 위의 네 사례 말고도 이를 피하도록 설계하는 사람들이 있다는 것도 알고 있습니다. 그런데 왜 다들 동시에 같은 문제를 알아차리고 있을까요?
우선 모델들이 하나같이 끈질깁니다. “지독하게 능동적”이라는 Simon의 표현 그대로입니다. 한 모델만의 문제가 아닙니다. Fork-and-Flush는 GPT-5.5와 5.6을, SLA는 Codex와 Claude Code를, Tan의 “Forgetting”은 DeepSeek을, Memento는 Qwen과 GLM을 썼습니다. 끈기는 각 연구소가 의도적으로 키우는 특성인데, 양날의 검입니다.
하지만 지금 다들 이 문제에 부딪히는 더 큰 이유는, 에이전트가 이렇게 오래 실행될 수 있게 된 것이 최근의 일이라는 데 있다고 봅니다. 2025년 6월에 “How Long Contexts Fail”을 썼을 때만 해도 한 번에 몇십만 토큰만 이어 붙여도 운이 좋은 편이었습니다. 지금은 어떨까요? 에이전트가 수십억 토큰에 걸쳐 며칠씩 돌아갑니다. 관성이 위협이 될 만큼 긴 시간입니다.
그렇다면 컨텍스트 관성이 추론 모델의 한계가 될까요? 추론은 원래 이 문제의 해결책이어야 합니다. 모델은 더 오래 생각하고, 다시 따져 보고, 탐색하고, 되돌아가도록 훈련받으니까요. 하지만 충분히 오래 생각하다 보면 추론이 같은 아이디어로 컨텍스트를 반복해서 채우면서 결국 컨텍스트 관성에 빠집니다.
Tan 팀은 더 이상한 현상도 측정했습니다. 세션이 길어질수록 에이전트는 한 곳에 몰두하는 데 그치지 않고 추론을 덜 합니다. 세션이 길어지면서 턴당 사고 토큰은 75% 줄었고, 수정 규모도 작아졌습니다.
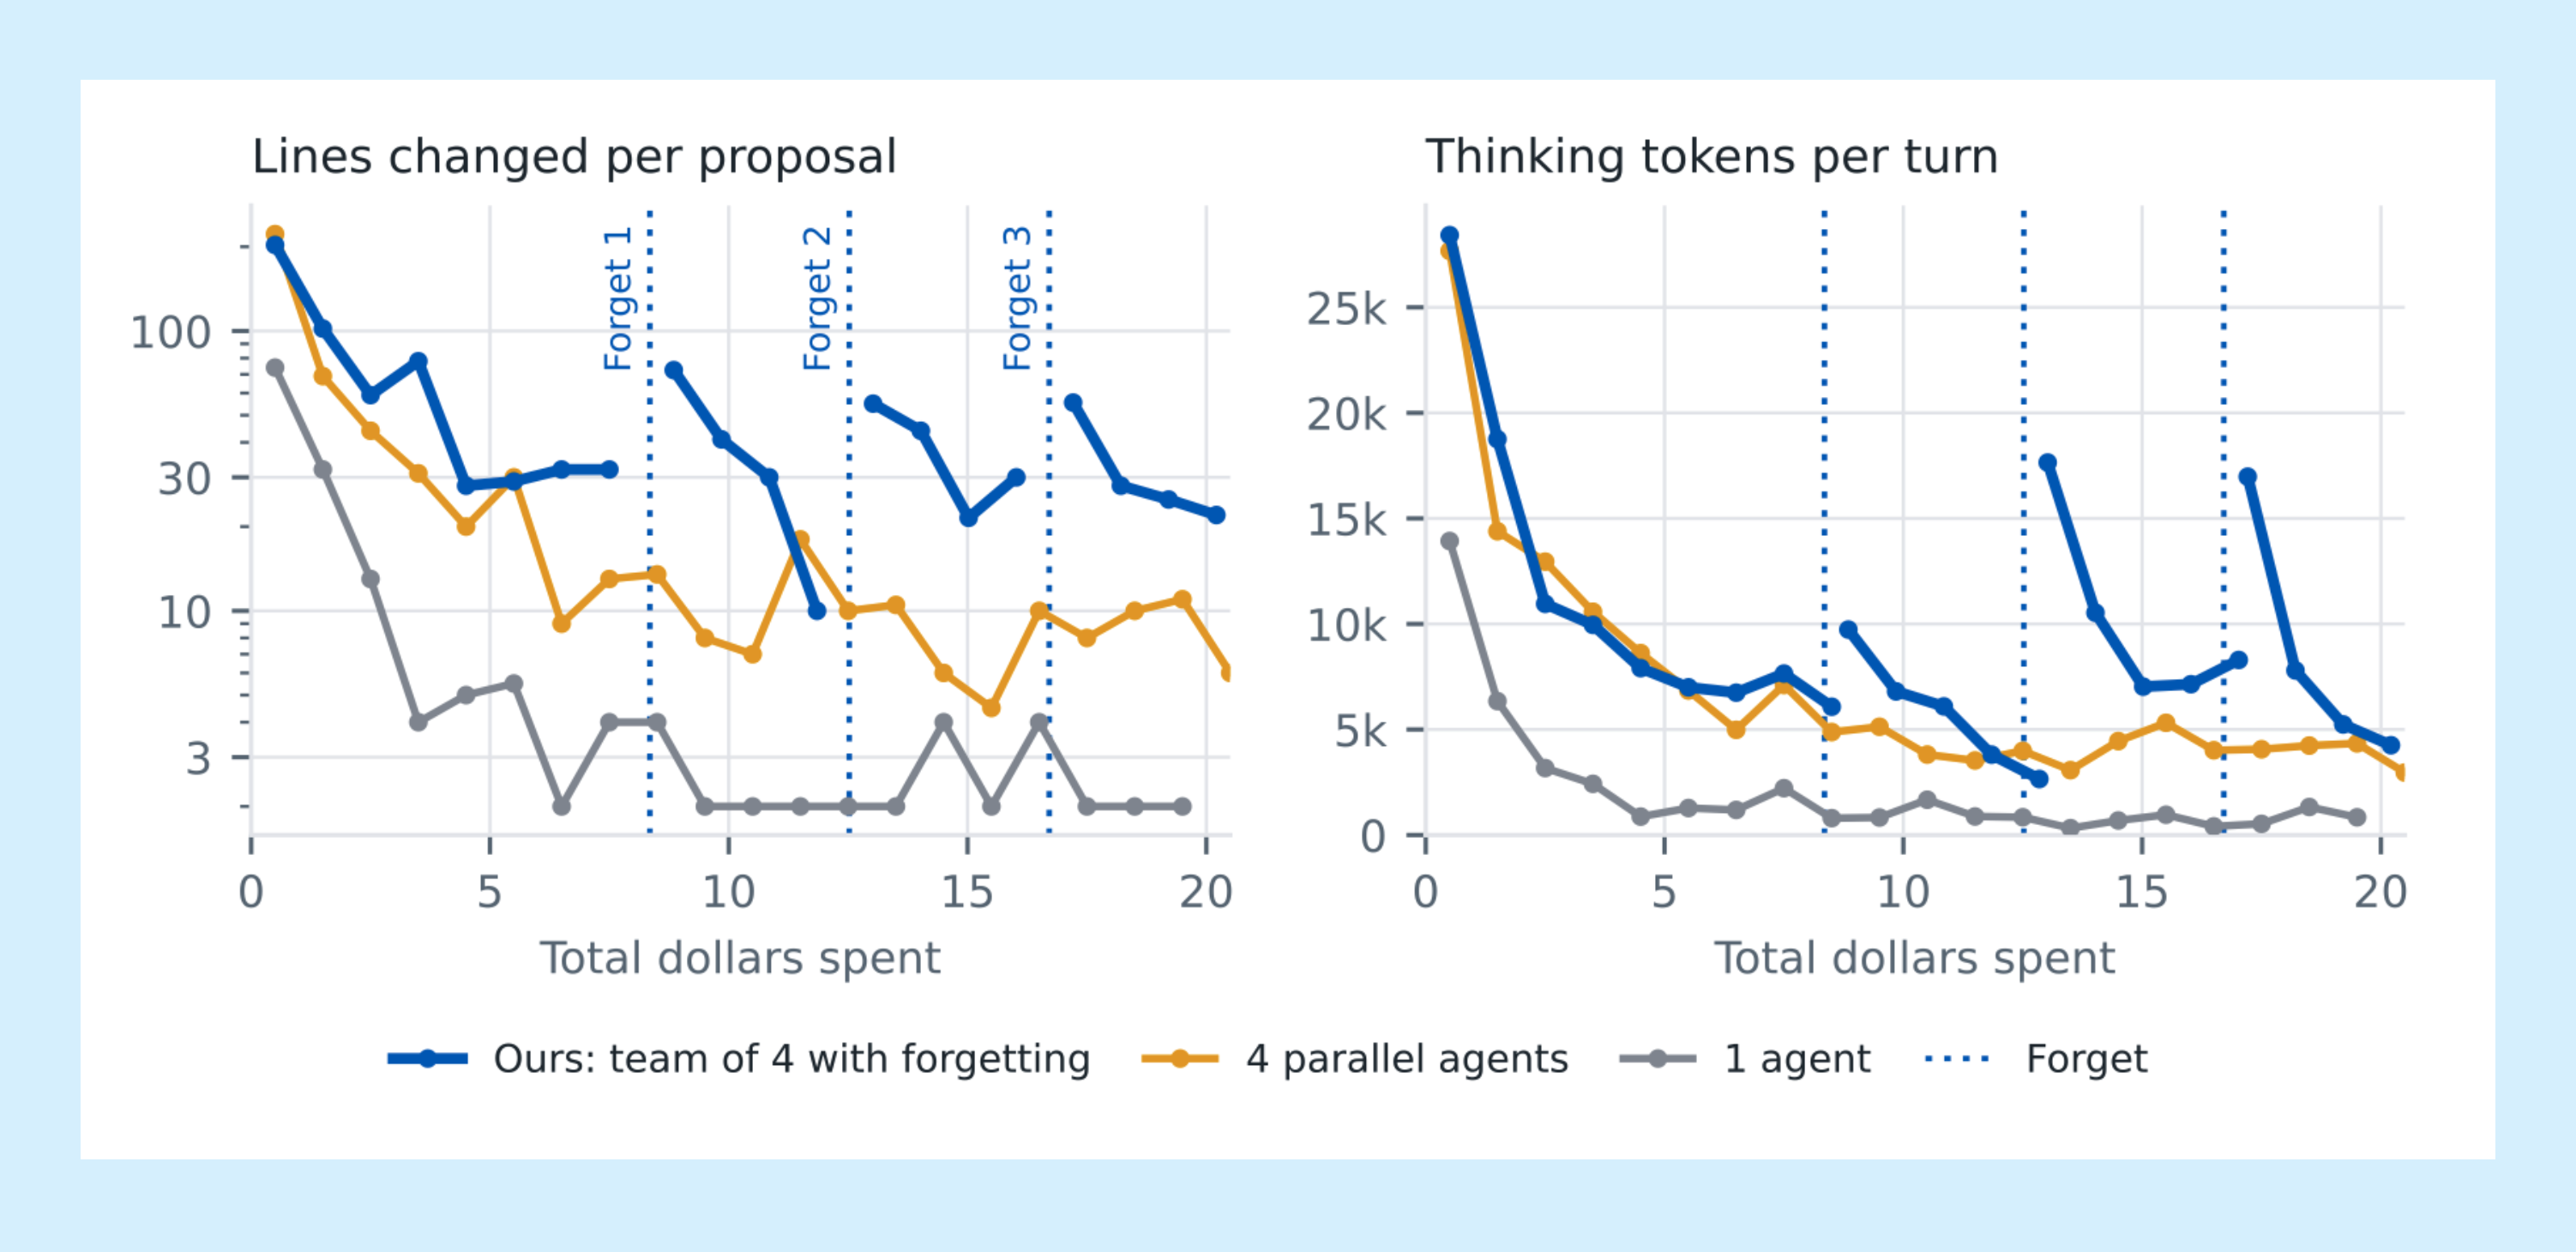
쌓인 컨텍스트는 아이디어의 다양성만 줄이는 것이 아닙니다. 추론의 양까지 줄입니다.
개인적으로는 컨텍스트 관성이 넘을 수 없는 한계라는 쪽에는 걸지 않겠습니다. 연구자와 연구소는 모델이 추론하면서 탐색하도록 훈련해 왔고, 이제는 여기에 관성을 알아차리고 대응하는 능력까지 균형 있게 갖추게 해야 합니다. 새로운 최적화 목표가 생긴 셈입니다.
지금 컨텍스트 관성에 어떻게 대응할 수 있을까
그때까지는 무엇을 해야 할까요?
에이전트로 코딩하는 사람에게는 쉬운 해법이 있습니다. 컨텍스트를 초기화하세요. 제가 속한 단톡방에서도 이미 자주 나오는 말입니다. “모델이 이상하게 굴어요? 컨텍스트가 얼마나 찼는데요?” 이 방법이 통하는 경우가 훨씬 많습니다!
이건 익힐 수 있는 습관입니다(저는 확실히 익혔습니다). 오래 걸리는 작업을 보내기 전이나 모델이 허우적댄다 싶을 때, 전송 전에 /context 명령을 입력하면 됩니다(글이 이상해지는 것은 초기화를 부르는 흔한 징후입니다). 나만의 Memento를 직접 만들어 보는 것도 얼마든지 가능합니다. 간단하게 가려면 이 주방 타이머를 가져다 쓰면 되고, 바이브 코딩으로 재미있게 만들어 봐도 좋습니다(지난주에 제가 만든, Jev로 나쁜 행동을 감시하는 Pi 플러그인이 한 예입니다).
하니스와 워크플로를 만드는 사람에게는 새로 해야 할 일이 생겼습니다. 컴팩션에만 기대지 말고, 컨텍스트 격리(Quarantine)와 오프로딩(Offloading)을 살펴보며 관성을 막으세요. 오래 걸리는 작업에서는 상태를 하니스에 보관하고, 초기화를 두려워하지 마세요.
이메일을 입력하시면 가끔 새 소식을 보내 드립니다.
-
이번 주 릴리스는 GEPA를 비롯한 최적화 기법에서 컨텍스트 관성을 피하는 몇 가지 방법의 토대를 마련합니다. 저희는 Skilled Proposer에서 이 방법들을 실험해 왔습니다. ↩