Anthropic연구Main
과학 컴퓨팅을 위한 장기 실행 Claude
Claude Opus 4.6이 며칠에 걸쳐 미분 가능한 우주론 솔버를 자율적으로 구축했습니다. 수개월이 걸릴 과학 컴퓨팅 작업을 단 며칠로 단축한 사례입니다.
이 글에서는 Discovery 팀의 연구원 Siddharth Mishra-Sharma가 테스트 오라클, 영속 메모리, 오케스트레이션 패턴 등 며칠에 걸쳐 진행되는 에이전트 코딩 워크플로를 자신의 전공 밖 과학 컴퓨팅 작업에 적용하는 방법을 설명합니다.
전제
현재 AI 에이전트를 쓰는 과학자 대부분은 대화형 루프 안에서 작업의 모든 단계를 일일이 통제합니다. 그런데 지난 1년 사이 모델이 장기 과제에서 눈에 띄게 좋아지면서 새로운 방식이 등장했습니다. 세부 사항마다 직접 개입하는 대신 상위 수준의 목표만 정해 주고, 에이전트 팀이 자율적으로 일하도록 맡기는 방식입니다. 이렇게 하면 원래 며칠, 몇 주, 심지어 몇 달이 걸렸을 프로젝트를 불과 몇 시간 만에 끝낼 수 있습니다. 수치 솔버 재구현, 오래된 Fortran 방언으로 작성된 레거시 과학 소프트웨어의 최신 언어 변환, 레퍼런스 구현을 기준으로 한 대규모 코드베이스 디버깅 같은 과학 작업이 이 방식에 잘 맞습니다. 작업 범위가 명확하고, 성공 기준이 분명하며, 사람이 계속 지켜보지 않아도 가끔 점검하는 정도면 충분한 작업들입니다.
Anthropic의 C 컴파일러 프로젝트가 이런 방식의 한 사례입니다. 이 프로젝트에서 Claude는 약 2,000개 세션에 걸쳐 작업하며 리눅스 커널을 컴파일할 수 있는 C 컴파일러를 만들었습니다. 이 글에서는 일반적인 대학 연구실을 염두에 두고, Claude Code로 과학 컴퓨팅 작업에 비슷한 패턴을 구성하는 방법을 소개합니다. 구체적인 예로 Claude Opus 4.6을 사용해 우주론 볼츠만 솔버의 미분 가능 버전을 구현한 과정을 살펴보겠습니다. 이 솔버는 빅뱅의 잔광인 우주 마이크로파 배경(CMB)의 통계적 성질을 예측하는 수치 코드로, 초기 우주에서 광자, 중입자, 중성미자, 암흑물질이 서로 얽힌 방정식을 시간에 따라 풀어 갑니다.
CLASS와 CAMB 같은 볼츠만 솔버는 우주론 분야의 핵심 과학 인프라입니다. Planck나 Simons Observatory 같은 관측 프로젝트의 데이터로 우주론 모형을 제약하는 데 쓰입니다. 솔버 전체에 걸쳐 그래디언트를 전파할 수 있는 미분 가능 버전이 있으면 그래디언트 기반 추론 기법을 쓸 수 있어 매개변수 추정 속도가 크게 빨라집니다. JAX로 작성하면 자동 미분과 GPU 같은 가속기 호환성을 사실상 공짜로 얻을 수 있어 이 작업에 잘 어울립니다.
사실 이 작업은 제 핵심 전공 분야가 아닙니다. 도구와 해당 과학에 대해 개략적으로 아는 정도라, 제가 직접 하면 현실적인 시간 안에는 끝낼 수 없습니다. 반면 그런 전문성을 갖춘 그룹들은 CLASS 기능 중 일부를 갖춘 미분 가능 솔버를 JAX로 만들어 왔는데, 보통 연구자가 수개월에서 수년을 들여야 하는 일입니다. 이번 실험의 목적은 비전문가가 최소한의 지시만 내려도 에이전트가 어디까지 해낼 수 있는지 확인하는 것이었습니다.
이 작업은 수많은 에이전트에 병렬로 나눠 맡길 수 있는 C 컴파일러 프로젝트와는 구조가 다릅니다. 볼츠만 솔버는 깊이 결합된 파이프라인이라서, 초기 우주의 재결합 과정을 모델링할 때 생긴 작은 수치 오차나 부정확한 근사가 이후 모든 단계에 미묘하게 영향을 줄 수 있습니다. 그래서 필요한 에이전트 역량도 다릅니다. 디버깅하려면 전체 체인을 따라 인과관계를 추적하고 도메인 지식을 활용해야 합니다. 따라서 에이전트 하나가 순차적으로 작업하면서 필요할 때 서브에이전트를 띄우고, 레퍼런스 구현으로 불일치 지점을 이분 탐색하는 방식이 더 맞을 수 있습니다.
컴퓨팅 환경으로는 SLURM 작업 스케줄러가 돌아가는 HPC 클러스터를 사용하겠습니다. 다만 진행 상황 파일, 테스트 오라클, 명확한 규칙을 담은 에이전트 프롬프트라는 핵심 아이디어는 Claude Code를 어디서 실행하든 똑같이 적용됩니다.
계획 초안을 작성하고 로컬에서 다듬기
자율 연구 에이전트 팀을 관리하는 방식으로 넘어가면, 시간 대부분은 (Claude와 상의하면서) 프로젝트의 산출물과 관련 맥락을 명확히 담은 지침을 만드는 데 써야 합니다. 이 지침은 루트 디렉터리의 CLAUDE.md 파일에 둡니다. Claude는 이 파일을 특별하게 취급해서 컨텍스트에 계속 유지하고 전체 계획을 확인할 때 참조합니다. 중요한 점은 Claude가 작업하면서 문제를 해결할 때마다 이 지침을 직접 고쳐 이후 작업에 반영할 수 있다는 것입니다.
여기에서 우주론 볼츠만 솔버 프로젝트의 초기 CLAUDE.md를 볼 수 있습니다. 솔버를 처음 한 번 작성해 본 뒤 정리한 전체 계획과 설계 결정이 담겨 있습니다. 이 문서를 만들기 위해 먼저 프로젝트의 상위 목표를 정했습니다. 완전히 미분 가능하면서 레퍼런스인 CLASS 구현과 기능이 완전히 같아야 하고, 주요 과학 산출물에서 CLASS 대비 정확도 0.1%를 달성한다는 것입니다. 그 뒤 계획이 만족스러워질 때까지 Claude와 다듬었습니다. 대표적인 두 볼츠만 코드인 CLASS와 CAMB 사이의 일반적인 일치 수준이 0.1%라는 점에서, 이 정도면 적절한 과학적 목표로 보였습니다.
세션 간 메모리
진행 상황 파일은 여기서 관례대로 CHANGELOG.md라고 부르며, 어디든 들고 다닐 수 있는 에이전트의 장기 메모리이자 일종의 실험 노트 역할을 합니다. CLAUDE.md에는 Claude가 이 파일에 진행 상황을 기록하도록 지시해 두었습니다.
좋은 진행 상황 파일에는 현재 상태, 완료한 작업, 실패한 접근법과 실패 이유, 주요 체크포인트의 정확도 표, 알려진 한계를 기록하면 좋습니다. 특히 실패한 접근법이 중요합니다. 이게 없으면 이후 세션이 똑같은 막다른 길을 다시 시도하게 됩니다. 예를 들어 "섭동 ODE에 Tsit5를 써 봤지만 시스템이 너무 stiff하다. Kvaerno5로 전환했다" 같은 기록을 남길 수 있습니다. 여기에서 이런 요소가 담긴 예제 프로젝트의 changelog를 볼 수 있습니다.
테스트 오라클
에이전트가 더 개방적인 과학적 발견을 해내는 날도 분명 오겠지만, 지금 단계에서 장시간 자율 과학 작업이 성공하려면 에이전트가 스스로 진전이 있는지 판단할 수단을 갖추는 것이 필수입니다. 과학 코드라면 레퍼런스 구현, 명확하게 정량화할 수 있는 목표, 기존 테스트 스위트가 그런 수단이 될 수 있습니다. 회귀를 막으려면 에이전트가 작업하면서 테스트 스위트를 확장하고 테스트를 실행하도록 지시하는 것도 도움이 됩니다. 이번 예제에서는 CLASS C 소스를 레퍼런스 구현으로 삼아 단위 테스트를 작성하고 계속 실행하도록 Claude에게 지시했습니다.
조율 수단으로서의 Git
Git은 사람이 직접 개입하지 않고도 에이전트의 진행 상황을 모니터링하고 조율하기 좋은 수단입니다. 에이전트가 의미 있는 작업 단위를 끝낼 때마다 commit하고 push하도록 하세요. 그러면 문제가 생겼을 때 복구할 수 있는 이력이 남고, 진행 상황을 로컬에서 확인할 수 있으며, 세션 도중 컴퓨팅 할당량이 소진되더라도 작업이 사라지지 않습니다.
실제로는 CLAUDE.md에 다음과 같은 지침을 넣으면 됩니다. "의미 있는 작업 단위를 끝낼 때마다 commit하고 push할 것. commit 전에는 항상 `pytest tests/ -x -q`를 실행할 것. 기존에 통과하던 테스트를 깨뜨리는 코드는 절대 commit하지 말 것."
에이전트를 조종하려면 언제든 클러스터에 SSH로 접속해서 직접 프롬프트를 다시 입력하거나 지침을 수정하면 됩니다. 다만 로컬의 Claude Code 인스턴스에게 SSH로 접속해 명령을 실행하게 하는 편이 대개 더 편하며, 아래에서 설명하는 모든 작업에도 마찬가지로 적용됩니다.
실행 루프
앞서 말했듯이 먼저 로컬에서 계획을 다듬어 합리적으로 보이는 계획을 CLAUDE.md에 담아 두면 좋습니다. 그다음 컴퓨트 노드에서 tmux 같은 터미널 멀티플렉서 안에 Claude Code 세션을 시작하고, 에이전트에게 코드베이스 위치를 알려 준 뒤 알아서 작업하게 둡니다. 세션이 tmux 안에서 돌아가므로 접속을 끊고 노트북을 덮어도 되고, 가끔 진행 상황만 확인하면 됩니다. 볼츠만 솔버 작업 때는 커피를 사러 줄을 서 있는 동안 휴대폰으로 GitHub를 확인하곤 했습니다.
HPC 클러스터에서는 SLURM 스케줄러로 노드를 요청하게 됩니다. tmux 세션에서 Claude Code를 실행하는 작업 스크립트 예시는 다음과 같습니다.
#!/bin/bash
#SBATCH --job-name=claude-agent
#SBATCH --partition=GPU-shared
#SBATCH --gres=gpu:h100-32:1
#SBATCH --time=48:00:00
#SBATCH --output=agent_%j.log
cd $PROJECT/my-solver
source .venv/bin/activate
export TERM=xterm-256color
tmux new-session -d -s claude "claude; exec bash"
tmux wait-for claude
작업이 시작되면 tmux 세션에 접속해 Claude Code에 방향을 알려 줍니다(예: "CHANGELOG.md를 읽고 다음 작업을 이어서 진행해"). 제대로 가고 있다고 판단되면 세션에서 빠져나옵니다. 상태를 확인하거나 방향을 조정하거나 새 작업을 시작하고 싶을 때는 언제든 다시 접속하면 되며, 다음과 같은 명령을 쓸 수 있습니다.
srun --jobid=JOBID --overlap --pty tmux attach -t claude
Ralph 루프: 모델이 강력해질수록 프롬프트 엔지니어링, RAG, 컨텍스트 채우기 같은 맞춤형 오케스트레이션은 덜 필요해집니다. 그래도 특정 시점에는 역량을 끌어올리는 보조 장치로서 어느 정도의 스캐폴딩이 유용할 수 있습니다. 예를 들어 현재 모델은 에이전트의 게으름 문제를 보일 수 있습니다. 여러 부분으로 이루어진 복잡한 작업을 맡기면 전체를 끝내기 전에 핑계를 대며 멈추기도 합니다("시간이 늦었으니 내일 다시 이어서 할까요?").
이를 피하는 데 쓸 만한 오케스트레이션 패턴이 Ralph 루프입니다. 본질적으로는 for 루프로, 에이전트가 작업을 끝냈다고 주장하면 다시 컨텍스트로 불러들여 정말로 끝났는지 되묻습니다. 그러면 에이전트가 작업이 아직 기준에 못 미친다고 인정하고 기준을 충족할 때까지 계속 일하기 때문에, 장시간 작업에 유용합니다. 비슷한 패턴으로는 GSD(와 도메인 특화 변형), 그리고 Claude Code 기본 제공 /loop 명령이 있습니다.
Ralph는 /plugin으로 설치할 수 있습니다. Claude Code에서 호출하는 프롬프트는 보통 다음과 같습니다.
/ralph-loop:ralph-loop “Please keep working on the task until the success criterion of 0.1% accuracy across the entire parameter range is achieved.” --max-iterations 20 --completion-promise “DONE”이렇게 하면 Claude는 최대 20번까지 반복하며, 작업이 끝났다고 확신할 때 "DONE"이라는 주문을 외워 완료를 보증합니다.
결과
Claude는 이 프로젝트를 처음부터 며칠에 걸쳐 진행했고, 여러 출력에서 레퍼런스인 CLASS 구현과 1% 미만의 오차로 일치하는 수준에 도달했습니다. 저는 프로젝트 진행 중 코드의 주요 출력인 여러 CMB 각 파워 스펙트럼의 정확도가 어떻게 변해 왔는지 Claude에게 재구성해 달라고 요청했고, 개발 중 주요 마일스톤도 함께 표시하게 했습니다. 아래 그래프는 그 결과로, 1% 미만의 정확도에 이르기까지의 과정을 보여 줍니다.
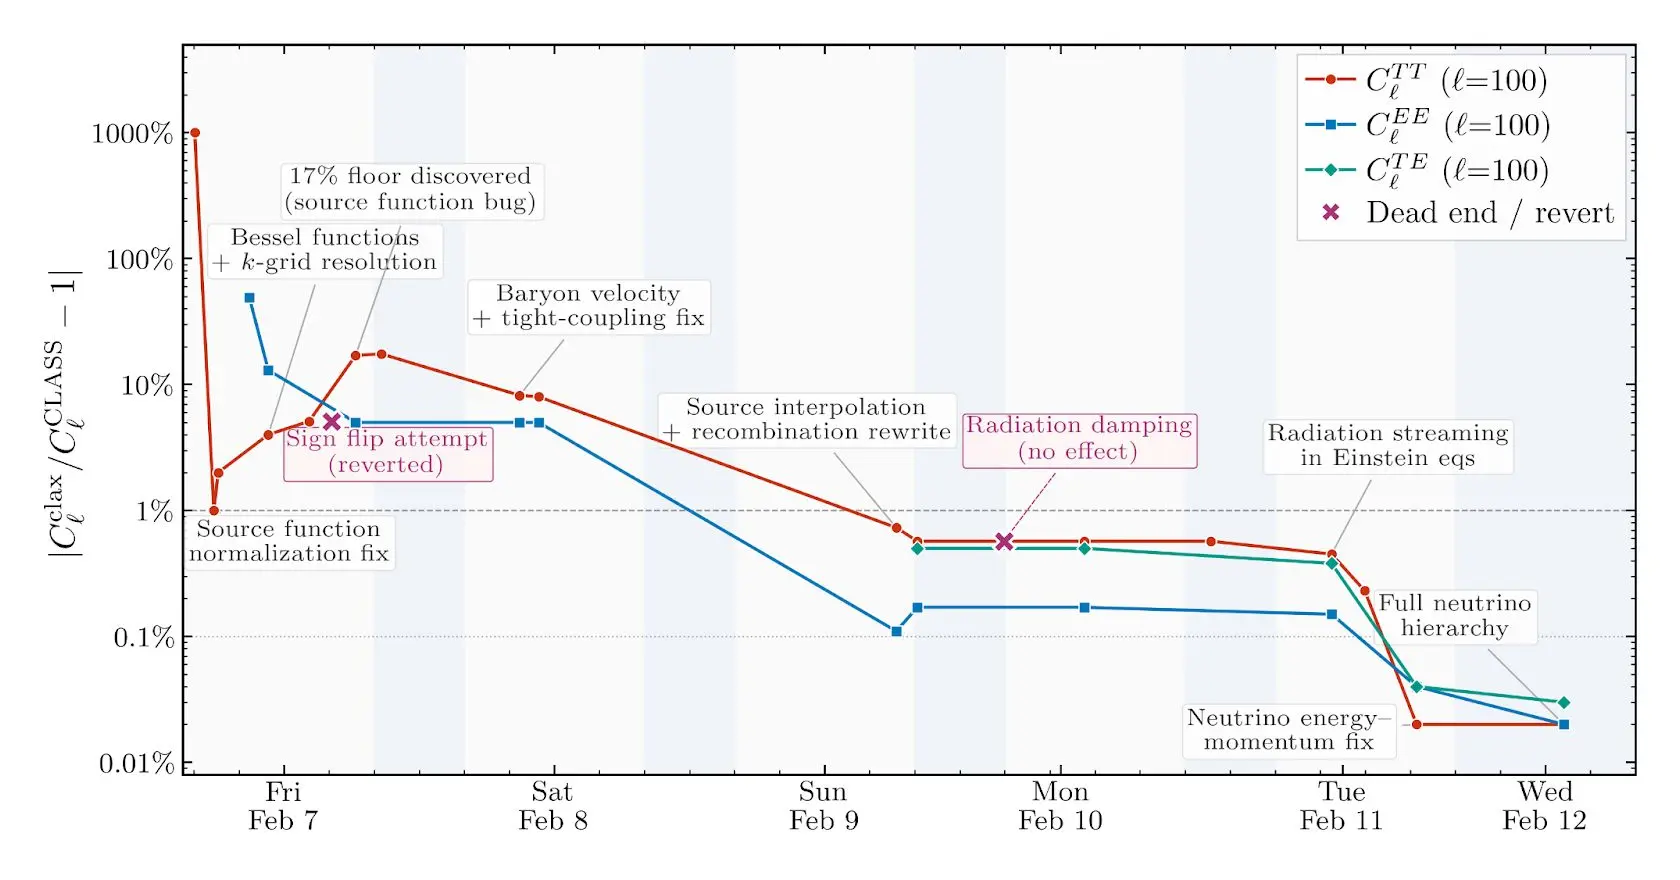
에이전트가 코드베이스를 작업하는 동안 시간에 따라 1% 미만의 정확도에 이르는 과정.
에이전트의 개발 과정은 다소 어설픈 면도 있었습니다. 예를 들어 테스트 커버리지에 분명한 빈틈이 있었습니다. 한동안은 기준(fiducial) 매개변수 한 지점에서만 코드를 테스트해서 버그를 잡아낼 수 있는 범위가 크게 줄었습니다. 게이지 규약에서 헛발을 딛거나 우주론자라면 바로 알아챌 버그를 붙들고 몇 시간씩 헤매는 기초적인 실수도 합니다. 그래도 1% 미만의 정확도라는 목표를 향해 꾸준히 전진했습니다.
이 프로젝트의 부수적인 소득도 있었습니다. git commit 이력을 지켜보면서 볼츠만 솔버와 그것이 모델링하는 물리에 대해 놀랄 만큼 많이 배웠습니다. 이 프로젝트는 제 핵심 전공 분야가 아니지만, Claude가 조금씩 진전하는 과정을 따라가며 모르는 내용을 찾아보는 것이 과학을 체득하는 효과적인 방법이었습니다. commit 로그는 빠르지만 지나치게 문자 그대로 일하는 박사후연구원의 실험 노트처럼 읽힙니다.
결과물인 솔버는 아직 프로덕션 수준은 아닙니다. 모든 영역에서 레퍼런스인 CLASS 구현과 허용할 만한 정확도로 일치하지는 않습니다. 그래도 에이전트 주도 개발이 연구자의 수개월, 길게는 수년치 작업을 며칠로 압축할 수 있음을 보여 줍니다.
이런 압축은 무엇을 유휴 시간으로 볼지도 바꿔 놓습니다. AI 연구자라면 누구나 밤사이 실험(예: 학습 실행)을 돌려 놓고 아침에 결과를 확인하는 만족감을 알 것입니다. 실험을 돌리지 않으면 기회비용이 생깁니다. 요즘은 에이전트를 돌리지 않는 것에도 비용이 드는 느낌입니다. 컴퓨팅 자원과 성공 기준이 명확한 프로젝트가 있다면, 에이전트가 일하게 하지 않은 밤마다 얻을 수 있었던 진전을 그냥 놓치는 셈입니다.