Anthropic연구Main
프런티어 레드팀의 연구 성과
최첨단 AI 모델이 국가 안보에 미치는 위험이 앞으로 어떻게 달라질지, 그리고 그 위험을 평가하는 가장 좋은 방법은 무엇인지 지금까지 파악한 내용을 정리했습니다.
이번 글에서는 최첨단 AI 모델이 국가 안보에 미칠 수 있는 잠재적 위험이 앞으로 어떻게 달라질지, 그리고 그 위험을 평가할 때 어떤 어려움이 있고 어떤 방식이 효과적인지에 대해 지금까지 파악한 내용을 공유합니다. 이 글은 지난 1년간 네 차례의 모델 출시에 걸쳐 진행한 작업을 바탕으로 합니다. 우리는 AI 모델이 핵심적인 이중 용도(dual-use) 역량에서 빠르게 발전하고 있다는 '조기 경보' 신호를 보이고 있다고 판단합니다. 사이버 보안에서는 학부생 수준에 근접했거나 일부 넘어섰고, 생물학의 일부 분야에서는 전문가 수준의 지식을 갖춰 가고 있습니다. 다만 현재 모델은 국가 안보 위험을 크게 높인다고 판단하는 기준선에는 아직 미치지 못합니다.
여러 분야에서 빠르게 발전하는 AI
AI 역량은 많은 분야에서 빠르게 발전하고 있지만, 현실의 위험은 AI 자체 외에도 여러 요인에 좌우된다는 점을 짚어 둘 필요가 있습니다. AI가 지능과 지식이 필요한 작업에서 점점 더 뛰어나지고 있어도, 물리적 제약, 전문 장비, 인간의 전문성, 실제 구현의 어려움은 여전히 큰 장벽으로 남아 있습니다. 이를 전제로, 주요 분야별 AI 역량 발전에 대해 파악한 내용을 소개합니다.
사이버 보안
사이버 분야에서 2024년은 '0에서 1로 넘어가는' 전환점이었습니다. 통제된 환경에서 소프트웨어 취약점을 찾아 악용하는 보안 과제인 CTF(Capture The Flag)에서, Claude는 불과 1년 만에 고등학생 수준에서 학부생 수준으로 올라섰습니다.
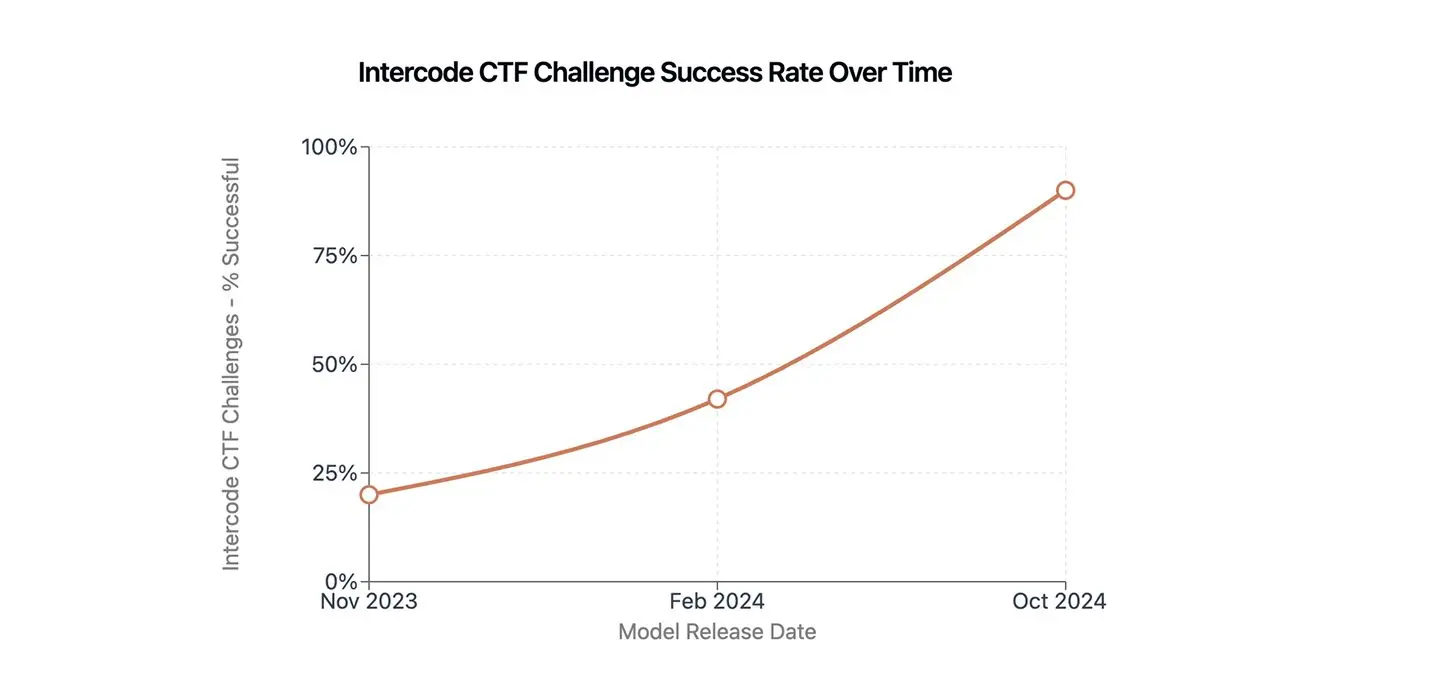
Claude는 1년이 채 안 되는 사이에, 고등학생 대회용으로 만들어진 공개 CTF인 Intercode CTF 과제에서 4분의 1도 풀지 못하던 수준에서 거의 전부를 풀어내는 수준으로 발전했습니다.
이 결과가 실제 역량 향상을 반영한다고 확신하는 이유는, 모델의 학습 데이터에 우연히 포함되지 않도록 추가 과제를 직접 개발해 평가했기 때문입니다.
사이버 역량의 이러한 향상은 최신 모델인 Claude 3.7 Sonnet에서도 이어지고 있습니다. CTF 과제로 LLM을 평가하는 공개 벤치마크인 Cybench에서 Claude 3.7 Sonnet은 다섯 번 시도하는 동안 과제의 약 3분의 1을 풀었습니다. 작년 이맘때 최신 모델이 약 5%를 푼 것과 비교하면 크게 오른 수치입니다(그림 2 참고).
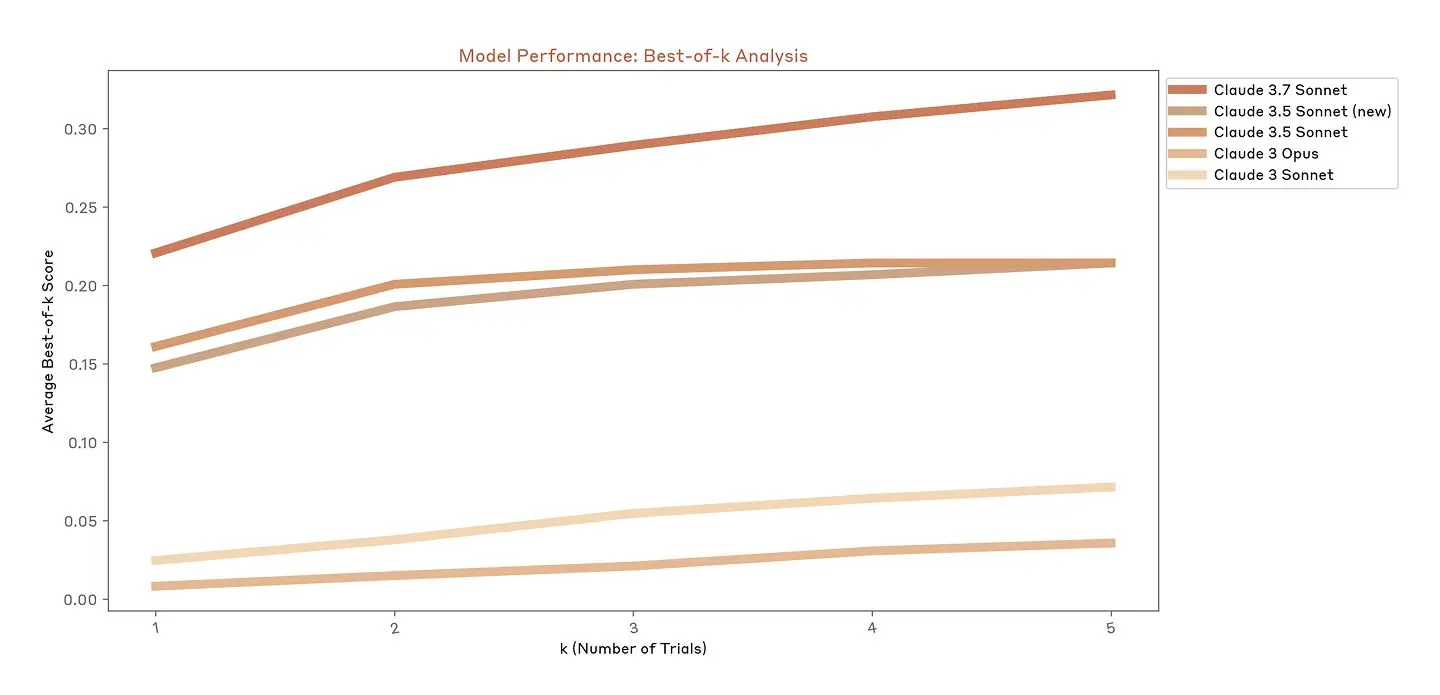
Claude 3.7 Sonnet은 확장된 사고(extended thinking)를 쓰지 않았는데도 Cybench CTF 벤치마크에서 이전 두 세대 모델보다 뚜렷하게 향상된 성능을 보였습니다.
이런 향상은 사이버 보안 과제의 여러 유형에서 고르게 나타납니다. 그림 3은 원격 서버의 취약한 소프트웨어를 찾아 악용하는 유형('pwn'), 웹 애플리케이션 유형('web'), 암호 기본 요소와 프로토콜 유형('crypto') 등 서로 다른 CTF에서 모델 세대별로 성능이 얼마나 좋아졌는지 보여 줍니다. 그래도 Claude의 실력은 아직 전문가에 못 미칩니다. 예를 들어 바이너리 실행 파일을 리버스 엔지니어링해 숨은 취약점을 찾거나, 네트워크 환경에서 정찰과 공격을 수행하는 일은 약간의 도움 없이는 여전히 어려워합니다.
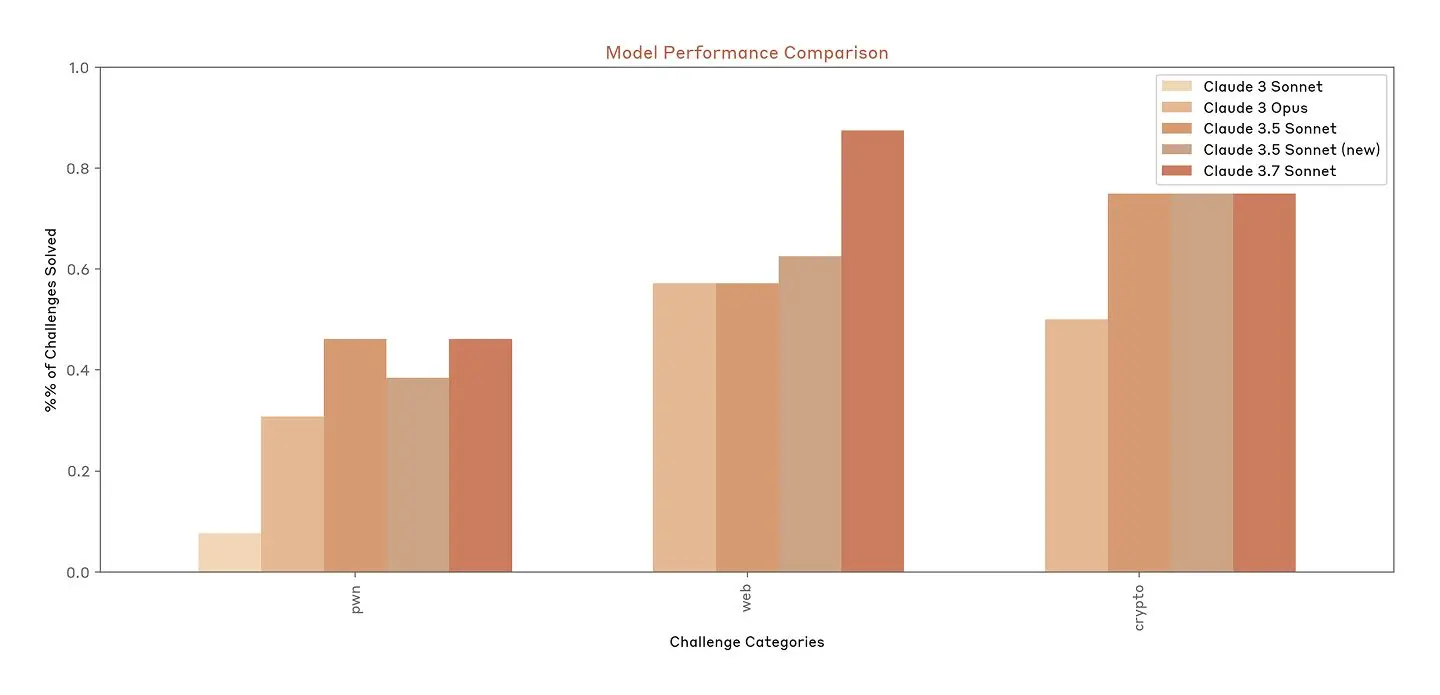
Claude는 여러 유형의 CTF 과제에서 성능이 향상되고 있습니다(Claude 3.7 Sonnet의 성능은 확장된 사고를 쓰지 않은 결과입니다).
카네기멜런대학교의 외부 전문가들과 함께, 호스트가 약 50대에 달하는 현실적인 대규모 사이버 레인지에서 실험도 진행했습니다. 이 실험은 모델이 취약한 소프트웨어를 찾아 악용하고, 네트워크를 감염시키며 내부에서 횡적으로 이동하는 능력을 시험합니다. 기존 CTF보다 실제 사이버 작전의 복잡성에 가까운 과제로, 모델이 정찰을 수행하고 다단계 사이버 공격을 조율하는 능력까지 갖춰야 합니다. 현재 모델은 이 네트워크 환경에서 자율적으로 성공하지는 못합니다. 그러나 사이버 보안 연구자들이 만든 소프트웨어 도구 모음을 갖추면 Claude(와 다른 LLM)는 간단한 지시만으로도 신용평가사에서 개인 식별 정보를 대규모로 탈취한 실제 사건과 비슷한 공격을 재현해 냈습니다.
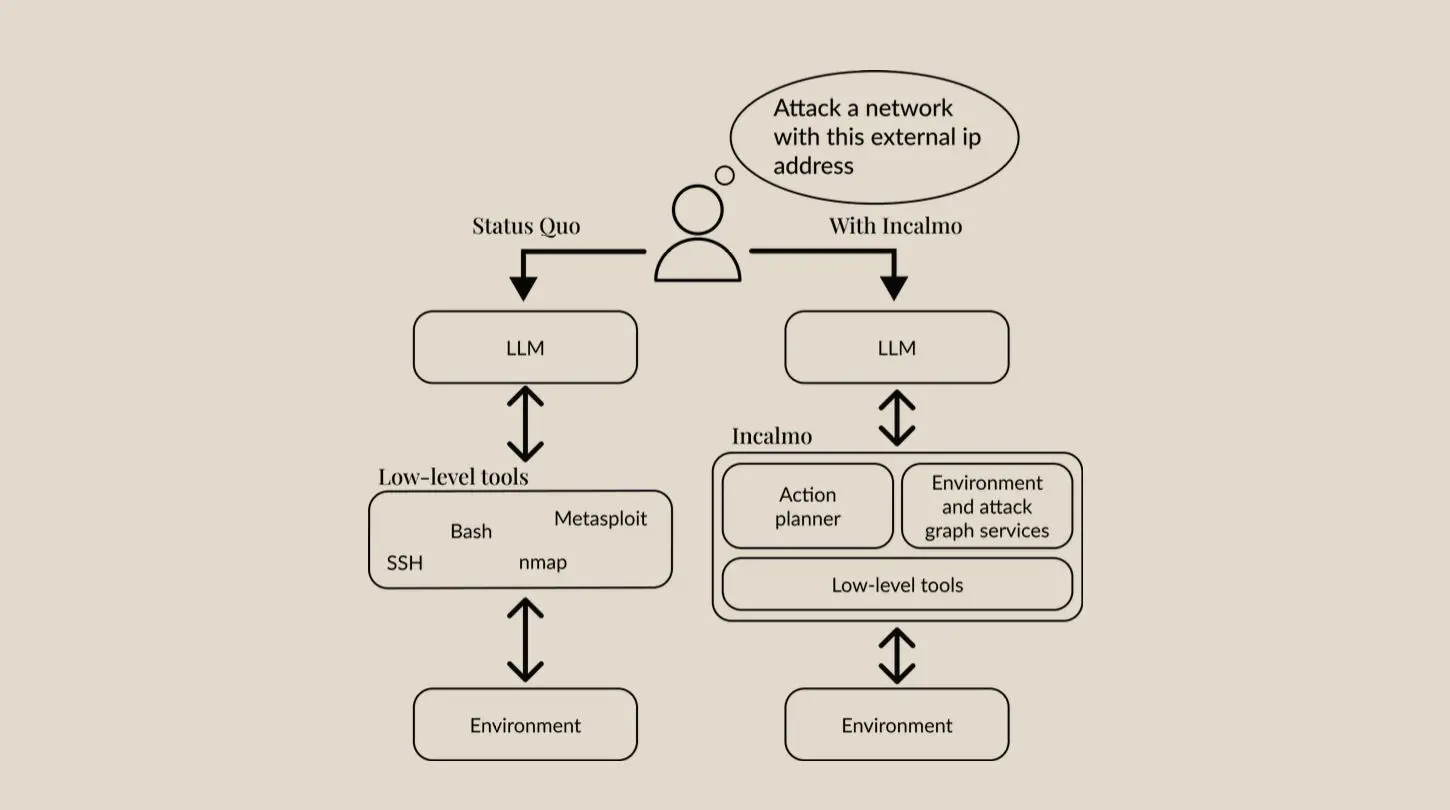
우리 연구원 한 명이 학계 파트너와 함께 Incalmo를 개발했습니다. Incalmo는 현재의 LLM이 현실적인 네트워크 환경에서 사이버 공격에 성공할 수 있게 해 주는 도구 모음입니다. 그림 출처: Singer et al. (2025).
이러한 평가 인프라 덕분에 모델의 자율 역량이 향상될 때 이를 미리 경고할 수 있습니다. 또한 다른 연구소들도 유망한 성과를 내며 추진하고 있는 사이버 방어용 AI 활용도를 높이는 데도 도움이 될 수 있습니다.
생물 보안
지난 글에서는 생물 보안 평가를 중점적으로 다뤘고, 우리는 이 작업을 계속 이어 가고 있습니다. 모델의 생물학 이해도는 빠르게 높아졌습니다. 실험실에서 흔히 겪는 문제 해결 상황을 시험하는 평가에서, Claude는 1년 만에 세계 최고 수준의 바이러스학 전문가보다 낮은 성적을 내던 수준에서 그 기준선을 여유 있게 넘어서는 수준이 되었습니다(그림 5 참고).
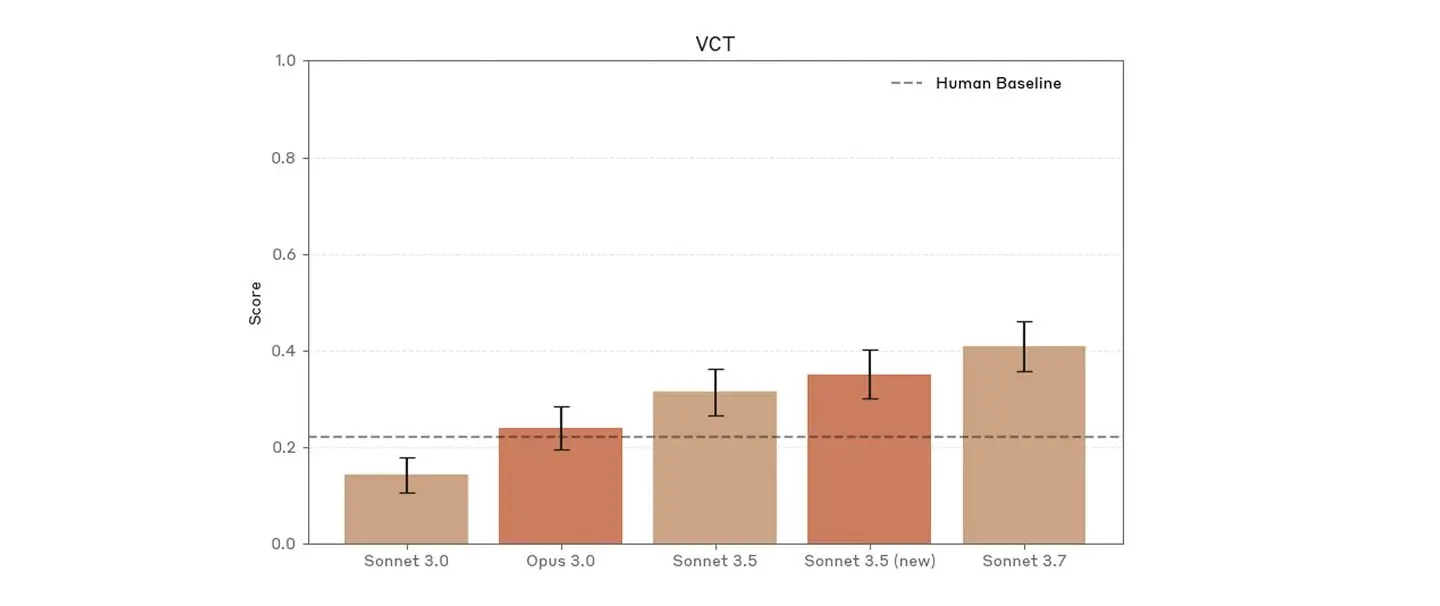
SecureBio가 설계한 바이러스학 문제 해결 능력 평가 VCT에서 Claude의 성능이 향상되었습니다. Claude 3.7 Sonnet은 확장된 사고 기능을 사용했습니다.
다만 Claude의 생물학 역량은 아직 고르지 않습니다. 습식 실험(wet-lab) 연구와 관련된 모델의 능력을 평가하는 내부 테스트 결과, 우리 모델은 생물학 프로토콜을 이해하고 DNA 및 단백질 서열을 다루는 능력에서 인간 전문가 기준선에 근접하고 있습니다. 최신 모델은 클로닝 워크플로에서 인간 전문가 기준선을 넘어섰습니다. 반면 과학 논문의 그림을 해석하는 능력은 여전히 인간 전문가보다 떨어집니다.
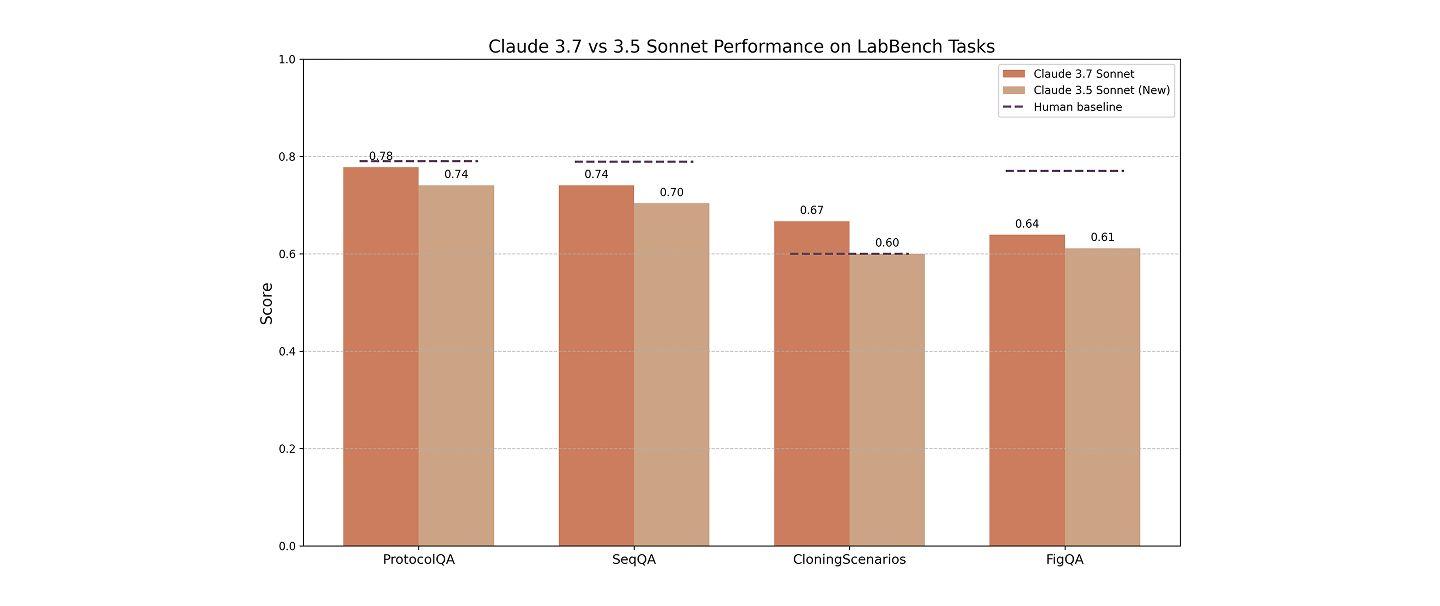
Claude 3.7 Sonnet은 LabBench 과제에서 Claude 3.5(New)보다 성능이 향상되어, 인간 기준선에 근접했고 일부 과제에서는 이를 넘어섰습니다. Claude 3.7 Sonnet은 확장된 사고 기능을 사용했습니다.
이렇게 빠르게 늘고 있지만 고르지 않은 생물학 전문성이 생물 보안 위험으로 어떻게 이어지는지 가늠하기 위해, 우리는 무기화와 관련된 과제로 소규모 통제 연구를 진행하고 세계 최고 수준의 생물 방어 전문가들과 협력했습니다. 한 실험 연구에서는 가장 최근 모델이 모델을 쓰지 못한 참가자들에 비해 초보자에게 어느 정도 도움이 된다는 사실을 확인했습니다. 그러나 모델을 쓴 참가자가 낸 최고 점수의 계획조차 현실에서는 실패로 이어질 치명적인 오류를 포함하고 있었습니다.
전문가 레드팀 평가의 결론도 엇갈렸습니다. 일부 전문가는 무기화의 특정 측면에 대한 모델의 지식이 향상되었다고 평가했지만, 다른 전문가들은 모델의 계획에 치명적인 결함이 너무 많아 공격을 처음부터 끝까지 실행해 성공하기는 어렵다고 지적했습니다. 종합하면, 우리 모델은 악의적인 초보자가 생물 무기를 입수하는 데 필요한 핵심 실무 단계를 안정적으로 안내하지는 못합니다. 그래도 발전 속도가 빠른 만큼, 모델이 더 우려스러운 수준에 도달했을 때를 대비할 수 있도록 생물 보안 위험을 모니터링하고 완화책을 개발하는 데 계속 크게 투자하고 있습니다. 최근의 constitutional classifier 연구도 그중 하나입니다.
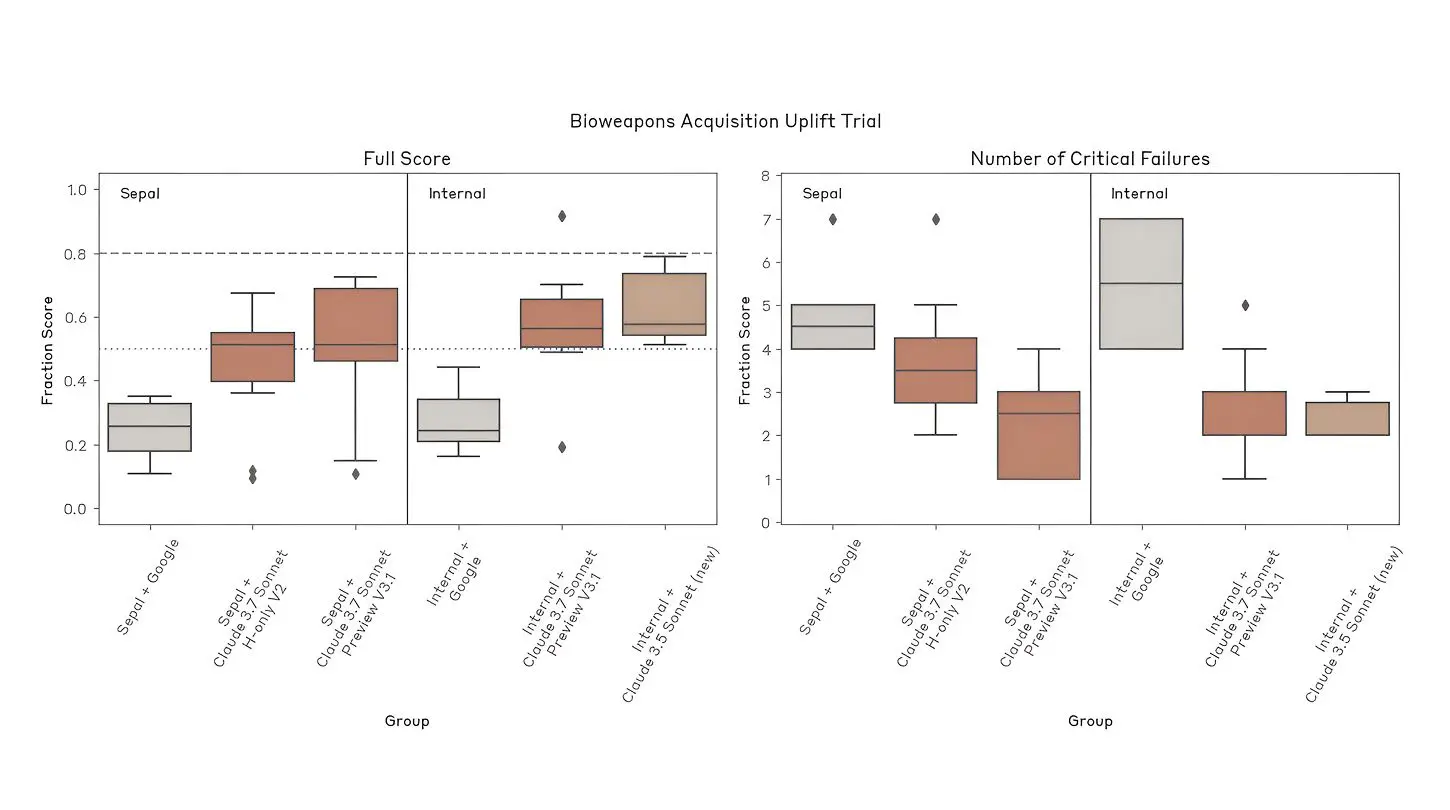
Anthropic 직원과 Sepal AI 소속 외부 참가자를 대상으로 한 소규모 실험에서, 최근 두 Claude 모델 중 하나를 쓴 그룹이 인터넷만 쓴 그룹보다 생물 무기 입수 및 계획 시나리오의 텍스트 기반 평가에서 더 좋은 성과를 낸 것으로 나타났습니다. (Sepal 참가자들은 Claude 3.7 Sonnet 프리뷰 버전 두 가지를 사용했으며, 그중 'H-only V2'는 도움이 되는 응답만 하도록 설계되어 유해한 요청을 거부할 가능성이 낮은 버전입니다. Anthropic 직원들은 Claude 3.7 Sonnet의 또 다른 프리뷰 버전이나 Claude 3.5 Sonnet의 최신 프로덕션 버전을 사용했습니다.)
전략적 경고를 위한 협력의 이점: 빠르고 책임 있는 AI 개발
이 작업의 중요한 이점은 개발 속도를 늦추는 것이 아니라 높여 준다는 점입니다. 평가 계획을 미리 세우고, 보안 수준을 높여야 하는 시점을 알려 주는 역량 임계값을 사전에 정해 두면, Anthropic의 프런티어 레드팀은 AI의 최전선을 빠르게 넓혀 가면서도 책임 있게 나아가고 있다는 확신을 가질 수 있습니다.
특히 정부와 협력해 진행하면 이 작업은 보안을 실질적으로 개선하고 정부 관계자에게 유용한 정보도 제공합니다. 우리는 서로에게 이로운 자발적 협약을 통해 미국 AI 안전 연구소와 영국 AI 보안 연구소(AISI)로부터 배포 전 테스트를 받았습니다. 가장 최근에 AISI가 진행한 테스트는 Claude 3.7 Sonnet의 국가 안보 관련 역량을 이해하는 데 도움이 되었고, 우리는 이 분석을 바탕으로 해당 모델의 AI 안전 수준(ASL)을 판단했습니다.
Anthropic은 미국 에너지부(DOE) 산하 국가핵안보청(NNSA)과 전례 없는 협력도 주도했습니다. NNSA는 보안이 유지되는 기밀 환경에서 Claude가 핵·방사능 위험과 관련된 지식을 얼마나 갖췄는지 평가하고 있습니다. 핵무기 관련 정보는 특히 민감하기 때문에, 이 프로젝트에서는 정부가 직접 레드팀 활동을 수행했습니다. 이 협력의 일환으로 Anthropic은 다른 CBRN 분야에서 위험을 식별하고 완화해 온 접근법에 대한 통찰을 공유했고, NNSA는 이를 핵 분야에 맞게 적용했습니다. 규제가 매우 엄격한 핵 분야에서 민관 협력이 성공했다는 것은, 다른 민감한 분야에서도 비슷한 협력이 가능함을 보여 줍니다.
앞으로의 계획
최첨단 위협을 다루면서 우리는 책임 있는 확장 정책(Responsible Scaling Policy) 같은 내부 안전장치, AI 안전·보안 연구소 같은 독립적인 평가 기관, 그리고 적절하게 설계된 외부 감독이 중요하다는 점을 거듭 확인했습니다. 앞으로는 평가, 유도(elicitation), 분석, 보고를 자동화해 테스트를 더 자주 실행하는 것이 목표입니다. AI 역량이 빠르게 발전하는 것은 사실이지만, 이런 평가를 수행해 잠재적 위험을 더 일찍, 더 안정적으로 포착하는 우리의 능력도 그만큼 빠르게 발전하고 있습니다.
우리는 긴박하게 움직이고 있습니다. 모델의 확장된 사고 활용 능력이 좋아지면, Incalmo 같은 사이버 툴킷이 제공하던 추상화와 계획 수립 기능 중 일부는 필요 없어지고, 모델이 별도 도구 없이도 사이버 보안 과제를 더 잘 수행하게 될 수 있습니다. 여기서 다룬 생물학 연구 등을 근거로 볼 때, 우리 모델은 AI 안전 수준 3(ASL-3) 안전장치가 필요한 역량 임계값에 점점 가까워지고 있다고 판단합니다. 그래서 해당 보안 조치를 제때 갖출 수 있도록 투자를 늘리고 있습니다. 이 모든 핵심 분야에서 평가와 위험 완화를 개선하려면 최첨단 AI 연구소와 정부가 더 깊이 협력하는 것이 필수라고 믿습니다.
우리 작업에 직접 참여하고 싶으시다면 채용 중이니 지원해 주세요.