Anthropic개발 블로그Playbooks
Claude Sonnet 5.5로 개발하기
Opus 대신 Sonnet을 선택해야 할 때는 언제인지, 비용은 얼마나 드는지, 어떻게 튜닝하면 좋은지 정리했습니다.
Claude Sonnet 5.5는 Opus 5.5에 이어 Claude 5.5 패밀리로 나온 두 번째 모델입니다. Sonnet 5보다 확실히 나아져서 더 똑똑하고 효율적이며 30% 더 빠릅니다. 토큰당 가격은 그대로인데, 같은 작업을 처리하는 데 필요한 토큰이 보통 훨씬 적어서 대부분의 작업에서 비용이 최대 30% 줄어듭니다.
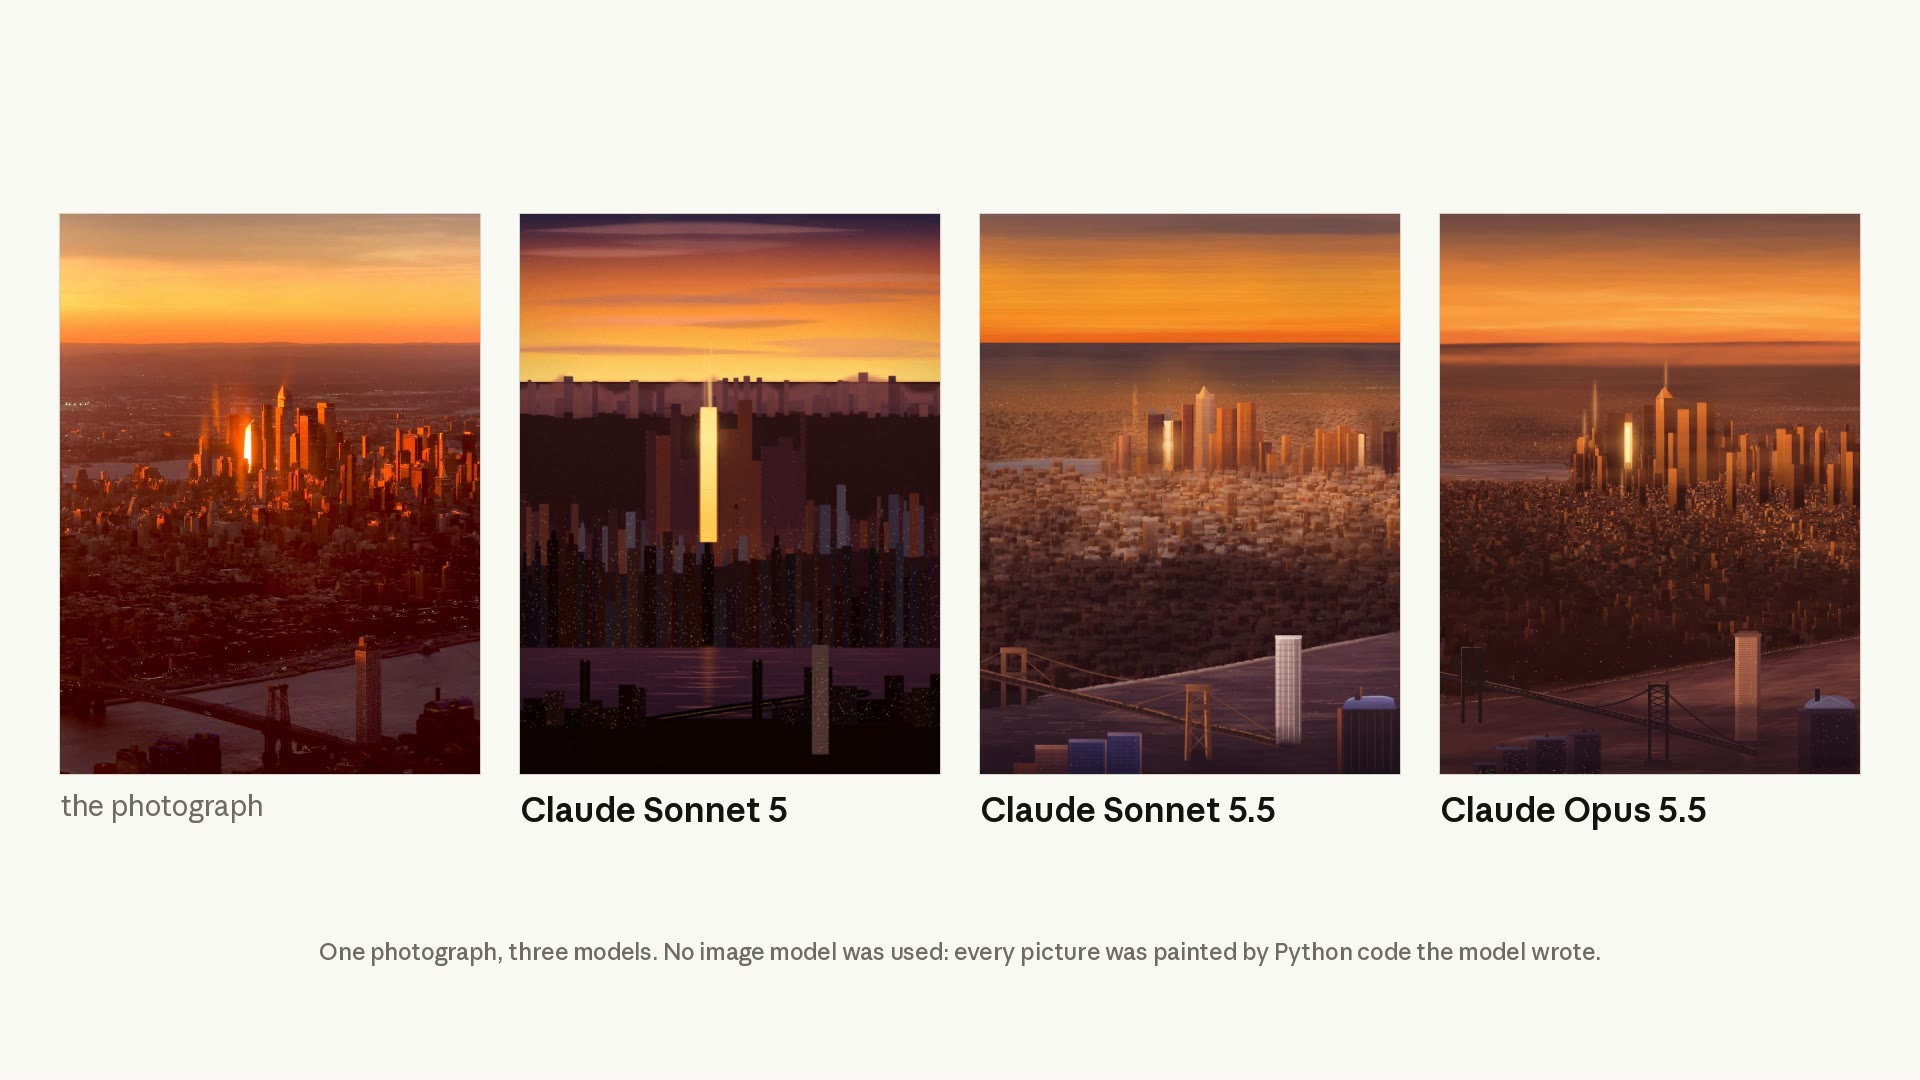
코드 투 페인팅 아이디어를 준 @jkeatn, 참고 이미지를 제공한 @IceSolst에게 감사드립니다.
이 가이드는 Sonnet 5.5로 개발하는 방법을 다룹니다. 먼저 아래 요청을 그대로 실행해 보세요.
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[
        {
            "role": "user",
            "content": "Analyze the trade-offs between microservices and monolithic architectures",
        }
    ],
    output_config={"effort": "medium"},
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Sonnet 5.5는 기본적으로 thinking을 사용하므로 응답이 thinking 블록으로 시작할 수 있고, content[0].text을 읽는 코드는 오류가 납니다. 그래서 이 루프는 블록을 타입별로 나누어 읽습니다.
SONNET 5.5와 OPUS 5.5 중 선택하기
Claude 5.5 패밀리에서 Opus 5.5는 세심한 판단이 필요한 복잡한 작업을 위한 모델입니다. 버그 수정이나 기능의 빠른 반복 개발처럼 범위가 분명한 일상적인 작업에는 Sonnet 5.5를 쓰세요. 문서, 슬라이드, 스프레드시트도 완성도 있게 만들고 디자인 감각도 뛰어납니다. 속도가 빨라 빠르게 반복 작업을 하기에 적합합니다. 대량 처리와 낮은 지연 시간이 필요한 워크플로를 위한 Claude Haiku 5.5도 몇 주 안에 합류할 예정입니다.
| 작업 유형 | 추천 시작점 |
|---|---|
| 범위가 분명한 일상적인 코딩: 버그 수정, 기능의 빠른 반복 개발, 요구사항 대비 검증 | Sonnet 5.5 |
| 대량의 일상적인 개발 작업 | Sonnet 5.5 |
| 디자인 감각이 도움이 되는, 완성도 높은 문서·슬라이드·스프레드시트 작업(원페이저, 다이어그램, 요약 슬라이드, 문서 편집, 스프레드시트 정리 등) | Sonnet 5.5 |
| 조사, 리뷰, 초안 작성처럼 명확하게 정의되어 반복 실행하는 에이전트 작업 | Sonnet 5.5 |
| 장시간 이어지는 에이전트 코딩과 지식 업무를 포함해 세심한 판단이 필요한 복잡한 작업 | Opus 5.5 |
| 가장 높은 지능이 필요한 가장 어려운 문제 | Opus 5.5 |
"Epic의 초기 테스트에서 Claude Sonnet 5.5는 상위 등급 모델에 기대하는 품질 기준을 충족했으며, 시스템 설계 감사와 데이터 흐름 검토에서도 안정적인 결과를 보였습니다. 이 모델은 게임플레이 시스템 아키텍처를 위한 수만 줄의 코드를 관리했고, 응답 속도도 빨랐으며, 몇 시간씩 걸리는 작업도 처리했습니다. 프롬프트를 세세하게 지시하지 않아도 결과물을 냈습니다." (Daniel Vogel, Epic Games COO)
Sonnet 5.5는 명확한 스펙이 있고 결과를 확인할 방법이 있는 작업에 가장 잘 맞습니다. 프롬프팅 가이드에도 "장기간에 걸친 가장 어려운 작업에는 Opus 모델이 더 나은 선택"이라고 나와 있습니다.
가격
| 100만 토큰당 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 입력 | $2 | $4 |
| 출력 | $10 | $20 |
| 캐시 쓰기, 5분 | $2.50 | $5 |
| 캐시 쓰기, 1시간 | $4 | $8 |
| 캐시 읽기 | $0.20 | $0.20 |
배치 처리와 프롬프트 캐싱을 포함한 Sonnet 5.5의 모든 가격은 Sonnet 5와 같습니다. 따라서 모델 ID만 바꿔도 토큰당 요금은 달라지지 않습니다. 미국 내 추론만 사용하는 옵션(inference_geo: "us")은 표준 가격의 1.1배입니다.
토큰당 가격은 같지만, 앞서 말씀드렸듯 Sonnet 5.5는 작업당 토큰을 Sonnet 5보다 적게 쓰는 편이라 전체 청구 금액은 달라질 수 있습니다.
서비스 환경(surface)마다 Sonnet의 기본 effort가 다를 수 있습니다. 예를 들어 Claude Platform에서는 high, Claude Code에서는 medium입니다.
Sonnet 5.5는 긴 변 기준 최대 2576픽셀까지 지원하는 고해상도 이미지 티어를 사용하며, 2000×1500 이미지는 Sonnet 4.6, Sonnet 4.5, Haiku 4.5보다 토큰이 약 2.5배 듭니다. 세부 묘사가 필요 없다면 전송 전에 이미지를 줄이세요.
모델 상세 정보
| 항목 | Sonnet 5.5 |
|---|---|
| 모델 ID | Claude API, Claude Platform on AWS, Google Cloud, Microsoft Foundry에서는 claude-sonnet-5-5, Amazon Bedrock에서는 anthropic.claude-sonnet-5-5 |
| 컨텍스트 윈도우 | 100만 토큰, 기본 지원(베타 헤더 불필요) |
| 최대 출력 | 12만 8천 토큰. Message Batches API에서 output-300k-2026-03-24 베타 헤더를 사용하면 최대 30만 토큰 |
| 지식 컷오프 | 2026년 6월 |
| Thinking | 기본 활성화(적응형 thinking). between_tools로 사전 thinking을 끌 수 있음 |
| Effort 단계 | low, medium, high, xhigh, max |
| 기본 effort | Claude API에서는 high, Claude Code에서는 medium |
| 토크나이저 | Sonnet 5와 동일 |
| 캐시 가능한 최소 프롬프트 | 512토큰(Sonnet 5는 1,024토큰) |
| 요청 한도 | Sonnet 5와 별도로 적용되며, 기본 티어 값은 동일 |
| Priority Tier | Claude API에서 사용 가능 |
| 데이터 보관 | 자격을 갖춘 고객은 데이터 무보관(zero data retention)으로 사용 가능 |
Claude API의 기본값은 high이라서 처음부터 좋은 결과를 얻을 수 있습니다. 먼저 이 값으로 시작해 평가해 보고, 워크로드에 맞는 effort 단계를 고르세요. xhigh나 max effort를 쓰고 싶어지더라도, Sonnet 5.5가 더 오래 생각하고 비용도 더 든다는 점을 염두에 두세요. 작업에 따라서는 품질, 속도, 비용의 균형이라는 Sonnet의 장점이 줄어들 수 있습니다. 그럴 때는 Opus 5.5를 고려해 보세요.
SONNET 5에서 마이그레이션하기
Thinking은 기본으로 켜져 있습니다. Sonnet 5를 thinking 없이 실행했다면 between_tools로 사전 thinking을 끌 수 있습니다. 방법은 아래 1단계에서 설명합니다.
모델 ID를 claude-sonnet-5-5으로 바꾼 다음, 호환성이 깨지는 변경 다섯 가지와 응답 형태의 변경 한 가지를 차례로 처리하세요. 각 항목은 Sonnet 5.5 마이그레이션 가이드에 자세히 나와 있습니다.
Claude Code로 마이그레이션을 맡길 수도 있습니다. /claude-api migrate this project to claude-sonnet-5-5을 실행하면 내장된 Claude API 스킬이 호출되어, 코드베이스 전체에서 모델 ID를 교체하고 호환성이 깨지는 파라미터 변경도 함께 적용합니다.
1. between_tools로 사전 thinking 끄기
Sonnet 5.5에서는 thinking 필드가 없는 요청이 적응형 thinking으로 실행되며, thinking: {"type": "disabled"}는 400 오류를 반환합니다. 대신 새로 추가된 between_tools 설정을 보내세요. between_tools를 쓰면 thinking이 도구 호출 사이에서만 일어나며, 전체 응답 시간은 같거나 더 빨라집니다.
# Before: Claude Sonnet 5
client.messages.create(
    model="claude-sonnet-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    output_config={"effort": "xhigh"},
    messages=[{"role": "user", "content": "..."}],
)

# After: Claude Sonnet 5.5
client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    thinking={"type": "between_tools"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "..."}],
)
예제에서는 effort도 xhigh에서 high로 낮췄습니다. between_tools에는 다음과 같은 제약이 있기 때문입니다.
between_tools은low,medium,higheffort에서 동작합니다.xhigh나max에서는 400 오류가 반환되므로, 그 단계에서 실행하려면 적응형 thinking을 사용하세요.- 다른 필드는 받지 않습니다.
display,budget_tokens,block_binding를 함께 보내면 400 오류가 반환됩니다. between_tools를 쓰면 대화 도중에 effort를 바꿀 수 없습니다. 턴마다 effort를 달리하려면 적응형 thinking을 사용하세요.- 모델이 도구 호출 사이에 작성하는 짧은 진행 상황 메모는 여전히 요약 텍스트가 담긴
thinking블록으로 반환됩니다. 콘텐츠 블록은 타입별로 읽고, 이 블록들은 어시스턴트 턴의 나머지 부분과 함께 수정 없이 그대로 다시 전달하세요. 도구를 쓰지 않으면 응답에는 텍스트만 포함됩니다. - Sonnet 5.5를 제공하는 모든 플랫폼에서 베타 헤더 없이 동작합니다. 사용 중인 SDK 버전에
between_tools이 정의되어 있지 않다면 SDK를 업데이트하세요.
between_tools로 사전 thinking을 껐는데 도구를 쓰지 않으면서 몇 단계의 추론이 필요한 요청이 있다면, 그 요청에는 적응형 thinking을 사용하세요.
2. 강제 tool_choice를 auto와 strict 도구로 바꾸기
타입이 any 또는 tool인 tool_choice는 토큰 카운팅 엔드포인트를 포함해 400 오류를 반환합니다. auto를 보내고, 입력이 스키마와 일치하도록 도구에 strict: true를 지정한 뒤, 프롬프트에서 언제 그 도구를 써야 하는지 알려 주세요.
weather_tool = {
    "name": "get_weather",
    "description": "Get the current weather in a given location",
    "input_schema": {
        "type": "object",
        "properties": {"location": {"type": "string"}},
        "required": ["location"],
        "additionalProperties": False,
    },
    "strict": True,
}

client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    tools=[weather_tool],
    tool_choice={"type": "auto"},  # was {"type": "tool", "name": "get_weather"}
    messages=[
        {"role": "user", "content": "What's the weather in Paris? Use the get_weather tool."}
    ],
)
Strict 도구 사용에는 모든 객체에 additionalProperties: false가 필요합니다.
3. 대화는 추가만 하는 방식으로 유지하기
Sonnet 5.5의 thinking 블록은 모델 및 대화와 연결되어 있습니다. Sonnet 5.5는 Sonnet 5의 thinking 블록을 읽을 수 있으므로, 대화 도중 Sonnet 5에서 Sonnet 5.5로 바꿔도 추론 내용이 유지됩니다. 다른 모델은 Sonnet 5.5의 블록을 읽지 못합니다.
4. 컴퓨터 사용을 toolset으로 옮기기
Claude API와 Google Cloud에서 Sonnet 5.5는 {"type": "computer_toolset_20260801"}를 통해서만 컴퓨터 사용을 지원하며, computer_20251124를 선언한 요청은 400 오류를 반환합니다. 요청에서 anthropic-beta: computer-use-2025-11-24 헤더를 빼고, SDK에서는 betas 파라미터를 제거한 뒤 베타 네임스페이스가 아닌 표준 클라이언트로 Messages API를 호출하세요. tools 항목을 교체하고, 에이전트 루프도 멤버 tool_use 블록, 배치 액션, 결과의 toolset_name에 맞게 수정해야 합니다. fine-grained-tool-streaming-2025-05-14 베타 헤더를 보내고 있다면 이것도 제거하세요. toolset 항목과 함께 쓰면 400 오류가 반환되기 때문입니다. 필요한 각 도구에는 대신 eager_input_streaming: true을 설정하세요. Amazon Bedrock은 여전히 computer_20251124를 허용합니다.
5. 어드바이저 조합 확인하기
어드바이저 도구를 쓸 때 Sonnet 5.5 실행기는 Opus 4.8, Opus 4.7, Sonnet 5를 어드바이저로 받아들이지 않습니다. 사용할 수 있는 어드바이저는 Opus 5.5, Opus 5, 그리고 Sonnet 5.5 자신입니다. 허용된 모든 어드바이저의 조언은 advisor_redacted_result 블록으로 암호화되어 반환되므로, 코드에서 조언 텍스트를 읽을 수 없습니다.
6. 도구 호출 사이의 텍스트는 thinking 블록에서 읽기
이 변경은 오류를 일으키지 않지만, UI에서 도구 호출 사이의 모델 메모가 표시되지 않을 수 있습니다. 한두 문장을 넘는 메모는 진행 상황 업데이트용 thinking 블록으로 반환되는데, 기본값인 display에서는 이 블록이 비어 있습니다.
적응형 thinking을 쓴다면 thinking.display를 "updates"(베타, thinking-display-updates-2026-08-18 헤더 사용) 또는 "summarized"로 설정하고, 비어 있지 않은 각 thinking 블록을 바로 뒤따르는 tool_use 블록보다 먼저 렌더링하세요. between_tools를 쓰면 display 없이 텍스트가 반환됩니다.
Sonnet 5.5에는 메시지별 effort(베타), 대화 중간의 시스템 메시지, 대화 중간의 도구 변경(베타)도 추가되었습니다. Sonnet 4.6 이하 또는 Haiku 4.5에서 넘어오는 경우에는 마이그레이션 가이드에서 출발 모델별 체크리스트를 확인하세요.
튜닝
Effort 스윕 다시 실행하기
Effort 단계가 재조정되어, 같은 단계라도 Sonnet 5에서와 thinking 양이 다르므로 기존 설정을 그대로 가져갈 수 없습니다. 에이전트형이거나 지연 시간에 민감한 워크로드가 아니라면 high로 시작하세요. 에이전트 코딩이나 여러 단계의 도구 사용에서는 스펙이 잘 정리된 작업에 medium로 시작하고, 더 어렵거나 긴 작업이면 high로 올리세요. 채팅처럼 지연 시간에 민감한 작업에는 medium 또는 low로 시작하는 것이 좋습니다. xhigh나 max는 평가에서 품질 향상이 확인된 경우에만 쓰세요.
Thinking도 max_tokens에 포함되므로 여유를 남겨 두세요. 에이전트 코딩에서는 max_tokens를 모델의 최대치인 128,000으로 설정하고 응답을 스트리밍하세요. Thinking을 줄이고 싶다면 effort 단계를 낮추세요. 시스템 프롬프트에서 덜 생각하라고 요청하는 것만으로는 확실히 줄어들지 않습니다.
Sonnet 5용 우회책 제거하기
기존 Sonnet 5용 프롬프트는 수정 없이도 잘 동작할 것입니다. 프롬프트에 거절 유도, 도구 호출 재시도용 shim, "게으르게 굴지 마" 같은 우회책이 들어 있다면 먼저 제거하고 평가를 다시 돌려 본 뒤에 다른 튜닝을 진행하세요.
낮은 effort에서는 실제 검증을 요청하기
Sonnet 5.5는 대체로 변경을 완료했다고 보고하기 전에 작업 결과를 확인하지만, low effort에서는 변경 사항을 실제로 실행해 보는 확인 단계를 건너뛰기도 합니다. 테스트나 빌드 출력 없이 변경이 완료되었다고 보고된다면, 프롬프팅 가이드가 권장하는 다음 시스템 프롬프트 문단을 사용하세요.
When you change code that can be run, built, or type-checked, run a real
check that exercises the change before reporting it done: the project's
tests, type-checker, or build, or the changed command itself. A syntax-only
check, or a check command that failed to start, does not count; if all
that is missing is the project's declared dependencies, install them with
its own package manager and lockfile (e.g. npm install, pip
install -r requirements.txt), never via sudo or the system package manager,
unless told not to. Only if no real check can run here, say which one you
did not run and why instead of reporting the change as done.
진행 상황은 thinking.display로 확인하기
모델에게 응답에 추론 과정을 써 달라고 요청하지 마세요. reasoning_extraction 거절이 발생할 수 있습니다. 대신 요약된 thinking을 읽으세요.
thinking={"type": "adaptive", "display": "summarized"}
사용자에게 보여 줄 진행 메모만 따로 받으려면 display: "updates"(베타)를 사용하세요. 첫 도구 호출 전 한 줄, 마지막에 짧은 요약처럼 예측 가능한 시점에 업데이트를 받고 싶다면 시스템 프롬프트에 그렇게 명시하세요.
프롬프트를 더 많이 캐시하기
캐시 가능한 최소 프롬프트가 512토큰으로 낮아져, 짧은 시스템 프롬프트와 도구 정의도 이제 캐시할 수 있습니다. 캐시 읽기 비용은 입력 가격의 10분의 1입니다. 요청 사이에 최상위 effort를 바꾸면 캐시가 무효화됩니다. 한 턴만 다른 단계로 실행하려면 캐시가 유지되는 메시지별 effort(베타)를 사용하세요.
거절과 폴백
자동화된 행동 감사에서 Sonnet 5.5는 정렬(alignment)과 정직성 대부분의 지표에서 Sonnet 5보다 좋아졌거나 같은 수준을 보였습니다. 또한 가장 강력한 모델과 비슷한 수준의 사이버보안 안전장치를 갖춘 첫 Sonnet 모델입니다. 일반적인 소프트웨어 개발 작업은 대부분 영향을 받지 않습니다.
거절된 요청은 HTTP 200과 함께 stop_reason: "refusal"를 반환하며, stop_details에는 cyber, bio, frontier_llm, reasoning_extraction, general_harms 다섯 가지 범주 중 하나가 표시됩니다. 서버 측 폴백(fallbacks: "default", 베타, Claude API)은 cyber와 frontier_llm 거절을 Sonnet 5로 재시도하며, 나머지 세 가지는 재시도하지 않습니다. SDK 미들웨어나 직접 구현한 재시도 로직을 사용할 수도 있습니다.
정당한 보안 업무를 위한 Cyber Verification Program도 곧 Sonnet 5.5까지 확대될 예정입니다.
이용 가능 여부
Claude Sonnet 5.5는 오늘부터 아래 플랫폼에서 사용할 수 있습니다. 개발자 플랫폼에서는 다음 모델 ID를 사용하세요.
- Claude API:
claude-sonnet-5-5 - Amazon Bedrock:
anthropic.claude-sonnet-5-5 - Claude Platform on AWS:
claude-sonnet-5-5 - Google Cloud:
claude-sonnet-5-5 - Microsoft Foundry:
claude-sonnet-5-5(Global Standard 배포에서만 사용 가능)
Claude Code에서
Claude Code v2.1.284(Agent SDK for TypeScript는 v0.3.284 이상)부터 sonnet 별칭이 Claude API에서 Sonnet 5.5를 가리킵니다. 기본 effort는 medium이며 100만 토큰 컨텍스트 윈도우를 기본으로 지원합니다. Claude Code에서는 Sonnet 5.5의 thinking을 끌 수 없고, effort로 모델이 생각하는 양을 조절합니다. Sonnet 5.5에는 fast 모드가 없습니다. default 모델은 계속 Opus 5.5이므로, 범위가 분명한 작업에는 /model sonnet로 전환해 사용하세요.
Sonnet 5.5를 마음껏 써 보시고, 언제든 피드백을 남겨 주세요.