Hamel Husain블로그
적대적 검증(Adversarial Validation)으로 AI 디버깅하기
자동화 기법을 활용해 AI 제품에서 흔히 발생하는 버그를 빠르게 찾아내는 방법을 소개합니다.
저는 수년간 모델 입력이나 학습 데이터의 갑작스러운 변화, 즉 '드리프트(drift)'를 탐지하는 간단한 방법에 의존해 왔습니다. 바로 적대적 검증(Adversarial Validation)1입니다. 이 방법은 단순하면서도 효과적입니다. 가장 큰 장점은? 복잡한 도구나 인프라가 전혀 필요 없다는 것입니다.
드리프트가 AI 버그를 유발할 수 있는 사례:
- 평가에 사용하는 데이터가 프로덕션에서 모델이 실제로 받는 입력과 크게 다를 경우, 평가 결과가 왜곡될 수 있습니다.
- 프롬프트, 함수, RAG 등의 업데이트가 파인튜닝이나 학습 데이터에 반영되지 않으면, 프로덕션에서 예상치 못한 모델 동작이 발생할 수 있습니다.
아무리 주의를 기울여도 버그는 언제든지 발생할 수 있습니다. 모든 AI/ML 프로젝트를 정기적으로 드리프트 점검하는 것은 투자 대비 효과가 매우 높은 활동입니다.
작동 원리
주의멋없는 경고
이 방법은 너무 단순해서 멋없어 보일 수 있습니다. 데이터 과학자들에게 깊은 인상을 남기기는 어렵습니다. 그럼에도 불구하고, 그 가치가 너무 크기 때문에 그냥 지나칠 수 없습니다.
MLOps 도구에 관한 제 발표의 이 슬라이드에서 적대적 검증의 기법을 설명하고 있습니다2:
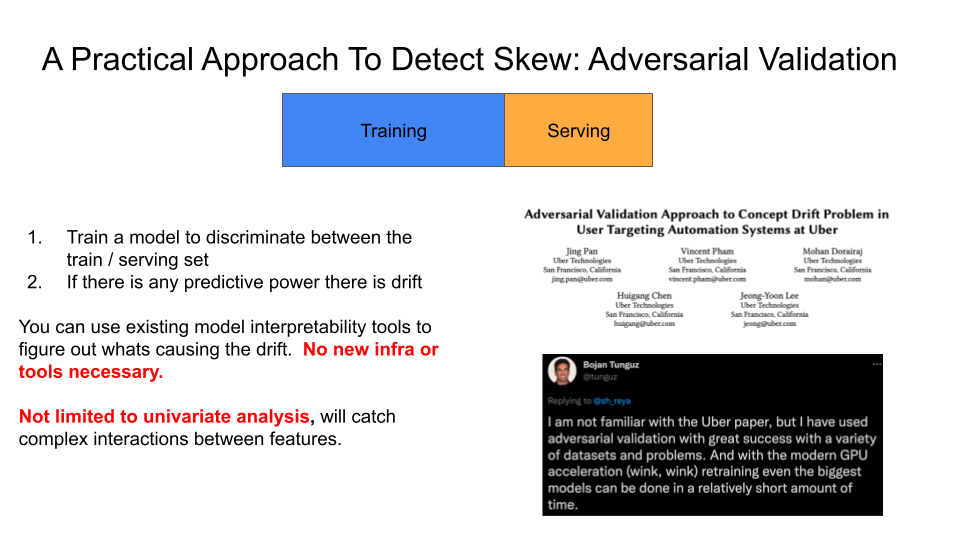
과정은 다음과 같습니다:
- 비교할 두 데이터셋을 수집합니다. 예를 들어:
- 두 번의 서로 다른 파인튜닝에서 나온 학습 데이터
- 학습 데이터 vs. 평가 데이터
- 학습 데이터 vs. 프로덕션 데이터 (동일한 형식으로 정리)
- 서로 다른 두 기간의 데이터
- 데이터셋에서 피처를 생성합니다. 토큰으로 피처를 만드는 기본 예시는 여기에서 확인할 수 있습니다.3
- 데이터셋 #1에는 레이블 0을, 데이터셋 #2에는 레이블 1을 부여합니다.
- 두 데이터셋을 구분하기 위해 이진 분류기(랜덤 포레스트, 로지스틱 회귀 등)를 학습시킵니다.
- 분류기가 충분한 예측력을 보인다면(예: AUC ≥ 0.60), 드리프트가 존재한다는 것을 알 수 있습니다.
- 로지스틱 회귀, 랜덤 포레스트 등 해석 가능한 모델을 사용했다면, 피처 중요도 지표를 통해 드리프트의 근본 원인을 파악할 수 있습니다. 신경망과 같이 복잡한 모델을 사용한 경우에는 SHAP 값이나 다른 방법으로 드리프트 원인을 분석할 수 있습니다. 처음에는 단순한 해석 가능한 모델로 시작하는 것을 권장합니다.
주의
이 과정에서 드리프트가 감지되지 않더라도, 드리프트가 없다는 의미는 아닙니다. 단지 사용한 모델과 피처로는 탐지할 수 없었다는 뜻입니다.
간단한 예시: ft_drift
저는 OpenAI API를 사용해 모델을 파인튜닝하는 분들과 함께 일하는 경우가 많습니다. 그래서 멀티턴 채팅 형식의 jsonl 파일 두 개 사이의 드리프트를 탐지하는 소형 CLI 도구 ft_drift를 만들었습니다. 현재 ft_drift은 프롬프트 템플릿, 스키마 등 토큰 기반 드리프트만 탐지하며, 시맨틱 드리프트는 탐지하지 않습니다. 하지만 적대적 검증의 기본 개념을 이해하는 출발점으로는 충분합니다. 도구의 실제 작동 데모는 다음과 같습니다:
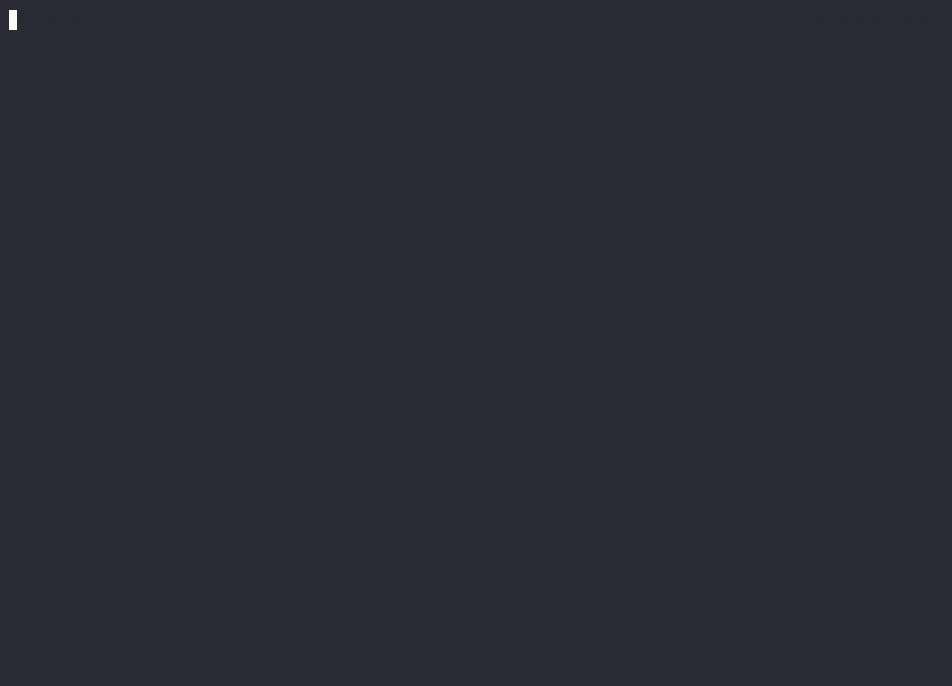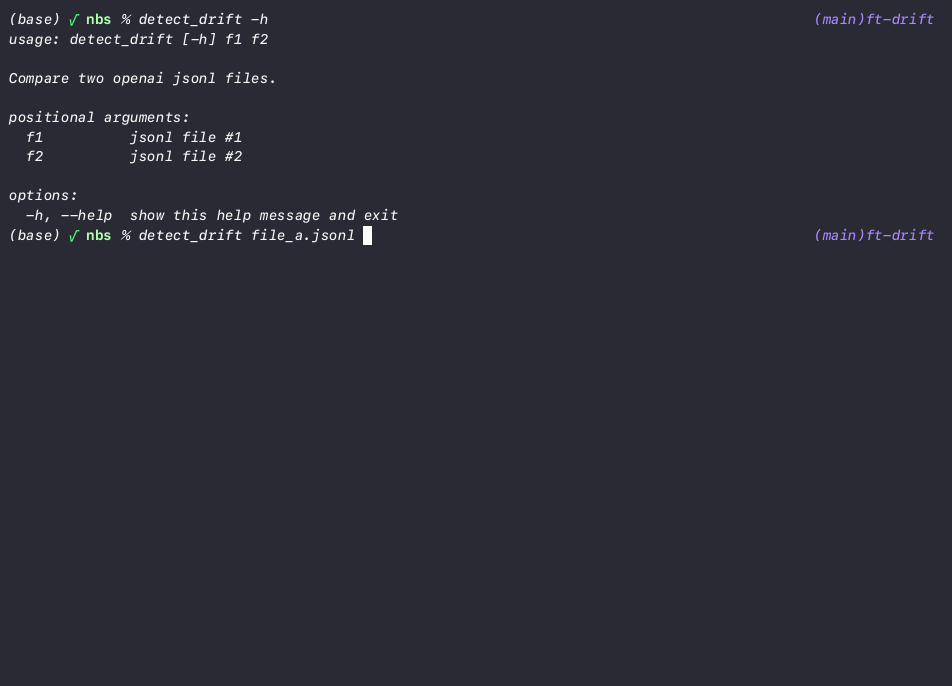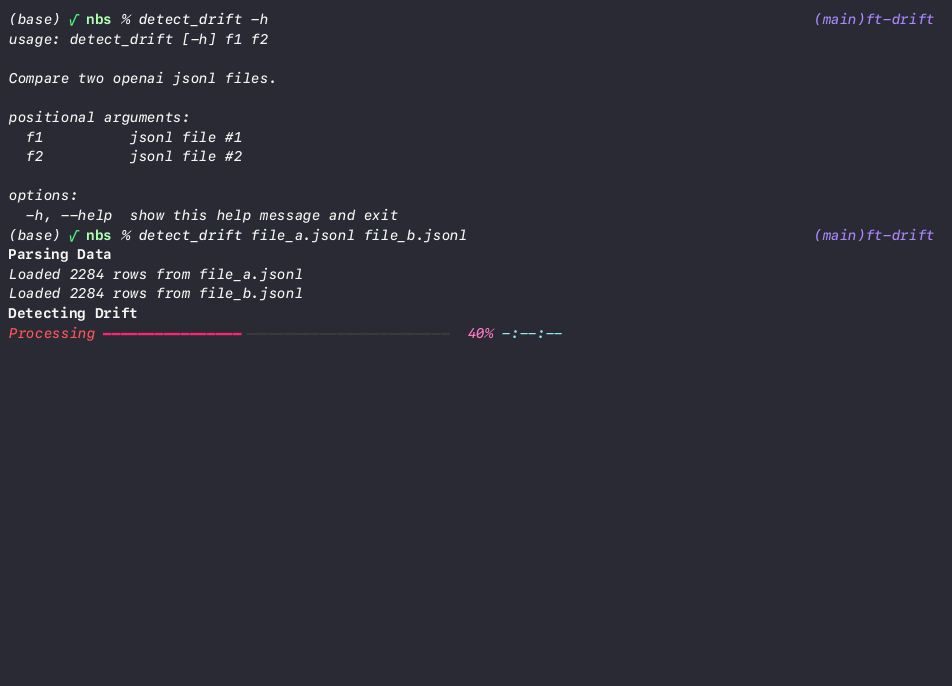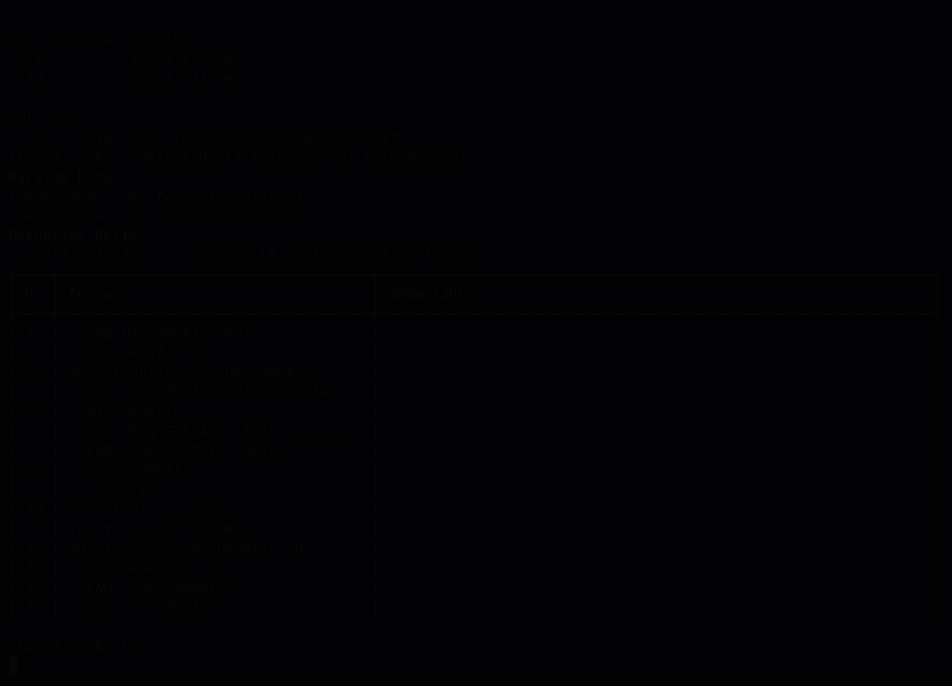
이 데모는 프롬프트 템플릿의 의도치 않은 변경으로 인해 모델에서 예상치 못한 동작이 발생한 실제 사례를 보여줍니다. 데모에서는 도구가 두 데이터셋 file_a.jsonl와 file_b.jsonl 사이의 차이를 감지합니다. 이후 드리프트를 유발한 주요 토큰들이 END-UI-FORMAT, UI-FORMAT 등과 같이 표로 표시됩니다. 이 도구를 활용해 문제의 근본 원인을 빠르게 찾을 수 있었습니다. 모델링 코드는 놀랄 만큼 단순하며 ft_drift/model.py에서 확인할 수 있습니다. 핵심은 시작하는 데 정교한 기법이 필요하지 않다는 것입니다. 이후에는 임베딩을 피처에 추가해 시맨틱 드리프트까지 탐지하도록 확장할 수 있습니다. 마찬가지로 대화 턴 수, 메시지 길이 등의 피처를 직접 추가하는 것도 가능합니다.


