Simon Willison블로그ai
새로운 GPT-5.6 패밀리 공개: Luna, Terra, Sol
OpenAI의 최신 플래그십 모델이 오늘 아침 정식 출시됐다. 소형부터 대형 순으로 Luna, Terra, Sol 세 가지 크기로 제공된다.
새 모델의 가격은 입력/출력 토큰 100만 개당 Luna $1/$6, Terra $2.50/$15, Sol $5/$30이다. 비교하자면 Claude Opus 시리즈는 $5/$25, Claude Fable 5는 $10/$50다. 다만 같은 작업이라도 모델마다 추론 토큰 수가 크게 달라질 수 있는 지금, 토큰당 단가만으로는 실질적인 비용을 가늠하기 어렵다.
OpenAI가 가장 크게 내세우는 벤치마크 성과는 장기 에이전트 성능이다. 세 모델 모두 Claude Fable 5를 앞선다는 벤치마크 결과가 공개됐다:
GPT-5.6은 토큰 하나하나에서 더 많은 유용한 작업을 끌어낼 수 있도록 훈련됐다. 55개 분야의 장기 전문가 워크플로우를 평가하는 Agents' Last Exam에서 GPT-5.6 Sol은 53.6점으로 신기록을 세우며 Claude Fable 5(적응형 추론)를 13.1점 차로 뛰어넘었다. 중간 수준의 추론 설정에서도 약 4분의 1 수준의 비용으로 Fable 5보다 11.4점 높은 성과를 냈다. 이러한 효율성은 더 작은 모델에도 이어진다. AI를 더 폭넓고 저렴하게 보급하는 데 핵심적인 역할을 하는 GPT-5.6 Terra와 GPT-5.6 Luna는 약 16분의 1 수준의 비용으로 Fable 5를 능가한다.
흥미로운 점은, Fable 5가 GPT-5.6 패밀리를 압도한 자체 보고 벤치마크 중 하나가 SWE-Bench Pro라는 것이다. 해당 벤치마크에서 Fable 5는 80%를 기록한 반면, GPT-5.6 Sol은 64.6%에 그쳤다. OpenAI가 어제 이 글을 통해 SWE-Bench Pro 감사 과정에서 발견한 문제점들을 공개적으로 지적한 이유가 여기에 있을 것이다:
이러한 결과에 비춰볼 때, SWE-bench Pro 과제의 약 30%에 오류가 있는 것으로 추정되며, 모델 개발사들은 결과를 면밀히 검토할 것을 권고한다
필자도 GPT-5.6 Sol을 사전에 사용해볼 기회가 있었다. 분명히 매우 유능한 모델이지만, Anthropic 모델로 처리해온 복잡한 코딩 작업에서는 아직까지 Fable을 능가한다는 인상을 받지 못했다.
여느 때와 마찬가지로, GPT-5.6 사용 모델 가이드에 가장 흥미로운 세부 내용이 담겨 있다. 탐색해볼 만한 새로운 API 기능도 다수 추가됐는데(아마 LLM에서도 지원을 추가해야 할 것 같다), 주요 내용은 다음과 같다:
- Programmatic Tool Calling은 모델이 '도구 호출을 오케스트레이션하는 JavaScript를 직접 작성하고 실행'할 수 있게 해주는 기능이다. MCP와 CLI 유틸리티를 유연하게 조합할 수 있는 풀 터미널 세션 사이의 간극을 메우는 데 도움이 될 것으로 보인다. Anthropic이 웹 검색 도구에 도입한 동적 필터링 메커니즘과도 유사한 방식으로, 단일 모델 턴 내에서 웹 검색 결과에 대한 코드 실행을 가능하게 한다.
- 멀티 에이전트는 모델이 '병렬적이고 집중적인 작업을 위해 서브 에이전트를 실행'할 수 있게 해주는 기능으로, 서브 에이전트 패턴이 이제 핵심 API에 직접 내장됐다.
- Prompt cache breakpoints는 Claude의 프롬프트 캐싱 방식을 OpenAI에 도입한 기능이다. API가 캐시 분기점을 자동으로 감지하는 대신, 사용자가 직접 분기점을 지정할 수 있다. 개인적으로는 자동 감지 방식이 더 편하긴 하지만(OpenAI도 여전히 지원한다), 직접 설정에 공을 들인다면 비용 최적화 효과를 기대할 수 있을 것이다.
- 이미지 요청 시 detail: original을 설정하면, 처리 전 이미지 리사이징 없이 원본 그대로 전달할 수 있다.
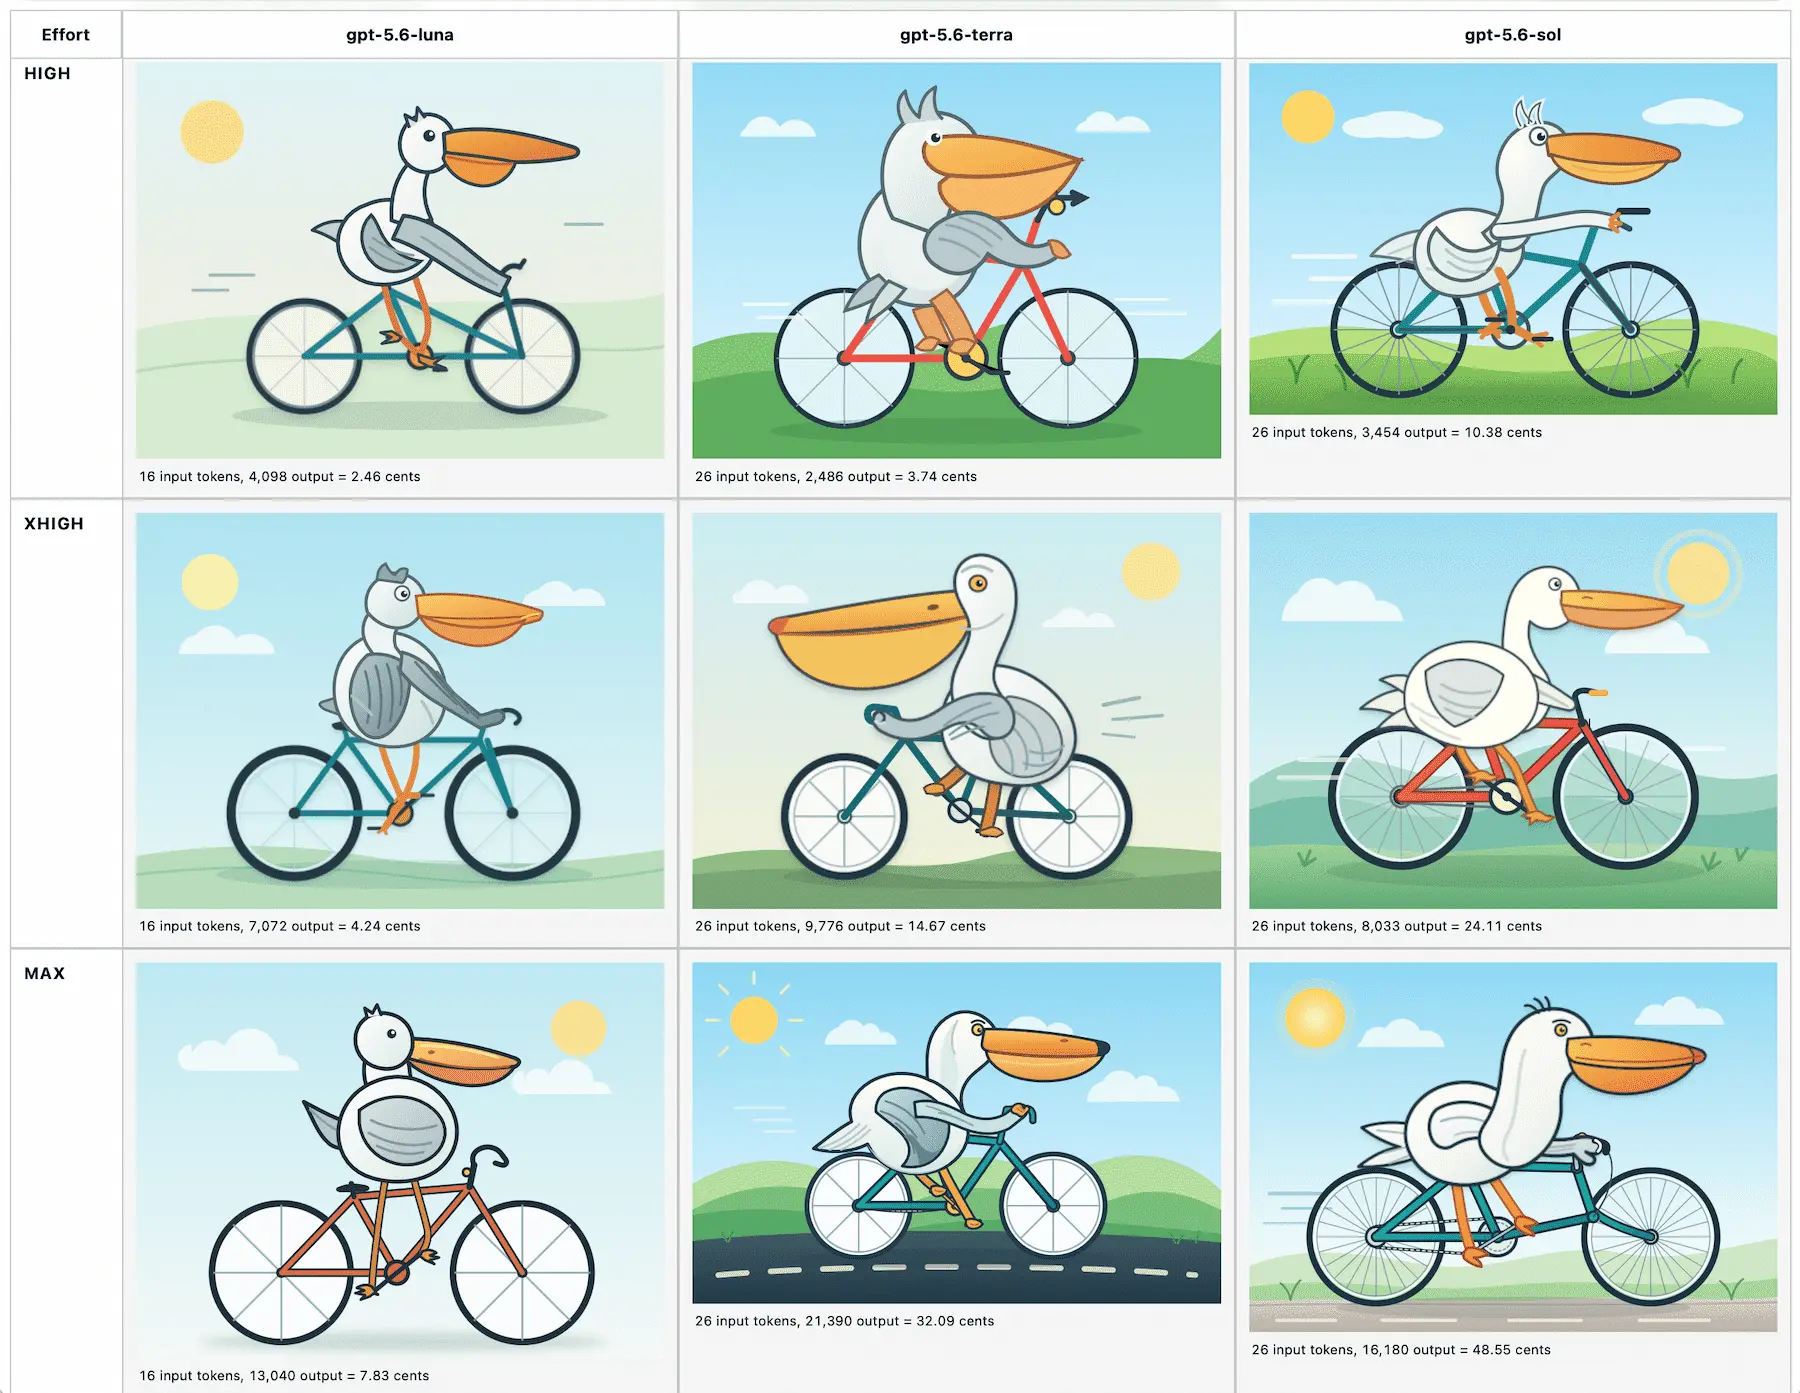
18가지 서로 다른 펠리컨을 담은 전체 페이지를 공유한다. 세 가지 모델 각각에 대해 none, low, medium, high, xhigh, max 총 여섯 가지 추론 수준을 적용한 결과를 담았다. 토큰 수와 계산된 비용도 함께 표시되어 있는데, 가장 저렴한 경우는 추론 수준 none의 gpt-5.6-luna로 0.71센트, 가장 비싼 경우는 최대 추론 수준의 gpt-5.6-sol로 48.55센트였다.
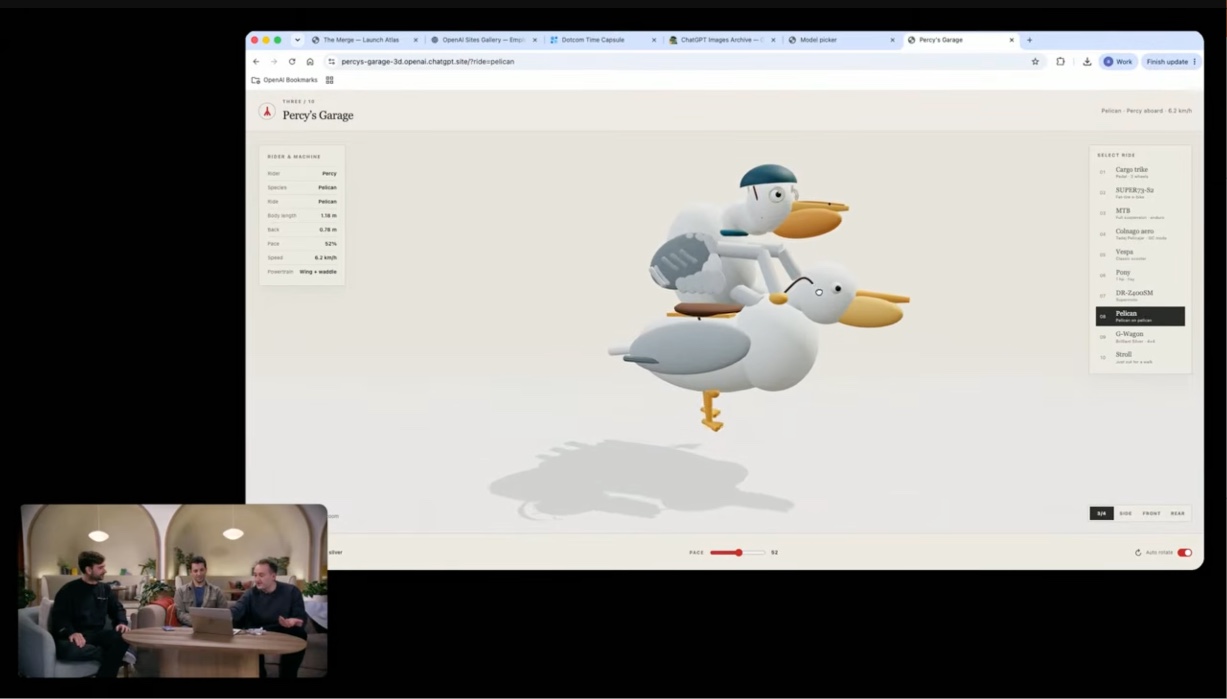
펠리컨 관련 소식을 하나 더 전하자면, 오늘 아침 진행된 라이브스트림의 17분 50초 지점에서 OpenAI가 직접 세발자전거, 자전거, 조랑말, 그리고 다른 펠리컨을 타고 있는 3D 펠리컨 데모를 선보인다!
현재 이 피드에는 블로그의 장문 아티클만 표시됩니다. /atom/everything/을 구독하면 모든 포스트를 받아볼 수 있으며, 다른 구독 옵션도 확인해보세요.


