Vercel기술 블로그engineering
Vercel AI Gateway에서 만나는 ElevenLabs
이제 Vercel AI Gateway에서 ElevenLabs를 사용할 수 있습니다. API 키 하나로 음성 합성, 음성 인식, 실시간 음성 에이전트, 음악, 효과음까지 모두 만들 수 있으며, 2주 동안 50% 할인도 제공됩니다.
Vercel과 ElevenLabs가 손잡고 ElevenLabs 모델 14종을 AI Gateway에 선보입니다. 출시를 기념해 11월 9일까지 14일 동안 AI Gateway에서 모든 ElevenLabs 모델을 50% 할인된 가격에 사용할 수 있습니다.
AI Gateway는 ElevenLabs 오디오 모델을 여섯 가지 유형으로 지원합니다.
음성 인식(Speech to text): 녹음 파일을 텍스트로 옮기거나, 사람이 말하는 동안 실시간으로 자막을 만들 수 있습니다.
스트리밍 음성 합성(Streaming text to speech): 언어 모델이 답변을 작성하는 도중에 바로 음성 재생을 시작하므로, 사용자가 답변이 완성될 때까지 기다리지 않아도 됩니다.
실시간 음성 에이전트(Realtime voice agents): 사용자가 앱에 말을 걸고, 앱이 소리 내어 답하는 대화를 하나의 라이브 세션에서 처리합니다. 고객 지원 전화, 튜터, 앱 내 어시스턴트에 유용합니다.
음악(Music): 원하는 곡을 일반 텍스트로 설명하면, 원하는 길이의 완성된 노래나 연주곡을 만들어 줍니다.
효과음(Sound effects): 짧은 설명만으로 게임이나 인터페이스에 쓸 소리, 자연스럽게 반복되는 배경음을 생성합니다.
다중 화자 대화(Multi-voice dialogue): 화자마다 다른 목소리를 지정해, 대화 전체를 한 번의 호출로 음성으로 만들 수 있습니다.
이 모든 오디오 모델은 게이트웨이 API 키 하나로 사용할 수 있습니다. 앱이나 에이전트가 사용자의 말을 텍스트로 옮기고, 수백 가지 모델 중 원하는 모델로 내용을 추론한 다음, ElevenLabs 음성으로 답할 수 있습니다. 생성한 음악과 효과음으로 사운드트랙을 만드는 것도 가능합니다.
모든 요청은 다른 AI Gateway 트래픽과 같은 사용량·비용·트레이스 화면에서 확인할 수 있습니다.
모델 유형
AI Gateway에서는 음성 인식, 실시간 음성, 음악 등을 아우르는 ElevenLabs 모델 14종을 사용할 수 있습니다.
모델 유형 | 모델 ID |
|---|---|
음성 인식 |
|
스트리밍 음성 합성 |
|
실시간 음성 에이전트 |
|
음악 |
|
효과음 |
|
다중 화자 대화 |
|
음성 합성과 음성 인식
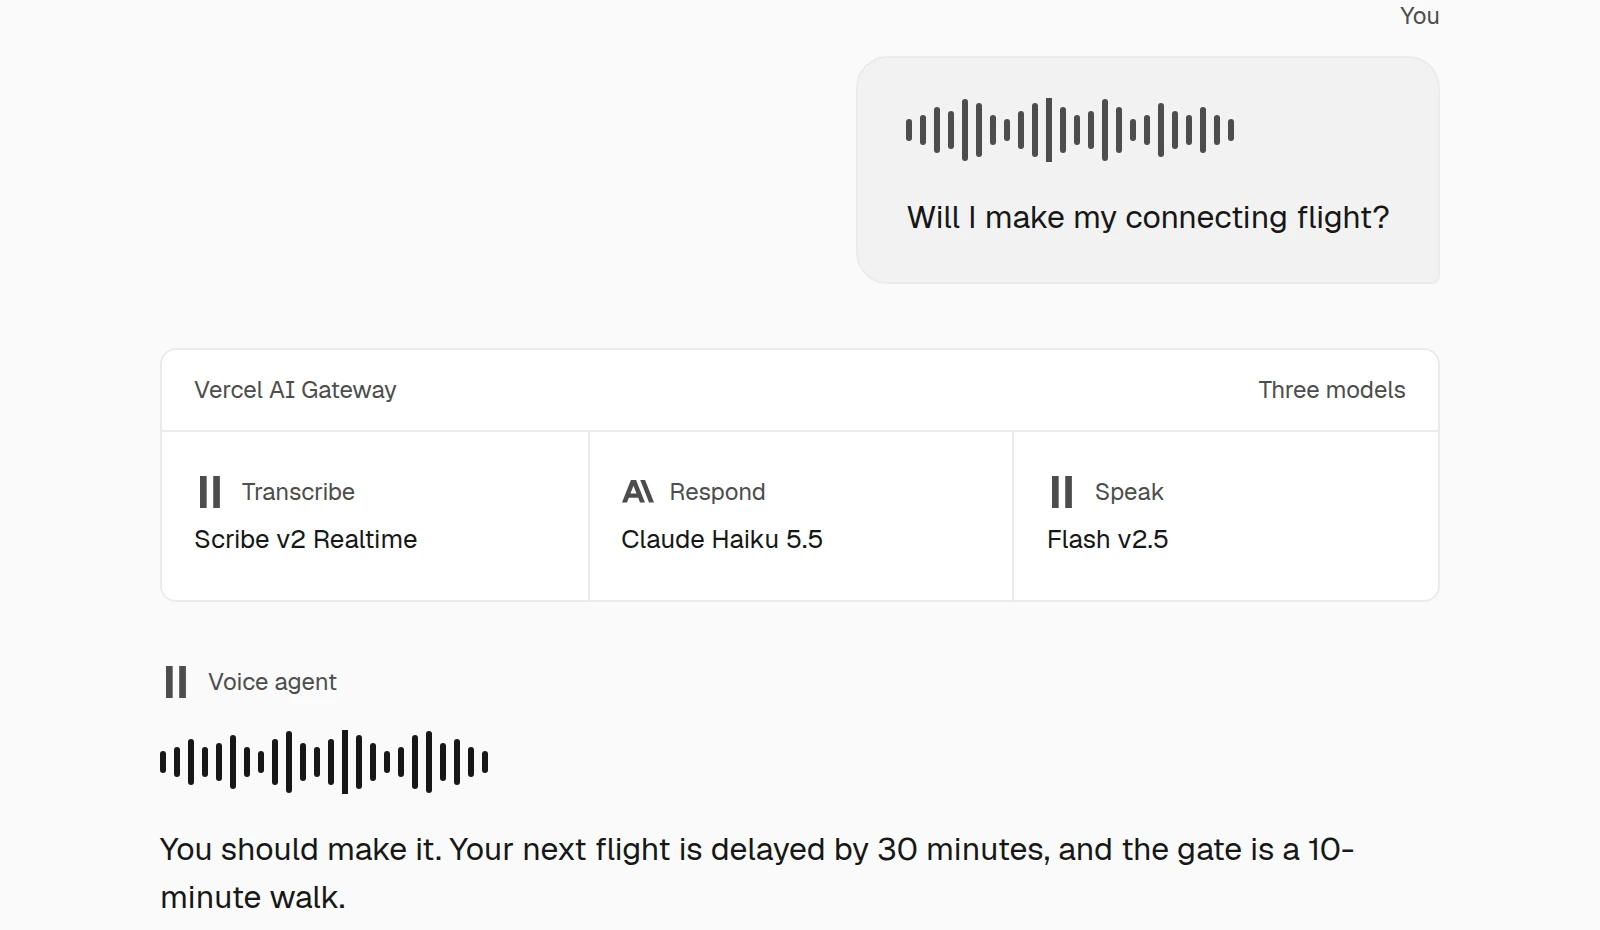
Scribe v2 Realtime은 사용자가 말하는 동안 음성을 곧바로 텍스트로 바꿉니다. 이어서 원하는 언어 모델이 답변을 작성합니다. 지연 시간이 짧은 ElevenLabs 음성 모델 Eleven Flash v2.5는 스트리밍으로 들어오는 답변을 그때그때 소리 내어 읽어 줍니다. 덕분에 모델이 답변을 다 쓰기도 전에 사용자는 응답을 들을 수 있습니다.
각 단계가 별개의 모델이라서, 나머지 파이프라인은 그대로 둔 채 음성 인식, 언어, 음성 합성 모델 중 하나만 바꿀 수도 있습니다.
아래 예시에서는 사용자가 연결편 항공기를 탈 수 있을지 묻습니다. 텍스트 모델이 항공편 운항 상태와 게이트까지의 거리를 종합해 답을 만들고, 음성 모델이 그 답변을 들려줍니다.
import {
  experimental_streamSpeech as streamSpeech,
  experimental_streamTranscribe as streamTranscribe,
  streamText,
} from 'ai';

const heard = streamTranscribe({
  model: 'elevenlabs/scribe-v2-realtime',
  audio: microphoneStream,
  inputAudioFormat: { type: 'audio/pcm', rate: 16000 },
});

const { textStream } = streamText({
  model: 'anthropic/claude-haiku-5.5',
  prompt: await heard.text,
});

const { audioStream } = streamSpeech({
  model: 'elevenlabs/eleven-flash-v2.5',
  text: textStream,
  voice: 'hpp4J3VqNfWAUOO0d1Us',
});
이 코드는 16kHz 마이크 스트림을 텍스트로 옮기고, 완성된 텍스트를 언어 모델에 전달한 뒤, 모델이 내놓는 텍스트를 곧바로 음성 합성으로 넘깁니다.
실시간 음성 에이전트
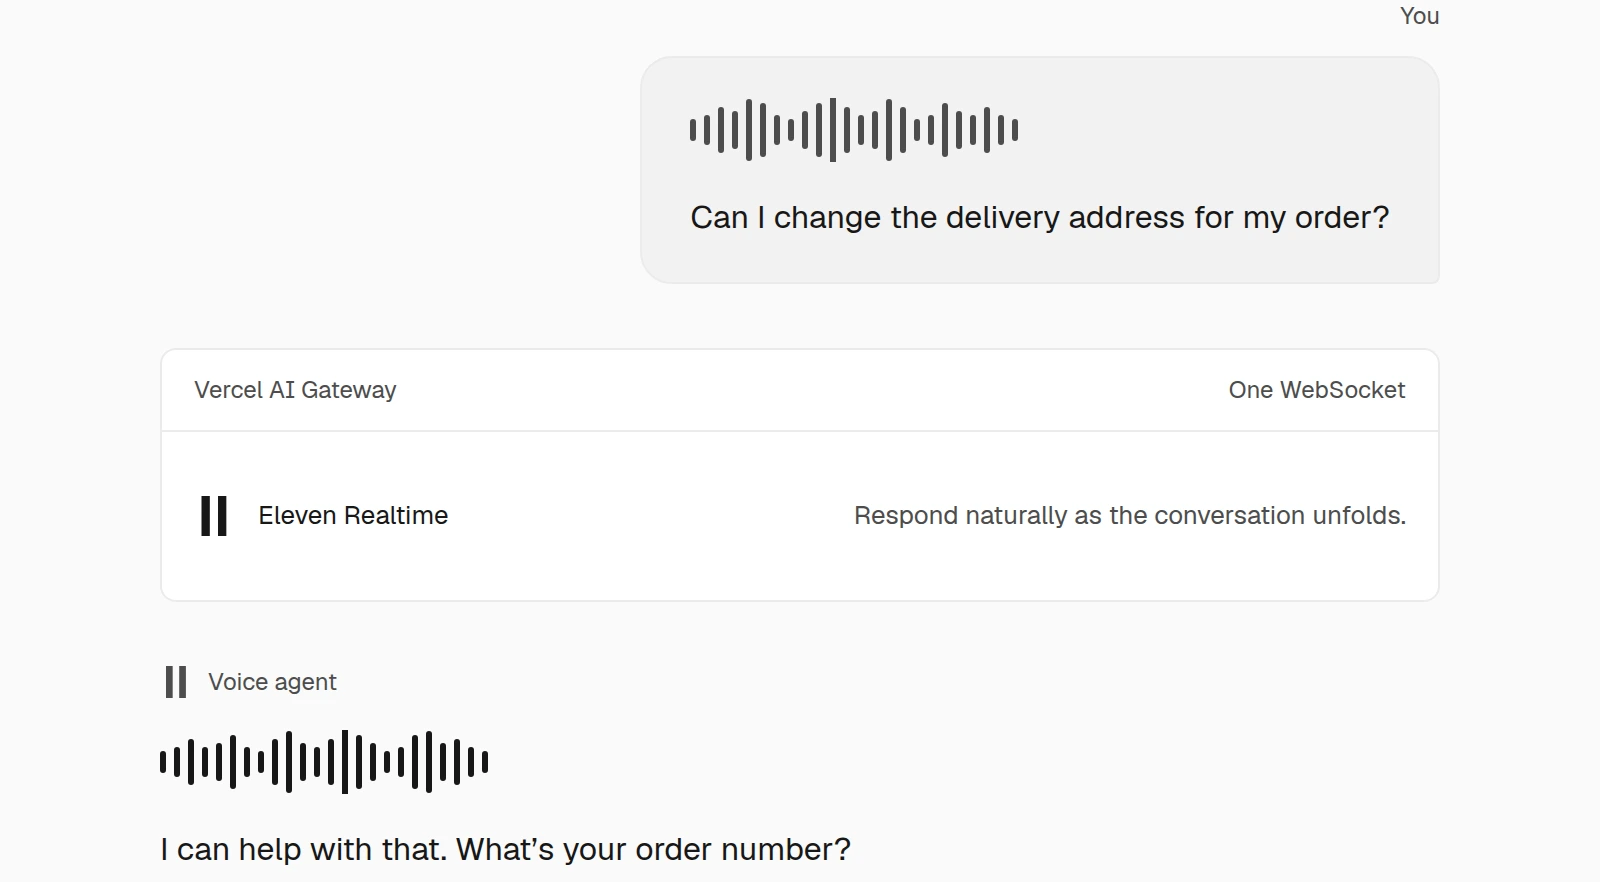
Eleven Realtime v1 Max와 Eleven Realtime v1 Mini는 음성 대화 전체를 모델 하나로 처리합니다. 고객 지원 통화나 앱 내 어시스턴트처럼 자연스러운 주고받기가 중요한 대화에 알맞습니다. 두 모델 모두 하나의 WebSocket 세션으로 사용자의 음성을 받아 음성으로 답하므로, 음성 인식과 음성 합성 단계를 따로 연결할 필요가 없습니다.
Eleven Realtime은 "주문한 상품의 배송지를 바꿀 수 있나요?"라는 말을 듣고, 하나의 WebSocket 세션 안에서 "도와드리겠습니다. 주문 번호가 어떻게 되시나요?"라고 답합니다.
import { gateway } from 'ai';

const { token, url } = await gateway.experimental_realtime.getToken({
  model: 'elevenlabs/eleven-realtime-v1-max',
});
WebSocket 세션은 브라우저가 직접 열기 때문에, 서버는 선택한 모델용 단기 토큰만 발급하면 됩니다. 덕분에 API 키가 클라이언트에 노출되지 않습니다.
브라우저에서는 @ai-sdk/react의 useRealtime 훅으로 연결합니다. 이 훅이 WebSocket 연결, 마이크 입력 캡처, 오디오 재생을 모두 처리합니다. 훅의 sessionConfig에는 ElevenLabs 음성 ID와 turnDetection: { type: 'semantic-vad' }을 지정하세요. 이 모델들은 사용자가 말을 끝냈는지 판단하는 시맨틱 음성 활동 감지(VAD)를 지원하지만, server-vad은 지원하지 않습니다. 브라우저 설정 전체 과정은 실시간 가이드에서 확인할 수 있습니다.
음악과 효과음
Music v2.5와 Music v2는 텍스트 설명만으로 오리지널 음악을 작곡합니다. 장르, 분위기, 원하는 악기를 적으면 요청한 길이의 완성된 곡을 보컬 유무에 맞춰 만들어 줍니다. 더 세밀하게 제어하고 싶다면 곡을 구간별로 나누고, 구간마다 스타일과 길이를 따로 지정할 수도 있습니다.
Sound Effects v2는 발걸음, 문 닫히는 소리, 게임 레벨 내내 반복되는 빗소리처럼 짧은 소리를 같은 방식으로 만듭니다.
세 모델 모두 generateSpeech를 사용하며, text에는 읽어 줄 문장 대신 원하는 소리에 대한 설명을 넣습니다. 다음은 30초 길이의 곡을 요청하는 예시입니다.
import { generateSpeech } from 'ai';

const { audio } = await generateSpeech({
  model: 'elevenlabs/music-v2.5',
  text: 'A mellow lo-fi beat with soft piano',
  providerOptions: { elevenlabs: { musicLengthMs: 30000 } },
});
다중 화자 대화
Eleven v4, Eleven v4 Turbo, Eleven v3는 여러 화자가 등장하는 대본을 한 번의 요청으로 연기합니다. 대사마다 목소리를 지정하면, 목소리가 바뀔 때마다 새로운 턴이 시작됩니다. 두 명이 진행하는 팟캐스트나 여러 배역이 나오는 장면도 하나의 연속된 녹음으로 받을 수 있어, 따로 만든 클립을 이어 붙일 필요가 없습니다.
import { experimental_streamSpeech as streamSpeech } from 'ai';

const host = 'hpp4J3VqNfWAUOO0d1Us';
const guest = 'CwhRBWXzGAHq8TQ4Fs17';

const { audioStream } = streamSpeech({
  model: 'elevenlabs/eleven-v4',
  text: [
    { type: 'text', text: 'Did the deploy go out?', voice: host },
    { type: 'text', text: 'It shipped an hour ago.', voice: guest },
  ],
  providerOptions: { elevenlabs: { dialogue: { voices: [host, guest] } } },
});
각 목소리는 ElevenLabs 음성 ID로 지정합니다. 언어 모델이 대본을 쓰는 대로 각 파트를 스트리밍으로 받아 오는 것도 가능합니다.
AI Gateway 소개
AI Gateway는 모델 호출, 사용량·비용 추적, 재시도·장애 조치(failover)·성능 최적화 설정을 하나의 통합 API로 제공하며, 이를 통해 제공업체 자체보다 높은 가동률을 구현합니다. 맞춤형 리포트, Zero Data Retention 지원, API 키별 예산 설정, 라우팅 규칙 등의 기능도 기본으로 갖추고 있습니다.
AI Gateway는 제공업체의 가격을 그대로 반영하며 추론에 별도의 플랫폼 수수료를 받지 않습니다. 자체 키 사용(Bring Your Own Key)(BYOK) 요청도 마찬가지입니다.
AI Gateway 오디오 문서에서 ElevenLabs 모델별 예제를 볼 수 있습니다. AI Gateway의 전체 오디오 모델을 살펴보고, 11월 9일까지 50% 할인된 가격으로 ElevenLabs를 사용해 보세요.

