Anthropic연구Main
LLM 덕분에 대규모 소프트웨어 형식 검증이 현실로 다가오고 있다
Claude가 오픈소스 라이브러리 123개의 컴파일된 코드를 대상으로 보안 속성을 형식적으로 증명했습니다. 이 과정에서 수년간 발견되지 않았던 버그도 찾아냈습니다.
Keane Lucas, Aengus Lynch, Luna Tong, Luke Champine, Zygi Straznickas, Dino Distefano, Harshikaa Agrawal
Evyatar Ben Asher, Ava Howell, Sami Jawhar, Chris Rohlf, Nickolai Zeldovich
Nicholas Carlini, Rajashree Agrawal, Jason Gross
대부분의 소프트웨어에는 버그가 가득하고, 이제 AI는 그 버그를 손쉽게 찾아내고 악용할 수 있습니다. 사이버 공격에 맞서는 기존 방어 수단만으로는 더 이상 충분하지 않으며, 코드에 버그가 없음을 증명할 방법이 필요합니다. 형식 검증(formal verification)이 이를 보장할 수 있지만, 지금까지는 전문가가 수년간 매달려야 해서 대부분의 실제 프로젝트에는 현실성이 없었습니다. 그러나 Theorem과 함께 진행한 이번 협업에서 우리는 상황이 달라졌음을 보여줍니다. 이제 LLM이 대규모로 형식 증명을 생성할 수 있고, 이를 통해 보안 보장을 증명까지 갖춘 새로운 소프트웨어 개발 워크플로가 가능해졌습니다. 우리는 Claude를 사용해 실제 오픈소스 소프트웨어 라이브러리 100여 개에서 어셈블리 코드 수준(RISC-V)의 보안 속성을 증명했습니다. 우리가 아는 한, AI로 형식 검증을 어셈블리 코드 수준의 프로덕션 소프트웨어에 적용한 최초의 대규모 시도입니다. 증명을 작성하는 동안 Claude는 수조 번의 테스트 실행에도 수년간 발견되지 않았던 버그도 찾아냈습니다. 모델 성능이 계속 좋아지면서, 형식 검증은 안전한 소프트웨어 개발에 필수적인 요소가 될 것으로 전망합니다.
들어가며
성숙하고 테스트도 충분히 거친 소프트웨어에조차 버그는 있고, LLM은 이를 점점 더 능숙하게 찾아냅니다. 전 세계 수십억 대의 기기에 탑재된, 오늘날 가장 철저히 테스트된 소프트웨어 중 하나인 Linux 커널에서도 최근 1,000개가 넘는 취약점이 공개되었습니다. 최첨단 모델이 무해해 보이는 버그를 연쇄적으로 엮어 치명적인 익스플로잇으로 만드는 능력도 갈수록 좋아지고 있습니다. 따라서 실제 공격이 벌어지기 전에 이런 버그를 찾아 고칠 수 있는 기법이 필요합니다.
이상적으로는 모든 버그를 찾아 수정한 뒤, 더 이상 남은 버그가 없다는 증명까지 제시할 수 있어야 합니다. 형식 검증이 그 방법 중 하나입니다. 형식 검증에서는 개발자가 코드를 수학적 모델로 옮긴 다음, 그 코드가 정해진 보안 규칙을 항상 따른다는 것을 증명하려 합니다. 증명에 실패했다면 규칙을 위반하는 버그가 코드에 있을 수 있다는 뜻이며, 실패의 양상으로 버그가 무엇인지도 짐작할 수 있습니다. 실패 원인을 제거하고 이 과정을 반복하면, 결국 해당 규칙을 위반하는 버그가 코드에 없다는 증명을 얻게 됩니다.
하지만 형식 검증은 쉽지 않습니다. 증명은 원래 코드보다 몇 배나 커질 수 있고, 작성하려면 상당한 노력과 소수만 가진 고도로 전문적인 기술이 필요합니다. 예를 들어 seL4 운영체제 커널을 구현하는 데는 2인년이 들었지만, 형식 검증에는 20인년이 들었습니다. 그래서 형식 검증은 Airbus의 항공전자 코드처럼 정말로 임무 수행에 치명적인 분야에서만 실용성이 있었습니다.
그러나 LLM이 이를 훨씬 쉽게 만들고 있습니다. 이제 최첨단 모델은 실제 소프트웨어의 정확성 증명을 완전히 자율적으로 생성할 수 있습니다. 이를 입증하기 위해 우리는 Claude에게 오픈소스 라이브러리 123개에 걸쳐 유용한 보안 속성을 증명하도록 했습니다. 일부 실행 파일이 특정 조건에서 절대 크래시하지 않음을 보이는 것도 여기에 포함됩니다. 구체적으로 Claude는 64MB 미만의 모든 입력과, 모델링된 모든 Linux 운영체제(OS) 응답 및 메모리 배치에 대해, 이 프로그램들이 메모리 안전성 오류나 assertion 실패 없이 항상 정상 종료함을 증명했습니다. 이는 일정한 가정 아래에서 성립하는데, 프로그램이 Linux OS를 쓰는 RISC-V1 CPU에서 고정된 메모리 예산으로 싱글 스레드 정적 바이너리로 실행된다는 것입니다. 가능한 모든 버그를 고치기까지는 아직 거리가 멀지만, 예전보다 훨씬 가까워졌고 그 목표로 가는 로드맵도 마련되었습니다.
우리는 누구나 검증하고 재사용할 수 있도록 증명 중 일부를 RISC-V 및 OS 시맨틱스와 함께 공개합니다. 이 프로젝트의 협력사인 Theorem은 다른 오픈소스 프로젝트에도 같은 파이프라인을 돌려 주겠다고 제안했으며, 개발자가 자신의 코드를 검증해 볼 수 있도록 Claude 스킬도 공개합니다.
형식 검증은 다양한 방법론을 아우르는 넓은 분야입니다. 아래에서는 다른 형식 검증 방법으로 보안 및 소프트웨어 개발 작업을 가속하려 했던 초기 탐색도 소개합니다. zlib 압축 알고리즘의 보안성 평가, Rust로 작성한 Python 인터프리터의 동작 동등성 증명, 핵심 소프트웨어에 오래 숨어 있던 버그 색출 등이 그 예입니다.
형식 검증의 앞날은 밝습니다. 모델이 똑똑해지면서 증명을 작성하는 비용은 떨어지고 있습니다. 게다가 더 많은 코드가 형식화되고 보안 보장을 얻는 방법이 표준화될수록, 코드베이스 간에 증명을 재사용하거나 수정해 쓸 수 있게 되어 비용이 분산됩니다. 모든 개발자가 LLM으로 형식 검증을 시도해 보시길 권합니다. 특히 예전에 성능이 낮은 모델로 시도했다가 잘 안 됐던 분들께 권합니다.
이후로는 형식 검증 실험을 더 자세히 다룹니다.
테스트를 증명으로 바꾸기
소프트웨어가 올바르다는 것을 증명하려면, 먼저 "올바르다"가 무엇을 뜻하는지부터 정해야 합니다. 정확성은 명세(spec)로 정의됩니다. 일부 프로그램은 의도한 동작을 형식적으로 명세할 명확한 방법이 있습니다. 예를 들어 PNG 디코더는 바이트열을 받아 (RFC 2083에 따라) 그에 해당하는 이미지로 디코딩합니다. 하지만 대부분의 프로그램은 이처럼 간단하지 않습니다. 텍스트 에디터나 웹 브라우저가 "올바르다"는 것은 무슨 뜻일까요? 포괄적이고 모호하지 않은 명세를 얻기 어렵다는 점은 소프트웨어를 더 큰 규모로 검증하는 데 큰 걸림돌입니다.
증명 대상으로 삼은 오픈소스 라이브러리의 코드에서 이 문제를 풀기 위해, 우리는 이미 있는 컴파일 가능한 테스트 스위트를 명세로 자동 변환하는 방식을 택했습니다. "이 테스트 스위트는 항상 통과한다"라는 규칙을 인코딩하되, RISC-V로 컴파일된 임의의 바이너리를 Linux에서 실행한다는 것이 무엇인지를 나타내는 범용 모델을 사용합니다. 이런 명세를 증명하는 일은 예전에는 사실상 불가능했습니다. 임의의 입력에 대해 수만 개 어셈블리 명령어의 모든 가능한 동작과 상호작용을 아우르며 논증하는 증명을 작성하기가 본질적으로 복잡했고, 그 결과 증명도 극도로 커지기 마련이었기 때문입니다. 바로 여기서 오늘날의 LLM이 힘을 발휘합니다. 명확하게 정의된 목표를 향해 수백만 줄의 코드를 처리하는 일은 LLM에 아주 적합한 작업입니다.
이번 프로젝트에서는 퍼즈 테스트부터 시작했습니다. 퍼즈 테스트에서 개발자는 입력을 받는 진입점2을 코드에 작성하며, 크래시를 일으키는 입력은 작성자가 신경 쓰는 버그가 됩니다. 그러면 테스트 엔진인 퍼저가 진입점에 반무작위 및 변이된 입력을 대량으로 생성해 넣으면서 버그를 찾습니다(그림 1 참고). 퍼저를 오래 돌릴수록 더 많은 버그를 찾을 수 있습니다. 하지만 이는 본질적으로 무차별 대입 방식이라, 입력을 아무리 많이 시도해도 가능한 모든 코드 경로를 실행한다는 보장은 없습니다.
퍼징은 생성한 입력을 대량으로 하나의 진입점에 넣어 크래시를 일으키는 입력을 찾는 방식입니다. 입력은 무한하므로 탐색이 완전해질 수는 없습니다.
퍼즈 테스트로 드러났을 모든 버그를 찾기 위해, 우리는 퍼즈 테스트를 컴파일된 RISC-V 명령어 위에서 정의되는 명세로 바꿨습니다. 이 명세는 64MB 미만의 모든 입력에 대해 퍼즈 테스트가 크래시하지 않는다고 말합니다.3 Claude가 이 명세를 증명하면 RISC-V에서의 퍼즈 테스트는 불필요해집니다. 해당 진입점을 퍼징해도 버그가 나올 일이 없기 때문입니다.
우리는 이 작업을 Google의 OSS-Fuzz 이니셔티브에 속한 수백 개 프로젝트에 적용했습니다. OSS-Fuzz는 자격을 갖춘 오픈소스 프로젝트에 지속적인 퍼즈 테스트를 제공합니다. OSS-Fuzz에는 개발자가 작성한 진입점이 수천 개 있는데, 이들은 (예: assertion 실패로) 크래시를 일으켜 코드의 속성이 깨졌는지 확인합니다. OSS-Fuzz는 C와 C++ 프로그램에 AddressSanitizer4(ASan)를 자동으로 적용해, 메모리에 잘못 접근하면 크래시하도록 만듭니다(메모리 오류는 소프트웨어 취약점의 주된 원인입니다). 메모리 안전성처럼 폭넓게 적용되는 명세는 거의 모든 소프트웨어에 해당합니다.
오픈소스 라이브러리와 기존 퍼즈 테스트를 RISC-V 실행 파일로 컴파일합니다. 이 실행 파일은 Theorem의 RISC-V 및 OS 형식 시맨틱스, 그리고 원하는 무크래시 속성과 함께 증명이 충족해야 할 명세를 기계적으로 만들어 냅니다. Claude가 증명을 작성하면 Rocq 커널이 명세에 비추어 이를 검사합니다. 초록색은 신뢰 대상 구성 요소가 올바르다는 전제 아래 증명된 부분입니다.
몇 주 동안 Claude는 발견한 버그를 성공적으로 패치한 뒤, OSS-Fuzz 라이브러리 123개에 걸친 진입점 239개에서 (최대 64MB까지의) 어떤 입력에도 크래시가 없음을 증명했습니다. 이 증명은 컴파일된 RISC-V 명령어(즉 실행 바이너리)를 대상으로 하며, Rocq 코드 약 1억 8천만 줄로 이뤄져 있습니다. 일반적인 증명 하나는 약 60만 줄이고, 중앙값 18,000개의 RISC-V 명령어로 이뤄진 바이너리에 보안 보장을 제공합니다. 증명은 Theorem의 RISC-V 명령어 및 Linux 프로세스 시맨틱스를 이용해 RISC-V 어셈블리 코드를 수학적 모델로 변환하는 방식으로 만들어집니다. 따라서 현재 이 증명들은 프로그램이 Linux OS를 쓰는 RISC-V CPU에서 고정된 메모리 예산으로 싱글 스레드 정적 바이너리로 실행된다고 가정합니다. 더 많은 어셈블리 아키텍처와 다른 운영체제 프로세스의 시맨틱스를 표준화하면 되므로, 증명 범위를 넓히는 일은 충분히 가능합니다. Claude가 작성한 증명에 대한 전문가의 평가도 읽어 보세요.
모든 입력에 대한 형식적 무크래시 증명은 진입점에서 도달 가능한 모든 경로의 크래시를 배제합니다. Claude는 증명을 반복해 다듬는 동안, 도달 가능한 크래시 유발 버그가 남아 있으면 이를 찾아 고치기도 합니다.
증명 코드의 양은 엄청나지만, 사람이 직접 검토할 필요가 있는 부분은 사실상 없습니다. 증명이 명세를 올바르게 충족하는지는 Rocq 증명 검사기가 보장하기 때문입니다. 따라서 개발자가 신뢰해야 할 대상은 다음뿐입니다.
- RISC-V와 Linux 프로세스의 형식 모델
- 증명된 정리(theorem)의 정확한 진술
- Rocq 증명 검사기 자체5
이것이 이 라이브러리들에 버그가 없다는 뜻은 아닙니다. 남아 있는 버그가 있다면 위에 나열한 대상 안에 있거나, Claude의 증명 범위 밖에 있다는 의미입니다. 버그가 남아 있을 수 있는 이 신뢰 대상(Rocq, RISC-V, Linux 시맨틱스)을 견고하게 만드는 일도 만만치는 않지만, 대규모로 확장된 증명이 다루는 모든 코드를 한 줄씩 디버깅하는 것보다는 훨씬 다루기 쉬운 과제입니다. 특히 이 방식은 신뢰 대상의 규모를 키우지 않고도 얼마든지 많은 프로젝트를 보호할 수 있습니다.
우리는 증명을 독립적으로 검증해 주시길 환영하며, 접근 방식을 개선하는 것도 권장합니다. 이를 위해 이번 프로젝트에서 만든 신뢰 대상(위 목록) 중 아직 공개되지 않은 것, 패치가 필요 없었던 퍼즈 테스트에 대한 Claude의 완전한 Rocq 증명, 그리고 증명하지 못한 다른 퍼즈 테스트의 명세를 공개합니다.
버그 찾기와 수정
앞서 우리는 많은 오픈소스 라이브러리에서 개발자가 작성한 테스트(퍼즈 테스트)를, Claude가 항상 통과함을 증명할 수 있는 명세로 바꿀 수 있음을 보였습니다. 때로는 Claude가 발견한 남은 버그를 패치한 뒤에야 증명이 가능했습니다. 이처럼 명세를 증명하려는 과정에서 수백 개의 버그가 발견되었습니다.
Claude가 수백 개 진입점을 증명하는 동안 많은 버그가 나타났습니다. 버그가 나올 때마다 사람을 기다리느라 Claude가 멈추는 일이 없도록, 발견한 버그는 Claude가 직접 고치게 했습니다. 코드를 패치하면 패치된 코드로 명세가 다시 생성되고, Claude는 그 새 명세를 증명해 나갑니다.6
우리가 찾은 버그 중에는 퍼저가 찾아낼 가능성이 낮은 것이 많습니다. 퍼저는 작은 입력을 변이시키고, 보통 1MB로 제한되며, 버그로 이끌 때 대개 코드 커버리지에 의존합니다. 한 라이브러리의 진입점을 증명하던 Claude는 그 라이브러리에 포함된 압축 해제기 복사본에서 카운터 언더플로를 발견했습니다. 이는 범위를 벗어난 쓰기로 이어졌지만, 드물고 특정한 구조를 가진 약 20MB 크기의 입력에서만 발생했습니다. 그 밖에도 64MB 입력과 2GB가 넘는 메모리가 있어야 발생하는 이미지 디코더의 범위 밖 읽기, 같은 파일에 대한 두 핸들에 걸쳐 특정 순서로 호출해야 발생하는 다른 라이브러리의 범위 밖 읽기, 깊게 중첩된 입력이 필요한 libexpat의 CVE-2026-56132 재발견이 있었습니다. Claude는 크래시를 전혀 일으키지 않는 로직 버그도 찾았습니다. 예를 들어 한 라이브러리가 메모리 안전하다는 것을 증명하던 중, 애플리케이션이 로드할 수 있는 파일을 제한하는 기능이 항상 적용되지는 않는다는 것을 알아냈습니다.
이 프로젝트의 궁극적인 목표는 RISC-V로 컴파일한 퍼즈 테스트에서 더 이상 찾을 크래시가 없다는 증명을 얻는 것이었습니다. 하지만 위와 같은 버그는 그 목표를 달성하든 못 하든 이 과정에 또 다른 이점이 있음을 보여줍니다. 시도하는 것만으로도 반드시 고쳐야 할 실제 버그가 나온다는 것입니다.
메모리 안전성 너머의 증명
퍼즈 테스트에서 더 이상 찾을 크래시가 없음을 증명하는 일은 들리는 것보다 의미가 큽니다. 실제 코드의 퍼즈 테스트는 인코딩-디코딩 왕복, 멱등성, 대수 법칙, 차분 테스트, 자기 일관성, 참조 구현과의 동등성처럼 의미 있는 상위 수준 속성의 위반 여부를 검사하는 경우가 흔합니다. 예를 들어 LZO 압축 알고리즘의 퍼즈 테스트는 입력을 압축했다가 해제하면 원본과 같은 결과가 나온다고 assert합니다. 속성이 성립하지 않으면 프로그램이 크래시하므로, 테스트가 절대 크래시하지 않음을 증명하는 것은 그 속성 자체를 증명하는 것과 같습니다.
개발자가 속성을 직접 명시하지 않았더라도 같은 일이 일어날 수 있습니다. 예를 들어 Claude가 cpp-httplib의 OSS-Fuzz 증명을 끝내려면, std::set 소멸자에서 과도한 재귀로 인한 스택 오버플로 가능성을 배제해야 했습니다. 이 재귀 깊이는 트리의 최대 깊이로 제한되므로, Claude는 libc++의 레드-블랙 트리 재균형 알고리즘이 트리 깊이를 로그 수준으로 제한하도록 올바르게 최적화되어 있음을 (기계어 수준에서!) 증명해야 했습니다.
다른 형식 검증 사례 연구
형식 검증은 방대한 분야입니다. 위의 퍼즈 테스트-증명 사례는 기계어 코드에 증명을 직접 적용해 LLM이 형식 검증을 더 폭넓게 쓸 수 있게 만든 하나의 예입니다.
LLM을 형식 검증에 활용해 다른 방식으로도 성과를 거뒀습니다. 예를 들어 Claude에게 zlib 압축 파일 형식을 정의하는 기술 문서인 RFC 1950의 형식 명세를 작성하게 했습니다. 이어서 Linux 커널의 zlib 구현이 그 명세를 올바르게 구현했음을 Claude가 증명하게 했습니다. 앞선 예와 마찬가지로 Claude는 이 속성을 바이너리 수준에서 증명했는데, RISC-V 대신 Claude가 생성한 (그리고 철저히 테스트한) x86 ISA의 형식 시맨틱스를 사용해 x86으로 컴파일된 바이너리를 직접 증명했습니다.7 이어서 널리 쓰이는 다른 라이브러리 대여섯 개에도 같은 과정을 반복했습니다. 그 과정에서 코너 케이스에 있는 사소한(악용 불가능한) 버그 몇 개를 발견했고, 현재 업스트림에 보고하고 있습니다. 이 실험에서 두 가지 결론을 얻었습니다. (1) 이처럼 극도로 철저히 테스트된 코드베이스는 이미 거의 완전히 올바르다는 점, (2) 실제로 존재하는 코드베이스에 대해 종단 간(end-to-end) 정확성 속성을 증명하는 것이 가능하다는 점입니다.
또 다른 실험에서는 Claude에게 Python의 상당 부분을 지원하는 인터프리터를 Rust로 개발하게 하고, 학술 논문에 기술된 CPython 시맨틱스를 따른다는 것을 (Rust용 검증 도구인 Verus로) 증명하게 했습니다. 이어서 무작위로 생성한 Python 프로그램 170만 개 이상을 실행해 CPython의 동작과 얼마나 일치하는지 실증적으로 측정했습니다. 테스트의 99.95%에서 CPython과 동일하게 동작했고, 나머지 차이는 이미 알려진 코너 케이스였습니다.
단순한 보안 속성을 형식 검증하려는 시도를 통해, 널리 쓰이는 핵심 애플리케이션 몇 개에서도 문제를 발견했습니다. 그중 하나에서는 10년 넘게 잠복해 있던, 이전에 알려지지 않은 로직 버그를 찾았습니다. 널리 쓰이는 PDF 리더를 검증하는 과정에서는 보통 1년 동안 보고되는 만큼의 보안 버그를 일주일 만에 찾았습니다.
이러한 작업 중 일부의 자세한 내용은 부록을 참고하세요.
이제 시작일 뿐입니다
LLM을 활용한 형식 검증의 핵심 한계 중 하나는 증명을 만드는 데 수억 개의 토큰이 들 수 있다는 점입니다. 이 방법을 소프트웨어 생태계 전체에서 쓸 수 있게 하려면 비용 효율이 중요합니다. 다행히 효율이 좋아지리라 기대할 만한 설득력 있는 이유가 있습니다.
최신 모델일수록 토큰이 덜 든다
우리는 실제 OSS-Fuzz 코드로 작은 검증 과제 36개를 만들었습니다. Opus 5.5는 그중 절반을 Opus 5보다 약 40% 적은 토큰으로 증명합니다. 모델이 긴 검증 과제로 학습될수록 이런 추세가 계속되리라 예상합니다.
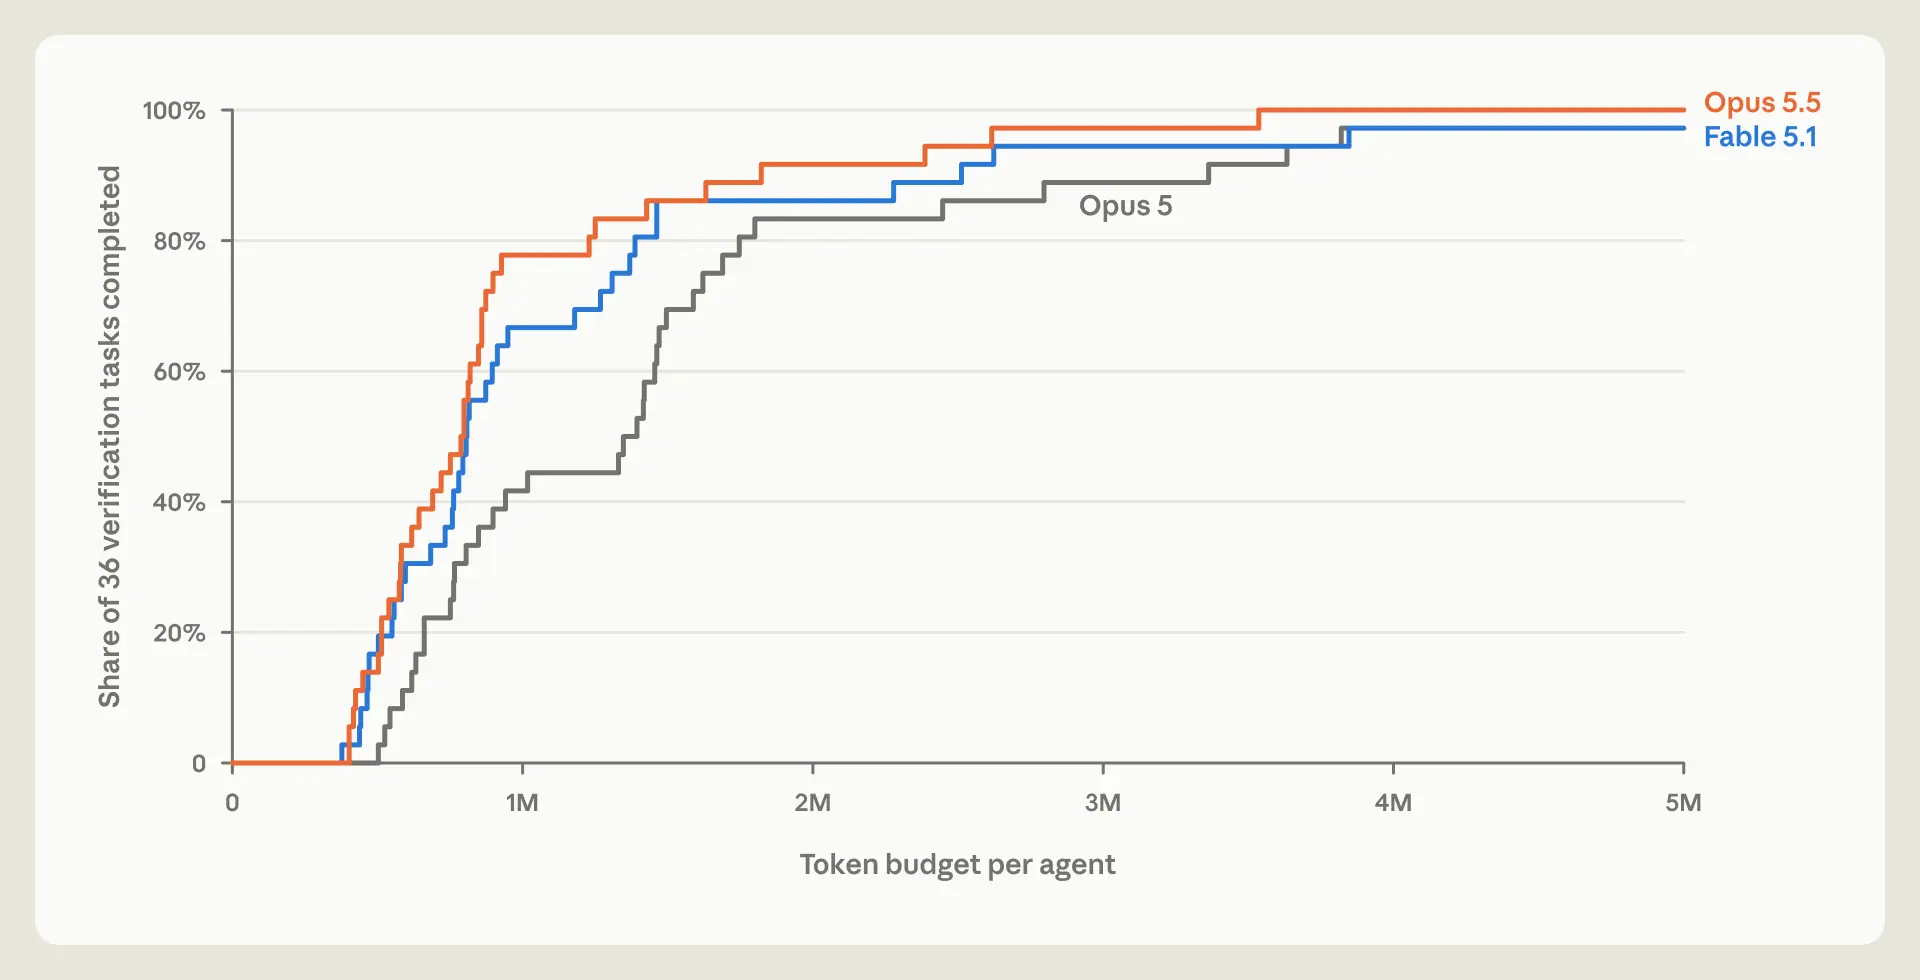
Opus 5.5는 이전 모델보다 증명을 빨리 끝냅니다. 단일 에이전트가 주어진 토큰 예산 내에 증명한 형식 검증 과제 36개의 비율입니다. 각 과제는 토큰 예산 500만 개로 독립적인 단일 에이전트 시도를 세 번씩 받았고, 첫 시도가 끝나는 시점에 증명된 것으로 집계합니다.
증명은 재사용할 수 있다
에이전트가 따로 일하면 같은 노력을 중복해서 들이는 경우가 많습니다. 증명은 소프트웨어처럼 더 작은 증명들로부터 재귀적으로 구축되며, 증명이 작을수록 재사용하기 쉬운 경향이 있습니다. 이 영향을 측정하기 위해 에이전트들이 자기 대상을 증명하는 동안 서로의 증명을 복사할 수 있게 했습니다. 이 공유 작업 공간을 쓸 수 있게 하자 에이전트가 혼자 일할 때보다 토큰이 17% 적게 들었고, 혼자 시도했을 때는 실패했던 과제를 성공한 에이전트도 있었습니다.
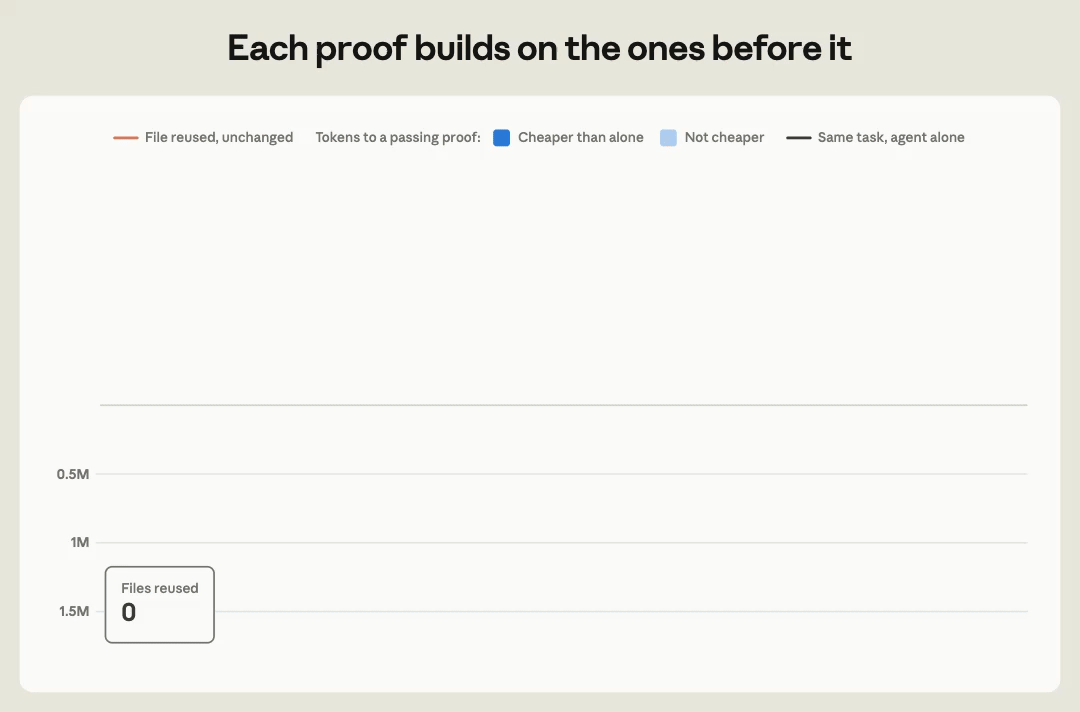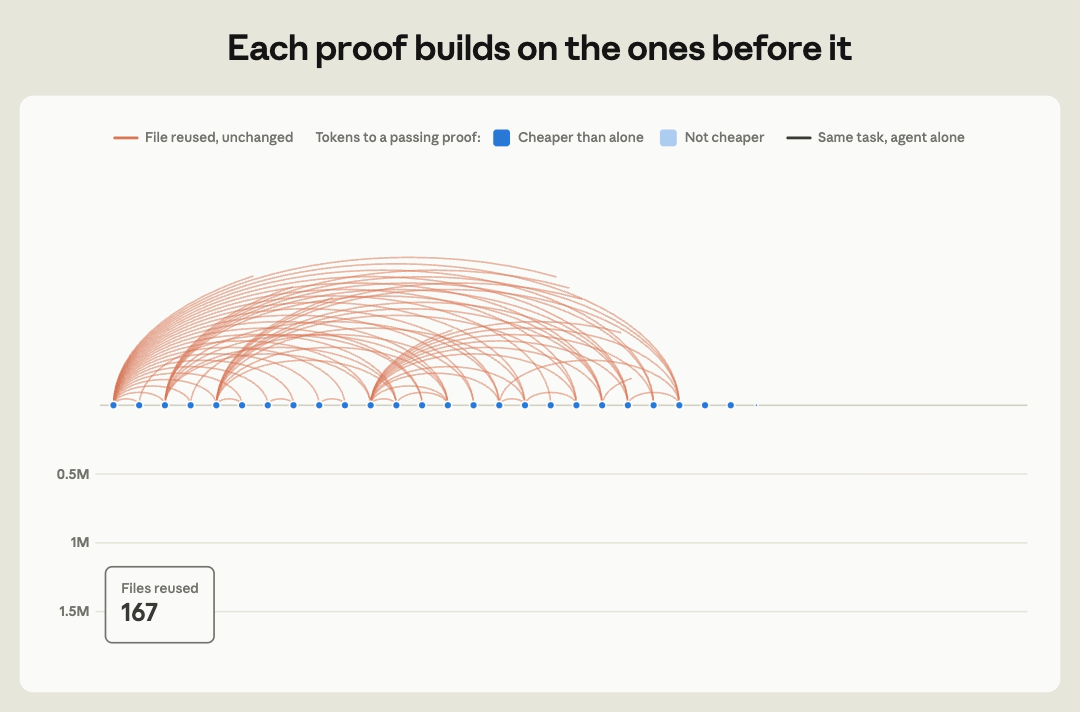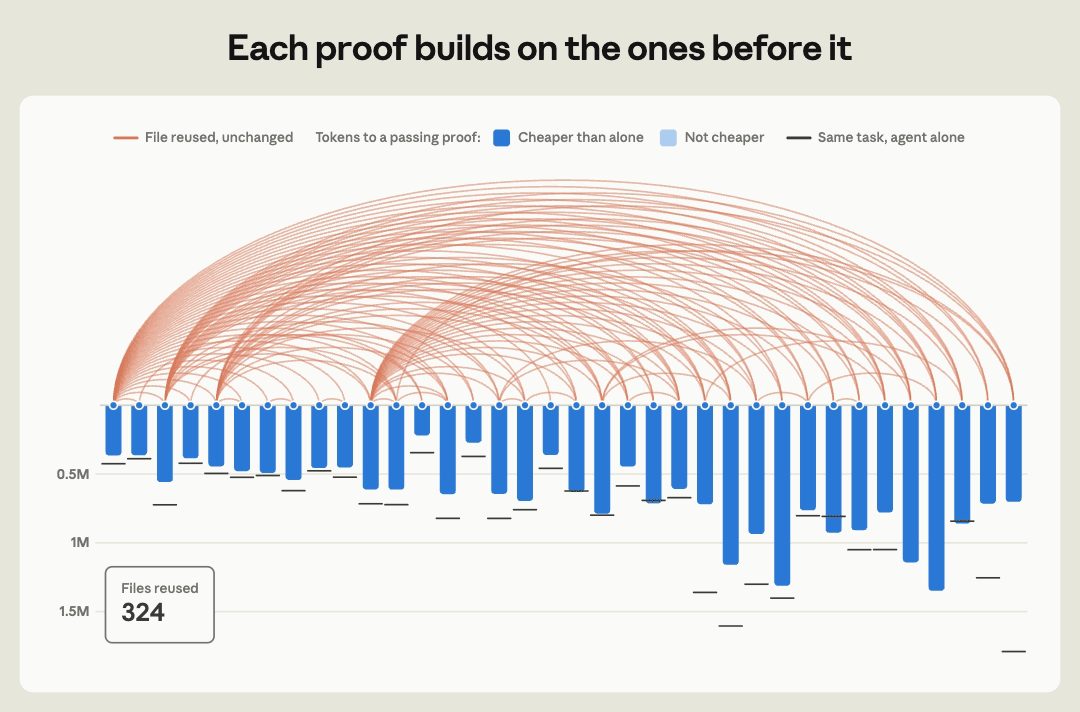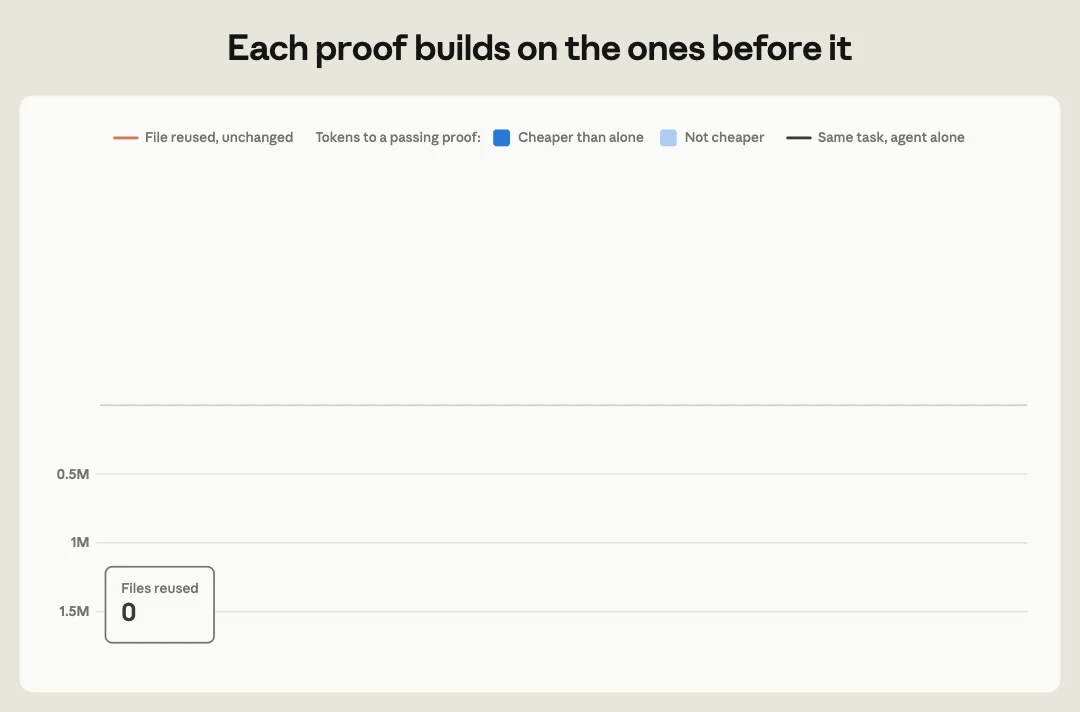
하나의 공유 작업 공간에서 나온 증명 36개를 완료된 순서대로 나열했습니다. 수정되지 않은 파일을 공유하는 두 증명은 호로 이어집니다. 막대는 각 증명을 작성하는 데 쓴 토큰을, 검은 선은 같은 과제를 에이전트가 혼자 처리했을 때의 평균 비용을 나타내며, 완료된 증명 34개 중 30개에서 혼자 처리할 때 비용이 더 높았습니다(혼자 일한 에이전트는 증명 두 개를 끝내지 못했습니다).
OSS-Fuzz 증명 작업에서도 같은 현상이 대규모로 나타났습니다. 증명의 대부분은 모든 프로그램에 공통으로 들어 있는 코드(특히 C 런타임과 AddressSanitizer의 초기화)에 관한 것이어서, 서로 매우 다른 프로그램의 증명도 상당 부분 겹칠 수 있습니다. 에이전트 팀은 이를 활용해 다른 팀이 끝낸 증명을 복사한 뒤 자기 프로그램에 맞게 고쳐 썼습니다(그림 6).
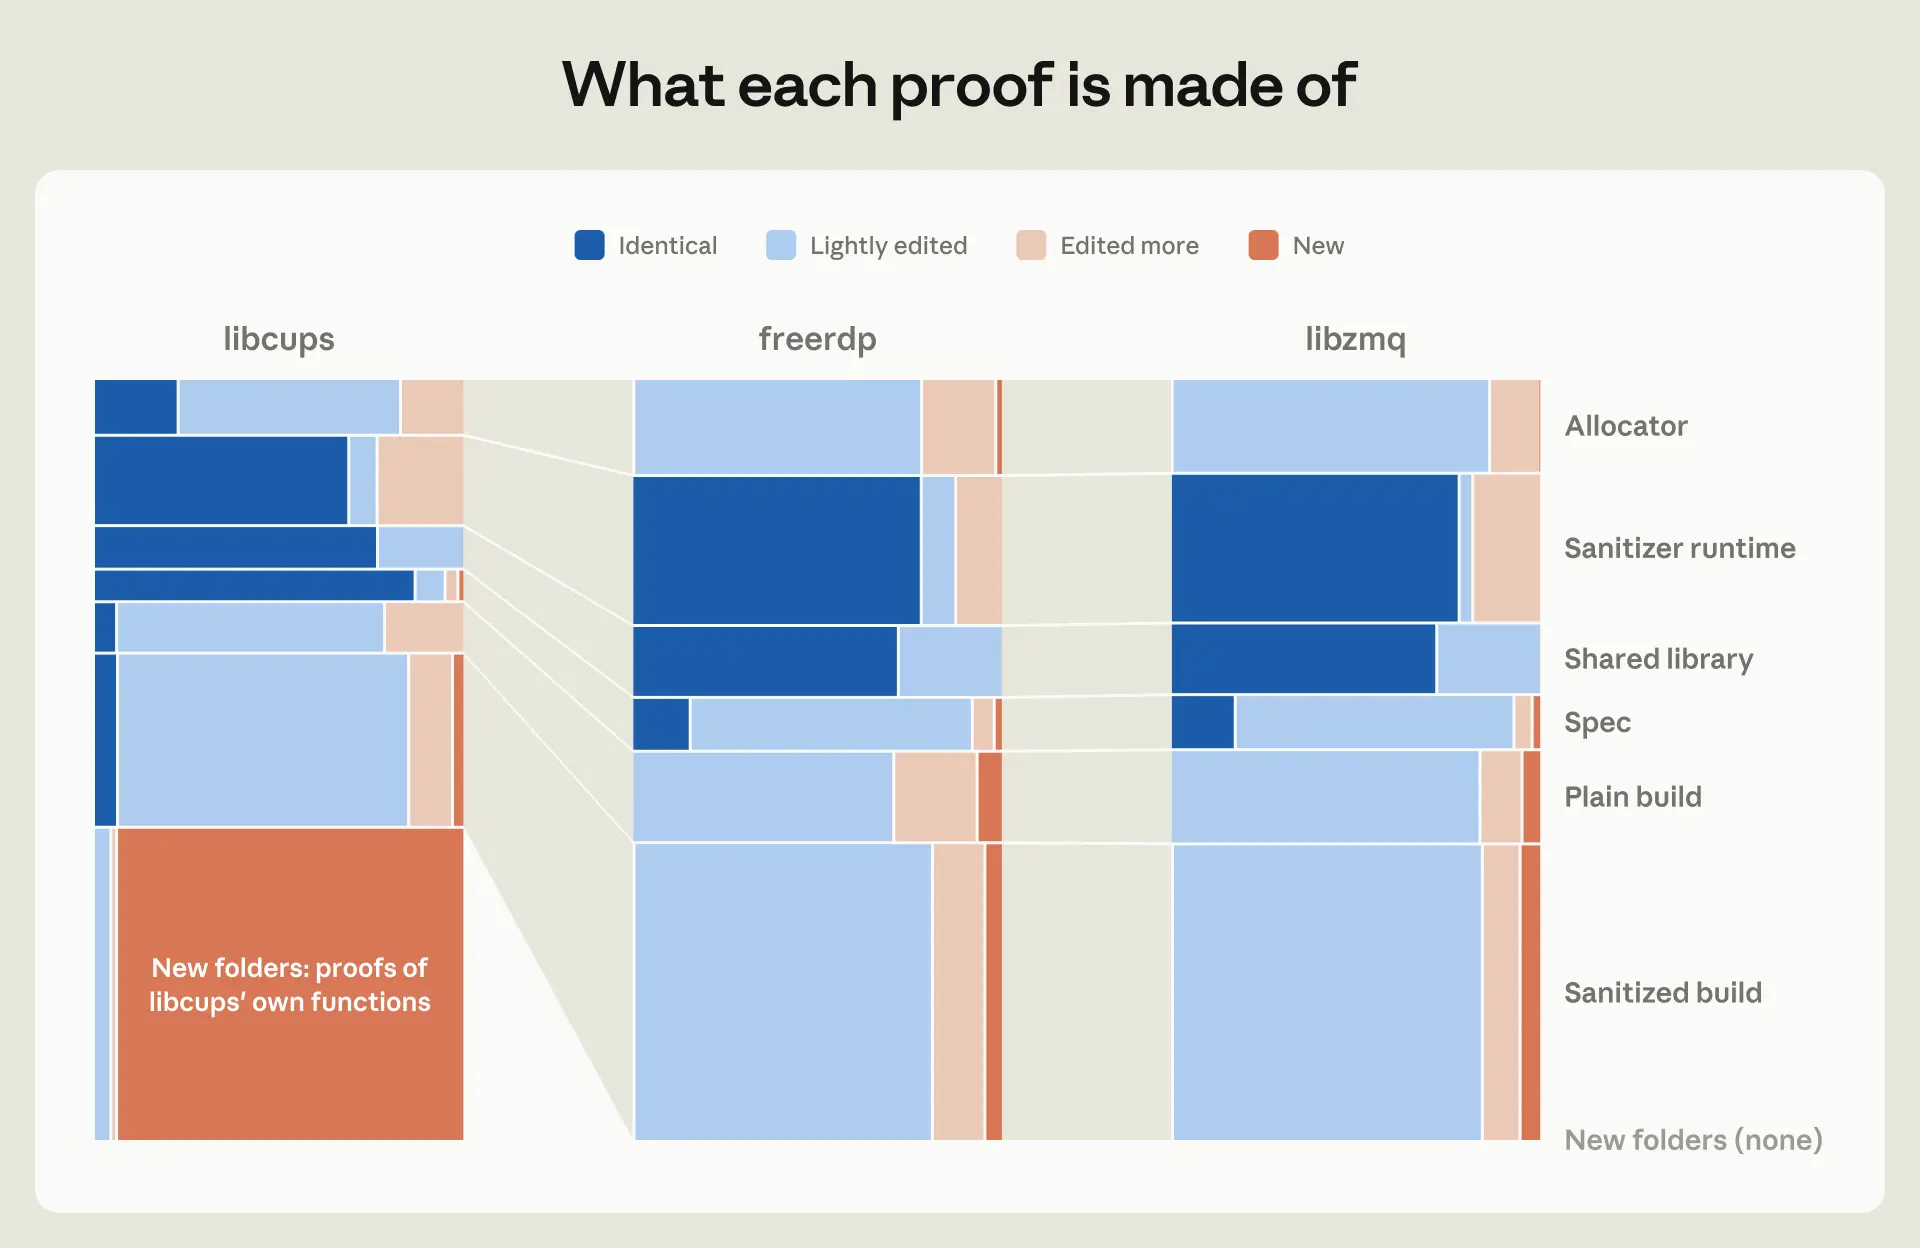
에이전트는 기존 증명을 복사해 새 프로그램에 맞게 수정했습니다. 각 열은 프로그램 하나의 전체 증명을 바이트 비율로 나타냅니다. 블록은 증명의 각 부분이며, 각 블록은 그대로 유지된 부분, 가볍게 수정된 부분(같은 파일, 크기 변화 2% 이내), 더 많이 수정된 부분, 새로 작성된 부분의 비율을 보여줍니다. 공유된 부분에는 새로 추가된 코드가 거의 없었습니다.
증명의 이런 재사용성 덕분에, Lean의 형식 수학 공유 라이브러리인 Mathlib은 700명이 넘는 기여자가 제출한 정리 약 30만 개 규모로 성장했습니다. 새 증명은 모두 기존 성과 위에 쌓입니다. 우리도 OSS-Fuzz 작업을 하며 비슷한 증명 자산을 쌓았고, 그중 일부를 이번 공개물에 포함합니다(오픈소스 소프트웨어에서 아직 패치되지 않은 버그를 드러낼 수 있는 증명은 공개하지 않습니다).
초기 실험 단계를 넘어서려면, 가장 중요한 의존성부터 시작해 방대한 기존 소프트웨어를 검증할 전략이 필요합니다. 이미 보여드렸듯이 범용 명세를 쓰고 바이너리 수준에서 작업하면 코드베이스 전체를 다른 언어로 다시 쓸 필요 없이 대규모로 이를 달성할 수 있습니다.
이 접근법은 패키지 단위로 증명을 재사용하기도 쉬워서, 각 의존성은 한 번만 검증하면 됩니다. 의존성은 거듭제곱 법칙을 따르기 때문에, 공유 라이브러리 몇 개만 증명해도 훨씬 많은 소프트웨어를 증명 가능한 범위로 끌어들일 수 있습니다. glibc, OpenSSL, cURL 같은 핵심 인프라를 포함한 Nix 생태계 전체를 검증하려는 Theorem의 로드맵에서 자세한 내용을 볼 수 있습니다.
한계
실제로는 형식 검증이 코드의 보안에 대해 우리가 바라는 것보다 적게 증명하는 경우가 있습니다.
"형식 검증됨"이 "버그 없음"을 뜻하지는 않습니다. Claude는 컴파일된 프로그램의 동작이 형식 명세의 요구 사항을 만족함을 보여주는 증명을 작성할 수 있고, 이는 외부 증명 검사기가 검증합니다. 하지만 증명 검사기는 명세가 현실과 일치하는지는 알려줄 수 없습니다. 현실과 일치하려면 명세가 CPU와 운영체제를 비롯해 검증 대상 프로그램이 실행되는 실제 기계의 모든 것을 정확히 포괄하고 모델링해야 합니다. 검증된 코드에서 버그가 나타난다면, 그것은 명세나 가정한 기계의 시맨틱스가 현실과 다르기 때문입니다. 다행히 이는 남은 버그를 어디서 찾아야 하는지, 그리고 버그가 남아 있을 수 있는 틈을 최소화하는 시스템을 어떻게 설계해야 하는지 안다는 뜻이기도 합니다. 아래에서 이것이 우리 증명에 어떻게 적용되는지, 그리고 그 틈을 메울 향후 과제를 소개합니다.
실제 기계는 모델이 설명하지 않는 동작을 합니다. 우리의 증명은 musl libc에 링크된 싱글 스레드 정적 RISC-V 바이너리를 대상으로 합니다. 그러나 대부분의 사용자는 이 라이브러리를 x86이나 ARM에서 glibc에 동적으로 링크해 실행합니다. 이 간극을 메우려면 실제 배포 환경과 더 비슷한 시스템 모델이 필요합니다. 예를 들어 x86의 정확한 시맨틱스를 생성하는 것이 그 첫걸음이 될 수 있습니다.
증명한 내용이 우리가 신경 쓰는 모든 것을 포괄하지는 않을 수 있습니다. 우리는 Google OSS-Fuzz의 여러 퍼징 진입점에서, ASan 크래시를 포함해 64MB 미만의 어떤 입력에도 크래시가 발생하지 않음을 증명했습니다. 그러나 ASan은 모든 메모리 안전성 버그를 탐지하지 못하고, 우리가 각 라이브러리의 모든 진입점을 검증한 것도 아닙니다. 설령 모두 검증했더라도, 모든 진입점을 검증한다고 라이브러리 전체가 커버되지는 않습니다(특히 죽은 코드가 있다면 그렇습니다). 게다가 실제 프로그램이 라이브러리를 잘못 사용해 호출하는 쪽에서 메모리 손상이 생길 수도 있습니다. 이 간극을 메우려면 각 공개 함수에 대해 호출하는 쪽이 지켜야 할 조건을 명시하고, 호출하는 쪽이 이를 엄격히 따라야 합니다.
LLM을 형식 기법에 활용하는 방법을 더 알게 되고 모델이 계속 발전하면, 이러한 한계도 해결 가능해져 우리가 의존하는 코드의 훨씬 큰 비율을 검증할 수 있게 되리라 기대합니다.
결론
방향은 분명합니다. 지금까지는 가장 안전이 중요한 코드에서 전문가가 맞춤 제작하는 보장에만 실용적이던 형식 검증이, 머지않아 오늘날의 퍼징처럼 거의 모든 프로덕션 소프트웨어에 실용적인 수단이 될 것입니다. 정적 타입이나 테스트 프레임워크 같은 다른 정확성 도구가 그랬듯이, 검증도 "덧붙이는" 것에서 "기본 내장"되는 것으로 성숙할 것이며, 이는 LLM뿐 아니라 언어 설계와 개발 워크플로의 혁신이 함께 이끌 것입니다.
LLM이 코드 취약점을 자동으로 스캔해 점점 더 많이 찾아내는 오늘날에는, 코드의 보안 속성을 보장할 수 있는 프로세스를 써야 합니다. LLM으로 규모를 키운 형식 검증은 이전에는 불가능했던 범위와 규모에서 이런 보장을 확보하는 유망한 접근법입니다. 더 많은 분이 직접 실험해 보시기 바랍니다. 그래야 견고한 소프트웨어가 널리 퍼지고, 소프트웨어 버그는 잘 이해되고 빠르게 해결할 수 있는 드문 일이 되는 세상을 함께 만들 수 있습니다.