Stencil기술 블로그
단 하루 오후 만에 LLM 15개의 코딩 성능을 높였다. 바뀐 건 하네스뿐이었다.
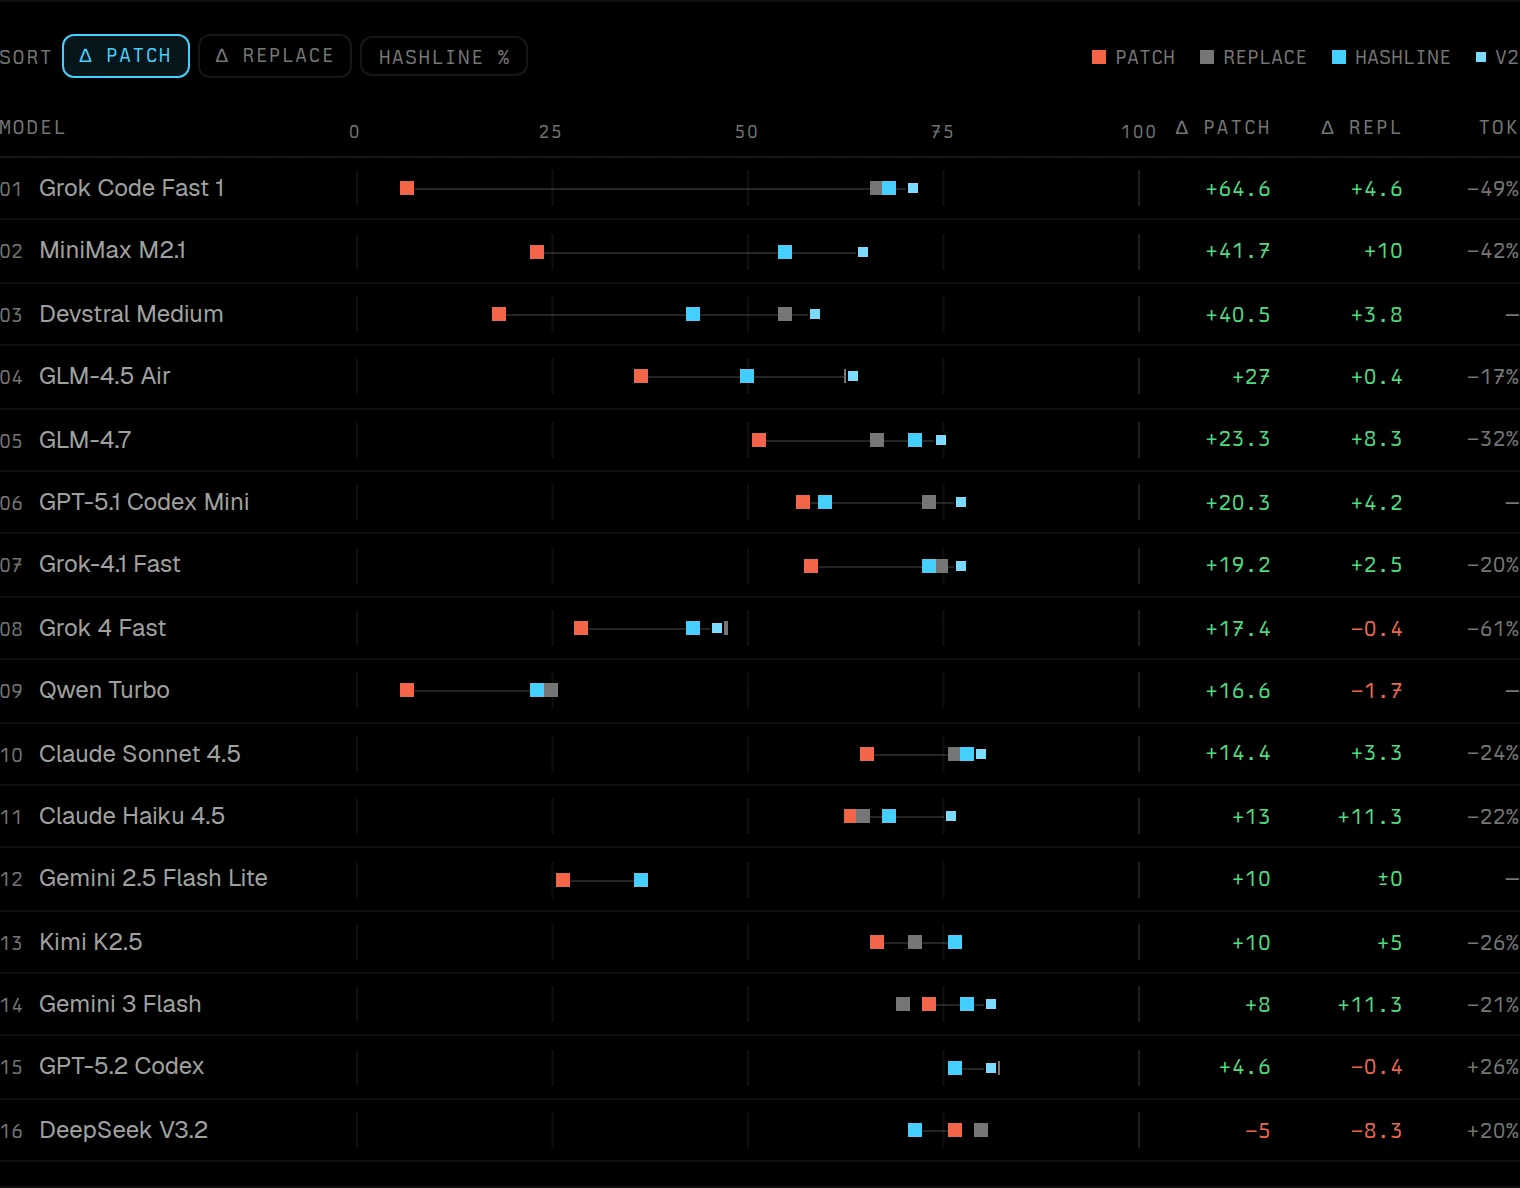
16개 코딩 모델을 대상으로 테스트한 결과, hashline의 콘텐츠 해시 라인 앵커 방식이 14개 모델에서 패치 방식을 앞질렀다. 기존 성능이 낮은 모델일수록 개선 폭은 더 컸다.
실제로 바뀐 건 편집 도구(edit tool) 하나뿐이었다.
- +15pts 패치 대비 평균, 16개 모델
- 10× Grok Code Fast 1
- −61% 출력 토큰, 최선의 경우
- $0 학습 연산
 인터랙티브
편집 형식별·모델별 통과율 · 매회 새 세션으로 3회 실행 × 180개 태스크 · hashline이 14/16 모델에서 패치 대비 우위; v2 수정안은 12/16 모델에서 추가 개선 — 최대 상승폭 GPT-5.1 Codex Mini, 60.0% → 77.5%
잘못된 질문
요즘 코딩 분야의 화두는 거의 전부 '어떤 모델이 가장 뛰어난가'에 쏠려 있다. GPT-5.3 대 Opus, 이번 주 출시된 Gemini 대 또 다른 무언가. 하지만 이런 시각은 점점 더 잘못된 방향으로 흐르고 있다. 모델만이 유일한 변수인 것처럼 전제하기 때문이다. 실제로는 훨씬 더 평범한 곳에 병목이 존재한다. 바로 하네스(harness)다.
하네스는 사용자의 첫인상이 결정되는 곳이기도 하다(화면이 제멋대로 스크롤되는가, 아니면 버터처럼 부드럽게 움직이는가?). 모든 입력 토큰이 여기서 비롯되고, 모델 출력과 워크스페이스의 모든 변경 사이를 잇는 인터페이스도 바로 하네스다.
굳이 왜 신경 써야 하냐고? Opus가 훌륭한 모델일 수는 있다. 하지만 Claude Code는 지금 이 순간에도 서브 에이전트 출력에서 JSONL 원문을 그대로 노출하며 수십만 개의 토큰을 낭비하고 있다. 오픈 하네스에서는 이런 문제를 직접 고칠 수 있다. 서브 에이전트가 이제는 구조화된 데이터를 출력한다.
툴 스키마, 오류 메시지, 상태 관리—"모델이 무엇을 바꿔야 하는지 안다"에서 "문제가 해결됐다"까지의 모든 과정. 실제로 대부분의 실패는 바로 이 구간에서 발생한다.
모델에 종속되지 않는 구조이기 때문에, 모델은 그저 하나의 파라미터에 불과하다. 진짜 변수는 하네스이며, 여기에는 상상 이상의 통제권이 있다.
어쨌든, 어제 우리가 바꾼 변수 하나에 대해 이야기해보자.
편집 도구!
우리가 만든 것을 설명하기에 앞서, 현재의 기술 수준을 먼저 살펴볼 필요가 있다.
Codex는 apply_patch를 사용한다. 문자열을 입력으로 받으며, 사실상 OpenAI 방식의 diff다. 구조화된 스키마에 의존하는 대신, 하네스는 이 덩어리가 엄격한 규칙을 따를 것이라고 가정한다. OpenAI 팀이 분명 뛰어난 만큼, GPT의 Codex 변형 모델에서는 JSON 스키마나 필수 툴 호출처럼 LLM 게이트웨이 단계에서 토큰 선택이 이 구조에 맞게 편향되어 있을 가능성이 높다.
하지만 이 방식을 전혀 모르는 다른 모델에 그대로 적용하면? 패치 실패율이 치솟는다. 우리 벤치마크에서 Grok 4의 패치 실패율은 50.7%, GLM-4.7은 46.2%였다. 나쁜 모델이라서가 아니다. 그 언어를 모를 뿐이다.
Claude Code(와 대부분의 도구)는 str_replace를 사용한다. 정확히 일치하는 기존 텍스트를 찾아 새 텍스트로 교체하는 방식이다. 개념적으로는 단순하지만, 모델이 공백과 들여쓰기를 포함한 모든 문자를 완벽하게 재현해야 한다. 일치하는 부분이 여러 곳이면? 거부된다. "String to replace not found in file" 오류가 너무 흔한 나머지 전용 GitHub 이슈 메가스레드까지 생겼을 정도다(관련 이슈 +27개). 최적이라고 보기 어렵다. Gemini도 기본적으로 같은 방식에 약간의 공백 퍼지 매칭을 더했을 뿐이다.
Cursor는 별도의 신경망을 학습시켰다. 편집 초안을 받아 파일에 올바르게 병합하는 것만을 전담하는 파인튜닝된 70B 모델이다. 하네스 문제가 얼마나 어려운지, 가장 풍부한 자금을 보유한 AI 기업 중 하나가 아예 모델을 하나 더 투입하기로 결정했다. 그럼에도 그들은 자사 블로그 포스트에서 "400줄 미만의 파일에서는 aider 방식의 diff보다 전체 파일 재작성이 성능이 더 좋다"고 언급했다.
Aider의 자체 벤치마크에 따르면, 형식 선택만으로 GPT-4 Turbo의 성능이 26%에서 59%로 뛰었다. 하지만 같은 형식을 적용했을 때 GPT-3.5는 유효한 diff를 안정적으로 생성하지 못해 19%에 그쳤다. 형식이 모델만큼이나 중요하다는 뜻이다.
JetBrains의 Diff-XYZ 벤치마크는 이를 체계적으로 확인했다. 모든 모델과 사용 사례에 걸쳐 지배적인 단일 편집 형식은 존재하지 않는다. EDIT-Bench는 현실적인 편집 태스크에서 pass@1이 60%를 넘는 모델이 단 하나뿐임을 밝혔다.
이처럼 "어떻게 변경할 것인가"라는 단순한 문제에도 진정한 합의가 없다. 우리의 시각은 이렇다. 이 중 어떤 도구도 방대한 컨텍스트를 낭비하거나 완벽한 재현에 의존하지 않고, 모델이 수정하려는 라인에 안정적이고 검증 가능한 식별자를 제공하지 못한다. 모두 모델이 이미 본 내용을 다시 재현하는 방식에 의존한다. 재현에 실패하면—자주 그렇듯—사용자는 모델을 탓한다.
Hashline!
잠깐 함께 따라와 보자. 모델이 파일을 읽거나 특정 내용을 검색할 때, 모든 라인이 2~3자의 콘텐츠 해시로 태그가 붙어 돌아온다면 어떨까.
hello.js — 읽기
1:a3|function hello() {
2:f1|  return "world";
3:0e|}
모델이 편집할 때는 해당 태그를 참조한다. "2:f1 라인 교체, 1:a3부터 3:0e까지 범위 교체, 3:0e 뒤에 삽입." 마지막으로 읽은 이후 파일이 변경됐다면, 해시가 일치하지 않아 데이터가 손상되기 전에 편집이 거부된다(낙관적으로 보면).
의사 난수 태그를 떠올릴 수 있다면, 자신이 무엇을 편집하는지 알고 있을 가능성이 높다. 그렇다면 모델은 신뢰할 수 있는 "앵커(anchor)"를 표현하기 위해 기존 내용을, 더 나아가 공백까지 완벽히 재현할 필요가 없어진다.
벤치마크
실제 환경에서의 성능이 핵심 관심사인 만큼, 테스트 픽스처는 다음과 같이 생성했다.
- React 코드베이스에서 임의의 파일을 선택한다.
- 역변환을 예측할 수 있는 편집으로 버그를 유발하는 변이를 도입한다(예: 연산자 교체, 불리언 반전, off-by-one 오류, optional chain 제거, 식별자 이름 변경).
- 문제를 평이한 영어로 기술한다.
평균적인 태스크 설명은 다음과 같다.
# Fix the bug in `useCommitFilteringAndNavigation.js`

A guard clause (early return) was removed.
The issue is in the `useCommitFilteringAndNavigation` function.
Restore the missing guard clause (if statement with early return).
물론 100% 성공률을 기대하지는 않는다. 모델이 반드시 동일한 파일로 귀결되지 않는 독자적인 해법을 제시할 수 있기 때문이다. 하지만 버그 자체가 기계적인 성격이라, 대부분의 경우 수정 방법은 우리가 적용한 변이를 되돌리는 것이다.
태스크당 3회 실행, 회당 180개 태스크. 매번 에이전트 세션을 새로 시작하며, 사용 도구는 네 가지(읽기, 편집, 쓰기)다. 임시 워크스페이스를 제공하고 프롬프트를 전달한 뒤, 에이전트가 멈추면 포매팅 전후의 원본 파일과 비교한다.
16개 모델, 3가지 편집 도구를 대상으로 한 결과는 명확했다. 패치는 거의 모든 모델에서 최악의 형식이었고, hashline은 대부분의 모델에서 replace와 동등하거나 더 우수했으며, 기초 성능이 낮은 모델일수록 개선 폭이 컸다. Grok Code Fast 1은 6.7%에서 68.3%로 10배 향상됐다. 패치 실패가 너무 심각해 모델 본연의 코딩 능력이 기계적 편집 실패에 가려져 있었기 때문이다. MiniMax는 성능이 두 배 이상 올랐다. Grok 4 Fast의 출력 토큰은 61% 감소했는데, 재시도 루프에서 토큰을 소모하는 일이 없어졌기 때문이다.
그래서 뭐가 달라지는가?
Gemini의 성공률 8% 향상은 대부분의 모델 업그레이드보다 큰 성과이며, 학습 연산 비용은 전혀 들지 않았다. 약간의 실험과 벤치마킹에 쓴 약 300달러가 전부였다.
모델은 태스크를 이해하는 데 문제가 없을 때가 많다. 표현하는 데 문제가 있을 뿐이다. 착륙 장치 결함을 조종사 탓으로 돌리는 격이다.
벤더 이야기
Anthropic은 최근 큰 인기를 얻고 있는 오픈소스 코딩 에이전트 OpenCode를 차단했다. Claude Code 구독을 통한 Claude 접근을 막은 것이다.
"OpenCode가 비공개 API를 역공학했다"는 Anthropic의 입장은 표면적으로는 타당하다. 그들의 인프라이니 그들이 규칙을 정하는 건 당연하다. 하지만 이 조치가 시사하는 바를 보라.
하네스를 만들지 마라. 우리 것을 써라.
Anthropic만의 문제도 아니다. 이 글을 쓰는 도중, Google은 내 Gemini 계정을 아예 차단해버렸다.

속도 제한도 아니었다. 경고도 없었다. 비활성화였다. 벤치마크를 돌린 것뿐인데—그것도 새로운 기법으로 Gemini 3 Flash가 78.3%를 기록해 그들의 최선보다 5.0pp 앞섰다는 걸 보여준 그 벤치마크인데. 이유조차 모르겠다.
왜 거꾸로 된 행동인지 설명하겠다. 우리는 방금 다른 편집 형식이 그들 자신의 모델을 5~14 포인트 개선하면서 출력 토큰을 약 20% 줄인다는 걸 보여줬다. 이건 위협이 아니다. 무료 R&D다.
어떤 벤더도 경쟁사 모델을 위해 하네스를 최적화하지 않는다. Anthropic은 Grok을 위해 튜닝하지 않는다. xAI는 Gemini를 위해 튜닝하지 않는다. OpenAI는 Claude를 위해 튜닝하지 않는다. 하지만 오픈소스 하네스는 모든 모델을 위해 튜닝된다. 기여자들이 각기 다른 모델을 사용하고, 자신이 직접 마주친 실패를 고치기 때문이다.
모델은 해자(moat)다. 하네스는 다리다. 다리를 태우면 건너려는 사람만 줄어들 뿐이다. 하네스를 이미 해결된 문제, 혹은 사소한 문제로 취급하는 건 지극히 근시안적이다.
모든 코드, 벤치마크, 실행별 리포트: omp


