Stencil기술 블로그
Snapcompact: 최첨단 컨텍스트 압축 — 즉각적·로컬·무료, 셋 다 됩니다
Snapcompact는 에이전트 컨텍스트를 픽셀 폰트 이미지로 변환해, 프런티어 모델 4종에서 입력 비용을 3분의 1로 줄이면서도 원문에 가까운 정확도로 내용을 재현합니다.
1568×1568 PNG 한 장에 6×10 픽셀 폰트로 텍스트 약 40,000자를 담을 수 있습니다. 약 10,000 토큰 분량의 텍스트인데, Anthropic의 픽셀 산정 방식으로는 이미지 토큰 3,279개에 해당합니다. 어디로 향하는지 보이시나요?
Snapcompact의 원리는 이렇습니다. 컨텍스트 윈도우가 가득 차면, 내용을 고밀도 픽셀 폰트 비트맵으로 렌더링해서 이미지로 돌려주는 것입니다. "그림 한 장이 천 마디 말보다 낫다"는 말이 문자 그대로 사실로 드러났습니다 — 모델은 입력 비용의 3분의 1로 원문에 가까운 정확도로 내용을 읽어냅니다. 의례적인 벤치마크:
- 3,279 40,000자당 이미지 토큰
- ÷3 동일 컨텍스트, 입력 비용
- ÷2.0 F1 동등 기준 프론티어 청구액
- 0.39→1.00 튜닝 후 p(정답)
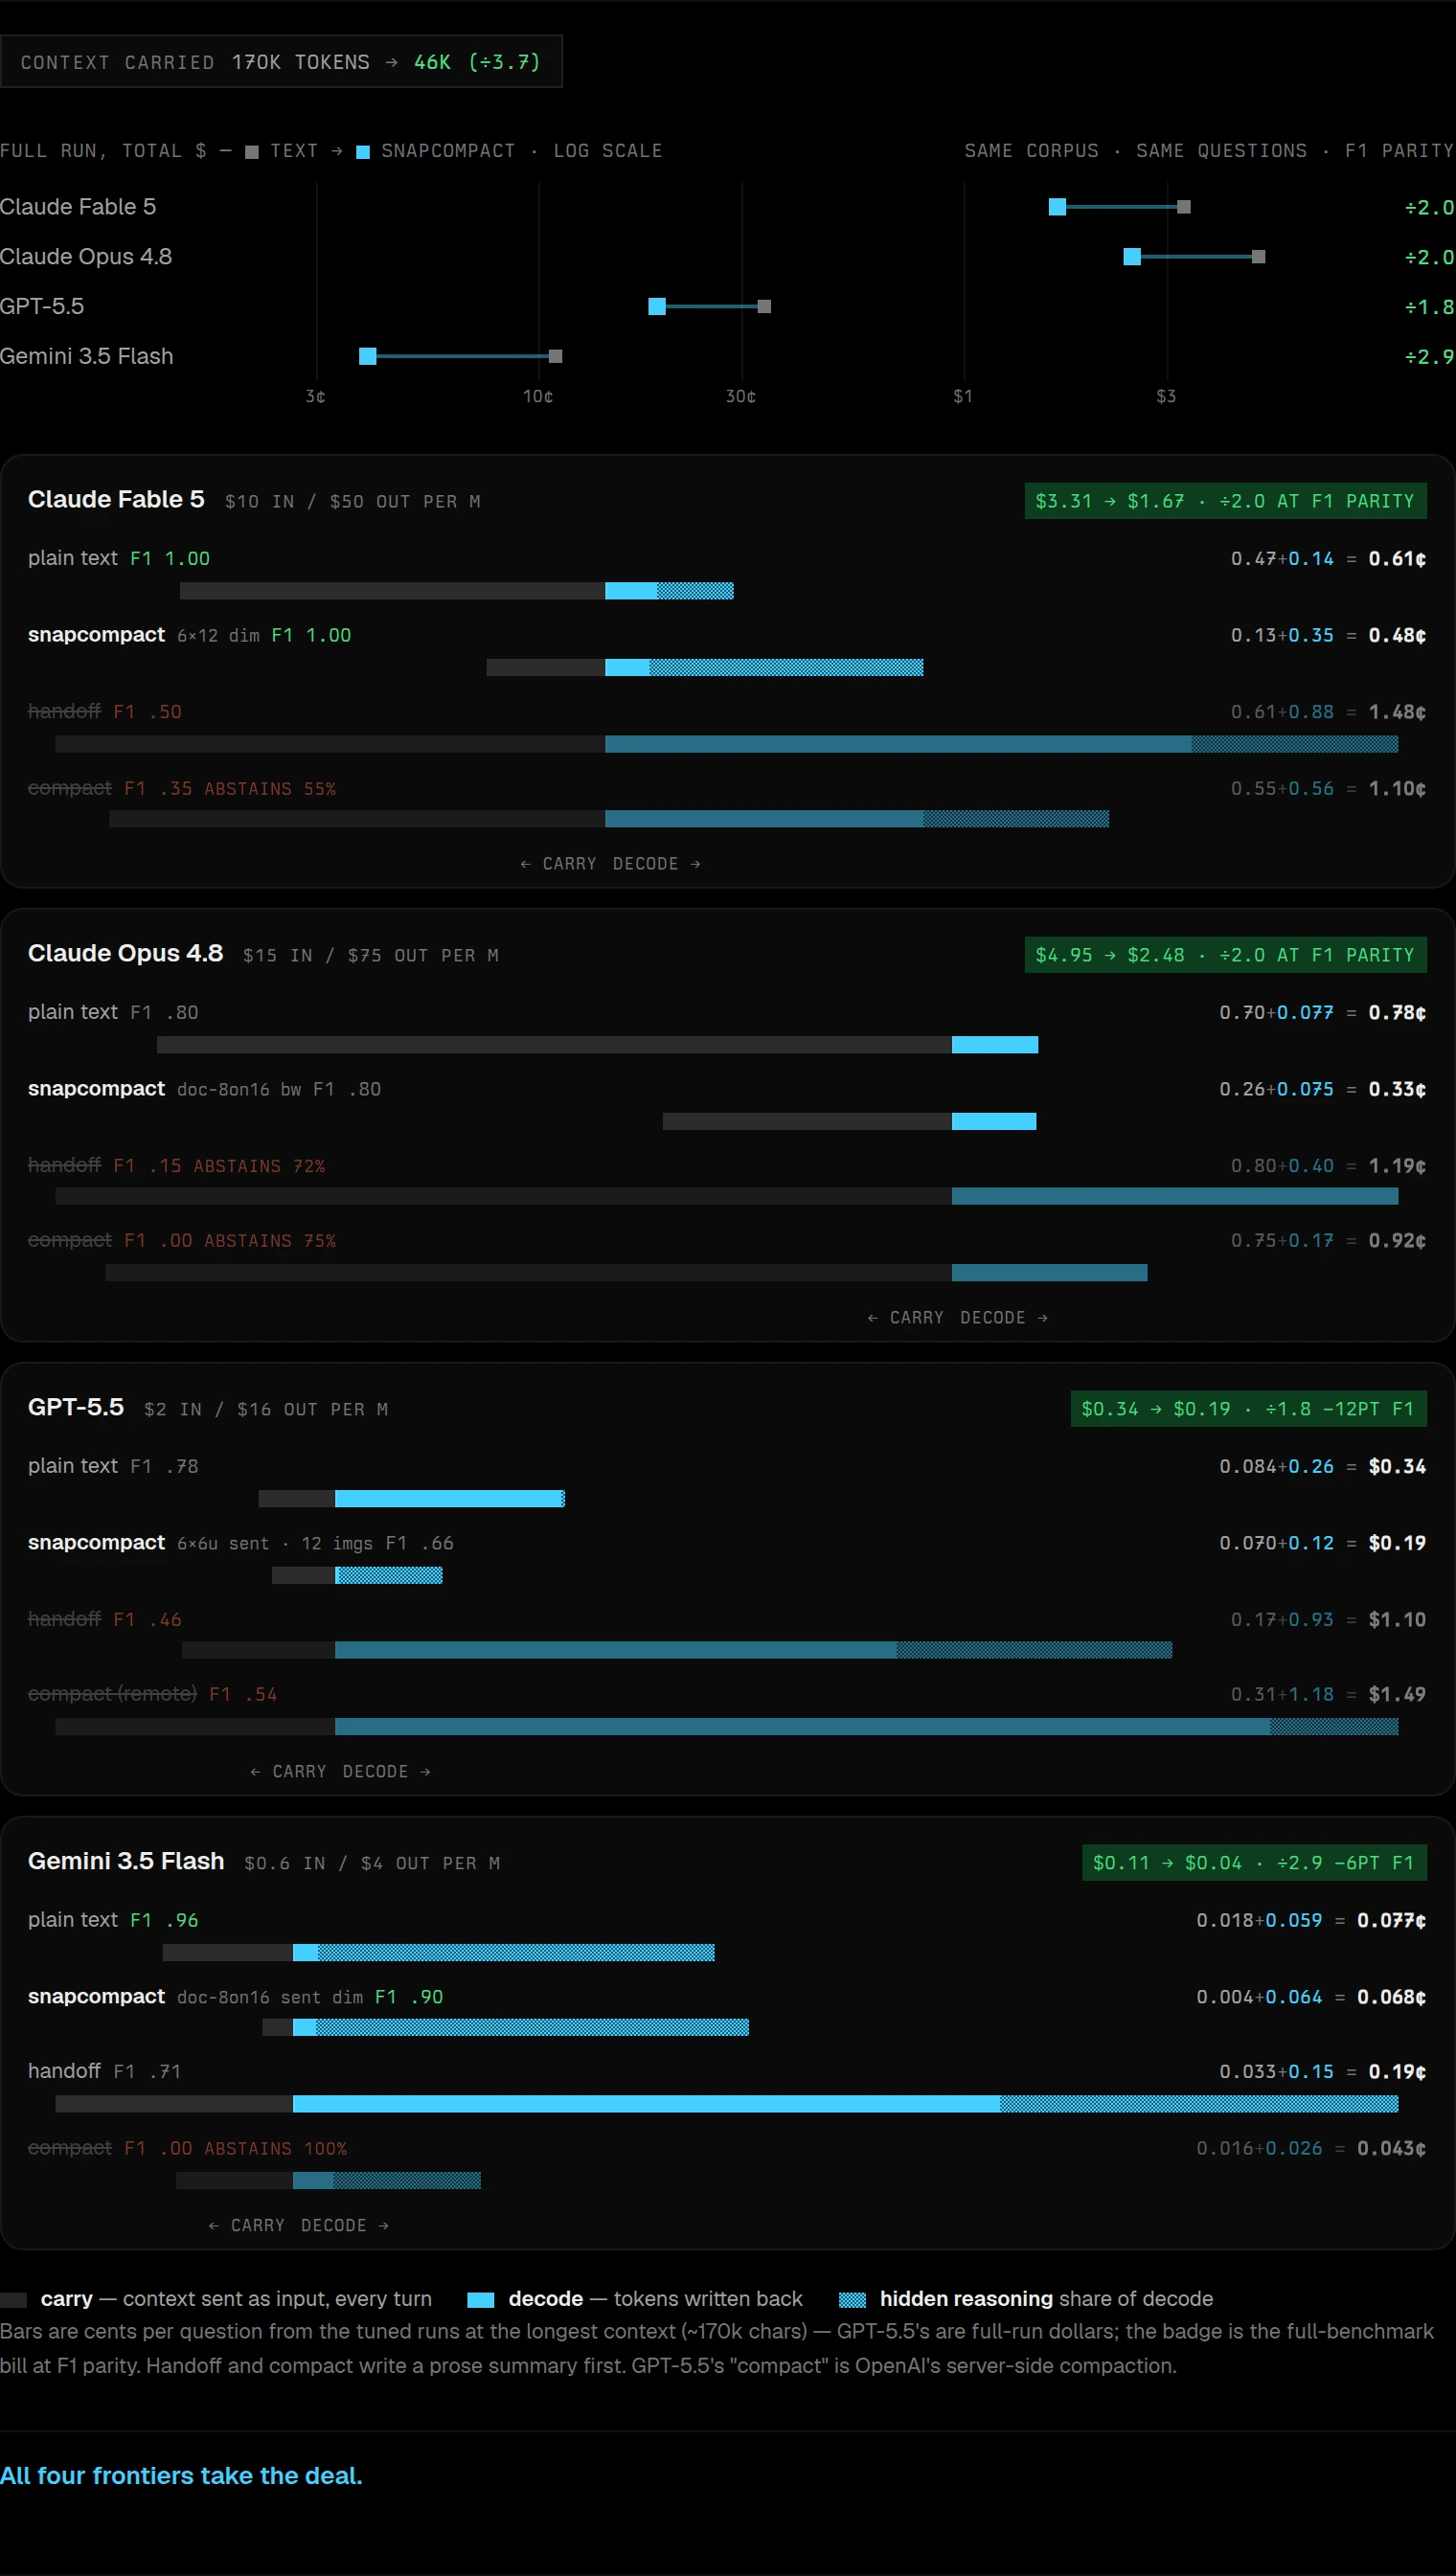
렌더러를 튜닝할 때 사용한 네 가지 프론티어 모델은 서로 혼합하지 않음 · GPT-5.5의 청구는 밀도와 무관하게 이미지당 ~2,900 토큰으로 고정되므로, 가장 고밀도로 읽을 수 있는 폰트가 유리합니다 — 그리고 그것의 원격 압축인, 어디서든 최고의 요약 방식은 10분의 1 크기 코퍼스에서 .90이던 것이 여기서는 .54로 떨어집니다
처음에는 농담("공짜 토큰 버그 ㅋㅋ")에서 시작했습니다. 그런데 벤치마크를 돌리고, 문제를 찾아내고, Qwen의 어텐션 레이어를 열어 분석하고, 수정한 뒤 다시 벤치마크를 돌렸더니 — 프론티어 모델에도 놀라울 만큼 잘 일반화됐습니다. 그래서 이 글을 쓰게 됐습니다.
압축에 반대하는 이유
저희는 압축을 그다지 좋아하지 않았습니다. 저희가 기여하는 오픈소스 하네스를 포함해, 모든 하네스에서 압축은 모델을 "불구로 만들어" 새 세션을 시작하는 편이 나을 정도였습니다.
툴 결과를 생략하는 방식은 그럭저럭 괜찮은 대안입니다 — 즉각적이고 결정적이긴 하지만, 때로는 충분하지 않습니다. 게다가 모델이 툴 호출 방식을 혼동하는 경우도 있습니다. LLM은 이야기를 완성하는 존재입니다. 이야기의 절반이 [elided...]이라면, 툴을 얼마나 자신 있게 사용할 수 있을까요?
핸드오프는 현재로서 최선의 방법입니다 — 하지만 계획과 달리, 핸드오프는 보통 직접 조율하지 않습니다. 그렇게 두면 에이전트는 소중한 컨텍스트를 낭비하면서 불필요하게 상세한 일지를 쓰고, 그 뒤에 TODO 목록을 덧붙입니다. 그 목록은 사실상 다음 에이전트에게 목표가 불가능하다고 선언하고 "MVP"나 내놓으라고 애원하는 꼴입니다.
오랫동안 저희의 입장은 이랬습니다. 압축이 자주 필요하다면 뭔가 잘못하고 있는 것이다 — 계획에 스코프 크리프(scope creep)가 생겼거나, 아니면 서브에이전트로 명시적으로 오케스트레이션해서 메인 에이전트가 전체 범위를 계속 담당할 수 있게 했어야 한다는 것이었습니다.
하지만 100만 토큰 컨텍스트 윈도우에 익숙해지다 보니, 요즘 세션은 일상적으로 50만 토큰을 넘깁니다 — 그 논리대로라면 치명적인 실수지요. 장기 과제는 하나의 일관된 에이전트가 계획을 끊김 없이 주도할 때 훨씬 잘 돌아가는데, 적극적으로 위임하더라도 그 수준에 쉽게 도달합니다.
그렇다면 압축은 계속 써야 합니다. 하지만 어차피 압축을 해야 한다면, 아무것도 잃지 않는 방식으로 해야 합니다.
어리석은 실험
시작은 328KB짜리 세션 로그와 단순한 의문이었습니다. 이걸 그냥 출력해서 세션 시작에 넣으면 어떨까?
첫 번째 시도는 최대한 욕심을 부렸습니다. Tom Thumb, 3×5 픽셀 폰트로 이미지 하나에 122,696자를 담았습니다.
아무 설명 없이 새 에이전트 세션에 보냈더니 다음과 같은 답변이 돌아왔습니다:
이 이미지는 무작위 픽셀로 가득 찬 순수 노이즈처럼 보입니다. 파일이 손상됐거나 PNG로 잘못 이름이 붙은 파일일 수 있습니다.
납득할 만한 반응이었습니다. 두 번째 시도에서는 X11 6x10 폰트(해당 셀 크기에 맞게 실제로 설계된 글리프)로 40,716자를 담고, 각 텍스트 행을 여섯 가지 색상으로 순환시켰습니다. 같은 모델에서 이런 결과가 나왔습니다:
- 세션의 주제를 파악하고 로그를 그대로 인용했습니다.
- 로그에서 18개의 식별자를 100% 재현율로 열거했습니다.
- 로그가 잘리는 이미지 최하단 행의 단일 할당에 대해 물었을 때는 "추측이지만 — 아마
0일 것 같습니다"라고 조심스럽게 답했는데, 상태를 정확하게 맞혔습니다.
10,000 토큰 분량의 텍스트를, 3,279개의 이미지 토큰으로 전달하면서 거의 완벽한 정확도로 재현했습니다. 좋습니다. 이제 진지하게 파고들 때가 됐습니다.
폰트 최적화
폰트를 얼마나 작게 만들 수 있을까요? 여러 폰트 설정을 실험하면서 모델에게 고정 영역을 전사하도록 요청하고, 정답과의 편집 유사도를 채점했습니다:
| 폰트 | px²/글자 | 글자/이미지 | 전사 | 식별자 인식 |
|---|---|---|---|---|
| 8×13 | 104 | 23,520 | 1.00 | 20/20 |
| 6×10 | 60 | 40,716 | 0.79 | 20/20 |
| 5×8 | 40 | 61,348 | 0.37 | 17/19 |
| 5×7 | 35 | 70,112 | 0.30 | 10/20 |
| 4×6 | 24 | 102,312 | 0.02 | 9/20 |
절벽은 급격하고, 글자당 35~40 px² 부근에 위치합니다. 그 이상에서는 정확한 전사 품질이 떨어지지만 식별자 수준의 재현율은 놀랍도록 강하게 유지됩니다 — 모든 바이트를 재현하지는 못해도, 이름은 읽어냅니다. 그 이하에서는 아무것도 안 됩니다.
재미있는 점은, 이 부분은 쓸모없는 것보다 더 나빴습니다 — 이 최적화가 잠시 후 발목을 잡게 됩니다.
생각해보면…
단일 세션 로그에 대한 일화는 일반화할 수 없으므로, 제대로 된 벤치마크를 만들었습니다. SQuAD v1.1, 정답이 명확한 추출형 질문입니다. 하네스는 각 기법의 수용 용량에 맞게 지문을 청크로 나누고, 청크당 30개의 질문을 균등하게 샘플링해(답이 이미지 행 전체에 고르게 분포하도록), 동일한 코퍼스에 모든 기법을 적용합니다:
- text — 코퍼스를 그대로 전달하는 방식, 즉 상한선입니다.
- handoff — 단순한 핸드오프 프롬프트입니다.
- compact — 가능한 경우 공급자 측 압축을, 그렇지 않으면 요약 호출을 사용합니다.
- img-{font}-{variant} — snapcompact로, 변형은 bw(흰 배경에 검은 글씨) 또는 sent(문장마다 글리프 색상이 순환)입니다.
점수는 SQuAD F1이며, 사실을 추출할 수 없을 때는 UNREADABLE로 답하도록 모델에게 지시했습니다.
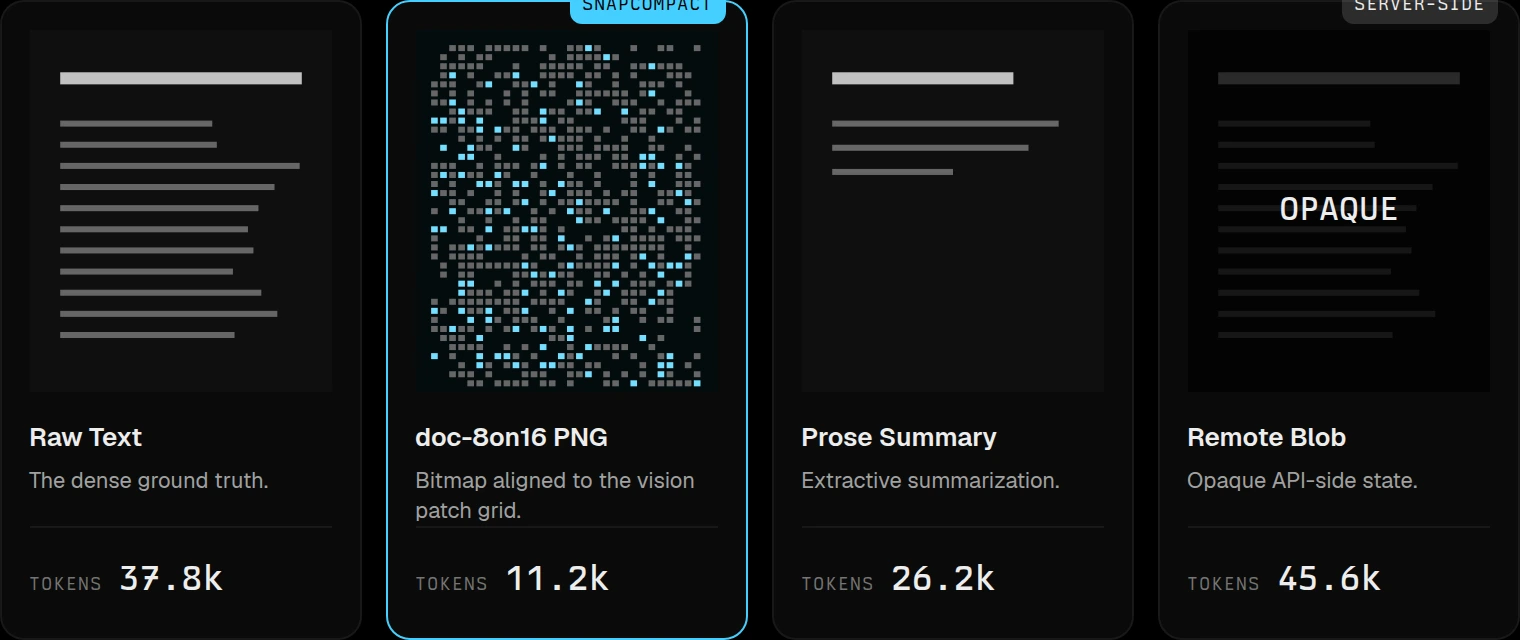
150,000자 컨텍스트를 전달하는 네 가지 방식과 각각의 입력 토큰 청구량 · 텍스트를 doc-8on16 PNG로 렌더링하는 방식 — 비전 패치 그리드에 맞춰 정렬된 8×16 셀의 문서 레이아웃 — 이 5/6 모델에서 새로운 기록을 세웠습니다
| 기법 | fable-5 | opus-4.8 | gpt-5.5 | gemini-3.5-flash |
|---|---|---|---|---|
| text (상한선) | 0.904$0.4984 | 0.911$0.6367 | 0.861$0.0847 | 0.898$0.0577 |
| handoff | 0.540$1.2241 | 0.248$1.0065 | 0.368$0.2386 | 0.889$0.1759 |
| compact | 0.406$0.9427 | 0.000$0.7576 | 0.896$0.3393 | 0.000$0.0420 |
| img-6×10-sent | 0.882$0.6400 | 0.601$0.2430 | 0.822$0.2452 | 0.805$0.0970 |
| img-6×10-bw | 0.856$0.7568 | 0.652$0.2369 | 0.792$0.3026 | 0.767$0.1135 |
| img-5×8-sent | 0.773$0.4532 | 0.409$0.1626 | 0.751$0.1819 | 0.738$0.1006 |
| img-5×8-bw | 0.830$0.6866 | 0.425$0.1619 | 0.778$0.2359 | 0.674$0.0941 |
첫 시도치고 나쁘지 않은데… 잠깐, 토큰 절약이 목표였는데, 왜 이게 더 비싸지? 다른 표를 봐봅시다.
토큰: 입력/출력/추론
| 기법 | fable-5 | opus-4.8 | gpt-5.5 | gemini-3.5-flash |
|---|---|---|---|---|
| text (상한선) | 37,793 / 2,410 / 1,435 | 37,793 / 931 / 0 | 17,761 / 2,998 / 2,298 | 24,535 / 10,745 / 9,983 |
| handoff | 49,363 / 14,609 / 3,717 | 43,237 / 4,773 / 0 | 25,032 / 11,710 / 4,835 | 49,387 / 36,577 / 11,959 |
| compact | 45,130 / 9,828 / 3,248 | 40,436 / 2,014 / 0 | 45,562 / 15,329 / 1,032 | 26,151 / 6,582 / 5,422 |
| img-6×10-sent | 11,816 / 10,437 / 9,483 | 11,816 / 877 / 0 | 10,188 / 14,049 / 13,368 | 4,991 / 23,491 / 22,764 |
| img-6×10-bw | 11,816 / 12,772 / 11,782 | 11,816 / 796 / 0 | 10,188 / 17,639 / 16,958 | 4,991 / 27,616 / 26,879 |
| img-5×8-sent | 7,955 / 7,474 / 6,897 | 7,955 / 577 / 0 | 4,519 / 10,773 / 10,336 | 3,355 / 24,659 / 24,196 |
| img-5×8-bw | 7,955 / 12,141 / 11,559 | 7,955 / 568 / 0 | 6,823 / 13,892 / 13,463 | 3,355 / 23,014 / 22,542 |
몇 가지 결론:
- 실제로 동작합니다. fable에서는 테스트한 모든 코퍼스 길이에 걸쳐 0.86~0.96 F1을 기록했으며, 동일한 정보를 입력 비용의 3분의 1로 전달했습니다. 놀랍습니다.
- 입력 비용 절감이 공짜는 아닙니다. 모델은 고밀도 이미지를 추론으로 디코딩하는데, 그 추론 비용이 이 예시에서 텍스트 조건의 출력 토큰보다 약 5배 더 듭니다.
Anthropic의 출력 가격 기준으로는, 디코딩 비용이 한 번의 패스에서 입력 절감분을 모두 잡아먹을 수 있습니다. 40,000 토큰 수준에서는 사소한 문제입니다 — (a) 그 범위에서 압축을 쓰는 사람은 없고, (b) 디코딩은 매 턴이 아니라 한 번만 발생합니다 — 그래도 최적은 아닙니다.
베이스라인은 대부분 이 방법이 왜 시도해볼 만한지를 확인해줍니다. 산문 압축은 사실을 갈아버립니다. 압축된 컨텍스트에서 Gemini는 240번 중 240번 UNREADABLE을 답했고, Opus는 209번 — 요약은 무엇을 하고 있었는지는 보존하지만, 무엇을 알고 있었는지는 보존하지 못합니다. 두 가지 예외가 있습니다. OpenAI의 불투명한 서버 측 압축은 거의 모든 것을 유지합니다(하지만 그냥 건너뛰는 것일 수도 있습니다. 누가 알겠어요?). 그리고 Gemini의 핸드오프 문서는 프롬프트의 의도를 무시하고 사소한 정보까지 꼼꼼히 적어냅니다. ㅋㅋ
어쨌든 — 이 기법이 동작하는지 여부는 각 모델의 비전 스택에 따라 실증적으로 달라지므로, 직접 테스트해봐야 합니다. 그러니 이제 비전 스택이 실제로 어떻게 동작하는지 파악해야 할 때가 됐습니다.
두 가지 전달 방식, 하나의 상태
snapcompact를 단순한 트릭이 아닌 메모리 포맷으로 만드는 더 강력한 주장은, 모델이 어느 전달 방식을 사용하든 동일하게 생각한다는 것입니다. 이미지를 읽는다는 것은 알고 있습니다. 문제는 내부 처리 결과가 텍스트와 같은 형태인지 여부입니다.
로컬 Qwen2.5-VL-7B-Instruct를 사용한 설정입니다. SQuAD 청크 하나와 그에 대한 열두 개의 질문을 준비합니다. 각 질문을 두 번 실행합니다. 한 번은 청크를 프롬프트에 일반 텍스트로, 한 번은 1568² 비트맵 이미지로 넣고 — 모든 디코더 레이어에서 마지막 프롬프트 토큰의 은닉 상태, 즉 모델의 "답변 직전" 요약을 캡처합니다.
원시 상태는 단순한 이유로 유사해 보입니다(같은 템플릿, 같은 모델). 그래서 비교할 때는 각 전달 방식의 레이어별 평균을 빼냅니다 — 센터링 후에 남는 것은 전달 방식이 아닌 콘텐츠입니다. 세 가지를 측정했습니다:
- 매칭된 쌍(같은 질문, 텍스트 ↔ 이미지): 레이어 19에서 코사인 유사도 0.66. 불일치 쌍(다른 질문): −0.06. 상태는 어떤 입력 형식인지가 아니라 어떤 콘텐츠에 대한 어떤 질문인지를 인코딩합니다.
- 교차 전달 방식 검색: 각 텍스트 실행에 대해 가장 가까운 이미지 실행을 찾습니다. 레이어 2부터는 12번 중 12번 모두 같은 질문입니다.
- 표현 기하학: 텍스트 전달 방식 내에서 계산된 12×12 질문 유사도 행렬은 레이어 1에서 이미지 전달 방식의 것과 r = 0.94로 상관됩니다. 이 값은 최종 레이어에서 0.85로 안정됩니다. 두 전달 방식은 거의 즉시 같은 관계 구조를 만들어냅니다. 레이어가 깊어질수록 발전하는 것은 질문별 상태 융합입니다.
동작 측면에서 두 전달 방식은 같은 답변을 생성합니다. 이것이 바로 비용 계산이 이익을 얻는 속성입니다. PNG는 컨텍스트의 그림이 아닙니다 — 컨텍스트 그 자체로 수렴합니다.
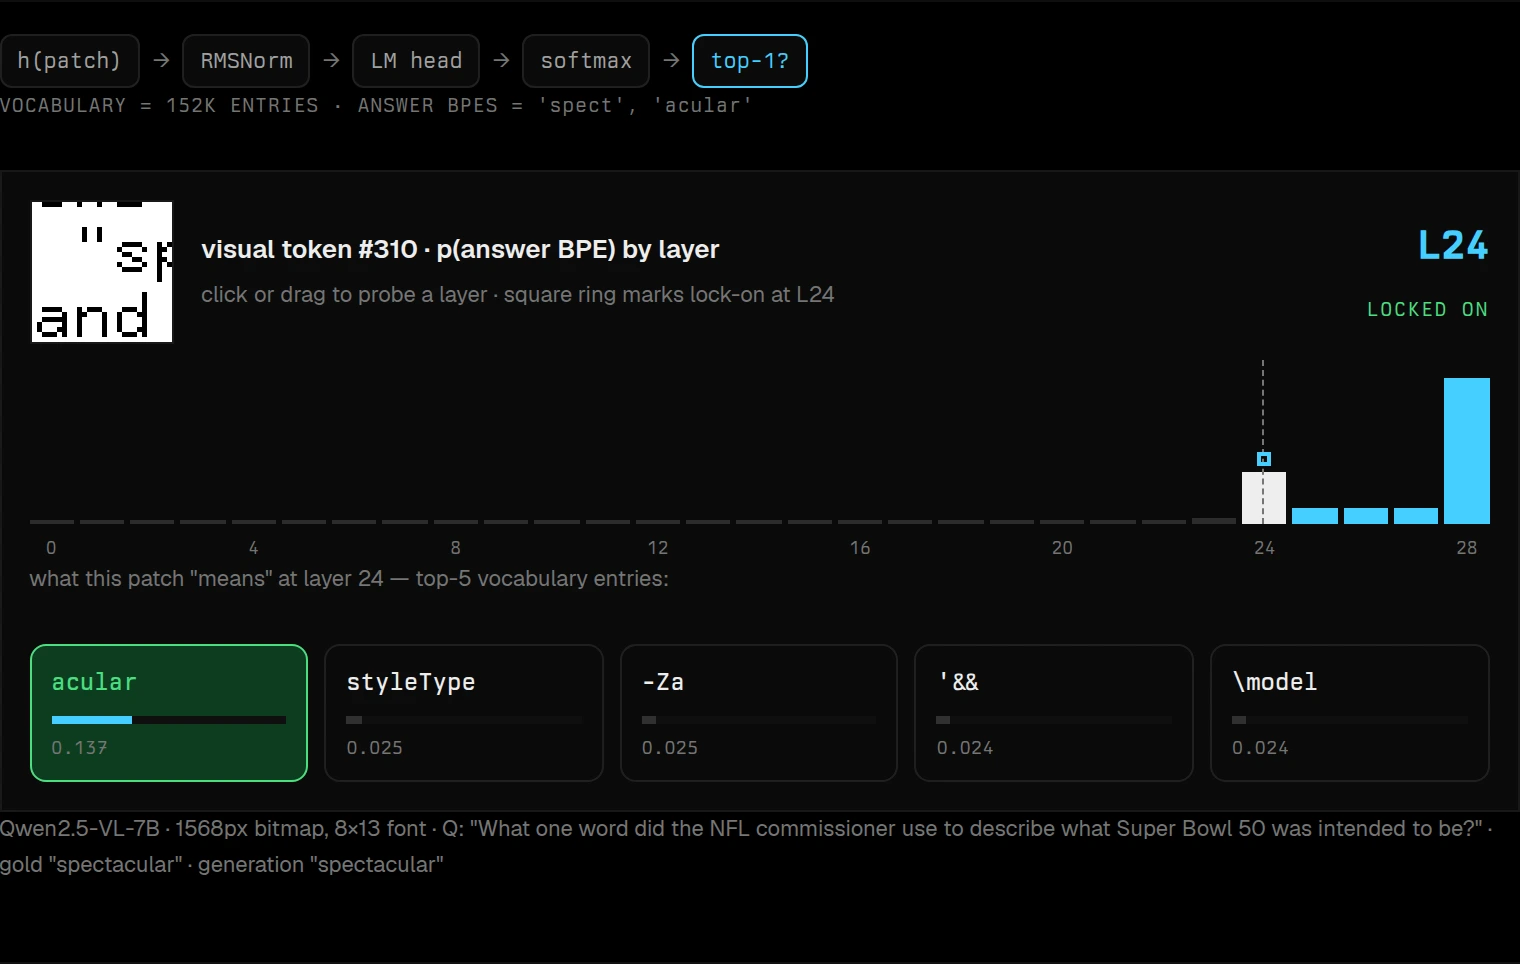
픽셀이 모델 내부에서 텍스트가 된다면, 어디서 그런지 물어볼 수 있습니다. 도구는 로짓 렌즈(logit lens)입니다. 모든 레이어에서 답변 단어를 포함하는 시각 토큰의 은닉 상태를 가져와 최종 RMSNorm과 LM 헤드를 통과시키고, 상위-1 어휘 항목을 확인합니다. 록온(lock-on)은 상위-1이 답변의 BPE 조각인 첫 번째 레이어입니다.
 인터랙티브
답변이 어디서 구체화되는지 측정하는 방법 · 록온 이전 레이어는 픽셀 디코딩에 쓰이고, 이후 레이어는 추론에 자유롭게 활용됩니다
기준이 되는 8×13 렌더링에서, "spectacular"의 끝부분을 포함하는 패치는 열일곱 개 레이어 동안 CJK 노이즈로 디코딩됩니다. L18 부근에서 글자 모양의 노이즈를 거치고(ALLERY, IGHL — 획이 모여 철자를 이루는 과정), L24에서 acular으로 전환되며 마지막 레이어에서 p=0.39까지 올라갑니다.
이 점이 중요한 이유는, 록온 이전 레이어는 픽셀을 단어로 바꾸는 데 쓰이고, 이후 레이어는 그 단어로 추론할 수 있기 때문입니다. 그래서 단순하게 생각하기로 했습니다. 어텐션은 증거를 누적하죠? 그렇다면 행을 반복하면 읽기가 더 강해지지 않을까요?
비전 토큰이 어떻게 동작하는지 알고 나면 또 하나 명확해지는 것이 있습니다. Qwen은 이미지를 28×28 픽셀 윈도우로 잘라 각각 시각 토큰 하나를 배정합니다. 그렇다면 이 글 초반에 아무 생각 없이 선택한 폰트 크기가 통하지 않는다는 것도 자명합니다. 6×10에서는 토큰 윈도우 하나에 세 텍스트 행에 걸쳐 번진 ~13개 글리프의 파편들이 담깁니다.
토큰 윈도우 안의 겹치는 잡음이 줄어들수록 추론이 덜 필요합니다. 단순하죠.
 인터랙티브
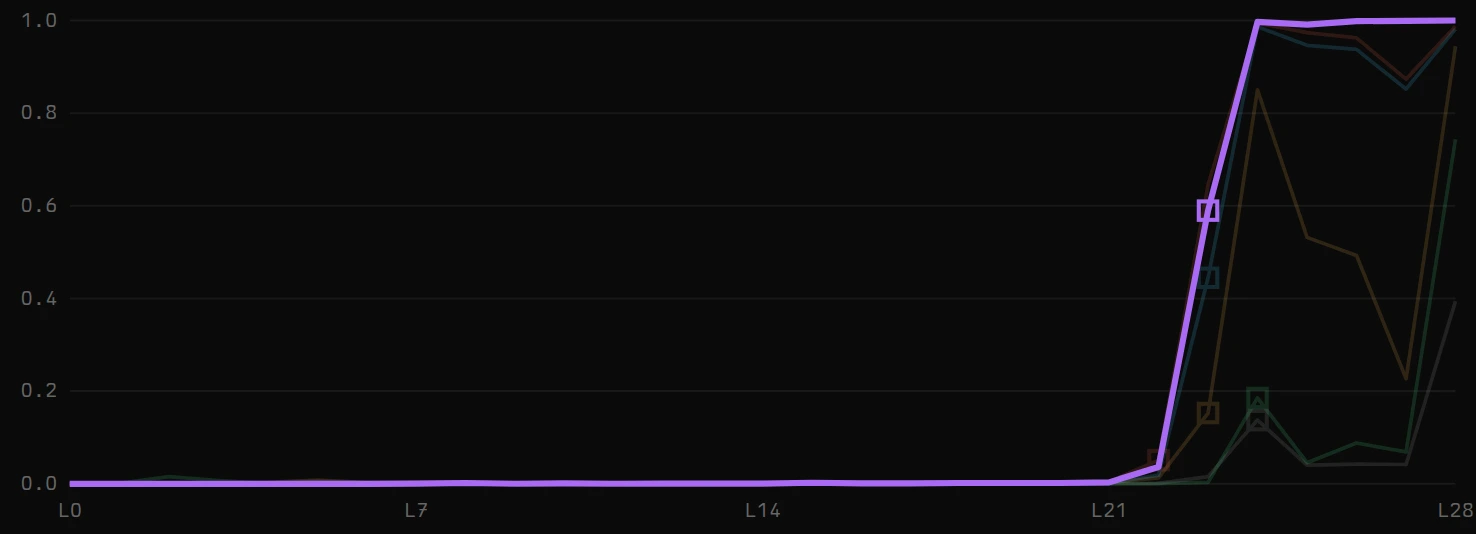
같은 지문, 같은 질문에 대한 여섯 가지 렌더링 · 록온 레이어는 거의 움직이지 않지만, 정렬과 반복이 디코딩된 답변의 확률을 0.39에서 1.00으로 끌어올립니다 · 조건을 클릭하면 모델이 정확히 무엇을 보았는지 확인할 수 있습니다
| 조건 | 록온 | 최대 p(정답) | 시각 토큰당 글자 수 |
|---|---|---|---|
| base 8×13 | L24 | 0.39 | 7.5 |
| repeat lines ×2, colored | L23 | 0.94 | 3.75 |
| aligned, 4×2 chars/token | L24 | 0.74 | 8.0 |
| aligned, 2×1 chars/token | L23 | 0.99 | 2.0 |
| aligned, 1 char/token | L22 | 0.99 | 1.0 |
| aligned + repeated | L23 | 1.00 | 1.0 |
깊이는 (크게) 움직이지 않았습니다. 최선의 경우 L24에서 L22였습니다. 이는 비전이 텍스트가 되는 위치가 구조적 속성이라는 OCR 라우팅 관련 문헌과 일치합니다. 하지만 확신도는 완전히 제어 가능합니다. 행 반복만으로 시각 토큰당 3.75자를 유지하면서 디코드 확률을 0.39에서 0.94로 높였습니다. 포맷이 모델을 더 빨리 읽게 만들 수는 없지만, 읽기를 모호하지 않게 만들 수는 있습니다. 그럭 모델은 많이 생각 안 합니다.
이 시점에서 문헌 검토를 해보니 사실 완전히 새로운 아이디어는 아니었습니다. DeepSeek-OCR은 광학 컨텍스트 압축을 위한 커스텀 인코더를 학습시켰고, Karpathy도 잡담으로 픽셀이 입력 매체로서 토큰보다 나을 수도 있다고 언급한 바 있습니다.
하지만 에이전트 하네스 맥락에서는, 낭비되는 추론 비용을 확인하고 그냥 넘어간 것 같습니다. 그런데 보세요? Qwen을 위해 만든 그럭-브레인 최적화가 프론티어 모델에도 놀라울 만큼 잘 일반화됩니다!
- 신중하게 조정된 고밀도 텍스트 비트맵은 컨텍스트 전달 방식으로서 매우 잘 작동합니다. 가독성 하한의 합성 픽셀 폰트 렌더링을 — 청구 공식, 자동 다운스케일, 적응형 추론 비용까지 포함해 — 실제 에이전트가 사용하는 압축 전략과 비교 벤치마크했습니다. PNG 팀 화이팅!
- 7B 오픈 모델에서 록온을 확실한 확신도로 끌어올릴 수 있습니다. 이렇게 작은 변화로 p=0.39에서 p=1.00까지 올라간 것은 의미 있습니다. 물론 반복은 픽셀 영역을 두 배로 만듭니다 — 고작 ~3배가 아닌 훨씬 더 큰 절감이 가능했을 텐데 — 그래도 텍스트보다 저렴하고, 이제 거의 완벽한 재현율을 갖췄습니다. 툴 결과를 PNG로 돌려줘도 될 만큼요.
하네스가 또 이깁니다. 모델에서 달라진 것은 아무것도 없습니다. 우리가 모델을 둘러싼 컨텍스트를 바꿨습니다.
평가 하네스, 폰트 렌더러, 질문별 기록, 화이트박스 프로브: omp — uv run final.py로 API 그리드를 재현할 수 있습니다(최초 실행 시 약 $35, 이후 캐시 사용 시 무료). 표현 실험에는 Qwen2.5-VL-7B가 탑재된 로컬 GPU가 필요합니다.


