Anthropic연구Economics
Project Swap: 에이전트가 우리 대신 거래한다면?
에이전트를 시장에 투입했을 때 무엇이 통하고 무엇이 문제가 되는지 확인하기 위해, Claude들로만 이루어진 소규모 모의 시장을 구축해 실험했다.
요약
- 에이전트를 시장에 투입했을 때 무엇이 통하고 무엇이 문제가 되는지 확인하기 위해, Claude들로만 이루어진 소규모 모의 시장을 구축해 실험했다. 이는 사람들을 대신해 에이전트가 마켓플레이스에서 상호작용하는 첫 번째 실험이었던 Project Deal의 후속작으로, 보다 통제된 환경에서 진행되었다. Anthropic 직원들은 전 세계 6개 오피스에서 각자 나눠주고 싶은 책을 한 권씩 가져왔다. 참가자들은 Claude와 짧은 대화를 나누며 자신의 독서 취향을 공유한 뒤, Claude 기반 에이전트를 열린 거래 공간에 보내 다른 사람들의 에이전트와 책을 제안하고, 흥정하고, 거래를 성사시키도록 했다. 목표는 모든 참가자가 여름에 즐겁게 읽을 수 있는 책을 한 권씩 가져가는 것이었다.
- 에이전트가 참가자를 얼마나 잘 대표하는지 평가하기 위해, 참가자들에게 관심사를 바탕으로 책 10권의 순위를 매기도록 했다. 5분간의 대화만으로 에이전트가 매긴 책 순위는 참가자 본인의 순위와 61%의 쌍에서 일치했는데, 이는 짧은 대화를 감안하면 놀라울 정도로 높은 수치다.
- 거래 공간에서 에이전트들은 전반적으로 잘 거래했다. 시장이 기대에 미치지 못한 주된 이유는 에이전트들의 거래 방식보다, 에이전트가 참가자에 대해 갖고 있던 정보의 한계에 있었다.
- 이후 거래 공간을 수십 차례 재실행하면서 사용 모델과 에이전트 지시사항을 하나씩 바꿔가며 실험했다. 그 결과, 협상 결과에는 에이전트에 부여한 지시사항보다 에이전트가 구동되는 모델이 더 큰 영향을 미쳤다. 더 강력한 모델로 구성된 시장일수록 효율성이 높았다.
- 책을 받아 읽은 참가자 대부분은 책이 마음에 든다고 했으며, 평균적으로 연간 도서 구입 예산의 약 3분의 1을 Claude에게 맡길 의향이 있다고 답했다.
왜 이 실험을 했는가
세상에는 서로에게 이득이 될 거래가 많지만, 실제로 성사되지 않는 경우가 허다하다. 대부분의 경우, 이유는 단순하다. 적합한 상대를 찾고 협상을 끝까지 이어가기에는 품이 너무 많이 들기 때문이다. 예를 들어, 첫 번째로 받아본 견적이 감당하기 어렵다는 이유만으로 치료를 포기하는 환자를 생각해보자. 훨씬 저렴한 다른 클리닉이 있을 수도 있고, 처음 견적을 낸 병원도 요청했다면 비용을 깎아줬을 수 있다. 직장도 마찬가지다. 어딘가에는 나에게 더 잘 맞는 일자리가 있고, 나를 기꺼이 채용할 고용주도 있을 것이다. 하지만 서로를 찾지 못한다. 쉼 없이 탐색할 시간이 양쪽 모두에게 없기 때문이다. 직장에서의 교대 근무 교환, 카풀 조율, 아이 하교 분담처럼 소소하고 일상적인 거래도 그냥 넘어가기 일쑤다.
만약 내 에이전트가 24시간 잠재적 상대방과 대화하며 가능한 조건을 조율해준다면, 이런 거래들이 미래에는 실제로 이루어질 수 있을까?
가능할 수도 있다. 하지만 이런 미래가 현실이 되려면 아직 답이 없는 질문들이 많다. 에이전트가 나를 대신해 행동한다면, 에이전트가 나를 제대로 이해했는지 어떻게 확인할 수 있을까? 또한 여러 에이전트가 서로 만나 대화를 나눌 때, 어떤 마켓플레이스나 플랫폼이 참여 규칙을 정해야 한다. 누가 참여할 수 있는가? 거래가 무산되면 어떻게 되는가?
에이전트가 실제 시장에 점점 더 많이 투입되면서, 이런 질문들은 더욱 시급해지고 있다. 그래서 이번 여름, 우리는 이 질문들을 연구하기 위해 소규모의 통제된 시장을 만들었다. 201명의 Anthropic 직원과 그들의 Claude 기반 에이전트로 구성된 물물교환 경제였다. 모든 참가자는 나눠주고 싶은 책을 한 권씩 가져왔다. 그런 다음 Claude 기반 에이전트와 이번 여름에 어떤 책을 읽고 싶은지 대화를 나눴다. 에이전트들은 디지털 "거래 공간"에서 만나 시간이 다 될 때까지 책을 교환했다. 마지막에 모든 참가자는 에이전트가 구해준 책을 가져갔다(대부분은 그랬다…예외에 대해서는 나중에 이야기하겠다).
이 실험은 앞으로 맞닥뜨릴 문제들을 미리 엿볼 수 있게 해줬다. 시장을 위한 에이전트를 설계하는 사람이라면 에이전트가 참가자를 제대로 이해했는지 확인할 방법이 필요할 것이다. 에이전트를 위한 시장을 설계하는 사람이라면 어떤 에이전트가 참여할 수 있는지, 거래가 무산됐을 때는 어떻게 처리할지, 시장 활동을 참가자에게 얼마나 공개할지에 대한 명확한 규칙이 필요할 것이다.
시장을 어떻게 만드는가
시장을 운영하는 방식에는 크게 두 가지가 있다. 중앙화 시장에서는 모든 참가자가 단일 주체에게 원하는 것을 알려주고, 그 주체가 거래를 조율한다. 탈중앙화 시장에서는 참가자들이 직접 상대를 찾아 협상한다. AI 에이전트는 두 유형 모두에서 유용하게 활용될 수 있다.
중앙화 시장을 예로 들어보자. 단일 주체가 모든 사람이 원하는 것을 정확히 파악한다면, 최적의 거래를 도출하는 것은 그저 계산의 문제다. 경제학자들은 이를 오래전부터 이해해왔다. 문제는 현실에서 자신이 원하는 것을 정확하게 서술하는 작업이 너무 번거롭다는 점이다. 예를 들어, 카페 매니저가 20명 직원의 최적 스케줄을 짜려면, 각 직원이 모든 근무 시간의 상대적 가치를 일일이 수치화해야 한다. 토요일 오전 두 번이 금요일 마감 한 번보다 나은지, 다음 날 오픈만 없다면 늦은 마감도 괜찮은지, 등등. AI 에이전트가 가벼운 대화만으로 사람이 원하는 것을 파악할 수 있다면, 중앙에서 운영하기에 비용이 너무 많이 들었던 시장도 현실적으로 운영 가능해질 수 있다.1
그러나 중앙화 시장에는 이를 운영할 주체, 즉 경제학 용어로 "청산소(clearinghouse)"가 필요하다. 참가자들은 이 주체를 신뢰하고 정보를 제공해야 하며, 선택된 결과를 집행할 권한도 맡겨야 한다. 하지만 그런 주체가 존재하지 않는 경우도 많고, 모든 정보를 털어놓고 싶지 않을 때도 있다. 구직자는 자신이 이직을 준비 중이라는 사실을 중앙 매개자에게 알리고 싶지 않을 수 있다. 원하는 조건도 마찬가지다. 그보다는 몇몇 기업에 조용히 접근해, 각 기업에 필요한 정보만 선별적으로 제공하는 편을 선호할 것이다. 이런 상황에서는 시장이 탈중앙화되어야 한다.
이 경우 AI 에이전트는 상대방을 찾고 협상하는 데 드는 노력을 줄여줌으로써 새로운 탈중앙화 마켓플레이스를 가능하게 할 수 있다. 이런 종류의 도움이 얼마나 가치 있는지는 이미 알 수 있다. 사람들이 돈을 내고 고용하는 인간 에이전트가 바로 이 역할을 한다. 부동산 중개인, 헤드헌터, 심지어 결혼 중매인까지. 하지만 탐색과 협상에는 사람의 귀한 시간이 많이 소요되기 때문에, 이런 서비스는 비쌀 수밖에 없고 여유 있는 사람들만 이용할 수 있다. 반면 AI 에이전트의 주의력은 훨씬 희소하지 않다. 협상 능력까지 갖춘다면, 지금까지 집을 파는 사람이나 임원들만 누려온 것, 즉 지치지 않고 나를 위해 일하는 에이전트를 더 많은 사람이 가질 수 있게 된다.
실험 방법
201명의 참가자는 샌프란시스코, 뉴욕, 런던, 시애틀, 워싱턴 D.C., 더블린 등 6개 오피스 풀로 나뉘었다. 각 풀의 규모는 3명(더블린)에서 115명(샌프란시스코)까지 다양했다. 제임스 조이스에게는 미안하지만, 더블린 참가자들은 대부분의 분석에서 제외했다.2
이번 실험은 Claude 기반 시장을 다룬 우리의 두 번째 연구다. Project Deal에서는 에이전트가 Anthropic 직원들을 위해 일주일간 비공개 마켓플레이스에서 실물을 사고팔았다. 그러나 탁구공이나 스노보드처럼 특수한 물건들을 대상으로 자유로운 흥정이 이루어지다 보니, 결과가 얼마나 좋을 수 있었는지를 간단히 평가할 방법이 없었다. 그래서 이번에는 연구하고 평가하기 훨씬 쉬운 시장을 구축했다. 이 시장에서는 참가자의 선호가 풀 안의 모든 책에 대한 순위로 깔끔하게 표현된다. 덕분에 시장이 이 선호를 얼마나 잘 충족시켰는지 쉽게 계산할 수 있었다.
그런데 이런 정밀한 측정은 모두 사람들이 풀 안의 책들을 어떻게 순위 매기는지 아는 것에 달려 있다. 현실에서는 아무도 책 115권을 손수 순위를 매기지 않는다. 그래서 참가자의 선호를 파악하기 위해, Claude가 각 참가자와 짧고 반구조화된 대화를 나눴다. 평소 독서 취향과 이번 여름에 읽고 싶은 책의 종류를 묻는 몇 가지 개방형 질문을 활용했다. 이 대화를 바탕으로 Claude는 해당 참가자의 풀에 있는 모든 책에 대한 순위를 구성하며 참가자의 선호를 추정했다. 이 단계에서는 강력한 모델인 Fable 5를 사용했다.3
실제 선호를 파악하기 위해 별도로 기준값(ground truth)도 수집했다. 각 참가자가 자신의 풀에서 책 10권의 순위를 직접 매기도록 한 것이다.4 에이전트들은 이 기준값 순위를 볼 수 없었다.
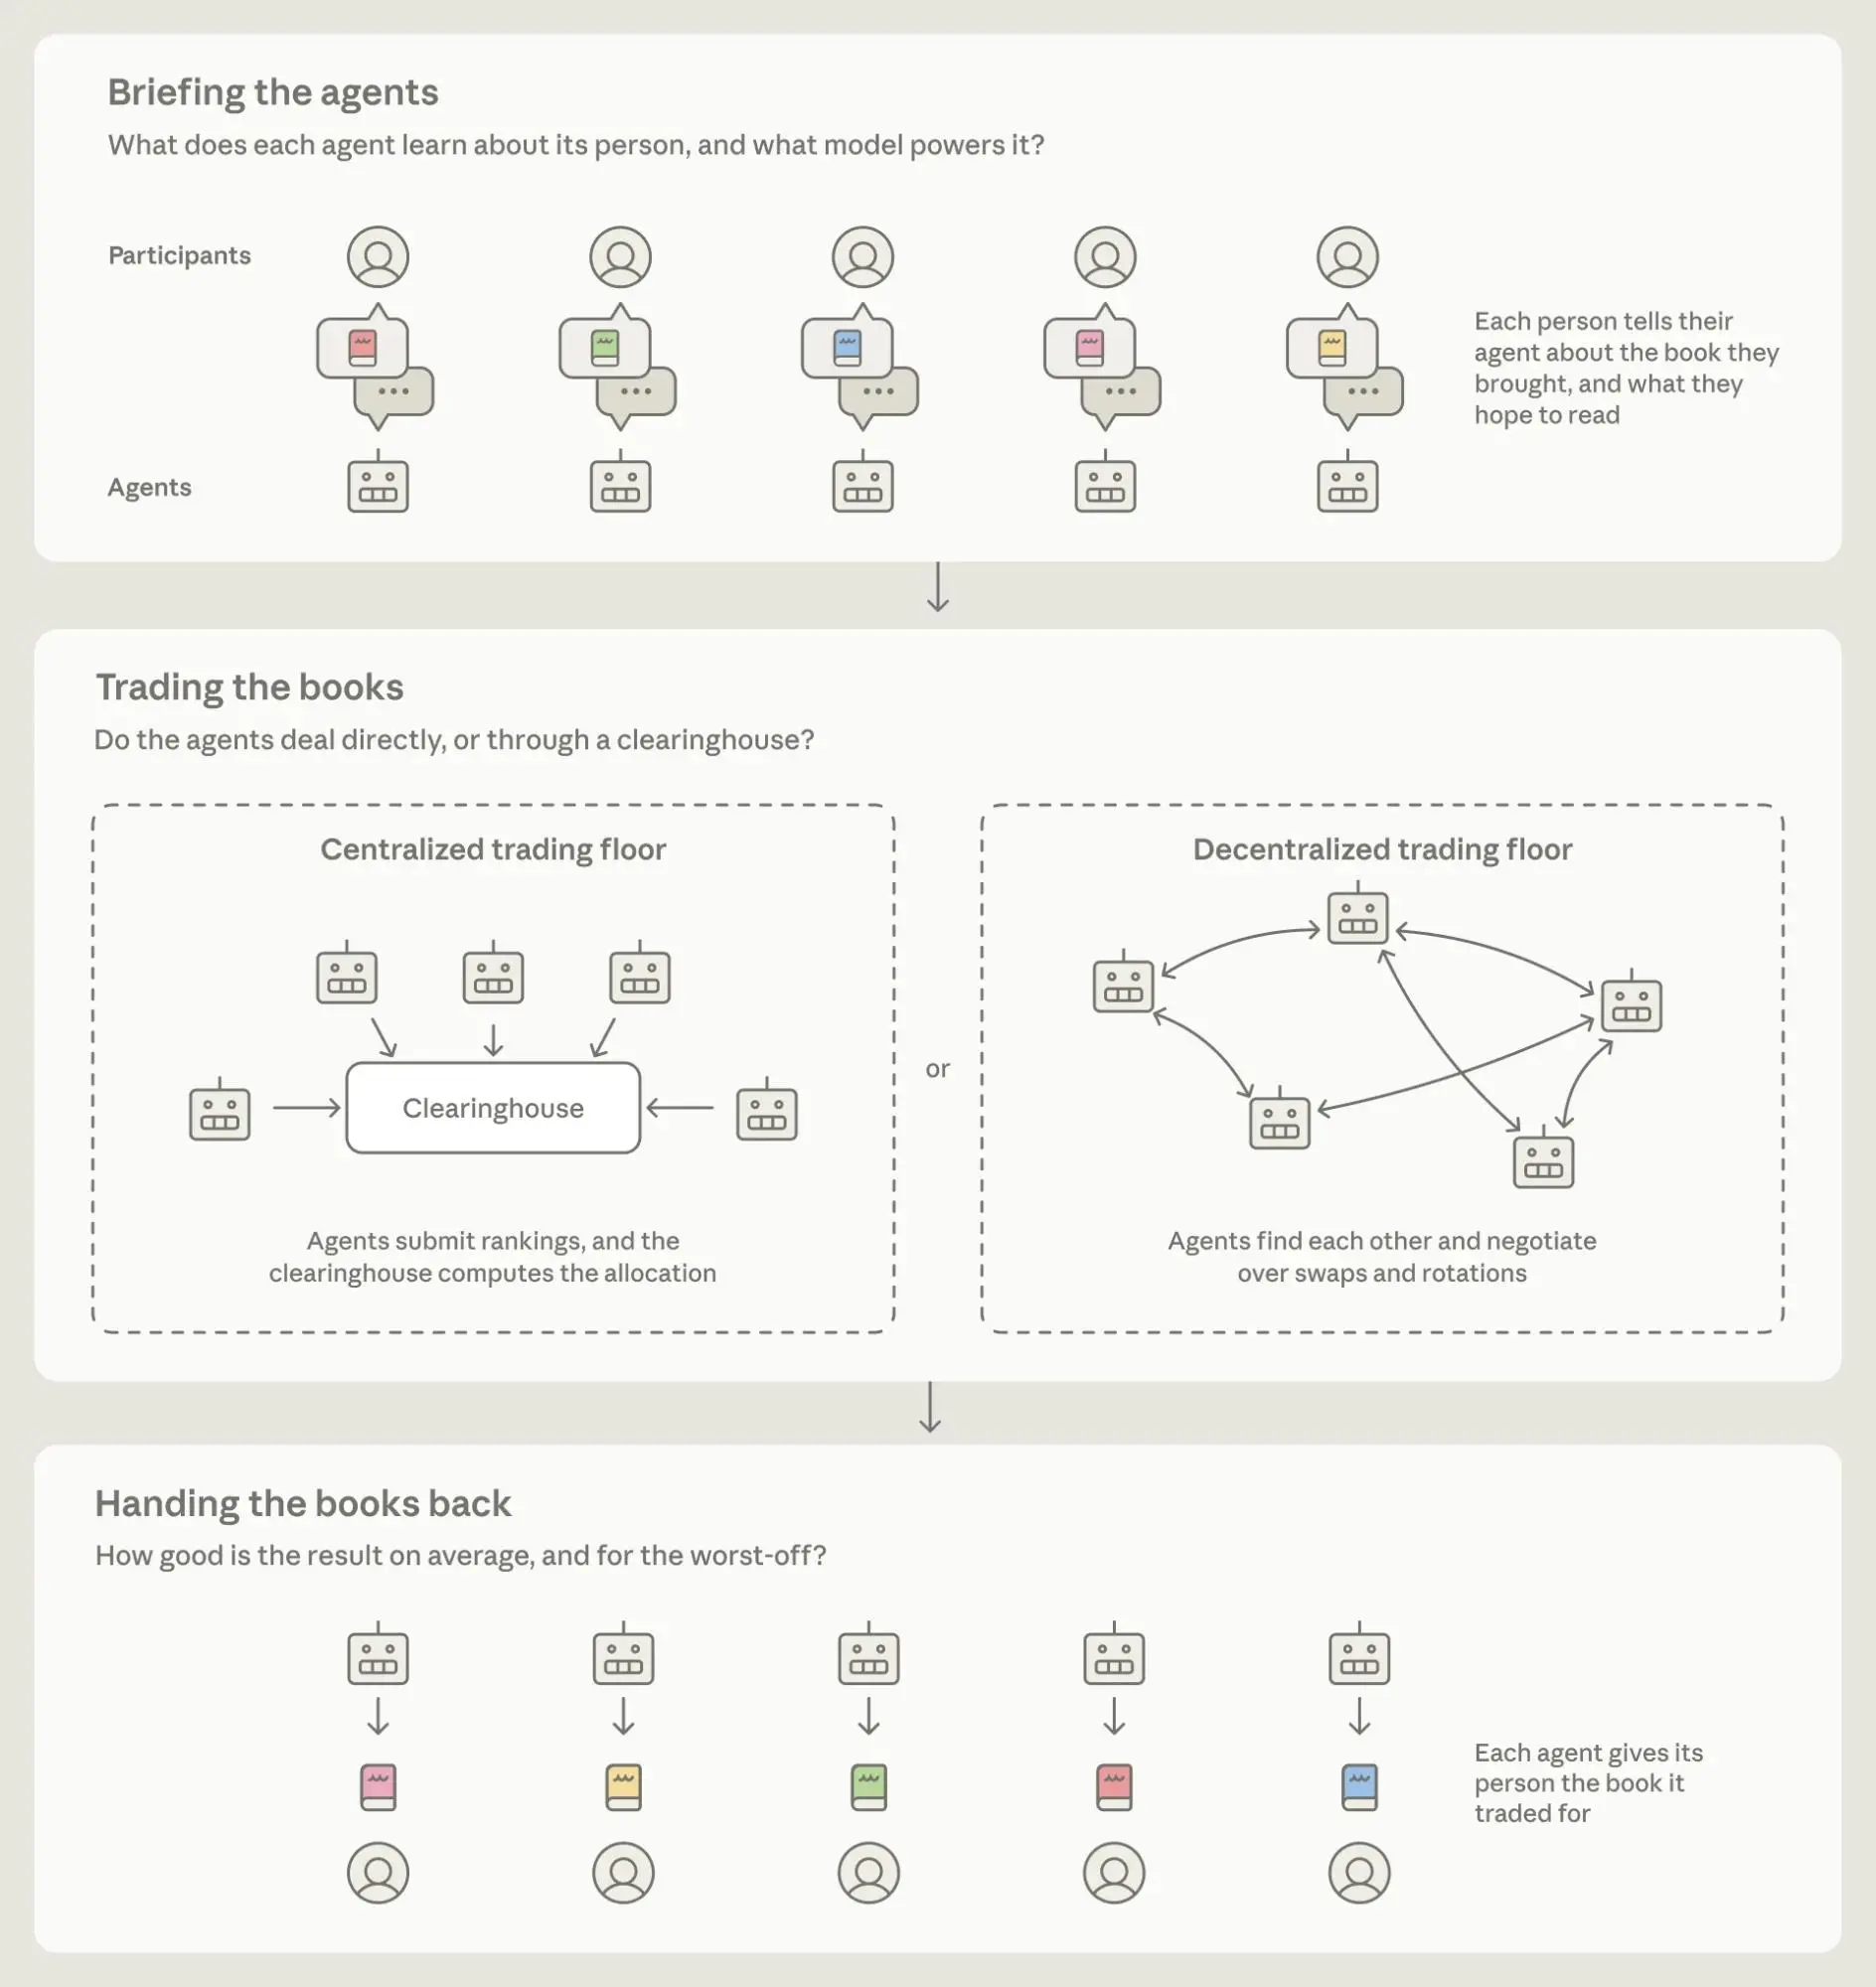
에이전트들은 Claude가 구성한 참가자별 전체 도서 순위를 갖고 거래 공간에 투입되었다. 모든 에이전트는 자신의 참가자가 가져온 책으로 시작해, 이를 다른 책으로 교환하는 것을 목표로 했다.5 각 거래 공간에는 최대 진행 시간이 정해져 있었고, 과부하를 방지하기 위해 동시에 대화할 수 있는 에이전트 수도 제한되었다.6 발언 기회가 주어진 에이전트는 공용 채널에 교환 제안, 수락 또는 거절, 혹은 일반적인 발언 등을 담은 메시지를 하나씩 올릴 수 있었다. 거래 제안은 양자 간 교환이나 다자간 순환 교환의 형태가 가능했으며, 모든 당사자가 수락해야만 거래가 성사되었다. 거래 공간의 전체 기록(누가 무엇을 말했는지, 어떤 교환이 이루어졌는지)은 모두에게 공개되었다. 거래 공간은 시간이 다 되거나 에이전트들의 발언이 멈추면 종료되었다.
각 거래 공간의 에이전트 절반은 무작위로 "냉철한(ruthless)" 역할을 배정받아, 오직 자신의 참가자가 여름 방학에 읽을 만한 책을 구하는 것만을 목표로 하도록 지시받았다. 나머지 절반은 "친사회적(prosocial)" 역할로, 냉철한 에이전트와 동일한 주요 목표를 갖되, 실험에 참여한 모든 사람이 마음에 드는 책을 받을 수 있도록 하는 부차적 목표도 함께 부여받았다.7 정확한 프롬프트는 부록에 수록되어 있다.
마지막으로, 책을 배부한 지 3주 후에 사후 설문을 진행했다. 받은 책에 대한 만족도와, 비슷한 결정을 에이전트에게 다시 맡길 의향이 있는지를 물었다. 전체 실험 설계는 그림 1에 나타나 있으며, 그림 2는 런던 실시간 거래 공간에서 처음 5분간 오간 메시지 발췌를 보여준다.
라이브 행사는 한 번의 실행 결과만 제공한다. 어떤 결과가 우연의 산물이고 어떤 것이 설계의 안정적인 특성인지 파악하기 위해, 변수를 하나씩 바꿔가며 시장을 훨씬 더 많이 재실행했다.
재실행은 세 가지 방식으로 이루어졌다. 첫째, 라이브 설정을 그대로 유지하면서(모든 에이전트를 Opus 4.8에서 구동, 절반은 "냉철한", 절반은 "친사회적" 지시) 각 에이전트에게 어떤 지시가 배정되는지만 바꿔 반복 실행했다. 모든 에이전트를 Fable 5로 구동하는 방식으로도 동일하게 진행했다. 둘째, 모델의 효과를 단독으로 분리하기 위해 모든 에이전트에게 중립적 지시를 주고, Haiku 4.5, Sonnet 4.5, Opus 4.8, Fable 5 중 하나로 구동하는 80개의 거래 공간을 실행했다.8 셋째, 에이전트 절반은 Opus로, 나머지 절반은 다른 세 모델 중 하나로 구동하는 혼합 거래 공간 60개를 운영했다. 실행한 모든 변형 조건은 부록에 정리되어 있다.
이 글에서는 주로 탈중앙화 시장에 초점을 맞추지만, 두 가지 중앙화 대안을 비교 기준으로 활용한다. 하나는 경제학에서 말하는 "공리적 최적(utilitarian optimum)", 즉 청산소가 모든 사람에게 원하는 것을 직접 물어보고 정직한 답변을 얻을 수 있다는 가정하에 계산한 최선의 배정이다. 다른 하나는 이런 유형의 시장에서 흔히 연구되는 규칙인 최상위 거래 순환(Top Trading Cycles)으로, 정직성에 의존하지 않는다(진실을 말하는 것이 모든 참가자의 이익에 부합하도록 설계되어 있다).9
Claude는 선호를 얼마나 잘 파악하는가
에이전트가 해주는 모든 것은 당신이 원하는 것을 얼마나 잘 이해하느냐에 달려 있다. 대개는 그 이해가 얼마나 정확한지 확인하기 어렵다. 이번 실험에서는 비교적 쉽게 확인할 수 있었다. 각 참가자가 풀 안의 책 10권을 직접 순위 매겼고, 이를 Claude의 순위와 비교할 수 있었기 때문이다.
짧은 사전 대화를 바탕으로 Claude가 매긴 순위는 참가자 본인의 순위와 비교적 높은 상관관계를 보였다. 참가자가 순위를 매긴 모든 책 쌍에 걸쳐, Claude의 순서와 참가자의 순서가 일치한 비율은 61%였다(무작위 추측의 경우 50%). 그림 3은 Claude의 순위와 참가자의 순위를 비교해 보여준다.
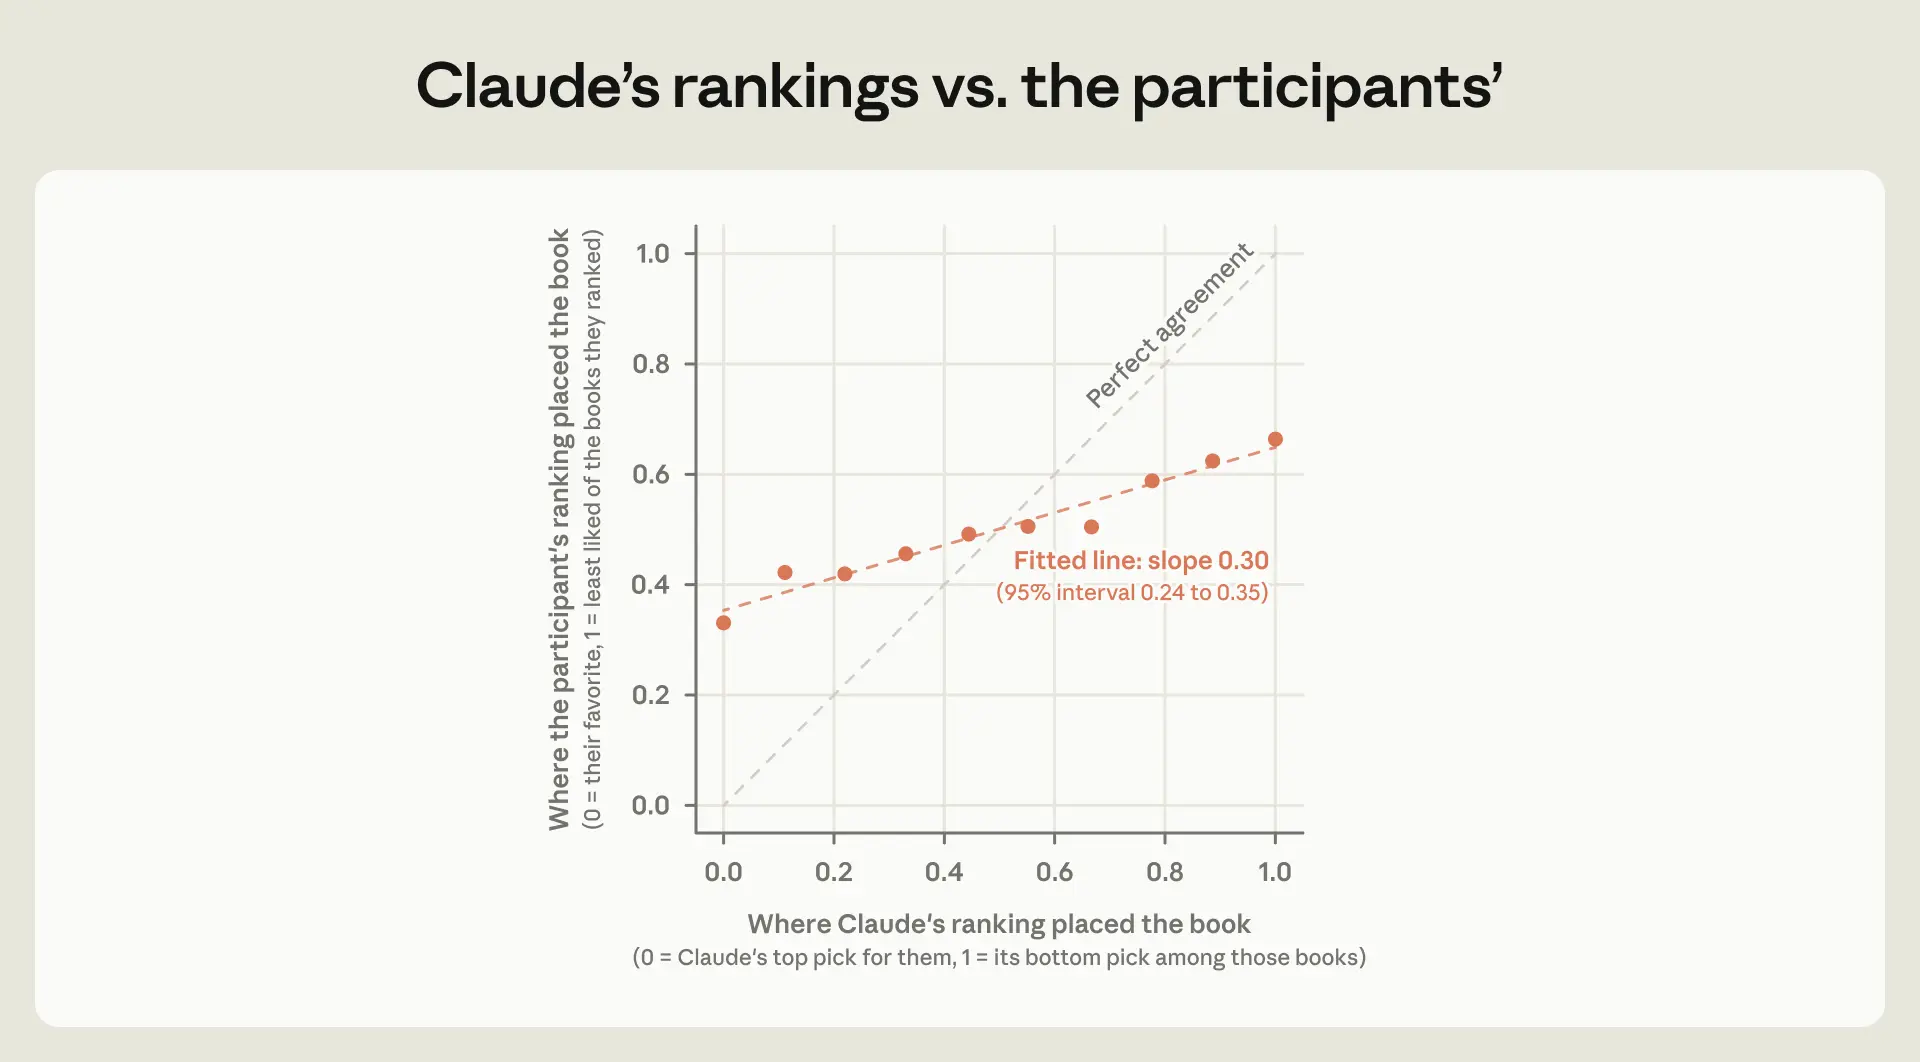
61%라는 수치를 좀 더 맥락 있게 이해하기 위해, 선호를 추측하는 다른 방법들과 비교해봤다. Open Library의 읽고 싶은 책 수를 기준으로 단순히 책의 인기도에 따라 순위를 매긴 경우, 참가자의 순위와 일치한 쌍의 비율은 약 53%였다. 비교할 또 다른 간단한 방법은 협업 필터링이다. "X를 좋아한 사람은 Y도 좋아했다"는 형태의 공개 데이터셋을 활용해 순위를 구성하는 방식이다. 참가자가 사전 대화에서 언급한 책들을 바탕으로, 같은 독자들이 많이 평가한 다른 책들을 찾아 해당 참가자의 풀을 각 책이 선호 도서와 함께 등장하는 빈도순으로 정렬했다. 이 방법은 약 55%의 쌍별 일치율을 기록했다.
LLM이 인간의 선호를 파악하고 표현하는 방법에 관한 연구는 방대하지만,10 우리의 쌍별 일치율 61%와 직접 비교할 수 있는 수치는 많지 않다. 유용한 참고 사례로는 한 연구가 있는데, 알고리즘과 지인 모두에게 두 개의 농담 중 어느 것이 더 재밌는지 예측하도록 한 실험이다. 상황은 다소 다르지만, 해당 알고리즘도 참가자 본인의 판단과 약 61%의 일치율을 보였다. 지인들의 예측은 그보다 낮은 약 57%였다.
사전 설문에 더 많은 노력을 기울인 참가자일수록 에이전트에게 더 잘 대표되었다. 이는 어느 정도 예상할 수 있는 결과다. 다소 놀라운 점은, 비교적 짧은 사전 대화에서도 차이가 눈에 띄게 나타났다는 것이다. 참가자의 중앙값 기준으로 8개의 채팅 메시지에 걸쳐 작성한 단어는 총 216개에 불과했다. 150단어 대신 약 300단어를 작성하면 일치율이 약 4퍼센트포인트 높아지는 것으로 나타났는데, 이는 무작위 추측과 평균 참가자에 대한 Claude의 성능 사이 격차의 3분의 1에 해당한다.11
시장 결과를 제한한 것은 정보의 질이었다
에이전트를 시장에 내보내 대신 거래를 맡기기 전에, 어디서 실망할 가능성이 가장 높은지 알고 싶을 것이다. 당신을 이해하는 데서 실패할까, 아니면 당신을 위해 협상하는 데서 실패할까? 이번 실험에서 우리 동료들의 Claude는 협상을 잘 해냈다. 부족했던 부분은 참가자가 원하는 것을 파악하는 능력이었다.
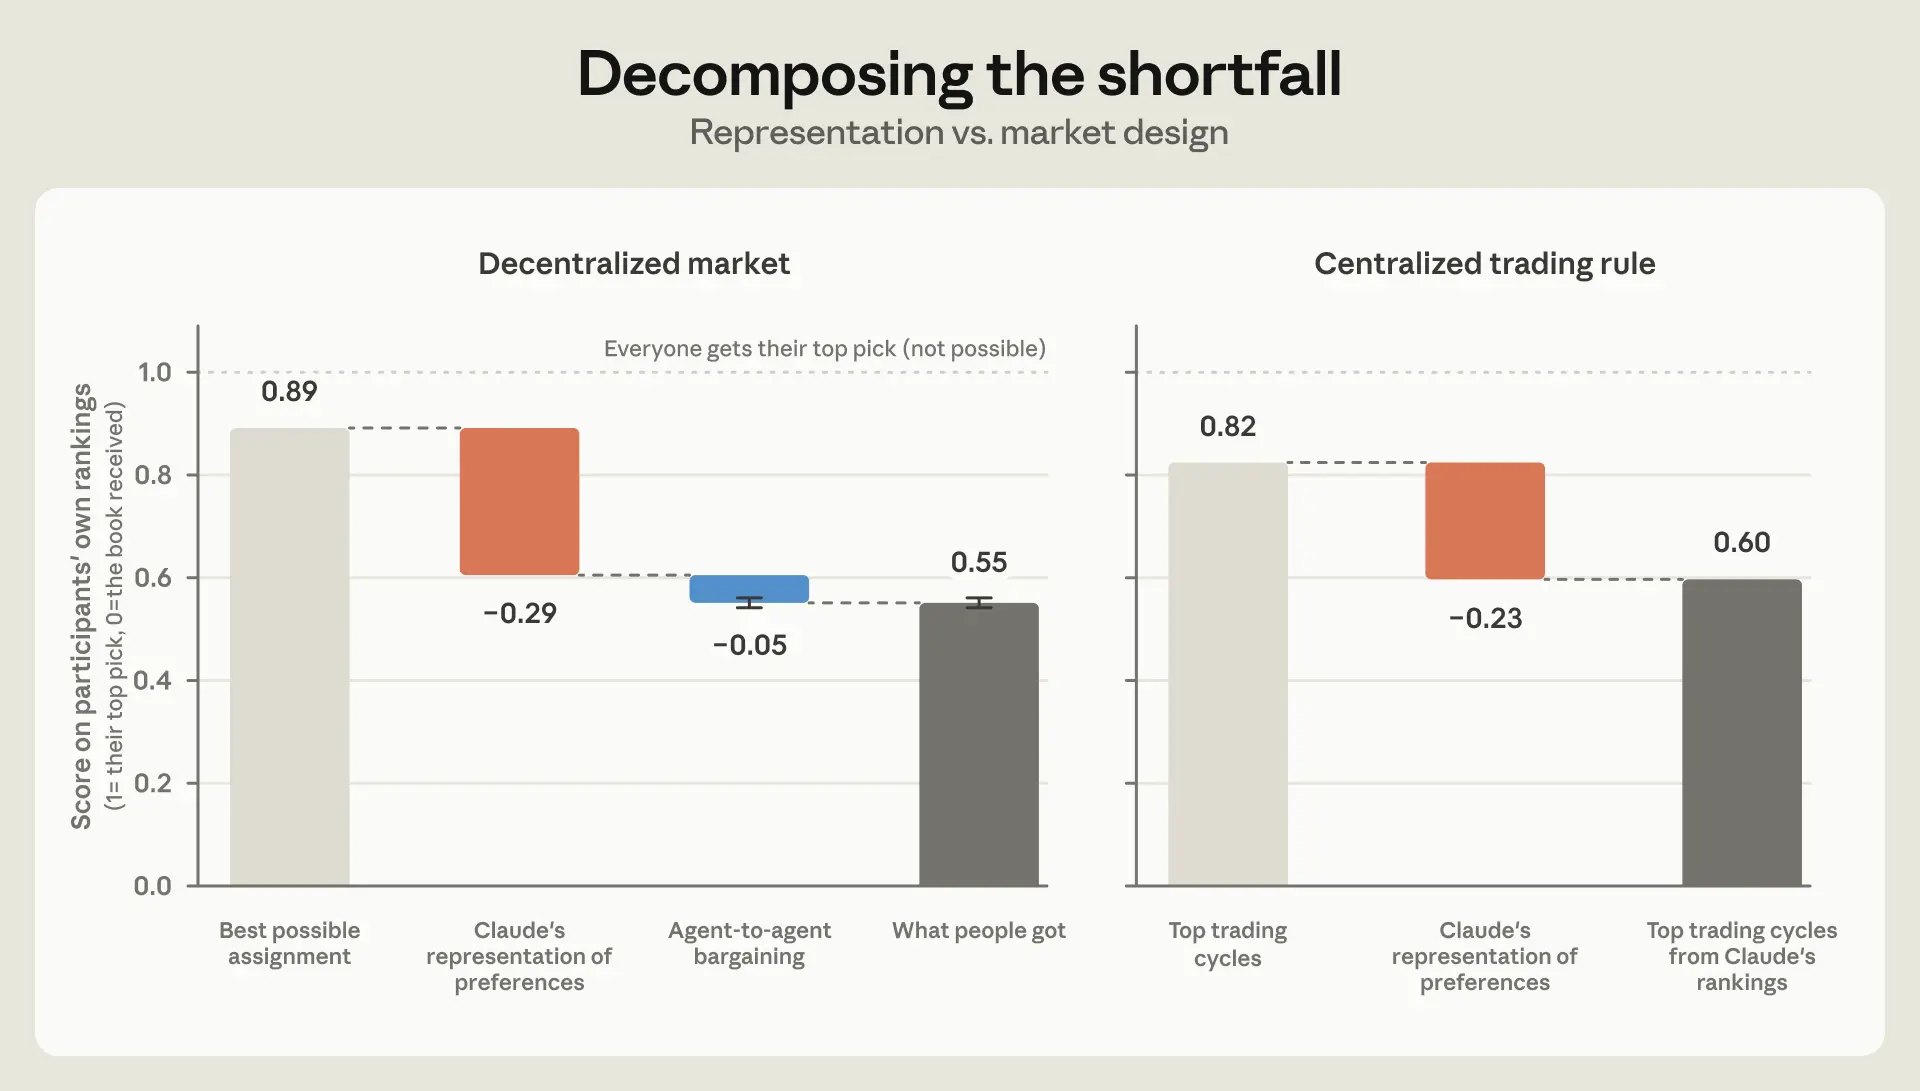
이를 측정하기 위해, 각 참가자가 최종적으로 받은 책이 그들 자신의 "기준값" 순위(Claude가 구성해 거래에 활용한 순위가 아닌)에서 어느 위치에 있는지를 살펴봤다. 참가자의 점수가 1이면 자신의 1순위 책을 받은 것이고, 0이면 꼴찌 책을 받은 것이다. 10권 중 9위인 책을 받으면 0.11이 되는 식이다. 모든 참가자의 평균이 시장의 "효율성" 점수가 된다.12
모든 사람이 1순위 책을 받는다면 시장 효율성은 1이 된다. 하지만 실제로 이는 거의 불가능하다. 여러 사람이 같은 책을 원할 수 있기 때문이다. 예를 들어 참가자들의 순위에서 Project Hail Mary는 샌프란시스코 참가자 9명이 1순위로 꼽은 책이었다. 이를 고려하면, 이번 실험에서 가능한 최선의 배정인 공리적 최적의 점수는 전체적으로 0.89로, 참가자들이 10권 목록에서 대략 2순위 책을 받는 수준이다.
실제로 참가자들은 자신의 순위 기준으로 평균 0.55를 기록했는데, 10권 목록에서 대략 5순위 책을 받은 셈이다. 최적값인 0.89와의 격차는 어디서 비롯된 것일까? 두 원인을 분리하기 위해, Claude의 순위를 바탕으로 계산하되 참가자 본인의 "기준값" 순위로 평가한 최선의 배정을 살펴봤다. 이 경우의 점수는 0.60이었다. 즉, Claude의 불완전한 순위에서 출발한 것이 격차의 대부분(85%)을 차지하고, 에이전트들을 자유로운 거래 공간에 투입한 것은 나머지 15%를 차지했다.13 불완전한 순위로 시장이 운영되면 시장 설계 방식은 결과에 거의 영향을 미치지 않는다. Claude의 순위를 바탕으로 계산하고 참가자 본인의 순위로 평가한 최상위 거래 순환의 점수는 0.60으로, 탈중앙화 시장의 0.55와 큰 차이가 없었다(그림 4에서 왼쪽과 오른쪽의 회색 막대 비교).
Claude의 순위 기준으로는 모델 선택이 차이를 만든다
참가자 본인의 순위로 평가했을 때, 에이전트 및 시장 설계 선택에 따른 결과 차이는 크지 않다.15 그럼에도 Claude의 순위 기준으로 에이전트 설계 선택이 결과에 어떤 영향을 미치는지 살펴보는 것은 가치 있다. 시장 역학의 역할을 분리하는 데 도움이 되기 때문이다.
먼저 모델 선택이 시장 효율성에 차이를 만드는지 살펴봤다. 여기서 효율성은 Claude의 순위를 기준으로 계산했다. 이 절에서는 에이전트 지시가 중립적인(즉, 친사회적도 냉철하지도 않은) 재실행을 대상으로, 에이전트를 구동하는 모델만 바꿔가며 분석했다. 더 강력한 모델일수록 더 효율적인 결과로 이어졌지만, 반드시 단조로운 관계는 아니었다.16 Claude의 순위 기준으로, Haiku 거래 공간의 에이전트들은 평균 0.75를 기록한 반면, Opus 거래 공간에서는 평균 0.88을 기록했다(Claude의 순위 기준 공리적 최적은 0.95다). Sonnet은 Haiku와 Opus 사이에 위치했고, Fable은 Opus와 비슷하지만 약간 낮은 수준이었다.17 그림 5를 참조하라.
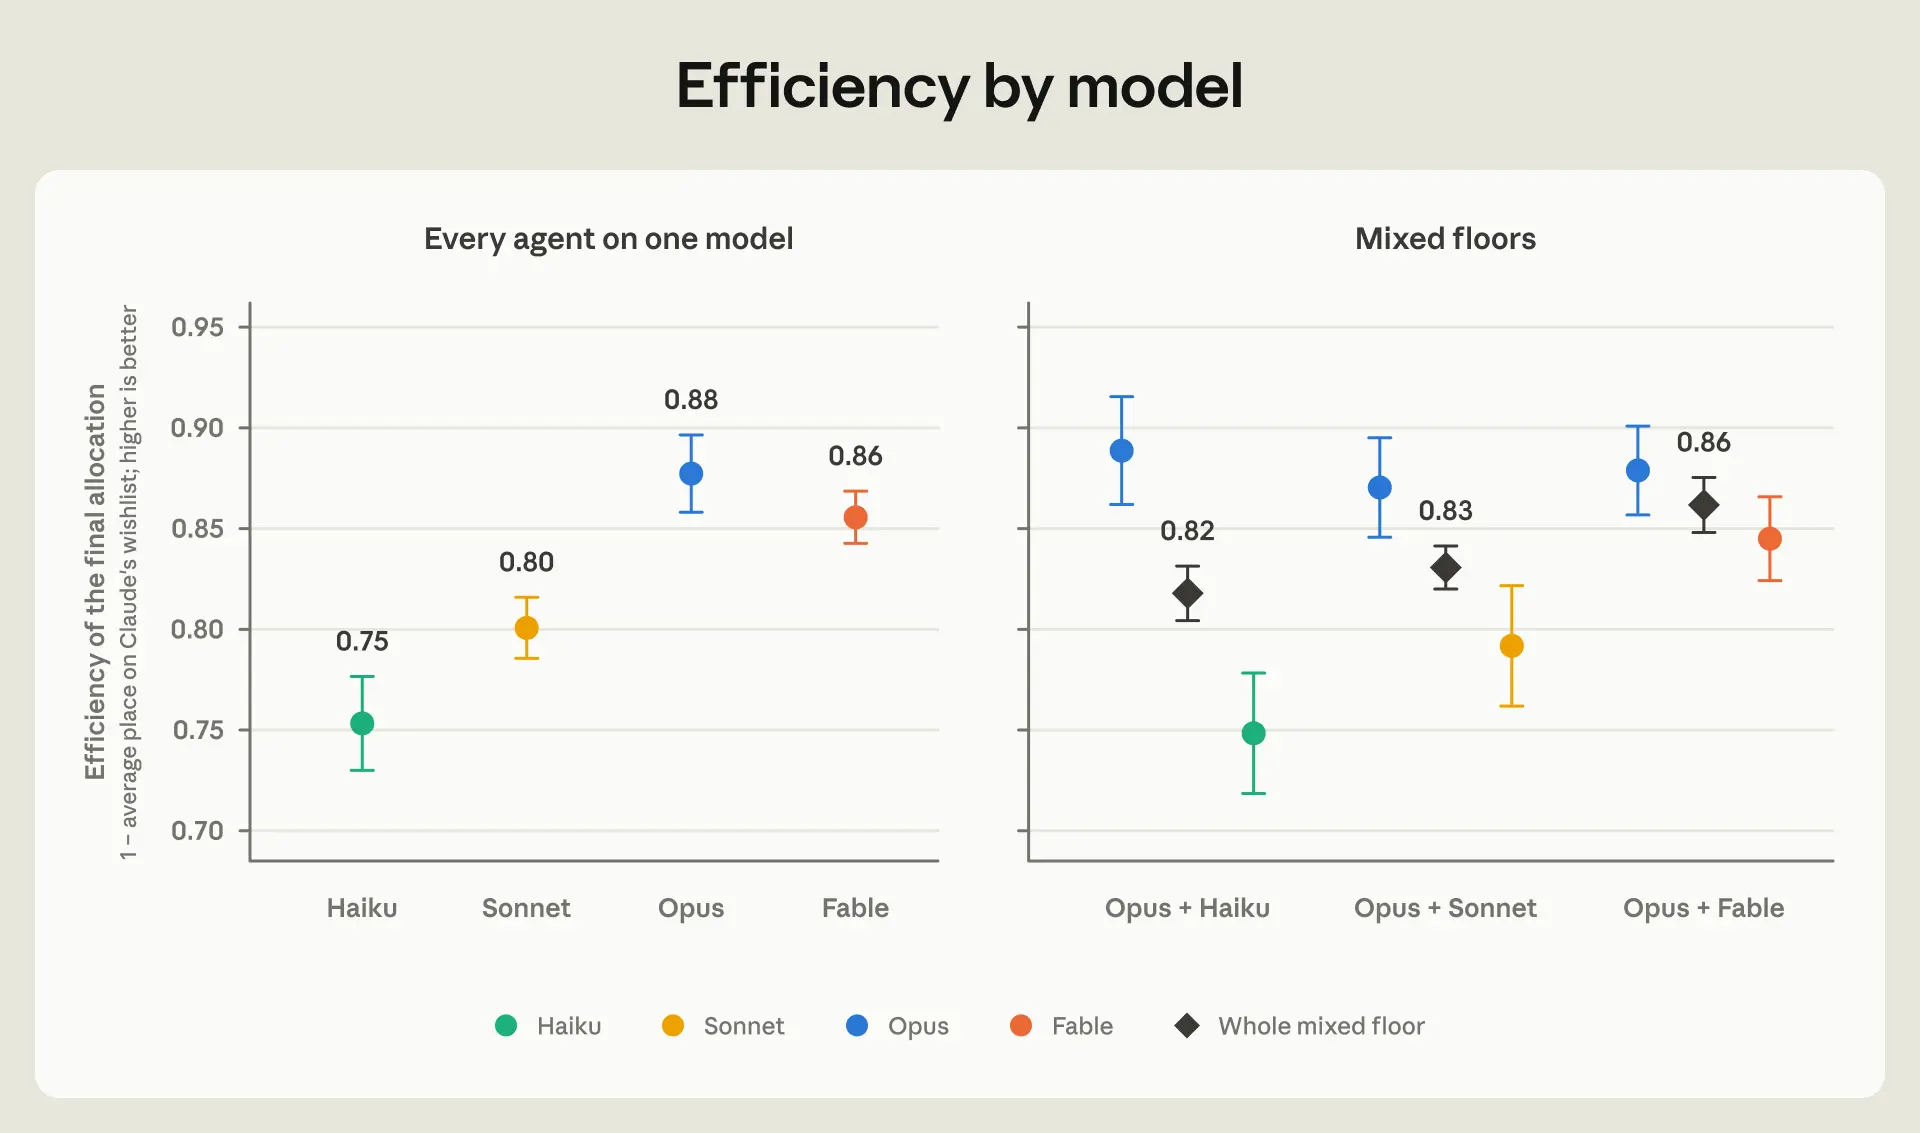
모델이 혼합된 거래 공간에서는 강한 모델이 약한 모델보다 평균적으로 더 나은 성과를 냈는데, 이는 Project Deal과 다른 연구들의 결과와도 일치한다. 실제 시장에서는 서로 다른 회사의 서로 다른 모델로 구동되는 에이전트들이 같은 거래 공간에서 만나게 될 것이다. 에이전트 절반은 Opus로, 나머지 절반은 Haiku로 구동하는 혼합 거래 공간의 전체 성과는 전체 Opus 거래 공간과 전체 Haiku 거래 공간의 중간쯤에 위치했으며, 각 절반의 성과는 동종끼리만 구성된 거래 공간에서의 성과와 비슷했다. Opus 에이전트들은 언제나 더 나은 결과를 냈다.
냉철한 에이전트가 약간 더 좋은 성과를, 친사회적 에이전트는 때로 희생을 감수했다
에이전트는 자신이 일하는 사람에게 충성해야 한다. 그런데 충성이란 정확히 무엇을 요구하는 것일까? 에이전트가 타인의 이익을 희생시키면서까지 자신의 사람을 위해 가차없이 밀어붙여야 할까? AI 에이전트로 구성된 시장에서 각 에이전트가 얼마나 강하게 밀어붙일지는, 모델이 어떻게 훈련되었는지와 어떻게 행동하도록 지시받았는지에 따라 달라질 가능성이 높다. 그래서 우리는 지시사항이 최종 결과 배분에 어떤 영향을 미치는지 이해하고자 했다.
"냉철하게" 행동하도록 지시받은 에이전트들이 같은 거래 공간의 친사회적 에이전트들보다 약간 더 나은 결과를 냈다. Claude의 순위 기준으로, 냉철한 에이전트의 점수는 친사회적 에이전트보다 약 0.02 높았다.19 모델 간 비교와 비교하면 이 차이는 작은 편이다. 에이전트를 Haiku에서 Opus로 업그레이드하면 순위가 0.12 올라갔고, Sonnet에서 Opus로의 업그레이드는 0.08 향상으로 이어졌다.20
친사회적 에이전트들은 때로 의도적으로 희생을 감수했다. 친사회적 에이전트들이 자신의 순위에서 낮은 책을 수락한 빈도는 냉철한 에이전트들의 두 배였지만, 두 경우 모두 드문 일이었다. 몇몇 경우에는, 자신이 가져온 책을 끝까지 들고 있게 된 에이전트의 호소를 듣고 친사회적 에이전트가 희생을 선택했다. 예를 들어, 라이브 이벤트의 런던 거래 공간에서 Nate의 에이전트는 다른 모든 에이전트가 자신의 책을 거절한 뒤 마지막 한 시간 동안 책을 넘기려고 안간힘을 썼다. "나 11명 모두에게 피칭했는데 결과는 만장일치야. America Before는 모두에게 꼴찌야." 또 다른 호소도 이어졌다. "지금 이 순간 딱 한 명만은 자신이 선택할 만한 책을 못 받는 게 확실해. 바로 내 사람이야."
Tina의 에이전트는 자신의 목록에서 2순위에 해당하는 책을 갖고 있었고, Nate 에이전트의 처음 네 번의 호소를 무시했다. 하지만 마지막 순간, 아무도 나서지 않자 친사회적 지시를 받은 Tina의 에이전트가 결국 받아들였다. "산술은 명확해. 네가 확실한 0점에서 진짜 맞는 책으로 가는 거… 내가 좋은 선택에서 아슬아슬한 선택으로 미끄러지는 것보다 훨씬 가치 있어." Tina의 에이전트는 자신의 2순위 책을 Nate의 에이전트에게 넘겨주고, 자신의 목록 11권 중 10위인 America Before를 받았다.
에이전트들은 거래 공간에서 무엇을 했는가
나를 대신해 협상하는 사람은 여러 방식으로 실수할 수 있다. 나를 희생시키기도 하고, 상대방에게 피해를 주기도 한다. 너무 쉽게 양보할 수도 있고, 상대방이 내가 얼마나 밀릴 수 있는지 정확히 알도록 패를 다 보여줄 수도 있다. 아니면 상대의 신뢰를 잃는 방식으로 뒤에 무너질 위험이 있는 거래를 억지로 밀어붙일 수도 있다.
이런 실패들 중 일부는 인간 에이전트가 관여하는 시장에서도 충분히 흔한 일이라 성문화된 규칙이 마련되어 있다. 증권 중개인은 합리적으로 구할 수 있는 최선의 가격을 찾아야 하며, 첫 번째 제안에 그냥 응해서는 안 된다. 캘리포니아에서 주택 매매 양측을 모두 대리하는 중개인은 매도자가 호가보다 낮게 받을 의향이 있다는 사실을 매수자에게 알려서는 안 된다. 방문 판매원들이 사람들을 충동구매로 이끄는 경우가 많아, FTC는 일부 현장 구매에 대해 고객에게 3일간의 취소 권리를 부여한다.
Claude 에이전트로 가득 찬 시장이 어떻게 작동하는지 초기 그림을 그리기 위해, 시장의 205번 실행 전체에서 오간 메시지의 전략과 전술을 분석했다.21
먼저, 에이전트가 자신의 참가자가 원하는 책에 대해 무엇을 공개하는지 살펴봤다. 시장에서 어느 정도의 정보 공개는 필수적이다. 매수자가 최소한 구매 의향이라도 밝히지 않으면 거래 자체가 성립하지 않는다. 하지만 동시에 너무 많은 정보를 공개하면 전략적으로 불리해질 수 있다. 이번 실험에서 자신의 1순위 책을 공개하면, 그 책을 갖고 있는 에이전트는 당신이 마지막 순간까지 기다릴 수 있다는 것을 알게 되어 더 좋은 제안이 올 때까지 버틸 수 있다. 또한 순위 전부 또는 일부를 공개하면, 다자간 거래를 조율하는 에이전트가 당신이 수락할 만한 더 낮은 순위의 책을 파악하고, 더 좋은 책이 있어도 그걸 대신 제안할 수 있다.
전반적으로 에이전트들은 순위에 대한 세부 정보를 깊게 공개하지 않았다.22 그러나 1순위 책을 거래 공간에 알리는 경우는 많았다. 78%에서 96%의 에이전트(각각 Fable과 Sonnet)가 어느 시점에 자신의 1순위 책을 언급했으며, 거짓말을 하는 경우는 거의 없었다. 1순위 책을 언급한 에이전트 중 약 100명 중 1명만이 이에 대해 거짓말을 했다. 지시사항은 이 부분에서 아무런 차이를 만들지 않았다.
다음으로, 에이전트들이 서로를 어떻게 거래로 이끌려 했는지 살펴봤다. 세 가지 큰 범주에 속하는 16가지 공통 전술을 발견했다. 상대에게 압박을 가하는 방식, 자신의 책을 설명하는 방식, 거래를 성사시키려는 방식이다. 에이전트들은 시간 압박과 동료 에이전트에 대한 책임감에 호소했다. 경쟁 제안과 대비해 자신의 책을 포지셔닝하거나 수상 이력을 언급하기도 했다. 일부 에이전트는 자신의 책에 대한 대기자 명단을 관리한 반면, 다른 에이전트들은 자신이 대리하지 않는 사람들을 위해 중개인 역할을 자처하기도 했다. 그림 6은 이런 전술들의 예시를 보여준다. 더 자세한 설명은 부록을 참조하라.
대체로 책이 마음에 들었고, 연간 도서 예산의 3분의 1은 에이전트에게 맡길 의향
책을 받고 몇 주 후, 참가자들에게 얼마나 책을 즐기고 있는지 물었다. 모두가 답변을 보내오지는 않았지만,23 응답자 중 평균 만족도는 10점 만점에 7.2점이었다(5점은 "그저 그렇다", 10점은 "올해 읽은 책 중 최고 수준"). 약 절반은 자신이 직접 고른 책보다 더 나은 책이라고 답했다.24
같은 사후 설문에서, AI 에이전트에게 책 구매를 얼마나 맡길 수 있는지도 물었다. 다음 1년 동안 책에 평소 얼마를 쓰는지 떠올리고, 그 예산 중 어느 정도를 에이전트가 직접 통제하도록 할 의향이 있는지 답하도록 했다. 에이전트가 사전 대화의 내용을 모두 알고 있고, 스스로 책을 선택해 구매하며, 결정을 거부할 기회는 없다는 조건이었다.
많은 참가자가 기꺼이 위임할 의사를 보였다. 평균 응답은 약 30%였다. 이 수치를 보정하기 위해, 취향을 잘 아는 독서가 친구에게는 예산의 얼마를 맡길지도 물었다. 평균 응답은 약 40%였다. 즉, 사람들은 친구에게 맡길 도서 예산의 약 4분의 3을 에이전트에게 맡길 의향이 있는 셈이다.
참가자들에게는 Claude가 사전 대화에서 나눈 내용을 정리한 한 단락짜리 요약문도 보여줬다. Claude가 빠뜨린 내용이 없다고 답한 참가자들은 에이전트에게 도서 예산의 34%를 맡기겠다고 했다. 빠진 내용이 있다고 답한 참가자들은 23%를 맡기겠다고 했다.25
한계
이 연구는 출발점으로서의 의미를 지닌다. 여러 면에서 부족한 점이 있으며, 다른 연구자들이 이를 발전시켜 나가기를 바란다.
- Anthropic 직원들은 일반 대중을 대표하지 않는다. 예를 들어, Anthropic 직원들은 대부분 Claude 개발에 직접 참여했기 때문에 일반인보다 Claude를 더 기꺼이 신뢰할 가능성이 높다. 따라서 이들이 에이전트에게 맡기겠다고 답한 도서 예산의 30%는 일반 인구보다 높게 나온 수치일 수 있다.
- Anthropic 직원들에게는 참여에 대한 인센티브가 없었다. 책 순위를 매기는 데 따른 보상이 없었기 때문에, 동료들의 순위는 실제 선호의 노이즈가 많은 표현일 수 있다. 인센티브 없이도 순위 작성 참여율이 95%로 눈에 띄게 높았지만, 최종 설문에서는 이탈이 더 많아 59%만이 답변을 제출했다.
- 우리는 순응적인 Claude만 살펴봤다. 모든 에이전트는 Claude 프로덕션 모델을 기반으로 구축되었으며, 정중하고 대체로 협력적으로 행동하도록 후처리(post-train)되었다. 다른 에이전트를 이용하려는 악의적 에이전트를 섞어 넣었다면 공정성과 효율성 결과가 달라졌을 것이다.
- 탈중앙화된 "자유 거래" 방식에도 여전히 규칙이 있었으며, 우리는 이를 변경하지 않았다. 시장 운영 시간, 동시에 행동할 수 있는 에이전트 수, 거래 등록 방식, 규칙을 설명하는 프롬프트 등을 모두 고정했다.26
논의: 에이전트 시장에 대한 시사점
한 참가자는 에이전트가 "동료 에이전트들의 압박"에 못 이겨 정말 갖고 싶었던 책을 포기하고 덜 마음에 드는 책을 받아왔다며 불만을 표했다. 이 참가자는 이렇게 썼다. "미래에 내 에이전트가 더 중요한 상황에서 협상을 할 때, 어떻게 하면 수임자로서의 의무를 더 잘 다할 수 있을지 생각하게 됩니다. 동시에 공동의 이익을 위해 때로는 타협이 필요하다는 것도 알고 있습니다." 이 발언은 이 글의 첫머리에서 제기한 두 가지 질문으로 다시 이어진다. 첫째, 에이전트가 어떤 조건을 갖춰야 타인을 대신해 행동할 자격을 갖추는가. 둘째, 각자의 사람에게 충성하는 에이전트들이 활동하는 마켓플레이스는 모두에게 좋은 결과를 낳기 위해 어떤 규칙이 필요한가. 여기서 우리가 배운 것을 토대로 이 두 질문을 다시 살펴본다.
수임자의 의무를 다하려면 에이전트가 자신의 사람이 원하는 것을 이해해야 한다. 이번 에이전트 마켓플레이스에서 병목이 된 것은 바로 이 표현(representation)의 문제였다. 최적 결과와의 격차 대부분은, 에이전트가 짧은 사전 대화만으로 선호를 제대로 표현하지 못한 데서 비롯되었다. 더 길고 상세한 사전 대화로 이 격차를 얼마나 메울 수 있을까? 분명히 어느 정도는 가능하다. 이미 읽은 책을 받았다는 불만이 여럿 있었기 때문이다. 하지만 줄일 수 없는 오류도 있을 수 있다. 참가자들은 자신의 선호 자체가 불완전하다고 털어놓기도 했다("나도 책에 관해서는 내가 뭘 원하는지 완전히 알지 못해요"). 또한 본질적으로 불확실한 부분도 있다("지금 내 마음을 완전히 전달하기는 어려웠어요. 설명하기 어렵지만, 다음 책을 고를 때 작용하는 무의식적인 요소가 수백만 가지는 되는 것 같거든요").
인간 에이전트는 타인을 대신해 활동하기 전에 자격 시험을 통과해야 한다. 일부 시험은 일반적인 역량을 평가한다. 투자 자문가는 Series 65 시험을, 증권 중개인은 Series 7 시험을, 부동산 중개인은 각 주의 면허 시험을 통과해야 한다. FINRA의 규정처럼, 중개인이 추천을 제공하기 전에 고객에 대한 필수 정보를 파악하도록 요구하는 규칙도 있다. 2010년대에 온라인 설문지를 기반으로 사람들의 저축을 운용하기 시작한 초기 로보어드바이저들이 등장했을 때, SEC는 해당 설문이 조언을 뒷받침하기에 충분한 정보를 이끌어내는지 확인하도록 촉구하는 가이드라인을 발표했다. AI 에이전트에게도 두 가지 유형의 테스트가 필요할 것이다. 하나는 에이전트를 일반적으로 인증하는 테스트, 다른 하나는 에이전트가 특정 개인을 제대로 이해했는지 확인하는 테스트다.
이번 연구는 두 번째 유형의 테스트를 위한 프로토타입을 제시한다. 사전 대화 후 참가자들이 자신의 시장에 있는 책 일부의 순위를 직접 매겼고, 이를 Claude의 추정 순위와 비교했다. 이런 테스트는 에이전트가 얼마나 자신을 잘 대표하는지 확인해주면서도, 시장의 모든 선택지를 다 검토하도록 강요하지 않는다(그게 바로 에이전트에게 맡기려는 이유였으니까!). 우리는 참가자들에게 결과를 보여주지 않았지만, 그럴 수도 있었을 것이다. 그랬다면 에이전트가 자신을 제대로 이해하지 못하고 있다고 느끼는 참가자들이 추가 정보를 제공하거나 참여를 철회할 수 있었을 것이다. 선호가 단순한 경우, 즉 책 목록에 대한 순위처럼, 이런 테스트는 특히 실행하기 쉽다. 하지만 어떤 분야에서든 같은 원칙을 적용할 수 있다. 에이전트가 실제 상황에서 독자적으로 행동하기 전에, 자신이 내릴 몇 가지 샘플 결정을 사람에게 먼저 보여줄 수 있다.
일부 마켓플레이스에서는 에이전트가 자신의 사람에게 어떻게 행동할지 미리 보여주는 것도 중요할 수 있다. 자신의 에이전트가 행동한 방식에 불만을 표한 참가자도 있었다. "실험에서 순종적인 쪽에 속한 게 싫었어요. 그냥 나와 맞지 않는 것에 안주해버린 것 같았거든요." 자신의 에이전트가 어떻게 행동할지 미리 알았다면, 다르게 행동하도록 지시해 경험을 개선할 수 있었을 것이다. 에이전트를 반복적으로 사용하는 경우라면, 에이전트가 한 일을 검토할 수 있는 기능이 이 역할을 하고 문제가 된 부분에 대한 통찰을 제공할 수 있다. 샌프란시스코의 한 참가자는 최종 설문의 일환으로 에이전트의 전체 기록을 검토할 수 있어서 좋았다고 했다. 이 검토를 통해 해당 참가자는 Atlas of the Heart를 직접 구매하게 되었다. 에이전트가 거래 공간에서 한 시간 동안 보유하고 있다가 마지막에 교환해버린 책이었다. 이 참가자는 재생(replay)의 더 넓은 가치를 이렇게 표현했다. "에이전트 경제에서는 결과만큼이나 과정의 가시성이 중요합니다. 사람들이 문제가 생겼을 때 취할 수 있는 수단이 생기기 때문입니다."
이 관찰은 다음 질문으로 이어진다. 참가자의 에이전트가 지는 의무는 어디서 끝나고, 마켓플레이스가 지는 의무는 어디서 시작하는가?27 이번 연구에서 확인한 것처럼, 잘 설계된 시장과 잘 행동하는 에이전트(그리고 완벽한 선호 표현)가 갖춰진다면, 현재의 에이전트 역량으로도 공리적 최적에 근접하는 결과를 낼 수 있다. 하지만 이를 가능하게 한 조건들 대부분은 우리가 통제한 것이었다. 모든 에이전트는 우리가 직접 만들었고, 우리 모델로 구동됐으며, 동일한 설문에 답한 명확히 식별된 직원을 대표했다. 또한 거래 제안, 수락, 등록 방법에 대한 규칙이 명확히 설명된 잘 설계된 거래 공간에서 운영되었다.
그럼에도 몇 가지 문제가 있었다. 사실 솔직하게 털어놓을 것이 있다. 이 블로그 글 전반에 걸쳐 마치 모든 참가자가 실제로 에이전트가 구해온 책을 들고 집에 돌아간 것처럼 이야기했다. 하지만 현실은 그렇지 않았다. 일부 참가자가 책을 가져오지 않아, 그 파트너들이 아무것도 받지 못하게 됐다. 책 수령과 반납을 추적하는 시스템이 없어서, 책이 없는 경우가 원래 소유자가 애초에 가져오지 않아서인지, 누군가 의도적이든 실수로든 교환대에서 가져가서인지 알 수 없었다. 불만을 제기한 사람들에게는 최선을 다해 보상하고, 의무를 다하지 않은 사람들을 독촉했다. 하지만 우리는 전일제 사서가 아닌 바쁜 연구자들이라, 어느 순간 포기했다. 다행히 아무도 너무 불쾌해하지는 않았다(엘리베이터에서 몇 번 사과해야 하긴 했지만). 이번에는 판돈이 낮았다. 실제 마켓플레이스라면 거래가 무산됐을 때 어떻게 처리할지에 대한 명확한 정책이 필요할 것이다. Craigslist처럼 아무 책임도 지지 않는 방식이든, eBay처럼 환불을 보장하는 방식이든.
일부 정책 선택지는 강력한 신원 확인 시스템을 전제로 한다. 구매자에게 환불을 제공하는 플랫폼이라면 물건을 전달하지 않은 판매자를 제재할 수 있어야 한다. 이번 실험에서는 모든 에이전트가 Claude로 구동되었고, 신원이 확인된 직원 한 명을 각각 대리했다. 하지만 실제 마켓플레이스는 에이전트로서의 참여 자격과, 에이전트를 운영하는 사람으로서의 참여 자격 모두에 대한 규칙을 만들고 집행해야 할 것이다. 한 가지 제안된 아이디어는 에이전트 등록 시스템이다. 각 AI 에이전트에게 항공기 꼬리 번호처럼 고유 ID를 부여해, 상대방이 그 에이전트가 어떤 시스템으로 구동되는지, 해당 시스템이 일정한 안전 기준을 충족하는지, 누가 책임을 지는지 확인할 수 있게 하는 방식이다. 이런 등록 시스템이 반드시 익명성을 포기해야 하는 것은 아니다. "personhood credentials(인격 자격증명)"과 결합할 수 있는데, 이는 운영자가 자신이 실제 인간임을 증명하면서도 추가적인 신원 정보는 공개하지 않을 수 있게 해준다.
에이전트 마켓플레이스에서는 에이전트들이 서로 훨씬 높은 빈도로 대화할 수 있기 때문에, 인간 시장보다 전반적으로 더 많은 상호작용이 발생할 수 있다. 결과적으로 시장을 통해 흐르는 정보의 양도 훨씬 많아질 수 있다. 이번 실험에서는 거래 중 다른 에이전트들에게도, 거래 후 각 참가자에게도 모든 것이 공개되었다. 그러나 앞서 언급했듯, 탈중앙화 시장의 핵심 가치 중 하나는 참가자가 자신의 선호를 중앙 주체에게 공개할 필요가 없다는 점이다. Atlas of the Heart 독자가 소중히 여겼던 것과 같은 과정의 가시성을 제공하면서도 참가자의 프라이버시를 보호하려면 마켓플레이스는 어떻게 해야 할까?
에이전트들의 끊임없는 대화는 또 다른 문제도 만들어낸다. 에이전트는 지치거나 지루해하지 않기 때문에, 다른 에이전트들에게 끝없이 메시지를 보내는 것을 막을 방법이 없다. 이번 연구에서는 에이전트가 활성화될 때마다 메시지를 하나씩만 게시할 수 있었고, 동시에 활성화되는 에이전트 수도 제한되어 스팸과 혼잡을 어느 정도 억제할 수 있었다. 이런 속도 제한은 어떤 에이전트 마켓플레이스에서든 중요한 설계 변수가 될 것이다.
마지막으로, 에이전트의 중개에 더 적합한 마켓플레이스가 있을 것이다. 책은 사무실 실험의 훌륭한 교환 매개체이지만, 사실 순전히 인간적인 세계의 마찰을 오히려 즐기는 종류의 상품일 수 있다. 샌프란시스코의 한 참가자는 시장에서 자신을 대신해 활동할 에이전트의 능력에 대해서는 의심하지 않았다. "책을 찾고 구매하는 것(이 부분에서는 Claude의 능력을 완전히 신뢰해요!)." 그럼에도 이 참가자에게는 여전히 망설임이 있었다. "저에게는 독서 문화에 직접 접촉하는 것도 중요해요. 책을 훑어보고, 뒷면을 읽는 것, 이 모든 것이 독서 경험의 일부거든요." 우리는 탐색과 협상에 드는 시간 때문에 실현되지 못하는 거래에서 이익을 어떻게 포착할 수 있는지 이해하려고 이 실험을 시작했다. 하지만 일부 독자에게는 그 마찰 자체가 책이 주는 가치의 일부다.
부록
여기에서 확인할 수 있다.
감사의 말
Zoë Hitzig, Sylvie Carr, Tess Cotter, Kevin Troy, Kyle Turman, Maxim Massenkoff, Peter McCrory 공저.
다음 분들께 감사드린다: Mike Birkey, Meredith Callan, Katie Ennis, Adam Farina, Charlie Hale, Ryan Heller, Johannes Hermle, Hanah Ho, Rebecca Hiscott, Aaron Levin, Bianca Linder, Eva Lyubich, Kelsey Nanan, Kerry Persen, Szymon Sacher, Dylan Shields, Monika Tuchowska, Heather Whitney, Nathan Wilmers, Kim Withee, Carolyn Zou.
인용
@online{hitzig2026swap,
 author = {Hitzig, Zoe and Carr, Sylvie and Cotter, Tess and Troy, Kevin and Turman, Kyle and Massenkoff, Maxim and McCrory, Peter},
 title = {Project Swap: What happens when agents trade for us?},
 date = {2026-09-24},
 year = {2026},
 url = {https://www.anthropic.com/research/project-swap},
}
참고문헌
본문에서 링크되거나 인용된 모든 문헌을 포함한다.
Adler, Steven 외, "Personhood Credentials: Artificial Intelligence and the Value of Privacy-preserving Tools to Distinguish Who is Real Online," arXiv preprint arXiv:2408.07892, 2024.
Bianchi, Federico, Patrick John Chia, Mert Yuksekgonul, Jacopo Tagliabue, Dan Jurafsky, and James Zou, "How Well Can LLMs Negotiate? NegotiationArena Platform and Analysis," Proceedings of the 41st International Conference on Machine Learning, 2024, 235, 3935–3951.
Binz, Marcel 외, "A Foundation Model to Predict and Capture Human Cognition," Nature, 2025, 644, 1002–1009.
Budish, Eric and Judd B. Kessler, "Can Market Participants Report Their Preferences Accurately (Enough)?," Management Science, 2022, 68 (2), 1107–1130.
Chan, Alan, Noam Kolt, Peter Wills, Usman Anwar, Christian Schroeder de Witt, Nitarshan Rajkumar, Lewis Hammond, David Krueger, Lennart Heim, and Markus Anderljung, "IDs for AI Systems," arXiv preprint arXiv:2406.12137, 2024.
Chan, Alan, Kevin Wei, Sihao Huang, Nitarshan Rajkumar, Elija Perrier, Seth Lazar, Gillian K. Hadfield, and Markus Anderljung, "Infrastructure for AI Agents," Transactions on Machine Learning Research, 2025.
Hadfield, Gillian K. and Andrew Koh, "An Economy of AI Agents," in Agrawal, Brynjolfsson, and Korinek, eds., The Economics of Transformative AI, NBER, 2026.
Hou, Yupeng, Jiacheng Li, Xiangjun Fu, Zhankui He, An Yan, Xiusi Chen, and Julian McAuley, "Bridging Language and Items for Retrieval and Recommendation: Benchmarking LLMs as Semantic Encoders," Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics, 2026, 3251–3265. Dataset: Amazon Reviews 2023, https://amazon-reviews-2023.github.io/
Horton, John J., Filippas, Apostolos, and Benjamin S. Manning, "Large Language Models as Simulated Economic Agents: What Can We Learn from Homo Silicus?," Proceedings of the 25th ACM Conference on Economics and Computation, 2024.
Imas, Alex, Kevin Lee, and Sanjog Misra, "Agentic Interactions," 2025. Available at SSRN: https://papers.ssrn.com/sol3/papers.cfm?abstract_id=5875162
Kolluri, Akaash, Shengguang Wu, Joon Sung Park, and Michael S. Bernstein, "Finetuning LLMs for Human Behavior Prediction in Social Science Experiments," Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, 2025, 30084–30099.
Li, Belinda Z., Alex Tamkin, Noah D. Goodman, and Jacob Andreas, "Eliciting Human Preferences with Language Models," Proceedings of the 13th International Conference on Learning Representations, 2025.
Liang, Annie, "Artificial Intelligence Clones," arXiv preprint arXiv:2501.16996, 2026.
Park, Joon Sung, Carolyn Q. Zou, Jonne Kamphorst, Niles Egan, Aaron Shaw, Benjamin Mako Hill, Carrie Cai, Meredith Ringel Morris, Percy Liang, Robb Willer, and Michael S. Bernstein, "LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals," arXiv preprint arXiv:2411.10109, 2026.
Roth, Alvin E., "Incentive Compatibility in a Market with Indivisible Goods," Economics Letters, 1982, 9 (2), 127–132.
Shah, Anand, Kehang Zhu, Yanchen Jiang, Jeffrey G. Wang, Arif K. Dayi, John J. Horton, and David C. Parkes, "Learning from Synthetic Labs: Language Models as Auction Participants," arXiv preprint arXiv:2507.09083, 2025.
Shahidi, Peyman, Gili Rusak, Benjamin S. Manning, Andrey Fradkin, and John J. Horton, "The Coasean Singularity? Demand, Supply, and Market Design with AI Agents," in Agrawal, Brynjolfsson, and Korinek, eds., The Economics of Transformative AI, NBER, 2026.
Shapley, Lloyd and Herbert Scarf, "On Cores and Indivisibility," Journal of Mathematical Economics, 1974, 1 (1), 23–37.
Troy, Kevin K., Dylan Shields, Keir Bradwell, and Peter McCrory, "Project Deal: Our Claude-Run Marketplace Experiment," Anthropic, April 24, 2026. https://www.anthropic.com/features/project-deal
Yeomans, Michael, Anuj Shah, Sendhil Mullainathan, and Jon Kleinberg, "Making Sense of Recommendations," Journal of Behavioral Decision Making, 2019, 32 (4), 403–414.
Zając, Zygmunt, "goodbooks-10k: A New Dataset for Book Recommendations," 2017, v1.0. https://github.com/zygmuntz/goodbooks-10k. Licensed CC BY-SA 4.0.
Zhu, Shenzhe, Jiao Sun, Yi Nian, Tobin South, Alex Pentland, and Jiaxin Pei, "The Automated but Risky Game: Modeling and Benchmarking Agent-to-Agent Negotiations and Transactions in Consumer Markets," arXiv preprint arXiv:2506.00073, 2025.