Anthropic제품 블로그Enterprise AI
AI 네이티브 SDLC 플레이북
소프트웨어 개발 라이프사이클(SDLC)을 AI로 단계별로 혁신하는 실전 가이드
코드는 더 이상 병목이 아니다
조직들은 1년 전만 해도 상상하기 어려웠던 속도로 AI를 활용해 코드를 작성하기 시작했다. 그러나 코드를 둘러싼 프로세스는 그 속도를 따라잡지 못하고 있다.
많은 엔지니어링 팀이 여전히 기존의 승인 관문, 리뷰, 인계 절차, 정책을 그대로 유지하고 있어, Claude Code와 같은 에이전트 코딩 솔루션으로 얻은 생산성 향상을 스스로 가로막고 있다.
소프트웨어 개발 라이프사이클(SDLC)은 소프트웨어를 아이디어에서 프로덕션까지 이끄는 프로세스다. 대부분의 조직은 기획, 설계, 구현, 테스트, 배포, 유지보수라는 여섯 단계를 기본 골격으로 운영한다. 전통적으로 각 단계는 서로 다른 역할이 담당하는 독립된 단계였다. 프로덕트 매니저가 요구사항을 작성하고, 기술 아키텍트가 이를 설계로 전환하고, 엔지니어가 설계를 구현하고, 규제 산업의 QA 팀이 검증하고, 릴리스 팀이 배포하고, 운영 팀이 운영 중인 시스템을 모니터링한다. 문서와 티켓, 승인 절차를 통해 단계 사이에서 작업이 이동한다.
전통적인 SDLC는 각 단계에서 책임과 통제를 확보하기 위해 프로세스가 촘촘하게 설계되어 있다. 하지만 이 구조는 코드 작성과 구현이 가장 시간과 비용이 많이 드는 단계였던 시대에 최적화된 것으로, 지금은 그런 전제가 성립하지 않는다. PRD와 추정 의식(estimation ritual), 제품 보안 검토는 모두 몇 주, 몇 달, 때로는 몇 분기에 걸친 개발 기간 동안 팀 전체의 방향을 맞추기 위해 존재했다.
전통적인 SDLC에는 또한 모든 단계를 사람이 수행한다는 전제를 바탕으로 한 통제 장치들이 내장되어 있다. 현재 가장 높은 가치를 창출하는 조직들은 에이전트 AI가 할 수 있는 일을 중심으로 프로세스를 재구성하면서도, 사람이 루프 안에 머물 수 있도록 설계하고 있다. 이 가이드에서는 고객사와의 협업을 바탕으로, Anthropic의 Applied AI 팀이 내부적으로 Claude를 SDLC 각 단계에 통합해 개발을 가속화하고 프로세스를 더 빠르게 운영하기 위해 실천해온 주요 사례들을 단계별로 살펴본다.
코드가 더 이상 병목이 아니고 구현 단계가 전통적인 SDLC가 허용하는 속도보다 빠르게 돌아가면, 세 가지 현실이 뒤따른다.
- 병목이 구현 단계 앞뒤로 이동한다. 주로 기획, 리뷰·테스트, 배포 단계인데, 이 단계들은 여전히 사람의 속도로 움직인다.
- 통제 방식이 현실과 어긋나면서 감당하기 어려워진다. 사람이 코드를 작성할 때는 한 줄씩 손으로 검토하는 것이 합리적이었지만, 에이전트가 변경 사항의 대부분을 생성하는 상황에서는 그 속도를 따라갈 수 없다.
- 거버넌스 비용이 증가한다. 예외 사항은 여전히 주 단위나 월 단위로 열리는 회의와 위원회를 거쳐야 하기 때문이다.
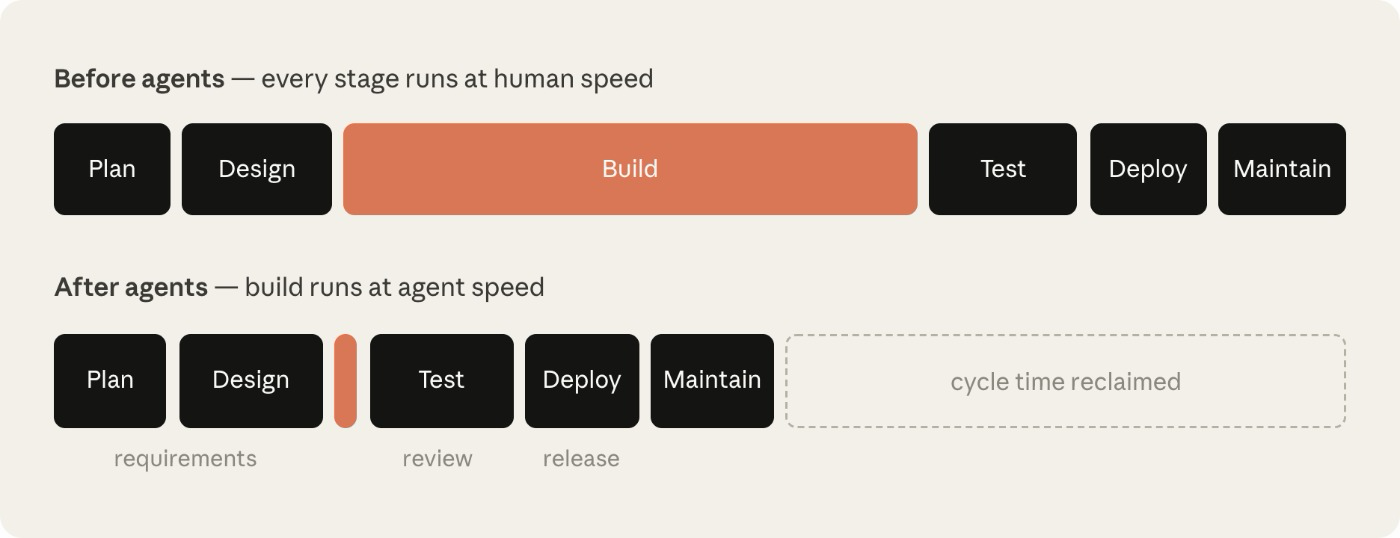
보안 병목을 예로 들어보자. 보안 팀의 규모는 사람의 산출물을 기준으로 정해진다. 에이전트가 코드 산출량을 몇 배로 늘리면, 리뷰 대기열이 쌓이거나 검토가 불충분한 채로 코드가 배포된다. 규제를 받는 조직은 어느 쪽도 받아들일 수 없기 때문에, 보안 및 정책 검토가 에이전트의 속도에 맞춰야 한다.
에이전트 AI의 생산성 향상을 온전히 실현하고 안전하게 운영하려면, 전통적인 SDLC 라이프사이클도 구현 단계가 겪은 것과 같은 수준의 변환이 필요하다.
AI 네이티브 SDLC란 무엇인가?
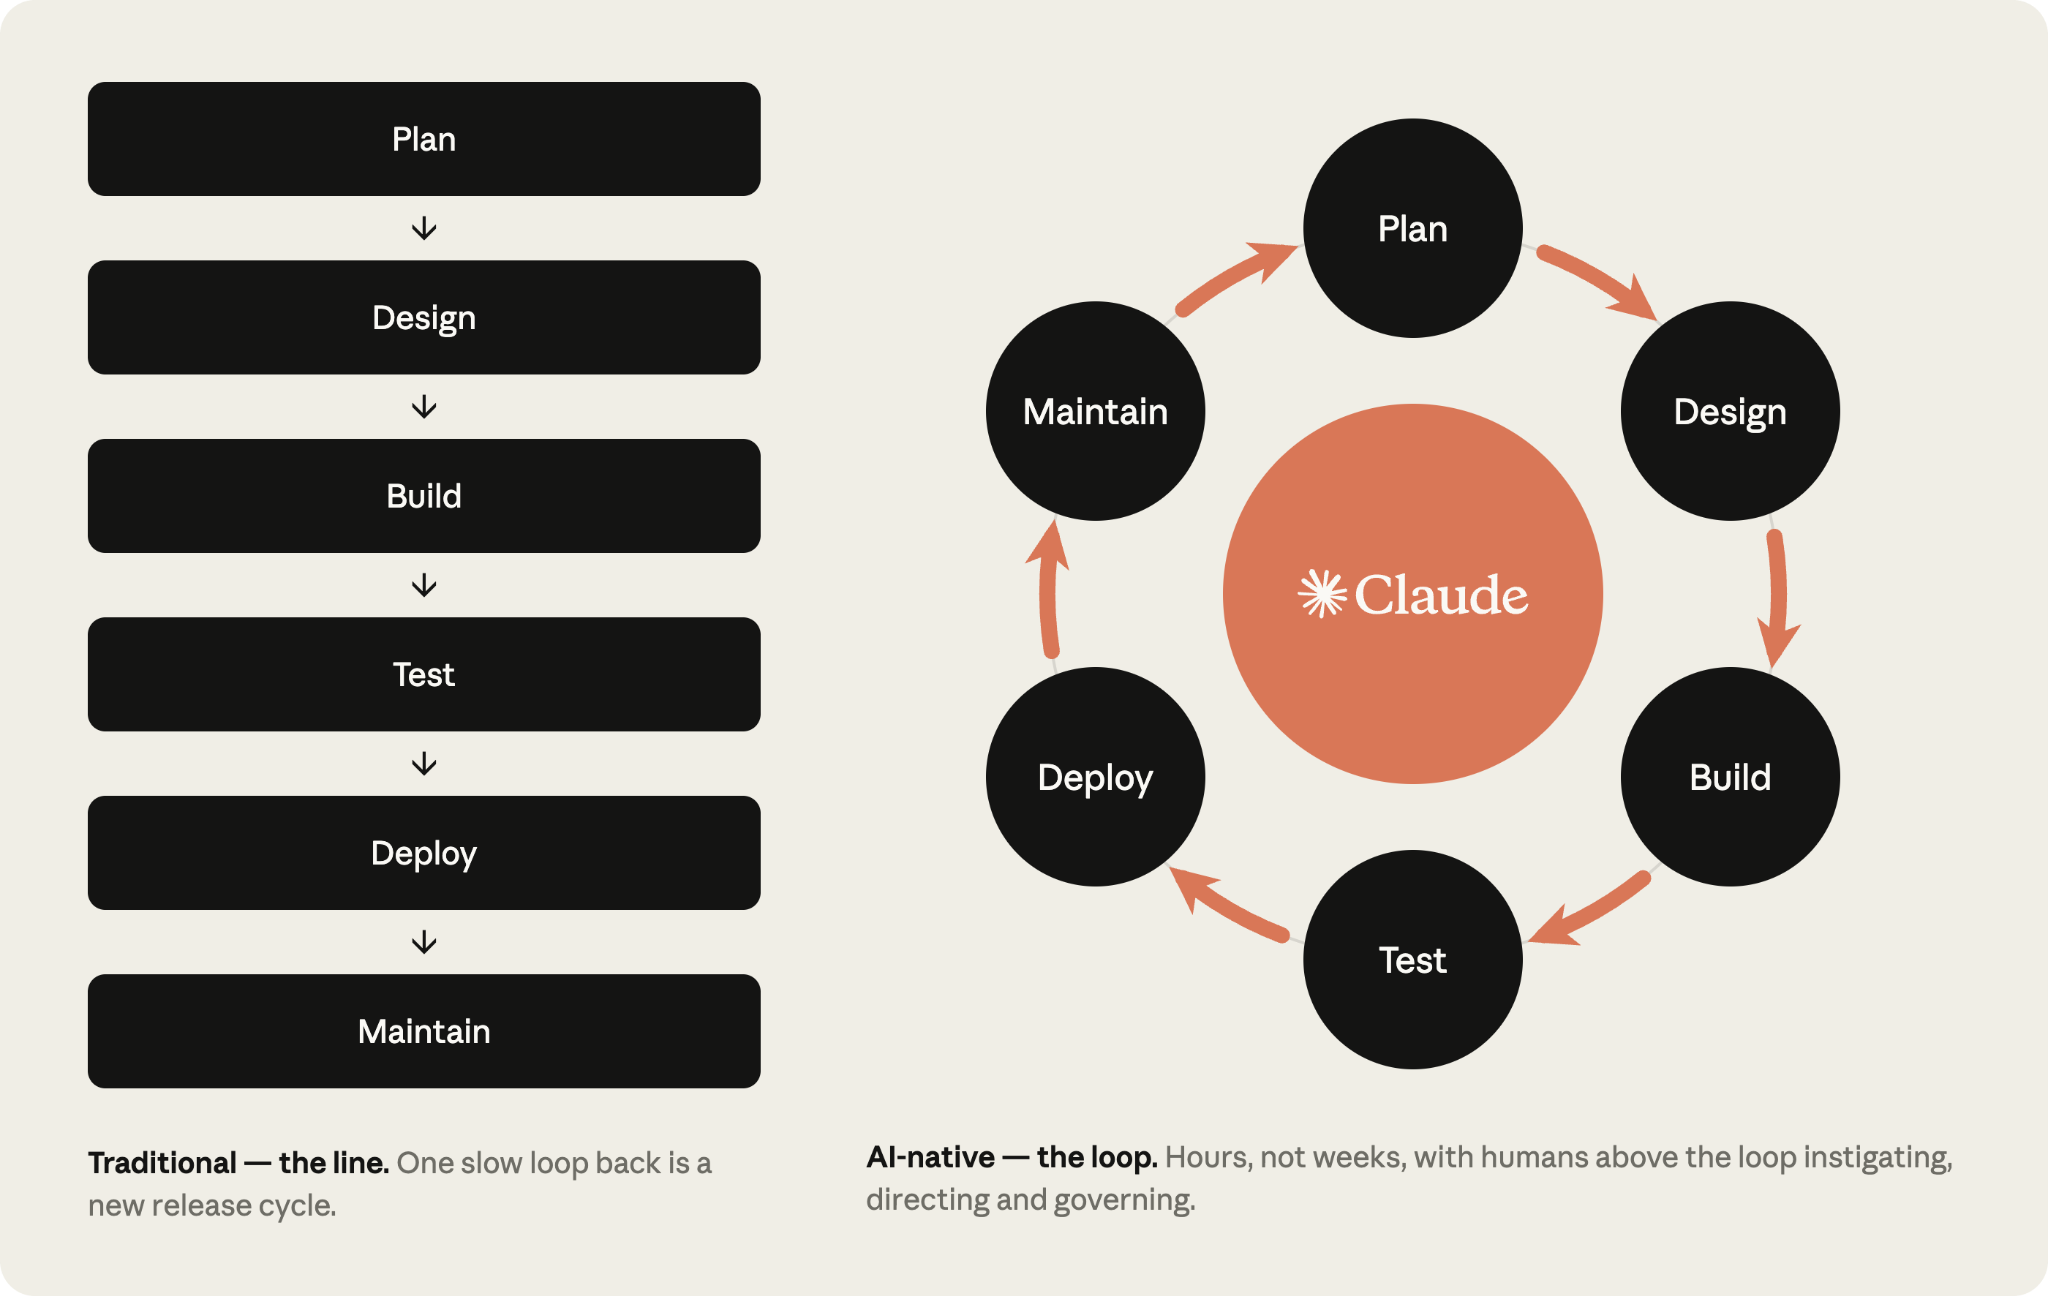
AI 네이티브 SDLC는 기존의 통제 목표를 새로운 방식으로 적용하도록 재설계된 프로세스다. 선형 흐름 대신 루프 구조를 취하며, AI가 각 지점에 내재된다. AI 네이티브 SDLC는 후속 플레이의 자동 인계와 트리거를 촉진함으로써, 전통적인 SDLC 단계 간 인계 과정에서 발생하는 수동적이고 번거로운 문제를 해소한다.
무엇이 달라지는가
아래 표는 전통적인 SDLC와 Claude 기반 AI 네이티브 SDLC 사이의 스펙트럼 양 끝단을 보여준다. 대부분의 조직은 두 열 사이 어딘가에 위치한다.
오른쪽 열을 관통하는 공통 요소는 커밋된 아티팩트(artifact)다. 각 단계는 아티팩트 하나를 버전 관리에 커밋하며 끝나고(intent.md, spec.md, plan.md, diff와 테스트, 리뷰 소견이 담긴 PR, 인시던트 기록 등), 다음 단계는 그것을 읽으며 시작한다. 초기 단계에서는 .md 파일이 주요 아티팩트인데, 프로덕트 오너와 에이전트 모두 동일한 파일을 읽고 실행에 옮길 수 있기 때문이다. 구현 단계부터는 코드와 그 기록이 아티팩트가 된다. 커밋 체인 자체가 감사 추적이기도 하다. 누가 무엇을 요청했고, 에이전트가 무엇을 산출했으며, 누가 승인했는지가 모두 기록된다.
판단이 필요한 모든 결정에 대한 책임은 여전히 사람에게 있다. 에이전트 SDLC 환경에서는 검토해야 할 아티팩트의 변화에 맞춰 사람의 주의도 함께 이동한다.
플레이
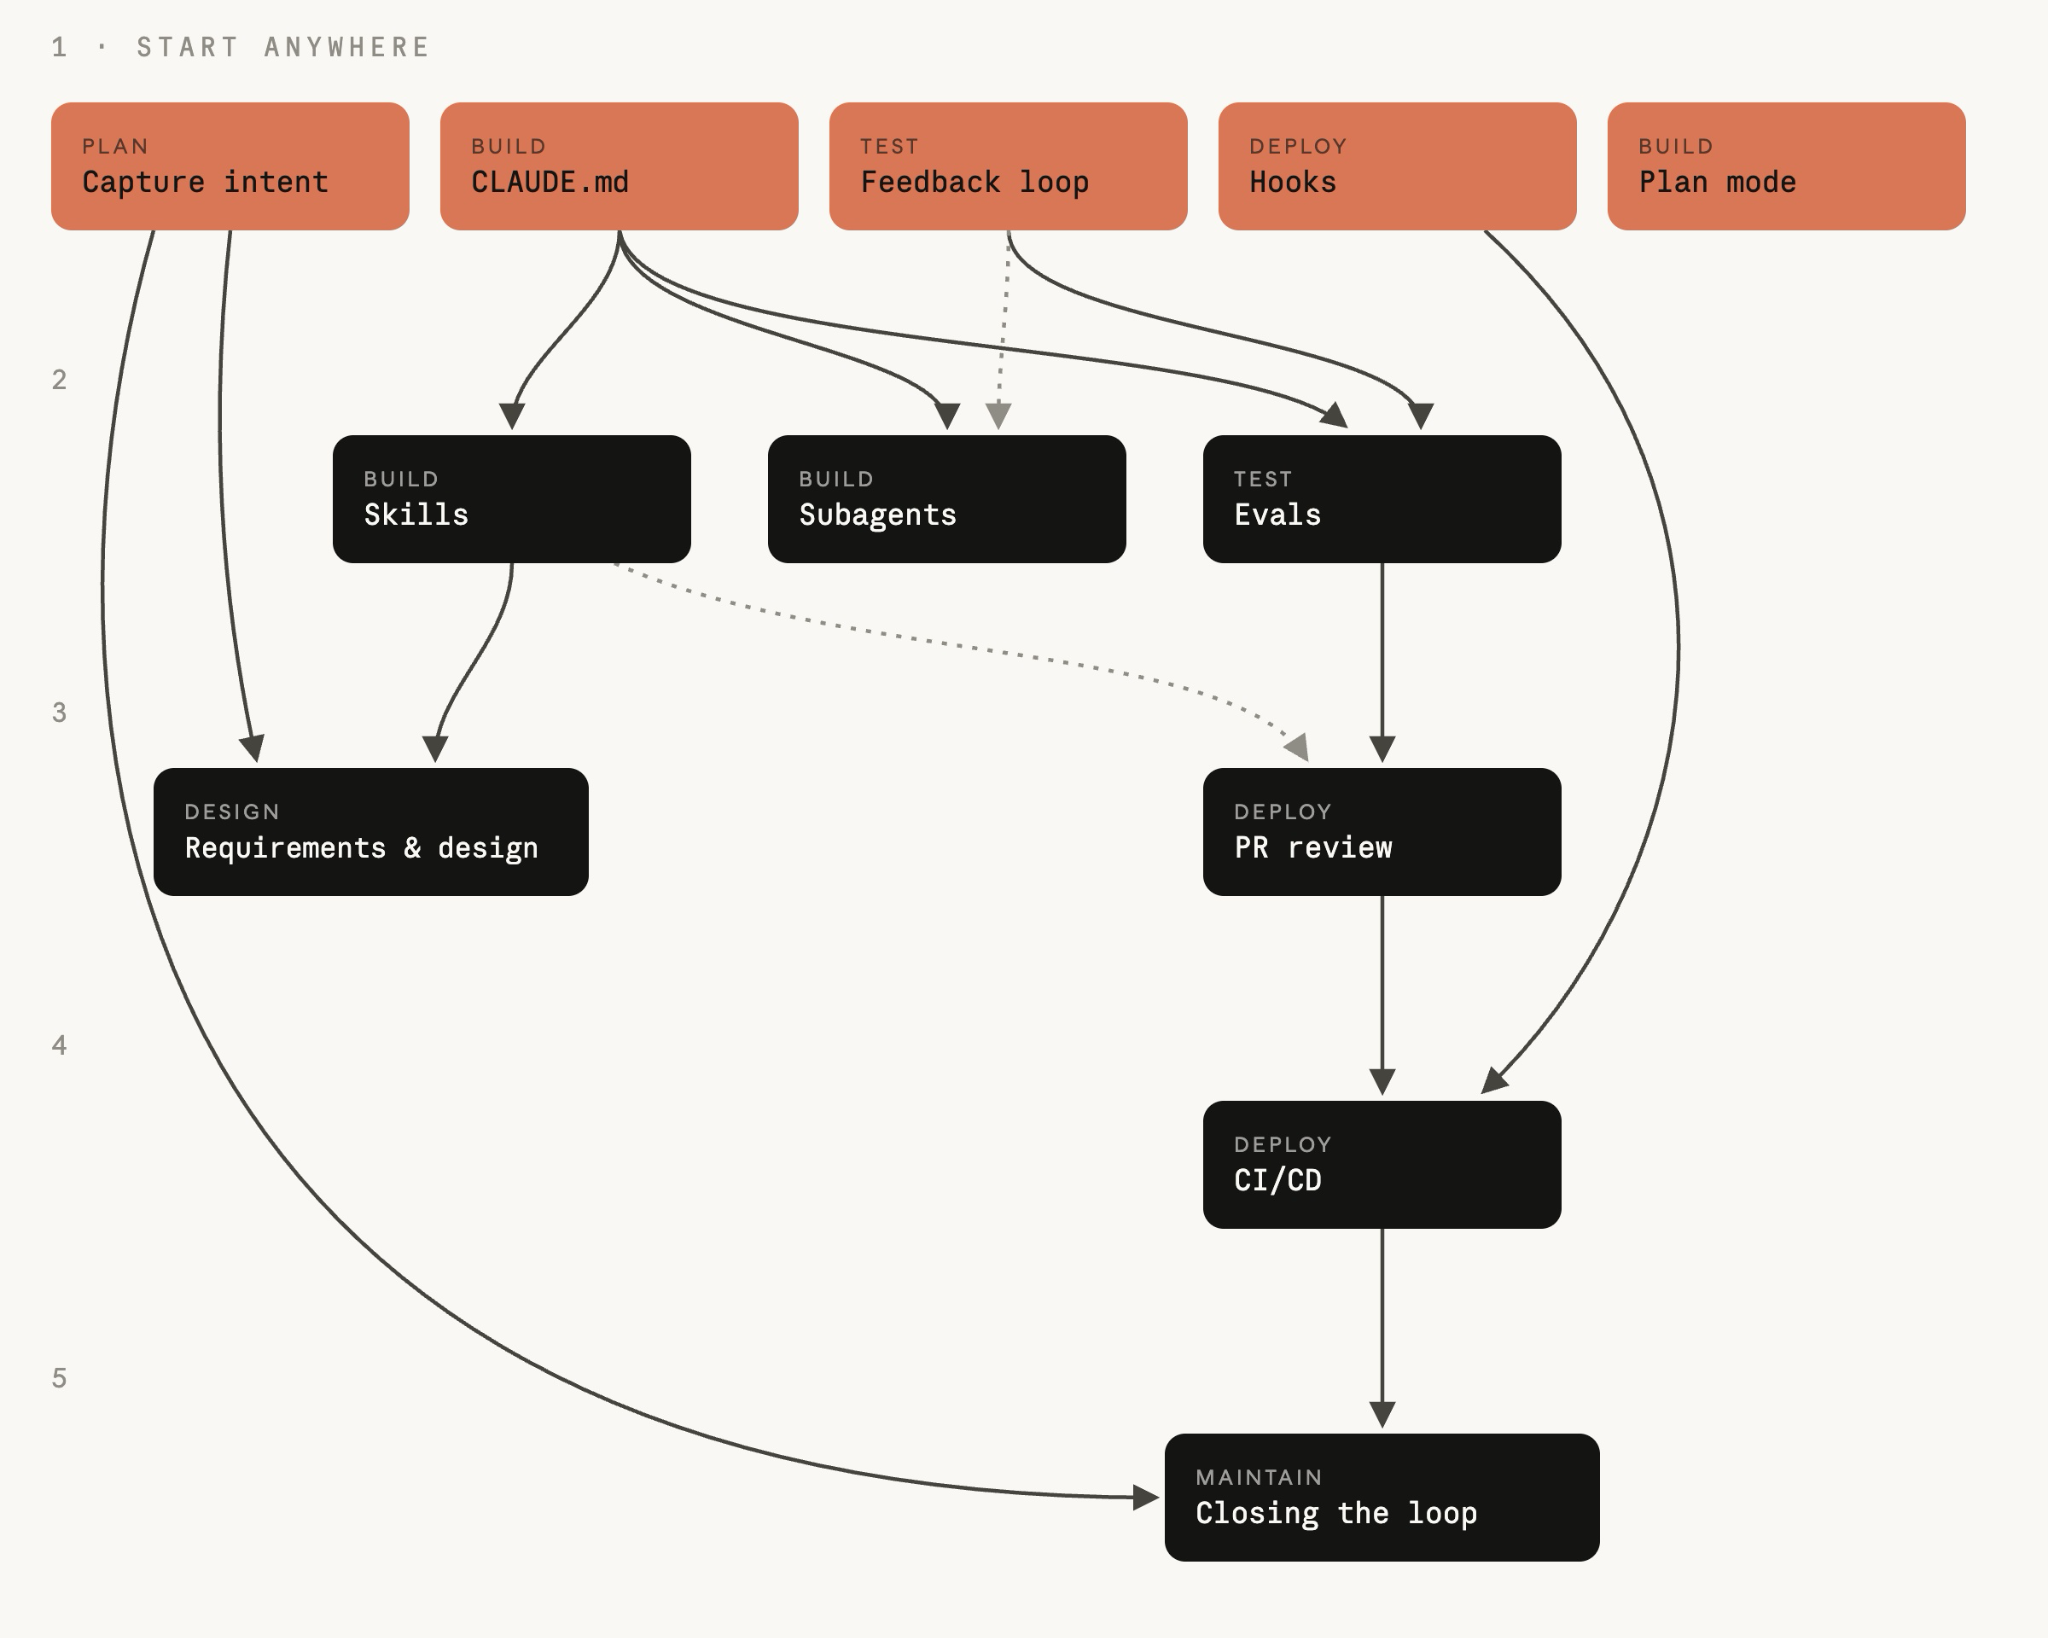
플레이는 플레이북의 핵심으로, 비선형적인 여섯 단계(기획, 설계, 구현, 테스트, 배포, 유지보수)로 구성되며, 전체 라이프사이클을 아우른다.
각 플레이에서 다루는 내용:
- 무엇이 달라지는가;
- 시작하는 방법;
- 구체적인 실행 단계;
- 거버넌스 고려사항; 그리고
- 효과를 어떻게 측정할 것인가.
각 플레이는 독립적으로 적용할 수 있으며, 조직은 고유한 필요에 따라 어느 단계를 먼저 혁신할지 선택할 수 있다. 각 플레이는 "전제조건" 항목에 의존 관계를 명시하며, 의존 관계 그래프가 이를 시각적으로 보여준다.
한 단계는 아티팩트를 커밋하며 끝나고, 그 커밋이 다음 단계를 시작시킨다. 승인된 intent.md은 요구사항 및 설계 단계를 트리거하고, 승인된 spec.md은 계획 모드를 시작시키며, 병합된 PR은 파이프라인을 구동하고, 프로덕션에서 통제 범위를 벗어난 사항은 다음 intent.md를 생성해 루프를 이어간다.
처음에는 각 단계를 수작업으로 프롬프트하고, 최종 상태는 승인된 아티팩트가 다음 관문을 자동으로 트리거하는 루프가 된다. 사람의 주의는 관문에 집중되며, 각 단계를 처음부터 시작하는 대신 에이전트가 플래그한 내용을 검토하는 데 쓰인다.
intent.md로 포착하기
소프트웨어 개발 프로세스를 시작하는 intent.md은 다양한 경로로 진입할 수 있다. 누군가 아이디어를 떠올리거나, 티켓이 등록되거나, 알림을 통해 인시던트가 드러나는 경우(6단계: 유지보수 참조)가 그 예다.
누군가 아이디어를 떠올리면, Claude와 함께 브레인스토밍을 하고 마크다운 프로토 스펙을 만든다. 전통적인 SDLC에서는 같은 사람이 프로덕트 팀 구성원을 설득해 함께 아이디어를 문서화하거나 대신 작성해달라고 요청해야 했다.
Claude가 생성한 프로토 스펙은 사람이 읽을 수 있고, 버전 관리가 되며, 다음 단계에서 즉시 활용할 수 있다. 프로토 스펙은 intent.md로 저장된다.
의도가 이벤트 트리거에서 비롯됐든 에이전트에서 비롯됐든, 동일한 절차가 적용된다. 프로덕트 오너가 에이전트가 작성한 intent.md를 검토하고 수정한 뒤 커밋한다.
이 설정은 플랫폼 또는 엔지니어링 팀이 한 번만 진행하면 된다. 조직 전반에서 다양한 기여자가 참여하게 되므로, 기술 팀원 한 명이 의도 저장소를 구축하고 쓰기 권한 대상을 결정해야 한다.
리포지토리가 구축되면, git 경험이 없는 기여자는 git을 직접 다루지 않아도 된다. 버전 관리 시스템(예: GitHub) 커넥터를 통해 Claude가 claude.ai나 Cowork에서 이들 대신 마크다운 파일을 커밋할 수 있다.
실행 방법
- 발안자가 자신의 언어로 Claude에게 문제를 설명한다. 오늘 할 수 없는 것, 영향을 받는 사람, 나아진 상태가 어떤 모습인지, 범위에서 제외되는 것 등을 자유롭게 이야기하면 된다. 격식체나 전문 용어가 필요하지 않다.
- 아이디어가 구체화될 때까지 브레인스토밍한다. Claude는 분석가라면 물어볼 법한 질문들, 즉 범위, 사용자, 제약 조건, 성공 기준에 대해 묻는다.
- 조직의 템플릿(기술 팀원이 설정하고 리드가 승인한 스킬로 인코딩 가능)을 사용해 결과를
intent.md으로 작성해달라고 Claude에게 요청한다. 여기에는 문제, 제안된 결과물, 영향받는 사용자와 시스템, 제약 조건, 미결 사항이 포함될 수 있다. - Claude가 잘못 이해한 부분을 발안자가 수정한다.
intent.md을 공유 저장소에 커밋한다. 작성자와 타임스탬프가 기록에 남고, 프로덕트 오너가 그 시점부터 아이디어를 이어받는다.
# Intent: claims status self-service
Author: J. Ortiz (claims operations). Status: draft.

## Problem
Customers phone the contact center to ask where their claim is.
Handlers spend roughly a third of call time on status-only queries.

## Proposed outcome
Customers see claim status, next step and expected date in the portal.

## Affected users and systems
Claims handlers, portal team, claims-core API.

## Constraints
No new PII in the portal session. Existing authentication only.

## Open questions
Do third-party loss adjusters need access too?
거버넌스 고려사항
증거는 커밋된 intent.md로, 작성자, 타임스탬프, 전체 수정 이력이 기록되며 의도 저장소의 git 히스토리에 로깅된다. 프로덕트 오너가 승인하고, 의도를 2단계: 설계로 진행시키거나 반려하는 결정은 병합 또는 클로징 리뷰로 기록된다.
요구사항과 설계
프로덕트 오너가 승인하면, Claude는 수락된 intent.md를 바탕으로 요구사항 및 설계 스펙을 작성한다. 이 과정은 브랜드, 보안, 컴플라이언스, UX에 관한 조직의 스킬을 기준으로 이루어진다.
프로덕트 오너는 스펙을 직접 작성하는 것이 아니라 검토한다. 이 프로세스의 목표는 엔지니어링 팀이 기획에 활용할 수 있는 스펙을 생성하되, 우려 사항을 명확히 플래그한 상태로 전달하는 것이다.
프론트엔드 작업이 가장 명확한 예다. intent.md가 수락되면, 프로덕트 오너가 intent.md을 바탕으로 Claude Design(베타)에서 목업을 만들고 반복 작업을 거친 뒤, Claude Code로 내보내 구현하면 된다.
실행 방법
- 프로덕트 오너가 조직의 스킬이 로드된 세션을 열고
intent.md를 첨부한다. - 프로덕트 오너의 프롬프트는
intent.md을 가리키고, 제약 조건을 명시하며, 우려 사항에 플래그를 요청한다. 처음에는 수작업으로 실행한 뒤, 조직 수준의 슬래시 명령어로 체계화한다. 이후에는 의도 저장소에서intent.md이 수락되는 시점을 트리거로 삼아, 병합 시 발동하는 비대화형 작업이 조직의 스킬을 로드한 상태로 실행하고spec.md를 풀 리퀘스트(PR)로 커밋하도록 설정한다(5단계: 배포의 CI/CD 플레이에서 연결 방법을 다룬다). 이 시점부터 프로덕트 오너는 리뷰 단계에서 처음 관여하게 된다. - 같은 프로덕트 오너가 아이디어를 기준으로 스펙을 검토한다. 스펙이 명시된 문제를 해결하는지,
intent.md에서 제기된 미결 사항이 해소되었거나 이월되었는지 확인한다. - 플래그된 우려 사항부터 처리한다. 분석가라면 에스컬레이션했을 지점이기 때문이다. 프로덕트 오너는 엔지니어링 팀이 스펙을 받아보기 전에 각 사안을 담당 정책 오너와 함께 해결한다.
spec.md를intent.md와 함께 커밋한다. 두 파일 쌍이 요청한 내용과 결정된 사항을 함께 기록한다.- 프로덕트 오너가 스펙과 의도를 구현 단계로 진행할지 결정한다. 조직에서 더 높은 위험으로 분류한 사항은 기술 리드와 상의한다. 이 결정은 항상 사람이 내리며, 스펙을 수락하는 것이 3단계: 구현의 계획 모드 플레이를 시작하는 신호가 된다.
실제 모습 (프롬프트)
Read the attached intent.md and produce a requirements and design spec for integrating it into our existing codebase. Apply the skills available to you so the plan conforms to our brand guidelines, security policies and UX standards. Document the spec fully as spec.md, ready to hand to the engineering team. Describe clearly any areas of concern, especially where you cannot satisfy contradicting policies.거버넌스 고려사항
라이브 정책은 몇 주 뒤 리뷰에서 발견되는 것이 아니라, 스펙을 작성하는 순간 읽히고 적용된다. 조직의 스킬이 스펙의 제약 조건으로 적용되며, 스펙과 이를 생성한 프롬프트, 그 시점에 유효했던 스킬 버전이 모두 버전 관리에 기록된다. 프로덕트 오너가 스펙에 서명하고, 플래그된 우려 사항을 담당 정책 오너에게 전달한다.
Claude Code 계획 모드를 기본 시작점으로
엔지니어는 계획 모드로 Claude Code 세션을 시작하고, 2단계: 설계에서 승인된 spec.md을 Claude에게 제공한 뒤, 계획이 만족스러울 때까지 Claude와 함께 반복적으로 검토한다.
실행 방법
- 엔지니어가 Claude와 함께 계획 모드로 세션을 시작한다.
- 엔지니어가 Claude에게
intent.md과spec.md을 제공하고, 변경할 파일, 작업 순서, 검증에 필요한 테스트를 명시한 구현 계획을 작성해달라고 요청한다. - 이 변경이 무엇을 깨뜨릴 수 있는지, 가장 위험한 단계는 무엇인지, Claude가 선택하지 않은 다른 방안은 무엇인지 질문하며 계획을 검토한다.
- 이 대화를 전혀 보지 못한 엔지니어도 계획만 보고 변경을 구현할 수 있을 때까지 반복한다.
- 승인된 계획을
plan.md로 커밋한다. 계획은 감사 추적에 포함되며, 배포 단계의 PR 리뷰 플레이(5단계: 배포)에서 최종 diff와 대조하는 데 활용된다. - 계획을 수락하고 Claude가 구현을 진행하도록 한다. 계획이 탄탄하면 구현은 대개 한 번의 패스로 완료된다.
- 구현이 계획에서 벗어나는 경우, 동일 커밋에서
plan.md를 함께 업데이트한다. 훅을 활용해 두 파일의 동기화를 강제하는 방법도 고려할 수 있다.
실제 모습 (plan.md)
# Plan: claims status self-service (from intent.md 2026-06-02)

## Files that change
portal/src/claims/StatusPanel.tsx (new), claims-api/routes/status.py,
claims-api/tests/test_status.py

## Order of work
1. Add the status endpoint behind existing auth.
2. Panel against the endpoint.
3. Wire into the portal nav.

## Risks
The claims-core API rate-limits at 50 rps; the panel must cache.

## Proof
test_status.py covers the four claim states; screenshot matches the
approved mock.
거버넌스 고려사항
설계 리뷰는 코드가 한 줄도 생성되기 전, 즉 방향 수정이 문서 편집만으로 가능한 시점에 이루어진다. 계획 모드 자체가 이를 강제하는데, 엔지니어가 계획을 수락하기 전까지 Claude는 파일을 편집할 수 없기 때문이다. 계획과 그 수정 내역, 승인자가 함께 기록된다. 일반적인 변경은 엔지니어가 승인하고, 조직에서 더 높은 위험으로 분류한 사항은 기술 리드나 아키텍트에게 전달된다.
Claude Code 자동 모드
Claude Code는 자동 모드로도 실행할 수 있다. 엔지니어가 계획을 승인하고 반복 검토를 마치면, Claude가 편집 시마다 확인을 요청하지 않고 각 변경 사항을 스스로 적용한다. 이후 단계의 가드레일이 성숙할수록(잘 조정된 CLAUDE.md, 정책을 인코딩한 스킬, 안전하지 않은 행동을 차단하는 훅, Claude가 실행할 수 있는 테스트 스위트), 자동 수락은 범위가 좁은 spec.md, 영향 반경이 작은 변경, 테스트가 이미 커버하는 코드 등 일상적인 작업의 기본값이 된다.
이제 사용자가 에이전트의 편집 과정을 지켜보고 행동을 검토하는 방식에서, 더 긴 자율 세션이 끝난 뒤 아티팩트를 검토하는 방식으로 전환된다. 자동 수락 모드는 worktree와 함께 사용할 때 개인 및 팀 차원의 병렬 작업을 더욱 가능하게 하며, 6단계: 유지보수에서 설명하는 대로 SDLC를 자율적으로 실행하고 루프를 닫는 데 핵심적인 역할을 한다.
CLAUDE.md
CLAUDE.md는 Claude에게 새로 합류한 팀원이 알아야 할 맥락, 즉 컨벤션, 명령어, 아키텍처, 팀이 자주 겪는 실수를 알려준다. 사람들의 머릿속과 위키에 흩어져 있던 지식이 에이전트가 매 세션 시작 시 읽는 하나의 파일로 집약되며, 팀 전체가 함께 관리하고 실수가 발생할 때마다 업데이트한다.
실행 방법
- 리포지토리에서
/init를 실행한다. Claude가 발견한 내용을 바탕으로 초기CLAUDE.md를 생성한다. - 생성된 파일에서 새로 합류한 팀원이 첫날 필요한 내용만 남긴다. 빌드, 테스트, 린트 명령어, 중요한 컨벤션, Claude가 자주 틀리는 사항을 유지한다.
- 팀 전체가 하나의 버전을 공유하고 코드처럼 변경 사항을 리뷰할 수 있도록,
CLAUDE.md을 리포지토리 루트에 git으로 커밋한다. - 실용적인 규칙이 하나 있다. Claude가 같은 실수를 두 번 하면, 그 수정 사항을
CLAUDE.md에 반영한다. - Claude가 세션 시작 시 전체를 읽으며 오래된 내용은 불필요하게 컨텍스트를 차지하므로, 한 페이지 이내로 유지한다.
실제 모습 (CLAUDE.md)
# Payments service

## Commands
- Build: make build
- Test: make test (unit), make itest (integration, needs docker)
- Lint: make lint (runs in CI; fix before pushing)

## Conventions
- Java 21, Spring Boot 3. No new Lombok.
- Money is always BigDecimal, never double.
- Every endpoint needs an integration test in src/itest.

## Architecture
- api/ holds REST controllers, core/ holds domain logic,
  adapters/ talks to external systems.
- Kafka events are defined in schemas/; never edit generated classes.

## Things Claude gets wrong
- Do not bump dependency versions; the platform team owns them.
- The legacy v1/ package is frozen; changes go in v2/.
거버넌스 고려사항
CLAUDE.md은 버전 관리되므로 에이전트가 따르는 지침을 검토하고 감사할 수 있다. 팀 컨벤션이 이 파일을 통해 적용되고, 변경 사항은 git 히스토리에 기록되며, 코드 오너가 PR 리뷰에서 변경을 승인한다.
조직의 집단 지식으로서의 스킬
스킬은 조직이 집단 지식을 실제로 작동하게 만드는 방법이다. 지침이 명시적이고, 버전 관리되며, 폭넓게 적용되고, 정책이 바뀔 때 중앙에서 한 번에 업데이트된다. 기준은 간단하다. 일관되게 적용해야 하는 집단 지식에는 스킬을 작성하고, CLAUDE.md이나 프롬프트에 속하는 컴포넌트에는 스킬을 작성하지 않는다.
실행 방법
- 현재 일관성 없이 적용되는 지식 하나를 선택한다. 보안 표준, API 설계 컨벤션, 브랜드 규칙 등이 예가 될 수 있다.
- 이를 스킬로 작성한다. 스킬은 폴더 안에
SKILL.md하나로 구성되며, 프론트매터(frontmatter)에 트리거 조건을 명시하고 본문에 수행할 작업을 기술한다. 엔지니어가 Claude의 도움을 받아 정책 오너의 단일 정보 출처를 바탕으로 작성한다. - 코드와 함께 배포되도록 리포지토리의
.claude/skills/<name>/에 스킬을 저장하거나, 플러그인을 통해 조직 전체에 배포한다. - 스킬이 제대로 트리거되는지 테스트한다. Claude에게 다양한 방식으로 관련 작업을 요청하고, 매번 스킬이 로드되는지 확인한다.
- 정책이 바뀌면 스킬을 수정하고 정책 오너의 승인을 받는다.
- 엔지니어는 다음 세션부터 자동으로 새 버전을 적용받는다.
실제 모습 (.claude/skills/secure-api-review/SKILL.md)
---
name: secure-api-review
description: Apply the API security standard. Use whenever creating or
  modifying an external-facing endpoint, reviewing API code, or
  generating an OpenAPI spec.
---
# Secure API review

When you create or change an API endpoint:
1. Authentication: every endpoint requires the gateway JWT;
   no anonymous routes outside /health.
2. Input validation: validate request bodies against the OpenAPI
   schema and reject unknown fields.
3. Audit: every state-changing endpoint emits an audit event with
   actor, action, entity and timestamp.
4. Data classification: fields tagged pii in the schema must never
   appear in logs or error messages.

Run scripts/check-endpoints.sh and include its output in your summary.
거버넌스 고려사항
스킬은 통제 수단이지만, 권고 성격의 통제다. 코드를 작성하는 동안 Claude가 정책을 적용할 가능성을 높여주지만, 세션이 반드시 이를 따르도록 강제하지는 않는다. 반드시 적용되어야 하는 정책은 스킬 뒤에 결정론적인 장치가 필요하다. 예를 들어 해당 행동을 차단하는 훅이나 PR 단계에서 정책을 재확인하는 리뷰 패스가 있다. 스킬이 위반을 드물게 만들고, 훅이 위반을 거의 불가능하게 만든다. 스킬 호출은 세션 추적 기록에 남으며, 정책 오너가 스킬 변경 사항을 코드처럼 리뷰한다.
빌드 타임 가드레일로서의 훅
스킬이 권고성 통제라면, 훅은 그 뒤에 있는 결정론적 레이어다. Claude가 구현 중 수행하는 행동 대부분은 파일 편집과 셸 명령어이므로, 구현 단계에서 훅이 가장 자주 실행된다.
구현 단계 훅으로 할 수 있는 것:
- 생성된 클래스나 고정된 패키지 등 보호된 경로 편집 차단;
- 파일 편집 후 포매터와 린터를 자동 실행해 코드 스타일 불일치가 쌓이지 않도록 방지;
- diff에 크리덴셜이 포함되지 않도록 차단.
예외 없이 반드시 적용되어야 하는 정책이 있는 스킬 뒤에는 훅을 적용한다. 훅은 매칭되는 행동마다 실행되므로, 구현 단계 훅은 빠르게 실행되고 변경된 파일에만 범위를 한정해야 한다. 전체 테스트 스위트처럼 무거운 검사는 커밋이나 PR 단계에 적합하다.
사람의 승인을 요청하는 훅은 5단계: 배포의 관문 플레이에서 다뤄야 한다. 구현 중 승인 프롬프트가 발생하면 병렬로 실행 중인 모든 세션의 크리티컬 패스에 사람이 다시 개입하게 되기 때문이다.
병렬 세션과 서브에이전트
엔지니어 한 명이 여러 작업 흐름을 동시에 진행할 수 있다.
병렬 세션은 별도의 git worktree에서 독립된 작업을 수행하는 또 다른 Claude Code 인스턴스다. 각 독립 세션은 서로의 존재를 알지 못하며, 이를 조율하는 엔지니어만이 공통 요소다.
서브에이전트는 단일 세션 안에서 자체 컨텍스트 윈도우와 도구 제한을 갖춘 범위 한정 도우미로 실행되며, 애플리케이션이 예상대로 동작하는지 확인하는 것처럼 여러 작업에 반복적으로 등장하는 작업에 적합하다.
병렬 세션은 한 엔지니어가 동시에 진행할 수 있는 작업 수를 늘려주고, 서브에이전트는 각 세션이 자신의 작업에 집중하도록 돕는다. 엔지니어의 역할은 이 모두를 조율하고 검토하는 것이다.
실행 방법
- 엔지니어가 서로 다른 파일을 건드리는 작업으로 분리한다. 계획 모드 플레이(3단계: 구현)에서 작성한 계획을 활용해 어떤 작업이 독립적인지 파악한다. 같은 파일을 공유하는 작업은 단일 세션에서 순차적으로 처리한다.
- 각 병렬 작업에 별도의 worktree를 할당한다. 예를 들어 하나의 터미널에서
claude --worktree feature-auth를, 다른 터미널에서claude --worktree fix-rate-limit을 실행한다. worktree는 자체 브랜치에서의 별도 체크아웃으로, 세션 간 파일 충돌을 방지한다. - 세션 두세 개가 시작점으로 적당하다. 현실적인 상한선은 한 사람이 제대로 검토할 수 있는 흐름의 수이므로, 검토가 따라가는 동안에만 세션을 추가한다.
- 반복 작업은 서브에이전트로 전환한다.
.claude/agents/의 마크다운 파일로 정의하며, 각 파일에 이름, 언제 사용할지 설명, 사용 가능한 도구를 명시한다. 예시로는 메인 에이전트가 완료한 후 불필요한 복잡성을 제거하는 코드 단순화 에이전트, 앱을 실행해 동작을 확인하는 검증 에이전트, 메인 컨텍스트를 넘치게 하지 않으면서 코드베이스를 탐색하고 결과를 보고하는 리서치 에이전트 등이 있다. 팀 전체가 공유할 수 있도록 정의 파일을 git에 커밋한다.
실제 모습 (.claude/agents/verifier.md)
---
name: verifier
description: Runs the app and checks the change works before the session
  reports done
tools: Bash, Read
---
Start the app with make run. Exercise the changed behavior and the two
nearest neighboring flows. Report what you ran, what you saw, and any
behavior that does not match plan.md. Do not fix anything; report only.
거버넌스 고려사항
세션이 많아질수록 산출물도 늘어나므로, 통제는 리포지토리의 설정에서 나와야 한다. 훅과 권한 설정은 모든 세션에 동일하게 적용되며, 세션이 수행한 작업은 기록되고 실행한 엔지니어에게 귀속된다.
Claude에게 피드백 루프 제공하기
테스트, 빌드, 스크린샷 비교 등 어떤 방식이든 Claude가 자신의 작업을 직접 검증할 수 있는 방법을 항상 제공한다. 이를 통해 세션이 엔지니어에게 전달되기 전에 스스로 작업을 확인하고 실수를 수정한다.
피드백 루프를 검증 서브에이전트(3단계: 구현)와 혼동해서는 안 된다. 피드백 루프는 작업 전반에 걸쳐 작업만큼의 횟수로 반복 실행된다. 반면 검증 서브에이전트는 세션이 작업을 완료했다고 판단한 뒤 새로운 컨텍스트 윈도우로 최종 확인을 수행하는 방식으로, 코드를 생성한 가정에 영향받지 않은 결론을 내린다.
실행 방법
- 현재 작업 확인에 여러 명령어와 환경 지식이 필요하다면, 실패 시 비정상 종료하는 단일 타깃(예: "make test" 또는 "npm test")으로 래핑한다.
CLAUDE.md의 Commands 섹션에 각 명령어와 정상 출력 예시를 함께 기재한다.- Claude가 직접 물어보지 않고 작업을 확인할 수 있도록, 정량적으로 확인 가능한 목표를 명시한다. 예를 들어 "test_status.py의 모든 테스트가 통과한다", "스크린샷이 첨부된 목업과 일치한다", "엔드포인트가 새로운 필드와 함께 200을 반환한다" 등이 있다.
- 버그 수정의 경우, 먼저 실패하는 테스트를 작성한다. Claude에게 버그를 테스트로 재현하도록 요청하고, 실행해서 예상한 이유로 실패하는지 확인한 뒤 해당 테스트를 커밋한다. 그 다음에만 테스트를 수정하지 말고 테스트를 통과시키도록 Claude에게 요청한다. 마지막 단계의 테스트 파일 훅이 이 제한을 강제한다. 수정 전에 존재했고 에이전트가 수정할 수 없었던 테스트는 버그가 사라졌다는 증거가 된다.
- UI 작업의 경우, 시각적 확인으로 루프를 닫는다. Claude에게 브라우저나 스크린샷 도구와 목업을 제공하고 반복하게 한다. 구현, 스크린샷, 비교, 수정의 과정을 거치며 두세 번의 반복이 일반적이고, 매 반복마다 결과물이 개선되어야 한다.
- 검증을 "완료"의 일부로 만든다. 지침은
CLAUDE.md에 둔다. 작업이 완료됐다고 보고하기 전에 테스트를 실행하고, 그 결과를 보여주도록 한다. - 마지막으로, 루프 자체를 보호해야 한다. 코드를 수정하는 에이전트가 해당 코드에 대한 검사를 약화시켜서는 안 되기 때문이다. 수정 작업 중 테스트 파일 편집을 차단하는 훅이 이를 방지한다. 대안은 리뷰에서 diff를 확인하고 테스트를 건드리는 변경을 거부하는 것이다.
실제 모습 (CLAUDE.md 검증 블록)
## Verifying your work

- Build: make build (must finish with "Build succeeded")
- Test: make test (all green; never skip or delete a failing test)
- Lint: make lint (zero warnings)

Run all three before reporting any task complete, and paste the output.
If a test fails, fix the code, not the test.CI에서 지속적 평가
평가(eval)는 단계 관문 QA의 AI 네이티브 버전이다. 실제로는 에이전트 설정이 변경될 때마다 실행되는 스위트를 의미한다. 새로운 모델로 교체하거나 프롬프트를 수정할 때, 평가 스위트가 에이전트가 동일한 수준으로 작업을 수행하는지 알려준다.
평가는 살아있는 스위트로 봐야 한다. 모델이 개선되면서 한때 변별력이 있던 케이스가 더 이상 효과적이지 않게 되고, 지속적인 모니터링에서 나타나는 새로운 케이스를 추가해야 한다.
사용 사례에 따라, 변경 시마다가 아닌 정해진 주기로 오프라인에서 평가를 실행하는 것을 선호하는 팀도 있다. 아래 단계는 지속적 평가를 기준으로 작성되었다.
실행 방법
- 플랫폼 엔지니어가 최근 작업에서 실제 태스크 20~50개를 예상/승인된 결과물과 함께 수집한다.
- 각 태스크를 평가로 작성한다. 즉, 프롬프트와 함께 허용 기준을 정의하는 검사 항목(테스트 통과, 린트 클린, 동작 유지, 정책 준수)을 함께 작성한다.
- 스위트는 CI에서 스케줄에 따라 비대화형으로 실행되며,
CLAUDE.md이나 스킬, 훅이 변경될 때마다 실행된다. 이 설정이 에이전트의 동작 방향을 결정하는 만큼, 코드에 적용하는 것과 동일한 수준의 회귀 테스트가 필요하다. - 설정 변경은 결과에 따라 관문을 통과해야 한다. 통과율을 떨어뜨리는 스킬 변경은 머지 전에 검토를 거친다.
- 프로덕션 인시던트가 발생할 때마다 해당 인시던트를 담당한 팀이 평가를 작성하고, 이를 회귀 테스트로 스위트에 영구 등록한다.
실제 예시 (.github/workflows/agent-evals.yml)
name: Agent evals
on:
  pull_request:
    paths: ['CLAUDE.md', '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: Run eval suite
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
거버넌스 고려사항
평가는 에이전트 출력을 따라잡는 QA 관문 역할을 한다. 통과율 임계값은 머지 검사로 강제 적용되고, 실행 결과는 로그로 남아 시간에 따른 추이를 비교할 수 있으며, 설정 변경의 소유 팀이 직접 승인한다.
PR 리뷰 루프에서의 AI
Claude는 리뷰를 주기도 하고 받기도 한다. 조직의 정책에 따라 인입되는 PR을 검토하고, 자신이 작성한 PR에 달린 리뷰 코멘트도 직접 처리한다. 덕분에 엔지니어는 PR 리뷰에서 의도와 위험 판단이라는 본질적인 부분에만 집중할 수 있다.
실행 방법
- 관리형 코드 리뷰 서비스가 가장 빠른 시작 방법이다. 관리자가 활성화하고 저장소를 선택하면 된다. 파이프라인 제어가 필요하거나 API 호출을 자체 클라우드 계약으로 라우팅하려면 claude-code-action으로 자체 CI에서 리뷰를 실행한다(배포 방법은 CI/CD 플레이 참조).
- 테크 리드는 리뷰 정책을 저장소 루트의
REVIEW.md에 작성한다. 조직이 중요하게 여기는 패스별로 구성한다: 버그와 논리 오류, 보안과 취약점, 요구사항 플레이의spec.md과 플랜 모드 플레이의plan.md, 설계 원칙에 대한 스펙 준수 여부.REVIEW.md에는 닛(Nit)과 구별되는 중요(Important) 기준, 그리고 건너뛸 항목도 함께 정의한다. - 테크 리드가 사람 개입 기준을 설정한다. 발견 사항 자체가 PR을 승인하거나 블록하지는 않으며, 브랜치 보호는 여전히 코드 오너의 승인을 요구한다. 발견 사항에 따라 머지를 관문으로 막고 싶은 플랫폼 엔지니어는, 체크 실행이 기계 가독 형식으로 게시하는 심각도별 카운트를 활용하면 된다.
- 리뷰어나 작성자가 리뷰 코멘트에
@claude을 태그하면, Claude가 해당 코멘트를 처리하고 수정 사항을 푸시한다. PR 스레드에는 요청과 변경 내용이 모두 기록된다. 이 수정 루프는 claude-code-action을 통해 실행된다. 관리형 서비스에서는@claude review을 댓글로 달면 대신 새 리뷰를 요청한다. Claude가 직접 연 PR의 경우, Claude가 PR을 끝까지 관리해 머지하도록 설정할 수 있다. 팀은 이 루프를 커스텀 슬래시 커맨드로 감싸 PR의 미해결 리뷰 코멘트와 실패한 체크를 일괄 처리하고 수정 사항을 푸시한다. 이 과정은 PR이 초록불이 되어 코드 오너 승인만 남을 때까지 반복된다. - 리뷰 발견 사항은
CLAUDE.md에 피드백된다. 같은 실수가 두 번째로 지적되면, 해당 리뷰의 일환으로 수정 내용이CLAUDE.md에 추가된다. 리뷰가CLAUDE.md를 읽기 때문에, 다음 PR부터는 같은 실수가 바로 잡힌다. 또한 변경으로 인해CLAUDE.md이 오래된 정보가 되었을 때도 리뷰가 이를 표시해준다. - 테크 리드는 월 1회 발견 사항을 평가해 리뷰어 품질을 개선하고,
REVIEW.md에서 닛 볼륨을 조정하는 방식으로 설정을 튜닝한다. 자동 생성 경로와 CI가 이미 강제하는 항목은 제외 처리한다.
실제 예시 (REVIEW.md)
# Review instructions

## Passes
Run three passes and tag each finding with its pass:
- Bugs: logic errors, broken edge cases, subtle regressions
- Security: injection risks, authentication gaps, PII in logs
- Compliance: the change matches spec.md, plan.md and our design principles

## What Important means here
Reserve Important for findings that would break behavior, leak data
or breach a policy. Style and naming are nits.

## Cap the nits
Report at most five nits per review; summarize the rest as a count.

## Do not report
Generated files under src/gen/ and anything CI already enforces.
거버넌스 고려사항
직무 분리 원칙이 유지된다. 코드를 작성한 에이전트는 해당 코드를 승인할 수 없기 때문이다. REVIEW.md의 리뷰 정책은 모든 PR에 동일하게 적용되며, 발견 사항·수정·평가·승인이 PR 히스토리에 모두 기록되므로 PR 자체가 감사 기록이 된다. 최종 승인은 브랜치 보호를 통해 사람이 하되, 발견 사항을 참고해 판단한다.
승인 관문으로서의 훅
빌드 단계에서 훅은 사람 개입 없이 행동을 허용하거나 차단하는 가드레일로 활용되었다(3단계: 빌드). 훅은 행동을 일시 중단하고 특정 담당자의 승인을 기다리도록 요청할 수도 있는데, 이것이 릴리즈 관문에 필요한 기능이다.
이 플레이는 릴리즈 관문이 가장 명확한 사례이므로 5단계(배포)에 배치했지만, 훅이 배포에만 국한되지는 않는다. 훅은 Claude가 행동하는 어느 곳에서나 실행된다. 예를 들어 3단계(빌드)에서는 변경 티켓 없이 마이그레이션이나 인프라를 편집하는 것을 차단하고, 4단계(테스트)의 수정 작업 중에는 에이전트가 테스트 파일을 편집하지 못하게 막을 수 있다.
실행 방법
- 엔지니어링 리더십은 변경 관리 및 컴플라이언스 담당자와 함께, 반드시 존속해야 할 사람 승인 관문을 목록화한다. 변경 관리 사인오프, 릴리즈 승인, 보호 경로 편집 등이 이에 해당한다.
- 플랫폼 엔지니어는 각 관문을 훅으로 구현한다. 훅은 Claude가 행동하기 전에 실행되는 스크립트로, 허용·요청·차단 중 하나를 수행한다.
- 팀 훅은 git의
.claude/settings.json에 저장하고, 비협상 훅은 플랫폼 또는 IT 관리자가 소유하는 관리 설정에 저장한다. 개별 엔지니어가 이를 비활성화할 수 없다. - 차단은 그 이유를 설명해야 한다. 훅이 행동을 막을 때 차단 사유와 승인 경로가 Claude의 출력에 함께 나타나야 한다.
실제 예시 (.claude/settings.json)
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "Bash",
          "hooks": [
            { "type": "command",
              "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
          ]
        }
      ]
    }
}
관문 자체 (.claude/hooks/production-gate.sh)
#!/bin/bash
# Production deploys require a named release authorization
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
   if [ -z "$RELEASE_APPROVAL" ]; then
     echo "Production deploys need a release authorization." >&2
     exit 2 # exit 2 blocks the action; the message goes to Claude
   fi
fi
exit 0
거버넌스 고려사항
훅이 곧 승인 관문이다. 관문 조건은 누구에게나, 매번 동일하게 적용된다. 허용·차단 결정은 타임스탬프와 함께 기록된다. 또한 관문은 승인의 기준, 즉 승인된 변경 티켓인지 릴리즈 매니저의 사인오프인지를 정의한다.
CI/CD 통합과 배포
CI/CD 파이프라인 내에서 Claude Code를 비대화형으로 실행하고, 장시간 실행되는 에이전트가 안전하게 동작하도록 실행 환경을 샌드박스로 격리한다. MCP 통합으로 배포를 노출하고, 에이전트가 실제로 롤백해야 하는 상황이 오기 전에 롤백 경로를 미리 검증해둔다.
실행 방법
- 플랫폼 엔지니어는 읽기 전용 판단 단계부터 시작한다. 파이프라인 작업에서
claude -p을 사용해 실패한 빌드를 분류하거나, 불안정한 테스트를 요약하거나, 체인지로그 초안을 작성한다. - 기존 관문 뒤에 쓰기 단계를 추가한다. 린트 수정, 자동 생성 문서 업데이트,
@claude멘션을 통한 리뷰 코멘트 처리 등의 작업이 해당된다. 에이전트가 작성하는 모든 내용은 브랜치 보호를 통해 PR로 제출되며, 에이전트는 main에 직접 푸시할 수 없다. - 실행 환경은 샌드박스로 격리된다. 에이전트 작업은 네트워크 정책 하에 단기 범위 토큰을 사용하는 컨테이너에서 실행되며, 기본적으로 프로덕션 자격 증명을 보유하지 않는다.
- 배포는 MCP를 통해 노출한다. 배포·상태 확인·롤백이 환경별로 범위가 한정된 툴로 제공되므로, 에이전트의 배포 권한은 자격 증명을 담은 쉘 스크립트가 아닌 허용 목록으로 관리된다.
- 환경별로 자율성을 단계화한다. 개발 환경에서는 에이전트가 자유롭게 배포하고, 프로덕션에서는 에이전트가 릴리즈를 준비하면 릴리즈 매니저가 승인하며 훅이 프로덕션 관문을 강제한다. 스테이징은 그 중간 어딘가에 위치한다.
- 롤백은 파이프라인에서 가장 철저하게 검증된 경로여야 한다. 에이전트가 실행할 수 있는 단일 커맨드로, 스테이징에서 정기적으로 검증된 것이어야 한다. 루프를 닫는 플레이(6단계: 유지보수)는 제어 밴드가 위반될 때 이 롤백을 호출하므로, 사전에 검증이 완료되어 있어야 한다.
실제 예시 (파이프라인 단계)
- name: Triage failed build
  if: failure()
  run: >
    claude -p "Read the build log at out/build.log. Identify the most
    likely cause, say whether the failure looks flaky or real, and write a
    three-line summary for the PR thread." >> triage.md
거버넌스 고려사항
핵심 원칙은 에이전트가 프로덕션 관문까지만 행동할 수 있고 그 이후는 넘어갈 수 없다는 것이다. 아래 통제 장치들이 이 원칙을 강제한다.
- 브랜치 보호는 에이전트가 작성하는 모든 내용을 PR로 전환하며, main으로의 직접 경로는 없다.
- 프로덕션 배포 훅은 지정된 릴리즈 매니저가 승인할 때까지 릴리즈를 차단한다. 각 비대화형 실행은 에이전트 고유 ID로 동작하므로, 파이프라인 로그에서 에이전트가 한 일과 트리거한 엔지니어가 한 일이 명확히 구분된다.
- 환경별 권한 단계가 관문에 도달하기까지 에이전트가 할 수 있는 범위를 정의한다.
유지보수와 루프 닫기
지금까지는 SDLC 각 단계에 Claude를 추가하는 방법을 다뤘다. 모든 단계에서 사람이 초기 단계를 시작해야 했다. 이 단계에서는 방향을 바꿔, Claude가 자율적으로 실행되며 루프를 닫는 것에 초점을 맞춘다.
예를 들어, 지속적으로 실행되는 모니터링 에이전트는 버그 티켓이 생성되면 intent.md를 만들고, 요구사항·플랜·빌드·테스트·리뷰 단계를 순서대로 거칠 수 있다. 6단계(유지보수)는 헤드리스로 실행되며, 단계 사이에는 독립적인 신뢰도 관문이 존재한다. 이 관문은 결정론적 검사이거나 대립적 리뷰 에이전트로, 이전 단계 출력물을 계속 진행할지 아니면 사람에게 에스컬레이션할지를 판단한다.
루프 닫기
결정론적 스크립트가 프로덕션을 감시하다가 제어 밴드가 위반되면 Claude를 호출한다. 위반 모니터링은 루프가 자율적으로 실행되는 패턴의 대표 예시다. 단계 말미의 Claude Tag(퍼블릭 베타) 섹션에서는 다른 채널을 통해 유입되는 작업을 다룬다.
실행 방법
- 서비스 오너 또는 플랫폼 엔지니어가 안정적인 롤링 기준선을 가진 지표 하나를 선택한다. CI 테스트 실패율, 배포 후 5xx 비율, PR 사이클 타임 등이 예시다.
- 탐지 스크립트를 작성한다. 보통 롤링 윈도우의 평균과 표준편차를 구하고 웨스턴 일렉트릭(Western Electric) 등의 규칙을 적용해 완만한 드리프트와 급격한 스파이크를 모두 감지한다. 스크립트는 버전 관리되고 단위 테스트가 적용되며, 탐지 자체는 완전히 결정론적으로 유지한다. 모델은 개입하지 않는다.
- 응답 티어는 버전 관리되는 설정 파일(아래
bands.yaml)에 정의한다. 1σ에서는 스크립트가 로그만 남기고, 2σ에서는 Claude를 읽기 전용 진단 모드로 호출하며, 3σ에서는 Claude가 행동할 수 있다. 단, 리뷰 관문으로 PR을 여는 것이나 사전 승인된 런북을 트리거하는 것만 가능하다. - 트리거 레이어는 GitHub 또는 GitLab의 스케줄 워크플로우, 기존 모니터링 스택의 웹훅, 또는 네트워크 내부의 크론 작업이 될 수 있다. Claude는 상태 없이 실행되며, CI 러너의 비대화형 단계로 동작하거나 샌드박스 컨테이너 내 Agent SDK 서비스로 실행된다. 배포와 모델 접근 옵션은 CI/CD 플레이에서 다룬다. 실행이 상태 없이 비대화형으로 이루어지므로, 루프는 누구도 시작하지 않아도 시작되고 종료된다.
- 에이전트는 1단계(플랜) 형식에 따라 진단 결과를
intent.md로 기록한다. 이상 징후와 근거, 제안된 결과, 영향받는 시스템, 미결 질문이 포함된다. 이후 발견 사항은 다른 모든 것과 동일하게 파이프라인을 거친다. - 서비스 오너나 온콜 엔지니어가 큐를 분류하고, 제품 관련 발견 사항은 프로덕트 오너에게 라우팅한다. 즉시 수정, 일정 등록, 기각 중 하나를 선택한다. 기각은 밴드를 튜닝하고 노이즈를 줄이는 데 기여한다.
- 수정 사항이 배포되면, 해당 인시던트에 대한 평가를 추가한다(지속적 평가 플레이). 이후 동일한 문제가 재발하지 않도록 보호하기 위해서다.
실제 예시 (CI 테스트 실패율을 모니터링하는 bands.yaml 예시)
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: { action: log }
  2sigma: { action: diagnose,
            tools: "Read,Grep,Bash(gh run view *)" }
  3sigma: { action: propose,
            routes: [pull_request, runbook:rollback-deploy] }
거버넌스 고려사항
티어 경계는 버전 관리되는 설정으로 강제되며, 권한 및 관리 설정이 프로덕션 접근을 차단한다. 호출·발견 사항·분류 결정은 타임스탬프와 함께 기록된다. 서비스 오너가 발견 사항을 분류하고 승인하며, 결과로 생성되는 변경은 일반 PR 리뷰 관문을 거친다. 에이전트가 트리거할 수 있는 런북은 사전에 승인된 것들만이다.
예시
- CI 테스트 실패율이 3σ를 초과하면, 에이전트가 불안정한 테스트를 격리하거나 리버트 PR을 열고, 리뷰 관문이 판단한다.
- 배포 후 5xx 비율이 배포 윈도우 내에서 3σ를 초과하면, 에이전트가 기존 롤백 파이프라인을 트리거한다.
- PR 사이클 타임이 드리프트 규칙에 걸리면, 에이전트가 엔지니어링 리더십을 위한 보고서를 작성한다. 이를 통해 이 하네스가 프로세스 지표에도 동일하게 작동함을 확인할 수 있다.
Claude Tag로 온콜 대응하기
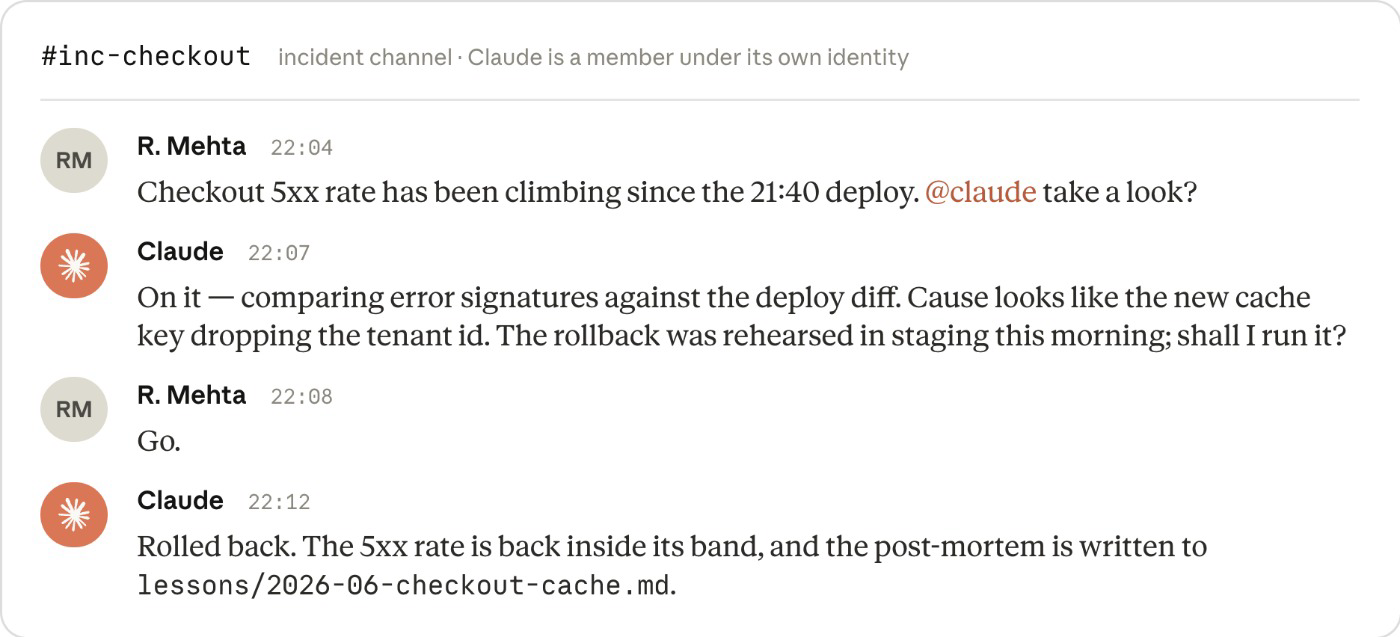
인시던트는 Slack이나 Teams 같은 업무용 커뮤니케이션 앱을 통해 유입되기도 한다. 인시던트 채널에 밤 10시에 올라오는 긴급 수정 요청도 이제는 즉시 처리할 수 있다. Claude Tag(현재 Slack에서 퍼블릭 베타 제공)는 Claude를 자체 ID로 해당 채널의 멤버로 만들어, 새 인시던트마다 즉각 대응하고 그 응답 자체가 루프와 향후 인시던트를 위한 메모리로 축적된다.
대화와 조직 지식은 채널에 남고, 채널 내 누구든 응답을 안내하고 처리할 수 있다. 팀원 모두가 가설을 검증하고, 새로운 옵션을 탐색하고, 실시간으로 조사할 수 있으며 채널 히스토리가 감사 추적성을 높인다. MCP를 통해 Claude는 지표가 기준선으로 돌아왔는지 확인하고 스레드에 보고하며, 포스트모텀을 향후 조사에서 읽을 수 있는 버전 관리된 교훈 파일로 작성한다.
Claude Tag가 처리하는 작업은 인시던트에 국한되지 않는다. MCP로 티켓에 태그되거나 채널에서 요청받으면, Claude는 동일한 방식으로 작업을 분류한다. 작고 범위가 명확한 수정은 리뷰 관문을 통해 PR로 제출되고, 더 큰 작업은 1단계(플랜)용 intent.md로 작성되어 루프가 스스로 돌아가기 시작한다.
마치며
모델과 하네스가 고도화되면서, 조직은 단순히 코드를 만드는 방식만이 아니라 소프트웨어 개발 라이프사이클 전체를 혁신할 수 있게 되었다.
이 혁신은 인간의 판단을 프로세스의 중심에 유지하면서, 대형 엔터프라이즈 조직의 거버넌스와 규제 요구사항을 함께 고려한다.
이 가이드에는 Applied AI 팀이 고객들을 위해 매일 실행하는 실제 모범 사례가 집약되어 있다. 실용적이고 바로 실행할 수 있는 자료로 도움이 되었길 바란다.
참고 자료 및 감사의 말
아래 문서는 플랫폼 팀이 이 통제 장치들을 설정하는 데 필요한 자료로, 실제 도입 순서에 맞게 정리했다.
이 가이드에 기여해주신 Jim Blackhurst, Will Steuk, Jamal Arif께 감사드린다. 이 가이드는 세 분의 선행 작업에서 영감을 받아 그 위에 구축되었다.


