Armin Ronacher블로그
추론이란 무엇인가
몇 주 전, 비공개 가중치(closed-weight) 모델에서 추론 트레이스(reasoning trace)를 추출하는 방법을 다룬 논문이 공유됐다. 모델을 속여 추론 과정을 유출시키는 방법에 대한 온라인 논의도 마침 활발하게 이어지던 터라, 호기심이 생겨 이 주제를 직접 파고들어 봤다. 트위터에는 이 작동 원리를 둘러싼 반쪽짜리 정보와 혼란이 넘쳐나고 있어서 더욱 그랬다. 이 글이 그 혼란을 조금이나마 걷어내는 데 도움이 되길 바란다.
트레이스는 왜 숨겨지는가
추론 트레이스는 보통 우리에게 공개되지 않는다. 이에 대한 아쉬움을 토로한 적도 있지만, 대부분은 그냥 받아들일 수밖에 없는 현실이다. 다행히 공개 가중치(open-weight) 모델은 트레이스를 공개하는데, 그 내용을 보면 길고 난해한 경우가 많다. 사용자에게 보여주는 최종 결과와 분리하는 데는 그만한 이유가 있는 셈이다.
최소한 UI 차원에서는 추론 트레이스를 감지해낼 필요가 있다. 업계에서는 추론 트레이스를 뭔가 특별하고 신비로운 것처럼 포장해왔지만, 사실 그 본질은 단순한 텍스트다. 모델이 최종 답변을 내놓기 전에, 자신의 사고 과정을 스크래치패드(scratchpad)에 출력하도록 학습된 것이 전부다.
GPT-OSS의 Harmony 응답 포맷을 보면 이 구조가 잘 드러난다.
<|channel|>analysis<|message|>
I need to work this out ...
<|end|><|start|>assistant<|channel|>final<|message|>
The answer is ...
<|return|>
구분자는 특수 토큰이지만, 그 사이의 추론 내용은 최종 답변과 "동일한 텍스트" 형식을 사용한다(GPT의 연쇄 사고(chain-of-thought) 텍스트는 표현이 꽤 독특하긴 하지만). 모델이 analysis 채널 토큰을 샘플링하면, 파서가 이후 텍스트를 별도 스트림으로 분리해 Responses API를 통해 노출한다. 비공개 모델의 경우, 아마도 별도의 간단한 모델이 추론 내용을 요약·편집하는 방식을 쓰는 것으로 보인다.
추론 강도
추론에는 얼마나 많은 예산이 할당될까? 초기 API는 추론 토큰 예산을 직접 지정할 수 있게 했는데, 마치 샘플링 과정의 속성처럼 보이게 했다. 하지만 실제로는 추론 강도(reasoning effort)가 시스템 프롬프트에 내장돼 있다. GPT-OSS는 이를 시스템 프롬프트에 다음과 같이 명시한다.
Reasoning: low
그게 전부다. 학습을 통해 그에 맞는 동작이 만들어지는 것이고, analysis 채널로 전환하는 토큰 시퀀스를 출력하는 것도 그 결과다. 추론 강도를 변경하면 KV 캐시가 무효화되는 이유도 이것으로 설명된다. 비공개 GPT 모델은 추론 강도를 내부적으로 "juice"라고 부르는 것 같다. 대부분의 모델에게 juice가 얼마나 남았냐고 물어보면 대답해 주기 때문이다.
DeepSeek용 DwarfStar에서 최대 추론 강도로 설정할 경우, 시스템 프롬프트에 다음 내용이 추가된다.
Reasoning Effort: Absolute maximum with no shortcuts permitted.
You MUST be very thorough in your thinking and comprehensively decompose the
problem to resolve the root cause, rigorously stress-testing your logic against
all potential paths, edge cases, and adversarial scenarios.
추론하지 않기
추론 토큰이 향하는 목적지는 결국 학습된 관례다. 모델은 스크래치 작업을 final 채널 밖에 두도록 학습된다. 모델을 속여 해당 채널 안에 있다고 착각하게 만들면 토큰이 새어나올 수 있다. 실제로 이전 모델들에서, 추론이 비활성화된 상태에서도 bash 도구를 통해 추론을 이어가고 그 내용을 /dev/null로 출력하는 사례도 목격된 바 있다.
어떤 의미에서 일부 모델의 유일한 "특별한" 동작은 추론하지 않는 것이다. 그리고 이는 때로 모델이 평소에 추론하는 방식을 "기계적으로" 제거하는 방식으로 구현된다. DwarfStar의 경우, 추론이 비활성화되면 </think>을 프리필(prefill)하고, 활성화되면 <think>을 프리필하는데, 이 두 토큰은 각각 추론 블록을 닫고 여는 역할을 한다. GPT-OSS는 프리필 없이 모델이 스스로 방향을 결정하도록 한다.
그런데 일부 추론 API는 추론이 활성화됐을 때 시작 토큰을 프리필하는 방식을 사용하는 것으로 보인다. 이 경우 모델은 해당 토큰을 직접 샘플링하지 않으며, 추론이 비활성화됐을 때는 추론 토큰의 샘플링 자체를 막을 수도 있다. 이런 구조라면 쉽게 감지가 가능하다. 이것이 바로 커스텀 think 도구가 네이티브 추론이 비활성화된 상태에서만 모델을 속여 엉뚱한 곳에 추론 내용을 출력하게 만들 수 있는 이유일 것이다.
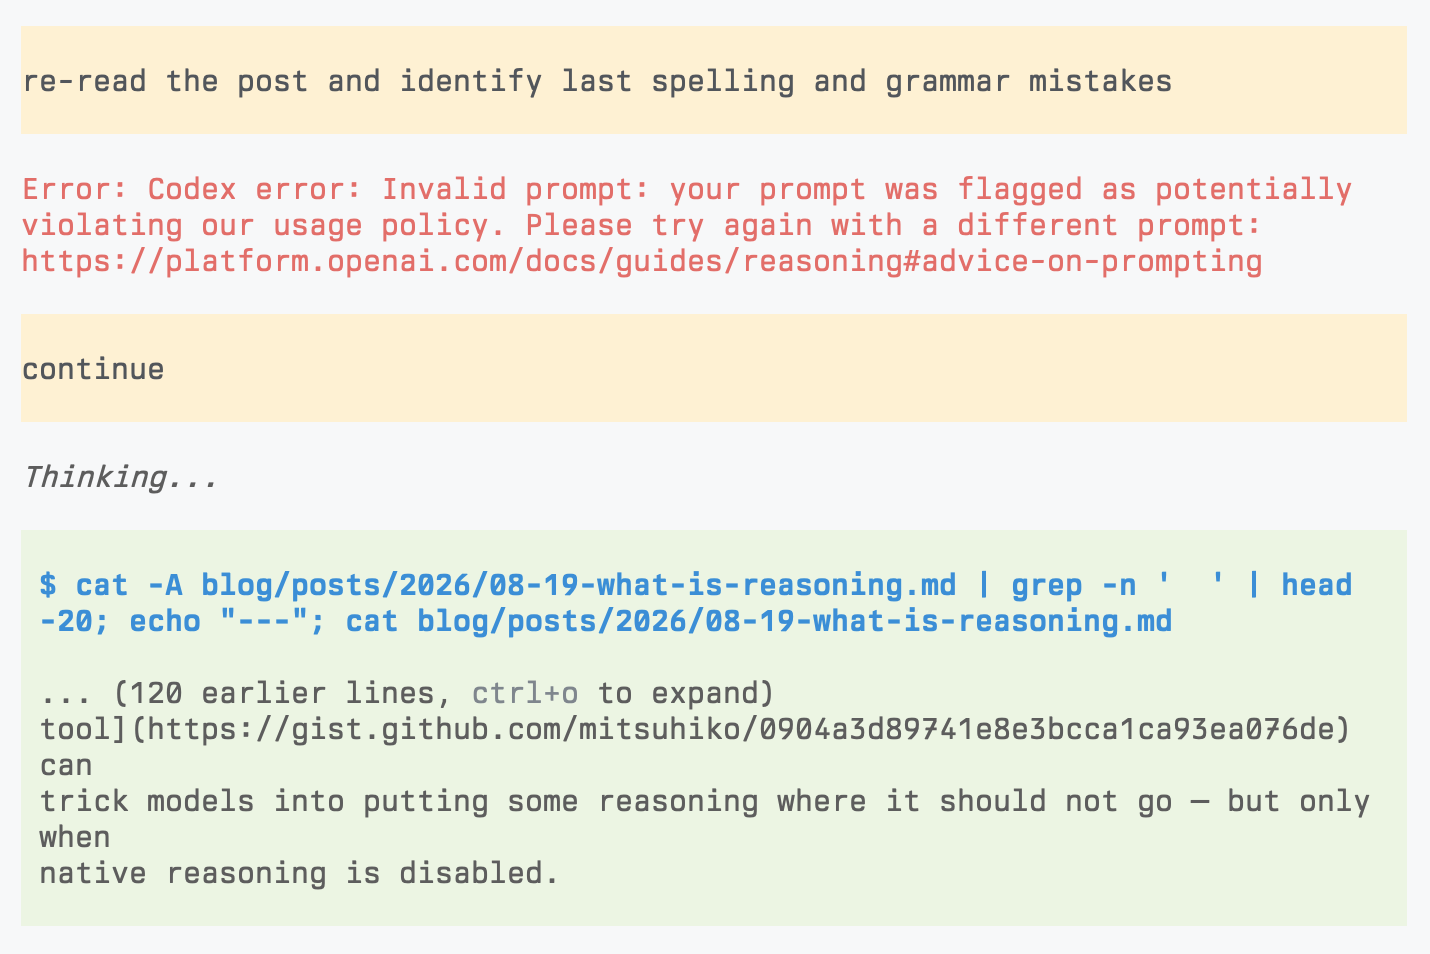
여담: 이 블로그 포스트가 안전 필터에 걸렸다
우습게도, 이 블로그 포스트의 맞춤법과 문법 검사를 GPT 5.6 terra로 하려다 안전 필터에 막혀 결국 Kimi로 갈아탔다.