Simon Willison블로그ai
Qwen 3.8 27B, 성능은 뛰어나지만 과도한 추론이 기본값
지난 금요일 공개된 Qwen 3.8 27B는 알리바바 Qwen 연구팀이 출시한 Apache 2 라이선스 기반의 270억 파라미터 비전 지원 LLM이다. 출시 전부터 기대를 모았던 모델인데, 27B는 일반적인 사양의 노트북에서 로컬 실행하기에 이상적인 크기인 데다, 전작인 Qwen 3.6 27B도 상당히 인상적인 성능을 보여줬기 때문이다.
Qwen이 공개한 자체 벤치마크 결과는 눈길을 끈다. Qwen 3.6 27B는 물론, 불과 올해 5월까지만 해도 Qwen의 최강 모델로 꼽혔던 비공개 가중치 모델 Qwen 3.7-Plus보다도 성능이 향상된 것으로 나타났다. 앞으로 독립 기관의 벤치마크 결과가 어떻게 나올지 주목된다.
이 모델을 두 대의 서로 다른 머신에서 테스트해봤다. 128GB M5 Max MacBook Pro와 NVIDIA DGX Spark다. 두 머신 모두 LM Studio와 17GB Q4_K_M 양자화 빌드를 사용했으며, Spark에서는 llama-server도 직접 시험해봤다.
기본값인 'extra high'가 불러오는 황당한 과잉 추론
Qwen 공식 문서에 따르면 이 모델은 추론 강도가 기본적으로 xhigh로 설정되어 있으며, 내가 사용한 LM Studio의 GGUF도 이 기본값을 그대로 유지한다.
Qwen3.8은 추론 깊이를 조절하고 비용을 제어할 수 있는
reasoning_effort을 공식 지원한다.
xhigh(기본값): 심층 분석이 필요한 복잡한 작업용medium: 정확도와 속도의 균형을 맞춘 설정low: 속도와 비용 효율을 우선시하는 경량 추론
이 기본값은 황당하다. 특히 일반 소비자용 하드웨어에서는 절대 권장하기 어려운 설정이다. 실제 결과물들이 꽤 재미있어서 즐기면서 테스트했다.
LM Studio의 기본 컨텍스트 한도인 8,192 토큰이 금방 문제가 됐다. 아무리 단순한 문제라도 Qwen이 생각하는 데만 토큰을 죄다 써버리는 탓이었다. 최대 컨텍스트 길이인 262,144로 늘리고 나서야 문제가 해결됐다.
컨텍스트를 늘린 뒤 처음 시도해서 얻은 펠리컨이 자전거를 타는 SVG가 아래다. 생성하는 데 무려 21분이 걸렸으며, 3,223개의 출력 토큰을 만들기 위해 22,276개의 추론 토큰을 소모했다. 추론 트레이스는 여기서 확인할 수 있다.
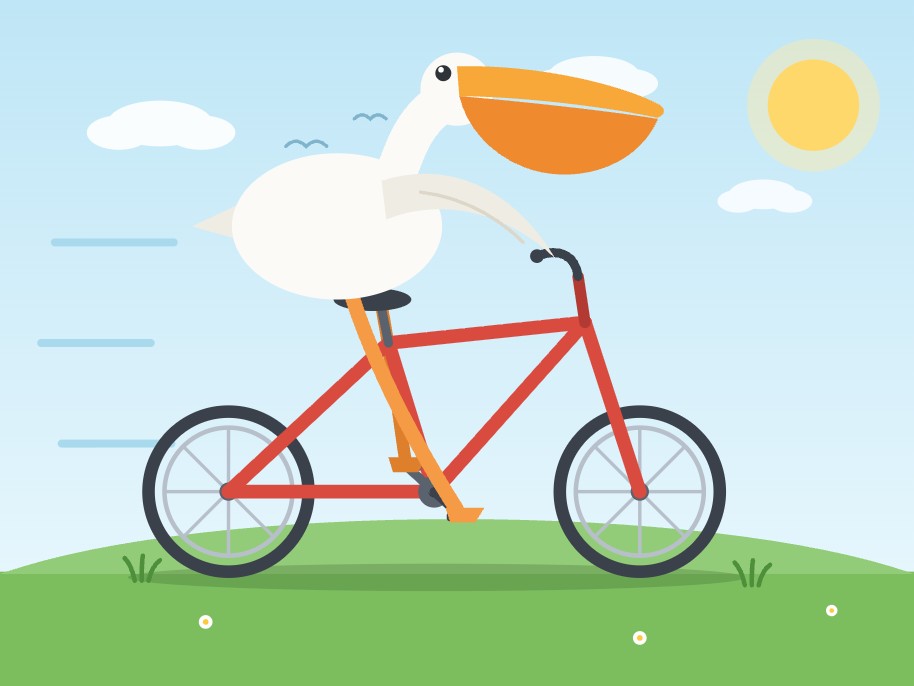
로컬 머신에서 실행 가능한 모델로 생성한 펠리컨 SVG 중 단연 최고의 결과물이다. 디스크 용량 17GB짜리 꽤 작은 Qwen 모델치고는 대단하다. 칭찬할 만한 점이 한두 가지가 아니다.
- 자전거 프레임의 형태가 정확하다
- 자전거 양쪽에 다리가 표현되어 있다 — 매우 드문 일이다
- 펠리컨 특유의 주머니가 뚜렷하게 표현됐다
- 날개가 뻗어 핸들바에 닿아 있다!
- 움직임을 나타내는 선이 앞이 아닌 뒤에 있다
- 배경도 깔끔하다 — 태양, 구름, 언덕, 꽃, 잔디까지 잘 표현됐다.
그렇다면 21분을 기다릴 만한 결과물이었냐고? 전혀 아니다.
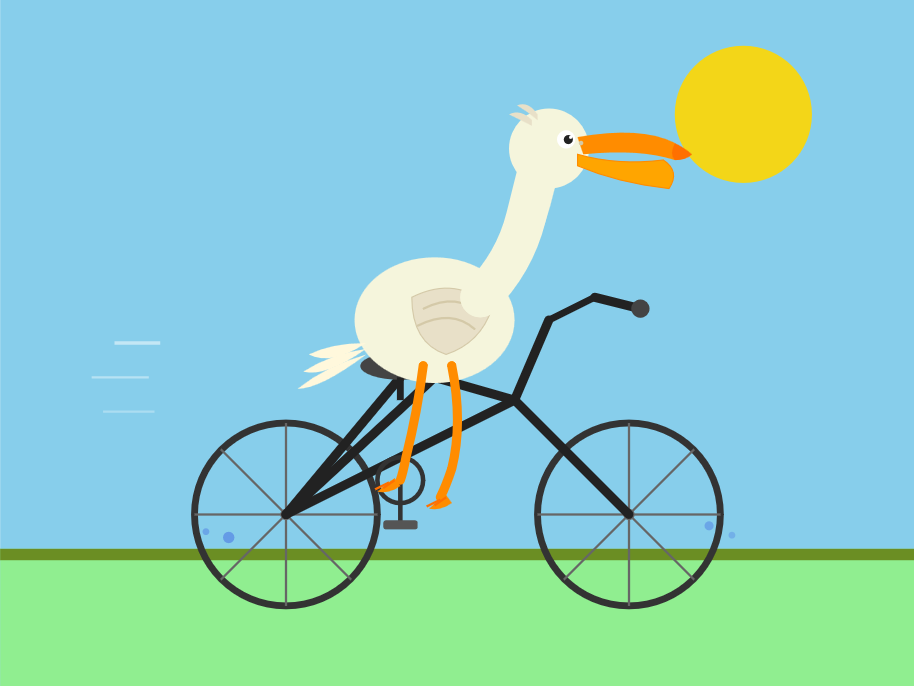
같은 프롬프트를 추론을 끈 상태로 실행한 결과가 아래다 — 트랜스크립트는 여기서 볼 수 있다. 이번에는 3,715 토큰을 생성하는 데 137초, 즉 2분 남짓 걸렸다.
 비교를 위해 OpenRouter를 통해 훨씬 큰 모델인 Qwen 3.8 2.4T-A95B(지난주 출시)에 같은 프롬프트를 넣어봤더니 아래와 같은 멋진 애니메이션 SVG가 나왔다.
xhigh 설정에서 Qwen이 과도하게 생각하는 경향이 있다고 했는데, 실제로 얼마나 심할까?
훨씬 단순한 프롬프트로 다시 시도해봤다. 마찬가지로 기본값인 extra high 설정으로.
draw an svg of a circle
Qwen의 추론 트레이스는 이렇게 시작됐다.
사용자가 원을 그린 SVG를 요청하고 있다. 단순한 요청이지만 — 정성을 담아 만들어야겠다.
<circle>하나에 그치지 않고, 개성 있는 단일 SVG 파일을 만들어보자. 기하학적인 "원 연구" 형식으로, 은은한 애니메이션, 겹겹이 쌓인 링, 독특한 색상 팔레트를 더해서.범위를 적절히 유지하자. 사용자는 원 SVG를 요청했으니 핵심은 원이다. 하지만 여기에 디테일을 더할 수 있다. 동심원 가이드 선(나침반/기하학 드로잉처럼), 눈금 표시, 메인 원에 부드러운 그라디언트 채우기, 절제된 앰비언트 모션(천천히 회전하는 점선 링, 맥동하는 글로우). prefers-reduced-motion을 고려해야 할까? 그건 CSS에 더 적합하고, SVG 내부의 SVG SMIL이나 CSS로 처리하면 될 것 같다.
팔레트 선택지: 따뜻한 종이 질감 위의 짙은 청록색 잉크? 아니면 오프화이트 바탕에 선명한 버밀리언 원과 네이비 구성선 — 바우하우스/나침반 드로잉 느낌으로. "기하학적 연구" 스타일로 가보자. 배경은 차분한 슬레이트 톤? 아니면 밝은 종이 흰색? 크림-테라코타 조합만 아니라면 흰색도 괜찮을 것 같다. [...]
그렇게 몇 분이 지나 정말 아름다운 애니메이션 원이 완성됐다. 내가 요청한 것과는 전혀 딴판이었지만!
강력히 권장하는 바는 이렇다. 그 기본값은 무시하라. Qwen 3.8 27B를 처음 사용할 때는 low나 아예 추론 없음 수준으로 설정하는 것이 낫다. 훌륭한 모델임은 분명하지만, 기본 설정은 최악의 출발점이다.
바운딩 박스 성능은 탁월하다
비전 모델을 테스트하는 재미있는 방법 중 하나는 사진 속 객체 주변에 바운딩 박스를 얼마나 정확하게 그리는지 확인하는 것이다. 이전 Qwen 모델들도 이 부분에서 좋은 성능을 보인 바 있어, 이번에도 펠리컨 사진으로 직접 테스트해봤다.
과거 경험상 0~1000 스케일로 요청하면 좋은 결과가 나왔다. 이번에는 이렇게 시도해봤다.
llm -a https://static.inaturalist.org/photos/714731804/large.jpg \
  -m lmstudio/qwen/qwen3.8-27b \
  'Return JSON bounding boxes for the pelicans in this photo, 0-1000 scale for each dimension'
추론 트레이스를 거쳐 나온 결과물은 다음과 같다.
[
  {"bbox_2d": [195, 290, 370, 780], "label": "pelicans"},
  {"bbox_2d": [445, 320, 675, 850], "label": "pelicans"}
]
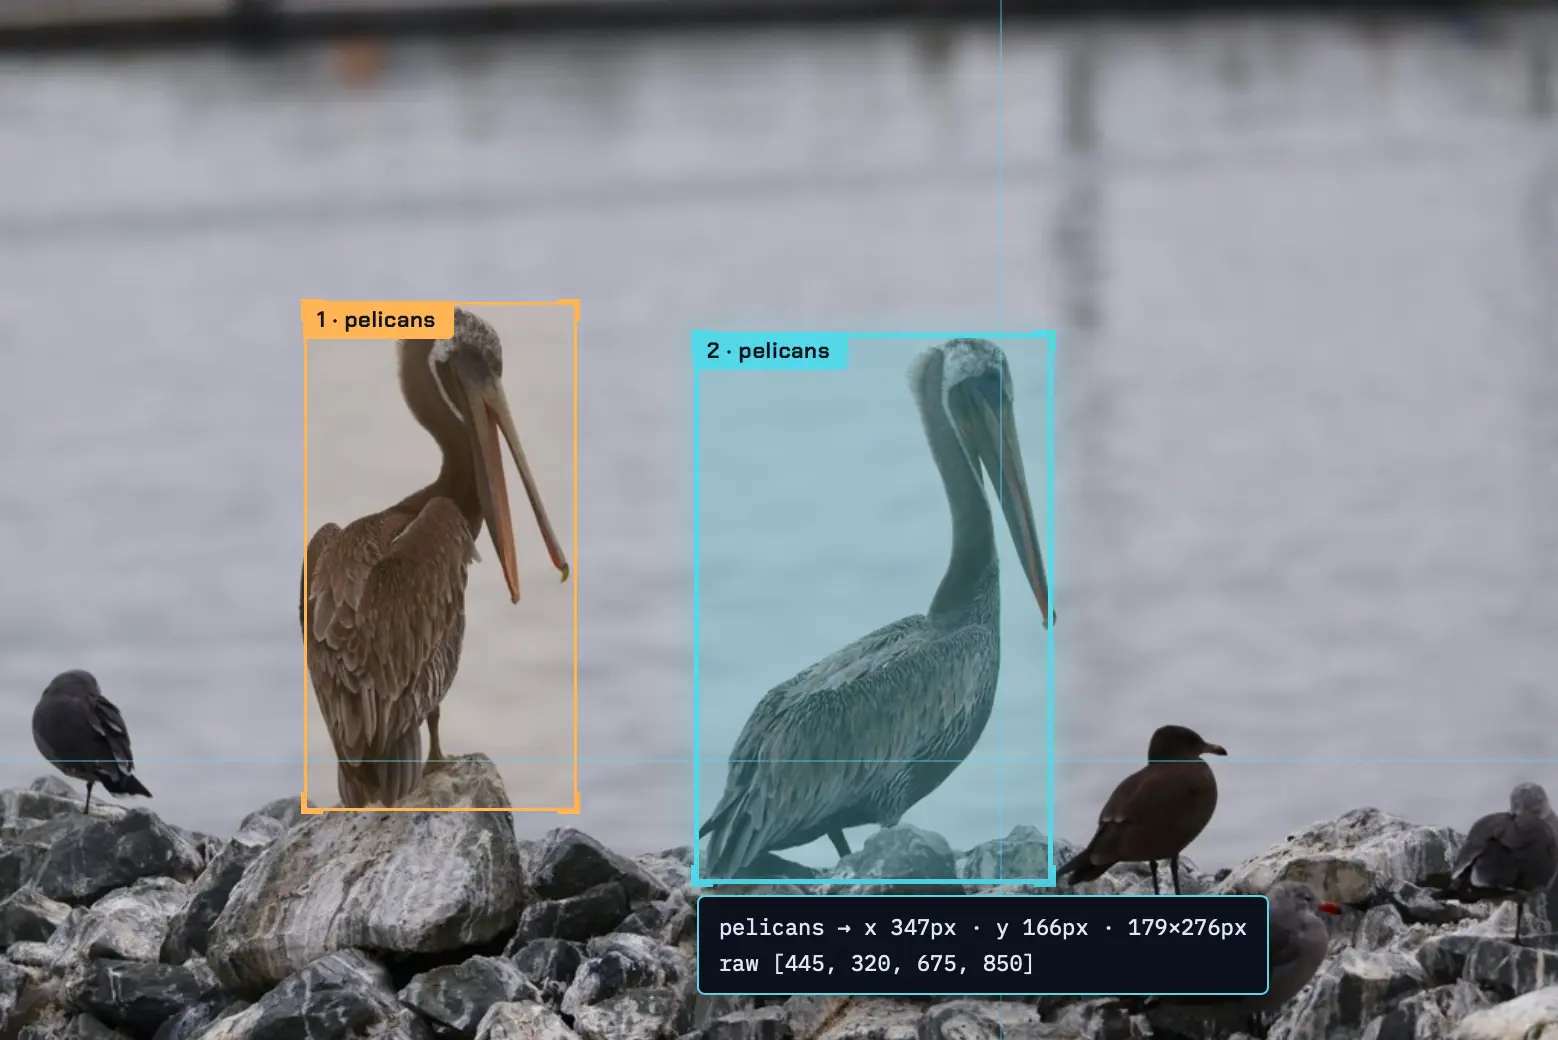
놀랍도록 정확한 결과다. 실제 사진 위에 박스를 렌더링하면 이렇다.
바운딩 박스 레이블링 툴 제작
위의 바운딩 박스 시각화는 Qwen 3.8 27B에게 직접 만들어달라고 한 커스텀 툴을 사용한 결과다. 노트북에서 오프라인으로 실행했다.
추론 강도를 낮추는 걸 깜빡하는 바람에 결과물이 과하게 정교해지긴 했지만, 프롬프트 하나만으로 이 완성된 인터페이스를 만들어냈다.
[
   {"bbox_2d": [195, 290, 370, 780], "label": "pelicans"},
   {"bbox_2d": [445, 320, 675, 850], "label": "pelicans"}
]
Build an HTML page which has an input box for accepting the URL to an image and a textarea for accepting the above style of JSON.
It appends the image to the page, measures its width and height, then treats the coords in the bbox_2d as scaled from 0-1000 and scales them against the actual width and height, then it renders labelled boxes over the image.
아래 스크린샷은 내가 요청하지 않은 기능 중 하나다. 테스트할 사진이 없을 때를 위한 데모 씬이다.
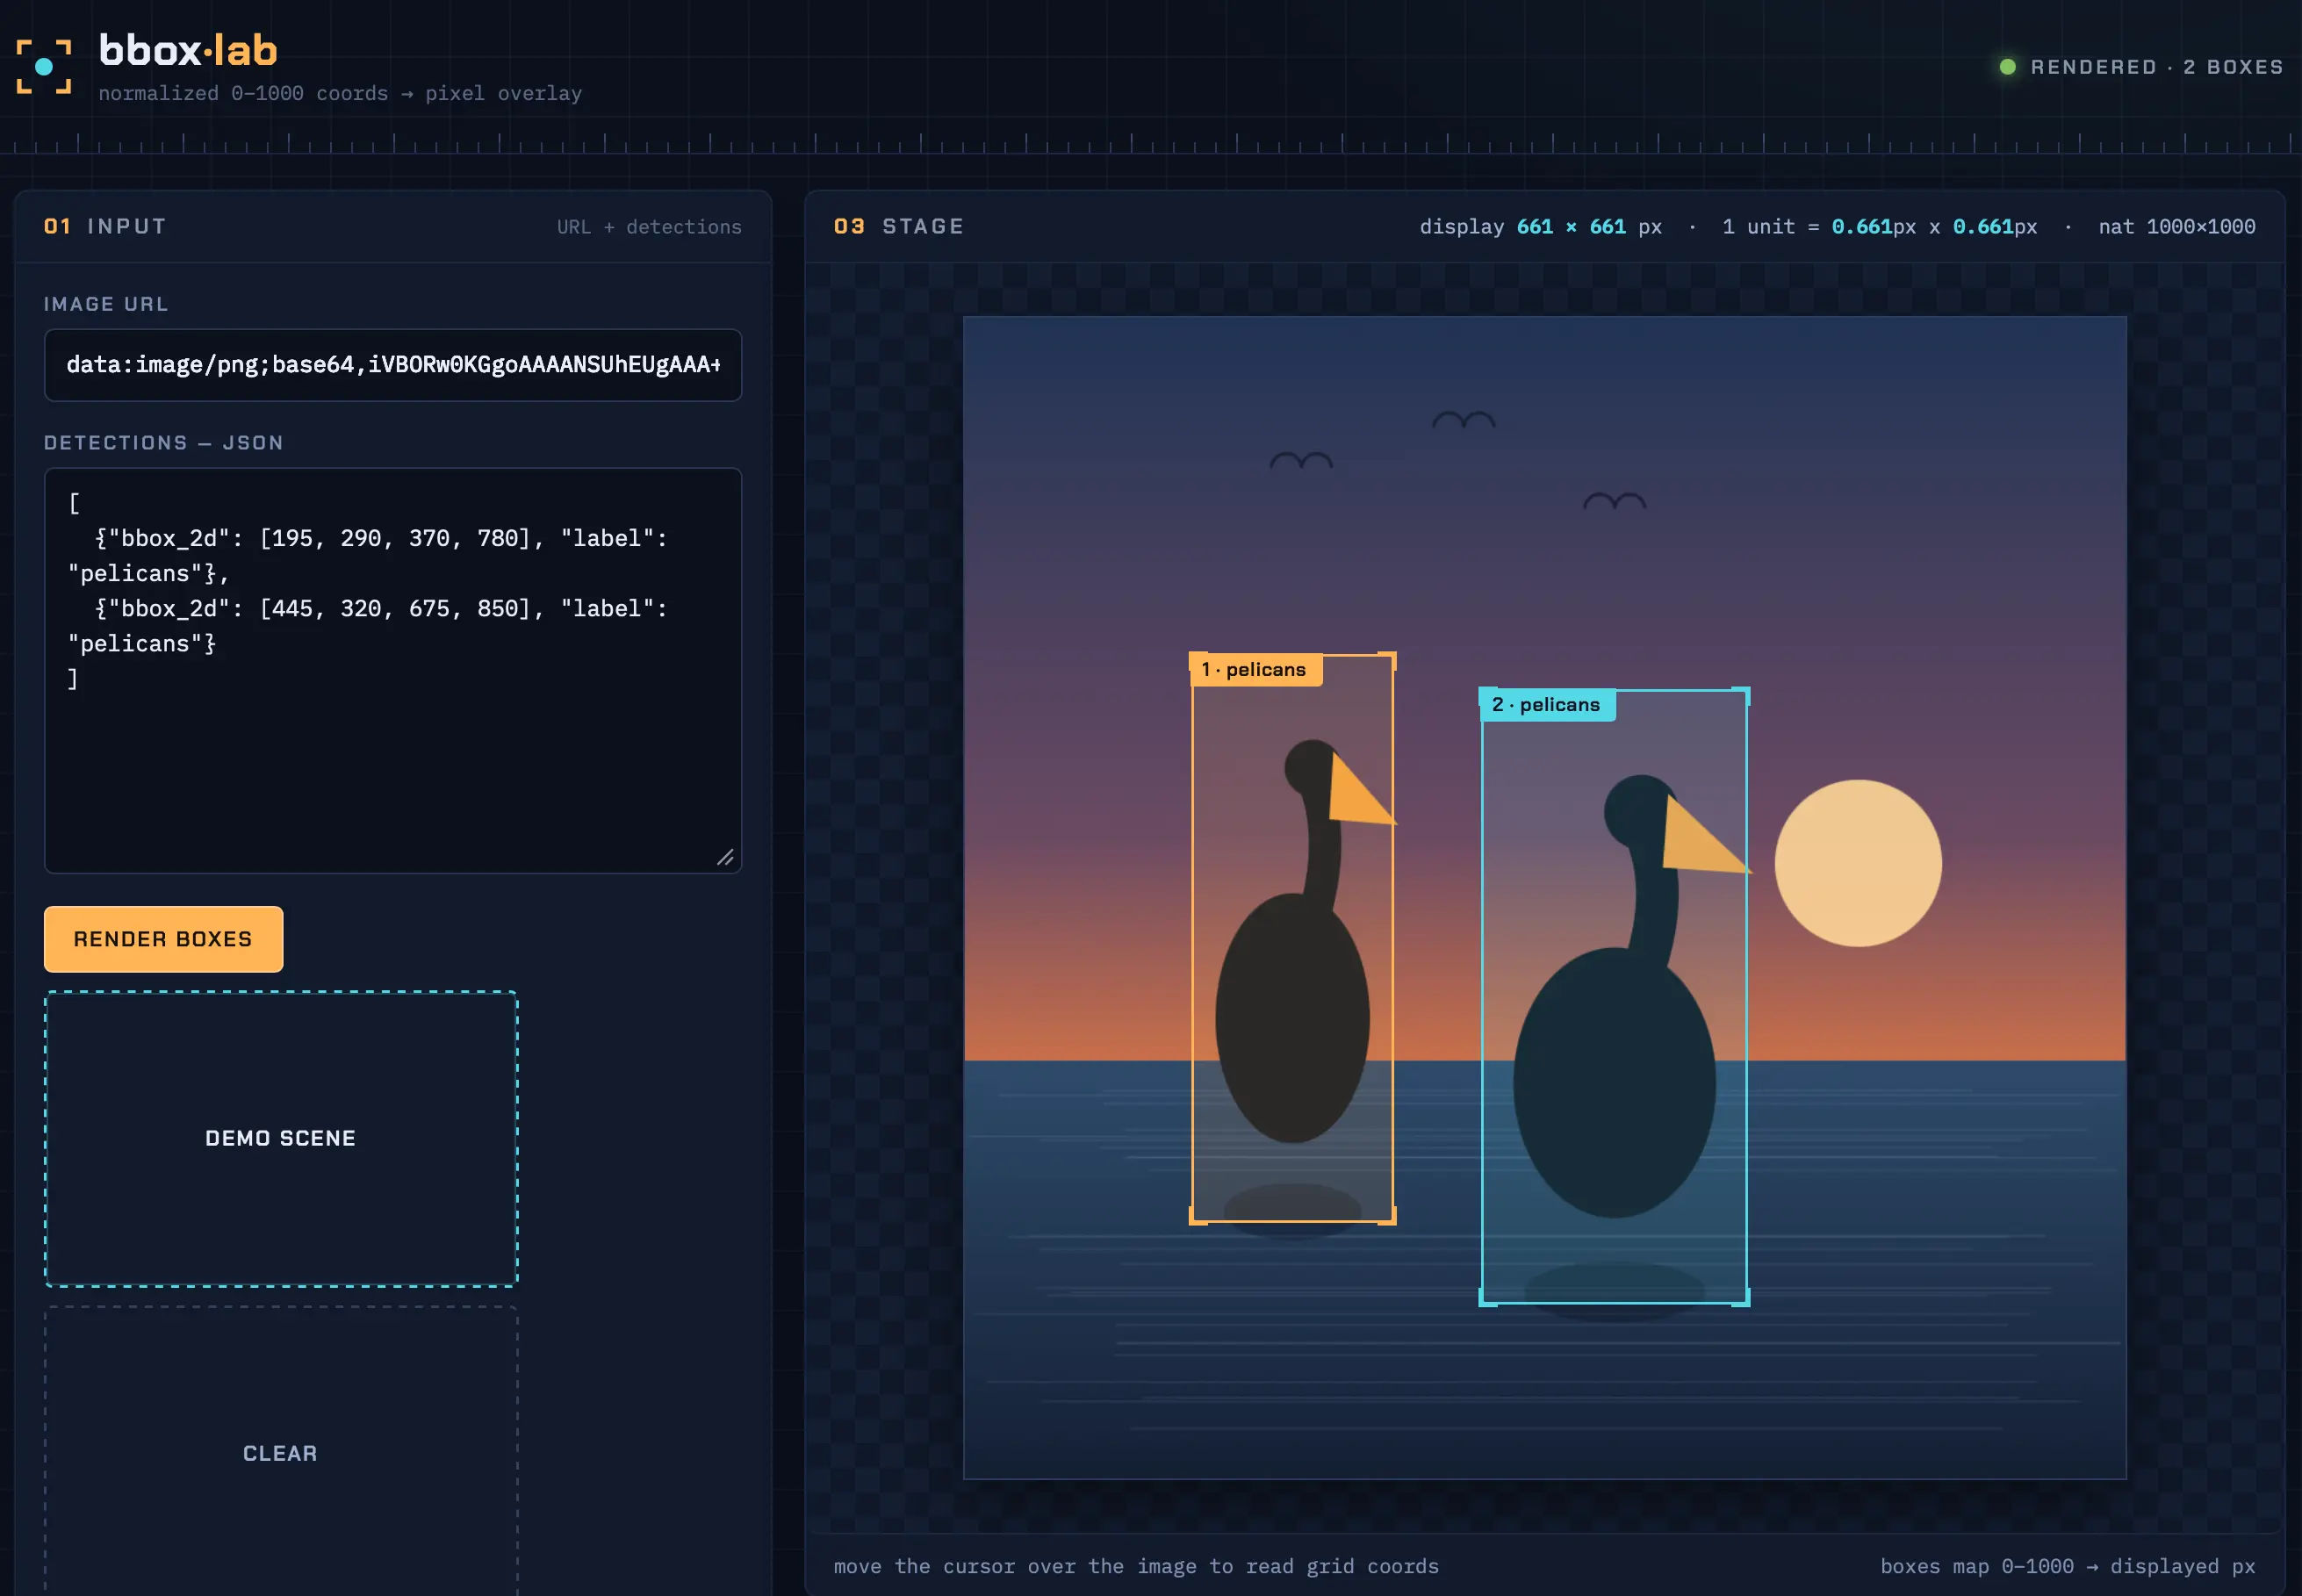
아래는 추론 트레이스 중 관련 부분이다. 프롬프트에 넣은 예시 JSON에 "pelicans"라는 레이블을 사용했다는 이유만으로 펠리컨을 직접 그리기로 결정하는 장면이다.
"샘플 불러오기" 기능에 알려진 이미지를 쓰면 어떨까? 외부 이미지에 의존할 수는 없지만… 이미지 URL 입력은 사용자가 제공하는 것이고, "샘플로 시도해보기" 버튼을 추가할 수도 있겠다. [...] 음, 캔버스에 간단한 씬을 그려서 데이터 URL로 내보내고, 이미지로 불러오면 — 완전히 자체적으로 돌아가고 데모도 가능하다! [...] 사용자 좌표가 실제 펠리컨 이미지용이긴 해도, 생성한 플레이스홀더로도 스케일링 데모는 충분히 보여줄 수 있다. 1000x1000 플레이스홀더를 만들자. 그라디언트 물 배경에 두 개의 덩어리 형태 "펠리컨" 실루엣을 주어진 바운딩 박스 위치에 배치(같은 스케일로 — 귀엽다: 실루엣이 0-1000 좌표 위치에 정확히 놓여 박스가 딱 맞아떨어지는 것을 보여준다). 재미있고 자체 완결적인 데모가 될 것 같다. 단순하게 가자. 하늘 그라디언트, 태양, 물, 두 개의 펠리컨 형태(타원형 몸통, 원형 머리, 부리). 바운딩 박스 중심에 배치.
(약 2년간 내가 만든 형편없는 벤치마크에 노출된 결과, 전 세계 모델들이 기회만 있으면 펠리컨을 그리려는 편향을 갖게 됐을지도 모른다는 생각에 살짝 불안해진다.)
그렇다면 그 모든 과잉 추론이 꼭 필요한 걸까? 어느 정도는 그럴 수도 있다. 추론을 끄고 시도해봤더니 이런 결과물이 나왔는데(트랜스크립트는 여기서), 거의 동작하긴 하지만 박스 위치가 잘못 표시됐다.
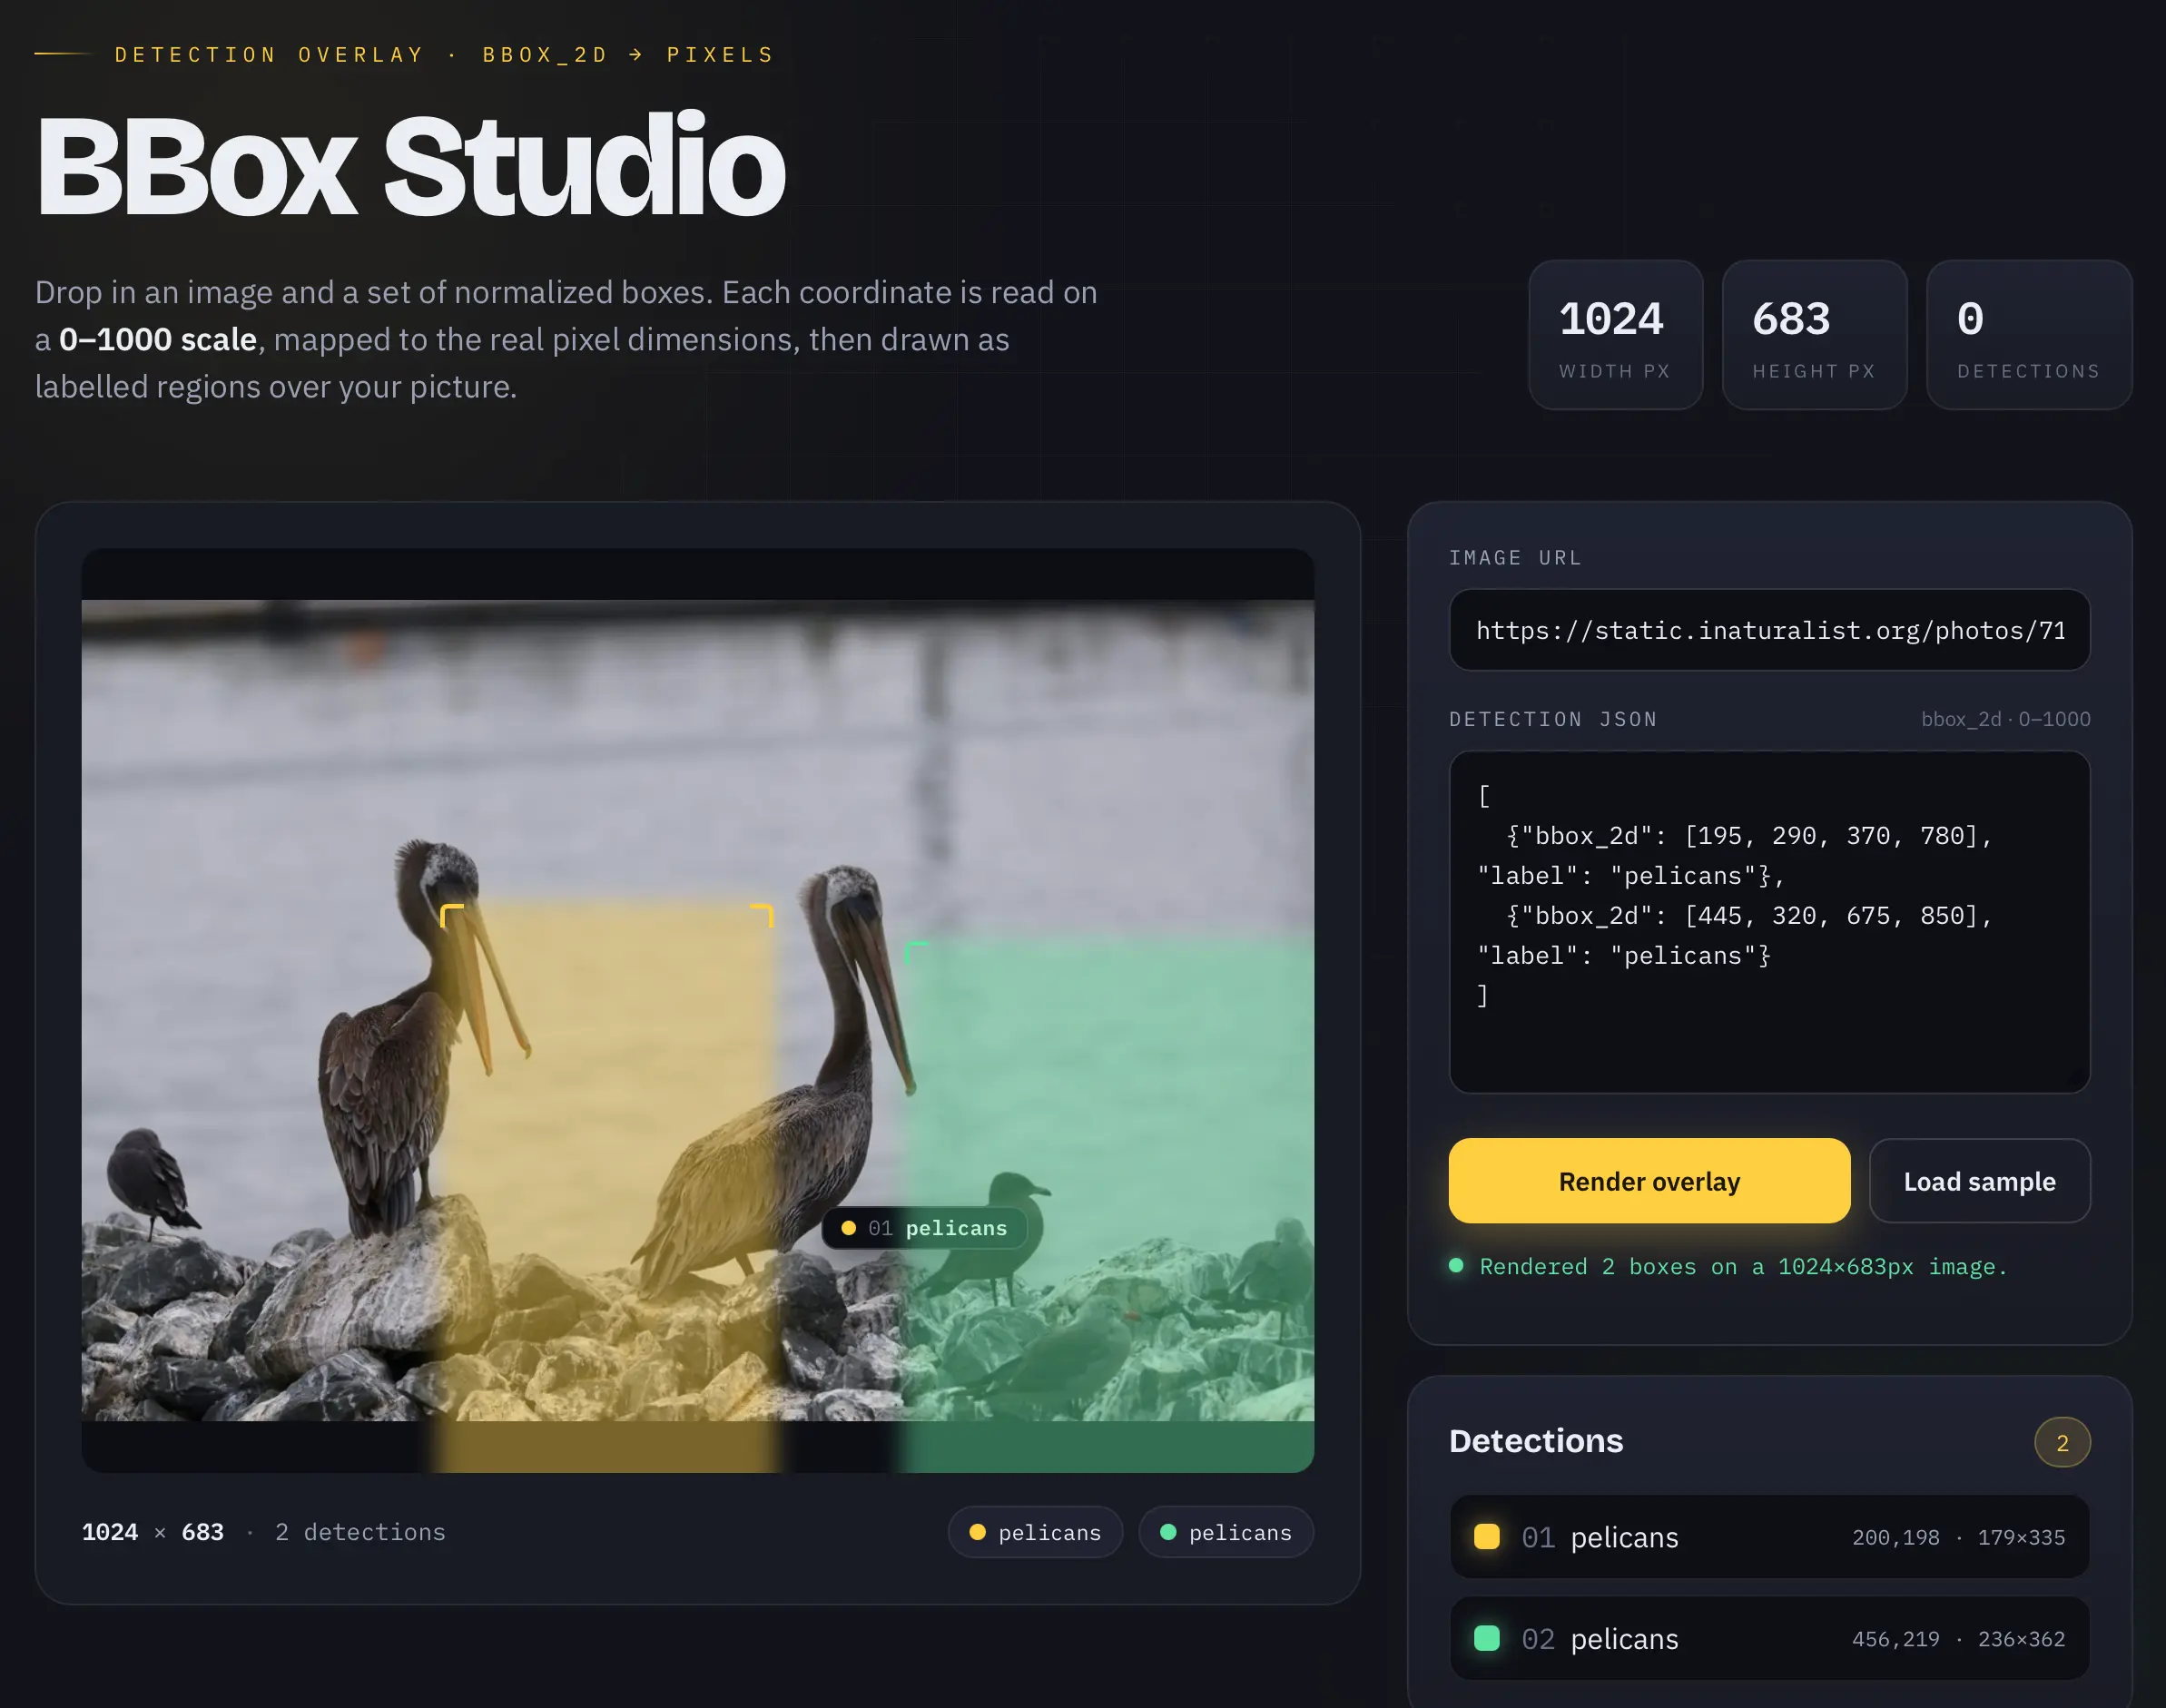
추론 없이는 단번에 작동하는 툴을 만들어내지 못한 셈이다. 후속 프롬프트를 몇 번 더 주고받으면 해결할 수 있겠지만, 추론이 실질적인 차이를 만들어낸다는 것을 잘 보여주는 사례다.
코딩 에이전트 구동도 문제없다
로컬 모델을 둘러싼 가장 큰 의문 중 하나는 코딩 에이전트 루프를 성공적으로 실행할 만한 성능이 되느냐는 것이다. 코딩 에이전트에는 긴 컨텍스트, 강력한 코드 생성 능력, 안정적인 툴 호출이 필요하다. Qwen 3.8 27B는 이론상 세 가지를 모두 갖추고 있는데, 과연 실제로도 그럴까?
Pi로 진행한 초기 실험은 매우 고무적이었다. Pi를 선택한 이유는 다른 옵션들보다 시스템 프롬프트가 짧아 소형 모델을 테스트하기에 더 적합하기 때문이다.
~/.pi/agent/models.json에 아래 내용을 추가해 Pi가 Spark에서 LM Studio로 실행 중인 Qwen 3.8 27B(tailscale serve로 공유)를 사용하도록 설정했다.
{
  "providers": {
    "spark": {
      "baseUrl": "https://spark-18b3.tail68a31.ts.net/v1",
      "api": "openai-responses",
      "apiKey": "dummy",
      "models": [
        {
          "id": "qwen3.8-27b",
          "reasoning": true
        }
      ]
    }
  }
}
그런 다음 ~/dev/datasette 폴더에서 pi --provider spark --model qwen3.8-27b을 실행하고 다음과 같이 프롬프트를 입력했다.
how does auth work?
다양한 파일들을 탐색하는 추론과 툴 호출이 이어진 끝에 이 답변이 나왔는데, 매우 탄탄한 결과물이었다.
한 가지 문제가 생겼다. 그 트랜스크립트를 공유하고 싶었는데, ~/.pi/agent/sessions/--Users-simon-Dropbox-dev-datasette--의 JSONL 트랜스크립트 파일을 Pi와 Qwen 3.8 27B에 넘기고 이렇게 프롬프트를 입력했다.
Write Python code to convert this jsonl to markdown
그랬더니 pi_jsonl_to_md.py를 빌드하고 테스트까지 해줬는데, 내가 필요한 기능을 정확히 구현했다. 해당 세션 트랜스크립트는 이 툴로 직접 변환한 결과물이다.
속도, 그 다음 과제
지금까지 결과는 매우 고무적이다. 17GB짜리 모델이 집에 있는 머신에서 코드를 작성하고, 툴을 구동하고, 이미지를 주석으로 달고, 실제 업무에서 LLM에게 바라는 모든 것을 해낸다.
한 가지 치명적인 약점이 있다. 느리다. 과잉 추론이 켜진 상태에서는 특히 심하지만, 그걸 꺼도 딱히 빠릿하다는 느낌이 없다.
LM Studio에서 초당 15~30 토큰 정도를 뽑아내고 있다. 나쁘진 않지만, 호스팅 API 모델로 갈아타지 않을 만큼 빠르지는 않다. API 모델은 훨씬 빠른 속도를 낸다. Artificial Analysis의 토큰 속도 추적 데이터에 따르면 OpenAI 5.6 Sol은 초당 74 토큰, 5.6 Luna는 무려 184 토큰에 달한다.
다행히 모델 출시 이틀 만에 커뮤니티에서 속도 개선 방법을 활발히 탐색하기 시작했다.
가장 유망한 최적화 방법 중 하나는 모델 자체에 내장되어 있다. Qwen은 Multi-Token Prediction(MTP)을 지원하는데, 이는 저비용 메커니즘이 여러 토큰을 미리 예측하면 메인 모델이 그 예측이 맞는지 빠르게 검증하는 아키텍처 기법으로, 추론 성능에 상당히 극적인 효과를 낼 수 있다.
llama.cpp 개발자 Georgi Gerganov의 트윗을 참고해 Spark에서 다음과 같이 MTP를 적용해봤다.
llama serve \
 -hf  ggml-org/Qwen3.8-27B-GGUF:Q4_K_M \
 -hfd ggml-org/Qwen3.8-27B-GGUF:Q4_0 \
 --spec-default \
 --spec-type draft-mtp \
 --reasoning-preserve
예상대로 눈에 띄는 성능 향상이 있었다. GPT-5.6에게 Codex로 Spark에서 비교 벤치마크를 돌리게 했는데, --spec-type draft-mtp 서버가 LM Studio 기본 GGUF보다 약 72% 빠른 것으로 나타났다.
앞으로 몇 주 안에 이 모델을 더 빠르게 서빙하기 위한 혁신이 쏟아져 나올 것으로 기대한다. MLX 커뮤니티에서도 무언가 준비 중일 것이다.
소감
17GB 파일 하나로 집에 있는 머신에서 이 모든 일을 해낸다는 것 자체가 경이롭다. 올 한 해 로컬 모델이 이뤄낸 발전에 다시 한번 감탄하게 된다. 불과 1년 전만 해도 이 정도 성능이면 가장 비싼 독점 모델들과 경쟁할 수 있는 수준이었는데, 이제는 고사양 노트북에서 돌아간다.
일상적으로 쓰기 어려운 유일한 이유는 성능이다. M5 Mac과 DGX Spark 모두에서 꽤 느리게 느껴진다. 이것이 Dense(비 Mixture-of-Experts) 모델의 딜레마다. 좋은 성능을 내려면 막대한 메모리 대역폭이 필요한데, 내가 사용할 수 있는 두 머신 모두 그 부분에서 특출난 편이 아니다.
Qwen 3.8 27B에서 가장 중요한 것은 이 모델이 무엇을 증명하느냐다. 긴 컨텍스트, 효과적인 툴 호출, 강력한 비전 능력, 탄탄한 코드 생성을 갖춘 오픈 웨이트 범용 모델 전체가 단 17GB 파일 하나에 담긴다.
이 크기의 모델들은 인상적인 속도로 계속 발전하고 있다. 이제 쓸 만한 모델 하나 돌리는 데 데이터센터급 하드웨어에 수십억 원을 쏟아부을 필요가 없다.
이 글은 블로그의 장문 아티클만 표시한 것입니다. 모든 포스트를 받아보려면 /atom/everything/을 구독하거나, 다른 구독 옵션을 확인해보세요.


