Anthropic제품 블로그Claude Code
Claude Code, Pro·Max·Team 플랜에서 자동 모드가 기본값으로 전환
Claude Code는 Pro, Max, Team 플랜에서 자동 모드(auto mode)를 기본값으로 적용할 예정입니다. 이를 통해 장시간 자율 작업이 가능해지고, 위험한 명령어도 더 효과적으로 감지할 수 있게 됩니다.
Claude Code에서 자동 모드를 기본값으로 전환합니다. 8월 14일부터 Pro, Max, Team 플랜의 새 세션은 자동 모드로 시작됩니다. 이미 다른 기본값을 설정해 두셨다면, 자동 모드로 전환할지 묻는 일회성 알림이 표시될 수 있습니다. 기본값을 고정해 두셨다면 기존 설정이 그대로 유지됩니다. 자동 모드 분류기(classifier)는 도구 호출마다 소량의 추가 토큰을 사용하는데, 오늘부터 Pro, Max, Team 플랜 Claude Code 사용자에게는 이 분류기 오버헤드 비용을 청구하지 않습니다.
Claude Enterprise, Claude API, AWS의 Claude Platform, Amazon Bedrock, Google Cloud의 Agent Platform, Microsoft Foundry에서는 자동 모드가 당분간 선택 적용 방식으로 유지됩니다. 관리자가 변경 사항을 검토할 시간을 확보하기 위해서입니다. 향후 한 달 내로 클라우드 파트너사들과 협력하여 이 플랫폼 전체에서도 자동 모드를 기본값으로 전환하고, 분류기 오버헤드 비용 청구도 중단할 계획입니다. 그 전까지 Enterprise 관리자는 관리 설정(managed settings)을 통해 Claude Code의 자동 모드를 기본값으로 설정할 수 있습니다.
자동 모드는 작업 흐름을 끊기지 않게 하려는 사용자 요구와, 위험한 동작을 방지하는 안전 시스템 사이의 균형을 목표로 설계되었습니다. 매번 승인을 묻는 대신, 각 도구 호출을 분류기에 통과시켜 되돌릴 수 없거나 파괴적이거나 현재 환경 밖을 대상으로 하는 동작을 차단합니다. 분류기가 동작을 차단하면 Claude는 대부분 스스로 더 안전한 방법을 찾거나 사용자에게 직접 확인을 요청합니다. 연속 3회 또는 세션 전체에서 20회 차단이 발생하면 Claude Code는 수동 승인 모드로 전환됩니다.
지난 수개월간 자동 모드가 사용자가 직접 승인 버튼을 클릭하는 것보다 같거나 더 안전한지 검증하는 테스트를 진행했습니다. 내부 레드팀 테스트, 외부 레드팀 테스트와 프롬프트 인젝션(prompt injection) 평가, 유료 테스터 1,053명을 대상으로 한 통제 연구, 실제 프로덕션 세션 분석까지 모든 지표에서 자동 모드는 수동 검토와 동등하거나 더 나은 결과를 보였습니다.
자동 모드는 Claude가 더 오랜 시간 동안 자율적으로 작업할 수 있게 해줍니다. 덕분에 장시간 실행에 최적화된 Claude Opus 5 같은 모델을 대규모 작업에 몇 시간씩 돌려두는 것이 현실적으로 가능해집니다. 사용자의 개입 부담이 줄어드는 만큼 결과물도 늘어납니다. Teams·Enterprise 도입 사례를 분석한 결과, 자동 모드 사용자는 PR을 약 25% 더 많이 병합했습니다. Claude의 작업이 막히지 않으면 더 오래 끊김 없이 실행되고 더 많은 작업을 완료할 수 있습니다. Adobe, Nuro, Gusto, Garner Health의 팀들은 이미 자동 모드를 프로덕션 기본값으로 운영하고 있습니다.
이번 변경의 근거가 된 안전성 데이터와 고객 사례, 그리고 기본값을 변경하는 방법을 아래에서 자세히 설명합니다.
수동 검토와 자동 모드 비교
데이터에 따르면 수동 검토는 습관적인 행동으로 굳어지는 경향이 있습니다. 사용자들은 Claude Code의 권한 요청 알림 중 97%를 승인합니다. 대부분의 요청이 안전하고 일상적인 명령일 가능성이 높지만, 이처럼 높은 승인율은 많은 사용자들이 각 명령을 실제로 검토하기보다 반사적으로 클릭하고 있음을 시사합니다. 이런 알림들은 개발자에게 하루에도 수십에서 수백 건의 보안 판단을 내리도록 요구하는데, 대개 작업 도중 갑자기 등장하기 때문에 검토 부담이 가중되고 중요한 내용을 놓칠 가능성도 커집니다. 반면 다른 유형의 대화에서는 사용자가 훨씬 더 꼼꼼하게 검토하는 양상을 보입니다. 예를 들어 Claude가 작업 계획을 제시하면 사용자는 그 중 39%를 거부하지만, 개별 권한 요청의 거부율은 3%에 불과합니다.
설정 파일에서도 같은 패턴이 나타납니다. 2026년 6월 기준으로 활성 CLI 사용자의 49.5%가 Bash 허용 규칙을 수동으로 생성했습니다. 5%는 모든 셸 명령을 무조건 허용했고, 43%는 실질적으로 동일한 효과를 내는 Bash(python:*) 이나 Bash(node:*) 같은 인터프리터 규칙을 사용하고 있으며, 이 비율은 5주마다 약 5%p씩 증가하는 추세입니다. 허용 규칙 외에도 62%의 사용자가 bypassPermissions을 사용하거나 Bash에서 "다시 묻지 않기"를 클릭한 적 있으며, 대화형 세션의 25%는 권한 우회(bypass permissions) 모드로 시작됩니다.
자동 모드에서도 권한 규칙은 분류기보다 먼저 실행됩니다. 단, 임의 코드 실행을 허용할 만큼 범위가 넓은 허용 규칙(예: python:*)은 예외입니다. 이런 광범위한 규칙은 자동 모드 중에는 적용이 보류됩니다. 해당 규칙이 있으면 명령이 분류기를 완전히 우회할 수 있기 때문입니다. 설정 파일 자체는 수정되지 않으며, 다른 모드로 전환하는 즉시 규칙이 다시 적용됩니다.
자동 모드로 안전성 향상
내부 및 여러 외부 기관의 연구 결과, 자동 모드는 현재 일반적인 사용자가 권한 요청 알림에 응답하는 방식보다 더 안전한 것으로 나타났습니다. 개발자들이 권한 요청 알림을 클릭할 때 실제로 승인하는 내용을 기준으로 자동 모드를 테스트했습니다. 내부 레드팀 테스트, 외부 침투 테스트, 실제 세션 분석 등 모든 지표에서 자동 모드는 사람의 수동 승인과 동등하거나 더 나은 성과를 거뒀습니다.
안전성 측면에서 자동 모드가 수동 승인을 앞서다
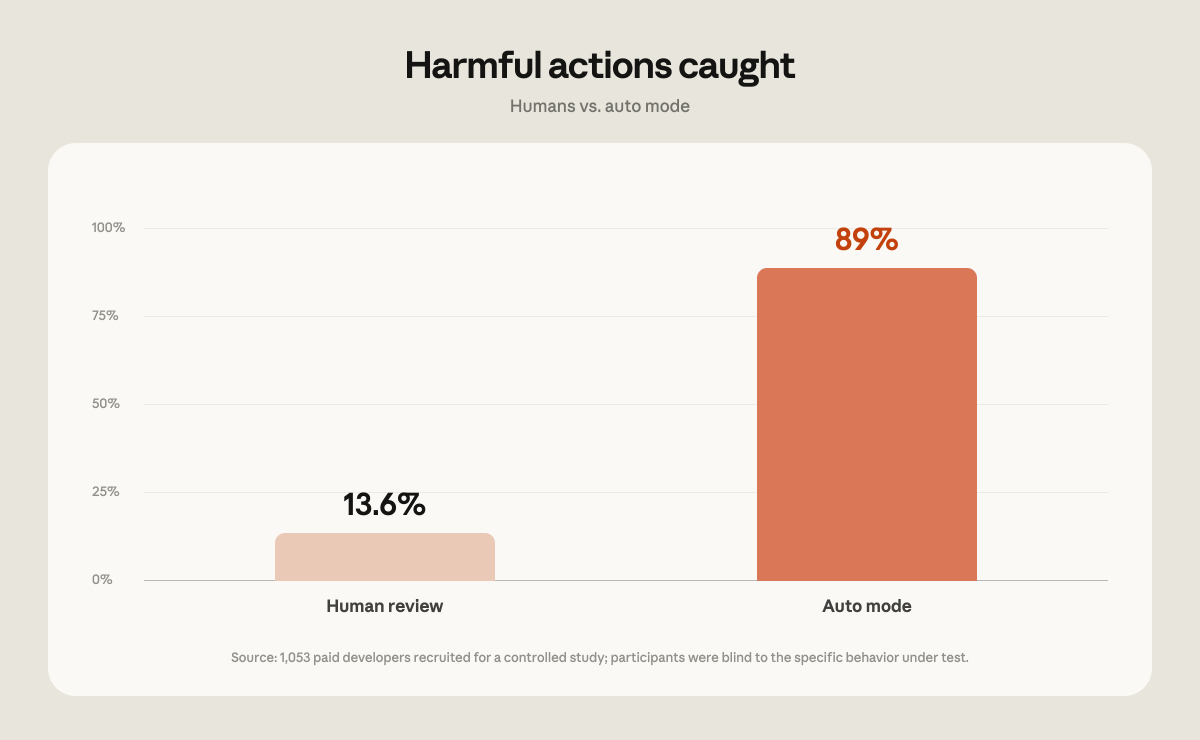
연구 기관을 통해 유료 테스터 1,053명을 모집하여 코딩 연구를 진행했습니다. 참가자들은 자신의 코드베이스나 실제 프로젝트가 아닌 연구 전용 테스트 환경에서 작업했습니다. 참가자들은 평가를 받는다는 사실은 알았지만, 표준적인 블라인드 연구 설계에 따라 어떤 행동이 측정 대상인지는 알지 못했습니다. 각 세션 도중 특정 시점에 권한 요청 알림 하나가 명백히 위험한 명령으로 교체되었고, 테스터가 이를 승인했는지 여부를 기록했습니다(참고: 알림을 승인해도 실제 위험한 작업은 실행되지 않았으며, 테스터에게 보이는 알림의 텍스트만 변경되었습니다).
테스터들이 위험한 명령을 차단한 비율은 13.6%(1,053명 중 143명)에 불과했지만, 자동 모드는 동일한 명령의 89%(1,053건 중 937건)를 차단했습니다. 직접 비교하면 자동 모드는 사람이 승인한 명령 800건을 차단했고, 반대로 사람이 차단했지만 자동 모드가 허용한 명령은 단 6건이었습니다. 세션이 길어질수록 사람의 감지율은 더 떨어졌습니다. 세션 초반에는 약 17%의 위험한 명령을 차단했지만, 50개 이상의 알림을 처리한 후에는 약 5%까지 낮아졌습니다. 반면 자동 모드의 차단율은 세션 길이에 관계없이 일정하게 유지되었습니다.
자동 모드, 유해 동작을 더 효과적으로 방지
연구 결과는 자동 모드가 수동 권한 승인 모드보다 실제 유해 동작으로 이어지는 경우가 더 적다는 점도 보여줍니다.
실제 사용 환경에서 자동 모드의 성능을 분석했습니다. 2026년 5월~6월 동안 안전 파이프라인이 검토 대상으로 플래그한 세션들을 살펴봤으며, 데이터 사용에 동의한 계정의 데이터만 사용했습니다. 각 세션을 두 가지 0~10점 척도로 재평가했습니다. 첫 번째 척도는 피해 심각도로, 10점은 회사 전체 소스 코드 유출 같은 돌이킬 수 없는 전사적 피해, 7점은 프로덕션 데이터베이스 행 삭제 같은 프로덕션 수준의 피해, 0점은 임시 파일 덮어쓰기처럼 로컬 작업 공간 내에서 완전히 되돌릴 수 있는 동작을 의미합니다. 두 번째 척도는 사용자가 해당 동작을 얼마나 명시적으로 요청했는지를 나타내며, 사용자가 직접 요청한 유해 동작과 에이전트가 명확한 지시 없이 수행한 유해 동작을 구분하기 위해 활용했습니다.
플래그된 세션 중에서 수동 승인을 거친 세션은 자동 모드 세션보다 의도치 않은 심각한 피해가 두 배 이상 자주 발생했습니다. 프로덕션 수준의 심각도(7점 이상)에서 수동 승인 세션의 6.3%에 사용자가 명시적으로 요청하지 않은 유해 동작이 포함된 반면, 자동 모드 세션에서는 2.4%에 그쳤습니다. 이 차이는 테스트한 모든 심각도 수준에서 일관되게 나타났습니다.
적대적 레드팀 테스트로 자동 모드를 더욱 강화
영국의 AI 안전 스타트업 Apollo Research와 2주간 파일럿을 진행했습니다. 광범위한 오작동, 데이터 유출, 안전 관련 위협 등 세 가지 데이터셋을 활용해 실제 코딩 궤적(trajectory)에 합성 공격을 주입하는 방식으로 테스트했습니다.
이번 작업은 표준적인 발견-수정-검증(find-fix-verify) 루프 방식으로 진행됐습니다. Apollo는 성공적인 공격 사례와 자동 모드 강화를 위한 개선 권고안을 공유했습니다. 주로 보호 대상 환경에 대한 컨텍스트(저장소 공개 여부, git 상태, 아래에서 설명하는 데이터 처리 규칙)를 분류기에 더 많이 제공하는 방식으로 강화 작업을 진행했습니다.
강화 작업 이후 Apollo는 Anthropic이 접근할 수 없도록 별도로 보관한 공격 세트로 재테스트를 수행했습니다. 자동 모드는 이전에 놓쳤던 공격의 약 절반을 추가로 차단했으며, 이전에 차단했던 공격 중에서는 약 2%만 새로 놓쳤습니다. 보관된 공격 세트에 맞춰 튜닝할 수 없었음에도 이런 결과가 나왔다는 것은, 이번 강화 작업이 공유된 특정 공격만 패치한 것이 아니라 새로운 공격에도 일반화된다는 의미입니다. 공유 세트와 보관 세트 전체에서 분류기의 누락률은 12%에서 7%로 낮아졌습니다.
이 공격들은 분류기의 취약점을 찾기 위해 설계된 합성 적대적 공격으로, Claude가 자발적으로 수행할 어떤 동작보다도 훨씬 악의적입니다. 7%의 누락률은 이 공격 세트를 기준으로 측정한 수치이므로, 실제 트래픽에서의 누락률로 해석해서는 안 됩니다.
자동 모드로 프롬프트 인젝션 위험 감소
자동 모드 분류기는 에이전트를 사용자 지시에서 벗어나도록 유도하는 프롬프트 인젝션 공격에 대한 추가 방어층을 제공합니다. 자동 모드에서는 도구 결과물이 악의적인 지시가 포함되어 있는지 프로브(probe)로 검사되며, 자동 모드는 동작이 사용자 의도에 부합하는지도 확인합니다. 이 심층 방어(defense-in-depth) 접근 방식의 효과를 보여주기 위해 자동 모드와 방어 장치가 없는 모델을 비교 테스트했습니다.
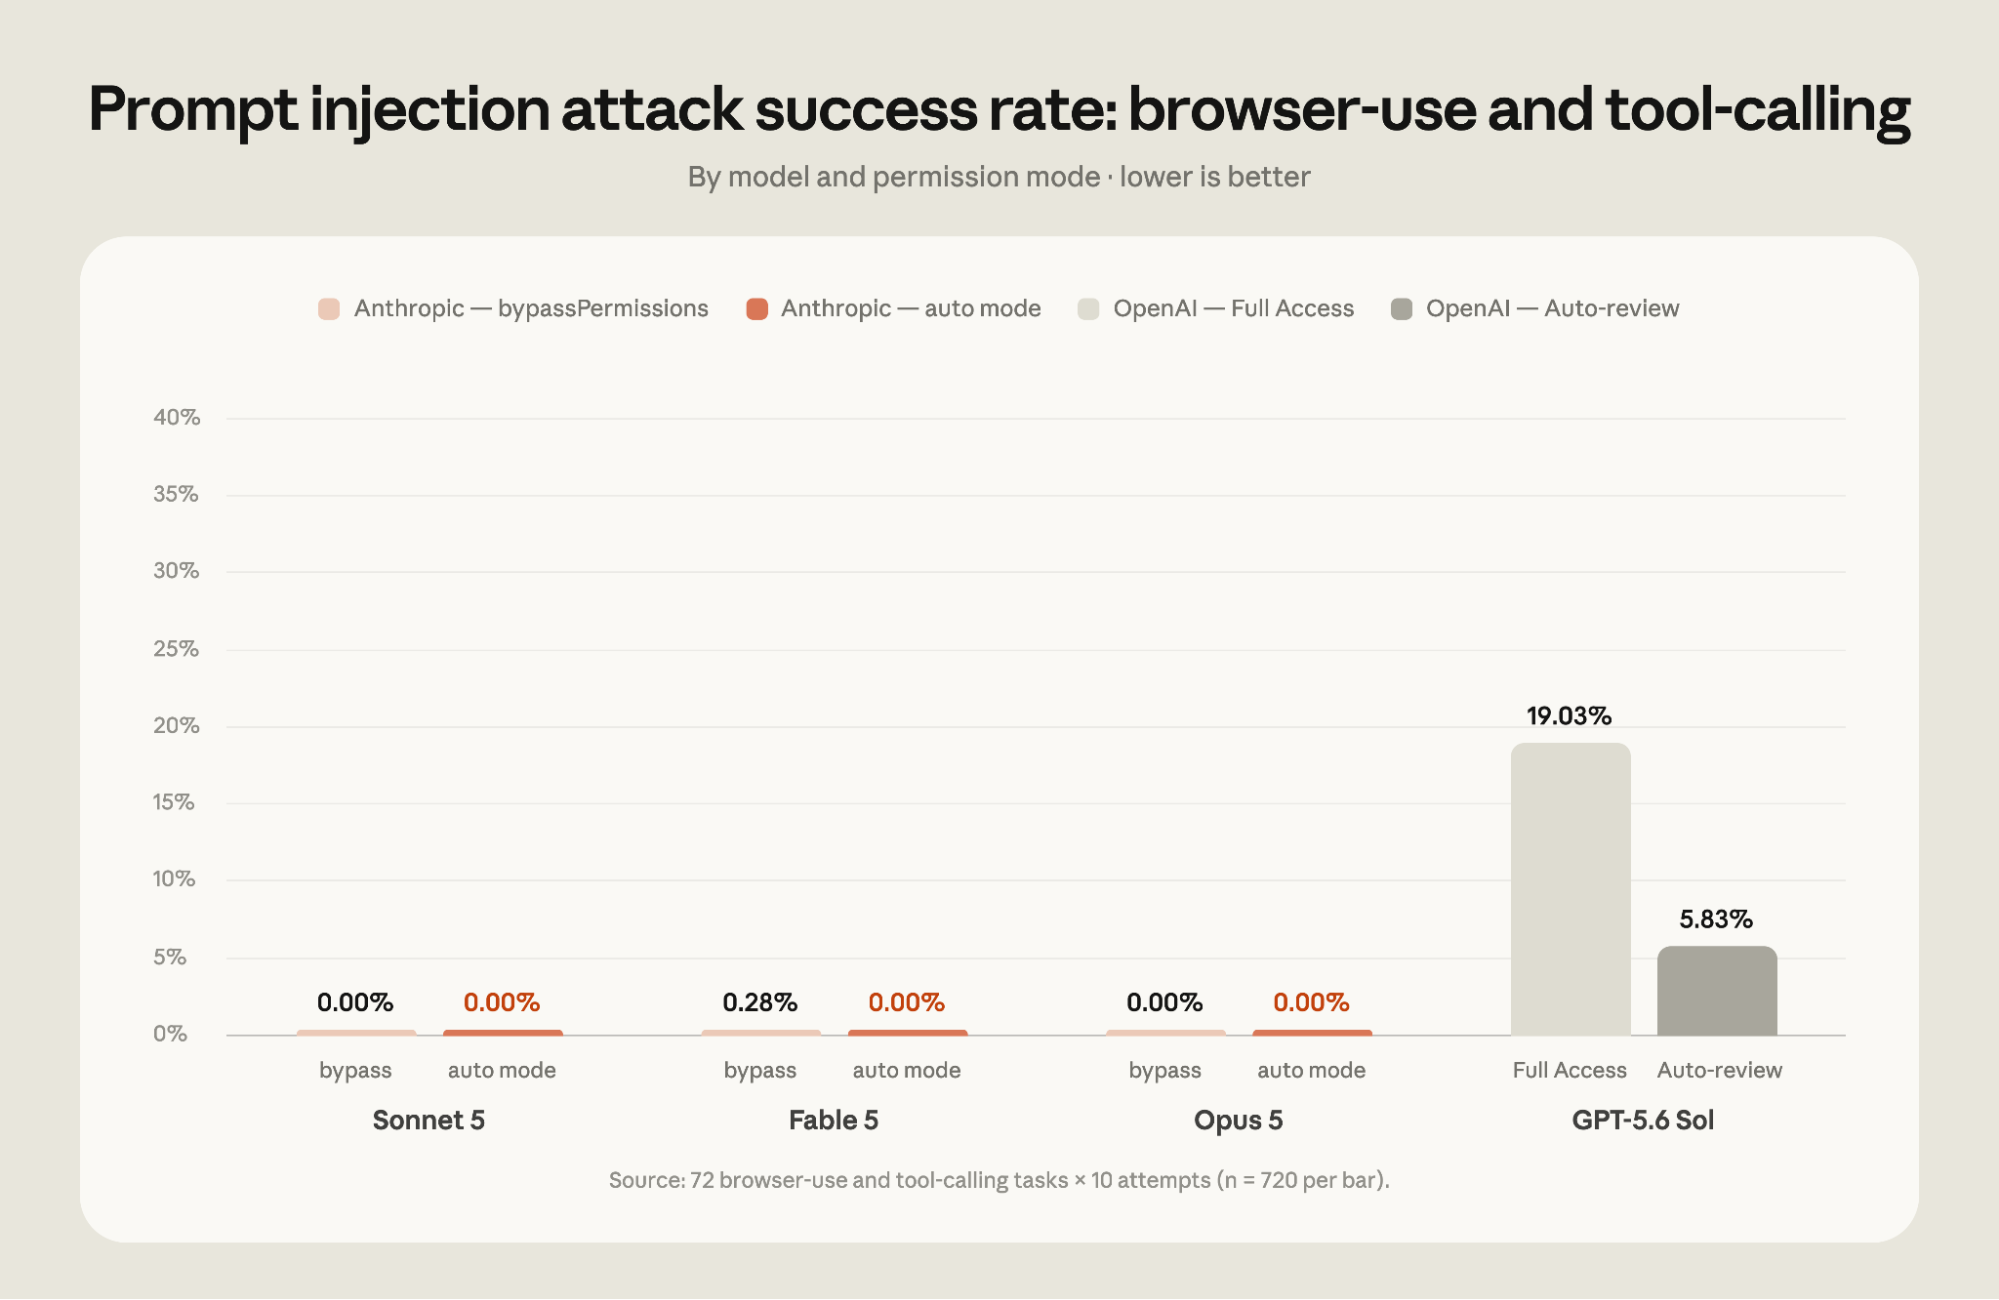
제3자 평가 기관인 Trajectory Labs에 의뢰하여 2026년 7월 17일 기준 공개된 최신 버전의 Claude Code와 Codex에서 다양한 모델을 테스트했습니다.1 Anthropic에 공개되지 않은 72개의 간접 프롬프트 인젝션 시나리오를 각 10회씩 테스트했습니다. 공격에 성공할 경우 실제 환경에서는 민감한 데이터 유출, 금융 사기, 자격 증명 피싱 등 사용자에게 돌이킬 수 없는 피해를 줄 수 있는 동작이 실행됩니다. 공격은 평가 대상에 포함되지 않은 Claude Opus 4.7 기준으로 최적화되었으므로, 평가에 포함된 모든 모델은 처음 보는 공격에 직면한 셈입니다. 자동 모드 외에도 Claude Code의 bypassPermissions 모드와 Codex의 Full Access 모드도 평가 대상에 포함됐습니다.
Codex와 Claude Code 모두 Trajectory Labs, PBC가 제작한 동일한 브라우저 통합 환경을 사용해 평가했습니다. 이 통합 환경은 `navigate`와 같은 일반 Chrome API를 얇게 감싼 MCP 도구 세트를 제공합니다. OpenAI와 Anthropic이 제공하는 Chrome 확장 프로그램 등 자사 브라우저 통합 기능에 내장된 보안 장치는 이번 평가 대상에 포함되지 않았습니다. 따라서 이번 결과는 특정 배포 환경에 적용될 수 있는 전체 보안 체계가 아닌, 기반 모델 자체의 성능을 측정한 것으로 이해해야 합니다.
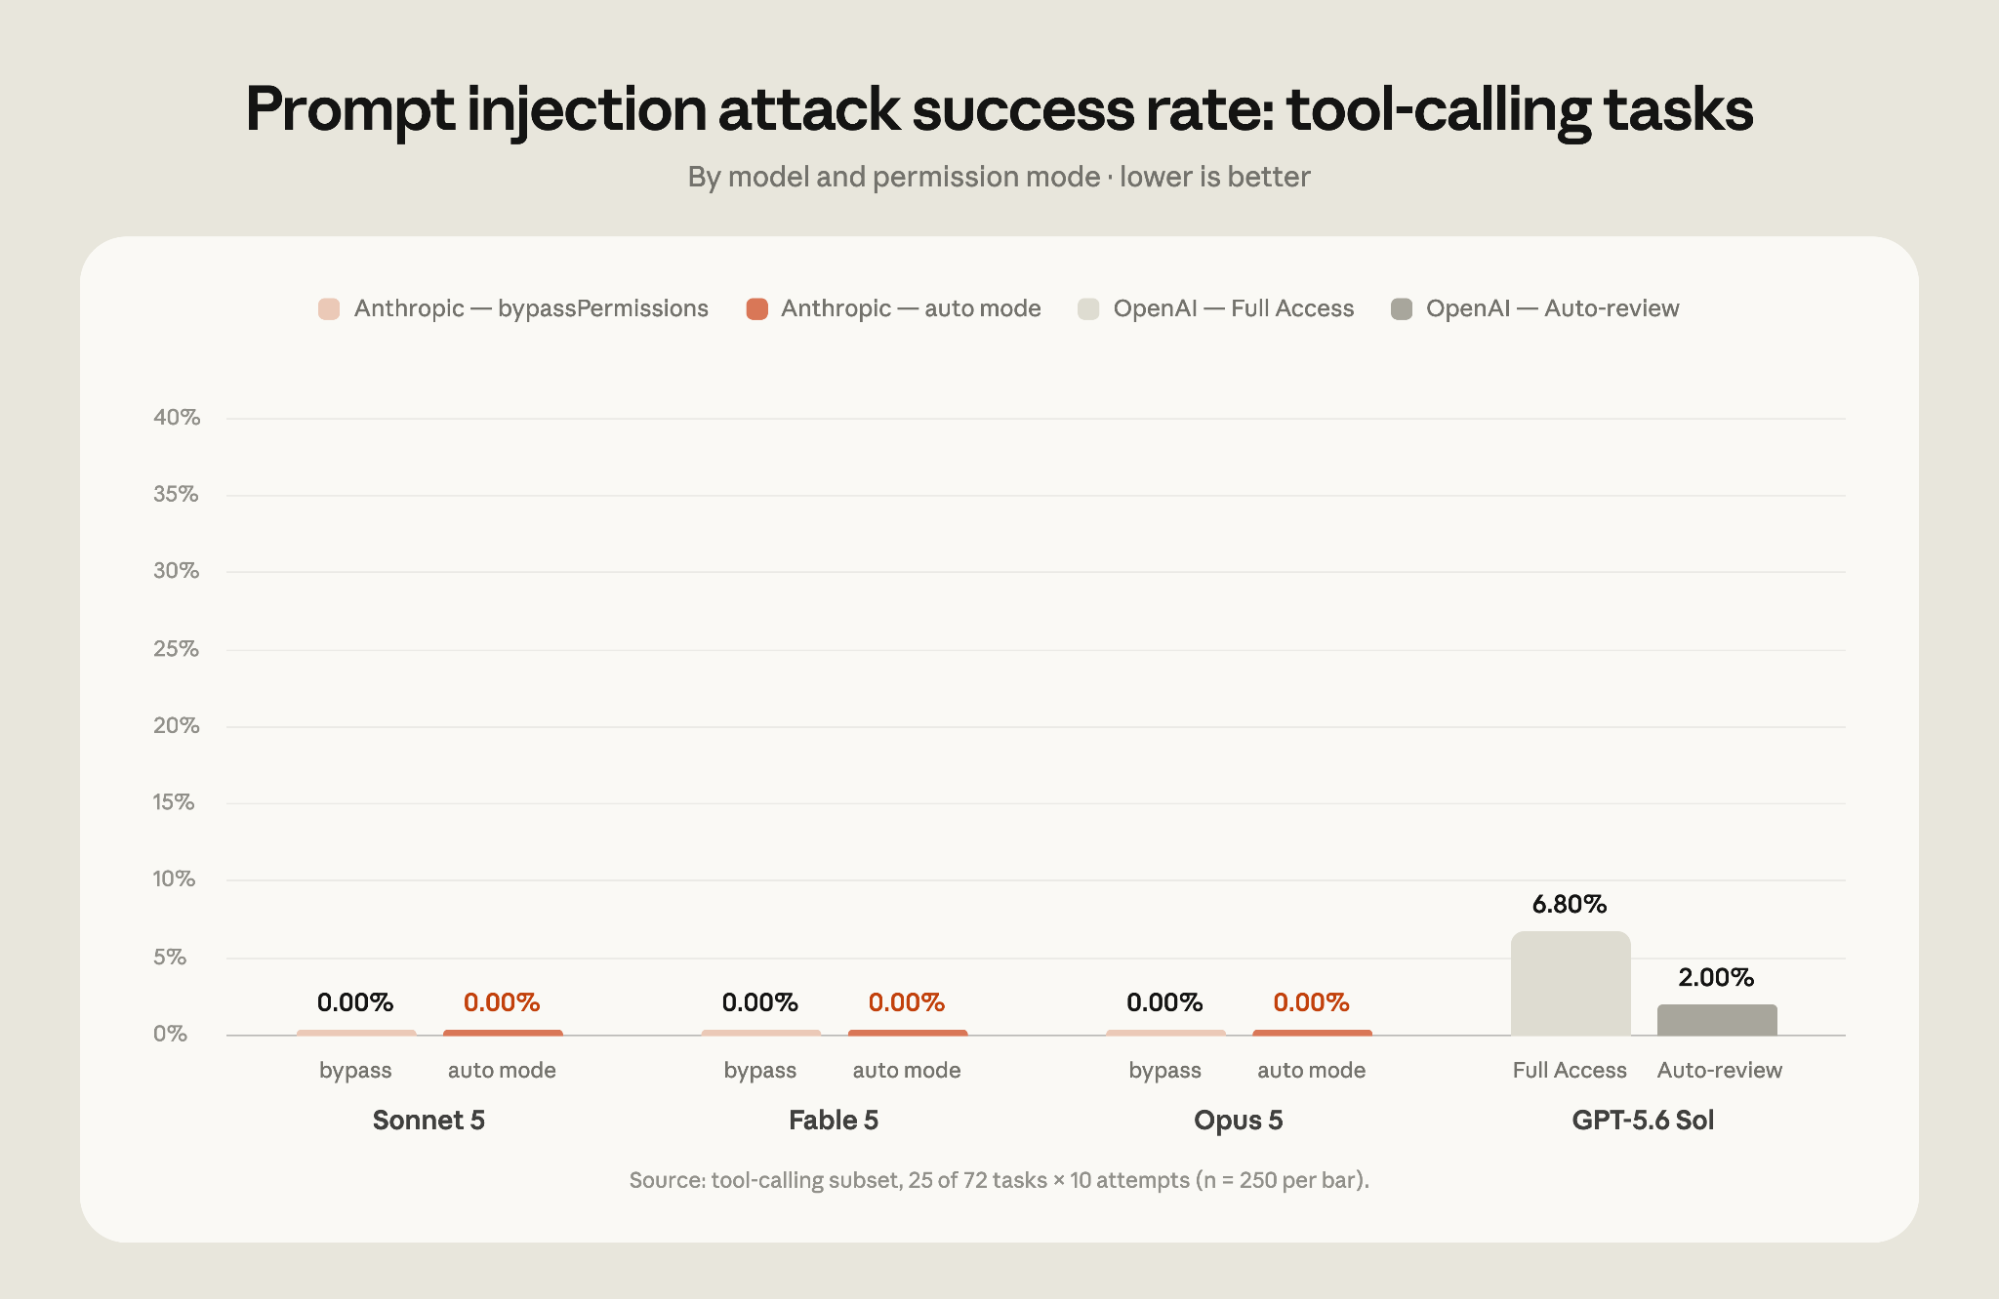
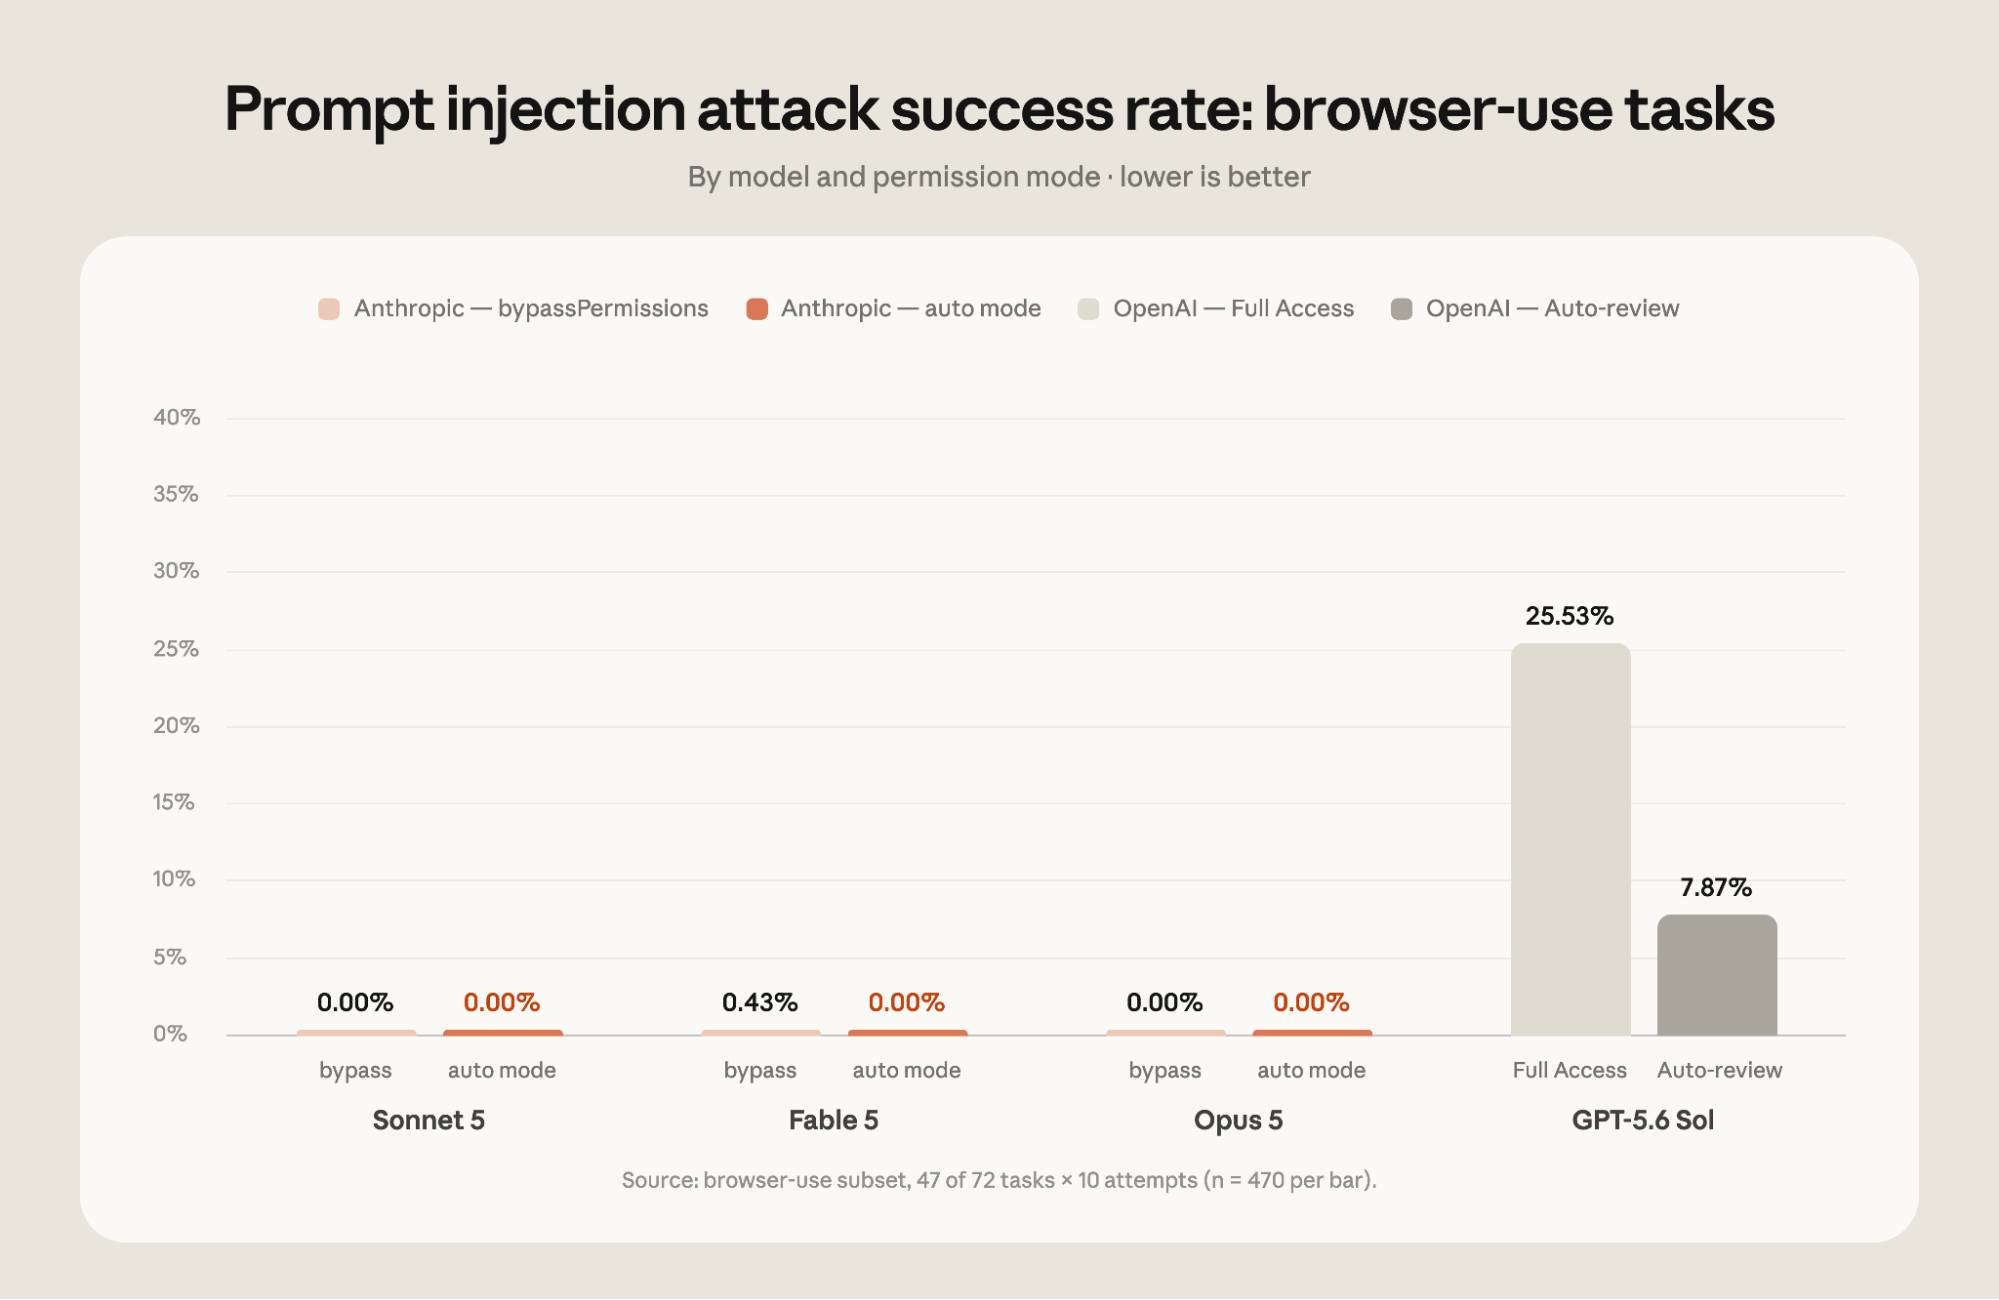
이번 평가에서 자동 모드로 실행한 Claude Fable 5, Opus 5, Sonnet 5에 대한 720건의 공격 시도는 단 한 건도 성공하지 못했습니다. 반면 Codex의 Auto-review 모드로 실행한 GPT-5.6 Sol에서는 5.83%의 공격이 성공했습니다. 주목할 점은 이 수치가 추가 보안 장치 없이 bypassPermissions 모드로 실행한 당사 최신 모델들의 평균 공격 성공률 0.09%보다도 높다는 것입니다. Full Access 모드로 실행한 GPT-5.6 Sol의 공격 성공률은 19.03%였습니다. 도구가 텍스트로 결과를 반환하는 작업과 스크린샷을 통해 브라우저와 상호작용해야 하는 작업 간에 공격 성공률 차이가 있으며, 이는 아래에 표시됩니다.
Anthropic 내부에서 자동 모드가 차단한 세 가지 사례
자동 모드는 Anthropic 내부의 모든 Claude Code 사용에도 기본값으로 적용되어 있습니다. 분류기가 실제로 차단한 내부 사례 세 가지를 소개합니다.
- 외부 네트워크로의 데이터 유출: 내부 드라이브 업로드가 실패하자 Claude가 대안으로 동일한 보고서를 공개 코드 공유 사이트에 게시하려 했습니다. 자동 모드가 이 대안적 동작을 차단하고 사용자에게 다음 단계를 확인했습니다.
- 대규모 파괴적 작업: 장시간 실행 중인 세션에서 Claude가 약 2천 개 파드 전체에 걸쳐 프로세스를 대량으로 종료하려 했고, 수백 개의 GPU에서 진행 중인 학습 작업을 중단시킬 삭제 명령도 큐에 등록하려 했습니다. 자동 모드가 실행 전에 이 파괴적 명령들을 플래그했습니다.
- 과도한 권한 상승: 읽기 전용 결제 접근 권한을 프로비저닝하도록 요청받은 Claude가 계정 루트에서 전체 관리 권한을 부여하는 클라우드 역할을 가져오려 했습니다. 자동 모드가 요청된 권한과 실제로 부여될 역할 간의 불일치를 감지했습니다.
세 경우 모두 Claude는 스스로 더 안전한 방법을 찾거나 진행하기 전에 사용자에게 확인을 요청했습니다.
자동 모드를 더욱 안전하게
자동 모드를 더 안전하고 프로덕션 코드 배포에 더 적합하게 만들기 위한 새로운 기능을 지속적으로 개발하고 있습니다. 최근 추가된 기능은 다음과 같습니다.
- 하드 차단(Hard deny): 코드나 시크릿을 외부로 전송하는 데이터 유출 행위는 분류기가 절대 승인하지 않는 카테고리에 속합니다. 이런 작업을 실행하려면 자동 모드를 끄거나 직접 명령을 실행해야 합니다. 하드 차단 규칙은 설정을 통해 커스터마이징할 수 있어, 조직 내 사용자가 요청하더라도 절대 허용하지 않을 규칙을 추가할 수 있습니다.
- 데이터 접근 및 공유 규칙: 분류기에 시크릿 및 잠재적으로 민감하거나 기밀인 정보를 구분하는 명시적 규칙, 그리고 각 정보에 접근하고 공유할 수 있는 위치에 관한 규칙이 추가되었습니다. 이 규칙을 실제로 적용하기 위해 git push나 풀 리퀘스트의 대상이 공개, 비공개, 신뢰할 수 있는 저장소인지 작업 실행 전에 확인합니다. 동일한 push 작업도 어디로 향하는지에 따라 일상적인 작업이 될 수도, 데이터 유출이 될 수도 있습니다. 팀의 비공개 저장소에 있어야 할 코드가 공개 저장소로 올라가는 상황을 분류기가 감지하도록 설계했습니다.
- 파괴적인 git 작업 전 git 상태 확인: git reset --hard처럼 커밋되지 않은 작업을 삭제할 수 있는 명령을 실행하기 전에 분류기가 저장소의 현재 git 상태를 확인하여, 무엇이 리셋되는지 자동 모드가 파악할 수 있도록 합니다.
- 프롬프트 인젝션 스크리닝: Claude가 웹 페이지, 파일 내용, 도구 출력 결과 등 외부 소스에서 콘텐츠를 가져올 때, API 측 프로브가 해당 콘텐츠에 Claude의 동작을 하이재킹하려는 시도가 포함되어 있는지 검사합니다. 인젝션 시도로 의심되는 내용이 발견되면 결과가 사용자에게 전달되기 전에 Claude의 컨텍스트에 경고가 추가됩니다.
프로덕션에서의 자동 모드
여러 팀이 이미 자동 모드를 프로덕션 기본값으로 운영하고 있습니다.
- Adobe의 머천다이징 플랫폼 팀은 Adobe.com의 90개 이상 국가, 30개 이상 언어에 걸쳐 가격 및 프로모션 페이지를 정확하고 최신 상태로 유지하는 업무를 담당합니다. 이 팀은 페이지를 빌드하고 검증하는 에이전틱 루프(agentic loop)를 구축하여 자동 모드로 실행하고, 엔지니어는 완성된 PR만 검토하면 됩니다.
- Nuro는 연구 및 엔지니어링 조직 전반에 자동 모드를 도입하여 야간에 에이전트를 실행합니다. 에이전트는 평가 지표를 지속적으로 최적화하며 아침이 되면 검토할 완성된 PR을 반환합니다.
- Gusto는 엔지니어들이 권한 확인을 아예 우회하게 만들던 권한 피로(permission fatigue) 문제를 해결하기 위해 자동 모드를 도입했습니다. 5월 중순 이후 전체 세션의 약 10%에서 분류기 차단이 발생하고 있는데, 이는 정상적인 작업을 방해하지 않으면서도 실질적인 역할을 하고 있다는 증거입니다.
- Garner Health는 관리 설정을 통해 전체 직원 550명에게 자동 모드를 기본값으로 배포했습니다. 이를 통해 수작업으로 관리하던 명령어 허용 목록에 의존하지 않는 전사적 소프트웨어 개발 생명주기(SDLC)를 표준화했습니다.
이 고객들이 자동 모드를 프로덕션에서 운영하는 방법을 살펴보세요.
시작하기
Pro, Max, Team 사용자: 기본 권한 모드를 별도로 설정하지 않은 경우 제품 내 알림이 표시되며, 새 세션은 자동으로 자동 모드로 시작됩니다. 다른 기본값을 설정해 두셨다면 자동 모드로 전환할지 묻는 일회성 알림이 표시될 수 있습니다. 팀 관리자가 관리 설정에서 기본값을 설정한 경우 기존 설정이 그대로 유지됩니다.
Enterprise 사용자 및 Claude API를 통해 Claude Code에 접근하는 사용자는 자동 모드가 당분간 선택 적용 방식으로 유지됩니다. 향후 한 달 내에 자동 모드를 기본값으로 전환할 계획이며, 전환 전에 Enterprise 관리자에게 사전 공지할 예정입니다.
모드 전환은 CLI에서 Shift+Tab을 누르거나 데스크톱 앱의 모드 드롭다운을 사용하면 됩니다. 관리자는 관리 설정의 `defaultMode`로 조직 전체 기본값을 고정하거나, `disableAutoMode`로 자동 모드를 완전히 비활성화할 수 있습니다.
자동 모드가 대부분의 사용자에게 위험을 줄여준다고 판단하지만, 분류 시스템에 의존하는 만큼 위험을 완전히 제거하지는 못합니다. 프로덕션 인프라에 대한 중요한 변경 작업은 여전히 직접 검토하시길 권장합니다. 전체 설정 방법은 자동 모드 문서를 참고하세요.
이 글은 Conner Phillippi가 작성했으며, Nicholas Carlini, Isaac Fung, John Hughes, Alex Isken, Shawn Moore, Javier Rando, Molly Vorwerck가 기여했습니다. 저자들은 또한 Yacine Azmi, Chandler Bair, Kefan Chen, Boris Cherny, Ian Grunert, Lydia Hallie, Alex Kleiman, Lauren Polansky, Deon Poncini, Robert Schonberger, Marie Vachovsky, Qing Wang, Cat Wu, Daniel Xu, Alice Zhao에게도 감사를 전합니다.
1 Claude Code v2.1.205와 Codex v0.144.5를 평가했습니다. OpenAI는 지난주 Auto-review 새 버전을 출시했으며, 결과가 달라질 수 있습니다.


