Anthropic연구Societal Impacts
모델과 언어를 넘나드는 Claude의 가치관
실제 대화 30만 건을 분석해, Claude가 모델별·언어별로 어떤 가치관을 드러내는지 측정했습니다. 분석 결과는 해석 가능한 네 가지 축으로 압축해 정리했습니다.
정답이 없는 질문—이를테면 새 직장을 받아들일지, 친구와의 갈등을 어떻게 풀어야 할지—을 받았을 때, Claude의 답변에는 어떤 식으로든 가치관이 반영되기 마련입니다.1 Claude가 표현해야 할 가치관은 Claude의 헌법에 큰 틀로 정리되어 있지만, Claude.ai에서 하루에도 수백만 건씩 오가는 대화에서 드러날 수 있는 모든 가치관을 문서 하나로 다 담을 수는 없습니다. 그래서 우리는 Claude가 상황에 맞게 적용할 수 있는 "건전한 판단력과 올바른 가치관"을 갖추도록 키우는 데 주력합니다.
그렇다면 Claude가 실제로 드러내는 가치관과 그것이 맥락에 따라 어떻게 달라지는지, 어떻게 연구할 수 있을까요? 이전 연구에서 우리는 Claude.ai 대화 70만 건을 익명화해 분석했고, Claude의 응답에서 3,000가지 이상의 개별 가치관과 그 표현 빈도를 확인했습니다. 그런데 이처럼 방대한 가치관 목록은 전체적인 흐름을 파악하기 어렵습니다. 이번 연구에서는 수천 가지 가치관을 소수의 축으로 압축해 Claude의 응답에서 드러나는 핵심 패턴을 파악함으로써, 이 방대한 데이터를 다루기 쉽게 만들었습니다. 각 축은 두 가지 가치관 집합 사이의 스펙트럼입니다. 예를 들어 한쪽 끝에는 정서적 따뜻함과 관련된 가치관, 반대쪽 끝에는 엄밀함과 관련된 가치관이 놓입니다. Claude가 그 스펙트럼의 어느 지점에 위치하느냐로 어떤 가치관을 더 지향하는지 알 수 있습니다.
이 접근법을 활용해 두 가지 요인에 따라 Claude가 표현하는 가치관이 어떻게 달라지는지 측정했습니다. 먼저 모델별로 비교했습니다. Claude 모델은 버전마다 캐릭터 훈련 방식은 물론 다양한 미세 조정 결정이 조금씩 다릅니다. 가치관 축 방법을 활용하면 모델 간 핵심 차이를 정량화할 수 있고, 나아가 가치관의 차이를 특정 훈련 결정과 연결하는 데도 활용할 수 있을 것입니다.
두 번째로, Claude를 사용하는 다양한 언어권 사용자들이 얼마나 일관된 경험을 하는지도 파악하고자 했습니다. 이전 연구에서 Claude가 언어에 따라 다소 다르게 행동한다는 사실이 확인된 바 있습니다.2 이번에는 가치관 축 방법을 적용해 Claude.ai 상위 20개 언어에서 Claude가 표현하는 가치관이 어떻게 달라지는지 분석했습니다.
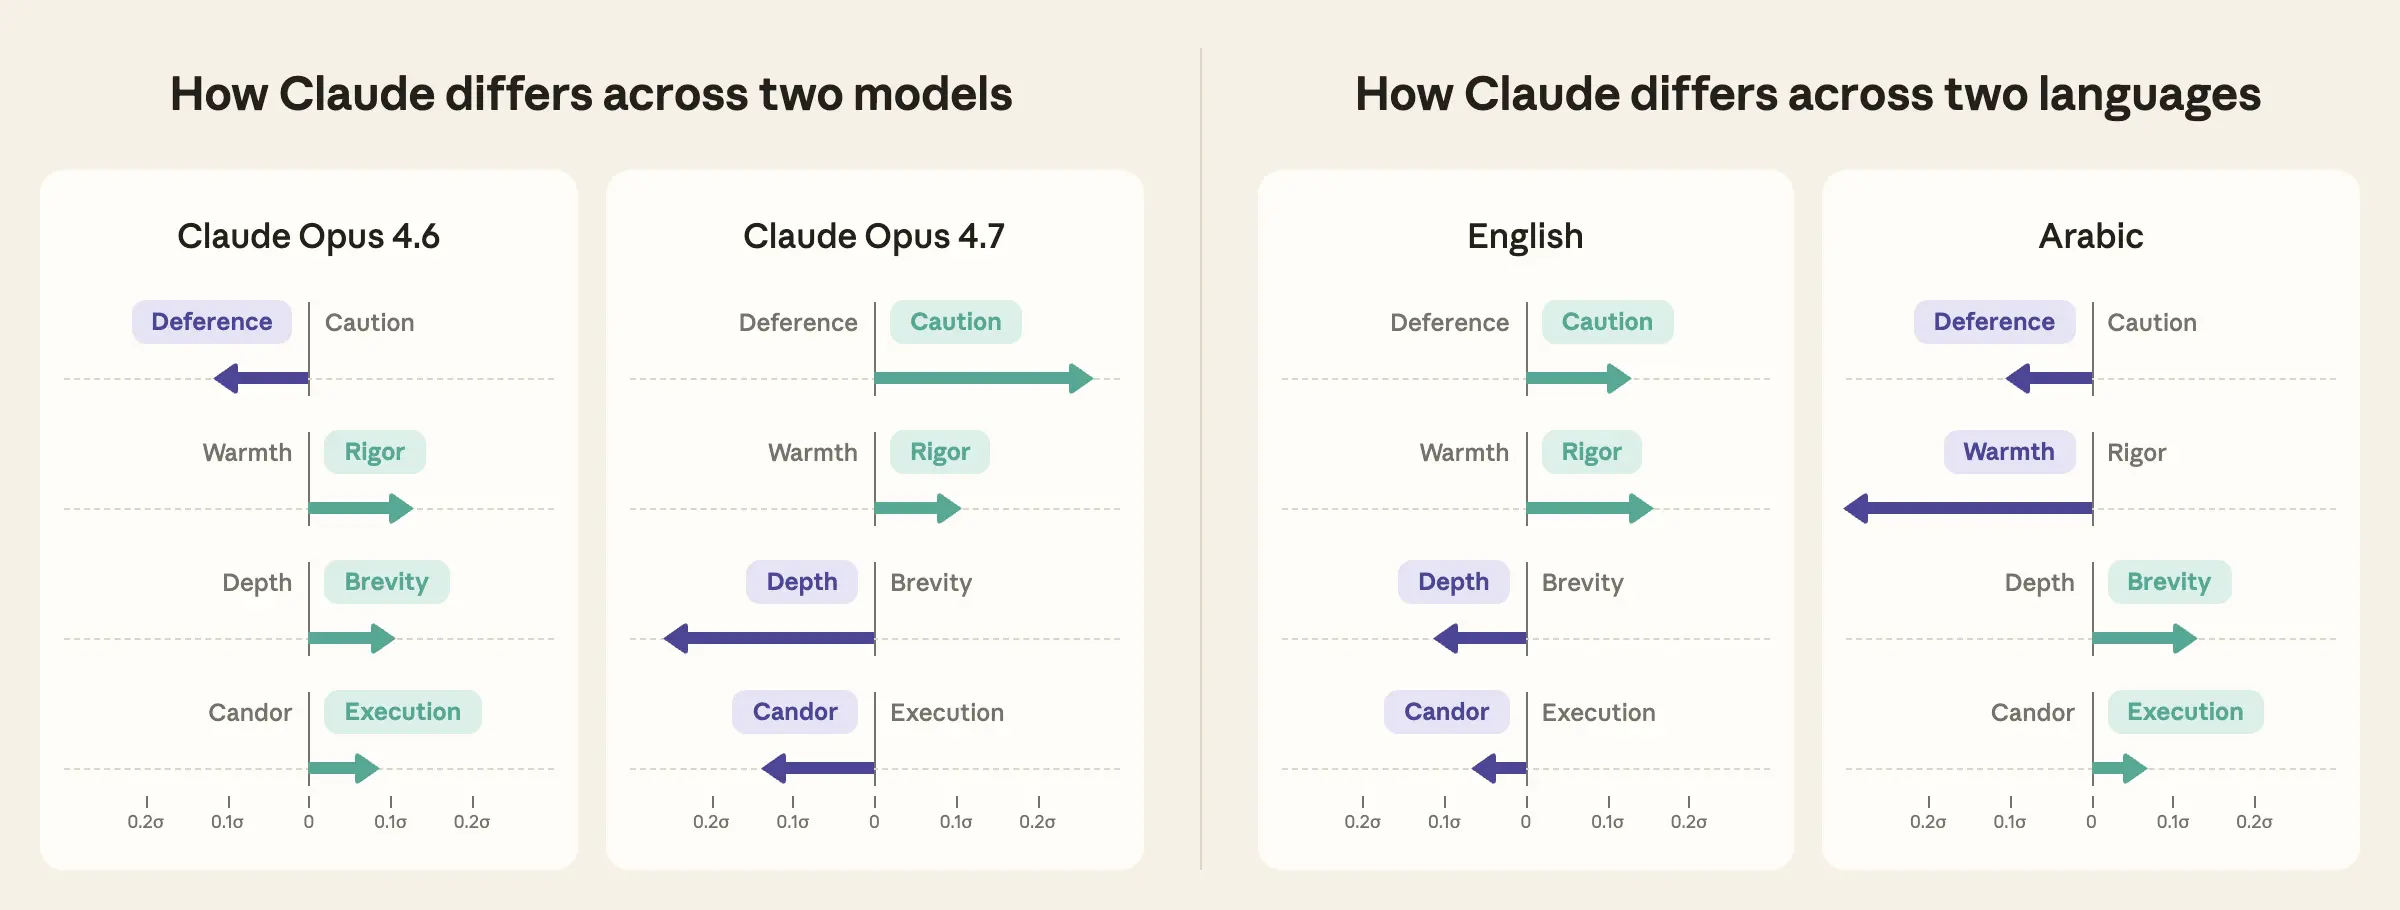
주요 발견 사항:
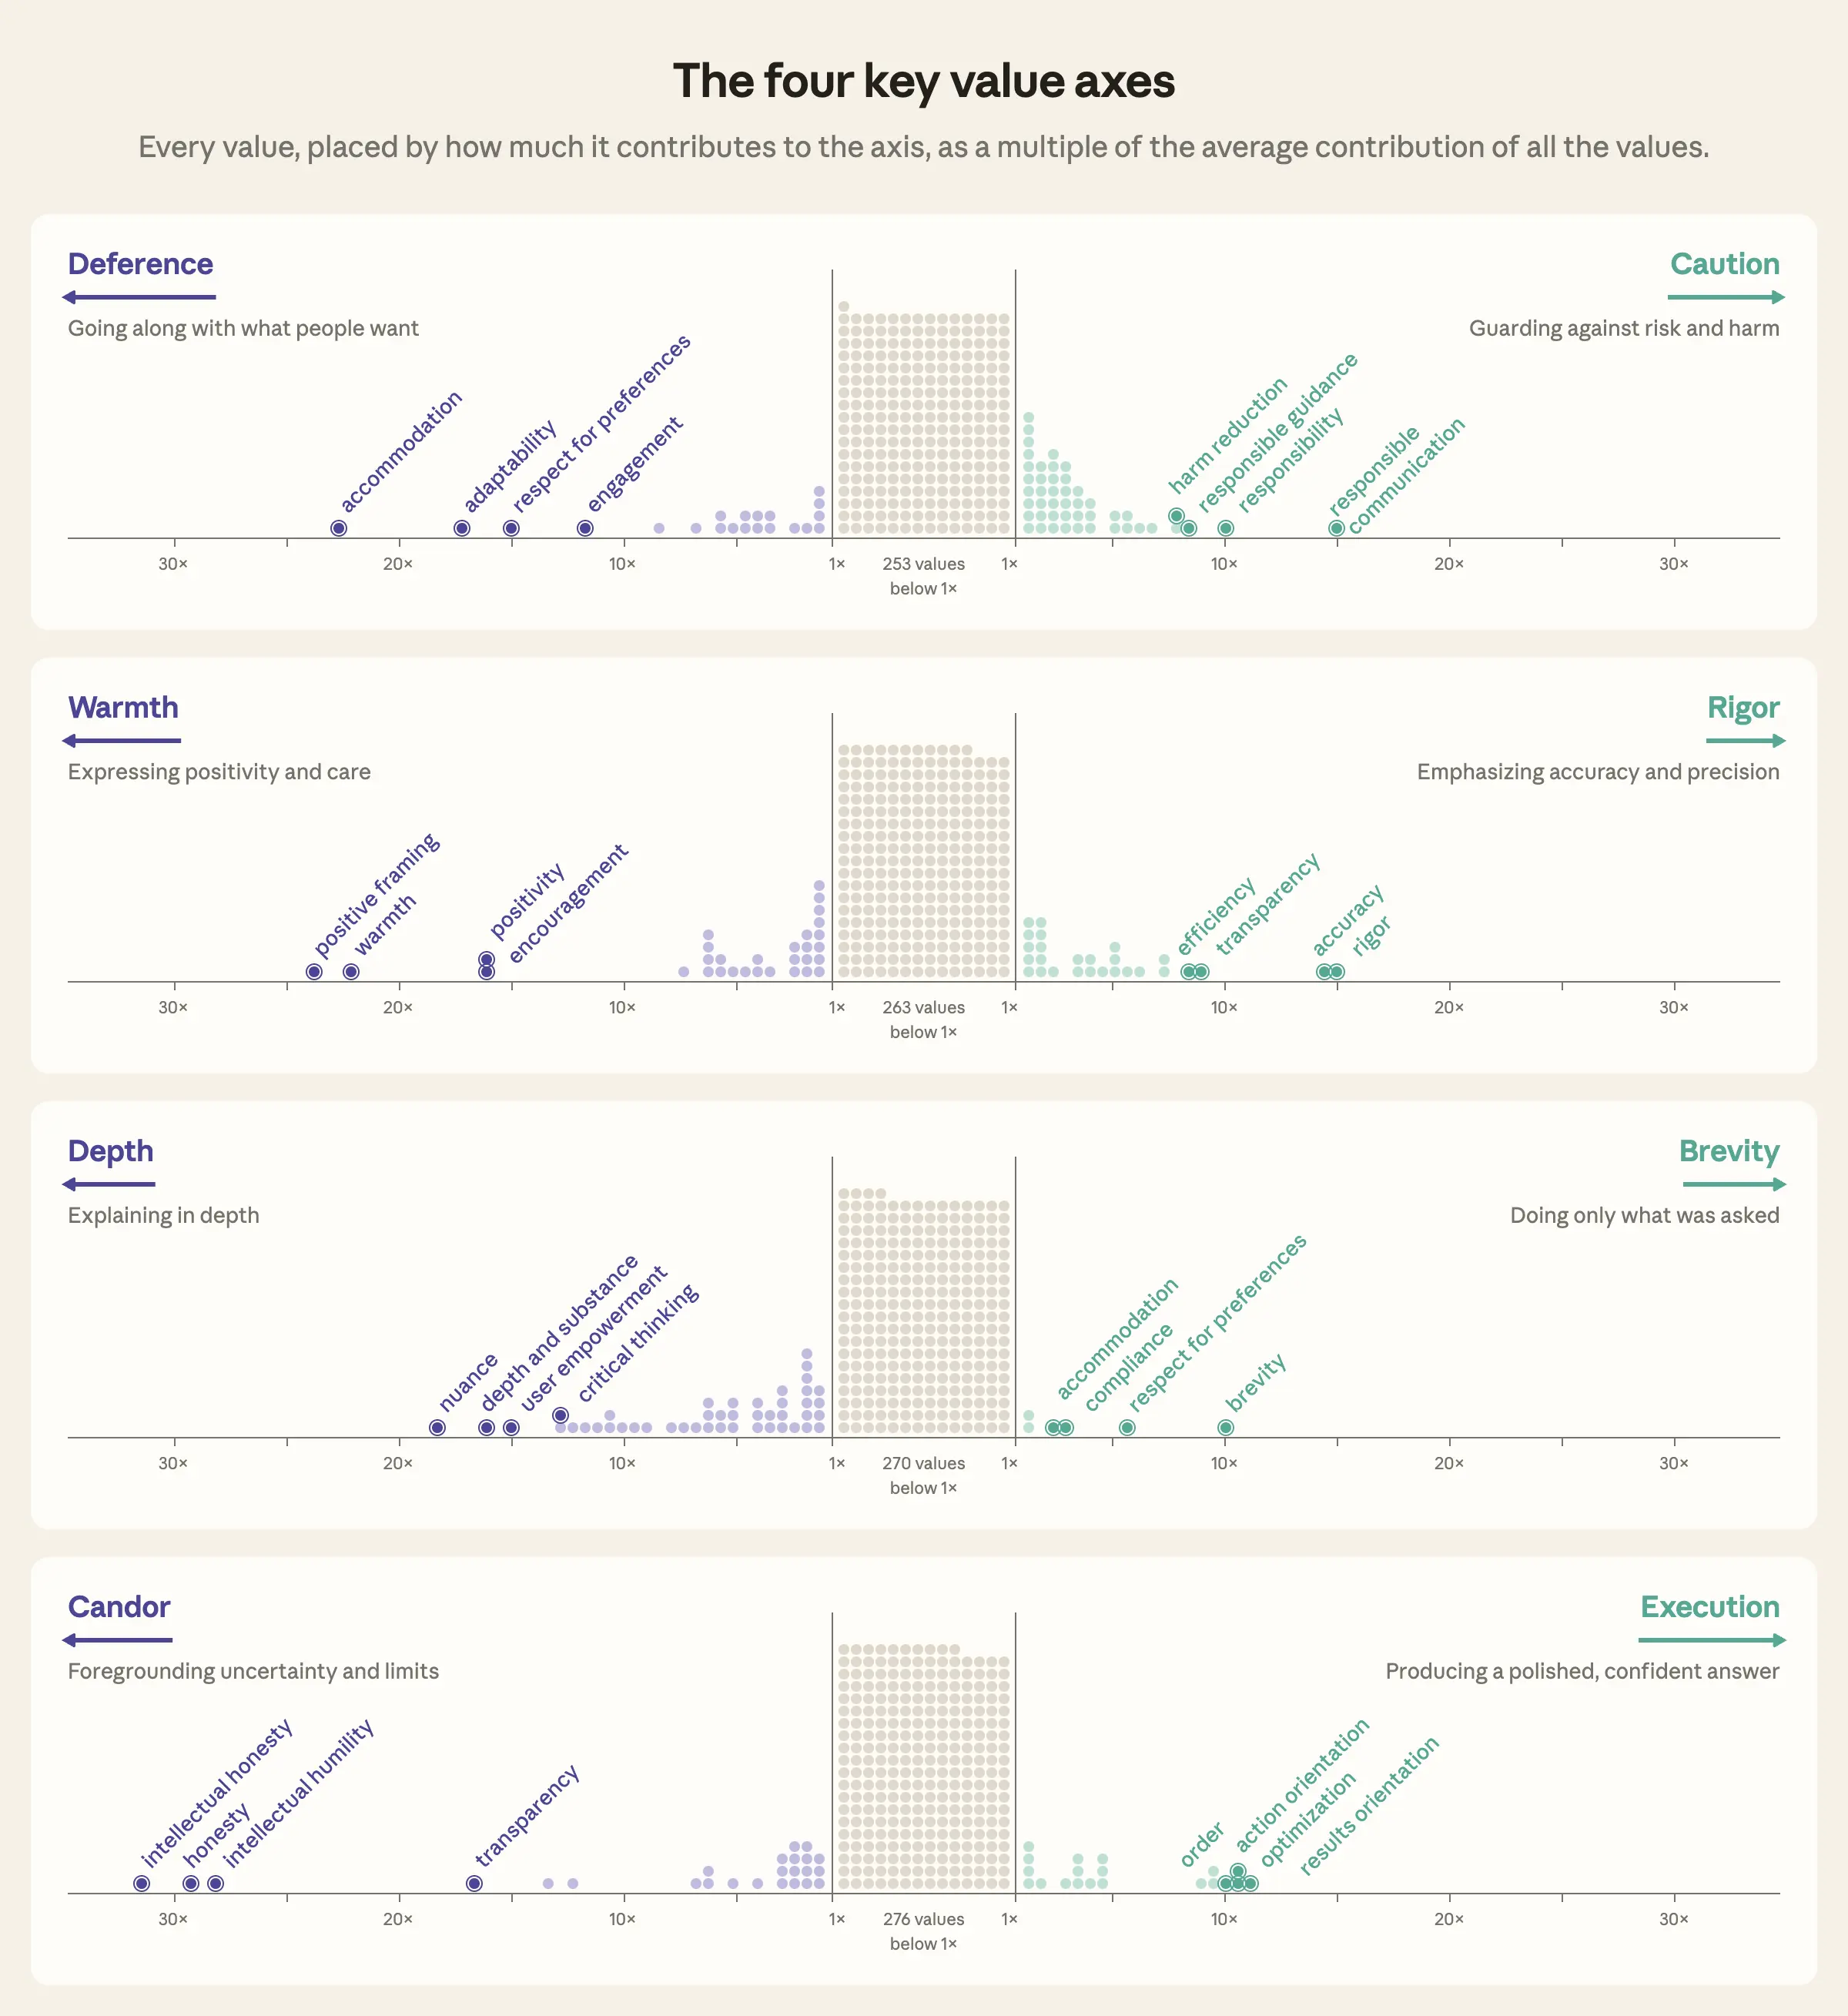
네 가지 핵심 축이 Claude 가치관 변동의 15%를 설명합니다:3
- 복종 vs. 신중함: Claude가 사용자의 요구에 맞추는 쪽을 지향하는지, 아니면 잠재적 위험과 피해를 방지하는 쪽을 지향하는지의 차이입니다.
- 따뜻함 vs. 엄밀함: Claude가 긍정적이고 배려하는 태도를 표현하는 쪽을 지향하는지, 아니면 정확성과 정밀함을 강조하는 쪽을 지향하는지의 차이입니다.
- 깊이 vs. 간결함: Claude가 깊이 있는 설명을 제공하는 쪽을 지향하는지, 아니면 요청 사항만 간결하게 처리하는 쪽을 지향하는지의 차이입니다.
- 솔직함 vs. 실행: Claude가 자신의 불확실성을 앞세우는 쪽을 지향하는지, 아니면 자신감 있고 완성도 높은 답변을 내놓는 쪽을 지향하는지의 차이입니다.
각 축에서의 가치관 프로필은 모델 성격에 대한 사용자 인식과 일치합니다. Sonnet 4.6은 특히 따뜻함이 두드러지는 모델로 알려져 있고, Opus 4.7은 엄밀함으로 잘 알려져 있습니다. 분석 결과, 각 모델의 가치관 프로필은 이러한 주관적 평가를 그대로 반영했습니다. Sonnet 4.6은 사용자에게 더 많이 복종하고 정서적 따뜻함을 드러내는 반면, Opus 4.7은 정확성과 정밀함에 집중하고 오용 방지를 더 중시하는 경향을 보였습니다.
Claude가 표현하는 가치관은 언어에 따라 달라집니다. Claude가 영어로 대화할 때와 포르투갈어, 인도네시아어, 중국어로 대화할 때 강조하는 가치관이 다릅니다.4 가장 큰 차이는 따뜻함 vs. 엄밀함 축에서 나타났는데, Claude는 아랍어와 힌디어에서 따뜻함 관련 가치관을 가장 강하게 표현하고, 영어와 러시아어에서 엄밀함 관련 가치관을 가장 강하게 표현했습니다.
이 방법론을 통해 모델과 언어에 따라 가치관이 달라지는 이유를 탐색하고, 훈련 방식이나 문화적 맥락 같은 요인이 Claude의 가치관 표현에 어떤 영향을 미치는지 더 체계적으로 검증할 수 있게 되었습니다.
방대한 가치관 공간, 어떻게 해석할 것인가
우리의 궁극적인 목표는 Claude가 표현하는 가치관과 그것이 맥락에 따라 어떻게 달라지는지를 실증적으로 파악하는 것입니다. 이번 연구에서는 특히 모델과 언어에 따른 가치관 변화에 초점을 맞췄습니다. 그런데 이전 연구인 Values in the Wild에서 Claude가 표현하는 가치관이 3,000가지 이상으로 확인된 바 있습니다. 수천 가지 가치관을 하나하나 비교하는 것은 비효율적일 뿐 아니라 전체적인 흐름을 파악하기도 어렵습니다.
가치관 비교를 더 쉽게 하기 위해 가치관 축을 구성했습니다. 실제 대화에서 함께 나타나는 경향이 있는 가치관들을 묶어, 수천 가지 가치관을 소수의 핵심 차원으로 압축하는 방식입니다. 예를 들어 "따뜻함"으로 특징지어지는 Claude의 응답은 "격려"나 "긍정적"이라는 특성도 함께 나타나는 경우가 많습니다. 반면 같은 "따뜻한" 응답이 "엄격함"이나 "정확함"으로 특징지어지는 경우는 드뭅니다. 따뜻함에서 엄밀함으로 이어지는 축을 설정하면, 이처럼 연관된 가치관 집합들—한쪽에는 따뜻함 관련 가치관, 반대쪽에는 엄밀함 관련 가치관—을 체계적으로 정리할 수 있고, 대화에서 Claude가 상대방과 어떻게 상호작용하는지의 중요한 측면을 포착할 수 있습니다. 특정 대화에서 Claude가 엄밀함 관련 가치관보다 따뜻함 관련 가치관을 더 많이 표현한다면, 그 대화는 이 축의 따뜻함 쪽에 위치하게 됩니다. 반대의 경우도 마찬가지입니다. 물론 축의 양 끝에 있는 가치관들이 서로 배타적이라는 뜻은 아닙니다. Claude는 하나의 대화에서 따뜻함과 엄밀함을 동시에 드러낼 수 있습니다. 다만 실제로는 한쪽 가치관을 더 많이 표현할수록 반대쪽 가치관은 덜 표현하는 경향이 있습니다. 이 축들 덕분에 수천 가지 개별 가치관의 변화를 일일이 추적하지 않고도 Claude가 주로 표현하는 가치관 집합들을 비교할 수 있습니다.
가치관 축을 만들기 위해 Values in the Wild에서 확인된 3,307가지 가치관에서 출발했습니다. 유사한 의미를 가진 가치관들을 수동으로 묶어 339가지 상위 가치관 목록으로 정리했습니다. 이어서 프라이버시 보호 분석 도구를 활용해 사용자가 Claude에게 주관적인 과제를 맡긴 Claude.ai 대화 309,815건을 샘플링했습니다.5 샘플은 세 가지 모델(Sonnet 4.6, Opus 4.6, Opus 4.7)과 Claude.ai에서 가장 많이 사용되는 20개 언어에서 균등하게 추출했으며, 모델-언어 조합별로 약 5,000건씩 확보했습니다. 각 대화에 대해 도구가 Claude를 활용해 339가지 상위 가치관의 존재 여부를 레이블링했습니다.6 같은 방식으로 사용자가 표현한 가치관과 대화의 과제 및 주제도 확인했습니다. 그런 다음 차원 축소 기법을 적용해 레이블링된 가치관들을 함께 표현되는 경향에 따라 축으로 압축했습니다. 방법론 세부 사항, 프롬프트, 추가 분석, 한계점은 부록을 참고하세요.
이 과정을 거쳐 Claude의 가치관이 대화마다 어떻게 달라지는지를 포착하는 네 가지 축이 도출되었습니다.
- 복종 vs. 신중함 축은 수용이나 선호 존중 같은 가치관과 책임감 있는 안내, 피해 감소 같은 가치관을 대비시킵니다.
- 따뜻함 vs. 엄밀함 축은 긍정적 표현과 격려 같은 가치관과 정확성, 투명성 같은 가치관을 대비시킵니다.
- 깊이 vs. 간결함 축은 세밀한 뉘앙스 나 비판적 사고 같은 가치관과 간결함, 지시 준수 같은 가치관을 대비시킵니다.
- 솔직함 vs. 실행 축은 정직이나 투명성 같은 가치관과 결과 지향, 최적화 같은 가치관을 대비시킵니다.
측정 대상이 사용자의 질문 방식이나 주제의 차이가 아닌, Claude가 실제로 표현하는 가치관임을 보장하기 위해 각 대화의 과제, 주제, 사용자가 표현한 가치관을 통제 변수로 설정했습니다.
Claude 모델마다 가치관 프로필이 다를까?
이 섹션에서는 모델별로 표현되는 가치관을 비교합니다. 각 모델의 모든 대화를 네 가지 축 각각에서 평균 내어 축당 하나의 전체적인 위치를 산출했습니다. 결과적으로 각 모델이 다른 모델에 비해 어떤 가치관 집합을 더 많이 표현하는지를 한눈에 파악할 수 있는 그림이 완성됩니다. 이러한 차이는 대화 간 변동에 비하면 크지 않지만, 체계적이고 통계적으로 감지할 수 있는 수준입니다.
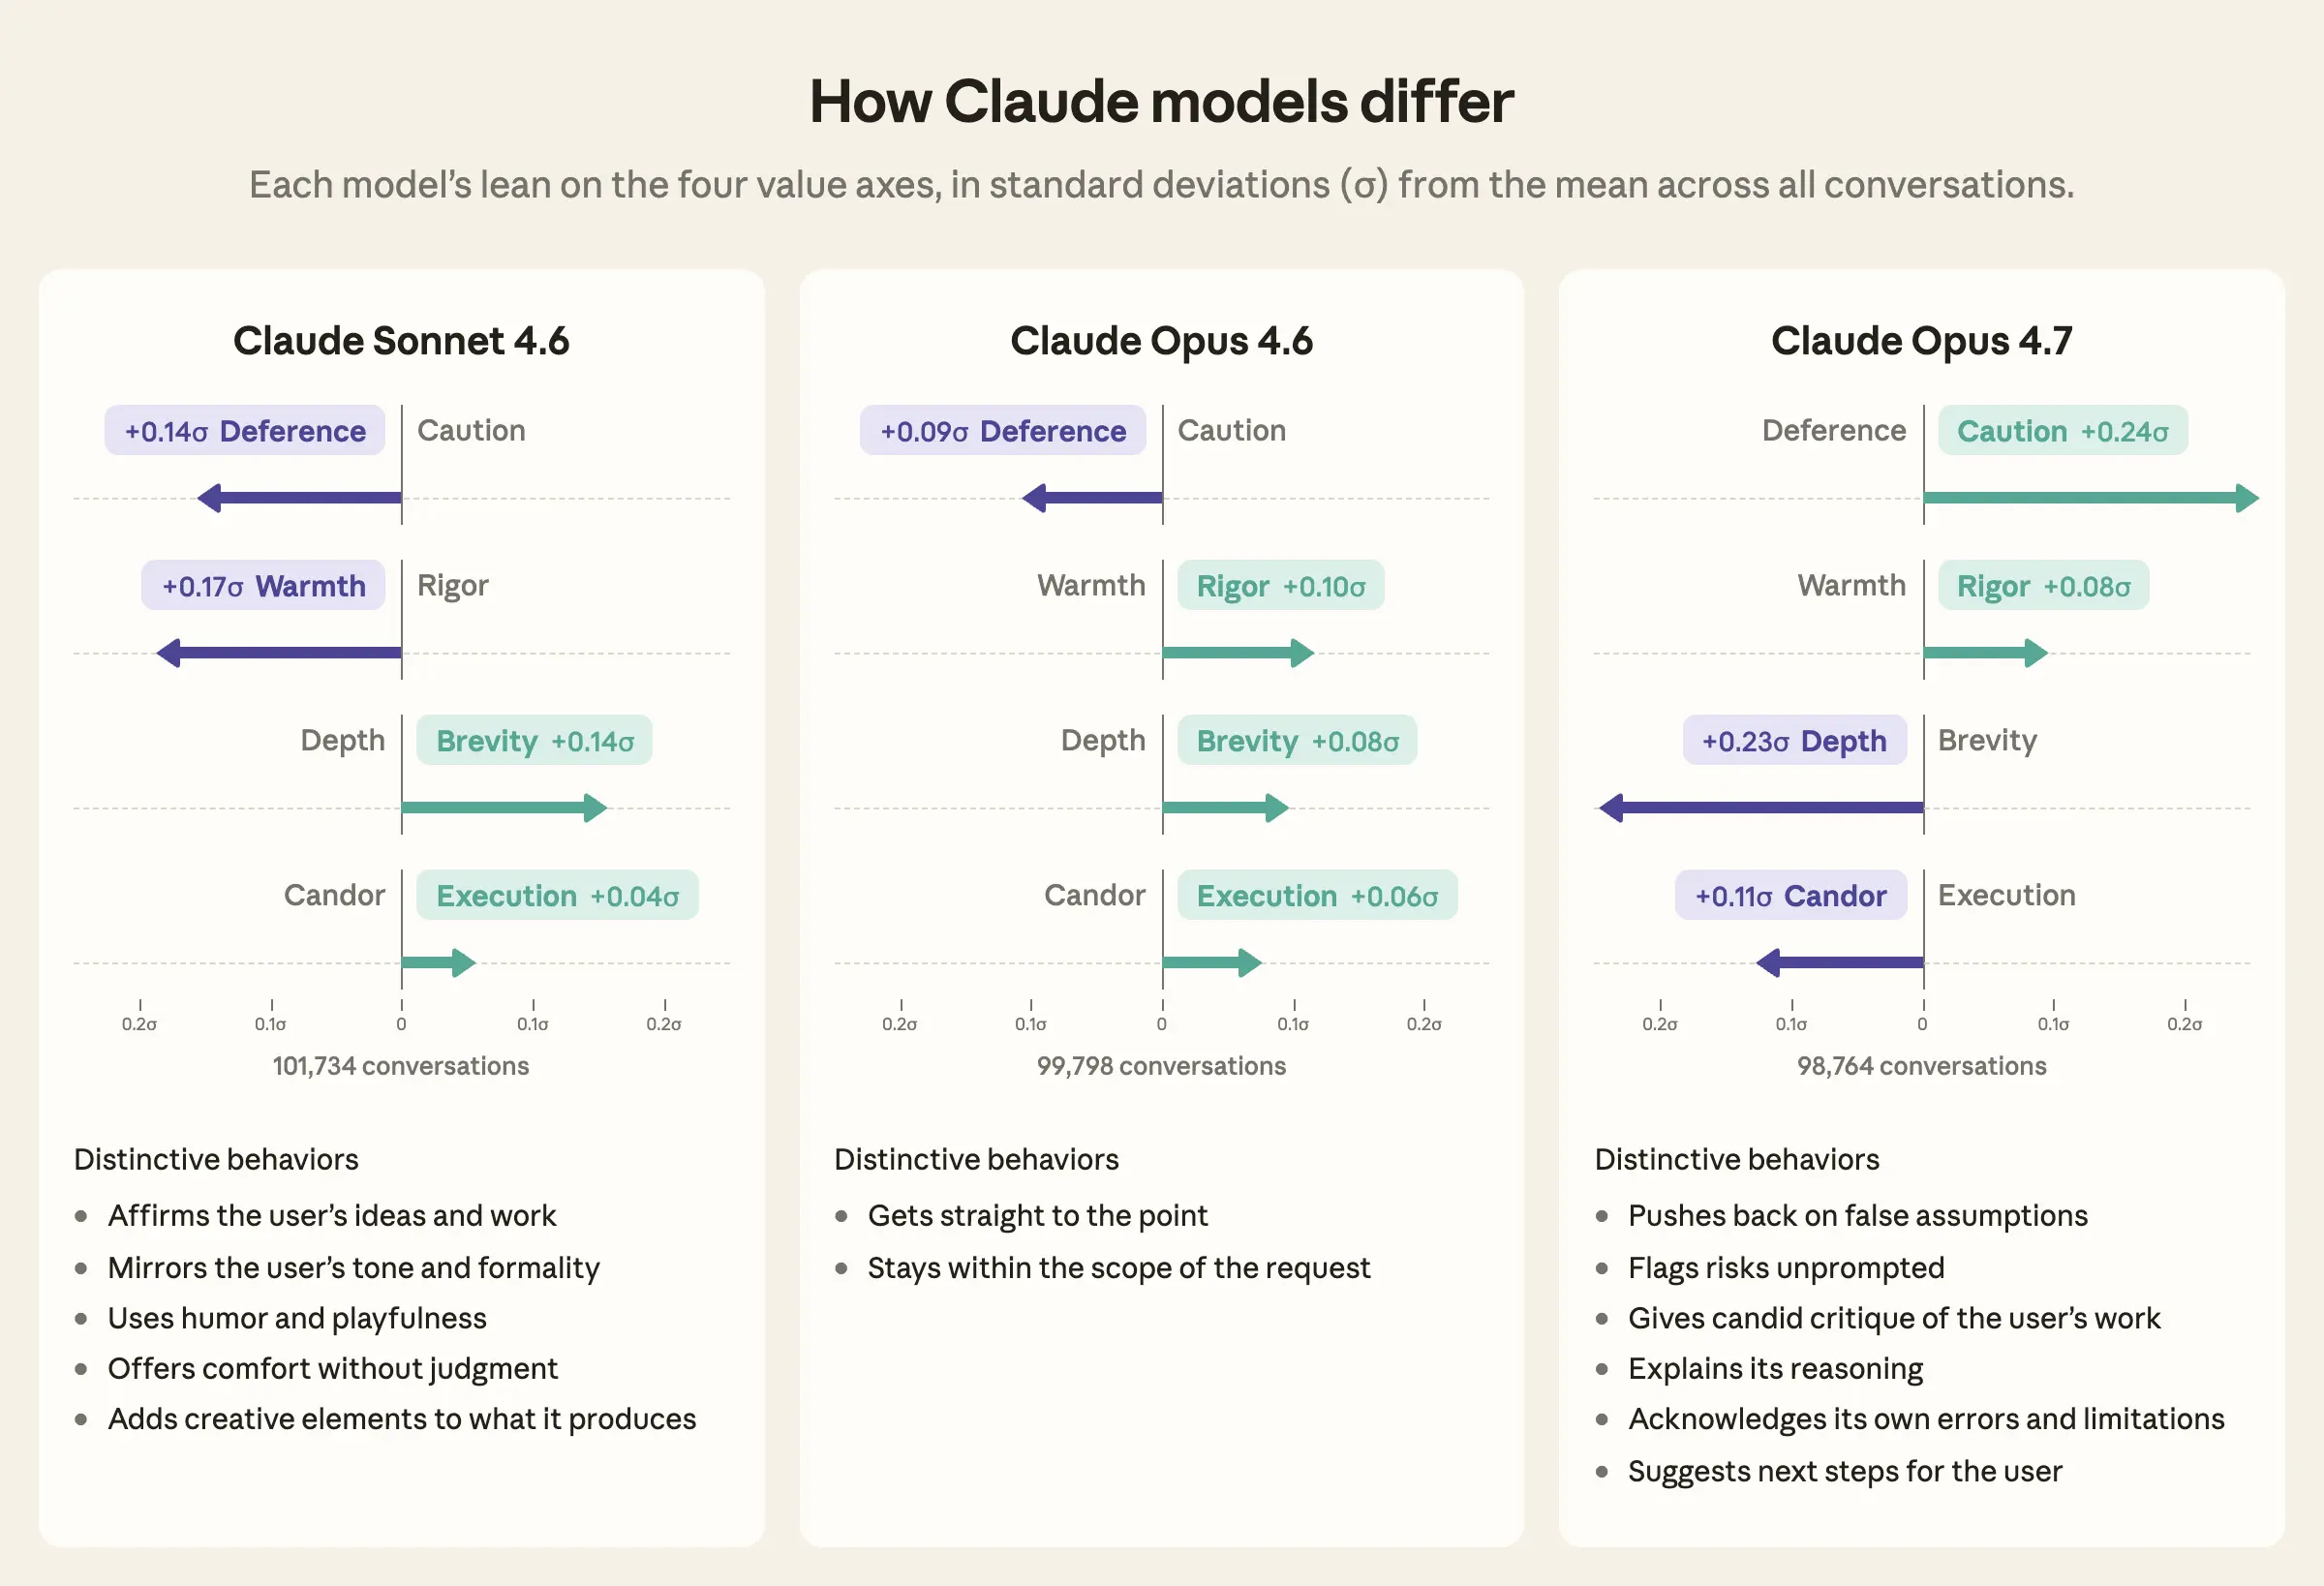
실제로 이 차이가 어떻게 나타나는지 살펴보기 위해 모델 간 차이가 가장 두드러지는 구체적인 가치관을 들여다봤습니다. Claude 기반 프라이버시 보호 도구는 대화 속 가치관에 레이블을 붙일 때마다 Claude가 해당 가치관을 어떻게 표현했는지 짧게 기술합니다. 우리는 비슷한 행동 패턴을 보이는 기술들을 묶어 그림 3에 요약했으며, 이를 통해 모델 간 차이를 더 구체적으로 확인할 수 있습니다.
- 복종 vs. 신중함. Sonnet 4.6은 신중함보다 복종을 가장 강하게 표현하며, 사용자의 아이디어와 작업을 자주 긍정적으로 인정합니다. Opus 4.7은 신중함을 가장 강하게 표현하며, 요청 없이도 위험 요소를 경고하는 경우가 많습니다.
- 따뜻함 vs. 엄밀함. Sonnet 4.6은 따뜻함을 가장 강하게 표현하며, 주로 유머와 유쾌함, 그리고 비판 없이 사용자를 위로하는 방식으로 드러납니다. Opus 4.7은 따뜻함보다 엄밀함을 가장 강하게 표현하며, 사용자의 가정에 의문을 제기하고 솔직하게 비판하는 경향이 있습니다.
- 깊이 vs. 간결함. Opus 4.7은 결론의 근거를 함께 제시하며 깊이 있는 설명을 지향하는 반면, Opus 4.6과 Sonnet 4.6은 간결함을 지향합니다. 특히 Opus 4.6은 핵심만 빠르게 전달하는 경향이 강합니다.
- 솔직함 vs. 실행. Opus 4.7은 자신의 한계를 솔직하게 인정하며 솔직함 쪽에 기울고, Opus 4.6은 사용자의 요청 범위 안에서 충실히 수행하는 실행 쪽에 더 기우는 경향이 있습니다.
이러한 발견은 Anthropic 내부와 외부 사용자들이 각 모델을 인식하는 방식과 일치합니다. Claude.ai 사용자들은 Opus 4.7이 다른 모델보다 답변에 단서를 더 많이 단다고 언급했습니다. Anthropic 직원들은 Opus 4.7이 투명성, 정직, 겸손을 상대적으로 더 많이 드러내고, Opus 4.6은 간결함이 두드러진다고 설명했습니다. 또한 Sonnet 4.6은 출시 블로그 포스트에서 따뜻하고 정직하며 친사회적인 모델로 소개된 바 있습니다. 우리의 축이 이러한 인식을 그대로 반영한다는 사실은, Claude가 표현하는 가치관을 레이블링하고 비교하는 이 방법이 모델의 실제 행동 방식을 포착하고 있음을 보여줍니다.
사용자들은 어떤 Claude 모델을 쓰느냐에 따라 서로 다른 가치관을 경험할 수 있습니다. 예를 들어 Opus 4.7은 사용자의 작업에 솔직한 비판을 제시하거나 요청 없이도 위험 요소를 경고하는 반면, Sonnet 4.6은 격려와 유머로 대화를 이끌어 가는 경향이 있습니다. 이런 모델 간 가치관 차이는 캐릭터 훈련 결정 등 여러 요인에 의해 형성될 가능성이 높으며, 가치관 축 방법은 이 차이를 명확히 드러냄으로써 궁극적으로 특정 훈련 결정과의 연결점을 찾는 데 도움이 될 것입니다.
언어에 따라 Claude의 가치관 표현이 달라질까?
대화 언어에 따라 Claude가 표현하는 가치관이 달라질 것으로 예상할 수 있는 이유는 여러 가지입니다. 우선 Claude의 훈련 데이터가 언어마다 다르며, 이것이 가치관 표현에 영향을 미칠 수 있습니다. 또한 시스템 카드에 공개된 모델 평가 결과를 보면, 이미 언어에 따라 Claude의 지식과 민감한 요청 처리 방식에 차이가 있음이 확인됩니다.7 언어별로 Claude의 가치관 표현이 얼마나 다른지 측정하는 것은, 그 차이가 합리적인 변동인지 아니면 훈련 과정에서 개선이 필요한 문제인지를 판단하는 첫걸음입니다.
앞 섹션과 같은 방법으로 Claude.ai 상위 20개 언어에서 Claude의 가치관 프로필이 어떻게 달라지는지 산출했습니다. 아래에는 Claude 플랫폼 상위 언어별 가치관 프로필을 나타냈으며, 가치관 차이가 가장 큰 언어부터 표시했습니다.
언어에 따른 Claude의 가치관 표현 변동은 따뜻함 vs. 엄밀함 축과 솔직함 vs. 실행 축에서 가장 크게 나타나고, 복종 vs. 신중함 축과 깊이 vs. 간결함 축에서는 비교적 안정적입니다.
- 복종 vs. 신중함. 아랍어에서 복종을 가장 강하게, 영어에서 신중함을 가장 강하게 표현합니다.
- 따뜻함 vs. 엄밀함. 힌디어와 아랍어에서 따뜻함을 가장 강하게 표현하며, 공손한 언어, 유머와 유쾌함, 상대방의 아이디어와 작업에 대한 긍정적 반응으로 나타납니다. 영어와 러시아어에서는 엄밀함을 가장 강하게 표현하며, 가정에 의문을 제기하고, 세부 사항을 바로잡고, 근거를 요구하는 방식으로 드러납니다.
- 깊이 vs. 간결함. 영어에서는 세부 사항을 다듬고 교정하며 깊이 있는 설명 쪽으로 기울고, 아랍어에서는 간결함 쪽으로 기웁니다.
- 솔직함 vs. 실행. 네덜란드어에서는 자신의 오류를 솔직히 인정하며 솔직함 쪽으로 기울고, 인도네시아어에서는 실행 쪽으로 기웁니다.
이러한 결과를 종합하면, 대화 언어에 따라 Claude가 표현하는 가치관이 의미 있는 수준으로 달라진다는 것을 알 수 있습니다. 같은 유형의 요청이라도 Claude는 어떤 언어에서는 따뜻함과 복종 쪽으로, 다른 언어에서는 엄밀함과 신중함 쪽으로 기웁니다. 이는 이제 막 탐구하기 시작한 중요한 함의를 담고 있습니다. 예를 들어 같은 사업 계획서에 대해 피드백을 요청하더라도, 힌디어로 요청한 사용자와 러시아어로 요청한 사용자는 Claude가 평가를 표현하는 방식에서 서로 다른 가치관을 경험하기 때문에 결과물의 품질에 대해 서로 다른 인상을 받을 수 있습니다.
이러한 차이를 만들어내는 훈련 데이터의 특성이 무엇인지는 아직 밝혀지지 않았습니다. 한 가지 가능성은 언어마다 훈련 데이터 양이 고르지 않다는 것입니다. 데이터가 풍부한 언어에서는 일관된 가치관을 표현하도록 훈련하는 효과가 더 크게 나타날 수 있습니다. 데이터의 구성도 언어마다 다릅니다. 특정 언어는 전문적인 글쓰기가 과대 대표될 수 있고, 이런 텍스트는 다른 가치관을 반영할 수 있습니다. 데이터의 양과 구성 모두에서의 이러한 불균형이 언어별로 다른 가치관 표현으로 이어질 수 있습니다.
또한 이 변동 중 어느 정도가 바람직한 것인지도 아직 확실하지 않습니다. 언어마다 대화 규범이 다르며, Claude가 이러한 규범에 맞춰 다른 가치관을 표현하는 것일 수 있습니다. 동시에, 어떤 언어에서는 Claude가 의도한 행동에 더 가깝게 작동하고 다른 언어에서는 그렇지 않을 수 있으며, 이는 특정 언어 사용자들이 받는 서비스 품질의 격차로 이어질 수 있습니다.
이 방법론을 통해 훈련 데이터의 어떤 특성이 이러한 차이를 만들어내는지, 그리고 그 변동이 바람직한 것인지를 구분하는 작업을 시작할 수 있게 되었습니다.
앞으로의 방향
Claude가 표현하는 가치관을 소수의 축으로 압축할 수 있으며, 그 위치가 모델과 언어에 따라 달라진다는 사실을 보여주었습니다. 이를 통해 모델 평가와 배포 후 모니터링 과정에서 이러한 변화를 추적할 수 있는 방법이 생겼습니다. 그러나 왜 이러한 변화가 일어나는지, 그리고 Claude와 대화하는 사람들에게 어떤 의미를 갖는지는 아직 파악하지 못했습니다. 아래에서는 가장 유망하다고 판단하는 향후 방향을 간략히 제시합니다.
이러한 가치관 차이는 어디서 비롯되는가?
Claude의 가치관이 모델과 언어에 따라 달라진다는 사실을 알았다고 해서 왜 그런지까지 알 수 있는 것은 아닙니다. 일부 변동은 언어별 사전 학습 및 미세 조정 데이터의 차이에서 비롯된 것일 수 있습니다. 네 가지 축은 훈련 데이터에서 어떤 가치관 차이를 더 면밀히 살펴봐야 할지를 알려줍니다. 이 차이들을 특정 데이터, 훈련 단계, 혹은 맥락 요인과 연결할 수 있다면, 더 세밀하게 Claude의 행동을 조정하고자 할 때 어디에 개입해야 할지 알 수 있을 것입니다.
이러한 차이가 사용자에게 어떤 의미인가?
Claude가 어떤 가치관을 다르게 표현하는지, 그리고 그에 따른 행동 양상은 측정했지만, 이것이 사용자에게 실제로 어떤 영향을 미치는지는 아직 파악하지 못했습니다. Anthropic Interviewer 같은 도구를 활용해 사용자의 웰빙, Claude에 대한 신뢰, Claude의 판단 품질 등을 물어보고 이를 Claude가 표현하는 가치관과 연결할 수 있을 것입니다. 이를 통해 가치관 차이와 사용자 경험을 직접 연결하고, 사용자에게 실질적인 영향을 미치는 가치관 차이부터 개선 우선순위를 정할 수 있을 것입니다.
Claude의 가치관은 언어에 따라 어떻게 달라져야 하는가?
Claude의 헌법은 따뜻함, 신중함, 정직 같은 핵심 가치관을 제시하지만, 이것이 언어에 따라 어떻게 달라져야 하는지는 명시하지 않습니다. 분석 결과, 언어에 따라 이미 사용자들이 Claude를 다르게 경험하고 있음이 확인되었지만, 각 언어 사용자들이 어떤 변동을 원하는지는 아직 모릅니다. Claude의 가치관이 언어에 따라 어떻게 달라져야 하는지를 결정하려면, 해당 언어를 사용하는 사람들의 관점을 이해하고 그 무게를 고려해야 합니다.
Claude의 가치관 표현에 영향을 미치는 다른 요인은 무엇인가?
언어와 모델만이 Claude의 가치관 표현을 결정하는 요인은 아닐 것입니다. 연령, 직업, 지역 같은 인구통계학적 신호도 가치관 표현에 영향을 줄 수 있습니다. 이는 사용자가 명시적으로 드러낸 정보를 통해서이거나, 질문하는 사람과 상관관계가 있는 주제, 어조, 문체의 미묘한 차이를 통해서일 수 있습니다. 이러한 신호 중 어떤 것이 중요한지, 그리고 그로 인한 변동이 사용자에게 실제로 도움이 되는지를 파악하는 것이 이 방법론이 가능하게 하는 다음 단계입니다.
Claude가 표현하는 가치관을 안정적으로 조정할 수 있는가?
모델의 가치관 프로필을 측정할 수 있게 된 이상, 자연스럽게 떠오르는 질문이 있습니다. Claude가 표현하는 가치관을 얼마나 안정적으로 조정할 수 있을까요? 캐릭터 훈련 조정이나 시스템 프롬프트 변경을 통해 가치관을 유도한 뒤, 가치관 축 방법으로 모델의 가치관이 예상대로 바뀌었는지 검증하는 방식으로 시험해볼 수 있을 것입니다.
가치관 프로파일링을 모델 평가 및 모니터링의 일부로 삼을 수 있는가?
가치관 축 방법은 개방형 대화에서 모델의 행동 경향을 간단하게 요약할 수 있게 해주며, 이를 평가 프로세스에 통합할 수 있습니다. 모델 출시 전과 배포 후에 가치관 프로파일링을 실행하면 Claude가 표현하는 가치관에서 예상치 못한 변화를 포착할 수 있습니다. 또한 가치관 프로필과 Claude의 헌법 미준수 같은 문제 행동 사이의 상관관계를 파악하고, 이를 바탕으로 Claude의 행동을 개선하는 데 활용할 수도 있습니다.
Claude는 매일 수십 개 언어로 수백만 건의 대화에서 가치관을 드러냅니다. 지금까지는 훈련 과정에서 가치관을 형성할 수 있었지만, 실제 배포 환경에서 그것을 안정적으로 관찰하기가 어려웠습니다. 이제 측정 방법을 갖추게 됨으로써, Claude가 표현하는 가치관이 우리가 의도하지 않은 방식으로 달라지고 있다는 사실을 확인할 수 있게 되었고, 그 이유와 그 변동이 사용자에게 실제로 도움이 되는지를 연구할 수 있게 되었습니다. 이러한 변동을 이해하고 그에 대해 어떻게 할지 결정하는 작업은 앞으로도 계속해 나갈 것입니다.
저자
Matt Kearney, Miranda Zhang, Shan Carter, Judy Hanwen Shen, Kunal Handa, Jerry Hong, Saffron Huang, Miles McCain, Thomas Millar, Michael Stern, Mo Julapalli, Suzanne Wang, Devin Kuokka, Andrea Vallone, Shaoyi Zhang, Jim Baker, Kevin Troy, Matt Botvinick, Hanah Ho, Monika Tuchowska, Sarah Pollack, Jake Eaton, Deep Ganguli, Esin Durmus
감사의 말
이 연구의 여러 단계에서 피드백을 제공해 주신 분들께 감사드립니다: Amanda Askell, Joe Carlsmith, Jack Clark, Ishita Dasgupta, Andrew Lampinen, Shayne Longpre, David Saunders, Taylor Sorensen, Heather Whitney.
Bibtex
@online{anthropic2026values,
  author = {Matt Kearney and Miranda Zhang and Shan Carter and Judy Hanwen Shen and Kunal Handa and Jerry Hong and Saffron Huang and Miles McCain and Thomas Millar and Michael Stern and Mo Julapalli and Suzanne Wang and Devin Kuokka and Andrea Vallone and Shaoyi Zhang and Jim Baker and Kevin Troy and Matt Botvinick and Hanah Ho and Monika Tuchowska and Sarah Pollack and Jake Eaton and Deep Ganguli and Esin Durmus},
  title = {Claude's Values Across Models and Languages},
  date = {2026-07-13},
  year = {2026},
  url = {https://anthropic.com/research/claude-values-models-languages},
}
부록
여기에서 확인하실 수 있습니다.