Addy Osmani블로그
새로운 소프트웨어 개발 생명주기
에이전트 기반 SDLC(소프트웨어 개발 생명주기)를 주제로 Google 백서를 공동 집필했다. 기본 원칙을 넘어, 실제로 중요한 핵심 메커니즘들을 짚어본다: 에이전트의 대부분이 하네스(harness)로 구성되는 이유, 토큰 비용을 좌우하는 정적/동적 컨텍스트 분리 전략, 진정한 차별화 요소로서의 검증, SDLC 각 단계에서의 변화 양상, 그리고 프로토타입이 프로덕션 에이전트로 전환되는 시점까지. 논문에 수록된 6개의 그림도 함께 소개한다.
이번 주 Google이 발표한 백서 The New SDLC With Vibe Coding을 Shubham Saboo, Sokratis Kartakis와 함께 공동 집필했다. 짧은 시리즈의 첫 번째 편이다.
첫 번째 편인 만큼 기본 개념은 빠질 수 없다. 에이전트란 무엇인지, 바이브 코딩(vibe coding)이 무엇을 의미하는지, 왜 코드를 작성하는 일에서 코드를 판단하는 일로 무게중심이 이동하는지를 다룬다. 이 블로그의 독자라면 이미 알고 있을 내용이니 건너뛰고, 실제로 행동에 옮길 수 있을 만큼 구체적인 메커니즘들을 바로 살펴보겠다. 발표 자료에 활용하기 좋은 그림 여섯 장도 함께 소개한다.
에이전트 = 모델 + 하네스
이 논문에서 가장 유용한 개념적 틀은 바로 이것이다: 에이전트는 모델과 하네스의 결합이다. 모델은 하나의 입력에 불과하다. 에이전트가 실제로 작업을 완수하도록 만드는 모든 것이 하네스다. 지침과 규칙 파일, 도구와 MCP 서버, 실행 샌드박스, 하위 에이전트를 생성하고 모델 간 라우팅을 처리하는 오케스트레이션 로직, 생명주기 시점마다 결정론적 코드를 실행하는 훅(hook), 그리고 에이전트가 목표에서 이탈하는지 감지하는 옵저버빌리티(observability)까지 모두 하네스에 해당한다.
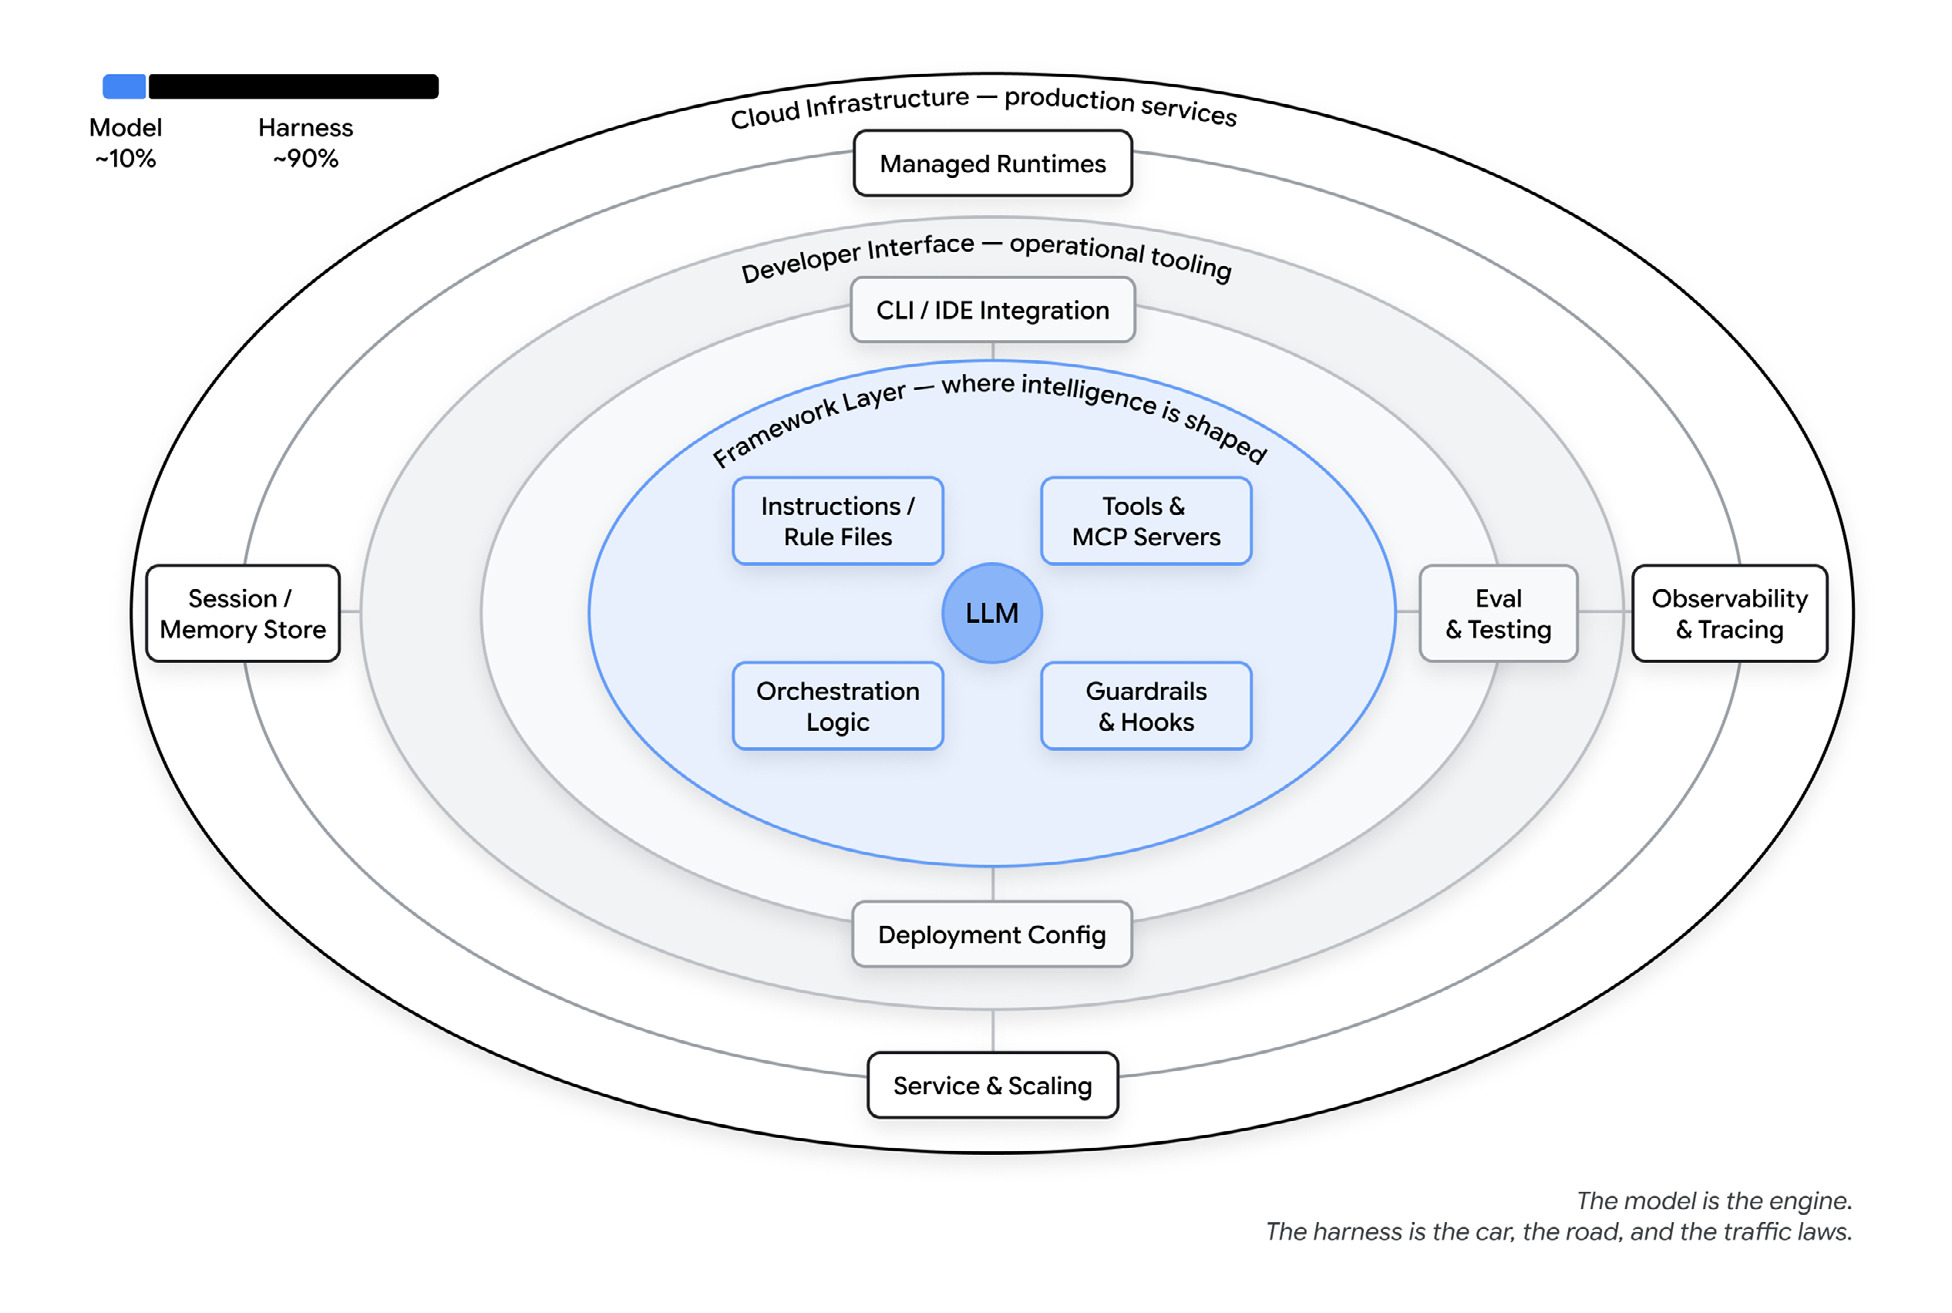 모델은 엔진이다. 하네스는 자동차이자 도로이자 교통법규다.
하네스의 영향력을 수치로 보여주는 공개 사례가 두 가지 있다. Terminal Bench 2.0에서 한 팀은 동일한 모델을 유지한 채 하네스만 바꿔 코딩 에이전트 순위를 30위권 밖에서 5위권 안으로 끌어올렸다. LangChain 역시 같은 벤치마크에서 고정된 모델 주변의 시스템 프롬프트, 도구, 미들웨어만 교체해 13.7점을 추가로 획득했다.
따라서 에이전트가 실패할 때는 하네스를 먼저 점검해야 한다. 주범은 대개 누락된 도구, 지나치게 느슨하게 작성된 규칙, 미처 추가하지 않은 가드레일, 혹은 노이즈로 가득 찬 컨텍스트 윈도우다. 대부분의 에이전트 실패는 설정 실패다. 이는 오히려 낙관적인 해석이기도 한데, 설정은 새 모델을 기다리지 않고도 오늘 당장 고칠 수 있는 부분이기 때문이다. 하네스 아래에서 모델은 계속 교체될 것이다. 복리로 가치를 쌓는 팀은 하네스를 한 번 구축하고 여러 프로젝트에 걸쳐 다듬는다. 자세한 내용은 하네스 엔지니어링과 팩토리 모델에서 다룬 바 있다.
컨텍스트 엔지니어링의 구조, 그리고 비용을 결정하는 방식
하네스가 시스템 전체라면, 컨텍스트 엔지니어링은 그 안에서 가장 레버리지가 큰 조절 장치다. 논문은 에이전트 컨텍스트를 여섯 가지 유형으로 분류한다: 지침(역할, 목표, 경계), 지식(문서, 다이어그램, 도메인 데이터), 메모리(세션 로그와 영구 상태), 예시(퓨샷 데모와 참조 패턴), 도구(호출 가능한 API와 서비스), 가드레일(하드 제약과 안전 규칙).
실제로 토큰 비용을 움직이는 결정은 무엇을 정적 컨텍스트에 넣고 무엇을 동적 컨텍스트에 넣느냐다.
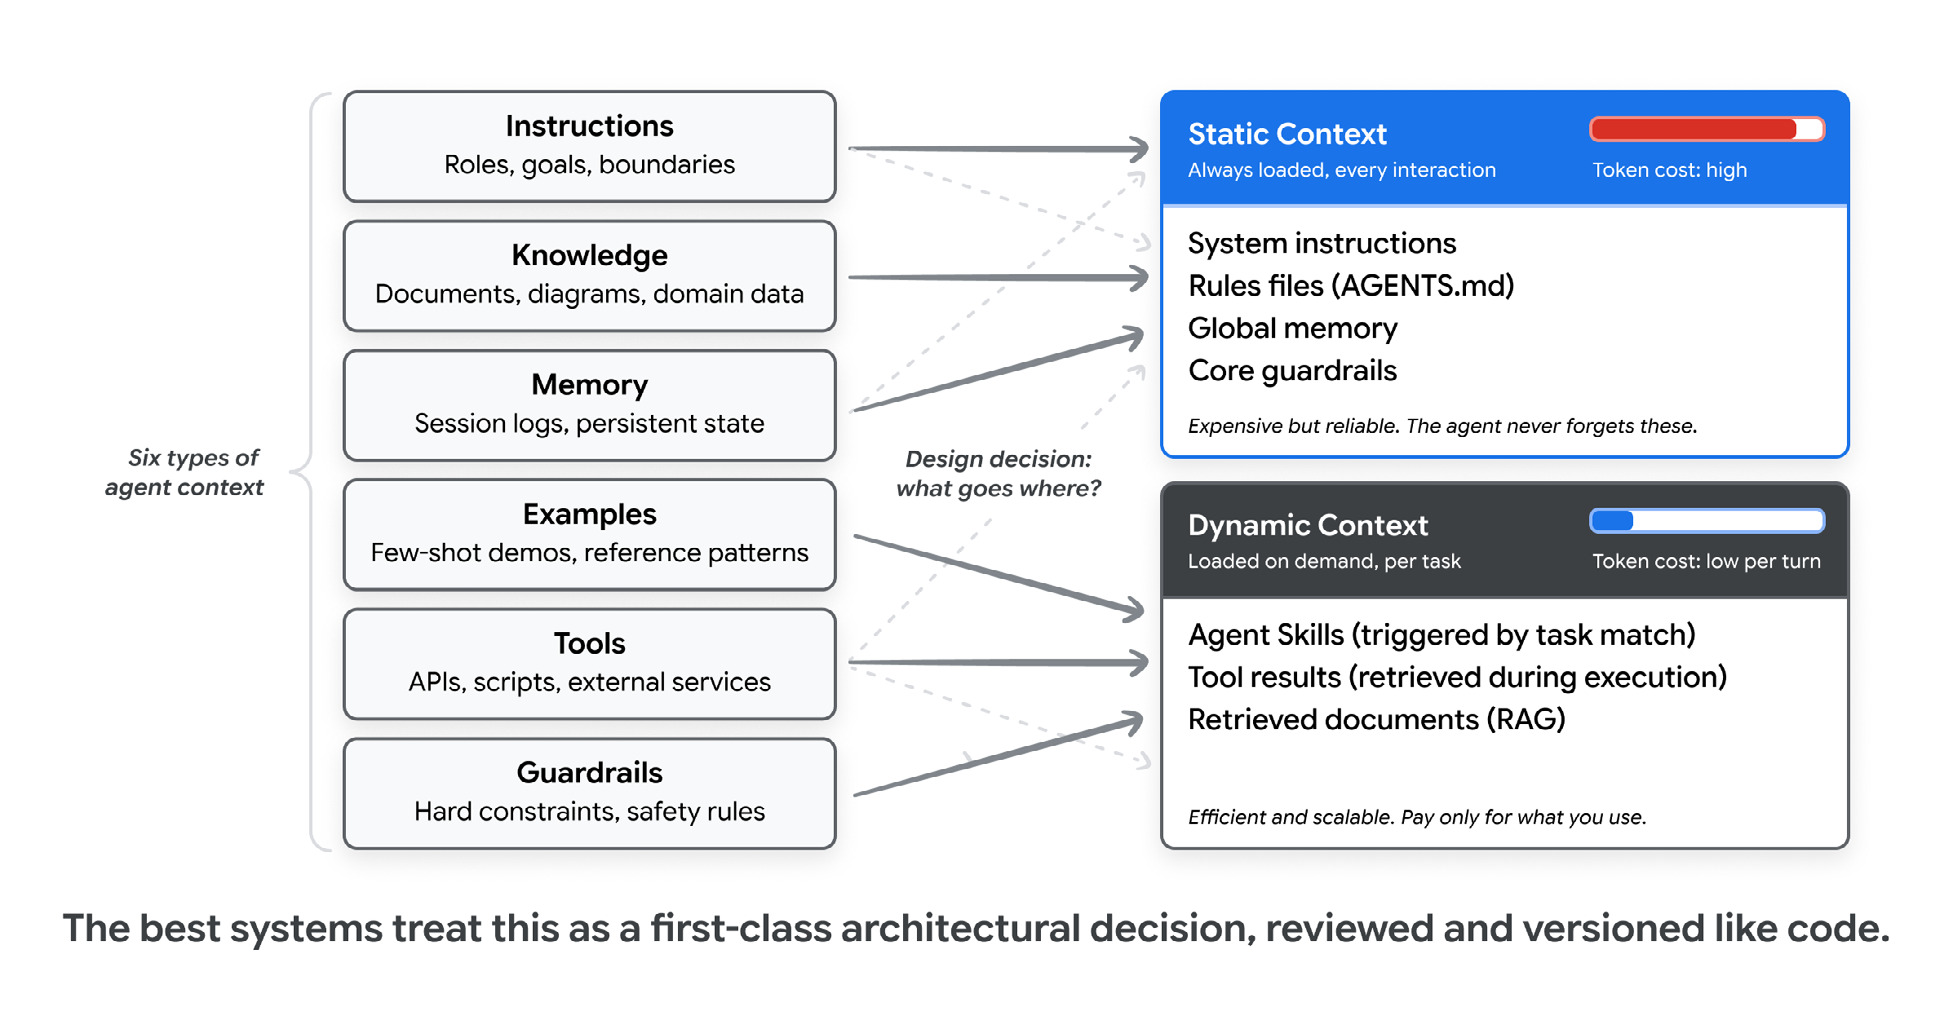 정적 컨텍스트는 매 턴마다 존재하기 때문에 안정적이지만 비용이 크다. 동적 컨텍스트는 해당 작업에 필요한 것만큼만 비용을 지불하므로 저렴하다.
정적 컨텍스트는 항상 로드된다. 시스템 지침, 규칙 파일(AGENTS.md, CLAUDE.md, GEMINI.md), 글로벌 메모리, 핵심 가드레일이 여기에 해당한다. 동적 컨텍스트는 필요할 때만 로드된다. 작업 매칭 시 트리거되는 스킬, 실행 중간에 가져오는 도구 결과, RAG에서 끌어온 문서가 그 예다. 정적 컨텍스트가 너무 많으면 토큰이 낭비되고 신호가 희석되며, 너무 적으면 에이전트가 안전을 지켜주는 규칙을 잊는다. 도입할 만한 패턴은 이 경계를 1급 아키텍처 결정으로 취급하는 것이다. 풀 리퀘스트에서 검토하고 설정 파일처럼 버전 관리해야 한다.
동적 컨텍스트를 확장 가능하게 만드는 핵심 메커니즘은 점진적 공개 방식의 에이전트 스킬(Agent Skills)이다. 에이전트는 시작 시 가벼운 메타데이터만 확인하고, 작업이 매칭될 때 전체 지침을 로드하며, 명시적으로 필요한 경우에만 심층 참조 자료를 가져온다. 이 덕분에 하나의 에이전트가 수십 개의 전문화된 기능을 보유하면서도 지금 사용 중인 기능 하나에 해당하는 토큰 비용만 지불할 수 있다. 자세한 내용은 에이전트 스킬에서 다뤘다.
검증: 바이브 코딩과 엔지니어링을 가르는 기준선
같은 에이전트를 사용하더라도 바이브 코딩부터 에이전트 엔지니어링까지 스펙트럼 어디에든 위치할 수 있다. 그 위치를 결정하는 것은 결과물을 어떻게 검증하느냐다.
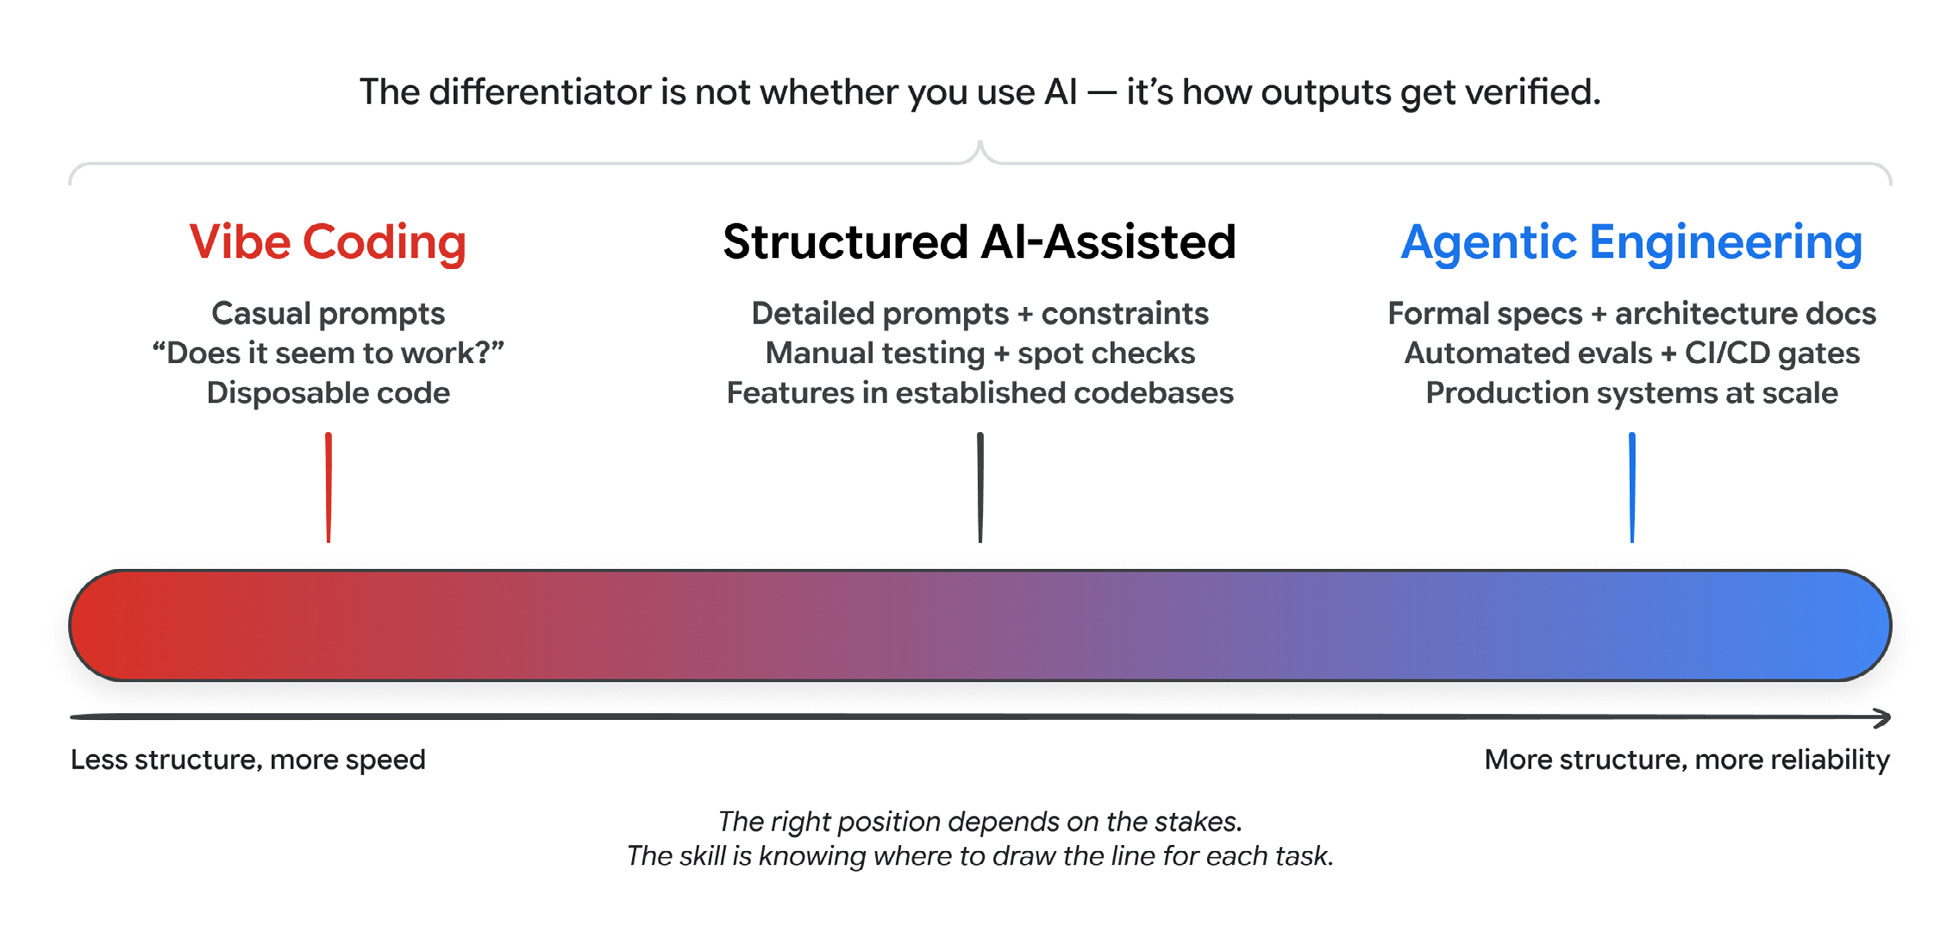 적절한 위치는 작업의 중요도에 달려 있다. 핵심 역량은 각 작업마다 어디에 선을 그어야 할지 아는 것이다.
검증은 두 가지 메커니즘으로 이루어진다. 테스트는 결정론적인 부분을 검증한다. 즉, 이 입력이 주어지면 함수가 저 출력을 반환하는지 확인한다. 평가(eval)는 결정론적이지 않은 부분을 검증하는데, 논문은 이를 두 가지로 유용하게 구분한다. 출력 평가는 최종 산출물이 올바른지를 묻고, 궤적 평가(trajectory evaluation)는 도구 호출 순서와 중간 추론 과정이 타당했는지를 묻는다. 둘 다 중요하다. 눈에 띄는 오류가 있는 결과물보다, 검증 단계를 건너뛴 채 매끄럽게 생성된 결과물이 더 위험한 실패이기 때문이다.
리더에게 그대로 전달하고 싶은 한 가지 권고: 기준은 데모가 아닌 평가에 두어야 한다. 데모는 에이전트가 한 번 성공할 수 있음을 증명할 뿐이다. 실질적인 루브릭을 갖춘 평가 스위트를 통과한다는 것은 안정적으로 성공함을 증명한다. 이는 검증이 병목이다와 에이전트 코드 리뷰에서 계속해서 주장해온 것과 같은 맥락이다.
SDLC 각 단계는 실제로 어떻게 달라지는가
AI는 생명주기를 불균등하게 압축한다. 그리고 그 불균등함 자체가 핵심이다. 몇 주가 걸리던 구현은 몇 시간으로 줄어든다. 반면 요구사항 정의, 아키텍처 설계, 검증은 판단력이 필요한 작업이기 때문에 인간의 속도를 유지한다. 결국 명세의 품질이 병목이 되고, 검증이 중심으로 이동한다.
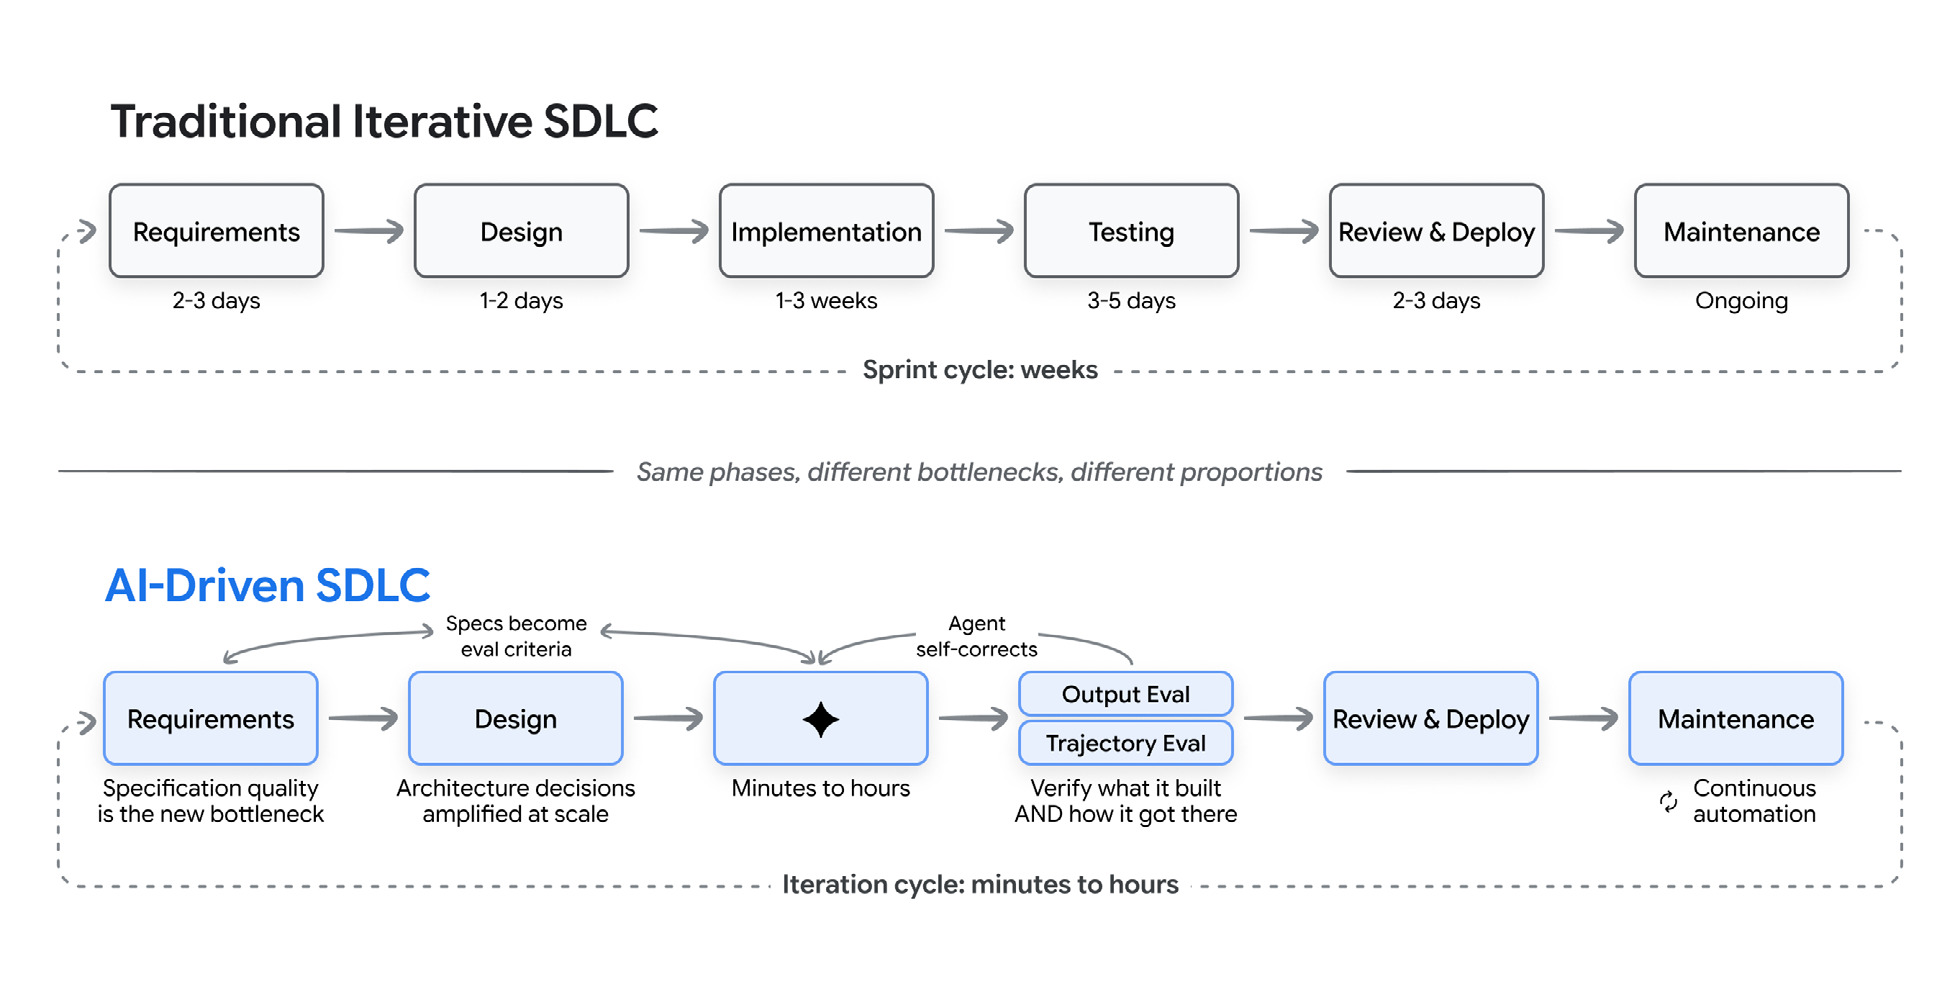 단계는 같지만, 병목도 달라지고 비중도 달라진다.
각 단계를 구체적으로 살펴보면:
- 요구사항 정의는 팀 간에 전달되는 문서 작업에서 명세와 초기 프로토타입을 동시에 만들어내는 대화로 변한다. 에이전트는 간단한 설명에서 사용자 스토리를 작성하고 엣지 케이스를 발굴하며, 설명을 몇 분 만에 동작하는 프로토타입으로 바꾼다.
- 아키텍처는 가장 인간 중심적인 단계다. 일관성과 가용성 간의 트레이드오프처럼 모델이 완전히 파악하기 어려운 비즈니스 맥락에 의존하는 결정들이 많기 때문이다. 개발자의 역할은 에이전트가 구현할 구조적 결정을 내리고 문서화하는 것으로 바뀐다.
- 구현은 성과와 주의사항이 공존하는 단계다. 설문조사에서는 25~39%의 생산성 향상이 보고된 반면, METR 연구에서는 검증과 수정 시간을 포함하면 숙련 개발자가 일부 작업에서 오히려 19% 더 오래 걸리는 것으로 나타났다. 솔직한 해석은 이렇다: AI는 구현을 '작성하는 일'에서 '검토하는 일'로 바꾼다.
- 테스트 및 QA는 역할이 뒤집힌다. 테스트와 평가는 에이전트에게 의도를 전달하는 주된 수단이 되며, 지속적인 품질 플라이휠로 연결된다. 벤치마크 대비 평가 → 실패 사례 클러스터링 → 원인이 된 프롬프트나 도구 수정 → 회귀 스위트 검증 → 프로덕션에서 새로운 실패 모드 모니터링의 흐름이다.
- 유지보수는 가장 과소평가된 단계다. 원작자만 이해할 수 있어 "건드리기엔 너무 위험한" 코드를 이제는 에이전트가 읽고 리팩터링하고 현대화할 수 있다. 번거롭고 위험하다는 이유로 미뤄두었던 프레임워크 마이그레이션과 더 이상 사용하지 않는 코드 정리도 이제는 실행된다.
이 모든 것의 상한선은 여전히 80% 문제다. 에이전트는 기능의 처음 80%를 빠르게 생성하지만, 나머지 20%, 즉 엣지 케이스와 통합 접합부는 현재 모델들이 종종 갖추지 못한 깊은 맥락 이해를 요구한다.
경제학: 컨텍스트와 라우팅은 재무 레버다
리더에게 중요한 지표는 속도가 아니라 총소유비용(TCO)이다. AI 시대는 TCO를 이전의 직관과 반대되는 방식으로 나눈다.
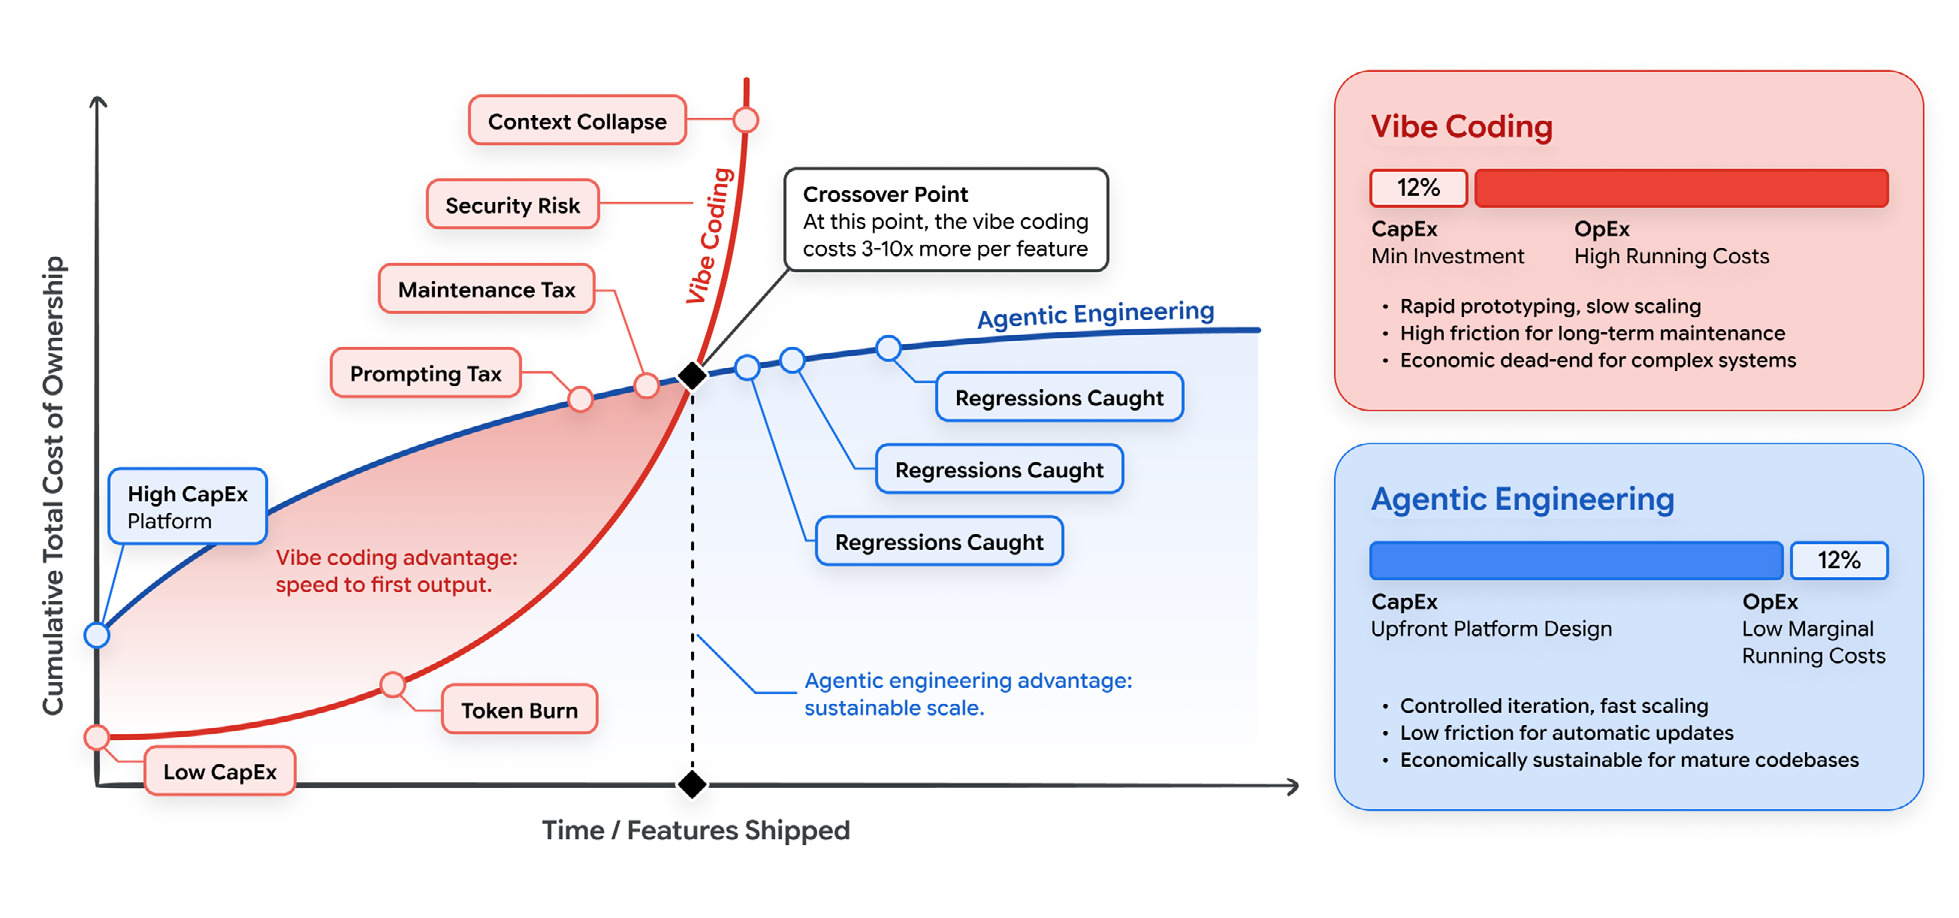 교차점을 넘어서면 바이브 코딩은 기능당 비용이 3~10배 더 든다. 코드가 얼마나 오래 유지되느냐가 그 교차점에 도달하는지를 결정한다.
바이브 코딩은 초기 비용(CapEx)이 낮은 대신 운영 비용(OpEx)이 높다. 진입 장벽은 구독료 하나와 몇 개의 프롬프트뿐이지만, 숨겨진 비용은 운영 단계에 있다. 비구조화된 파일을 컨텍스트에 쏟아붓고 모델에게 자신의 실수를 수정하도록 요청하는 과정에서 발생하는 토큰 소모, 나중에 그 즉흥적인 코드를 역공학해야 할 때 발생하는 유지보수 비용, 그리고 빠른 생성이 기능만큼이나 취약점을 양산할 때의 보안 수정 비용이 누적된다. 에이전트 엔지니어링은 이 곡선을 뒤집는다. 초기에 더 높은 비용(스키마, 테스트 스위트, 구조화된 컨텍스트)을 투자하는 대신, 이후 기능당 한계 비용은 낮아진다.
이 차트를 직접 만들었기 때문에 솔직히 말하겠다. 바이브 코딩의 기능당 비용이 3~10배 더 든다는 교차 승수는 측정된 상수가 아니라 예시적인 수치다. 주장하는 것은 수치가 아니라 곡선의 형태다.
개발자에게 전달하고 싶은 핵심은 컨텍스트 엔지니어링과 지능적인 모델 라우팅이 단순한 기술적 선택이 아니라 재무 레버라는 점이다. 10만 토큰짜리 저장소를 매 프롬프트마다 통째로 넣는 방식은 규모에서 지속 가능하지 않다. 잘 설계된 팩토리는 어려운 추론 작업(요구사항, 아키텍처, 초기 구현)을 대형 모델로 라우팅하고, 결정론적이고 복잡도가 낮은 작업(테스트 생성, 코드 리뷰, CI 모니터링)은 더 작고 저렴하고 빠른 모델로 라우팅한다. 출력 품질은 유지하면서 토큰 비용을 낮추는 것이다. 이것이 내가 오케스트레이션 세금과 혁신 예산에서 다뤄온 경제적 엔진의 실체다.
앞으로의 방향: 프로토타입이 프로덕션 에이전트가 된다
이 논문에서 가장 미래 지향적인 아이디어이자, 가장 주의 깊게 지켜봐야 할 변화다. 일회용 스크립트를 만들던 터미널 워크플로우가 이제 같은 자리에서 프로덕션 에이전트를 만들어낸다. 종종 이미 사용하고 있던 코딩 에이전트와의 대화만으로.
실제 에이전트를 구축하고 평가하고 배포하는 것(영구 메모리, 범위가 지정된 권한, 평가 커버리지, 옵저버빌리티)은 과거에는 별도의 스택과 별도의 워크플로우를 의미했다. 이제 그 모든 것이 이미 운영 중인 루프 안으로 통합된다. Google의 Agents CLI는 이를 중심으로 설계됐다. 한 번만 설치하면 선호하는 코딩 에이전트가 전체 생명주기를 아우르는 스킬을 갖추게 되고, 자연어로 구동할 수 있다.
# one-time setup
uvx google-agents-cli setup

# then, in your coding agent:
> Build a support agent that answers questions from our docs.
> Evaluate it on the FAQ dataset.
> Deploy it to Agent Engine.
그 단 하나의 명령 뒤에서, 에이전트는 프로젝트를 스캐폴딩하고 코드를 작성하며 평가 세트를 생성하고 실행한 뒤 관리형 런타임에 배포하고 결과를 보고한다. 어제 노트북에서 돌아가던 프로토타입이 오늘 사용자에게 서비스하는 프로덕션 에이전트가 된다. 재작성 없이. 에이전트 간 협력은 공개 표준 위에서 이루어진다. 도구 접근에는 MCP, 에이전트 간 위임에는 A2A가 쓰인다. 논문은 Anthropic의 실험 사례를 인용하는데, 에이전트 팀이 2주에 걸쳐 Rust로 동작하는 C 컴파일러를 만들었으며, 인간은 구현이 아닌 방향 설정과 검토를 담당했다.
일상적으로는 논문이 명명한 두 가지 모드 사이를 오간다. 컨덕터(conductor)는 실시간, IDE 내, 키스트로크 수준의 제어 방식으로 탐색이나 낯선 코드를 다룰 때 적합하다. 오케스트레이터(orchestrator)는 비동기, 멀티 에이전트 위임, 목표 수준의 제어 방식으로 마이그레이션이나 테스트 생성처럼 잘 정의된 작업에 적합하다. 이제 툴링은 두 가지를 동시에 지원한다. 에디터의 인라인 완성, 터미널 에이전트에 전달하는 목표, 단락 하나를 받아 몇 시간 뒤 풀 리퀘스트로 돌아오는 백그라운드 에이전트가 공존한다. 컨덕터에서 오케스트레이터로의 전환은 툴링의 변화이기 이전에 역량의 변화다.
나머지 사람들을 위한 슬라이드
마지막 그림은 이 글을 읽는 당신을 위한 것이 아니다. 당신이 함께 이끌어가야 할 사람들을 위한 것이다. 여전히 이것을 고급 자동완성 정도로 여기는 경영진, 아직 이 흐름에 올라타지 못한 동료들 말이다.
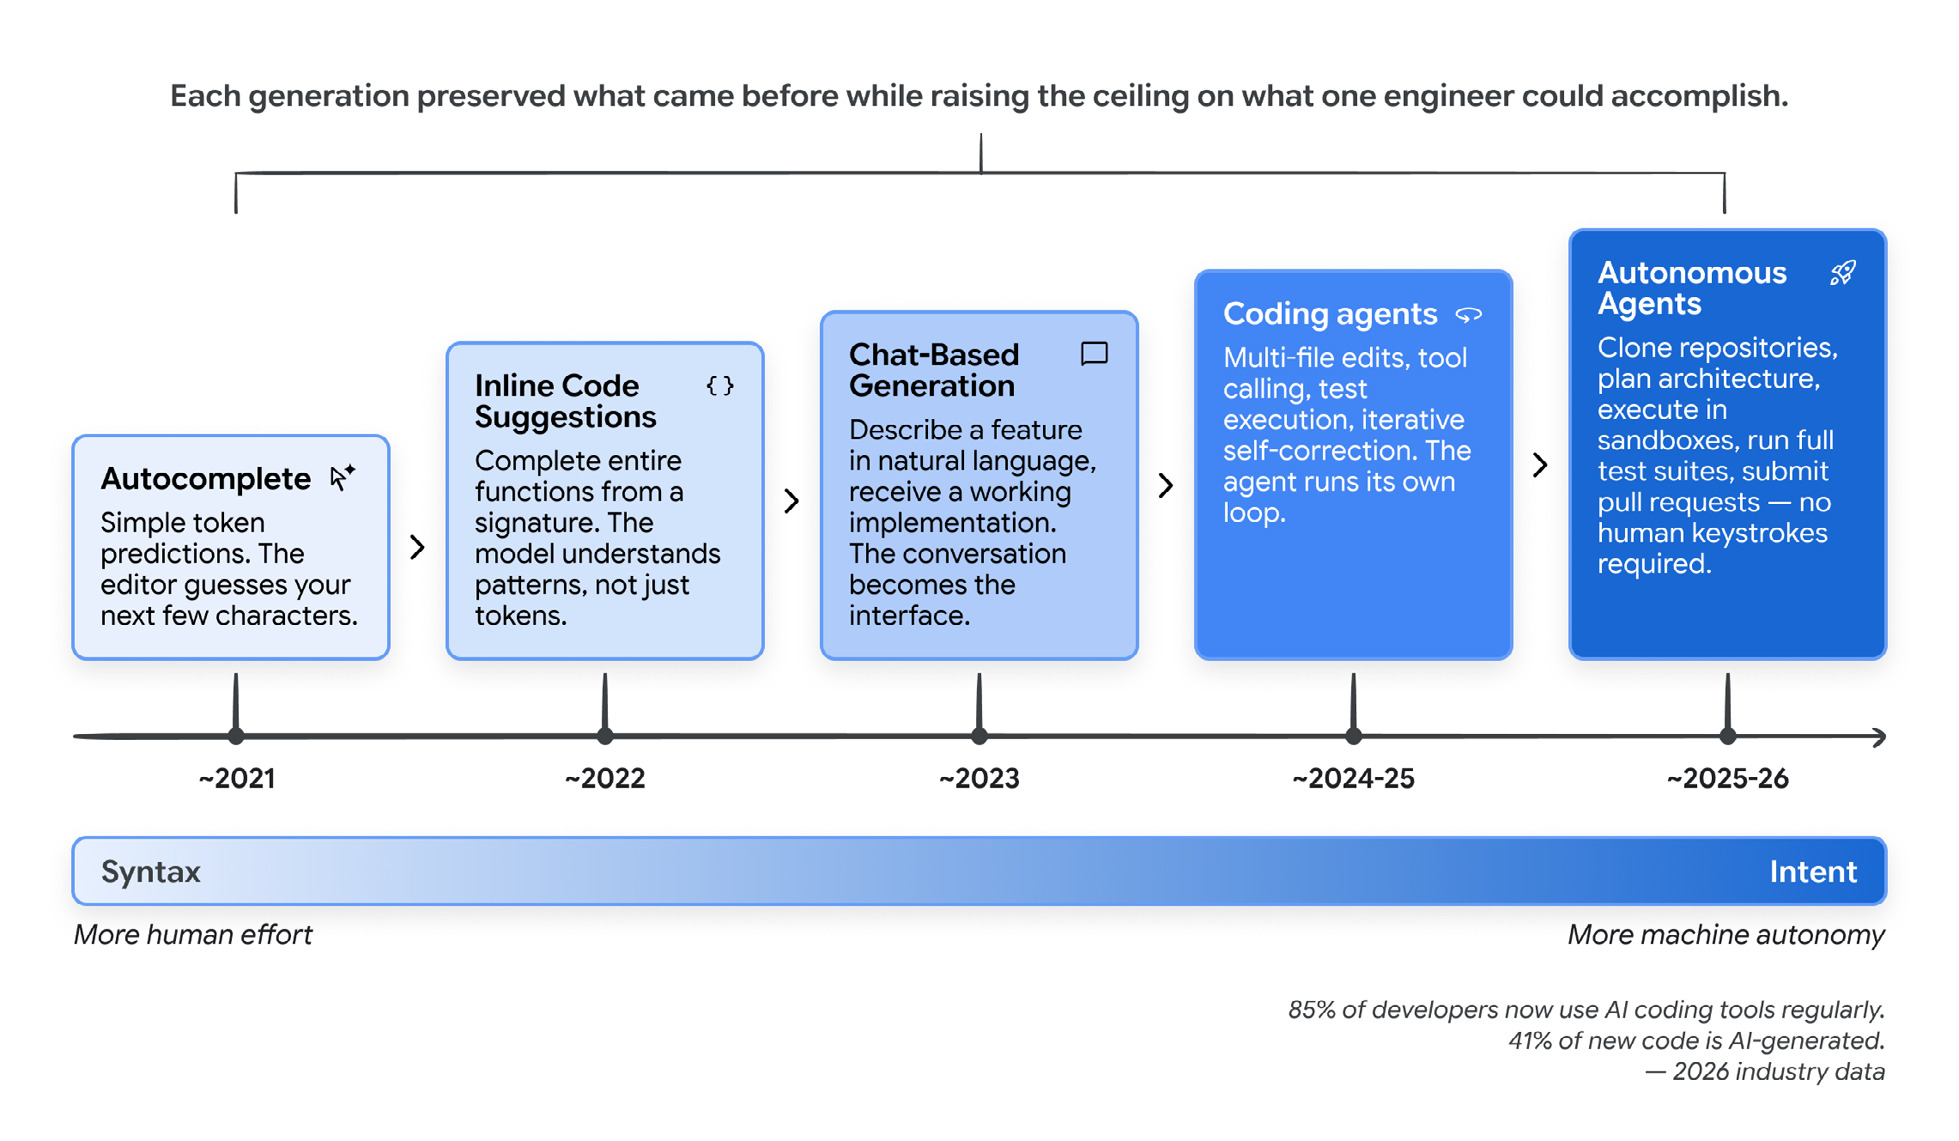 각 세대는 이전의 것을 보존하면서도 개발자 한 명이 해낼 수 있는 일의 천장을 높여왔다.
"이게 진짜인가요?"라는 질문을 끝내는 데 효과적인 도입 현황 수치도 담겨 있다. 2026년 초 기준, 전문 개발자의 85%가 AI 코딩 에이전트를 정기적으로 사용하고 있으며, 51%는 매일 사용한다. 새로 작성되는 코드의 약 41%는 AI가 생성한다.
이번 주 시작할 수 있는 것들
논문은 개인, 리더, 조직을 위한 권고사항으로 마무리된다. 그 중 가장 먼저 실행할 만한 구체적인 것들을 꼽으면:
- 저장소에
AGENTS.md를 추가하라. 열 줄이면 시작하기에 충분하다. 스택, 컨벤션, 하드 규칙, 워크플로우. 에이전트가 해서는 안 될 행동을 할 때마다 규칙 하나를 추가하라. - 코드보다 테스트와 평가를 먼저 작성하라. 테스트와 평가는 에이전트와의 계약이며, 잘 만든 평가 스위트는 어떤 자연어 프롬프트보다 의도를 정확하게 전달한다.
- 반복적인 워크플로우 하나를 골라 처음부터 끝까지 첫 번째 실제 에이전트로 만들어보라. 코딩 에이전트로 프로토타입을 만들고, 제 역할을 증명하면 프로덕션으로 올려라. 에이전트 하나를 직접 만드는 경험은 백 가지 사례를 읽는 것보다 많은 것을 가르쳐준다.
- 하네스, 평가 스위트, 정적 컨텍스트를 개인 스크립트가 아닌 팀의 공유 버전 관리 자산으로 취급하라. 가장 많은 가치를 쌓아가는 팀은 하네스를 한 번 구축하고 수없이 다듬는다.
이 모든 것의 근본 원칙은 벽에 붙여두고 싶은 한 문장으로 요약된다. AI는 엔지니어링 문화를 증폭시킨다. 강점도, 약점도 함께 배가된다. 코드 생성 문제는 점점 해결되고 있다. 남은 과제, 그리고 지금 잘하게 될 가치가 있는 과제는 명세 작성, 검증, 그리고 이 둘을 하나로 묶는 시스템이다. 전문은 여기서 확인할 수 있다.


