Anthropic연구Frontier Red Team
Claude와 속성 기반 테스트(property-based testing)로 Python 생태계 전반의 버그 탐지하기
버그 없는 프로그램을 만드는 일은 소프트웨어 엔지니어링에서 손꼽히는 난제입니다. 대규모 소프트웨어 프로젝트에서 버그를 효율적으로 찾아낼 수 있는 에이전트를 개발했습니다.
Muhammad Maaz1,2, Liam DeVoe3, Zac Hatfield-Dodds2, Nicholas Carlini2
1MATS, 2Anthropic, 3Northeastern University
대규모 소프트웨어 프로젝트에서 버그를 효율적으로 찾아낼 수 있는 에이전트를 개발했습니다. 이 에이전트는 코드가 만족해야 할 일반적인 속성을 추론한 뒤, 퍼즈 테스팅(fuzz testing)과 유사한 기법인 속성 기반 테스트를 적용해 NumPy, SciPy, Pandas 같은 주요 Python 패키지에서 버그를 발견합니다. 철저한 수동 검증을 마친 후 해당 버그들을 각 프로젝트 개발자에게 보고하는 중이며, 일부는 이미 패치가 완료되었습니다.
자세한 내용은 전체 논문을 읽거나, GitHub 저장소를 확인하거나, 사이트에서 발견한 버그 목록을 직접 살펴보세요.
들어가며
버그 없는 프로그램을 만드는 일은 소프트웨어 엔지니어링에서 손꼽히는 난제입니다. 개발자가 최선을 다해도 버그는 어딘가에 숨어 있기 마련입니다. 가장 일반적인 테스트 방식은 예시 기반 테스트(example-based test)로, 개발자가 구체적인 사용 사례를 직접 작성하고 실제 출력이 기댓값과 일치하는지 확인합니다. 예를 들어, [2, 10, 5, 4] 리스트에 정렬 함수를 적용했을 때 [2, 4, 5, 10]이 반환되는지 검증하는 식입니다. 하지만 이런 방식으로 프로그램 전체를 빠짐없이 검증하기란 매우 어렵습니다. 개발자가 미처 테스트하지 않은 엣지 케이스에 버그가 남아 있는 경우가 많기 때문입니다. 생각해보면 당연한 일이기도 합니다. 테스트 단계에서 특정 엣지 케이스를 떠올리지 못했다면, 구현 단계에서도 그 케이스를 고려하지 않았을 가능성이 높습니다.
반면 속성 기반 테스트는 코드의 일반적인 속성이 모든(또는 대부분의) 입력에 대해 성립하는지 검증하는 소프트웨어 테스트 패러다임입니다. 개발자는 프로그램의 속성이나 불변 조건을 명시합니다. 예를 들어 "JSON 역직렬화는 직렬화의 역연산이다"와 같은 속성을, 해당 속성이 허용하는 입력의 범위(예: JSON으로 직렬화 가능한 임의의 객체)와 함께 정의합니다. 그러면 속성 기반 테스트 프레임워크가 퍼징과 유사한 기법으로 유효한 입력을 자동 생성하며 이 속성의 반례를 탐색합니다. 개발자가 개별 테스트 케이스가 아닌 입력 도메인 전체를 명시하기 때문에, 속성 기반 테스트를 활용하면 모든 엣지 케이스를 일일이 고민하는 부담에서 벗어나 더 높은 추상화 수준에서 작업할 수 있습니다.
이 연구는 MATS 프로젝트의 결과물로, 2025 NeurIPS Deep Learning for Code 워크숍에서 발표한 논문을 바탕으로 합니다. 우리는 기존 코드에 대해 속성 기반 테스트를 자율적으로 작성하는 AI 에이전트를 개발했습니다. 이 에이전트는 타입 어노테이션, 독스트링, 함수 이름, 주석 등을 읽어 속성을 도출하고, 이를 바탕으로 Hypothesis를 사용해 속성 기반 테스트를 작성합니다.
이번 연구에서는 보안 취약점에 국한하지 않고 버그 탐지 전반을 목표로 삼았습니다. 보안 취약점을 유발하는 많은 종류의 로직 버그는 속성 기반 테스트로 충분히 발견할 수 있습니다. 실제로 최근 블로그 포스트에서 스마트 컨트랙트의 버그 탐지를 다루었는데, 해당 취약점의 대부분이 로직 버그에서 비롯된 것이었습니다. 앞으로는 여기서 소개하는 것과 유사한 기법을 배포 전 단계에 적용해 버그를 선제적으로 발견하는 것도 가능해질 것으로 기대합니다.
이 에이전트를 활용해 NumPy, SciPy, Pandas 등 인기 오픈소스 Python 저장소에서 수백 건의 잠재적 버그를 발견했습니다. 이를 책임감 있게 공개하고 메인테이너에게 불필요한 부담을 주지 않기 위해 각 버그를 꼼꼼히 검토했습니다.
우리가 택한 검토 절차는 일반적인 코드 리뷰보다 훨씬 까다롭지만, 오탐(false positive)을 최소화하는 것을 최우선으로 삼았습니다. 검토 과정은 다음과 같습니다. 먼저 우선순위가 가장 높은 버그만 추려 검토 대상으로 선정했습니다. 선정된 잠재적 버그는 전문가 세 명에게 보내 각자 평균 한 시간씩 검토하도록 했습니다. 세 명의 검토자 중 한 명이라도 유효성을 확신하지 못한 버그는 제외했습니다. 이후 블로그 저자들이 후보 버그 전체를 직접 검토했으며, 정확성에 확신이 생긴 경우에만 해당 저장소 메인테이너에게 이슈를 직접 등록했습니다. 이미 여러 건의 버그 리포트를 제출했으며, 추가 제출도 진행 중입니다.
아직 검증되지 않은 버그와 무효로 판정된 버그까지 포함한 전체 데이터를 이 사이트에 공개해두었습니다. 메인테이너가 직접 확인할 수 있도록 완전성을 갖추기 위한 조치입니다. 앞으로 몇 주에 걸쳐 추가 검증을 마친 나머지 버그들을 계속 보고하고, 대상 PyPI 프로젝트도 확대해 나갈 계획입니다.
# example-based test
def test_sort():
    assert my_sort([1,3,2]) == [1,2,3]
    assert my_sort([1,0,-5]) == [-5,0,1]

# property-based test in Hypothesis
from hypothesis import given, strategies as st

@given(st.lists(st.integers()))
def test_sort(lst):
    result = my_sort(lst)
    for i in range(len(result)-1):
        assert result[i] <= result[i+1]
그림 1. 코드를 테스트하는 두 가지 방법. 예시 기반 단위 테스트는 개발자가 직접 지정한 특정 입력값을 검증합니다. 반면 속성 기반 테스트는 일반적인 속성(예: 정렬된 리스트의 정의)을 명시하고, 해당 속성을 위반하는 입력을 프레임워크가 자동으로 생성해 탐색합니다.
속성 기반 테스트 에이전트
우리의 속성 기반 테스트 에이전트는 커스텀 Claude Code 명령어로 구현되어 있습니다. 에이전트는 단일 인수를 입력받아 테스트 대상을 지정하며, 대상은 단일 Python 파일(예: normalizers.py), 모듈(예: numpy, scipy.signal), 또는 함수(예: requests.get, json.loads) 중 하나입니다. 에이전트는 다음 절차에 따라 잠재적 버그를 찾아냅니다.
- 코드를 읽고, 관련 문서를 조회하며, 코드베이스 내 다른 요소와의 관계를 파악해 대상을 이해합니다.
- 파악한 내용을 바탕으로 속성을 제안합니다.
- Hypothesis를 사용해 해당 속성에 대한 속성 기반 테스트를 작성합니다.
- 테스트를 실행하고 결과를 되짚어봅니다. 실패했다면 실제 버그를 발견한 것인지, 아니면 테스트를 수정해야 하는지 판단합니다. 성공했다면 테스트가 실질적인 의미를 갖는지, 아니면 단순히 자명한 조건을 검증하는 것에 불과한지 확인합니다.
- 실제 버그를 발견했다는 확신이 서면, 형식에 맞춘 버그 리포트를 작성합니다.
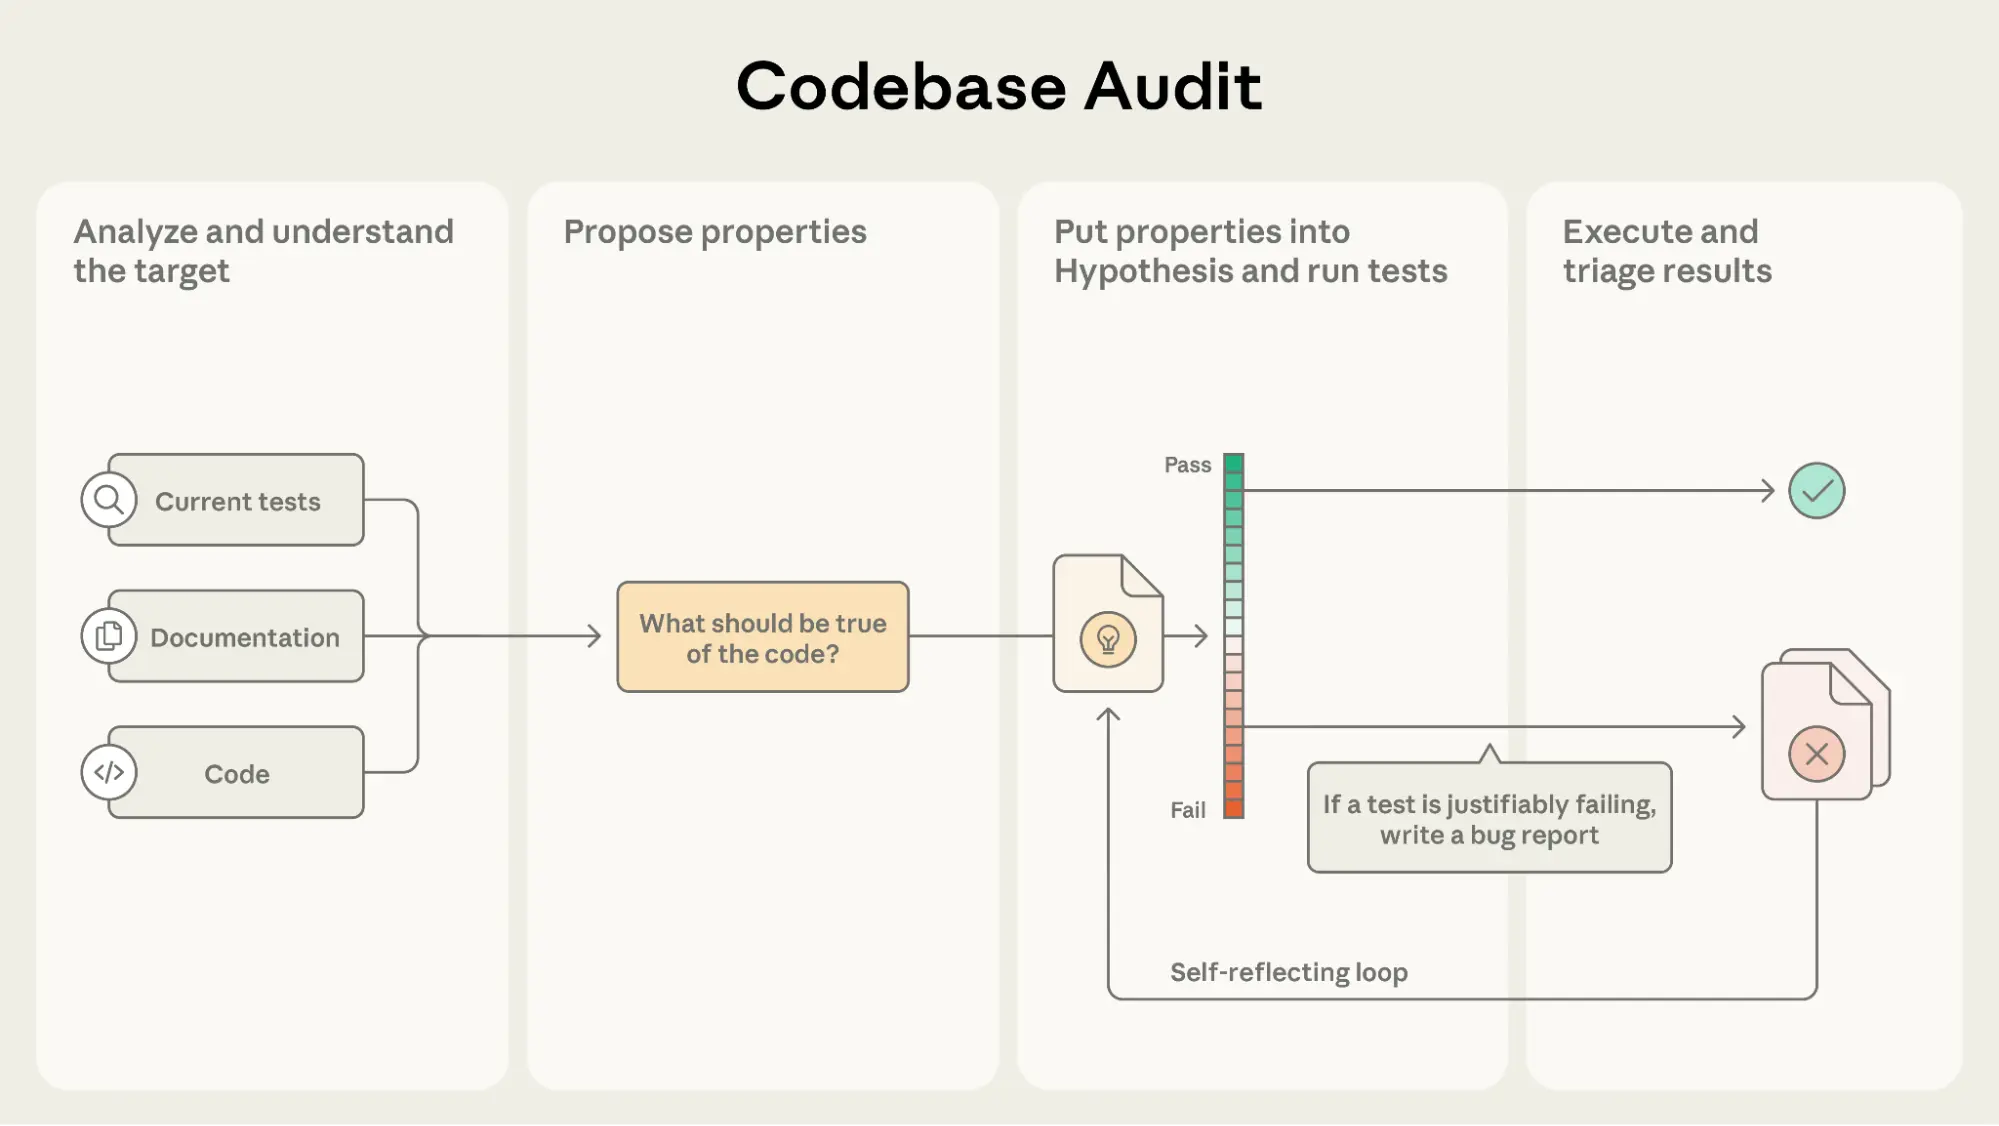
에이전트가 장거리 다단계 추론을 수행할 수 있도록, 할 일 목록을 활용해 진행 상황을 추적하도록 유도했습니다.
에이전트 설계에서 가장 중점을 둔 것은 오탐 감소였습니다. 실제 사용 경험에 비추어 볼 때, 개발자에게 실질적으로 도움이 되는 도구는 잘못된 리포트를 최소화합니다. 자기 반성(self-reflection) 루프가 오탐 감소에 기여하며, 속성을 대상 코드의 명시적 사용 사례와 문서에 근거해 도출하는 방식도 마찬가지입니다. 예를 들어, 한 에이전트 실행에서 처음에는 통과하는 속성을 작성했지만, 자기 반성 과정에서 테스트 전체를 try-catch 블록으로 감싸두었다는 사실을 발견했습니다. 이를 제거하자 테스트가 실패했고 버그가 확인되었습니다. 또한 Opus 4.1과 Sonnet 4.5에서 Sonnet 4 대비 자기 반성 능력이 눈에 띄게 향상된 것도 확인했습니다.
실행 예시
에이전트가 테스트 대상을 어떻게 처리하는지 보여주기 위해, Claude가 numpy.random.wald 구현에서 버그를 발견하는 과정을 요약한 실행 기록을 소개합니다. 에이전트는 먼저 함수의 시그니처, 독스트링, 기존 테스트 코드를 살펴보는 것에서 시작합니다.
참고로 에이전트가 제안한 수정 방법은 정확하지 않습니다. 저희가 직접 버그를 수정하는 과정에서 오류의 원인을 수치적으로 불안정한 계산에서 찾을 수 있었습니다. 병합된 수정 내역은 이 링크에서 확인할 수 있습니다.
실제 PyPI 패키지에서의 버그 탐색
실제 환경에서 에이전트의 성능을 검증하기 위해 수치 계산부터 파싱, 데이터베이스에 이르기까지 다양한 도메인에 걸친 인기 Python 패키지 100여 개를 엄선했습니다. 각 패키지에 에이전트를 실행해 생성된 버그 리포트를 모두 수집했습니다.
에이전트 평가
논문에서 다루는 1단계 평가에서는 Claude Opus 4.1을 사용해 각 패키지에 에이전트를 실행하고 생성된 버그 리포트를 전부 수집했습니다. 리포트 평가 기준은 두 가지로 정했습니다. 첫째, "이것이 유효한 버그인가?", 둘째, "유효한 버그이면서 라이브러리 메인테이너에게 보고할 만한 수준인가?"입니다. 두 번째 기준이 더 엄격합니다. 예를 들어 버그는 실재하더라도 너무 사소해 리포트를 제출하기 애매한 경우가 있기 때문입니다.
984건의 버그 리포트 중 50건을 수동으로 선별해 검토했습니다. 그 결과 56%가 유효한 버그였으며, 32%는 실제로 보고할 만한 유효한 버그였습니다.
이 수동 검토를 바탕으로, 유효하고 수정 가치가 있는 버그를 개발자에게 우선적으로 제시하기 위한 15점 만점의 루브릭(rubric)을 마련했습니다. Opus 4.1을 활용해 모든 버그 리포트를 이 루브릭에 따라 채점했습니다. 이 순위 매기기 단계는 효과가 상당했습니다. 상위 점수 버그 리포트의 86%가 유효했으며, 81%는 유효한 동시에 보고할 만한 수준이었습니다.
2단계 평가에서는 Sonnet 4.5를 사용해 주요 패키지 10개를 대상으로 에이전트를 여러 차례 반복 실행했습니다. 또한 Sonnet 4.5 기반의 평가 에이전트를 별도로 개발해 코드와 버그 리포트를 읽고 버그의 정확성과 심각도를 판별하도록 했으며, 이는 1단계의 루브릭보다 훨씬 정교한 방식이었습니다. 마지막으로 전문가 검토자 3명에게 보수를 지급하고 심각도가 높은 버그의 정확성을 검증하도록 했습니다.
에이전트가 발견한 모든 버그 리포트는 https://mmaaz-git.github.io/agentic-pbt-site/에서 확인할 수 있습니다.
메인테이너 검증
코드에서 버그를 찾는 도구의 효과를 평가하기란 쉽지 않습니다. 버그 리포트의 정확성을 최대한 검증하더라도, 최종 판단은 패키지 메인테이너가 내립니다. 에이전트가 메인테이너 관점에서도 유효하고 수정 가치 있는 버그를 발견하는지 확인하기 위해, 특히 흥미로운 버그 다섯 건을 선별해 수정 패치와 함께 각 GitHub에 직접 보고했습니다. 앞으로 몇 주에 걸쳐 검증을 완료하는 대로 추가 버그 보고를 이어갈 계획입니다.
numpy
numpy.random.wald가 음수를 반환하는 버그입니다. Wald 분포에서 추출한 샘플은 양수여야 하므로 이는 명백한 버그입니다. 앞서 소개한 실행 예시에서 다룬 바로 그 버그이기도 합니다. Claude는 Wald 분포의 이 속성을 알고 있었고, 생성된 모든 샘플이 양수인지 확인하는 간단한 속성 기반 테스트를 작성했습니다. 저희는 오류의 원인을 코드 내 치명적 소거(catastrophic cancellation)에서 찾아냈고, 풀 리퀘스트 제출 시 수치적으로 더 안정적인 공식을 제안했습니다. NumPy 메인테이너가 풀 리퀘스트에서 직접 확인한 바에 따르면, 새로운 공식은 기존 알고리즘보다 상대 오차가 거의 10자릿수 낮습니다.
패치 병합 완료: https://github.com/numpy/numpy/pull/29609
aws-lambda-powertools
slice_dictionary()가 이터레이터를 증가시키지 않아 첫 번째 청크만 반복해서 반환하는 버그입니다. 에이전트는 딕셔너리를 분할한 뒤 재조합하면 원래 딕셔너리가 복원되어야 한다는 속성을 도출해 이 버그를 발견했습니다.
패치 병합 완료: https://github.com/aws-powertools/powertools-lambda-python/pull/7246
cloudformation-cli-java-plugin
item_hash()가 모든 리스트에 대해 hash(None)과 동일한 값을 반환하는 버그입니다. 반환값이 None인 인플레이스(in-place) .sort() 메서드를 사용한 것이 원인입니다. 에이전트는 서로 다른 입력의 해시값은 달라야 한다는 속성을 테스트해 이 버그를 잡아냈습니다.
패치 제출 완료: https://github.com/aws-cloudformation/cloudformation-cli/pull/1106
tokenizers
EncodingVisualizer.calculate_label_colors()에 닫는 괄호가 누락되어 유효하지 않은 HSL CSS를 반환하는 버그입니다. 에이전트는 출력값이 HSL 색상 코드 정규식과 일치해야 한다는 속성을 테스트해 이를 발견했습니다.
패치 병합 완료: https://github.com/huggingface/tokenizers/pull/1853
python-dateutil
easter()가 율리우스력(Julian calendar)을 사용할 때 일부 연도에서 일요일이 아닌 날짜를 반환하는 문제입니다. 메인테이너는 서로 다른 역법 체계로 인한 의도된 동작이라고 밝혔으며, 이 동작의 의미가 미묘하다는 점도 인정했습니다.
이슈 무효 처리: https://github.com/dateutil/dateutil/issues/1437
python-dateutil 리포트는 에이전트의 중요한 한계를 보여줍니다. 의미가 미묘하거나 복잡한 코드에서 속성을 도출하는 것은 여전히 어렵습니다. 코드가 묵시적인 가정을 전제하고 있다면, 올바른 테스트 속성이 무엇인지는 라이브러리 메인테이너만이 판단할 수 있습니다.
결론
언어 모델이 계속해서 발전함에 따라, 에이전틱 속성 기반 테스트는 인간이 작성하는 테스트를 보완하는 점점 더 중요한 수단이 될 것으로 생각합니다. 속성 기반 테스트가 제공하는 높은 수준의 의미론적 보장은 개발 과정과 자연스럽게 결합됩니다. LLM은 함수 이름, 독스트링, 다른 함수에서의 호출 방식 등 맥락을 바탕으로 특정 코드 블록이 반드시 만족해야 할 속성을 파악하는 데 특히 뛰어남을 확인했습니다. 덕분에 LLM이 높은 품질의 속성 기반 테스트를 효과적으로 작성할 수 있습니다.
앞으로 LLM을 테스트와 버그 탐지에 적용하는 것은 중요한 연구 방향이라고 생각합니다. 특히 LLM의 취약점 익스플로잇 능력이 향상될수록, LLM을 공격에 활용하는 악의적 행위자보다 한발 앞서 나가는 것이 필수적입니다.
이번 연구에서는 자동 패치 생성을 다루지 않았지만, 이는 명확한 향후 연구 방향입니다. 코드 블록의 정확성 속성을 (거의) 완전하게 명세할 수 있다면 버그 수정이 훨씬 수월해집니다. 머지않아 LLM이 메인테이너가 검토할 만한 수준의 고품질 패치를 효과적으로 제안할 수 있을 것으로 기대합니다.