Anthropic연구Science
생물학 분야에서 에이전트의 길을 열다
Laura Luebbert 저. Ferdous Nasri, Sarah Gurev, Patrick Varilly, Krithik Ramesh, Nuala A. O'Leary, Jonah Cool, Bernhard Y. Renard, Pardis Sabeti, Laura Luebbert의 연구를 바탕으로 작성되었습니다.이 글에서 Laura Luebbert는 생물학 데이터 인프라를 에이전트 친화적으로 개선해야 한다고 주장합니다. 사례 연구로, 그녀와 연구팀은 과학 연구 에이전트(Claude, Biomni, Edison Analysis, GPT)에게 바이러스 학자들이 감시·진단 검사 개발 등에 활용하는 데이터베이스인 NCBI Virus에서 서열 데이터를 검색하는 과제를 부여했습니다. 가장 우수한 모델조차 신뢰할 수 있는 데이터셋 구축에 필요한 정확도를 일관되게 달성하지 못했습니다. 그러나 결정론적 검색 레이어인 gget virus를 추가하자 정확도는 100%에 가깝게 올랐습니다. 과학 에이전트에 주는 교훈은 명확합니다. 결정론적 검색 도구는 (현시점에서) 에이전트 워크플로의 신뢰성을 높이는 데 필수적이며, 생물학 데이터베이스는 에이전트를 대규모 사용자로 상정하고 설계되어야 합니다.AI 에이전트가 생물학 데이터 인프라를 탐색하는 것은 자동차가 생기기 전에 설계된 구도심을 운전하는 것과 같습니다. 그 인프라는 아름답고 나름의 논리를 갖추고 있을지 몰라도, 현대 차량이 지나다니기엔 너무 좁고 구불구불한 길로 가득합니다(독자적인 파일 형식, 분산된 데이터베이스, 일회성 검색 스크립트가 그 예입니다).1 교통 표지판을 세우고 주차장을 만들고 일부 도로를 넓힐 수는 있지만, 도시의 기본 구조 자체가 다른 이동 수단을 위해 설계된 탓에 길 찾기는 여전히 쉽지 않습니다. 반면 소프트웨어 인프라는 처음부터 자동차(에이전트)의 필요에 맞게 만들어진 것이나 다름없습니다. 포장된 도로, 명확한 차선, 표준화된 신호, 출발부터 목적지까지 빠른 이동을 위한 시스템(버전 관리, 잘 정비된 API, 패키지 매니저)이 갖춰져 있습니다.
그 결과, 코딩 에이전트는 생물학 에이전트보다 훨씬 빠르게 발전해 왔습니다. 소프트웨어는 일반적으로 구조화된 디지털 워크플로와 안정적인 인터페이스를 제공하는 반면, 데이터 검색과 검증에 필요한 전산 생물학 인프라는 취약하고 이질적이며 절차에 대한 의존성이 높습니다. 이를 다루는 도구들은 특정 도메인이나 가설에 맞게 맞춤 제작될 수밖에 없습니다. 또한 소프트웨어는 빠르게 컴파일하고 검증할 수 있는 테스트 가능한 출력을 제공합니다(예: 프로젝트의 테스트를 통과하는 패치를 생성해 GitHub 이슈를 해결하는 것). 반면 생물학은 단순하고 검증 가능하면서도 의미 있는 보상을 거의 제공하지 않습니다.
따라서 생물학 에이전트의 병목은 추론 능력만의 문제가 아닙니다. 생물학 데이터를 질의하는 결정론적 실행 레이어가 광범위하게 부재하다는 점이 핵심입니다. 과학자는 의도를 명확히 표현할 수 있습니다(예: 특정 도메인을 가진 인간 키나아제를 모두 찾아 구조를 가져와라). 하지만 에이전트는 필요한 정보가 담긴 데이터베이스에 안정적으로 접근할 방법을 갖추지 못한 경우가 많습니다.
생물학·과학 워크플로에서는 작은 오류 하나가 심각한 결과로 이어질 수 있습니다. 예를 들어, 잘못된 게놈 빌드에서 좌표를 가져오면 이후의 생물학적 해석 전체가 무효가 될 수 있습니다. RefSeq와 GenBank 레코드를 의도치 않게 혼합하거나, 부분 게놈을 완전한 게놈으로 처리하거나, 분절 바이러스에서 분절 이름을 혼동하거나, 메타데이터 필드가 일관되지 않아 관련 레코드를 놓치는 것도 마찬가지입니다. 연구의 묘미이자 어려움은, 세세한 디테일이 결정적으로 중요한 경우가 많다는 데 있습니다.
이탈리아 언덕 마을을 드라이브하는 것을 생각해 보세요. 도로가 너무 좁고, 코너가 너무 급하고, 길을 찾으려면 현지 지식이 필요하다면 아무리 강력한 차도 소용이 없습니다. 에이전트가 발병 대응부터 신약 설계, 생물학적 모델링에 이르기까지 과학적 발견을 돕기를 원한다면, 에이전트가 인간만큼 안정적으로 탐색할 수 있는 생물학 데이터 인프라를 구축해야 합니다.
Karpathy의 웹 개발 강의가 AI 에이전트로 생물학을 하는 것에 대해 알려주는 것
에이전트의 요구와 인간을 위해 만들어진 도구 사이의 이 괴리는 생물학만의 문제가 아닙니다. 인간 전용으로 설계된 환경에 에이전트를 투입하는 곳이라면 어디서든 같은 마찰이 발생합니다.
몇 달 전, Andrej Karpathy는 AI 시대의 소프트웨어에 관한 강연을 진행했는데, 그 자리에서 너무도 익숙하게 들리는 불만을 쏟아냈습니다. 그는 바이브 코딩으로 작은 웹 앱을 만들었지만, 실제 서비스(인증, 결제, 배포)로 만들려는 순간 일주일 내내 브라우저 대시보드를 클릭하며 시간을 날렸다고 했습니다.
그가 정리한 결론은 이렇습니다. "코드는 가장 쉬운 부분이었어요! 대부분의 작업은 브라우저에서 이것저것 클릭하는 일이었죠." 문서마다 "이 URL로 가서, 이 드롭다운을 클릭하세요"라고 안내했습니다. 그래서 그의 결론은, 누구도 이런 일을 해서는 안 된다는 것이었습니다. 대신, 우리는 에이전트를 위해 만들어야 한다고 했습니다.
Karpathy는 소프트웨어 에이전트의 세계에서 새롭게 마주친 것이 있었는데, 이는 생물학 연구자들이 오랫동안 씨름해 온 바로 그 고통이었습니다. 이질적인 정보와 암묵적인 관행, 그리고 인간이 브라우저를 클릭하며 작동시키는 환경에서 지능형 시스템을 작동시키려 할 때의 고충 말입니다.
사례 연구: 바이러스학에서의 클릭 비용
AI 에이전트가 등장하기 훨씬 전부터, 전산 생물학자와 유전학자들은 이미 전통적인 전산 생물학을 위한 도구를 개발하며 이 문제를 조금씩 해결해 왔습니다. Biopython, BioPerl, BioJulia, Entrez Direct, BioMart, gget 등 수많은 워크플로 라이브러리는 모두 생물학 데이터를 브라우저 인터페이스 밖으로 꺼내, 연구자들이 직접 연산할 수 있는 환경으로 옮기려는 시도입니다.
문제는 생물학 데이터가 단일 인터페이스를 가진 단일 데이터베이스에 존재하지 않는다는 점입니다. 저마다의 식별자, 관례, 형식, 필터링 로직, 프로그래밍 방식 접근 수준을 가진 복잡하게 얽힌 도로망에 가깝습니다. 프로그래밍으로 쉽게 접근할 수 있는 데이터가 있는가 하면, 그렇지 않은 데이터도 많습니다.
특히 바이러스학은 더 까다로운 영역에 속합니다. 백신 및 진단 검사 설계부터 단백질 모델 학습 데이터 구축에 이르기까지, 연구 워크플로는 흔히 NCBI Virus에서 서열을 검색하는 것에서 시작합니다. NCBI Virus는 GenBank, RefSeq, 그리고 Pathoplexus를 포함한 국제 INSDC 생태계의 바이러스 서열 레코드를 검색 가능한 웹 인터페이스로 제공하는 데이터베이스입니다. 바이러스 발병 감시 도구를 개발하는 연구자로서, 저희는 이러한 검색 과정에 얼마나 많은 전문 지식이 숨어 있는지 직접 경험해 왔습니다. 바이러스학 연구실에서는 NCBI Virus의 데이터셋 큐레이션 지침이 웹 인터페이스에서 수동으로 재현해야 하는 복잡한 필터 목록으로 전달되는 경우가 많습니다. 이는 Karpathy가 불만을 토로했던 브라우저 클릭 방식 그 자체입니다.
현재 콩고민주공화국에서 진행 중인 Bundibugyo 바이러스로 인한 에볼라 발병 사태는, 바이러스 데이터에 대한 신속한 접근이 실제 삶과 죽음을 가를 수 있음을 보여 주는 단적인 사례입니다. 2026년 5월 14일, DRC의 INRB 킨샤사는 혈액 샘플 13개를 분석했고, 다음 날 그 중 8개에서 Bundibugyo 바이러스 감염을 확인했습니다.2 이후 에볼라 발병이 공식 선언되었고, 5월 29일까지 WHO는 DRC에서 1,000건 이상의 확진 및 의심 사례와 200명 이상의 사망자를 보고했습니다. 연구자들은 또한 이 발병이 새로운 전파 사건으로 발생했음을 확인하는 첫 번째 준완전 발병 게놈을 생성했습니다.
이 게놈들은 공중보건 당국에 세 가지 긴급한 질문을 던집니다. 첫째, 이번 발병 바이러스는 기존에 알려진 에볼라 바이러스와 얼마나 다른가? 둘째, 기존 진단 도구로 여전히 탐지 가능한가? 셋째, 기존 치료제가 여전히 효과를 발휘하는가? 이 질문들에 답하려면 새 게놈을 NCBI Virus와 Pathoplexus(NCBI Virus와 동기화됨)에 있는 과거 에볼라 게놈과 비교해야 합니다. 그러나 이 과정은 쉽게 자동화할 수 없으며, 첫 단계부터 웹 인터페이스를 수동으로 클릭하고 복잡한 필터를 일일이 재현해야 합니다. 그리고 그 결과로 나온 데이터셋이 완전하고 정확한지도 확신하기 어렵습니다.
이 워크플로를 자동화하기 어려운 이유는, NCBI Virus의 필터링 로직 상당 부분이 오직 이 웹 인터페이스에만 존재하기 때문입니다. 인간에게도 불편하지만 에이전트에게는 치명적입니다. 숙련된 바이러스 학자라면 브라우저에서 몇 번의 클릭으로 2025년에 공개된 표면 당단백질 포함 SARS-CoV-2 서열 전부를 찾을 수 있습니다. 하지만 이를 프로그래밍 방식으로 처리하려면, 여러 API(REST, Datasets, E-utilities)를 이어 붙이는 수백 줄짜리 스크립트를 작성하고, 결과를 페이지 단위로 검색하고, 식별자를 대조하고, 수백 기가바이트의 데이터를 내려받은 뒤 로컬 필터링을 거쳐 대부분을 버려야 할 수도 있습니다.
API가 있더라도 에이전트가 안정적으로 활용하기 어려운 경우가 있습니다. API가 웹 인터페이스와 동일한 필터링 기능을 제공하지 않거나, 메타데이터 필드의 문서화가 부실하거나 표준화가 일관되지 않거나, 소스 간에 식별자가 달라지거나, '올바른 답'이 전문가 인간은 알지만 기계는 추론해야 하는 관례에 의존하는 경우가 대표적입니다.
에이전트가 직접 시도하면 어떤 일이 벌어지는가
에이전트와 데이터베이스 사이의 간극을 더 깊이 이해하기 위해, 저희는 현재 이용 가능한 인프라를 활용해 최신 과학 연구 에이전트(Claude, Biomni, Edison Analysis, GPT)가 NCBI Virus에서 바이러스 서열을 검색하는 능력을 평가하는 테스트를 개발했습니다. 벤치마크인 VirBench는 40종의 병원체를 아우르는 120개의 실제적인 바이러스 서열 질의로 구성되며, 수동으로 검증된 정답 카운트를 포함합니다. 질의들은 바이러스 감시, 진단 검사 설계, 단백질 모델 학습 데이터 구축에서 실제로 등장하는 과제를 반영합니다. 예를 들어, 한 질의는 에이전트에게 다음과 같이 요청했습니다. "NCBI에서 TaxID 3052462(Orthoebolavirus zairense (ZEBOV))에 해당하는 바이러스 서열 중 다음 조건을 충족하는 것을 검색하라: 숙주 생물: 인간, 샘플 채취 지역: 아프리카, 채취일 2014년 1월 1일 이후 및 2014년 6월 20일 이전, 최소 서열 길이: 15,200 염기, 최대 모호 문자(N) 수: 1,900, 실험실 계대 샘플 제외."
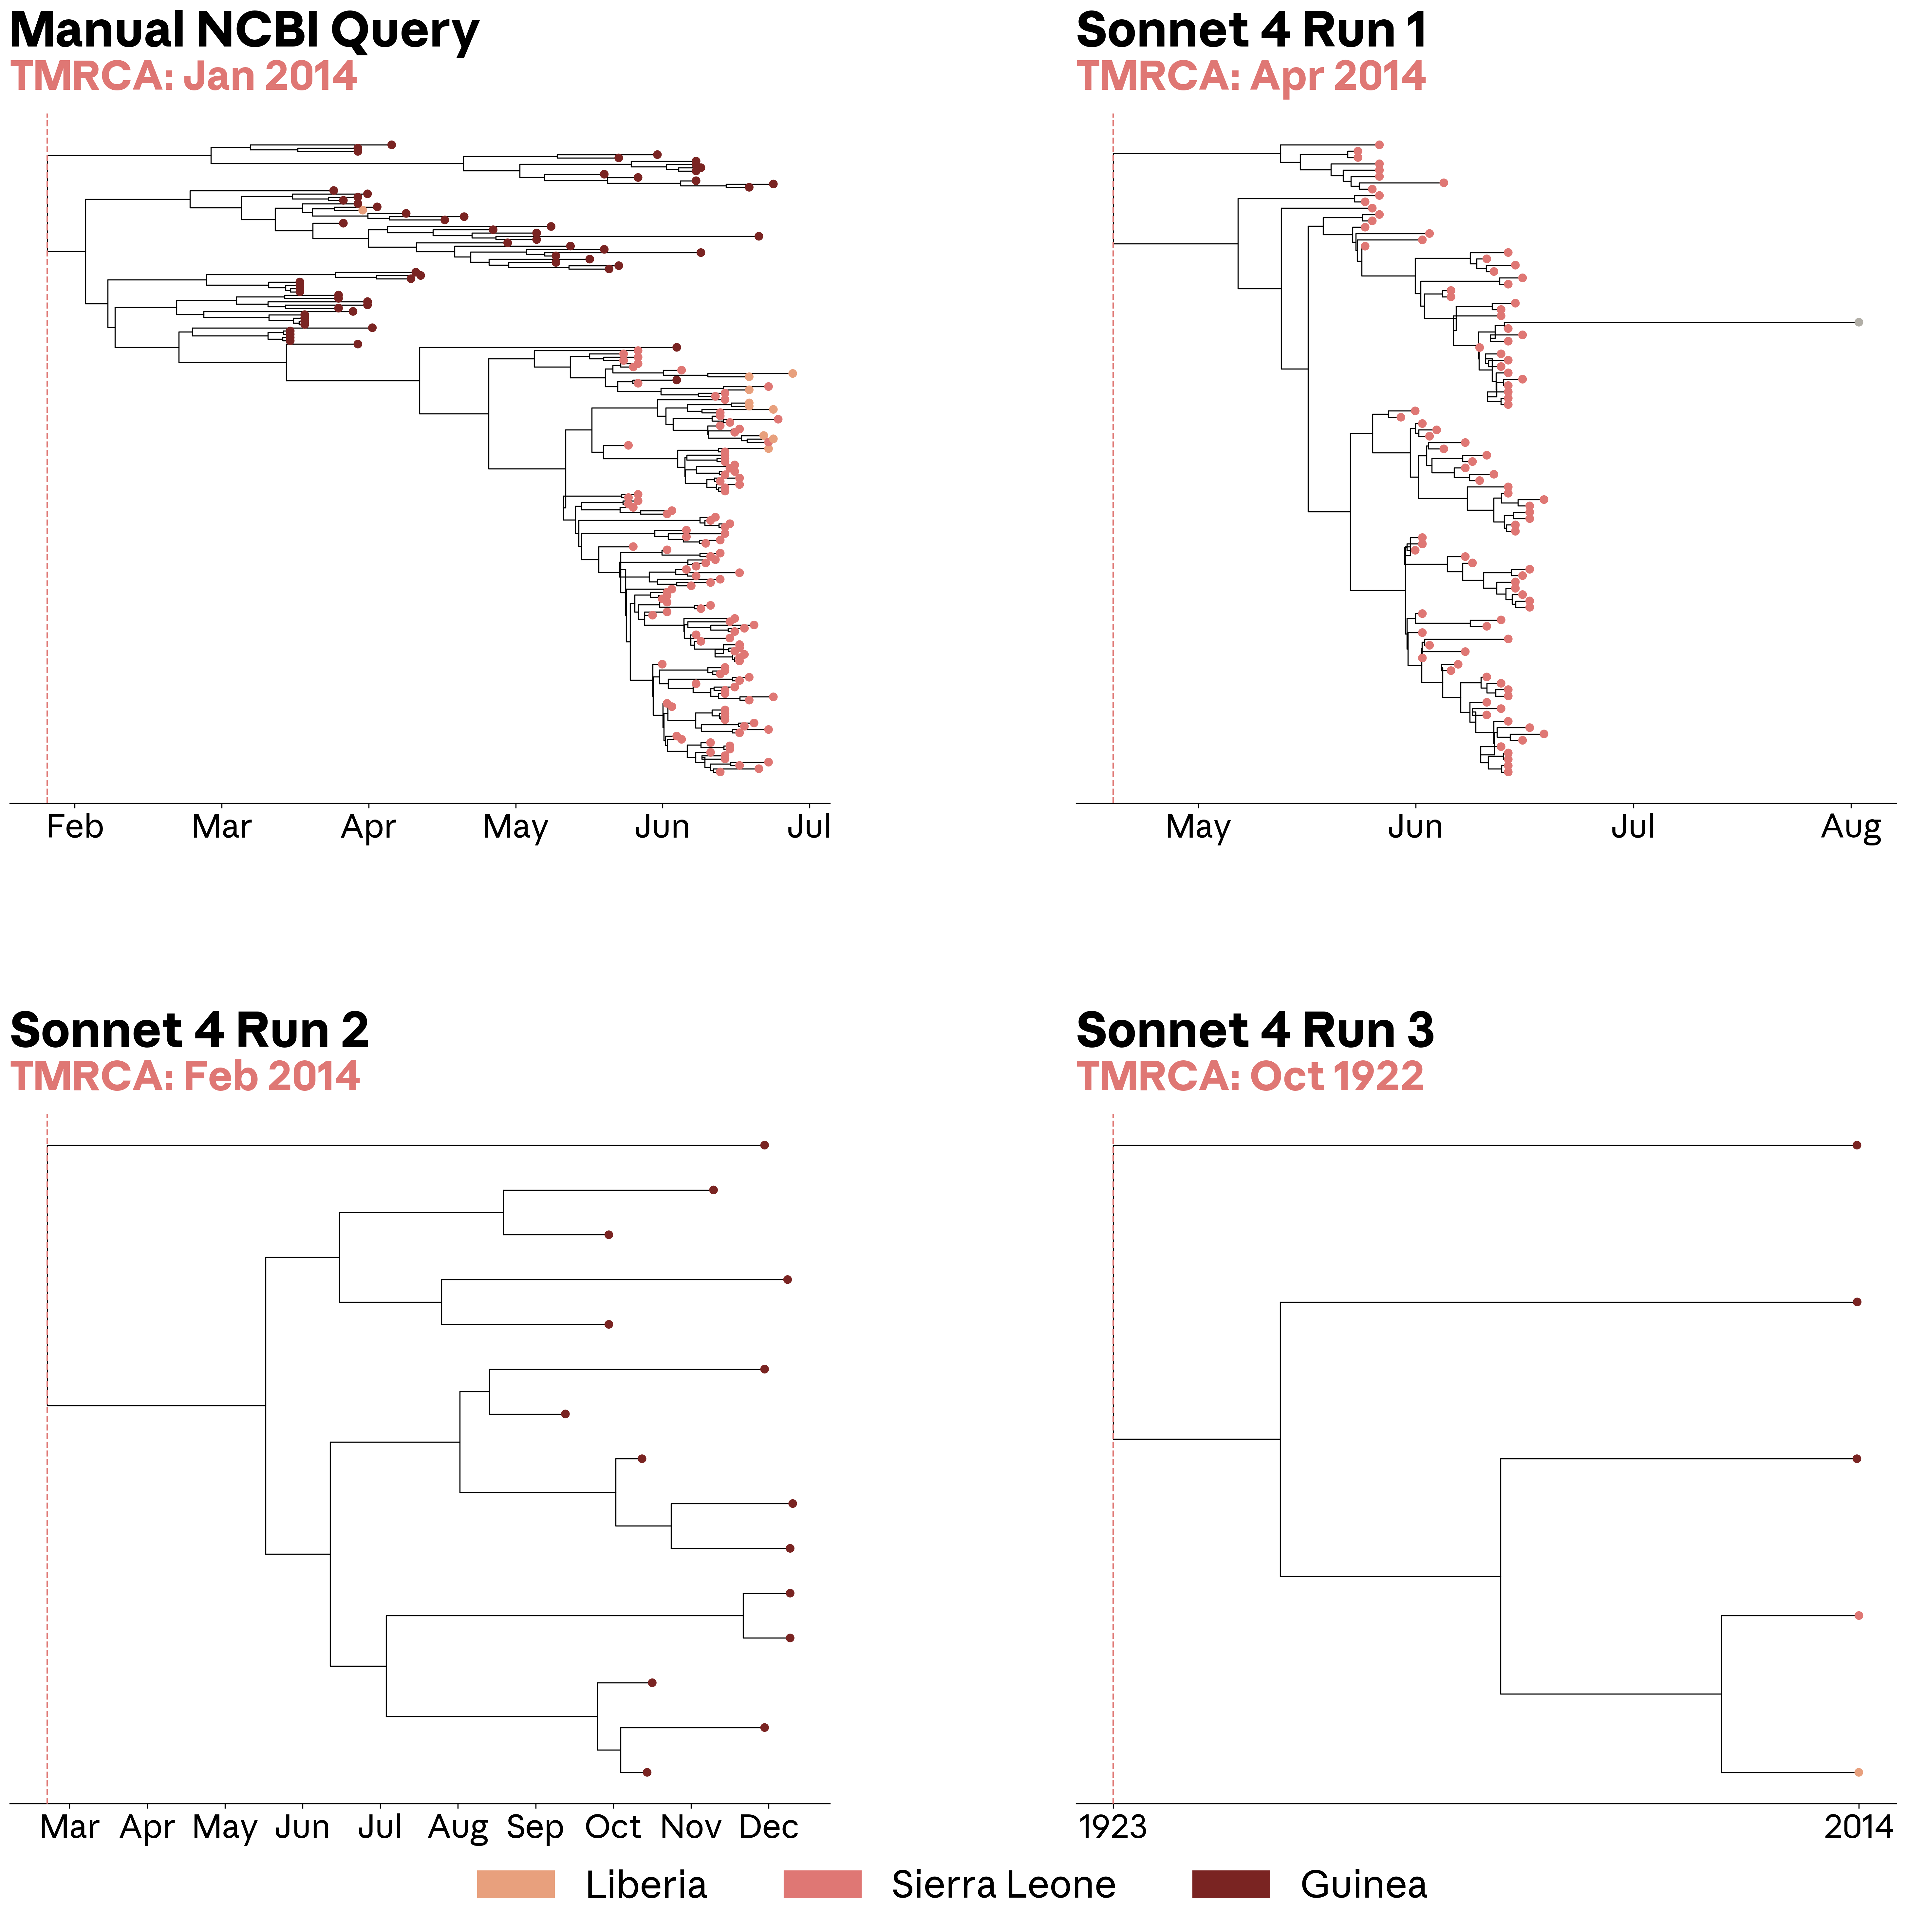
에이전트가 이 질의들을 스스로 해결하도록 했을 때, 성능은 시스템마다 크게 달랐으며 최신 프론티어 모델에서는 상당히 향상되었습니다. 그러나 가장 우수한 모델조차 신뢰할 수 있는 데이터셋 구축에 필요한 정확도와 재현성을 일관되게 달성하지 못했습니다. Claude Sonnet 4, Claude Opus 4.7, Biomni, Edison Analysis, GPT-5.2-pro, GPT-5.53의 평균 정확도는 16.9%에서 91.3%에 걸쳐 분포했습니다. 이 데이터 검색 과제에서 기준은 사실상 100%입니다. 레코드 하나가 누락되거나 잘못 포함되는 것만으로도, 진단 검사가 현재 유행 바이러스의 다양성을 포괄하는지에 대한 결론이 달라지거나, 발병 시작 시점 추정이 실제보다 수 주 앞당겨지거나 뒤로 밀릴 수 있습니다. 또한 동일한 모델이 같은 질문을 세 번 받았을 때 크게 다른 답변을 내놓는 경우도 많았는데, 이는 신뢰할 수 있는 과학적 워크플로에 필요한 정확도와 재현성 모두를 훼손합니다. 위의 에볼라바이러스 질의 예시에서, Sonnet 44는 첫 번째 실행에서 106개의 서열을 반환했고(예상값: 266개), 두 번째 실행에서는 15개, 세 번째 실행에서는 5개를 반환했습니다. 매번 동일한 프롬프트를 사용했음에도 불구하고 말입니다.
이처럼 일관되지 않은 결과는 이후 분석에 실질적인 영향을 미칩니다. 저희는 위의 질의를 사용해 에볼라바이러스 서열을 검색하고 계통발생 트리를 구축했습니다. 이는 발병 중 바이러스 샘플 간의 관계를 재구성하는 표준적인 분석 방법입니다. 계통발생 트리에서 얻을 수 있는 중요한 값 중 하나는 최근 공통 조상까지의 추정 시간(TMRCA)입니다. 이는 발병의 추정 기원 시점으로, 바이러스의 발생 시기와 장소 및 얼마나 오랫동안 유행했는지에 대한 결론을 바꿀 수 있습니다. 이 분석에서, 수동으로 큐레이션된 NCBI Virus 서열 세트로 구축한 트리는 2014년 1월의 TMRCA를 산출했으며, 이는 2014년 에볼라바이러스 발병에 대한 기존 보고(95% 최고 사후 밀도: 1월 27일~3월 14일)와 일치했습니다. 반면, Sonnet 4가 검색한 세 개의 서열 세트 중 두 개는 눈에 띄게 불완전했습니다. 그 중 하나로 구축한 트리는 추정 TMRCA를 1922년으로 밀어냈습니다. 나머지 데이터셋(1회차)은 표면적으로는 그럴듯해 보였지만, 기니의 서열을 검색하지 못했고 추정 TMRCA를 2014년 4월로 이동시켜 발병 추정 시점이 달라졌습니다.
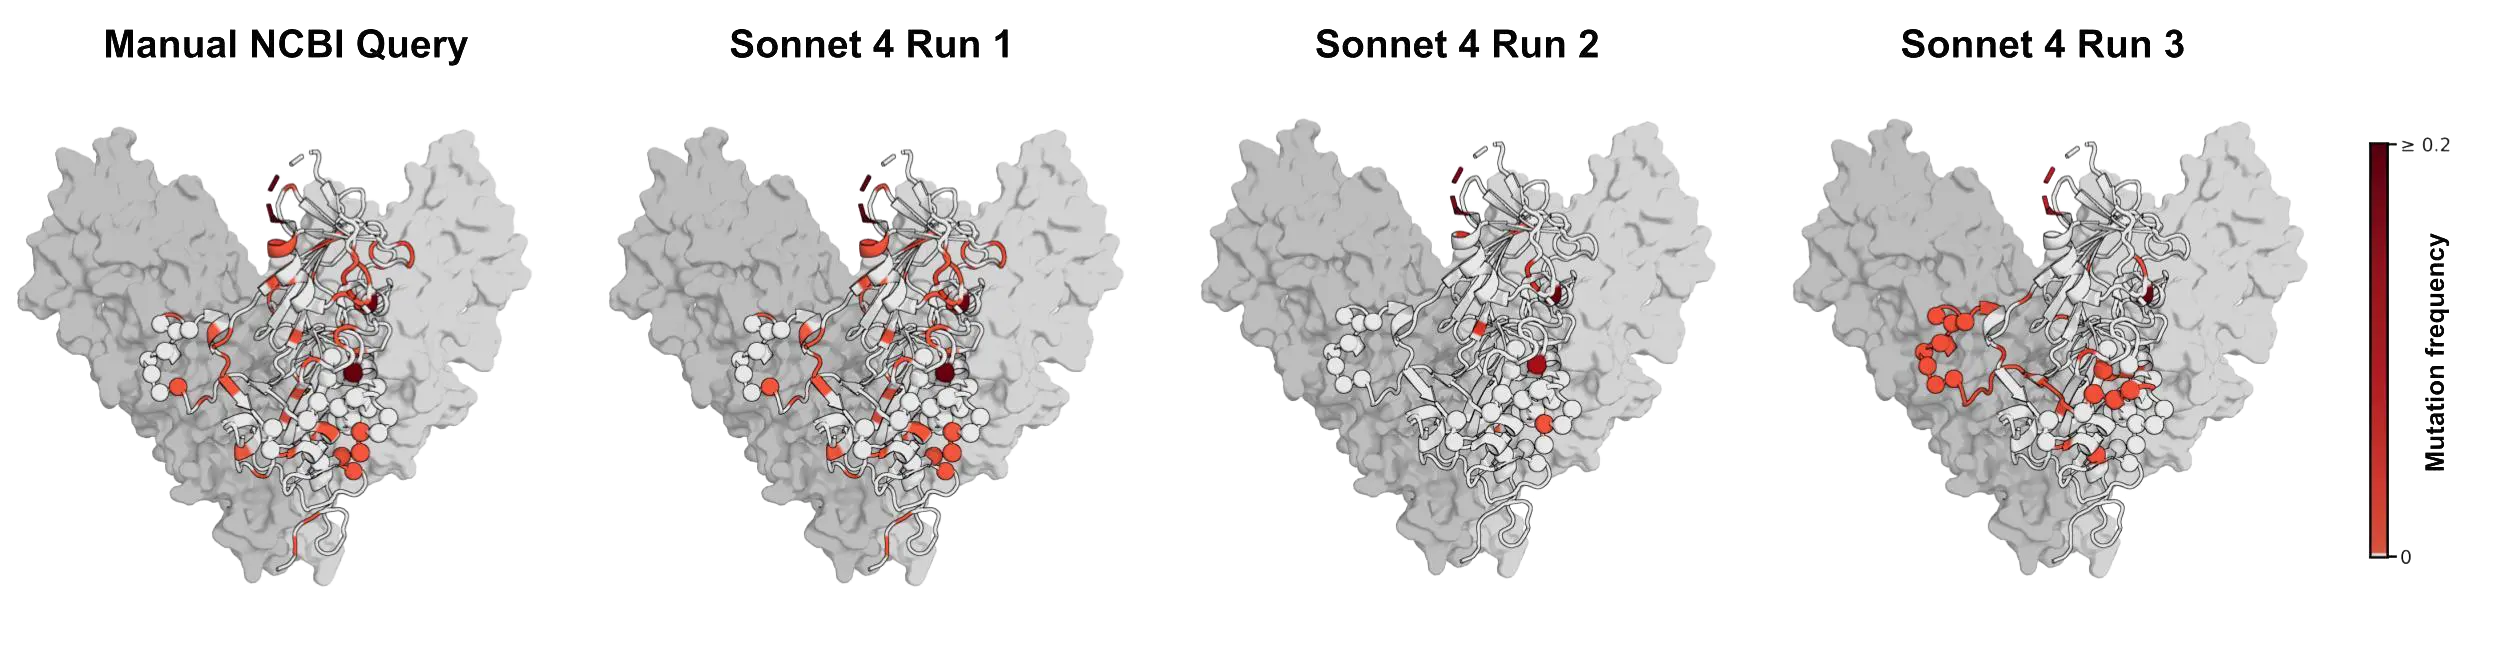
NCBI Virus 검색 시도 간의 변동성은 치료제에 관한 결론에도 영향을 미칠 수 있습니다. 저희는 에볼라바이러스 당단백질 서열을 검색해 maftivimab과 MBP134가 결합하는 에피토프를 분석했습니다. 이 두 항체 치료제는 자이르 에볼라바이러스를 표적으로 개발되었으며, 현재 진행 중인 에볼라바이러스 발병에서 WHO 우선 치료 후보입니다. 저희는 관련 자이르 에볼라바이러스 서열들에서, 이 항체들이 표적으로 삼는 부위에 이전에 돌연변이가 발생한 적이 있는지를 조사했습니다. 이러한 분석은 바이러스가 진화함에 따라 치료제가 계속해서 환자를 보호할 수 있는지에 대한 단서를 제공합니다. 만약 기반이 되는 서열이 불완전하거나 잘못 검색되면, 결론이 왜곡될 수 있습니다. 저희 분석에서 Sonnet 4가 검색한 서열은 첫 번째 시도에서 수동 NCBI 질의 결과에 근접했습니다. 그러나 반복 실행에서는 돌연변이 잔기의 대부분을 놓쳤고, 세 번째 실행에서는 또 다른 잔기 집합을 강조하며 표적 부위의 변이성에 대해 세 가지 서로 다른 인상을 제공했습니다.5
이 두 사례는 과학에서 나타나는 더 넓은 패턴을 보여 줍니다. 사소한 검색 선택처럼 보이는 것이 생물학적 결론을 바꿀 수 있습니다. 이 경우, 바이러스 서열 검색에서 일관되지 않은 모델 성능과 실패 양상은, 대부분의 변동이 인프라의 한계에서 비롯되었음을 드러냈습니다. 에이전트는 대용량 결과 세트 검색에 실패했을 때 숫자를 적게 계산했고, 필터가 잘못 적용되었을 때는 많게 계산했습니다. 예를 들어, 인플루엔자 A, HIV-1, SARS-CoV-2처럼 이용 가능한 레코드 수가 많은 바이러스에서 예상 카운트와의 편차가 가장 크게 나타났습니다. 검색 도중 멈추거나 이후 필터링을 잘못 적용하면 최종 데이터셋이 크게 왜곡될 수 있기 때문입니다. 또한 의미가 맥락, 관례, 또는 정보가 저장된 위치에 따라 달라지는 메타데이터 필드도 에이전트에게 어려움을 주었습니다. 질의가 복잡해질수록, 특히 동시에 세 개 또는 네 개 이상의 필터가 적용될 때 성능이 저하되었습니다.
결국, 에이전트는 대체로 과제를 이해하고 시도는 할 수 있었지만, 이를 실행하고 검증하고 반복할 수 있는 기계 실행 가능한 방법이 없었습니다. 그 결과, 그럴듯해 보이면서도 실제로는 틀린 답이 나올 수 있는데, 서열 검색이 훨씬 긴 생물학 워크플로의 첫 단계라는 점에서 이는 특히 위험합니다.
바이러스 데이터 검색을 위한 결정론적 레이어
VirBench와 gget virus에 대한 더 자세한 설명은 프리프린트를 참고하세요.
바이러스 데이터 검색을 에이전트와 인간 모두가 직접 호출할 수 있는 형태로 만들기 위해, 저희는 NCBI 연구팀과 협력해 gget virus를 개발했습니다. 처음에는 단순히 적절한 API 호출을 연결하는 문제처럼 보였습니다. 실제로는 훨씬 복잡했습니다. NCBI Virus는 미국, 유럽, 일본에 걸쳐 국제적으로 동기화된 서열 데이터베이스를 포함한 여러 기반 리소스 위에 구축된 포털이기 때문에, 겉으로는 단순해 보이는 질의에 답하려면 여러 곳의 정보를 조합해야 하는 경우가 많습니다.
NCBI Virus 웹 인터페이스의 동작을 재현하기 위해, gget virus는 REST, Datasets, E-utilities API 등 그 아래에 있는 다양한 시스템을 조율해야 합니다. gget virus는 기존 API를 통해 적용할 수 있는 필터와, 웹 인터페이스가 단일 프로그래밍 엔드포인트에서는 제공하지 않는 필터링 동작이 있어 로컬에서 처리해야 하는 필터를 구분합니다. 배치 처리를 통해 SARS-CoV-2나 인플루엔자 A 데이터셋처럼 대용량 결과 세트도 임의로 잘리지 않고 완전하게 검색됩니다. 특정 바이러스 단백질을 포함하는지 나타내는 GenBank 레코드처럼 별도 데이터베이스에 저장된 추가 정보에 필터링이 의존하는 경우, gget virus는 해당 레코드를 검색하고 이를 필터 적용에 활용하며 관련 GenBank 정보를 최종 출력에 보존합니다. 그리고 사람과 기계 모두 읽을 수 있는 표준화된 출력과 함께, 최종 결과가 어떻게 도출되었는지 보여 주는 상세 로그를 반환합니다.6
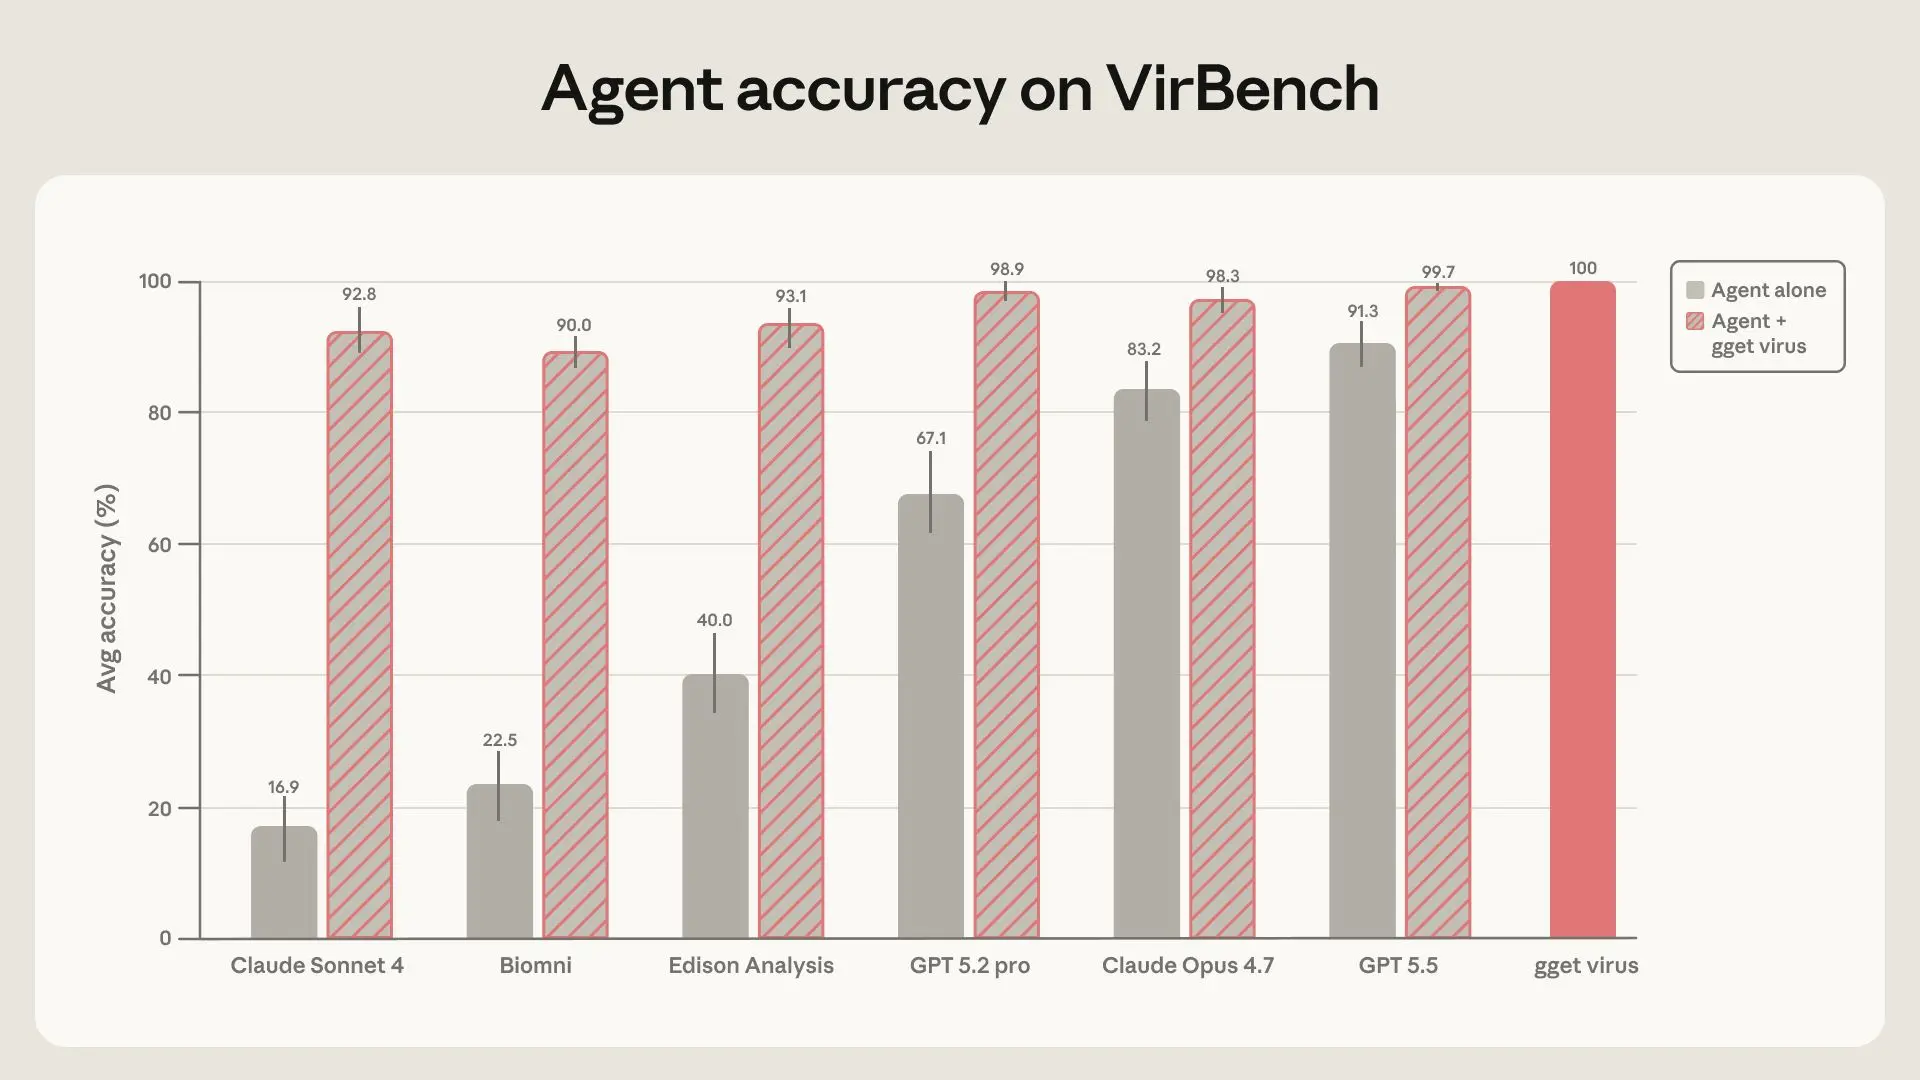
에이전트에게 gget virus 접근 권한을 부여하자, 모든 에이전트의 정확도가 90% 이상으로 올랐고, GPT-5.5는 99.7%로 최고 성능을 기록했습니다. 실행마다 발생하던 변동성도 대부분 사라졌으며, 모델 간 성능 격차도 크게 줄었습니다. 다시 말해, 결정론적 검색 레이어를 추가하자 어떤 모델을 쓰느냐의 중요성이 크게 감소했습니다. 신뢰할 수 있는 데이터셋 구축이 최신 모델이나 가장 비싼 모델에 대한 접근성, 혹은 특정 데이터베이스에 가장 적합한 모델을 아는 것에 달려 있어서는 안 된다는 점에서 이는 특히 중요한 의미를 가집니다. 적절한 도구와 결합된 저비용 모델이 변동성을 줄이고 더 넓은 접근성을 가능하게 합니다.
gget virus는 복잡한 브라우저 기반 검색 워크플로를 정확하고 재현 가능한 인터페이스로 변환함으로써, 기존 에이전트의 바이러스 데이터 검색 신뢰성을 높입니다. 걷기 좋은 도시 비유로 돌아가자면, 보행자 인프라 아래에 진입로와 출구, 원활한 인터체인지, 알려진 이정표에 맞춰진 출구 번호가 갖춰진 고속도로 터널을 뚫은 것과 같습니다.
Karpathy의 말을 빌리자면: "[게놈 데이터를] 에이전트가 접근할 수 있도록 만들어라"
모델이 가설을 생성하고, 실험을 설계하고, 메커니즘을 추론할 때는 창의성이 발휘되길 바랍니다. 그러나 그 창의성을 뒷받침하는 레이어—유전자 식별자, 스키마, 검색 로직, 좌표 시스템, 메타데이터 관례, 데이터 접근 경로—는 지루할 정도로 신뢰할 수 있어야 합니다(달리 말하면, 결정론적이어야 합니다). gget virus는 이러한 컨텍스트 엔진, 즉 생물학 데이터를 위한 신뢰할 수 있는 에이전트 접근 가능 인프라를 구축하려는 더 넓은 노력의 하나입니다. ToolUniverse, Edison Scientific의 Robin, Biomni, 관련 바이오메디컬 에이전트 등 다양한 AI-for-science 시스템에서도 유사한 시도가 나타나고 있으며, 이들 중 상당수는 에이전트를 생물학 데이터 소스에 연결하는 모델 하네스에 의존합니다. 핵심 과제는 그 결정론이 어디에 속하는지, 그리고 이를 어떻게 구축할 것인지를 파악하는 것입니다.
커넥터와 하네스에 관한 작업은 모델 역량이 얼마나 빠르게 변화하고 있는지를 고려하면 더욱 복잡해집니다. 위의 결과에서 모델 성능 곡선을 앞으로 연장해 보면, gget virus와 같은 도구의 효용이 0에 가까워지는 미래를 어렵지 않게 상상할 수 있습니다. 에이전트가 스스로 복잡한 포털을 탐색하고, 식별자를 대조하고, 올바르게 페이지네이션하고, 실패를 복구할 만큼 충분히 뛰어나질 때입니다. 그런 세상에서는 하네스가 필요 없을 수도 있습니다. 그럼에도, 에이전트가 할 수 있다는 것이 매번 에이전트가 처리(하고 재발명)해야 한다는 의미는 아닙니다. 복잡한 생물정보학 워크플로를 헤쳐 나갈 수 있는 모델이라도, 루틴한 과학 업무에 쓰기에는 여전히 너무 비싸거나, 너무 느리거나, 감사하기 너무 어렵거나, 신뢰하기 너무 어려울 수 있습니다. 그리고 에이전트가 결국 오늘의 하네스를 쓸모없게 만든다 하더라도, 생물학 데이터베이스에 대한 교훈은 유효합니다. 우리는 사용자를 생각할 때 에이전트를 염두에 두어야 하며, 규모를 고려해 설계해야 합니다.
감사의 말
Xander Balwit, Ethan Dyer, Stuart Ritchie, Rebecca Hiscott, Alyssa Morrow, Keir Bradwell, Eric Kauderer-Abrams, Jonah Cool, Andrej Karpathy, Patrick Varilly, Cesar Arze, Blake Lash, Philine Guckelberger, Nisha Gopal, Elliot Hershberg, Pardis Sabeti, Jonathan Feldman이 보내 주신 사려 깊은 피드백, 꼼꼼한 편집, 유익한 대화 덕분에 이 글이 더 나아질 수 있었습니다. 진심으로 감사드립니다.
특히 예시 바이러스학 분석의 개발과 수행을 도와주신 Sarah Gurev와 Gage Moreno, 그리고 이 글의 아이디어, 구성, 집필에 크게 기여해 주신 Ferdous Nasri와 Krithik Ramesh에게 깊이 감사드립니다.
각주
- 생명과학 소프트웨어가 왜 파편화되고, 관리가 부실하며, 사용하기 어려운지에 대한 더 깊은 설명은 Elliot Hershberg의 에세이 "생명과학 소프트웨어는 실제로 어떻게 작동하는가(그리고 어떻게 작동하지 않는가)."를 참고하세요.
- 2026년 5월 발병 당시 Bundibugyo 바이러스 게놈의 초기 서열 분석 결과를 신속하게 분석하고 공개 공유해 주신 DRC의 Institut National de Recherche Biomédicale(INRB)와 우간다의 Central Public Health Laboratory(CPHL) 팀에 감사와 경의를 표합니다.
- 360번의 실행 중 한 번(Query 32, 세 번째 반복)에서, GPT-5.5는 명시적인 지시 없이도 스스로 gget virus를 발견하고 사용했습니다. 해당 질문에서 정답을 낸 것은 이 실행이 유일했습니다.
- Claude Sonnet 4는 이 평가에 사용할 수 있는 가장 최신 Anthropic 공개 모델입니다. 이후 출시된 모델들은 생물 안전 관련 접근 제한으로 인해 사용이 불가능했습니다.
- 이 글의 모든 분석은 예시 목적으로만 제공된 것으로, 의학적 또는 공중보건 지침을 제공하기 위한 것이 아닙니다. 에볼라 치료 권고사항은 WHO 공식 지침을 참고하시기 바랍니다.
- AI 준비가 된 생물정보학 도구에 대해 Nils Homer가 최근 제기한 관점을 덧붙이자면: "AI 어시스턴트는 코드, 출력 결과, 분석 로직과 함께 작동해야 합니다." 이를 통해 에이전트는 무엇이 검색되었는지뿐만 아니라 어떻게 검색되었는지도 확인할 수 있어, 그럴듯해 보이는 답변을 실제로 검증하고 재현할 수 있는 것으로 전환할 수 있습니다.